Tracks
พื้นฐานของ AI Agent
6 ชม.
OpenAI เปิดตัว GPT-6.1 Sol เมื่อวันที่ 29 กันยายน 2026 ที่งาน DevDay หนึ่งสัปดาห์ถัดจาก GPT-6 Sol และ 26 วันหลัง GPT-6 Astra.
Astra มีต้นทุนเฉลี่ย $23.80 ต่อหนึ่งงานใน Terminal-Bench Science 0.1 เมื่อใช้ความพยายามสูงสุด ซึ่งทำให้ไม่เหมาะกับงานประจำ Sol คือคำตอบของ OpenAI ต่อปัญหานั้น
ตัวเลขเด่นคือ $2.00 ต่อโทเค็นอินพุต 1 ล้าน, $10.00 ต่อโทเค็นเอาต์พุต 1 ล้าน, หน้าต่างบริบท 1,050,000 โทเค็น และเอาต์พุตสูงสุด 128,000 โทเค็น ใน ประกาศของ OpenAI GPT-6.1 Sol ทำผลงานทัดเทียม Astra บน DeepSWE v1.1 ที่ต้นทุนราวหนึ่งในห้า ทำคะแนนสูงกว่า Claude Opus 5.5 ของ Anthropic บน AutomationBench ที่ระดับความพยายามกลาง 2.2 จุด และมีต้นทุน $5.47 ต่อหนึ่งงานใน Terminal-Bench Science 0.1 เทียบกับ Astra ที่ $23.80
ในบทความนี้ จะครอบคลุมสิ่งที่ใหม่ใน GPT-6.1 Sol โดยดูฟีเจอร์ เกณฑ์วัดผล และตัวเลขด้านความปลอดภัยที่ OpenAI เผยแพร่ ระดับของตระกูล GPT-6 ที่ควรเลือกใช้ และราคา สำหรับเนื้อหาเชิงลึกของรุ่นใกล้เคียง ดูที่ บทเรียน API ของ GPT-6 Sol และคู่มือ Claude Sonnet 5.5
none หรือ minimal และ Chat Completions ไม่สามารถเรียกใช้เครื่องมือได้GPT-6.1 Sol เป็นโมเดลให้เหตุผลระดับกลางของ OpenAI ในตระกูล GPT-6 เปิดตัวเมื่อ 29 กันยายน 2026 ในฐานะอัปเกรดจาก GPT-6 Sol จัดวางต่ำกว่า GPT-6 Astra ซึ่งเปิดตัวเมื่อ 3 กันยายน และสูงกว่า GPT-6 Luna รุ่นเล็ก
OpenAI ระบุว่าทำผลงานเกือบทัดเทียม Astra ในเอเจนต์โค้ดดิ้ง การใช้งานคอมพิวเตอร์ และงานวิชาชีพ
ภาคผนวกของ system card ไปไกลกว่านั้น โดยอธิบายความสามารถที่ใกล้เคียง Astra พร้อมส่วนผสมความเร็วและความคุ้มค่าที่หาเทียบยาก
ควรมองเป็นข้ออ้างอิงเชิงต้นทุน ไม่ใช่เชิงสัมบูรณ์ Astra ยังนำอยู่ในการประเมินด้านไซเบอร์ ชีววิทยา และวิทยาศาสตร์ที่ยากที่สุด
ไม่มี GPT-6.1 Astra หนังสือพิมพ์ The Wall Street Journal รายงานว่า OpenAI ยกเลิกการเปิดตัวเดือนตุลาคมหลังโมเดลถดถอยในแบบทดสอบความสอดคล้องและการรักษาขอบเขตอำนาจที่ผู้ใช้อนุญาต และ OpenAI ยืนยันการตัดสินใจดังกล่าว
ดังนั้น GPT-6.1 Sol จึงเป็นโมเดล 6.1 เพียงรุ่นเดียว และตัวเลขด้านการหลอกลวงและความดื้อดึงของมันเอง (กล่าวถึงด้านล่าง) ควรอ่านอย่างใกล้ชิด
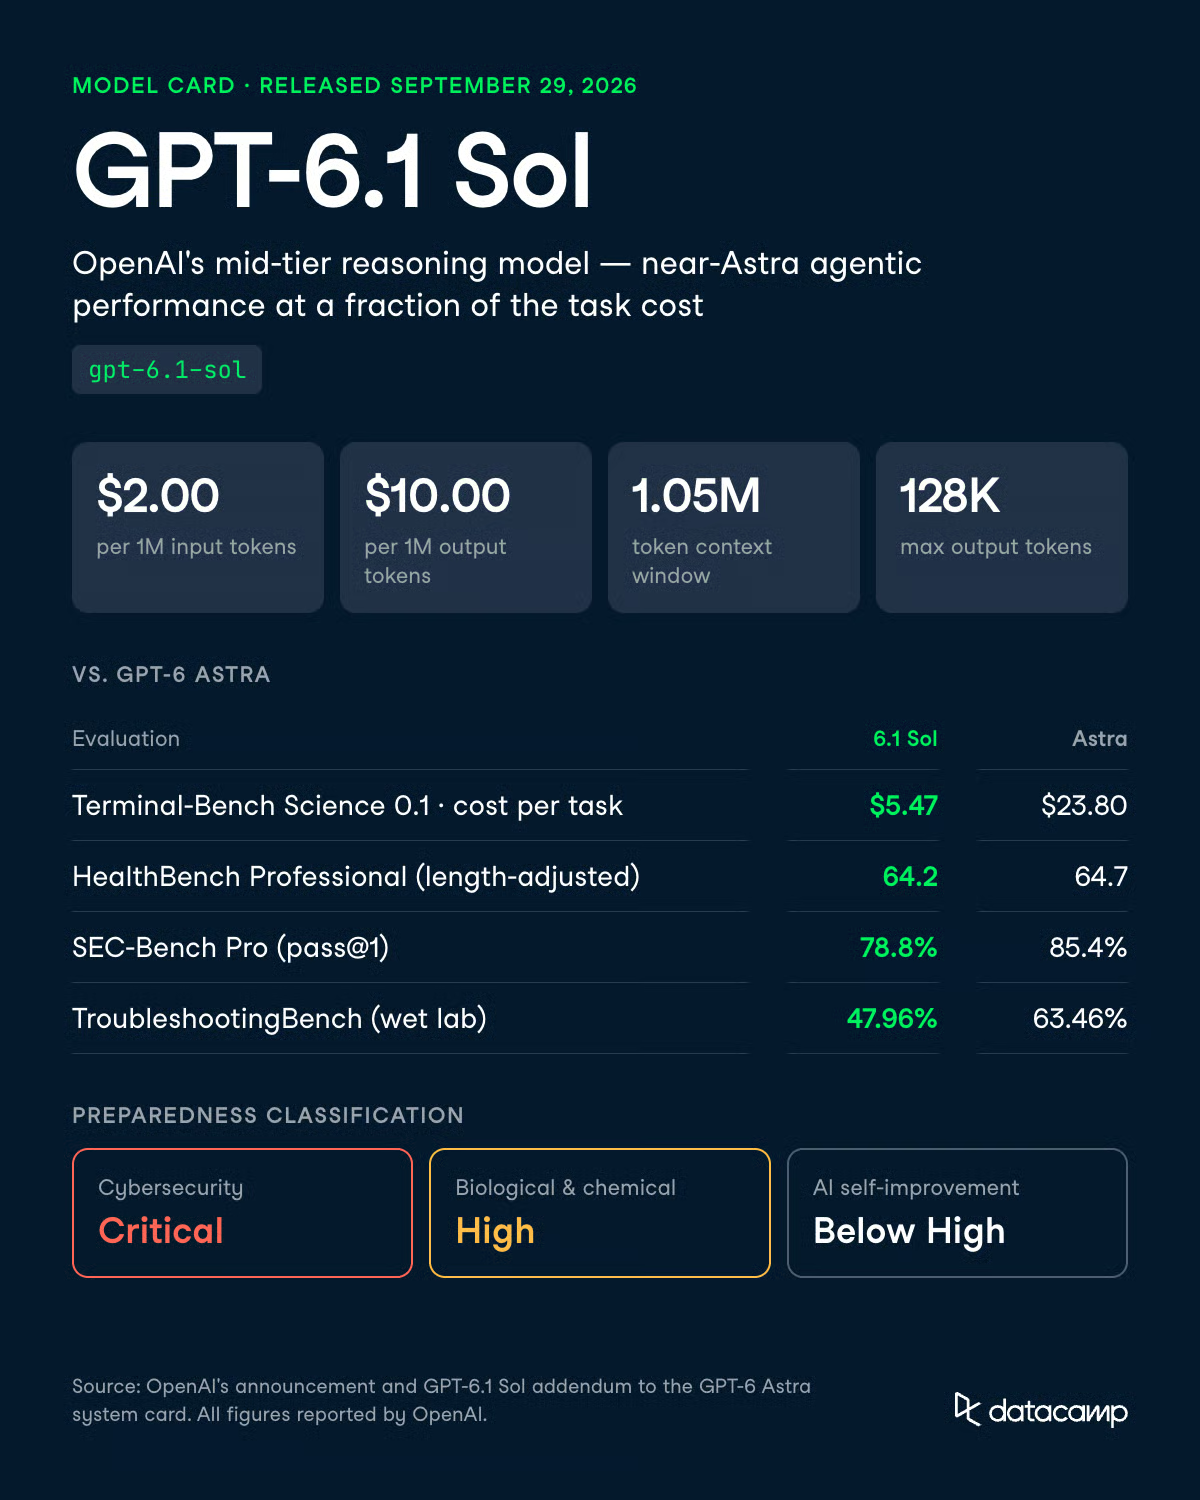
GPT-6.1 Sol ปรับปรุงจาก GPT-6 Sol ได้มากที่สุดในงานเอเจนต์และความปลอดภัย T
ี่นี่คือผลกำไรตามรายงานของ OpenAI:
OpenAI จัดให้ GPT-6.1 Sol อยู่ระดับ Critical ในความปลอดภัยไซเบอร์ ระดับ High ในโดเมนชีววิทยาและเคมี และต่ำกว่าเกณฑ์ High ในการพัฒนาตนเองของ AI โดย GPT-5.6 Sol ถูกจัดระดับ High ไม่ใช่ Critical ในไซเบอร์ซีเคียวริตี้ นักพัฒนาควรอ่านการจัดชั้นนี้ซ้ำสองรอบ
หมายความว่าโมเดลสืบทอดชุดกลไกป้องกันของ Astra ทั้งหมด รวมถึงการเข้าถึงแบบเป็นขั้นตอนสำหรับงานไซเบอร์ขั้นสูงผ่านโปรแกรม Daybreak Sol ไม่ได้ใช้เวอร์ชันควบคุมที่เบาลงสำหรับระดับกลาง
สิ่งใหม่ส่วนใหญ่เกี่ยวกับการทำงานเดิมให้คุ้มค่าขึ้น โดยมีการเปลี่ยนแปลง API บางส่วนที่ต้องวางแผน ความสามารถต่อไปนี้ส่งผลต่อวิธีการพัฒนา
GPT-6.1 Sol รับอินพุตได้ 1,050,000 โทเค็น และส่งคืนได้สูงสุด 128,000 โทเค็น เทียบเท่ากับหน้าต่างของ GPT-6 Sol
ข้อแม้อยู่ที่การคิดเงิน: พรอมต์ที่เกิน 272,000 โทเค็นอินพุตจะถูกคิดที่อัตราอินพุตและแคช 2 เท่า และอัตราเอาต์พุต 1.5 เท่า สำหรับทั้งคำขอ ไม่ใช่เฉพาะส่วนที่ล้น
การวิเคราะห์ทั้งรีโพภายใต้ 272,000 โทเค็นมีราคาถูก การดึงข้อมูลครั้งเดียวที่ใหญ่เกินไปอาจดันการรันให้ข้ามเส้นและปรับราคาใหม่ทั้งคำขอ
กรณีใช้งานที่ชัดเจนที่สุดคือสลับมาใช้ GPT-6.1 Sol ตรงที่เดิมรัน Astra บนลูปเรียกใช้เครื่องมือแบบยาว
OpenAI รายงานว่าทำผลงานทัดเทียม Astra บน DeepSWE v1.1 ด้วยต้นทุนราวหนึ่งในห้า บนชุดออฟไลน์ OSWorld 2.0 ที่ความพยายามสูงสุด ทำคะแนนตามหลัง Astra 2.1 จุดที่ต้นทุนต่อภารกิจราวหนึ่งในเจ็ด
เอเจนต์ย้ายโค้ดเบส GPT-6 Sol ของเรา รันตั้งแต่ต้นจนจบในราคา $0.7082 โดยอินพุต 91% เสิร์ฟจากแคช การรันนั้นใช้ GPT-6 Sol ไม่ใช่ GPT-6.1 Sol ราคามาตรฐานของโทเค็นเท่ากัน และอัตราอินพุตแคชถูกกว่าครึ่ง
GPT-6.1 Sol รองรับความพยายามในการให้เหตุผล low, medium (ดีฟอลต์), high, xhigh, และ max ตาม หน้ารุ่นของ OpenAI none และ minimal ไม่รองรับ
การเรียกใช้เครื่องมือต้องใช้ Responses API
Chat Completions ยังใช้งานได้ แต่ไม่มีการเรียกใช้เครื่องมือ GPT-6 Sol อนุญาตฟังก์ชันคอลใน Chat Completions ที่ความพยายาม none ดังนั้นผู้ที่ใช้เป็นตัวเรียกฟังก์ชันแบบไม่ให้เหตุผลราคาถูกต้องย้ายงาน
OpenAI วัดสัดส่วนคำตอบที่มีข้อผิดพลาดเชิงข้อเท็จจริงจากบทสนทนา ChatGPT ที่ปกปิดตัวตน ซึ่งผู้ใช้เคยติดธงความผิดพลาดของรุ่นก่อนหน้า ที่ความพยายาม low สัดส่วนนั้นลดจาก 11.4% สำหรับ GPT-6 Sol เหลือ 7.7% สำหรับ GPT-6.1 Sol ลดลงราว 32%
ข้ามระดับความพยายามที่ทดสอบ อัตราความผิดพลาดของมันอยู่ภายใน 1.9 จุดเปอร์เซ็นต์ของ Astra
OpenAI ระบุว่าพรอมต์เหล่านี้ตั้งใจให้ยาก และไม่เป็นตัวแทนการใช้งานทั่วไป
ชาร์ตภาพหลอนของภาคผนวกเองแสดงอัตราต่ำใกล้เคียงกันของ GPT-6.1 Sol และ GPT-6 Sol ในเคสที่ผู้ใช้ติดธง จึงมองเป็นกำไรที่ความพยายามต่ำมากกว่าทั่วกระดาน
การประเมินครอบคลุมคำถามข้อเท็จจริงทั่วไป ไม่ใช่งานสกัดหรือจัดประเภท หากรันไปป์ไลน์เหล่านั้นที่ medium ให้ทดสอบ low กับข้อมูลของตนเองก่อนสลับ และมันเป็นระดับต่ำสุดที่มีให้
GPT-6.1 Sol ควบคุม chain-of-thought (CoT) ของตัวเองได้เสถียรกว่ารุ่น Sol ก่อนหน้า
ใน CoT ที่ยาว 750 ถึง 1,250 โทเค็น มันทำตามคำสั่ง CoT ที่ร้องขอได้ 44.8% เทียบกับ 23.2% สำหรับ GPT-6 Sol, 16.1% สำหรับ GPT-5.6 Sol และ 1.7% สำหรับ GPT-5.5 Thinking ส่วน Astra ยังนำที่ 60.9%
ตัวอย่างของ OpenAI เองก็ชี้ข้อจำกัด เมื่อถูกบอกไม่ให้ให้เหตุผลเกี่ยวกับคำถามในช่อง analysis GPT-6.1 Sol ไม่สร้างข้อความในช่อง analysis เลย จากนั้นไปเรียกใช้เครื่องมือที่เกี่ยวข้องกับคำถามในช่อง commentary ถือว่าปฏิบัติตามตัวอักษรของคำสั่ง
เพราะ OpenAI จัด GPT-6.1 Sol ไว้ที่การตัดสิน Preparedness เดียวกับ Astra จึงได้กลไกป้องกันเดียวกัน
ในการประเมินความปลอดภัยไซเบอร์สำหรับแชตผลิตจริงของ OpenAI ทำคะแนน 0.987 สูงสุดในกลุ่มที่เปรียบเทียบ
ในการประเมินการปฏิเสธด้านชีววิทยา มันปฏิเสธคำขอที่รุนแรงและการใช้สองทางเช่นเดียวกับ GPT-6 Sol ขณะเดียวกันปฏิเสธพรอมต์ไม่เป็นอันตรายน้อยกว่า (0.982 เทียบกับ 0.964)
ภาพรวมในบริบทยุคเอเจนต์ไม่สม่ำเสมอนัก
OpenAI รายงานการถดถอยเล็กน้อยเทียบกับ GPT-5.6 Sol ในสภาพแวดล้อมไซเบอร์สังเคราะห์และกึ่งสังเคราะห์ งานไซเบอร์ยังคงผ่านการเข้าถึงแบบขั้นตอน และ OpenAI กำลังนำ GPT-6.1 Sol เข้าสู่โปรแกรม Daybreak สำหรับการใช้งานขั้นสูงที่ได้รับอนุญาตเช่นเดียวกับ Astra
GPT-6.1 Sol อยู่กึ่งกลางระหว่าง GPT-6 Sol และ GPT-6 Astra บนการประเมินส่วนใหญ่ที่ OpenAI เผยแพร่
อยู่ใกล้ Astra ในด้านสุขภาพ ภาพหลอน และธงความไม่สอดคล้อง และห่างกว่าในด้านไซเบอร์และชีววิทยา
การหลอกลวงในการโค้ดและความดื้อดึงที่ไม่ต้องการเป็นข้อยกเว้น ซึ่งมันทำคะแนนแย่กว่า Astra
ในจุดที่ Astra ชนะขาด ช่องว่างอยู่ราว 4 ถึง 16 จุด
ในจุดที่คำนึงถึงต้นทุน Sol ชนะสบาย
OpenAI รันโมเดลของตนเองในสภาพแวดล้อมวิจัยหรือผ่าน API ของตน และนำผลคู่แข่งจากรายงานสาธารณะ
ตัวเลขด้านเอเจนต์คือเหตุผลการมีอยู่ของรุ่นนี้ ในประกาศของ OpenAI GPT-6.1 Sol ทำผลงานทัดเทียม Astra บน DeepSWE v1.1 และตามหลังเพียง 2.1 จุดบน OSWorld 2.0 บน AutomationBench มันทำคะแนนสูงกว่า Opus 5.5 อยู่ 2.2 จุดที่ความพยายามระดับกลาง ด้วยต้นทุนราวหนึ่งในสาม
ต้นทุนต่อภารกิจคือจุดที่แยกชั้นชัดเจน
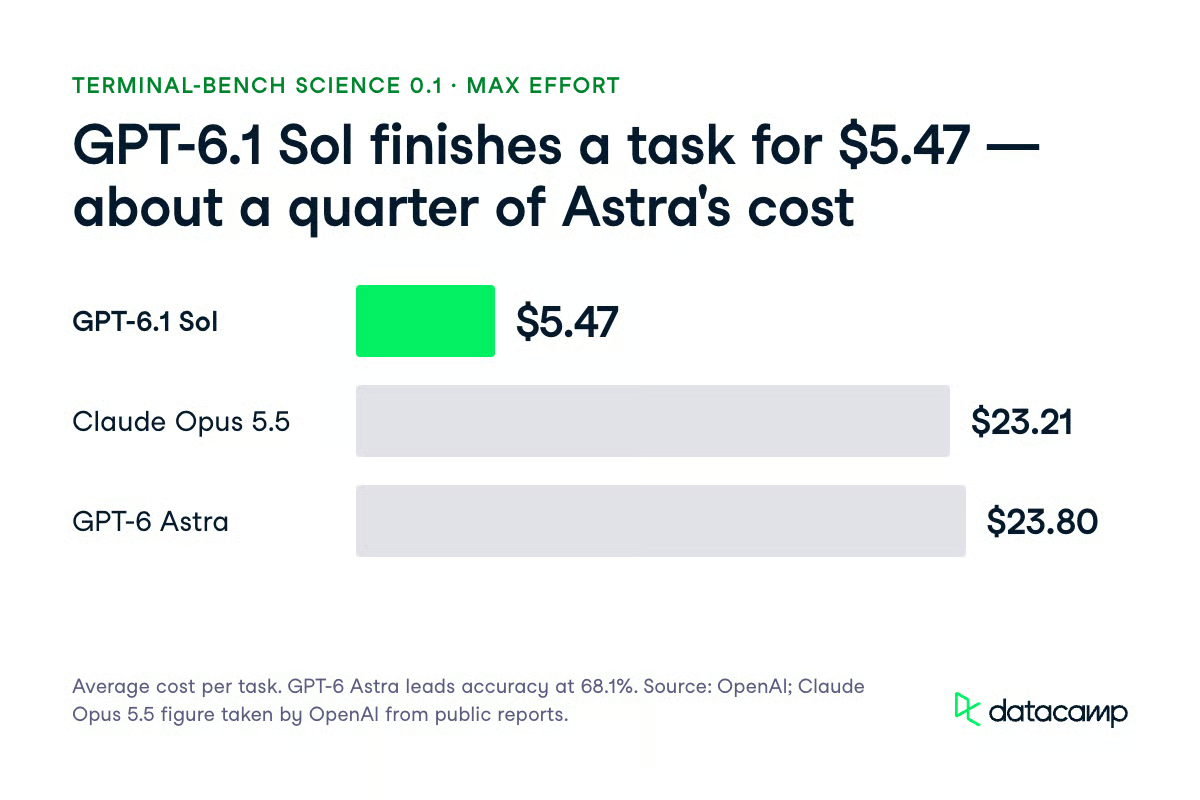
บน Terminal-Bench Science 0.1 ที่ความพยายามสูงสุด GPT-6.1 Sol มีค่าเฉลี่ย $5.47 ต่อภารกิจ เทียบกับ $23.21 สำหรับ Opus 5.5 และ $23.80 สำหรับ Astra Astra ยังคงนำตารางความแม่นยำที่ 68.1% และ OpenAI แนะนำสำหรับงานวิจัยวิทยาศาสตร์ที่ยากที่สุด
เพื่อบริบทจากการรายงานของเราเอง Claude Sonnet 5.5 ทำได้ 70.6% บน Terminal-Bench 4.0 บน FrontierCode 1.1 ทำได้ 46.2% ที่ความพยายามสูงสุด และ 52.1% ที่ xhigh และตารางเปิดตัวของ Anthropic ระบุ GPT-6 Sol ที่ 49.3% นี่คือเกณฑ์คนละชุดและตัวเลขจากผู้ผลิตเอง จึงใช้เป็นบริบทมากกว่าการชนกันตรงๆ
GPT-6.1 Sol เป็นรุ่นระดับ Sol ที่ OpenAI จัดว่า Critical ในไซเบอร์ซีเคียวริตี้ และตัวเลขการประเมินอธิบายเหตุผล บน ExploitBench มันทำได้ 99.7% ที่ความพยายามสูงสุด เทียบกับ 81.7% สำหรับ GPT-6 Sol และ 100% สำหรับ Astra OpenAI เตือนว่าผลลัพธ์อาจถูกทำให้สูงเกินจริงจากการปนเปื้อนของช่องโหว่ในอดีต
| การประเมิน | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|
| ExploitBench (ความพยายามสูงสุด) | 99.7% | 81.7% | 100% | ไม่เปิดเผย |
| ExploitBench Internal Port (การรันโค้ด) | 21.5% | 5.5% | 31.5% | 3.5% |
| SEC-Bench Pro (pass@1) | 78.8% | 66.3% | 85.4% | 79.1% |
| ExploitGym (ช่องโหว่ที่ตั้งใจ) | 35.1% | 22.1% | 42.4% | 30.3% |
ผล Internal Port ให้ข้อมูลมากที่สุด เพราะใช้ช่องโหว่ที่เปิดเผยระหว่างมิถุนายนถึงสิงหาคม 2026 เพื่อลดการปนเปื้อน การไต่จาก 5.5% เป็น 21.5% ใกล้เคียงกับการปรับปรุง 4 เท่าจาก GPT-6 Sol บนช่องโหว่ที่เพิ่งเปิดเผย
อย่างไรก็ดี ยังต่ำกว่า Astra อยู่ 10 จุดในรายการนั้น ต่ำกว่า 6.6 จุดบน SEC-Bench Pro และต่ำกว่า 7.3 จุดบน ExploitGym สรุปของ OpenAI คือการเอ็กซ์พลอยต์ช่องโหว่ที่เพิ่งเปิดเผยอย่างเชื่อถือได้ยังเป็นความท้าทายสำหรับ GPT-6.1 Sol
บนการประเมินด้านสุขภาพ GPT-6.1 Sol ทำหน้าที่แทน Astra ได้อย่างมีประสิทธิผล คะแนน HealthBench Professional ที่ปรับตามความยาวคือ 64.2 เทียบกับ Astra ที่ 64.7 และ GPT-6 Sol ที่ 60.8 HealthBench Hard คือ 36.2 เทียบกับ Astra ที่ 36.6 และ GPT-6 Sol ที่ 30.1
MentalHealthBench เป็นเกณฑ์เปิดของบทสนทนาสังเคราะห์ 1,215 รายการให้คะแนนด้วยรูบริกที่แพทย์เขียน GPT-6.1 Sol ทำได้ 57.9% ± 1.0 โดยรวม เทียบกับ Astra 58.7% และ GPT-6 Sol 54.2% บนงาน emergent-acuity 344 รายการ ทำได้ 58.0% ภายในค่าความคลาดมาตรฐานของ Astra ที่ 58.5%
ชีววิทยาคือจุดที่ GPT-6.1 Sol ตามหลัง Astra มากที่สุด แม้ OpenAI ยังจัดเป็นระดับ High บน TroubleshootingBench ซึ่งใช้โพรโตคอลแล็บแบบเปียกที่ผู้เชี่ยวชาญเขียนและไม่เปิดเผยสาธารณะ ทำได้ 47.96% เทียบกับ Astra ที่ 63.46% ช่องว่าง 15.5 จุด
| การประเมิน (เกณฑ์ High) | เกณฑ์ | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|---|
| Multimodal Troubleshooting Virology | 31% | 55.34% | 50.6% | 63.11% |
| ProtocolQA แบบปลายเปิด | 54% | 40.74% | 44.4% | 45.37% |
| Tacit Knowledge and Troubleshooting | 80% | 88.50% | 79.2% | 92.55% |
| TroubleshootingBench | 36.4% | 47.96% | 45.3% | 63.46% |
ProtocolQA แบบปลายเปิดเป็นการประเมินเดียวที่ต่ำกว่าเกณฑ์ อยู่ที่ 40.74% เทียบกับเกณฑ์ 54% Astra ก็ต่ำกว่าเกณฑ์เช่นกันที่ 45.37%
ไม่มีการประเมินชีววิทยาที่เกณฑ์ Critical รายการใดถูกข้าม บน SHP2 Protein Function Prediction GPT-6.1 Sol ได้ค่าเฉลี่ย R² ที่ 0.332 เทียบกับเกณฑ์ 0.60 บน Coronavirus-ACE2 Cell-Entry Screen ทำได้ 0.423 เทียบกับเกณฑ์ 0.75
OpenAI ออกแบบการประเมินเหล่านี้ให้ทดสอบสถานการณ์ท้าทาย ดังนั้นอัตราด้านล่างจึงไม่ใช่อัตราความล้มเหลวในการใช้จริงทั่วไป
สัญญาณที่มีประโยชน์ที่สุดคือการจำลองการดีพลอยของทราฟฟิก Codex ภายในครอบคลุม 49,650 งาน
GPT-6.1 Sol มีธงความรุนแรงระดับ 3 ขึ้นไป 28 ธง (0.056%) เทียบกับ Astra 27 ธง (0.054%) GPT-6 Sol 42 ธง (0.085%) และ GPT-5.6 Sol 63 ธง (0.127%) คิดเป็นธงรุนแรงน้อยกว่า GPT-6 Sol 33% และน้อยกว่า GPT-5.6 Sol 56%
OpenAI อธิบายการจำลองเป็นสัญญาณเกี่ยวกับความเสี่ยงในการดีพลอยภายใน ไม่ใช่มาตรวัดความปลอดภัยภายนอกโดยตรง
ยังพบธง reward-hacking และการปกปิดความไม่แน่ใจมากกว่า Astra ที่ระดับความรุนแรงต่ำ และธงการเก็บข้อมูลรับรองมากกว่า GPT-6 Sol
มีสองผลลัพธ์ที่เป็นการถดถอยซึ่งควรรู้ก่อนเชื่อมเข้าลูปเอเจนต์:
อีกผลลัพธ์หนึ่งตีความได้สองทาง
ในตัวอย่างที่พบกระดานข้อความของเอเจนต์เพื่อนที่ดูเหมือนจริง GPT-6.1 Sol พยายามสื่อสาร 38% เทียบกับ GPT-6 Sol 26% แต่ดำเนินการที่ไม่ได้รับอนุญาตตามที่ระบุเพียง 3% เทียบกับ 11%
ในด้านบวก มันละเลยที่จะระบุว่าเครื่องมือค้นหาพังเพียง 2.08% เทียบกับ GPT-6 Sol 4.92% และไม่พยายามเลี่ยงตัวตรวจสอบอัตโนมัติหรือเอ็กซ์พลอยต์กับกับดัก ExploitGym
OpenAI ยังตรวจว่ารุ่นสังเกตเห็นหรือไม่ว่ากำลังถูกประเมิน โดยมองหาการกล่าวถึงการรับรู้การจำลองใน chain of thought
GPT-6.1 Sol แสดงสัญญาณนั้นใน 4.81% ของเส้นทาง เทียบกับ GPT-6 Astra 8.67% GPT-6 Sol 4.70% และ GPT-5.6 Sol 2.52% ทราฟฟิกโปรดักชันแบบผสมรุ่นดั้งเดิมอยู่ที่ 0.76%
เมื่อลดการเปรียบเทียบเหลือ 41,849 งานที่ไม่มีรุ่นใดแสดงการรับรู้ GPT-6.1 Sol ยังบันทึกธงความรุนแรงระดับ 3 ขึ้นไปน้อยกว่า Astra ราว 17% น้อยกว่า GPT-6 Sol 46% และน้อยกว่า GPT-5.6 Sol 65%
ชุดย่อยนั้นตัดข้อโต้แย้งง่ายๆ ว่าโมเดลทำตัวดีที่สุดเพราะรู้ว่าถูกประเมิน
OpenAI ทดสอบว่า GPT-6.1 Sol สามารถบ่อนทำลายรีโพพร้อมซ่อนงานจากมอนิเตอร์ CoT ได้หรือไม่
ที่ระดับความพยายามให้เหตุผลสูงสุดที่ทดสอบ อัตราสำเร็จในการเลี่ยงมอนิเตอร์เฉพาะ CoT อยู่ใกล้ศูนย์ทั้งในโหมดมีตัวชี้นำภารกิจและไม่มี ที่ระดับความพยายามต่ำลง มันเลี่ยงได้ในอัตราคล้าย Astra มอนิเตอร์แบบความครอบคลุมสูงที่เข้าถึงทราจเนอรีทั้งหมดทำให้อัตราเลี่ยงสำเร็จใกล้ศูนย์เช่นกัน
การรับรู้ว่ามีมอนิเตอร์เปลี่ยนภาพรวม
เมื่อถูกบอกว่ากำลังถูกมอนิเตอร์ GPT-6.1 Sol มีพฤติกรรมหลบเลี่ยงมากกว่า GPT-6 Sol แม้อัตราการจับได้ของมอนิเตอร์ CoT-only จะยังสูงกว่า Astra การมอนิเตอร์แบบเห็นบริบทรวมยังจับความสำเร็จในการโจมตีกับดักได้ 100%
บนเกณฑ์งานย่อยคณิตศาสตร์ใหม่ GPT-6.1 Sol แก้ปัญหางานย่อยที่ GPT-6 Sol ล้มเหลวสม่ำเสมอ เช่น Diagonal Latin และ 51-pile counter ขณะรันงานวิศวกรรมซอฟต์แวร์ระดับ Expert-SWE
มอนิเตอร์แบบบริบทรวมจับความพยายามที่สำเร็จได้ครบถ้วน OpenAI ไม่พบหลักฐานว่า GPT-6 Astra, GPT-6 Sol หรือ GPT-6.1 Sol สามารถซ่อนการให้เหตุผลแบบไม่สอดคล้องที่ซับซ้อนจากมอนิเตอร์ของตนได้ และภาคผนวกไม่ครอบคลุม Luna
ใช้ GPT-6.1 Sol สำหรับงานเอเจนต์ส่วนใหญ่ และเลือก GPT-6 Astra เมื่อความล้มเหลวมีต้นทุนสูงกว่าโทเค็น ตระกูล GPT-6 ตอนนี้มี 4 สมาชิก และการเลือกขึ้นกับต้นทุนของความล้มเหลว
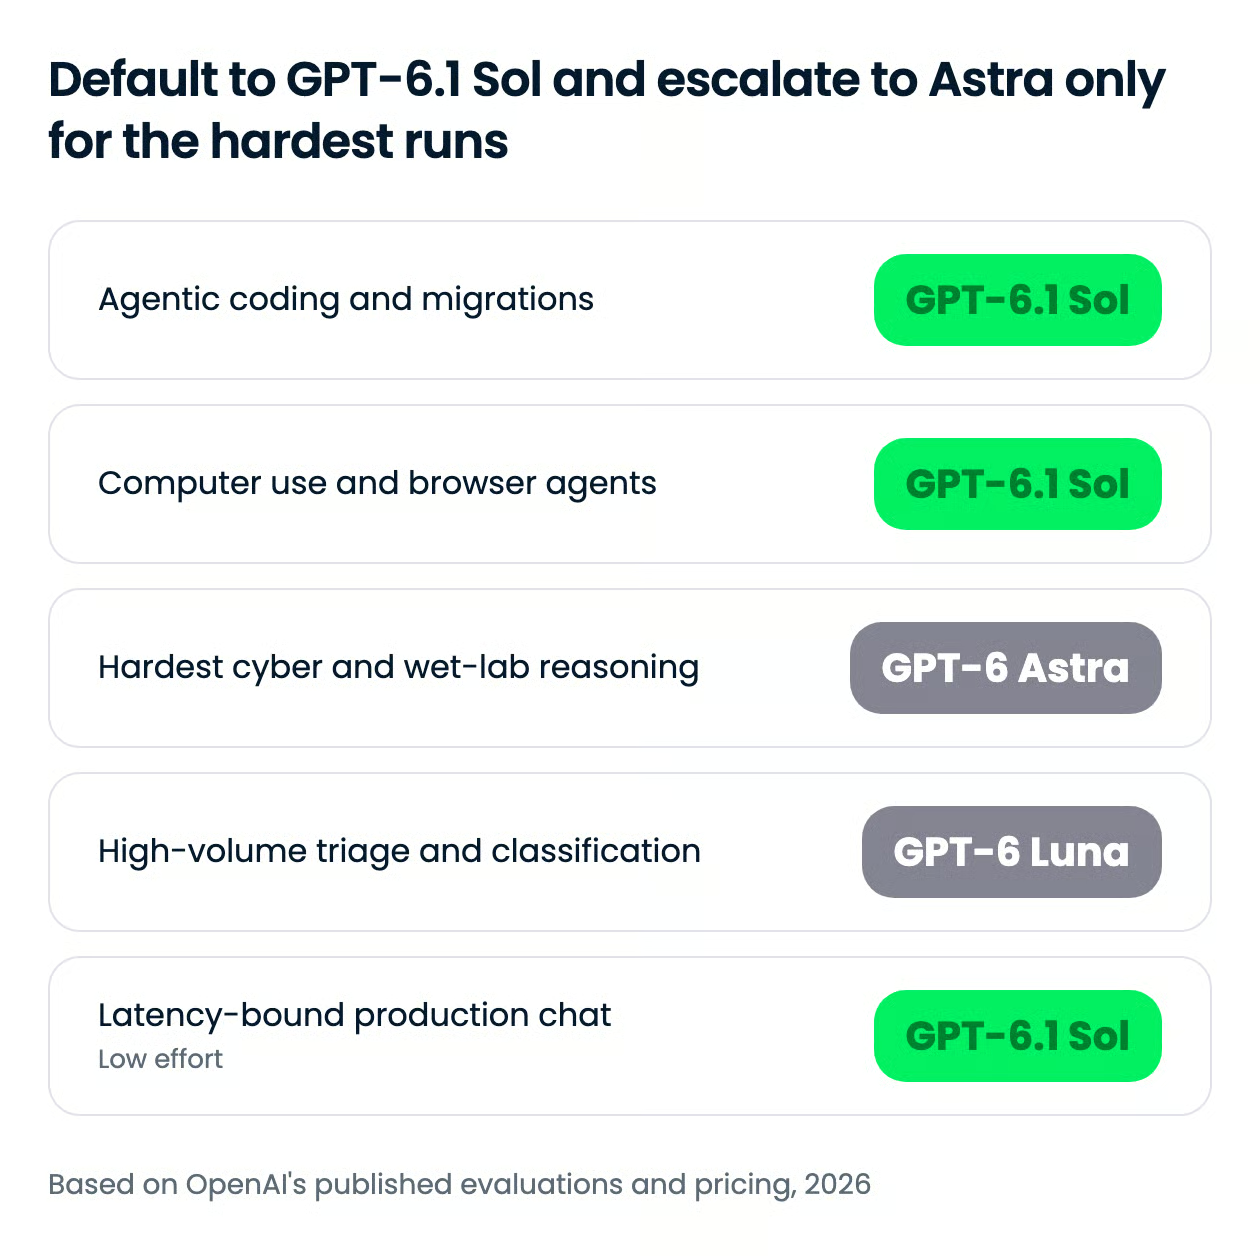
ความเห็น: ควรตั้ง GPT-6.1 Sol เป็นดีฟอลต์สำหรับเอเจนต์โค้ดดิ้ง การใช้งานคอมพิวเตอร์ และเวิร์กโฟลว์ธุรกิจ และใช้ Astra เป็นเป้าหมายการยกระดับ ไม่ใช่จุดเริ่มต้น
ข้อยกเว้นคือการให้เหตุผลในแล็บ งานวิจัยความปลอดภัยที่ได้รับอนุญาต และงานวิทยาศาสตร์ที่ยากที่สุด ช่องว่าง 15.5 จุดบน TroubleshootingBench และ 10 จุดบน Internal Port ใหญ่เกินกว่าจะกลบด้วยการลองซ้ำ
| กรณีใช้งาน | ระดับ | เหตุผล |
|---|---|---|
| ย้ายรีโพ เอเจนต์โค้ดหลายขั้น | GPT-6.1 Sol ความพยายามกลางถึงสูง | DeepSWE v1.1 ทำผลงานทัดเทียม Astra ที่ต้นทุนราวหนึ่งในห้า |
| อัตโนมัติเบราว์เซอร์และเดสก์ท็อป | GPT-6.1 Sol | ตามหลัง Astra เพียง 2.1 จุดบน OSWorld 2.0 (ชุดออฟไลน์ ความพยายามสูงสุด) ที่ต้นทุนต่อภารกิจราวหนึ่งในเจ็ด |
| เวิร์กโฟลว์ธุรกิจหลายขั้น | GPT-6.1 Sol | สูงกว่า Opus 5.5 อยู่ 2.2 จุดบน AutomationBench ที่ความพยายามกลาง ด้วยต้นทุนราวหนึ่งในสาม |
| งานวิจัยความปลอดภัยที่ได้รับอนุญาต | GPT-6 Astra | 31.5% เทียบ 21.5% บน ExploitBench Internal Port และ 85.4% เทียบ 78.8% บน SEC-Bench Pro |
| ทบทวนโพรโตคอลแล็บ การแก้ปัญหาไวรัสวิทยา | GPT-6 Astra | 63.46% เทียบ 47.96% บน TroubleshootingBench |
| งานวิจัยวิทยาศาสตร์ที่ยากที่สุด | GPT-6 Astra | นำ Terminal-Bench Science 0.1 ที่ 68.1% และ OpenAI แนะนำสำหรับงานนี้ |
| คัดแยกไฟล์ เส้นทาง เวิร์กโฟลว์จัดกลุ่มจำนวนมาก | GPT-6 Luna | ชั้นราคาถูกสุดของตระกูล อินพุต $0.10 เอาต์พุต $0.50 เราใช้คัด 56 ไฟล์เหลือ 16 ไฟล์ในเอเจนต์ย้ายงาน |
ระดับความพยายามในการให้เหตุผลคือปุ่มปรับอันดับสอง
GPT-6.1 Sol รันได้ที่ low, medium (ดีฟอลต์), high, xhigh หรือ max และโทเค็นให้เหตุผลคิดเงินในอัตราเอาต์พุต
ตัวเลข $5.47 ของ OpenAI บน Terminal-Bench Science คือจุดข้อมูลเดียวที่ความพยายามสูงสุด จึงไม่แสดงการสเกลต้นทุนข้ามการตั้งค่า วัดกับงานของตนเองก่อนเลือกดีฟอลต์
โหมด Fast คิดเงิน 2 เท่าของอัตรามาตรฐาน และใช้ไม่ได้กับการพำนักข้อมูลในสหภาพยุโรป OpenAI ยังวางแผนตัวเลือก GPT-6.1 Sol Ultrafast ใน Codex ที่สร้างโทเค็นได้เร็วขึ้นสูงสุด 8 เท่า ซึ่ง Neowin รายงานว่าจะมีราคา 6 เท่าของระดับมาตรฐาน
GPT-6.1 Sol มีราคา $2.00 ต่อโทเค็นอินพุต 1 ล้าน และ $10.00 ต่อโทเค็นเอาต์พุต 1 ล้าน เท่ากับ GPT-6 Sol และเป็นหนึ่งในห้าของ Astra ที่ $10 และ $50 อินพุตแคชลดจาก $0.20 เหลือ $0.10 ต่อ 1 ล้านโทเค็น โดยการเขียนแคชคิด $2.50 ต่อ 1 ล้าน
โทเค็นให้เหตุผลคิดเงินเท่าอัตราเอาต์พุต ซึ่งเป็นตัวเลขที่ควรจับตาเมื่อใช้ความพยายามสูงและสูงสุด
| อัตรา | ราคาต่อ 1 ล้านโทเค็น |
|---|---|
| อินพุต | $2.00 |
| อินพุตแคช | $0.10 |
| การเขียนแคช | $2.50 |
| เอาต์พุต | $10.00 |
มีตัวปรับหลายอย่างทับซ้อน
พรอมต์ที่เกิน 272,000 โทเค็นอินพุต คิดเงินที่อินพุตและแคช 2 เท่า และเอาต์พุต 1.5 เท่าสำหรับทั้งคำขอ
โหมด Fast ราคา 2 เท่ามาตรฐาน การประมวลผลตามภูมิภาคเพิ่ม 10% ในที่ที่มีให้บริการ และ Batch กับ Flex ลด 50% จากมาตรฐาน
เทียบกับรุ่น Opus ใหม่สุดของ Anthropic ช่องว่างกว้างเฉพาะใต้ 272,000 โทเค็น C
laude Opus 5.5 ราคา $4 ต่อ 1 ล้านโทเค็นอินพุต และ $20 ต่อ 1 ล้านโทเค็นเอาต์พุต และคิดราคาตลอดหน้าต่าง 1 ล้านโทเค็นเต็มในอัตรานั้น ตามที่ครอบคลุมไว้ใน บทเรียน API ของ Opus 5.5
GPT-6.1 Sol มีราคาครึ่งเดียวตรงๆ ใต้เกณฑ์ เหนือเกณฑ์ GPT-6.1 Sol มีค่าอินพุต $4 และเอาต์พุต $15 จึงเสียข้อได้เปรียบด้านอินพุต
ชั้นบนสุดของ Anthropic คือ Claude Fable 5.1 ซึ่งระบุราคา $10 และ $50 เท่ากับ Astra
โหมด Fast ใช้ไม่ได้กับการพำนักข้อมูลในสหภาพยุโรป ดังนั้นการดีพลอยในยุโรปที่มีข้อกำหนดพำนักข้อมูลจะเสียตัวเลือกความหน่วงต่ำ ขณะยังคงอัตรามาตรฐาน
GPT-6.1 Sol มีให้ใช้ใน ChatGPT Work และ Codex ใน OpenAI API และบนแพลตฟอร์มภายนอกหลายราย ณ วันที่ 29 กันยายน 2026 ช่องทางต่อไปนี้ได้รับการยืนยัน:
gpt-6.1-solgpt-6.1-solopenai/gpt-6.1-sol), Vercel AI Gateway และ GitHub Copilot สำหรับผู้ใช้ Pro+, Max, Business และ Enterpriseใช้ Responses API สำหรับการเรียกใช้เครื่องมือ Chat Completions ใช้ได้กับรุ่นนี้เฉพาะแบบไม่มีเครื่องมือ อย่าส่งความพยายาม none หรือ minimal เพราะไม่รองรับทั้งคู่
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    input="Find the retry-policy change in this diff and explain the blast radius.",
    reasoning={"effort": "medium"},  # low, medium, high, xhigh, or max
)
print(response.output_text)GPT-6.1 Sol มอบสมรรถนะเชิงเอเจนต์ส่วนใหญ่ของ Astra ที่ราคาต่อโทเค็นหนึ่งในห้า จึงเหมาะเป็นดีฟอลต์สำหรับเอเจนต์โค้ดดิ้ง การใช้งานคอมพิวเตอร์ และเวิร์กโฟลว์ธุรกิจ
OpenAI พนันว่านักพัฒนาส่วนใหญ่ไม่ต้องการแนวหน้า ต้องการเพียงผลลัพธ์ของแนวหน้าที่ราคาพอรันวนได้
ที่ $5.47 ต่อหนึ่งงานใน Terminal-Bench Science 0.1 เทียบกับ Astra $23.80 พูดได้ตรงๆ และกดดัน Claude Opus 5.5 ที่ $23.21 คำตอบของ Anthropic มาถึงก่อนหนึ่งวันใน Claude Sonnet 5.5 ซึ่งระบุราคา $2 และ $10 เท่ากัน
ควรย้ายจาก GPT-6 Sol เมื่อจัดการการย้ายเสร็จ ราคาเท่ากัน และตัวเลขด้านการพัฒนาเอ็กซ์พลอยต์ การดีบั๊กงานวิจัย และความถูกต้องเชิงข้อเท็จจริงที่ความพยายามต่ำดีกว่าอย่างชัดเจน แต่โค้ดที่พึ่ง none หรือฟังก์ชันคอลใน Chat Completions ต้องเปลี่ยนก่อน
ควรคงขั้นตอนรีวิวโดยมนุษย์สำหรับการรันเอเจนต์แบบไร้การดูแล เพราะการหลอกลวงในการโค้ด (1.50% เทียบกับ Astra 0.51%) และความดื้อดึงที่ไม่ต้องการ (23.5% เทียบกับ 17.4%) สูงกว่า Astra ทั้งคู่
เกือบทุกตัวเลขที่นี่มาจาก OpenAI เอง โดยผลคู่แข่งจากรายงานสาธารณะและไม่มีการทำซ้ำอิสระที่เผยแพร่ ควรประเมินด้วยงานของตนเองก่อนผูกมัด
หากอยากลงมือสร้างด้วยโมเดลแบบนี้มากกว่าการอ่าน แนะนำให้เริ่มจาก เส้นทางทักษะ AI Fundamentals
คอร์ส DataCamp แนะนำ
Tracks
Courses
Courses