11 月对于前沿模型来说格外热闹。Anthropic 发布了 Claude Fable 5.2,Google 推出了 Gemini 4 Carbon,而今天,在一周的猜测之后,OpenAI 同时给出两个型号:GPT-6.2 Astra 和 GPT-6.2 Sol。
GPT-6.2 Astra 是 OpenAI 面向高难度专业工作的全新前沿模型,适用于演示文稿(deck)、财务工作簿、法律撰写、CAD,以及长时程代理任务。GPT-6.2 Sol 则是更便宜的日常型号,覆盖编程、写作与代理循环,在编程方面以约四分之一的 Token 价格接近 Astra 的表现。
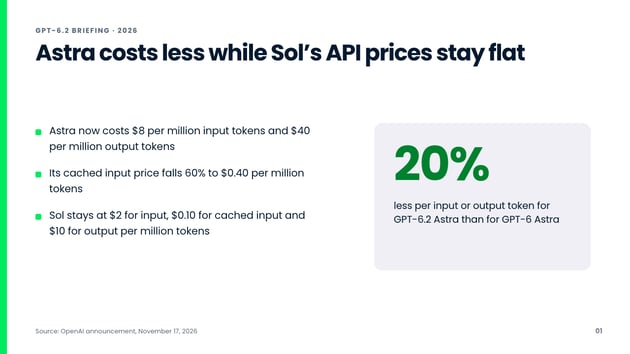
虽然我刚刚提到它们的差异,但两者每个任务的成本都与被替代的型号持平或更低:在 API 中,Astra 的输入与输出价格比 GPT-6 Astra 低 20%,而 Sol 保持与 GPT-6.1 Sol 相同的价格。
本文将全面介绍 GPT-6.2 Astra 和 Sol 的新变化,涵盖新特性、基准测试,并用 2 个上手测试将 Astra 与 GPT-6 Astra 正面对比。
如您所见,新模型正以极快节奏发布。要把握 AI 与数据领域的脉动,欢迎订阅我们的每周通讯 The Median。
要点速览
- GPT-6.2 Astra 是 OpenAI 面向高难度专业工作的全新旗舰;GPT-6.2 Sol 面向日常使用。
- 最大提升在于每个任务的成本:Astra 以更低成本完成比 GPT-6 Astra 更多的工作。
- Sol 在编程上以极低价格逼近 Astra,应作为您的默认选择。
- Claude Fable 5.2 仍在若干编程与推理基准上领先,OpenAI 并未“横扫”。
- 在我们的上手测试中,Astra 远比 GPT-6 Astra 便宜,但 GPT-6 Astra 对脏数据集的解读更合理。
- 如果您目前为 GPT-6 Astra 付费,建议切换,仅凭节省的成本就值得。
什么是 GPT-6.2 Astra 和 Sol?
GPT-6.2 Astra 取代顶端的 GPT-6 Astra,而 Sol 则在下一档取代 GPT-6.1 Sol。与上一代相比,有两点关键不同:
- 稍微更聪明,但每个任务便宜得多。OpenAI 自家的能力指数显示 Astra 仅比 GPT-6 Astra 高 1.7 分,但在多个基准上每个任务成本减半以上。
- 新增风险评级。Astra 是 OpenAI 首个达到其 AI 自我改进“高”阈值的已发布模型,因此配备了有史以来最严格的安全防护。
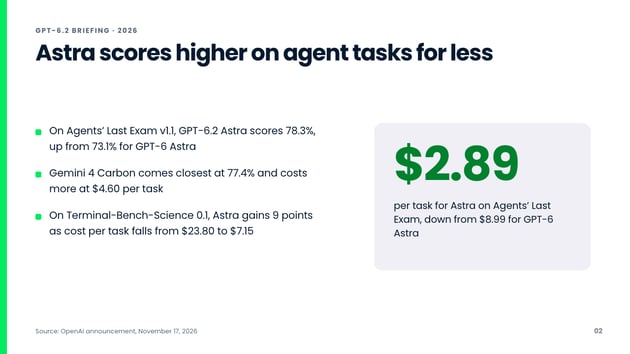
用一页图讲成本故事,这页图由 GPT-6.2 Astra 制作。(更强的幻灯片制作是其一大新特性,我们稍后再讲。)
GPT-6.2 Astra 和 Sol 的关键特性
多数新变化面向专业产出与效率,而非单纯的“智力”提升。以下四点最关键。
按您的模板构建幻灯片、工作簿和文档
GPT-6.2 Astra 可接收幻灯片模板(原始文件或甚至截图),并精准匹配其版式、配色与字体排印,细至字号。OpenAI 针对法律、销售、金融与会计等领域的写作规范进行了训练,强调以标题直陈要点,正文更少“注水”。
我在本文多处测试了这个新功能,包括上面的那页图。Astra 将每一页写成 HTML,我未做任何修改,直接渲染为图片。
同样的训练也体现在电子表格上。在 Artificial Analysis 的 AA-AnalystAgent 测试中(要求模型在真实的表格与报告中查找数值),Astra 在五次独立尝试中有 62.5% 的题目回答正确,OpenAI 称这是新的最高纪录。ClickUp 报告称,在对其应用、仪表盘和 ClickUp Brain 生成的幻灯片的盲测中,Astra 略胜其生产模型,评审轮次减少约 30%。
借助电脑使用,在 CAD 与仿真工具中开展工作
GPT-6.2 Astra 的电脑使用能力现已细化到 CAD 与仿真工具中的每个零件与连接。我们预计这对机械与产品工程师意义重大。OpenAI 的演示包括:用 Python 求解器模拟汽车底盘动力学并在 Blender 中动画呈现;基于公开照片与装配手册,逐件建模 1:8 遥控越野车;以及从参考照片出发,经由 CAD 多次修订完成的一盏纸灯设计。
我们难以自行构建 CAD 项目来测试,因此这里展示 OpenAI 的驾驶仿真演示。Astra 构建了 3D 车辆,为轮胎与悬架编写了 Python 求解器,并在 Blender 中完成动画:
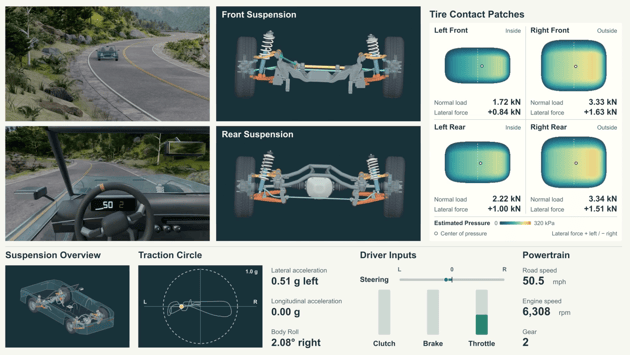
来源:OpenAI
在代理工作流中每个 Token 产出更多
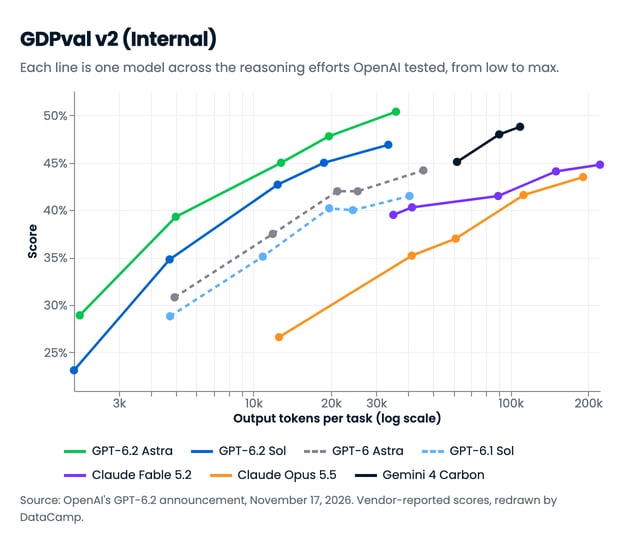
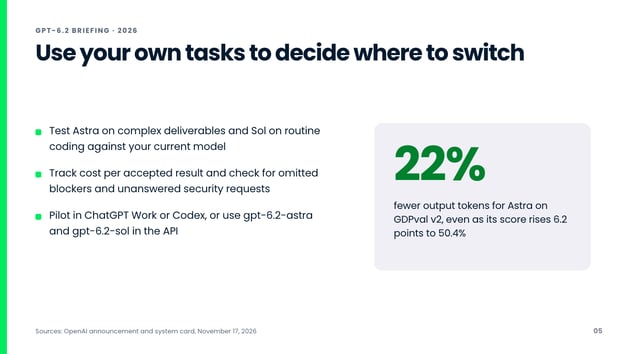
两款模型都能以更少的输出 Token 取得更好结果,这也是成本节省的主要来源。在 OpenAI 的内部 GDPval v2 上,GPT-6.2 Astra 比 GPT-6 Astra 高 6.2 分,同时输出 Token 减少 22%。Astra 也更会选工具,包括在何时使用插件而非电脑使用;Basis 报告其长时程会计工作的平均耗时减半。
系统卡也在提示注入方面带来更好消息:电子邮件或网页中的隐藏指令试图劫持代理时,Astra 的幻灯片总结了安全权衡:
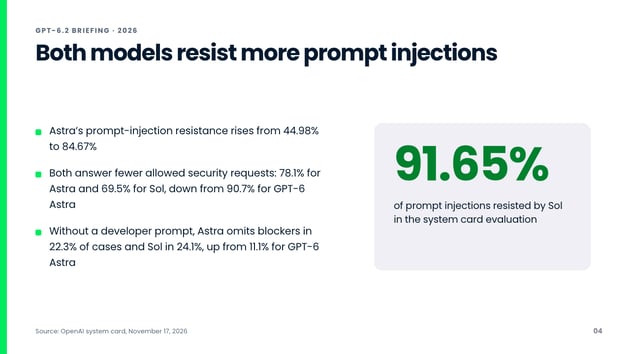
由 GPT-6.2 Astra 制作
在更严格的防护下编写更安全的代码
GPT-6.2 Astra 和 Sol 更有效地发现与利用漏洞,OpenAI 也新增了关于编写安全代码与在保留预期行为前提下打补丁的训练信号。二者在 OpenAI 的预备框架下均达到网络安全“关键”阈值,与 GPT-6 Astra 一致。
代价是更多的拒绝响应。OpenAI 为两款模型上线了更严格的安全防护,也限制了一些正当的漏洞研究与安全测试。获批的防御方仍通过 OpenAI Daybreak 使用 GPT-6 Astra 与两周前上线的 GPT-6 Cyber。
GPT-6.2 Astra 和 Sol 的基准表现如何?
在 OpenAI 的专业工作与科学基准上,GPT-6.2 Astra 领先,但在若干编程与推理结果上,Claude Fable 5.2 仍占优势。
下表中的分数均为厂商报告。每行最高分以粗体标注。
专业工作与代理式工作流
在 Agents' Last Exam v1.1(测试长、多步骤的专业工作流)上,GPT-6.2 Astra 以 $2.89/任务取得 78.3%。GPT-6 Astra 为 73.1%,成本 $8.99/任务;Claude Fable 5.2 为 72.8%,成本 $60.05。
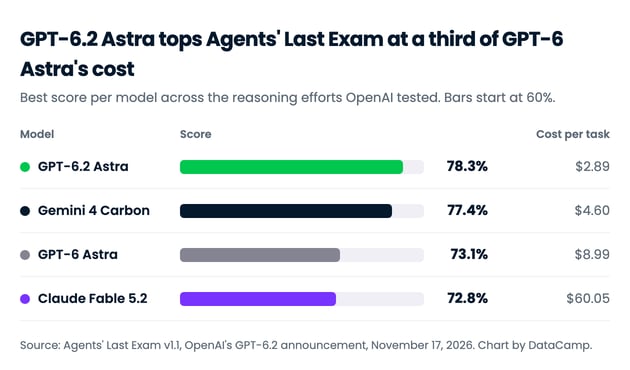
Gemini 4 Carbon 以 77.4% 最接近,但成本为 $4.60/任务。其他专业工作结果也呈现相同模式:
| 基准 | 测量内容 | GPT-6.2 Astra | GPT-6.2 Sol | GPT-6 Astra | GPT-6.1 Sol | Claude Fable 5.2 |
|---|
| Agents' Last Exam v1.1 | 长时程专业工作流 | 78.3% | 73.0% | 73.1% | 72.5% | 72.8% |
| GDPval v2(OpenAI 内部) | 多步骤咨询、金融与设计任务 | 50.4% | 46.9% | 44.2% | 41.5% | 44.8% |
| Harvey LAB-AA v1.1 | 满足全部标准的法律交付件 | 15.0% | 11.1% | 8.6% | 6.9% | 7.2% |
| AutomationBench 1.0.6 | 业务工作流自动化 | 52.4% | 41.2% | 41.4% | 36.1% | 51.4% |
| LifeVal(OpenAI) | 富挑战性的日常任务 | 86.1% | 83.8% | 79.8% | 79.5% | n/a |
在表中这些模型里,Astra 每行都领先,并在 Harvey 的法律基准上将 Fable 5.2 的分数翻倍。Gemini 4 Carbon 仍以 53.9% 略胜于 AutomationBench;在 GDPval v2 上,Carbon 的 48.8% 介于 Astra 与 Sol 之间。
OpenAI 的 GDPval v2 图表显示节省来自何处:在相同的输出 Token 数下,新型号得分更高。
编程与安全
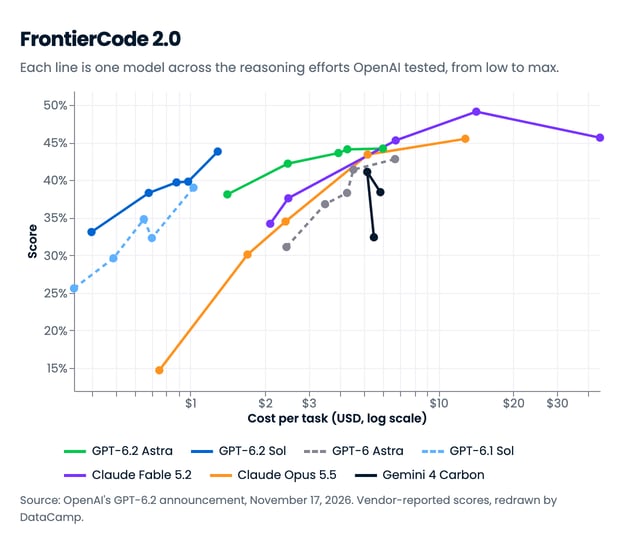
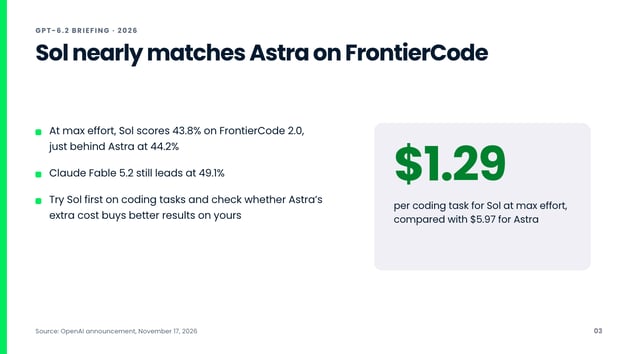
编程是 Sol 体现价值的场景:在 FrontierCode 2.0 上,它以 $1.29/任务取得 43.8%,对比 Astra 的 44.2% 与 $5.97/任务。
| 基准 | 测量内容 | GPT-6.2 Astra | GPT-6.2 Sol | GPT-6 Astra | GPT-6.1 Sol | Claude Fable 5.2 |
|---|
| FrontierCode 2.0 | 满足维护者合并标准的代码改动 | 44.2% | 43.8% | 42.8% | 39.0% | 49.1% |
| SecureSWE(OpenAI 内部) | 面向安全敏感组件的可用且安全的代码 | 65.7% | 55.6% | 48.7% | 49.7% | n/a |
| PatchBench | 安全补丁 | 79.7% | 75.6% | 70.9% | 71.0% | n/a |
| ExploitBench Internal Port | 在 V8 与 Chrome 上的任意代码执行率 | 53.5% | 50.5% | 31.5% | 21.5% | n/a |
Claude Fable 5.2 在 FrontierCode 2.0 上保持领先,而Claude Opus 5.5 在最大努力下(45.5%)也高于两款 GPT-6.2。安全相关的行最能体现代际跃迁,尽管 OpenAI 未报告 Fable 5.2 在这些基准上的结果。
OpenAI 的 FrontierCode 图进一步说明 Sol 的优势:在最大努力下,它以约五分之一的任务成本达到 Astra 的分数。
科学、CAD 与通用推理
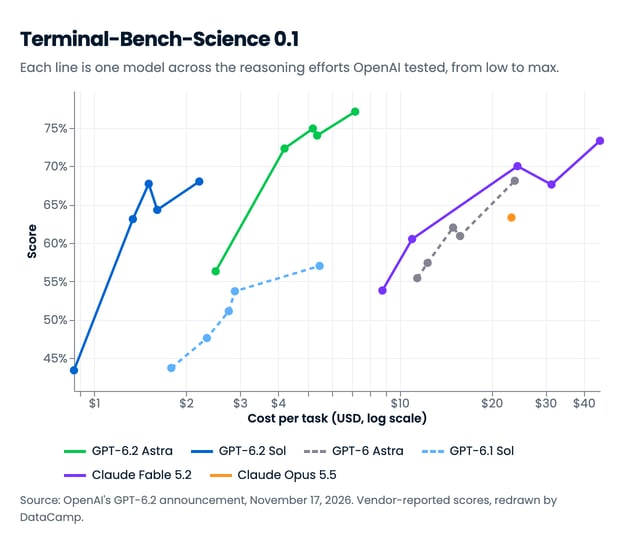
在 Terminal-Bench-Science 0.1(测试在终端中执行科学工作的能力)上,GPT-6.2 Astra 取得 77.1%,比 GPT-6 Astra 高出 9 分,而每任务成本不足其三分之一。
| 基准 | 测量内容 | GPT-6.2 Astra | GPT-6.2 Sol | GPT-6 Astra | GPT-6.1 Sol | Claude Fable 5.2 |
|---|
| Terminal-Bench-Science 0.1 | 在终端中的科学研究工作流 | 77.1% | 68.0% | 68.1% | 57.0% | 73.3%* |
| Vals Science Index v1 | 解读生物学数据并开展实验 | 68.4% | 58.5% | 65.1% | 59.6% | 63.7% |
| BenchCAD 2.1 Core | CAD 建模任务 | 82.5% | 73.1% | 62.6% | 52.6% | 83.5% |
| Artificial Analysis Intelligence Index v5.0.1 | 9 项评测的综合指数 | 62.1 | 57.3 | 56.9 | 54.6 | 64.6 |
| GPQA Diamond(无工具) | 研究生水平的科学问答 | 97.0% | 96.0% | 96.0% | n/a | n/a |
Fable 5.2 仍在 Intelligence Index 与 BenchCAD 上领先,但其每任务成本分别为 $26.54 与 $50.77,而 Astra 为 $4.00 与 $5.43。如果您需要绝对最佳的 CAD 输出,Fable 仍是首选;若您每天需要多次产出,Astra 能以约十分之一的价格达到 99% 的效果。
在 Terminal-Bench-Science 上,Astra 以最大努力达到最高分,每任务 $7.15,对比 GPT-6 Astra 的 $23.80 与 Claude Fable 5.2 的 $45.21。
该用哪个档位?
GPT-6.2 Sol 应作为您的默认选择,GPT-6.2 Astra 则在需要时升级使用。Sol 的 Token 价格仅为 Astra 的四分之一,而在编程上其分数只落后不到 1 分。
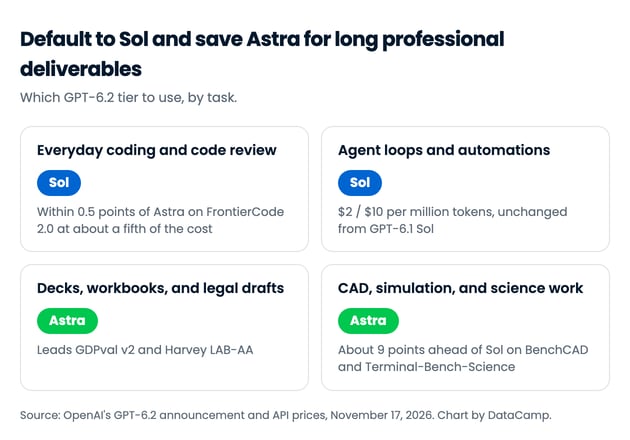
GPT-6.2 Astra 也在其自制的幻灯片中为自己作了同样的“降级”推荐:
由 GPT-6.2 Astra 制作
两款模型在 OpenAI 的图表中都提供五档推理强度,从低到最大,而强度设置与档位同样重要。在 Agents' Last Exam 上,Sol 的高强度(72.0%,$0.69/任务)仅比 GPT-6 Astra 的最大强度(73.1%,$8.99)低约 1 分,但成本仅为后者的十三分之一。Ultrafast 模式可在 API 中用于两款模型,并向 ChatGPT 的 Pro 500 订阅者开放。
| 用例 | 档位 | 原因 |
|---|
| 日常编程、重构与代码评审 | Sol | 在 FrontierCode 2.0 上仅比 Astra 低 0.5 分,成本约为其五分之一 |
| 高频代理循环与自动化 | Sol | $2 / $10 每百万 Token,延续 GPT-6.1 Sol 的价格 |
| 面向客户的演示文稿、财务工作簿与备忘录 | Astra | 模板匹配与 GDPval v2 的领先表现是 Astra 专属 |
| 法律撰写与研究 | Astra | 在 Harvey LAB-AA 上 15.0%,高于 Sol 的 11.1% |
| CAD、仿真与科学分析 | Astra | 在 BenchCAD 与 Terminal-Bench-Science 上领先 Sol 约 9 分 |
测试 GPT-6.2 Astra:上手示例
上述基准来自 OpenAI,因此我用 2 个测试将 GPT-6.2 Astra 与其前代 GPT-6 Astra 对比,提示与工具完全相同。对于仪表盘测试,两款模型均在 OpenCode 中运行,固定工具面(仅读取、搜索与编辑文件)、相同的高推理强度、单次尝试、全新会话。
测试 1:从脏数据生成“诚实”的仪表盘
任务:基于包含 173 个美国大学专业的收入与就业结果的 CSV,为职业顾问构建单文件 HTML 仪表盘,以便为客户比较学科领域。要求比较各类别的收入与就业、呈现收入最高与最低的专业、内嵌数据而非在线抓取,并适配一块 1440×900 屏幕。
真正的测试在于数据本身,存在提示中未提到的问题:
- 收入最高的石油工程($110,000)基于 36 人样本,而 173 个专业中有 76 个的样本不足 100。
- 收入最低的图书馆学($22,000)基于 2 人样本。
- 食品科学缺失研究生总数。
- 类别跨度极大:从仅有一个专业(跨学科,12,296 名毕业生)到包含 13 个专业共 130 万名毕业生(商业),因此如何取平均非常重要。
它同时检验两个发布主张:Astra 在分析型工作簿上的能力与其效率(以更少输出 Token 取得更好结果)。以下是 GPT-6.2 Astra 的产出:
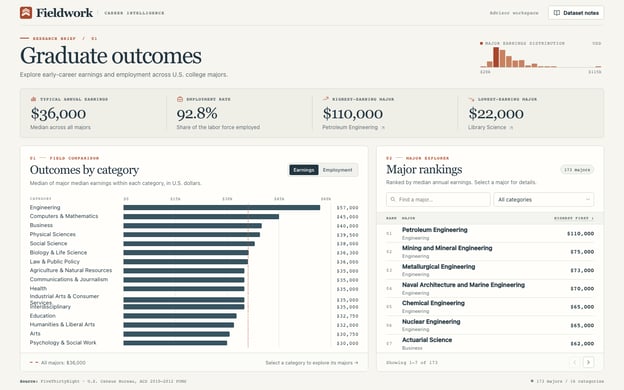
主要发现:
- 两款模型都在第一次尝试中交付了可用的仪表盘。都内嵌了全部 173 个专业,自绘 SVG 图表(未用图表库),一屏呈现,加载无误。
- 它们对同一数据的解读不同,导致类别排序变化。GPT-6.2 Astra 以各类别中“专业中位数的中位数”排名,使得拥有几千毕业生的专业与拥有 20 万毕业生的专业权重相同。GPT-6 Astra 则按各专业毕业生人数加权。结果是:在 GPT-6.2 Astra 的仪表盘上,健康类以 $35,000 排第 10;而在 GPT-6 Astra 上,因护理专业(209,394 名毕业生,$48,000 中位数)的分量得到体现,健康类以 $40.6k 排第 4。
- GPT-6 Astra 也将样本量信息放在更显眼的位置。其主表格显示收入前四名专业的样本量分别为 36、7、3、16。GPT-6.2 Astra 仅在选择专业后才显示样本量,并附带一行关于排名不稳定的提醒。
- GPT-6.2 Astra 更便宜、更精炼。其成本为 $1.79,对比 GPT-6 Astra 的 $2.93;输出 Token 为 27,821,对比 35,298。
我们再看看 GPT-6 Astra 的版本。将其类别图与上面的 GPT-6.2 Astra 对比:健康类在这里排第 4,而在对方那里排第 10;生物与生命科学从第 6 掉到第 11。
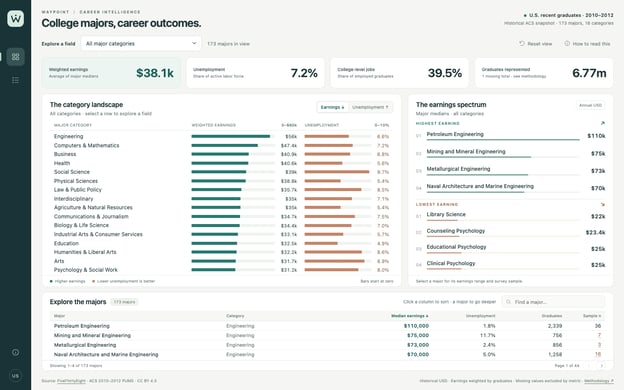
两种方法在数学上都说得通,且 GPT-6.2 Astra 明确标注了“专业中位数的中位数”。但职业顾问关心的是毕业生实际能达到的收入水平,只有按毕业生加权的版本才能回答这个问题。
测试 2:基于模板截图生成一套幻灯片
任务:将本文背后的研究笔记制作成一套 5 页幻灯片,供工程管理者决定是否切换使用;风格需与一张模板页一致。模型只收到模板的截图,提示要求其“精确到字号”地匹配,但未提供字体名称或任何字号。
这直接检验了 OpenAI 关于幻灯片的主张。因需识别图像,每个模型都通过 OpenRouter 发起单次 API 调用,使用相同的高推理强度;我也加入了 GPT-6.2 Sol,因为做幻灯片是日常工作。这是它们看到的模板,我为测试而设计:
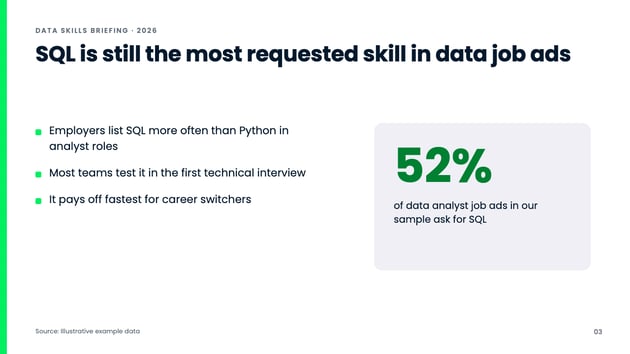
主要发现:
- 三款模型都仅凭截图重建了模板。都识别出字体为 Poppins,并保留了绿色强调条、引导行、灰色统计卡片、来源行与页码。每一页标题都像模板那样给出要点。
- 三者与模板的匹配度足够高,以肉眼难分。在浏览器中检查,只有 GPT-6.2 Sol 准确命中模板字号。Astra(OpenAI 声称能“精确到字号”匹配模板的模型)在字号上差一两像素。
- 在两代 Astra 之间,GPT-6.2 Astra 更经济。其成本 $0.22、输出 Token 4,968;GPT-6 Astra 为 $0.59、输出 Token 11,247;Sol 为 $0.07。
Astra 的 5 页幻灯片就是您在文中见到并配有说明的那些,所有数据与我的笔记一致。GPT-6 Astra 的整套同样可用,因此在该任务上两代并无明显差距。
那么 GPT-6.2 Astra 是否是一次实质升级?在成本上,是:两项测试分别节省 39% 至 63%,与 OpenAI 关于效率的说法一致。在判断力上,则未必:旧款在数据加权上更符合职业顾问的需求,而幻灯片上两者不相上下。
一次任务各一跑无法对两款模型定高下,但这与 OpenAI 自身关于 Blocker Deception 的发现吻合:检查 GPT-6.2 Astra 省略了什么,而不只是它做出了什么。
GPT-6.2 Astra 与 Sol 的定价与可用性
GPT-6.2 Astra 的输入与输出 Token 比 GPT-6 Astra 便宜 20%,缓存输入便宜 60%;GPT-6.2 Sol 则延续 GPT-6.1 Sol 的价格。标准 API 费率(每百万 Token):
| 模型 | 输入 | 缓存输入 | 输出 |
|---|
| GPT-6.2 Astra | $8.00 | $0.40 | $40.00 |
| GPT-6.2 Sol | $2.00 | $0.10 | $10.00 |
更低的单价只是节省的一部分。由于两款模型都使用更少的输出 Token,每任务成本进一步下降,这也是为何 Astra 的 Agents' Last Exam 成本不到 GPT-6 Astra 的三分之一。OpenAI 还建议保持提示前缀不变,新增指令置于其后,以提高缓存命中并在多轮中保留推理上下文。
Astra 对新价格的自我总结:
由 GPT-6.2 Astra 制作
在 ChatGPT 中,两款模型自发布日起面向 Plus、Pro、Enterprise 与 Edu 用户,在 ChatGPT Work 与 Codex 中可用。Enterprise 与 Edu 用户需由工作区管理员开启后方可访问。
Ultrafast 可用于任一模型,并向 Pro 500 订阅者开放;Pro 200 订阅者也首次获得 Ultrafast,从 GPT-6.2 Sol 开始。OpenAI 的公告未提及 Free 计划。
如何获取 GPT-6.2 Astra 与 Sol 的访问?
两款模型已在 OpenAI API 中普遍可用,型号为 gpt-6.2-astra 与 gpt-6.2-sol,Ultrafast 随发布一同上线。使用 OpenAI Python SDK 的最简请求如下:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "high"},
    input="Summarize this quarterly report in 5 bullet points: ...",
)
print(response.output_text)技术支持
两款模型也已在 OpenRouter(openai/gpt-6.2-astra 与 openai/gpt-6.2-sol)和 OpenCode 模型目录中上架。
如需参照上一代完成端到端构建,请查看我们的 GPT-6 Astra API 教程 与 GPT-6.1 Sol 教程;主要变化是切换模型 ID。
结语
GPT-6.2 是一次被 OpenAI 打造成“能力发布”的降价。Astra 在 OpenAI 报告的每项专业工作基准上都胜过 GPT-6 Astra,而每任务成本仅为其三分之一;在编程上,Sol 的表现足够接近,大多数团队应从它开始。
它并未终结整体竞赛。Claude Fable 5.2 仍在 FrontierCode 与 Intelligence Index 上领先,Gemini 4 Carbon 领先 AutomationBench,而在我们的测试中,旧款 Astra 对脏数据集的解读更合理。但若我今天在用 GPT-6 Astra,我会为省钱而立即切换。
由 GPT-6.2 Astra 制作
如果您想进一步了解如何基于 OpenAI 的模型进行构建,推荐查看我们的课程:Working with the OpenAI API。


11 月对于前沿模型来说格外热闹。Anthropic 发布了 Claude Fable 5.2,Google 推出了 Gemini 4 Carbon,而今天,在一周的猜测之后,OpenAI 同时给出两个型号:GPT-6.2 Astra 和 GPT-6.2 Sol。
GPT-6.2 Astra 是 OpenAI 面向高难度专业工作的全新前沿模型,适用于演示文稿(deck)、财务工作簿、法律撰写、CAD,以及长时程代理任务。GPT-6.2 Sol 则是更便宜的日常型号,覆盖编程、写作与代理循环,在编程方面以约四分之一的 Token 价格接近 Astra 的表现。
虽然我刚刚提到它们的差异,但两者每个任务的成本都与被替代的型号持平或更低:在 API 中,Astra 的输入与输出价格比 GPT-6 Astra 低 20%,而 Sol 保持与 GPT-6.1 Sol 相同的价格。
本文将全面介绍 GPT-6.2 Astra 和 Sol 的新变化,涵盖新特性、基准测试,并用 2 个上手测试将 Astra 与 GPT-6 Astra 正面对比。
如您所见,新模型正以极快节奏发布。要把握 AI 与数据领域的脉动,欢迎订阅我们的每周通讯 The Median。
要点速览
什么是 GPT-6.2 Astra 和 Sol?
GPT-6.2 Astra 取代顶端的 GPT-6 Astra,而 Sol 则在下一档取代 GPT-6.1 Sol。与上一代相比,有两点关键不同:
用一页图讲成本故事,这页图由 GPT-6.2 Astra 制作。(更强的幻灯片制作是其一大新特性,我们稍后再讲。)
GPT-6.2 Astra 和 Sol 的关键特性
多数新变化面向专业产出与效率,而非单纯的“智力”提升。以下四点最关键。
按您的模板构建幻灯片、工作簿和文档
GPT-6.2 Astra 可接收幻灯片模板(原始文件或甚至截图),并精准匹配其版式、配色与字体排印,细至字号。OpenAI 针对法律、销售、金融与会计等领域的写作规范进行了训练,强调以标题直陈要点,正文更少“注水”。
我在本文多处测试了这个新功能,包括上面的那页图。Astra 将每一页写成 HTML,我未做任何修改,直接渲染为图片。
同样的训练也体现在电子表格上。在 Artificial Analysis 的 AA-AnalystAgent 测试中(要求模型在真实的表格与报告中查找数值),Astra 在五次独立尝试中有 62.5% 的题目回答正确,OpenAI 称这是新的最高纪录。ClickUp 报告称,在对其应用、仪表盘和 ClickUp Brain 生成的幻灯片的盲测中,Astra 略胜其生产模型,评审轮次减少约 30%。
借助电脑使用,在 CAD 与仿真工具中开展工作
GPT-6.2 Astra 的电脑使用能力现已细化到 CAD 与仿真工具中的每个零件与连接。我们预计这对机械与产品工程师意义重大。OpenAI 的演示包括:用 Python 求解器模拟汽车底盘动力学并在 Blender 中动画呈现;基于公开照片与装配手册,逐件建模 1:8 遥控越野车;以及从参考照片出发,经由 CAD 多次修订完成的一盏纸灯设计。
我们难以自行构建 CAD 项目来测试,因此这里展示 OpenAI 的驾驶仿真演示。Astra 构建了 3D 车辆,为轮胎与悬架编写了 Python 求解器,并在 Blender 中完成动画:
来源:OpenAI
在代理工作流中每个 Token 产出更多
两款模型都能以更少的输出 Token 取得更好结果,这也是成本节省的主要来源。在 OpenAI 的内部 GDPval v2 上,GPT-6.2 Astra 比 GPT-6 Astra 高 6.2 分,同时输出 Token 减少 22%。Astra 也更会选工具,包括在何时使用插件而非电脑使用;Basis 报告其长时程会计工作的平均耗时减半。
系统卡也在提示注入方面带来更好消息:电子邮件或网页中的隐藏指令试图劫持代理时,Astra 的幻灯片总结了安全权衡:
由 GPT-6.2 Astra 制作
在更严格的防护下编写更安全的代码
GPT-6.2 Astra 和 Sol 更有效地发现与利用漏洞,OpenAI 也新增了关于编写安全代码与在保留预期行为前提下打补丁的训练信号。二者在 OpenAI 的预备框架下均达到网络安全“关键”阈值,与 GPT-6 Astra 一致。
代价是更多的拒绝响应。OpenAI 为两款模型上线了更严格的安全防护,也限制了一些正当的漏洞研究与安全测试。获批的防御方仍通过 OpenAI Daybreak 使用 GPT-6 Astra 与两周前上线的 GPT-6 Cyber。
GPT-6.2 Astra 和 Sol 的基准表现如何?
在 OpenAI 的专业工作与科学基准上,GPT-6.2 Astra 领先,但在若干编程与推理结果上,Claude Fable 5.2 仍占优势。
下表中的分数均为厂商报告。每行最高分以粗体标注。
专业工作与代理式工作流
在 Agents' Last Exam v1.1(测试长、多步骤的专业工作流)上,GPT-6.2 Astra 以 $2.89/任务取得 78.3%。GPT-6 Astra 为 73.1%,成本 $8.99/任务;Claude Fable 5.2 为 72.8%,成本 $60.05。
Gemini 4 Carbon 以 77.4% 最接近,但成本为 $4.60/任务。其他专业工作结果也呈现相同模式:
在表中这些模型里,Astra 每行都领先,并在 Harvey 的法律基准上将 Fable 5.2 的分数翻倍。Gemini 4 Carbon 仍以 53.9% 略胜于 AutomationBench;在 GDPval v2 上,Carbon 的 48.8% 介于 Astra 与 Sol 之间。
OpenAI 的 GDPval v2 图表显示节省来自何处:在相同的输出 Token 数下,新型号得分更高。
编程与安全
编程是 Sol 体现价值的场景:在 FrontierCode 2.0 上,它以 $1.29/任务取得 43.8%,对比 Astra 的 44.2% 与 $5.97/任务。
Claude Fable 5.2 在 FrontierCode 2.0 上保持领先,而Claude Opus 5.5 在最大努力下(45.5%)也高于两款 GPT-6.2。安全相关的行最能体现代际跃迁,尽管 OpenAI 未报告 Fable 5.2 在这些基准上的结果。
OpenAI 的 FrontierCode 图进一步说明 Sol 的优势:在最大努力下,它以约五分之一的任务成本达到 Astra 的分数。
科学、CAD 与通用推理
在 Terminal-Bench-Science 0.1(测试在终端中执行科学工作的能力)上,GPT-6.2 Astra 取得 77.1%,比 GPT-6 Astra 高出 9 分,而每任务成本不足其三分之一。
Fable 5.2 仍在 Intelligence Index 与 BenchCAD 上领先,但其每任务成本分别为 $26.54 与 $50.77,而 Astra 为 $4.00 与 $5.43。如果您需要绝对最佳的 CAD 输出,Fable 仍是首选;若您每天需要多次产出,Astra 能以约十分之一的价格达到 99% 的效果。
在 Terminal-Bench-Science 上,Astra 以最大努力达到最高分,每任务 $7.15,对比 GPT-6 Astra 的 $23.80 与 Claude Fable 5.2 的 $45.21。
该用哪个档位?
GPT-6.2 Sol 应作为您的默认选择,GPT-6.2 Astra 则在需要时升级使用。Sol 的 Token 价格仅为 Astra 的四分之一,而在编程上其分数只落后不到 1 分。
GPT-6.2 Astra 也在其自制的幻灯片中为自己作了同样的“降级”推荐:
由 GPT-6.2 Astra 制作
两款模型在 OpenAI 的图表中都提供五档推理强度,从低到最大,而强度设置与档位同样重要。在 Agents' Last Exam 上,Sol 的高强度(72.0%,$0.69/任务)仅比 GPT-6 Astra 的最大强度(73.1%,$8.99)低约 1 分,但成本仅为后者的十三分之一。Ultrafast 模式可在 API 中用于两款模型,并向 ChatGPT 的 Pro 500 订阅者开放。
测试 GPT-6.2 Astra:上手示例
上述基准来自 OpenAI,因此我用 2 个测试将 GPT-6.2 Astra 与其前代 GPT-6 Astra 对比,提示与工具完全相同。对于仪表盘测试,两款模型均在 OpenCode 中运行,固定工具面(仅读取、搜索与编辑文件)、相同的高推理强度、单次尝试、全新会话。
测试 1:从脏数据生成“诚实”的仪表盘
任务:基于包含 173 个美国大学专业的收入与就业结果的 CSV,为职业顾问构建单文件 HTML 仪表盘,以便为客户比较学科领域。要求比较各类别的收入与就业、呈现收入最高与最低的专业、内嵌数据而非在线抓取,并适配一块 1440×900 屏幕。
真正的测试在于数据本身,存在提示中未提到的问题:
它同时检验两个发布主张:Astra 在分析型工作簿上的能力与其效率(以更少输出 Token 取得更好结果)。以下是 GPT-6.2 Astra 的产出:
主要发现:
我们再看看 GPT-6 Astra 的版本。将其类别图与上面的 GPT-6.2 Astra 对比:健康类在这里排第 4,而在对方那里排第 10;生物与生命科学从第 6 掉到第 11。
两种方法在数学上都说得通,且 GPT-6.2 Astra 明确标注了“专业中位数的中位数”。但职业顾问关心的是毕业生实际能达到的收入水平,只有按毕业生加权的版本才能回答这个问题。
测试 2:基于模板截图生成一套幻灯片
任务:将本文背后的研究笔记制作成一套 5 页幻灯片,供工程管理者决定是否切换使用;风格需与一张模板页一致。模型只收到模板的截图,提示要求其“精确到字号”地匹配,但未提供字体名称或任何字号。
这直接检验了 OpenAI 关于幻灯片的主张。因需识别图像,每个模型都通过 OpenRouter 发起单次 API 调用,使用相同的高推理强度;我也加入了 GPT-6.2 Sol,因为做幻灯片是日常工作。这是它们看到的模板,我为测试而设计:
主要发现:
Astra 的 5 页幻灯片就是您在文中见到并配有说明的那些,所有数据与我的笔记一致。GPT-6 Astra 的整套同样可用,因此在该任务上两代并无明显差距。
那么 GPT-6.2 Astra 是否是一次实质升级?在成本上,是:两项测试分别节省 39% 至 63%,与 OpenAI 关于效率的说法一致。在判断力上,则未必:旧款在数据加权上更符合职业顾问的需求,而幻灯片上两者不相上下。
一次任务各一跑无法对两款模型定高下,但这与 OpenAI 自身关于 Blocker Deception 的发现吻合:检查 GPT-6.2 Astra 省略了什么,而不只是它做出了什么。
GPT-6.2 Astra 与 Sol 的定价与可用性
GPT-6.2 Astra 的输入与输出 Token 比 GPT-6 Astra 便宜 20%,缓存输入便宜 60%;GPT-6.2 Sol 则延续 GPT-6.1 Sol 的价格。标准 API 费率(每百万 Token):
更低的单价只是节省的一部分。由于两款模型都使用更少的输出 Token,每任务成本进一步下降,这也是为何 Astra 的 Agents' Last Exam 成本不到 GPT-6 Astra 的三分之一。OpenAI 还建议保持提示前缀不变,新增指令置于其后,以提高缓存命中并在多轮中保留推理上下文。
Astra 对新价格的自我总结:
由 GPT-6.2 Astra 制作
在 ChatGPT 中,两款模型自发布日起面向 Plus、Pro、Enterprise 与 Edu 用户,在 ChatGPT Work 与 Codex 中可用。Enterprise 与 Edu 用户需由工作区管理员开启后方可访问。
Ultrafast 可用于任一模型,并向 Pro 500 订阅者开放;Pro 200 订阅者也首次获得 Ultrafast,从 GPT-6.2 Sol 开始。OpenAI 的公告未提及 Free 计划。
如何获取 GPT-6.2 Astra 与 Sol 的访问?
两款模型已在 OpenAI API 中普遍可用,型号为
gpt-6.2-astra与gpt-6.2-sol,Ultrafast 随发布一同上线。使用 OpenAI Python SDK 的最简请求如下:两款模型也已在 OpenRouter(
openai/gpt-6.2-astra与openai/gpt-6.2-sol)和 OpenCode 模型目录中上架。如需参照上一代完成端到端构建,请查看我们的 GPT-6 Astra API 教程 与 GPT-6.1 Sol 教程;主要变化是切换模型 ID。
结语
GPT-6.2 是一次被 OpenAI 打造成“能力发布”的降价。Astra 在 OpenAI 报告的每项专业工作基准上都胜过 GPT-6 Astra,而每任务成本仅为其三分之一;在编程上,Sol 的表现足够接近,大多数团队应从它开始。
它并未终结整体竞赛。Claude Fable 5.2 仍在 FrontierCode 与 Intelligence Index 上领先,Gemini 4 Carbon 领先 AutomationBench,而在我们的测试中,旧款 Astra 对脏数据集的解读更合理。但若我今天在用 GPT-6 Astra,我会为省钱而立即切换。
由 GPT-6.2 Astra 制作
如果您想进一步了解如何基于 OpenAI 的模型进行构建,推荐查看我们的课程:Working with the OpenAI API。