更新:2026 年 9 月 2 日:阿里巴巴发布了 Qwen3.8-Max-0902,这是针对编码与智能体性能的 Qwen3.8-Max 升级版快照。下文新增一节以反映最新基准测试。
Qwen3.8-Max-0902 有何新变化
2026 年 9 月 2 日,阿里巴巴发布了 Qwen3.8-Max-0902,属于对 Qwen3.8-Max 的训练后升级。架构保持不变:2.4 万亿参数、100 万 token 上下文窗口,且定价不变(输入 $2/百万、输出 $6/百万)。此次升级重点聚焦编码与长周期智能体工作。
最显著的成果是 Code Arena WebDev,Qwen3.8-Max-0902 以 1691 分位列总榜第一,比 Claude Opus 5 Max(1687)高 3 分,比 Kimi K3 Max(1674)高 17 分,比此前的 Qwen3.8-Max(1669)高 22 分。它还在每百万 token 混合计价 5 美元的帕累托前沿上位居榜首。
相较 Qwen3.8-Max 的基准提升
8 个编码基准全部提升。涨幅最大的是 TerminalBench 3.0(从 11.3 到 29.0)与 ProgramBench Almost Solved(从 10.5 到 28.0),均超过翻倍。下表展示了编码、智能体与多模态三大类的完整对比。
| Benchmark | Qwen3.8-Max-0902 | Qwen3.8-Max | Claude Opus 5 |
|---|
| 编码 |
| TerminalBench 3.0 | 29.0 | 11.3 | 42.7 |
| DeepSWE 1.1 | 69.3 | 56.6 | 73.6 |
| NL2Repo-Bench | 64.9 | 55.9 | 72.3 |
| ProgramBench (Almost Solved) | 28.0 | 10.5 | 41.5 |
| SWE-Marathon | 44.8 | 39.1 | 50.0 |
| MLS-Bench-Lite | 50.1 | 41.0 | 49.8 |
| SWE-Atlas QnA | 66.3 | 60.3 | 63.2 |
| QwenSWEBench V2 | 70.0 | 55.1 | 68.0 |
| 智能体 |
| CoWorkBench | 76.1 | 74.8 | 79.6 |
| JobBench | 64.0 | 53.4 | 67.8 |
| Toolathlon Verified | 73.3 | 72.5 | 77.6 |
| WorkArena (Elo) | 1468 | 1348 | 1437 |
| 多模态 |
| MMMU-Pro | 82.7 | 82.3 | 82.6 |
| ERQA | 78.3 | 77.8 | 67.3 |
加粗表示在该基准上 Qwen3.8-Max-0902 领先 Claude Opus 5。所有结果来自阿里巴巴公开的对比表。
对比 Claude Opus 5,0902 更新在三项编码基准(MLS-Bench-Lite、SWE-Atlas QnA、QwenSWEBench V2)中领先,并在 WorkArena 及两项公开的多模态评测中获胜。Claude 仍在 TerminalBench 3.0、DeepSWE 1.1 以及智能体协作基准上占优。定价未变,因此如果您已在使用 Qwen3.8-Max,这是一次免费的、对编码有实质提升的升级。Qwen 还在 9 月 18 日发布了 Qwen3.8-Omni-Flash。
原文如下
阿里巴巴的 Qwen 团队于 2026 年 8 月 3 日发布了 Qwen3.8-Max,它直指前沿市场中竞争最激烈的领域:自主软件工程与长周期企业级工作。这是 Qwen 首次计划开源 Max 级模型,权重预计下周与较小的 Qwen3.8-27B 一同发布。
Qwen3.8-Max 是一个 2.4 万亿参数的专家混合(MoE)模型,激活参数为 950 亿,具备 100 万 token 上下文窗口,并原生支持文本、图像与视频输入。其核心宣称是在 OSWorld-Verified 上取得 86.1 的成绩,领先 GPT-5.6 Sol Max(83.2)、Claude Fable 5(85.0)与 Gemini 3.1 Pro(76.2)。它也拿下已披露的最高 PaperBench 分数 93.0,定价为每百万输入/输出 token 分别 $2/$6。
本文将覆盖 Qwen3.8-Max 的全部新内容,聚焦其编码与智能体能力,解读基准测试,并为您设置可上手的实测方案。相关内容请参阅我们的 Grok 4.5 指南、GPT-5.6 Terra 与 Claude Sonnet 5 对比,以及我们的 Claude API 完整指南。您也可以阅读关于 全新 Qwen3.8-Flash 的介绍。
什么是 Qwen3.8-Max?
Qwen3.8-Max 是 Qwen 家族中能力最强的模型,采用稀疏的 MoE 架构,总参数 2.4 万亿,每次前向传递约 950 亿激活参数。
它建立在 Qwen 3.5 的架构基础上,重点面向四个方向:
与 Qwen3.7-Max 相比,最大的结构性变化在于规模与开源权重的承诺。Qwen 过去从未发布过 Max 级模型的权重,官方称 Qwen3.8-Max 与 Qwen3.8-27B 将于下周登陆 Hugging Face 与 ModelScope。
阿里巴巴尚未披露许可证,因此目前仍不清楚会采用 Apache 2.0 等宽松许可,还是更为严格的自定义许可。
最受关注的基准消息集中在智能体电脑使用能力。
在 OSWorld-Verified 上(评估智能体在真实桌面环境中的操作能力),Qwen3.8-Max 领先其对比测试过的所有专有模型。
对一个将可自托管的模型而言,这与常见“落后一代”的开源权重发布有实质不同。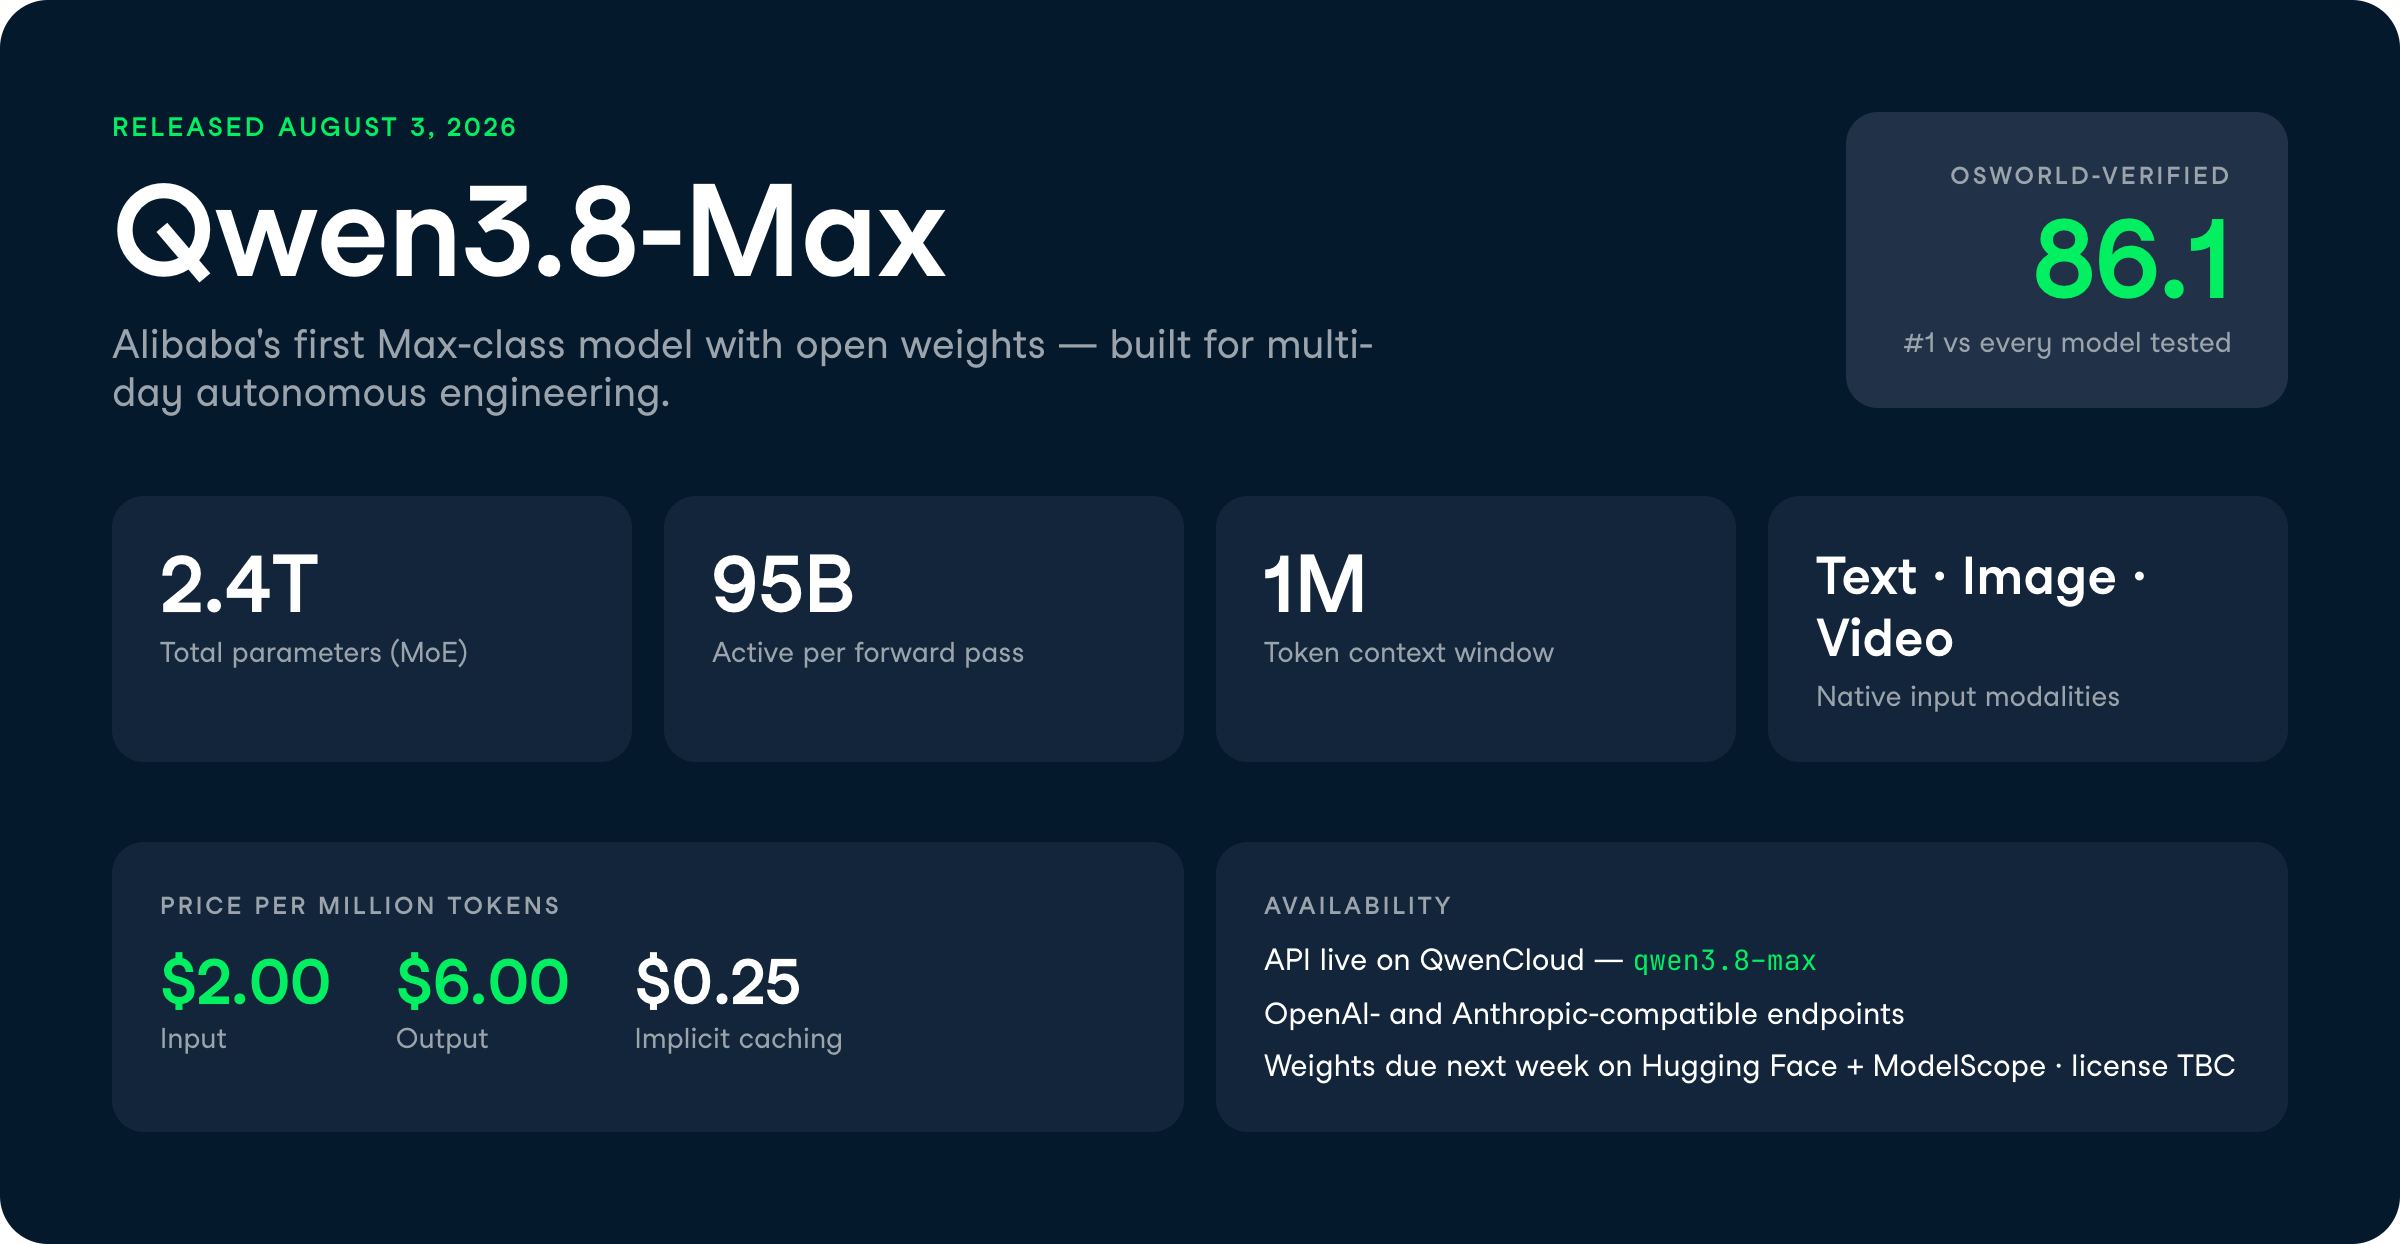
Qwen3.8-Max 的新特性
Qwen3.8-Max 贯穿的主题是长周期上的自治能力。
Qwen 将各项能力都围绕同一理念展开:模型不遵循固定计划,而是在数天的连续工作中通过反馈回路自我纠错。
以下是我认为最突出的特性。
多日自主编码
Qwen3.8-Max 能在无人干预的情况下,数天连续运行,将一个编码项目从空文件夹推进到可交付成品。
官方的旗舰演示连续自主运行约 16 天,构建了一个自进化的 CLI 框架,累计 265 次提交、127 个 PR 与 151 个 Issue。
机制是一条反馈回路:需求以 GitHub Issues 形式进入,智能体领取并执行,然后触发构建、单测、端到端测试与 CI 检查,最后合并。
对实务者而言,这指向的是一个用于无人值守工程流水线的模型,而非解答一次性代码问题。
显而易见的注记是:这些都是厂商主导的展示。
受控环境下的 16 天自主运行,并不等同于把它对准您的生产单体仓库后就能高枕无忧。
科研复现与自我改进
Qwen3.8-Max 能阅读论文,从零用代码复现实验,并尝试超越原方法。
在 Qwen 的示例中,模型工作约 5 天(约 125 小时),编写约 7600 行代码,执行 1100+ 次动作,进行 33 轮 GPU 训练,且未提供起始代码。
它先复现了论文的六个主要结论,随后进行了 4 轮、18 个想法的自我改进循环:假设—编码—GPU 运行—分析。
其最终方法在 AIME24(竞赛级数学基准)上比论文原法高出 2.71 分。
这类流程通常会占据研究团队一周的准备时间,甚至实验尚未开始。
用于并行智能体编排的动态工作流
动态工作流让 Qwen3.8-Max 以编程方式规划任务,并并行调度大量子智能体。
在量化研究演示中,模型将 6 个简短因子描述分解为每个 50 个研究方向,调度约 330 个子智能体,完成约 6000 次回测,并在运行中自适应调整工作流。
与固定脚本的区别在于模型基于证据行动。
当它识别出过拟合信号时,会逐轮修剪冗余因子;当发现三模型集成在小截面上不如固定方向综合稳健时,它会自主切换框架。
所选因子的超额夏普比达 0.64 至 1.48,这是可量化、可核验的结果,而非“感觉”。
将视觉用作反馈回路,而非仅仅输入
Qwen3.8-Max 在执行过程中使用视觉,不只是读取输入。
在任务中,它会检查自己的中间输出,识别诸如界面错位或物体方向错误等问题,并调整计划加以修正。
在输入侧,它可处理 200 多页的 PDF(涵盖文本、图表与版式),并能通过构建人物、事件与时间戳的视频记忆图处理超过 100 小时的视频。
Qwen 还发布了 Qwen-MM-Plugins,这是一套扩展库,为现有智能体框架增添图像与视频处理、多模态记忆与视觉工具使用能力。
对构建重文档或重视频的智能体而言,记忆图是值得关注的关键一环。
可控的推理开销
Qwen3.8-Max 提供 reasoning_effort 参数,以在成本与深度间取舍。三个级别可调节模型在回答前的“思考量”:
xhigh(默认):适用于需要深入分析的复杂任务medium:在准确性与速度间取得平衡low:以速度与成本为优先的高效推理
需要提醒的是:一位 r/LocalLLaMA 用户指出 Qwen 模型常有“过度思考”倾向,而 DeepSeek V4 Flash 即使输出质量较低,推理时间也更短。如果您的工作负载对时延敏感,请先将其调至 low,再决定默认值是否合适。
Qwen3.8-Max 基准测试
Qwen 的基准套件更偏向长周期执行而非静态考试,这与模型定位相符。
在已发布的表格中,Qwen3.8-Max 在智能体电脑使用、科研复现与编码方面领先或具强竞争力,而在部分软件工程评测上落后于 GPT-5.6 Sol Max 与 Fable 5。
它呈现出更为均衡而广泛的能力谱系,而非在每个类别都一家独大。
| Benchmark(类别) | Qwen 3.8 Max | Qwen 3.7 Max | Opus 4.8 | Fable 5 | Gemini 3.1-Pro | GPT5.6 Sol(max) |
|---|
| SWE-Pro(软件工程) | 67.7 | 60.6 | 69.2 | 80.0 | - | 64.6 |
| TerminalBench-2.1(终端智能体) | 86.6 | 74.5 | 84.6 | 84.6 | - | 88.8 |
| PaperBench(科研复现) | 93.0 | 64.8 | 80.3 | 88.8 | - | 90.5 |
| FrontierSWE(软件工程) | 73.5 | 40.7 | 70.0 | 88.8 | - | - |
| QwenReactBench(React 前端) | 1724 | 1538 | 1694 | 1770 | - | 1564 |
| CoWorkBench(专业协作任务) | 74.8 | 64.6 | 72.3 | 75.9 | - | 71.5 |
| JobBench(智能体赋能人类流程) | 53.4 | 31.3 | 48.4 | 57.4 | - | 45.4 |
| Agents' Last Exam(长周期高价值任务) | 52.4 | 31.1 | 45.1 | - | - | 53.6 |
| BabyVision(视觉推理)* | 82.0 / 91.3 | 64.7 / 70.4 | 28.4 / 81.2 | 42.5 / 90.5 | 55.9 / 68.3 | 65.5 / 88.9 |
| CharXiv(RQ)(图表推理)* | 88.4 / 93.5 | 85.8 / 85.9 | 78.5 / 89.9 | 87.9 / 93.5 | 84.4 / 89.9 | 85.1 / 89.1 |
| ERQA(具身推理) | 77.8 | 69.8 | 57.2 | 70.0 | 68.0 | 70.0 |
| PerceptionBench(视觉感知) | 63.5 | 51.1 | 47.2 | 57.2 | 56.2 | 59.7 |
| LVBench(长视频理解) | 81.8 | 76.2 | 67.3 | 75.1 | - | 78.8 |
| Vision2Web(视觉网页开发) | 69.0 | 42.1 | 62.4 | 70.5 | - | 62.1 |
| MobileWorld(移动端智能体使用) | 77.8 | 51.2 | 67.5 | 85.5 | 58.1 | 76.9 |
| OSWorld-Verified(智能体电脑使用) | 86.1 | 73.3 | 83.4 | 85.0 | 76.2 | 83.2 |
重要说明:
* 双分数:对于包含双指标的基准(BabyVision 与 CharXiv),数值格式为 w/o python / w/ python,对应各图表中内层与顶部数值。
* 缺失数据(-):短横线表示该模型未参与该基准测试或成绩未纳入图表。
OSWorld-Verified
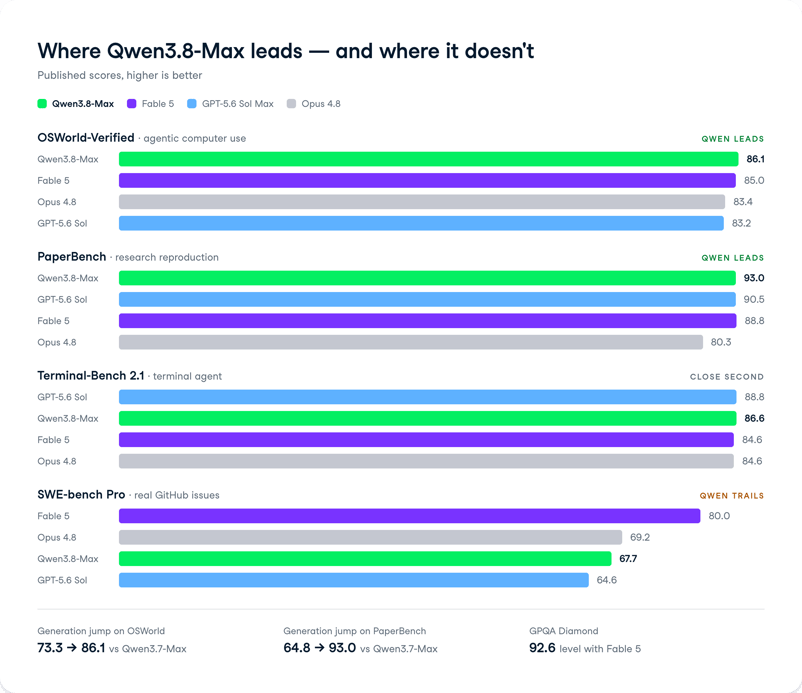
Qwen3.8-Max 在 OSWorld-Verified 上得分 86.1,领先 Fable 5(85.0)、GPT-5.6 Sol Max(83.2)与 Gemini 3.1 Pro(76.2)。
该基准衡量“电脑使用”智能体在真实桌面环境中的可靠性,即通过点击界面完成多步任务。
对构建驱动实际应用而非仅调 API 的智能体而言,这是最关键的指标。Qwen3.7-Max 在该项仅为 73.3,家族内提升显著。
PaperBench
在 PaperBench 上,Qwen3.8-Max 取得 93.0 的最高已披露分数,领先 GPT-5.6 Sol 的 90.5 与 Fable 5 的 88.8。
PaperBench 衡量模型将论文实验用代码复现的能力,这与 5 天科研复现展示直接对应。
相较 Qwen3.7-Max 的 64.8,这是巨大跃升。如果您的工作涉及把论文转化为可运行流水线,这是强烈信号。
Terminal-Bench 2.1
Qwen3.8-Max 在 Terminal-Bench 2.1 上得分 86.6,介于 GPT-5.6 Sol 的 88.8 与 Opus 4.8、Fable 5 的 84.6 之间。
该基准测试智能体在终端内于时限下完成工程任务的能力。
这较 Qwen3.7-Max 的 74.5 有实质改进,也让开源权重模型在命令行智能体工作上逼近顶级专有成绩。
SWE-bench Pro
此处 Qwen3.8-Max 略显落后。其在 SWE-bench Pro 上得分 67.7,落后于 Fable 5 的 80.0 与 Opus 4.8 的 69.2,但领先 GPT-5.6 Sol 的 64.6。
SWE-bench Pro 衡量在专业代码库中解决真实 GitHub Issues 的能力。
这是一个坦诚的短板。我们评测 Grok 4.5 时,Fable 5 在 SWE-Bench Pro 也以 80.4 领先,因此在这项评测上 Anthropic 的模型仍是标杆。
GPQA Diamond 与通用能力
在 GPQA Diamond(研究生水平的科学推理基准)上,Qwen3.8-Max 得分 92.6,与 Fable 5(92.6)持平,略低于 GPT-5.6 Sol 的 94.1。它还在 IFBench(指令跟随)上以 82.8 领先,在 HealthBench 以 60.2 领先,并在 PRBench-Finance 以 58.3 领先。
总体模式一致:在智能体与应用型工作上强势,在推理上具竞争力,偶尔在最难的推理考试“人类的最后一考”上落后,后者它得分 43.6,对比 Fable 5 的 53.3。
Qwen3.8-Max 定价与可用性
Qwen3.8-Max 现已可通过 QwenCloud 获取,API 模型 ID 为 qwen3.8-max。该 API 支持与 OpenAI 兼容的 chat completions 与 responses 端点,也兼容 Anthropic 接口,因此只需少量配置即可将 Claude Code 或 Codex 指向它。
定价处于中端,并低于其对标的美国顶级专有模型:
- 输入:每百万 token 收费 $2.00
- 输出:每百万 token 收费 $6.00
- 隐式缓存:每百万 token 收费 $0.25
合计 $8 不到 Claude Opus 5 的 $30 的三分之一,也低于 GPT-5.6 Sol Standard 的 $35 的四分之一。其定价与 Grok 4.5 相同,均为 $2/$6,详见我们对 Grok 4.5 的报道。Qwen3.8-Max 与 Qwen3.8-27B 的开源权重预计下周登陆 Hugging Face 与 ModelScope,但许可证条款尚未公布。
结语
Qwen3.8-Max 体现了阿里巴巴对“开源权重能与谁竞争”的判断。在可自托管前提下,于 OSWorld-Verified 与 PaperBench 领先 Fable 5 与 GPT-5.6 Sol Max,并以 $2/$6 的价格出现,这种“每个智能体任务的成本”压力将传导至整个专有梯队。
当然也有现实的保留:16 天的自主编码与 5 天科研复现是厂商展示,并非独立复现;下周即将发布的权重许可证也未知。在 r/LocalLLaMA 上,更受讨论的是更小的 Qwen3.8-27B,不少评论者对能在一块消费级 GPU 上“榨取智能”的前景更感兴趣,而非只能在少数配置上运行的 2.4T 庞然大物。
我的看法:如果您在构建能操作真实界面或复现实验流水线的智能体,Qwen3.8-Max 值得认真测试,尤其是在权重量产、可自托管之后。如果您的工作主要是专业软件工程、攻坚复杂 GitHub Issues,则 Fable 5 仍在 SWE-bench Pro 领先,建议并行测试后再做决策。
若您希望通过 API 熟悉此类模型的使用,建议先学习我们的 AI Fundamentals 技能路径 以夯实基础。


更新:2026 年 9 月 2 日:阿里巴巴发布了 Qwen3.8-Max-0902,这是针对编码与智能体性能的 Qwen3.8-Max 升级版快照。下文新增一节以反映最新基准测试。
Qwen3.8-Max-0902 有何新变化
2026 年 9 月 2 日,阿里巴巴发布了 Qwen3.8-Max-0902,属于对 Qwen3.8-Max 的训练后升级。架构保持不变:2.4 万亿参数、100 万 token 上下文窗口,且定价不变(输入 $2/百万、输出 $6/百万)。此次升级重点聚焦编码与长周期智能体工作。
最显著的成果是 Code Arena WebDev,Qwen3.8-Max-0902 以 1691 分位列总榜第一,比 Claude Opus 5 Max(1687)高 3 分,比 Kimi K3 Max(1674)高 17 分,比此前的 Qwen3.8-Max(1669)高 22 分。它还在每百万 token 混合计价 5 美元的帕累托前沿上位居榜首。
相较 Qwen3.8-Max 的基准提升
8 个编码基准全部提升。涨幅最大的是 TerminalBench 3.0(从 11.3 到 29.0)与 ProgramBench Almost Solved(从 10.5 到 28.0),均超过翻倍。下表展示了编码、智能体与多模态三大类的完整对比。
加粗表示在该基准上 Qwen3.8-Max-0902 领先 Claude Opus 5。所有结果来自阿里巴巴公开的对比表。
对比 Claude Opus 5,0902 更新在三项编码基准(MLS-Bench-Lite、SWE-Atlas QnA、QwenSWEBench V2)中领先,并在 WorkArena 及两项公开的多模态评测中获胜。Claude 仍在 TerminalBench 3.0、DeepSWE 1.1 以及智能体协作基准上占优。定价未变,因此如果您已在使用 Qwen3.8-Max,这是一次免费的、对编码有实质提升的升级。Qwen 还在 9 月 18 日发布了 Qwen3.8-Omni-Flash。
原文如下
阿里巴巴的 Qwen 团队于 2026 年 8 月 3 日发布了 Qwen3.8-Max,它直指前沿市场中竞争最激烈的领域:自主软件工程与长周期企业级工作。这是 Qwen 首次计划开源 Max 级模型,权重预计下周与较小的 Qwen3.8-27B 一同发布。
Qwen3.8-Max 是一个 2.4 万亿参数的专家混合(MoE)模型,激活参数为 950 亿,具备 100 万 token 上下文窗口,并原生支持文本、图像与视频输入。其核心宣称是在 OSWorld-Verified 上取得 86.1 的成绩,领先 GPT-5.6 Sol Max(83.2)、Claude Fable 5(85.0)与 Gemini 3.1 Pro(76.2)。它也拿下已披露的最高 PaperBench 分数 93.0,定价为每百万输入/输出 token 分别 $2/$6。
本文将覆盖 Qwen3.8-Max 的全部新内容,聚焦其编码与智能体能力,解读基准测试,并为您设置可上手的实测方案。相关内容请参阅我们的 Grok 4.5 指南、GPT-5.6 Terra 与 Claude Sonnet 5 对比,以及我们的 Claude API 完整指南。您也可以阅读关于 全新 Qwen3.8-Flash 的介绍。
什么是 Qwen3.8-Max?
Qwen3.8-Max 是 Qwen 家族中能力最强的模型,采用稀疏的 MoE 架构,总参数 2.4 万亿,每次前向传递约 950 亿激活参数。
它建立在 Qwen 3.5 的架构基础上,重点面向四个方向:
与 Qwen3.7-Max 相比,最大的结构性变化在于规模与开源权重的承诺。Qwen 过去从未发布过 Max 级模型的权重,官方称 Qwen3.8-Max 与 Qwen3.8-27B 将于下周登陆 Hugging Face 与 ModelScope。
阿里巴巴尚未披露许可证,因此目前仍不清楚会采用 Apache 2.0 等宽松许可,还是更为严格的自定义许可。
最受关注的基准消息集中在智能体电脑使用能力。
在 OSWorld-Verified 上(评估智能体在真实桌面环境中的操作能力),Qwen3.8-Max 领先其对比测试过的所有专有模型。
对一个将可自托管的模型而言,这与常见“落后一代”的开源权重发布有实质不同。
Qwen3.8-Max 的新特性
Qwen3.8-Max 贯穿的主题是长周期上的自治能力。
Qwen 将各项能力都围绕同一理念展开:模型不遵循固定计划,而是在数天的连续工作中通过反馈回路自我纠错。
以下是我认为最突出的特性。
多日自主编码
Qwen3.8-Max 能在无人干预的情况下,数天连续运行,将一个编码项目从空文件夹推进到可交付成品。
官方的旗舰演示连续自主运行约 16 天,构建了一个自进化的 CLI 框架,累计 265 次提交、127 个 PR 与 151 个 Issue。
机制是一条反馈回路:需求以 GitHub Issues 形式进入,智能体领取并执行,然后触发构建、单测、端到端测试与 CI 检查,最后合并。
对实务者而言,这指向的是一个用于无人值守工程流水线的模型,而非解答一次性代码问题。
显而易见的注记是:这些都是厂商主导的展示。
受控环境下的 16 天自主运行,并不等同于把它对准您的生产单体仓库后就能高枕无忧。
科研复现与自我改进
Qwen3.8-Max 能阅读论文,从零用代码复现实验,并尝试超越原方法。
在 Qwen 的示例中,模型工作约 5 天(约 125 小时),编写约 7600 行代码,执行 1100+ 次动作,进行 33 轮 GPU 训练,且未提供起始代码。
它先复现了论文的六个主要结论,随后进行了 4 轮、18 个想法的自我改进循环:假设—编码—GPU 运行—分析。
其最终方法在 AIME24(竞赛级数学基准)上比论文原法高出 2.71 分。
这类流程通常会占据研究团队一周的准备时间,甚至实验尚未开始。
用于并行智能体编排的动态工作流
动态工作流让 Qwen3.8-Max 以编程方式规划任务,并并行调度大量子智能体。
在量化研究演示中,模型将 6 个简短因子描述分解为每个 50 个研究方向,调度约 330 个子智能体,完成约 6000 次回测,并在运行中自适应调整工作流。
与固定脚本的区别在于模型基于证据行动。
当它识别出过拟合信号时,会逐轮修剪冗余因子;当发现三模型集成在小截面上不如固定方向综合稳健时,它会自主切换框架。
所选因子的超额夏普比达 0.64 至 1.48,这是可量化、可核验的结果,而非“感觉”。
将视觉用作反馈回路,而非仅仅输入
Qwen3.8-Max 在执行过程中使用视觉,不只是读取输入。
在任务中,它会检查自己的中间输出,识别诸如界面错位或物体方向错误等问题,并调整计划加以修正。
在输入侧,它可处理 200 多页的 PDF(涵盖文本、图表与版式),并能通过构建人物、事件与时间戳的视频记忆图处理超过 100 小时的视频。
Qwen 还发布了 Qwen-MM-Plugins,这是一套扩展库,为现有智能体框架增添图像与视频处理、多模态记忆与视觉工具使用能力。
对构建重文档或重视频的智能体而言,记忆图是值得关注的关键一环。
可控的推理开销
Qwen3.8-Max 提供
reasoning_effort参数,以在成本与深度间取舍。三个级别可调节模型在回答前的“思考量”:xhigh(默认):适用于需要深入分析的复杂任务medium:在准确性与速度间取得平衡low:以速度与成本为优先的高效推理需要提醒的是:一位 r/LocalLLaMA 用户指出 Qwen 模型常有“过度思考”倾向,而 DeepSeek V4 Flash 即使输出质量较低,推理时间也更短。如果您的工作负载对时延敏感,请先将其调至
low,再决定默认值是否合适。Qwen3.8-Max 基准测试
Qwen 的基准套件更偏向长周期执行而非静态考试,这与模型定位相符。
在已发布的表格中,Qwen3.8-Max 在智能体电脑使用、科研复现与编码方面领先或具强竞争力,而在部分软件工程评测上落后于 GPT-5.6 Sol Max 与 Fable 5。
它呈现出更为均衡而广泛的能力谱系,而非在每个类别都一家独大。
重要说明:
* 双分数:对于包含双指标的基准(BabyVision 与 CharXiv),数值格式为 w/o python / w/ python,对应各图表中内层与顶部数值。
* 缺失数据(-):短横线表示该模型未参与该基准测试或成绩未纳入图表。
OSWorld-Verified
Qwen3.8-Max 在 OSWorld-Verified 上得分 86.1,领先 Fable 5(85.0)、GPT-5.6 Sol Max(83.2)与 Gemini 3.1 Pro(76.2)。
该基准衡量“电脑使用”智能体在真实桌面环境中的可靠性,即通过点击界面完成多步任务。
对构建驱动实际应用而非仅调 API 的智能体而言,这是最关键的指标。Qwen3.7-Max 在该项仅为 73.3,家族内提升显著。
PaperBench
在 PaperBench 上,Qwen3.8-Max 取得 93.0 的最高已披露分数,领先 GPT-5.6 Sol 的 90.5 与 Fable 5 的 88.8。
PaperBench 衡量模型将论文实验用代码复现的能力,这与 5 天科研复现展示直接对应。
相较 Qwen3.7-Max 的 64.8,这是巨大跃升。如果您的工作涉及把论文转化为可运行流水线,这是强烈信号。
Terminal-Bench 2.1
Qwen3.8-Max 在 Terminal-Bench 2.1 上得分 86.6,介于 GPT-5.6 Sol 的 88.8 与 Opus 4.8、Fable 5 的 84.6 之间。
该基准测试智能体在终端内于时限下完成工程任务的能力。
这较 Qwen3.7-Max 的 74.5 有实质改进,也让开源权重模型在命令行智能体工作上逼近顶级专有成绩。
SWE-bench Pro
此处 Qwen3.8-Max 略显落后。其在 SWE-bench Pro 上得分 67.7,落后于 Fable 5 的 80.0 与 Opus 4.8 的 69.2,但领先 GPT-5.6 Sol 的 64.6。
SWE-bench Pro 衡量在专业代码库中解决真实 GitHub Issues 的能力。
这是一个坦诚的短板。我们评测 Grok 4.5 时,Fable 5 在 SWE-Bench Pro 也以 80.4 领先,因此在这项评测上 Anthropic 的模型仍是标杆。
GPQA Diamond 与通用能力
在 GPQA Diamond(研究生水平的科学推理基准)上,Qwen3.8-Max 得分 92.6,与 Fable 5(92.6)持平,略低于 GPT-5.6 Sol 的 94.1。它还在 IFBench(指令跟随)上以 82.8 领先,在 HealthBench 以 60.2 领先,并在 PRBench-Finance 以 58.3 领先。
总体模式一致:在智能体与应用型工作上强势,在推理上具竞争力,偶尔在最难的推理考试“人类的最后一考”上落后,后者它得分 43.6,对比 Fable 5 的 53.3。
Qwen3.8-Max 定价与可用性
Qwen3.8-Max 现已可通过 QwenCloud 获取,API 模型 ID 为
qwen3.8-max。该 API 支持与 OpenAI 兼容的 chat completions 与 responses 端点,也兼容 Anthropic 接口,因此只需少量配置即可将 Claude Code 或 Codex 指向它。定价处于中端,并低于其对标的美国顶级专有模型:
合计 $8 不到 Claude Opus 5 的 $30 的三分之一,也低于 GPT-5.6 Sol Standard 的 $35 的四分之一。其定价与 Grok 4.5 相同,均为 $2/$6,详见我们对 Grok 4.5 的报道。Qwen3.8-Max 与 Qwen3.8-27B 的开源权重预计下周登陆 Hugging Face 与 ModelScope,但许可证条款尚未公布。
结语
Qwen3.8-Max 体现了阿里巴巴对“开源权重能与谁竞争”的判断。在可自托管前提下,于 OSWorld-Verified 与 PaperBench 领先 Fable 5 与 GPT-5.6 Sol Max,并以 $2/$6 的价格出现,这种“每个智能体任务的成本”压力将传导至整个专有梯队。
当然也有现实的保留:16 天的自主编码与 5 天科研复现是厂商展示,并非独立复现;下周即将发布的权重许可证也未知。在 r/LocalLLaMA 上,更受讨论的是更小的 Qwen3.8-27B,不少评论者对能在一块消费级 GPU 上“榨取智能”的前景更感兴趣,而非只能在少数配置上运行的 2.4T 庞然大物。
我的看法:如果您在构建能操作真实界面或复现实验流水线的智能体,Qwen3.8-Max 值得认真测试,尤其是在权重量产、可自托管之后。如果您的工作主要是专业软件工程、攻坚复杂 GitHub Issues,则 Fable 5 仍在 SWE-bench Pro 领先,建议并行测试后再做决策。
若您希望通过 API 熟悉此类模型的使用,建议先学习我们的 AI Fundamentals 技能路径 以夯实基础。