
{count, plural, other {课程}}
Large Language Models (LLMs) 概念
{hours} 小时
112.3K
注意:Bonsai 2 27B 现已发布,基于 Qwen3.8 27B
在本地运行语言模型正变得越来越容易,即便是在较老的硬件上。Bonsai 是一款 1 比特模型,体积小、速度快且高效,非常适合在 Windows 笔记本电脑上本地使用。
在本教程中,我将用通俗的方式介绍 Bonsai 是什么以及 1 比特模型的工作原理,并一步步带您完成完整的安装与运行流程。
这包括下载 Bonsai 8B GGUF 模型、设置 PrismML 的 llama.cpp 分支、在命令行中测试模型、以本地服务器形式运行它,并使用 curl 和内置的 WebUI 检查一切是否正常工作。
我也建议您查看我们关于本地运行 GLM-5.1 和 Qwen3.5-27B 的指南。
Bonsai 是 PrismML 推出的紧凑型 1 比特语言模型系列,包含 1.7B、4B 和 8B 多种规格,用户可根据设备与性能需求选择合适的大小。
Bonsai 系列面向高效本地推理设计,支持 llama.cpp 及相关运行时。旗舰款 Bonsai 8B GGUF 模型相较典型的 FP16 8B 模型体积小得多,同时仍具备具有竞争力的能力。
1 比特模型通过将每个权重存储为单个位来工作,而非使用标准的全精度数值。在 Bonsai 的 Q1_0 格式中,值 0 映射为负缩放,值 1 映射为正缩放,并在每 128 个权重上共享一个 FP16 缩放因子。
这种方法大幅降低了内存占用,同时在推理中仍能保持模型的可用性与高效性。Bonsai 将 1 比特设计应用于嵌入、注意力投影、MLP 投影以及 LM head,实现端到端的 1 比特模型。
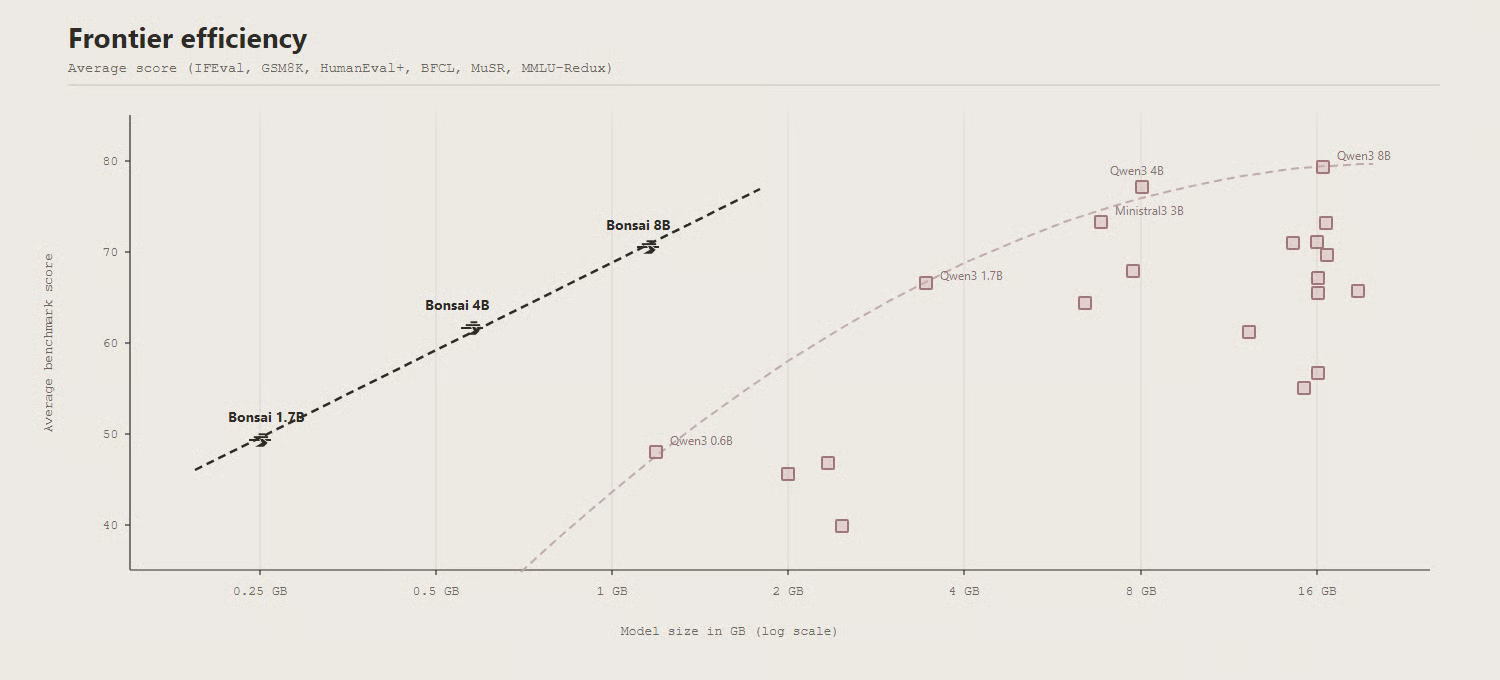
来源:prism-ml/Bonsai-8B-gguf · Hugging Face
在基准测试中,Bonsai 8B 显示出小得多的 1 比特模型仍可与 6B–9B 范围的全精度模型竞争。其模型卡报告在六个评测类别中的平均得分为 70.5,接近多款标准 8B 模型。这使得 Bonsai 不仅以体积和速度见长,同时也在性能上保持了扎实的表现。
在本教程中,我在一台较老的 Windows 笔记本上运行 Bonsai,配置为第 12 代英特尔处理器与 NVIDIA RTX 3070 GPU。Bonsai 8B 的一大优势是只需约 2 GB 的显存或系统内存即可运行,这让它对旧款笔记本和低内存系统也十分实用。
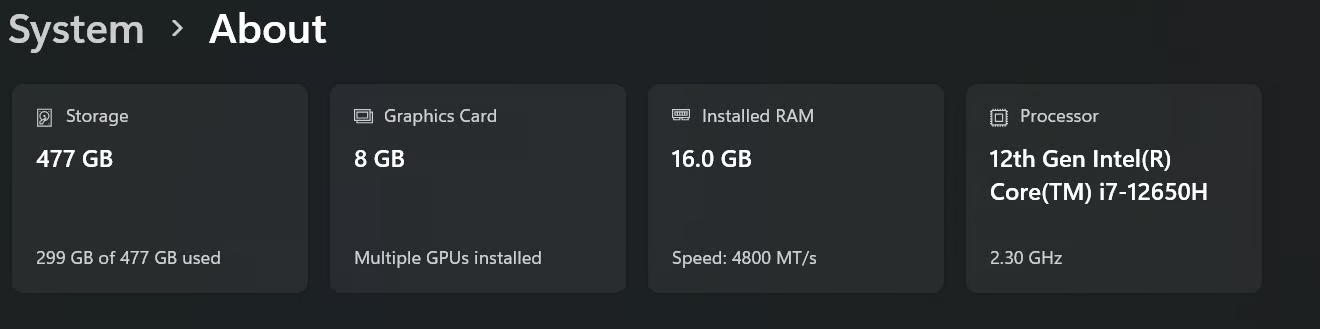
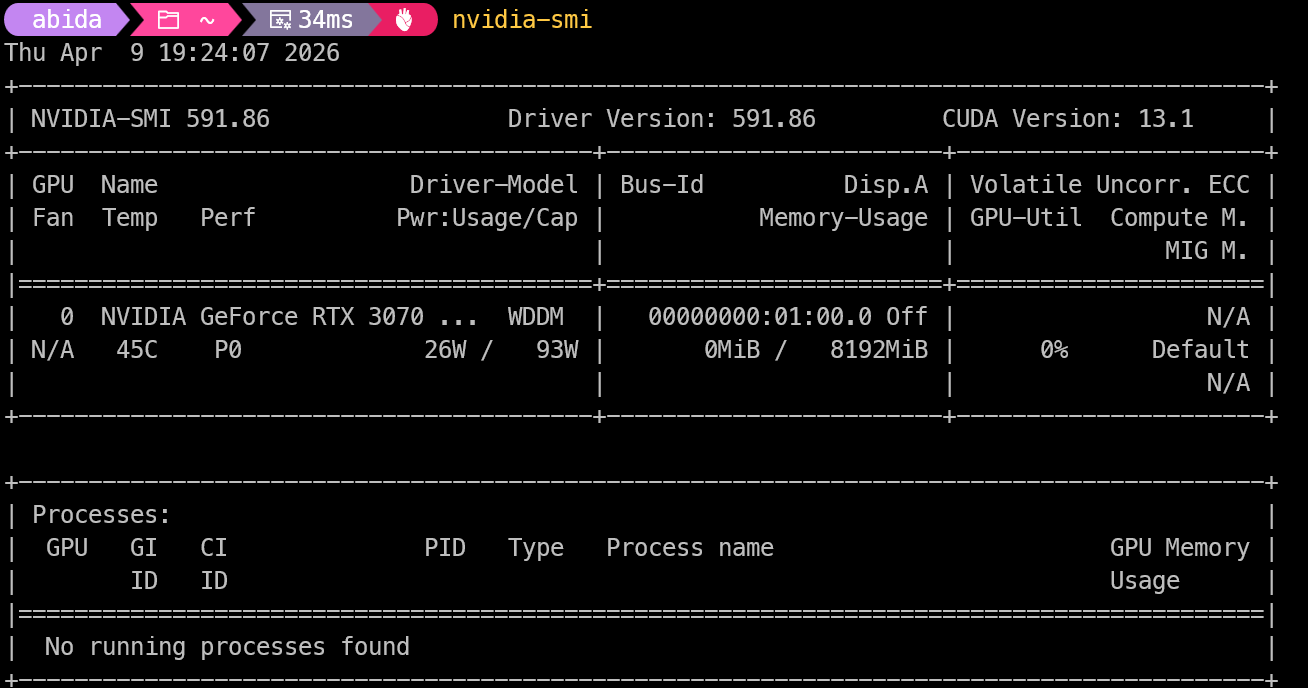
为获得更好的速度,建议安装最新的 NVIDIA 显卡驱动与 CUDA Toolkit,可在 NVIDIA 的官方下载页面获取。CUDA Toolkit 是 NVIDIA 官方的 GPU 加速应用开发环境。
安装完毕后,打开命令提示符或终端运行:
nvidia-smi该命令会显示您的 NVIDIA GPU、驱动版本与 CUDA 支持情况。如果正确列出了您的 GPU,说明系统已准备好在本地运行 Bonsai 时使用 GPU 加速。
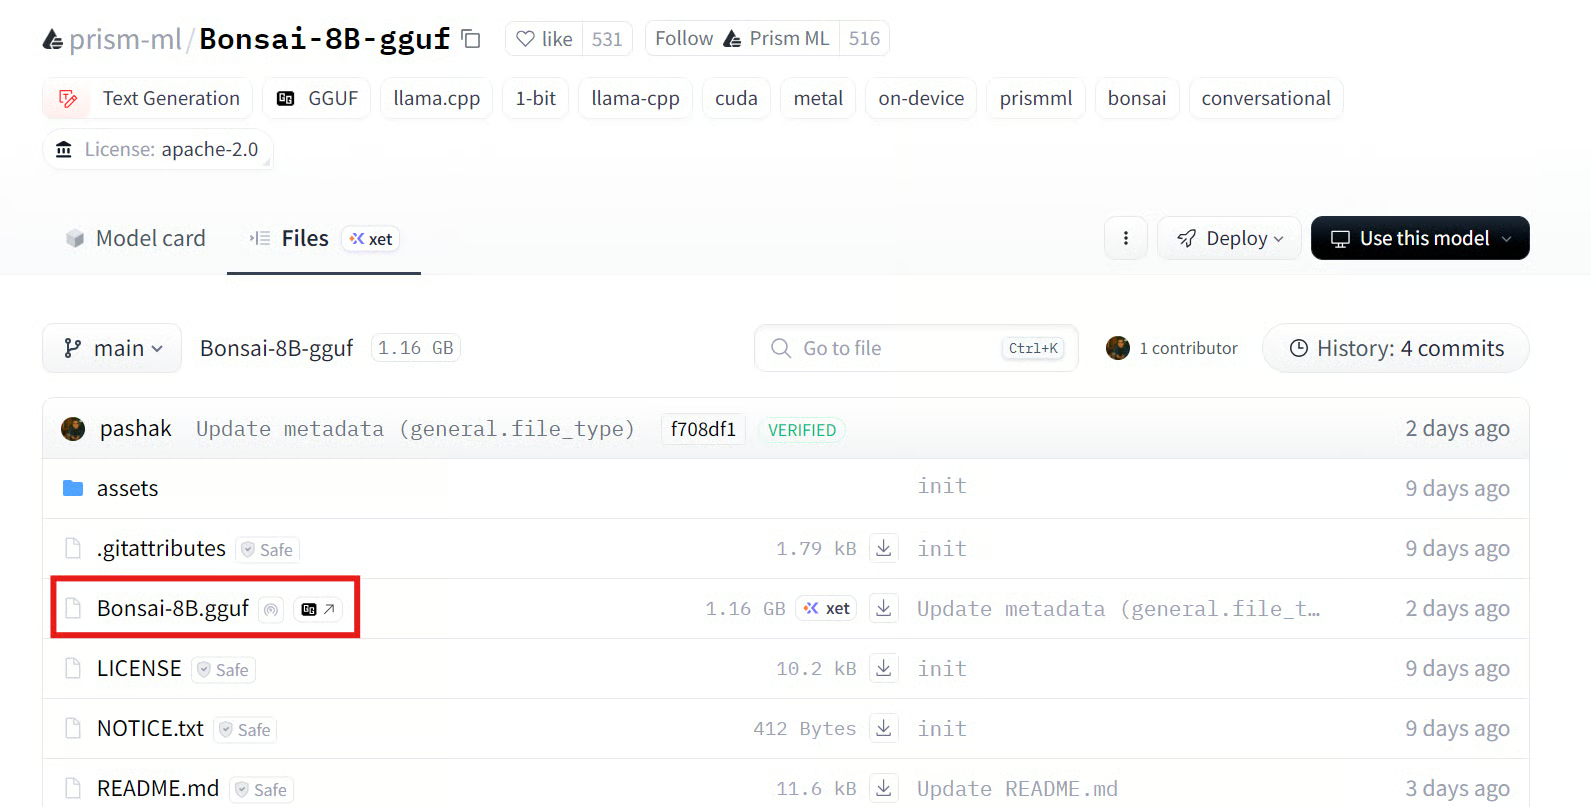
首先,前往 Bonsai 8B GGUF 存储库(在 Hugging Face 上),使用下载按钮直接获取 GGUF 模型文件。
然后,在您的系统上创建名为“Bonsai”的文件夹。在其中再创建一个名为“model”的文件夹,并将下载的 GGUF 文件放入该文件夹。
接着,打开 PrismML llama.cpp 发布页面,下载与您 CUDA 版本匹配的 Windows x64 预编译构建。按照本教程,您应下载 Windows x64(CUDA 13.1)文件及同一发布页中的 CUDA 13.1 DLL。
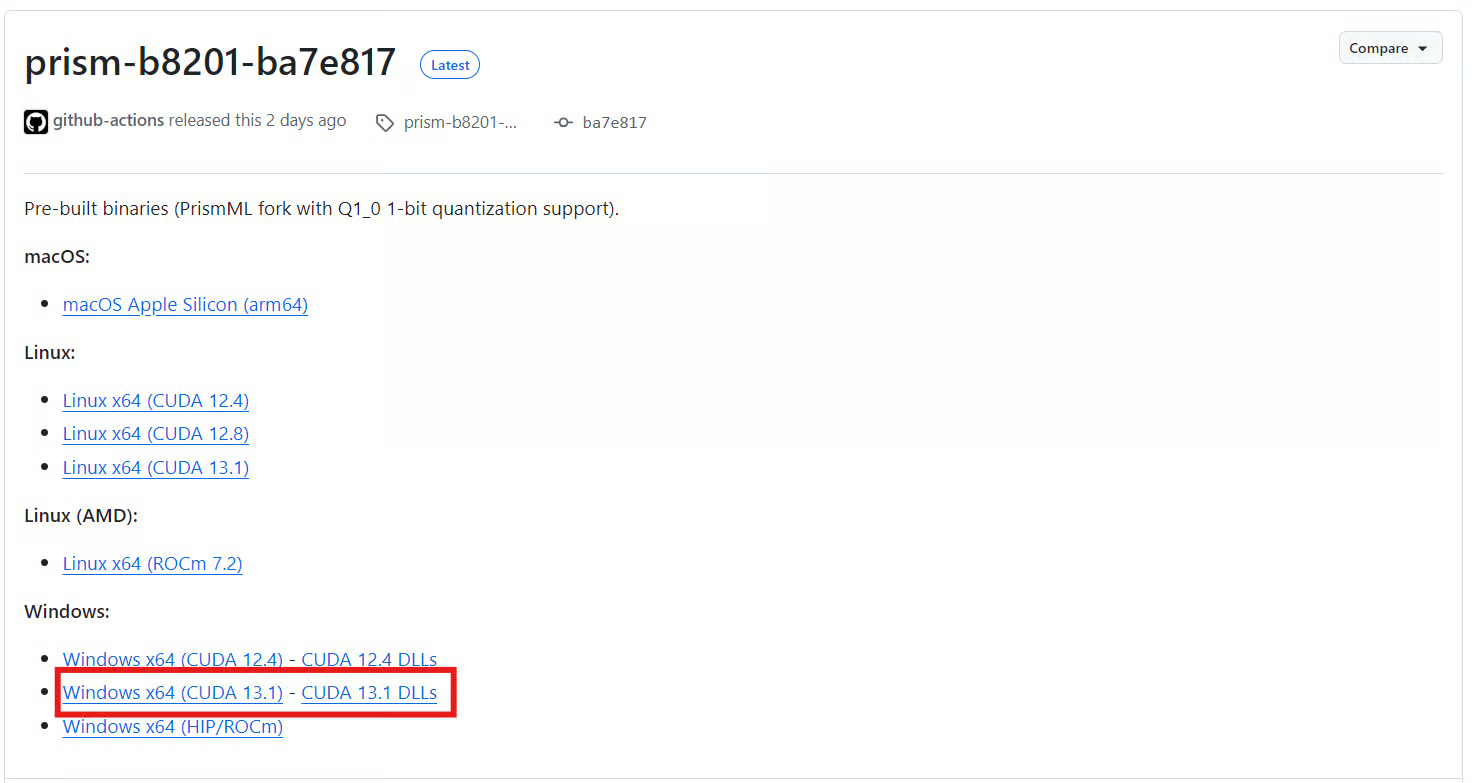
下载完两个 ZIP 文件后,将它们解压到先前创建的“Bonsai”文件夹内。
完成后,该文件夹应包含带有 Bonsai GGUF 文件的 model 目录,以及用于在命令行与本地服务器中运行模型所需的 llama.cpp 文件。
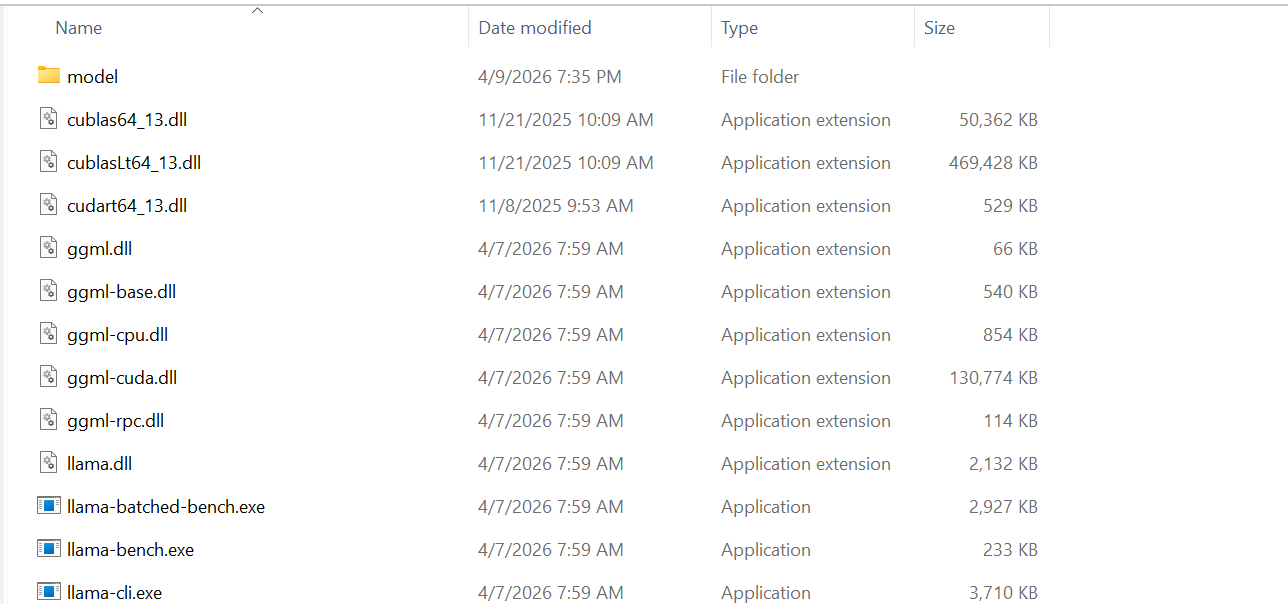
现在打开“Bonsai”文件夹,在空白区域单击右键,选择“在终端中打开”。这样您就可以直接从包含 llama.cpp 文件与“model”目录的文件夹中运行模型。
然后运行以下命令,用 llama-cli 测试 Bonsai:
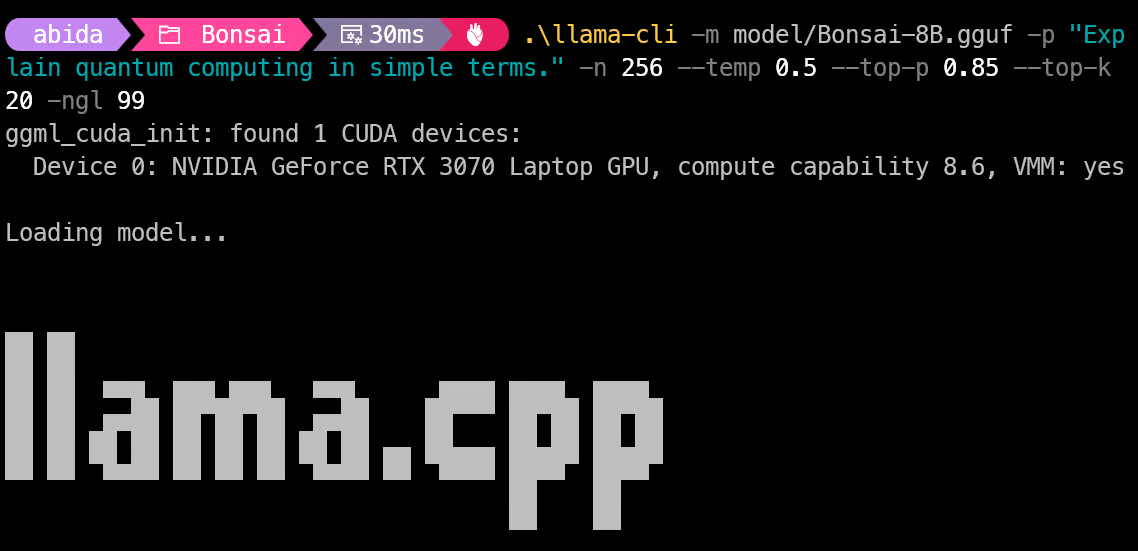
.\llama-cli -m model/Bonsai-8B.gguf -p "Explain quantum computing in simple terms." -n 256 --temp 0.5 --top-p 0.85 --top-k 20 -ngl 99该命令遵循官方 Bonsai 快速上手中推荐的提示与生成设置,包括 temperature 0.5、top-p 0.85、top-k 20,以及用于将层卸载到 GPU 的 -ngl 99。
在我的测试中,模型在不到一秒内加载进了 GPU 内存,响应既快速又准确。
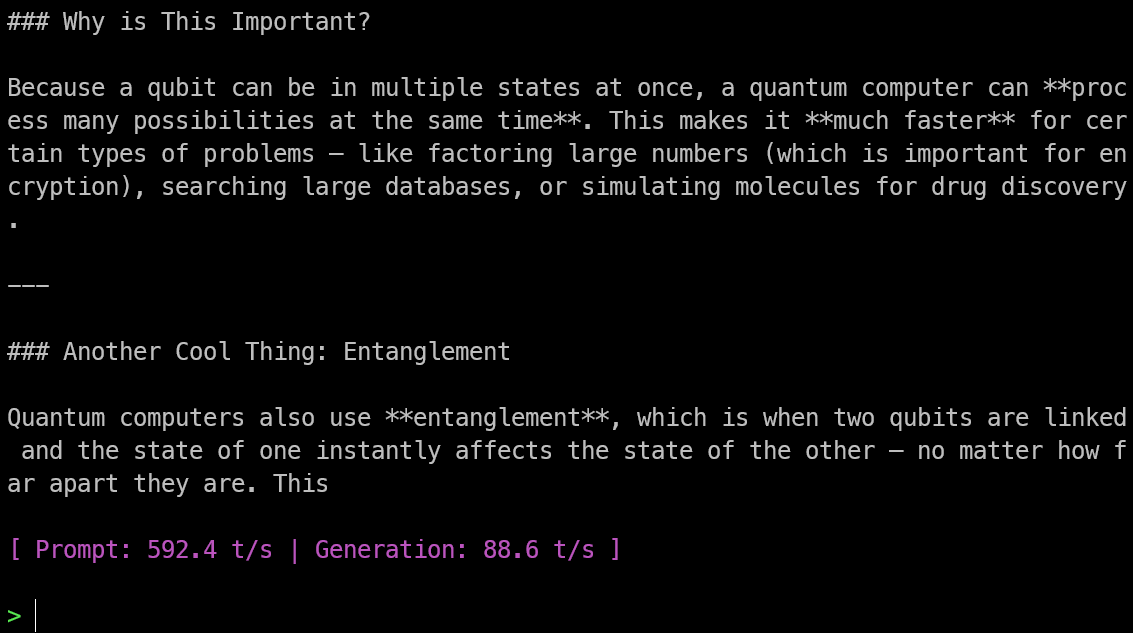
我还测得大约每秒 88.6 个 token,这对于在旧款笔记本上本地运行模型来说相当惊人。
在 CLI 中测试模型后,您可以使用 llama-server 将其作为本地推理服务器运行:
.\llama-server -m model/Bonsai-8B.gguf -ngl 99 --host 127.0.0.1 --port 8033这与官方 Bonsai 模型页面展示的本地服务器设置一致,PrismML 使用 llama-server 通过本地 HTTP 端点提供模型服务。
在我的测试中,模型在不到 5 秒内完成加载。
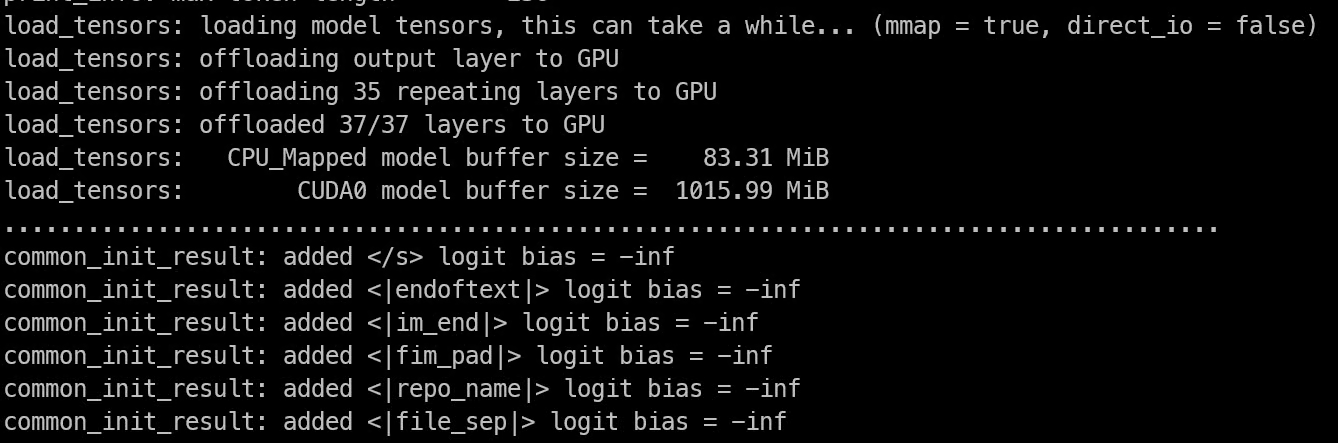
加载完成后,终端显示服务器运行在 127.0.0.1:8033,这意味着 Bonsai 现已可通过您机器上的本地 API 端点访问。
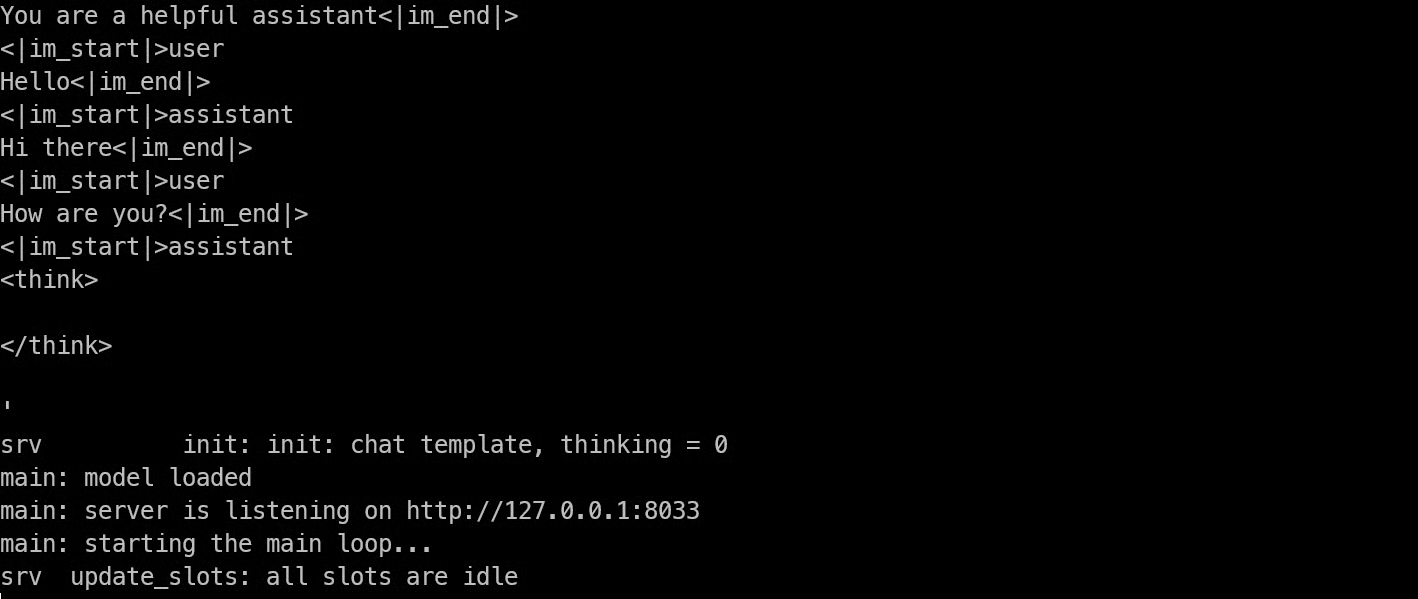
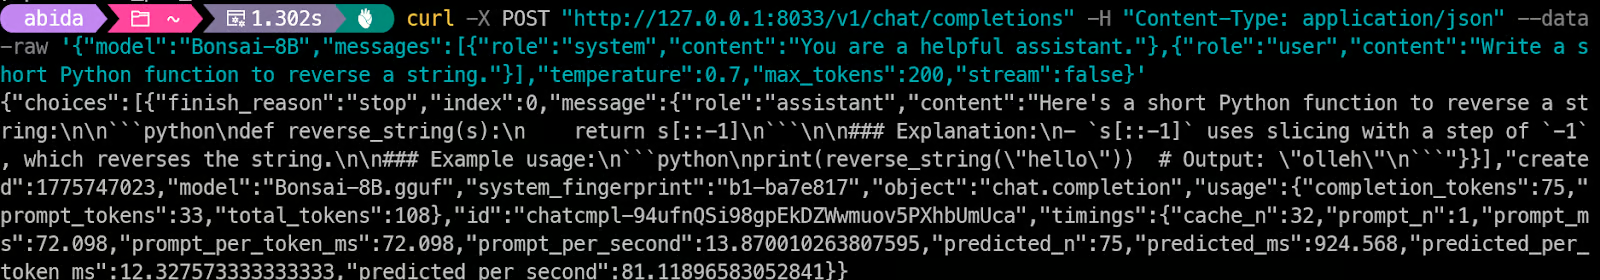
现在 Bonsai 服务器已在运行,下一步是用 curl 测试本地 API。llama-server 的端点与 OpenAI 兼容,因此您可以向 /v1/chat/completions 发送请求并获得常规的聊天补全响应。
在终端中运行以下命令:
curl -X POST "http://127.0.0.1:8033/v1/chat/completions" -H "Content-Type: application/json" --data-raw '{"model":"Bonsai-8B","messages":[{"role":"system","content":"You are a helpful assistant."},{"role":"user","content":"Write a short Python function to reverse a string."}],"temperature":0.7,"max_tokens":200,"stream":false}'如果一切正常,服务器将返回包含生成结果的 JSON 响应。
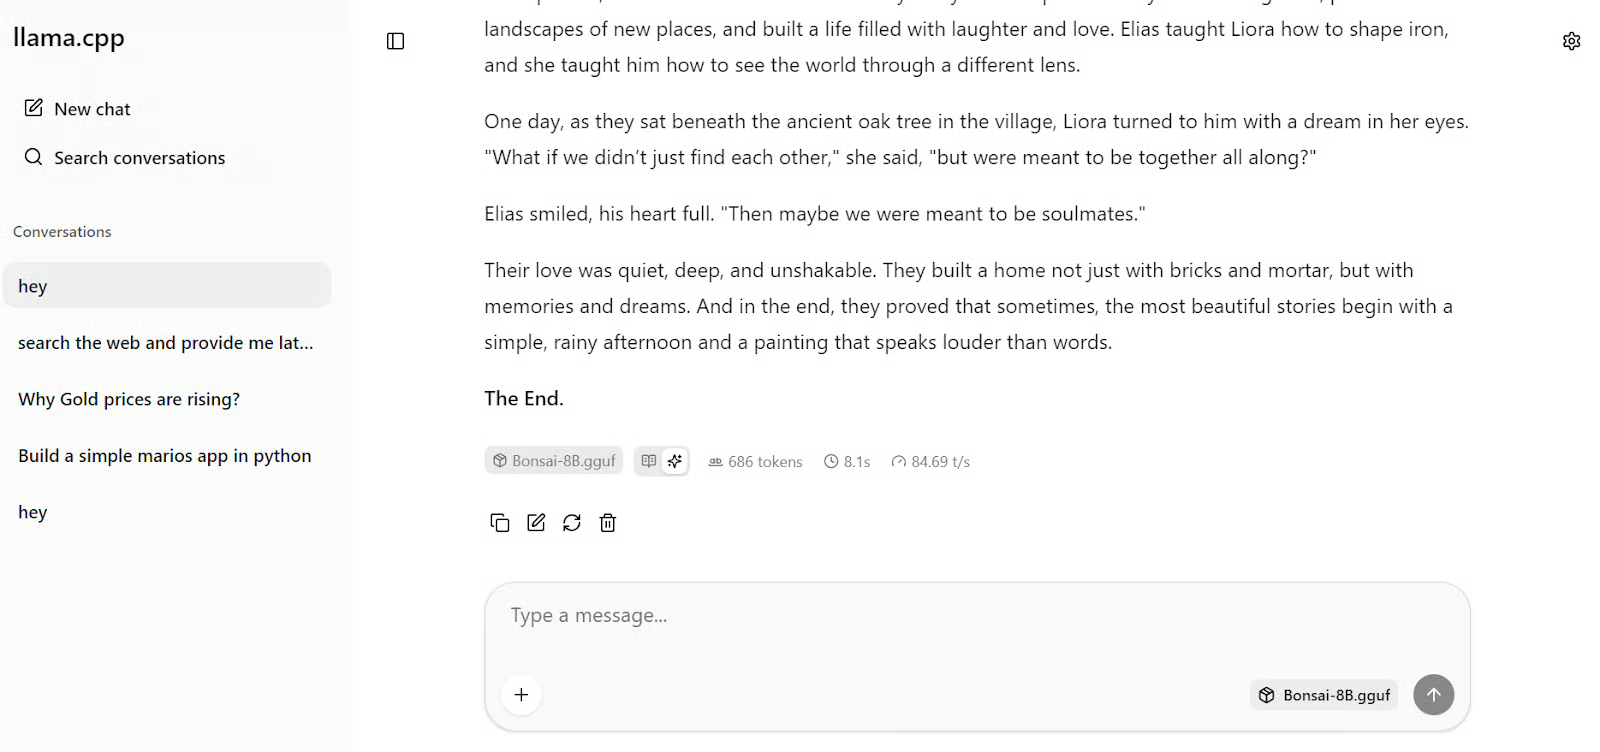
服务器启动后,在浏览器中打开 http://127.0.0.1:8033/。llama.cpp 服务器包含内置的 Web UI。
这为您提供了一个类似 ChatGPT 的简洁界面,用于测试本地运行的模型。就我而言,界面立即打开,我便能直接在浏览器中与 Bonsai 对话。
我先让它写一个故事,几秒钟内就返回了结果,速度约为每秒 85 个 token。
为了检验它处理真实编码任务的表现,我给出了如下提示:
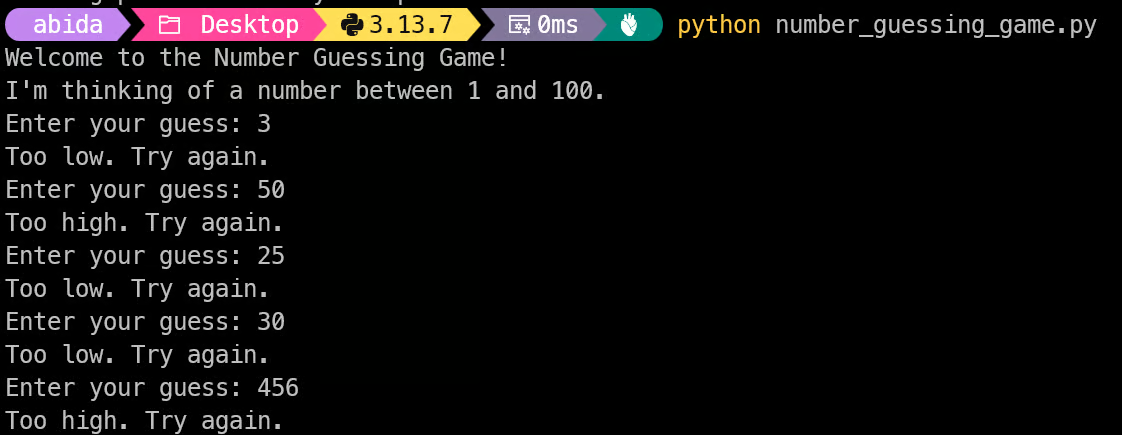
Write Python code to build a command-line number guessing game where the user guesses a randomly selected number, receives "too high" or "too low" hints after each guess, and sees the total number of attempts once they guess correctly.同样,响应很快。模型生成了代码,并附上了如何保存文件、用 Python 运行的简单说明。
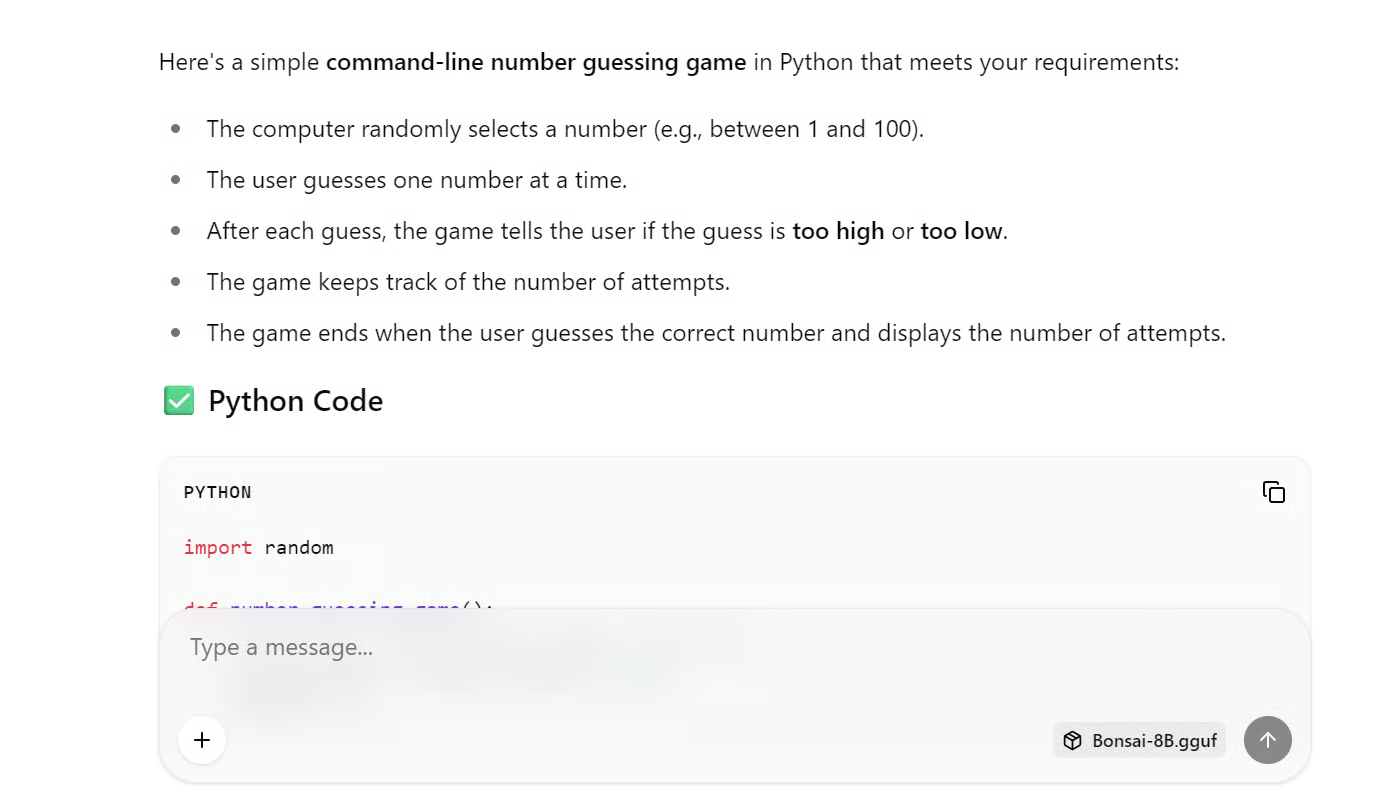
我将代码复制到一个 Python 文件中,在终端中运行,开箱即用,没有任何问题。
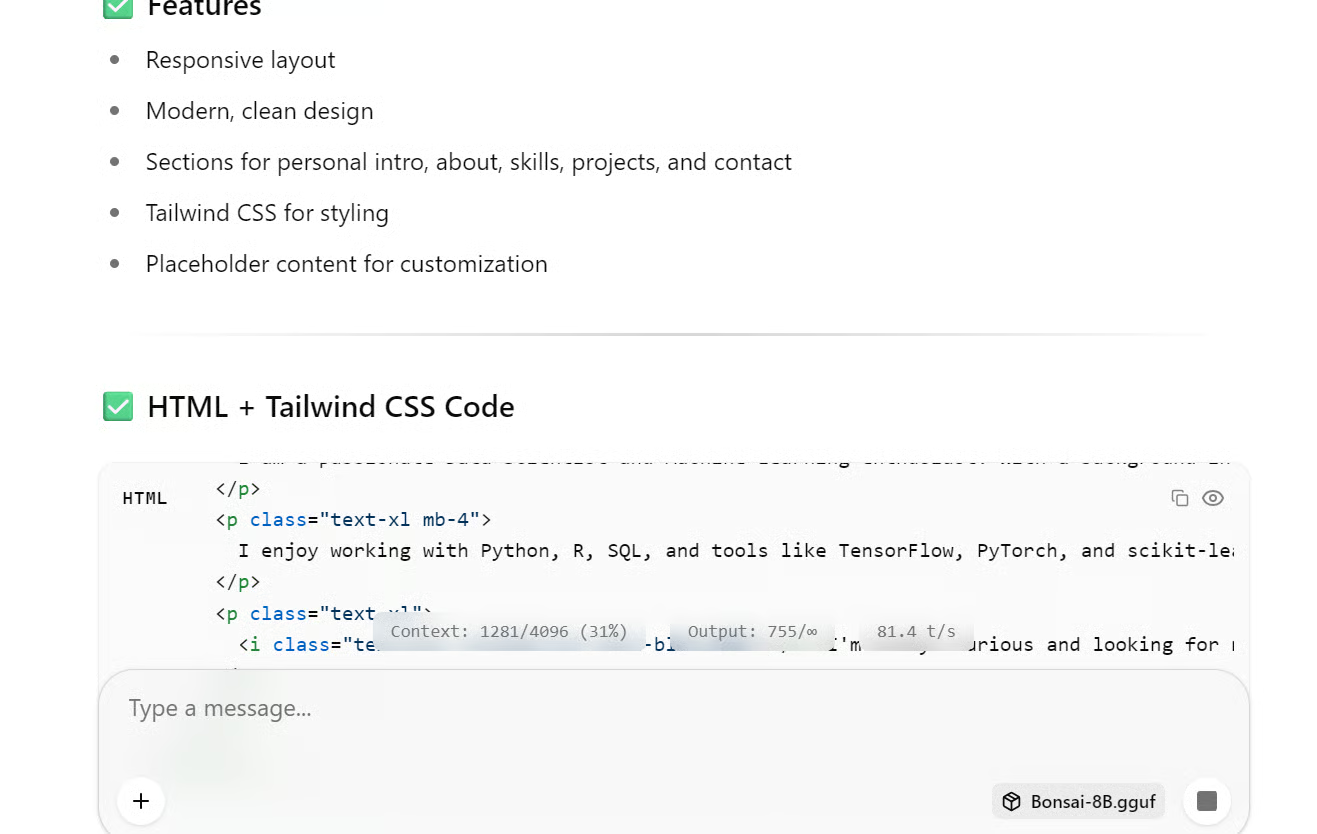
我还测试了第二个提示,看看它在前端生成方面的表现:
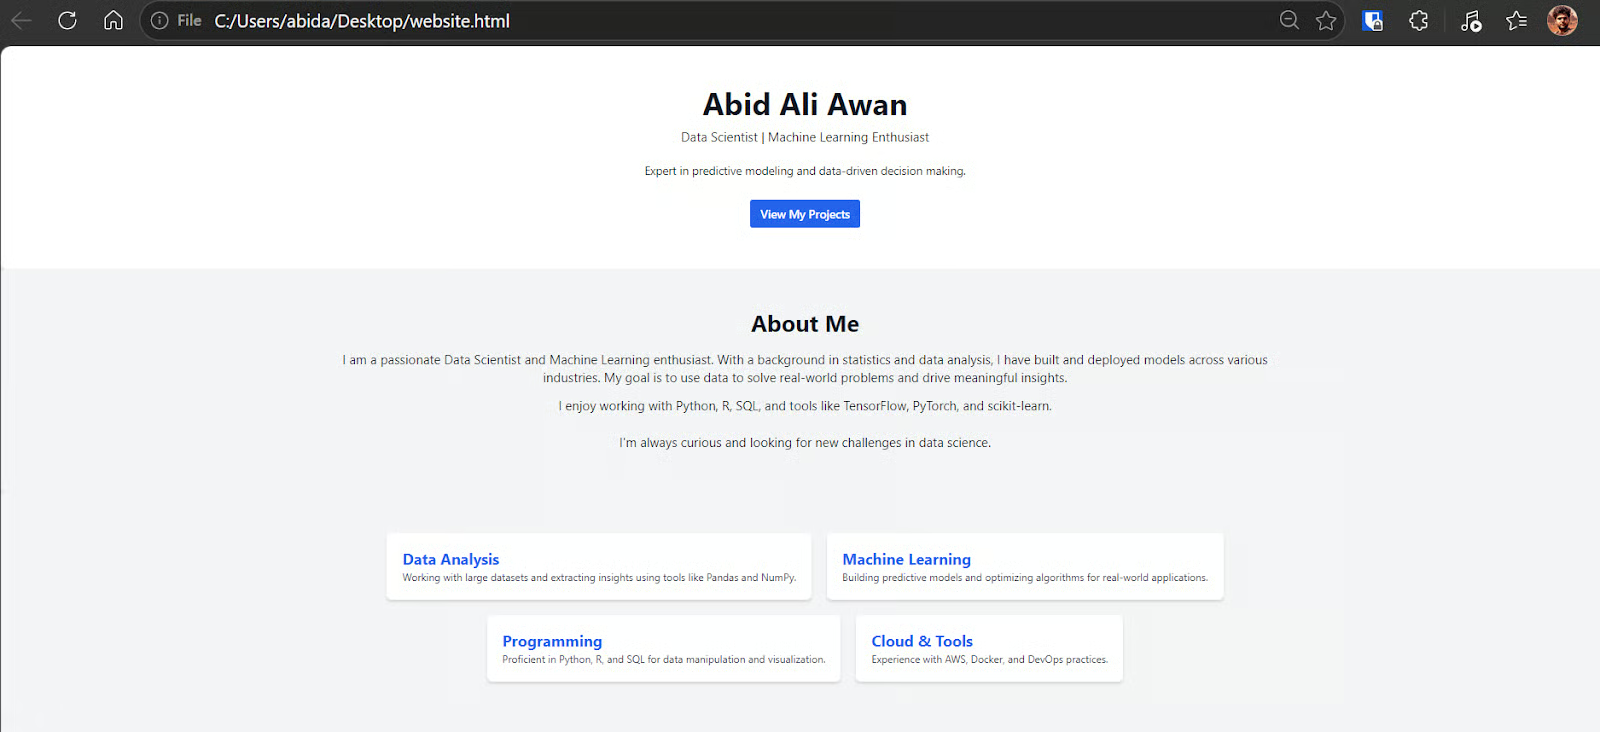
Create a simple, clean HTML personal profile website for Abid Ali Awan, a Data Scientist, with sections for a hero intro, about, skills, projects, and contact, using modern styling and placeholder content that can be customized later.响应依然很快。我将生成的代码复制到一个 HTML 文件中并在浏览器打开,页面正常渲染。
以这般小的模型体量,结果确实令人印象深刻。
Bonsai 最令我惊讶的是速度、体积与智能性的结合。我没想到如此小的模型,在一台老旧的 Windows 笔记本上也能如此快速且好用。
完整的安装过程也比我预期的简单得多。我只需从 Hugging Face 下载 GGUF 文件和 PrismML 的 llama.cpp 构建文件,把一切放到一个文件夹里,然后在终端中运行命令进行测试与本地服务部署。从零配置到实际使用,我花了不到两分钟。
llama.cpp 的 WebUI 让整个体验更易上手,尤其适合对本地 AI 部署或算力了解有限的用户。服务器跑起来后,我就能通过简单的浏览器界面测试提示、生成代码并尝试创作任务,无需任何额外工具。
我也很满意输出质量。以该体量的模型而言,Bonsai 在编码与创作方面的表现都出乎意料地好。它在 CLI、本地服务器与 WebUI 下都很快。但我认为,这样的小模型并不适合代理式编码或那些需要更深层推理与更长上下文处理的复杂任务。
尽管如此,如果您想本地运行模型,我认为 1 比特模型是非常有前景的方向。它们在效率与智能之间实现了良好平衡,并让日常硬件上的本地 AI 更加实用。我也很想接下来尝试更大的 1 比特模型,规模更接近 Qwen3.5-27B 的范围,因为那或许能在速度、内存占用与能力之间带来更佳的平衡。
LLM 课程
{count, plural, other {课程}}
{count, plural, other {课程}}
{count, plural, other {课程}}