2026 年 10 月,Google DeepMind 在全栈层面密集发版。Gemini 4 Argon 于 10 月 13 日全面开放,10 月 27 日团队又发布了 Genie 4,这是一款可生成可步行、可用文本操控、并可实时收听的环境的新型世界模型。
Genie 4 原生多模态,可在画面的同时生成环境声、音乐和交互式对话。它基于 Gemini 家族构建:Gemini Omni 决定外观与行为基调,Gemini 3.8 Flash 作为引导代理,确保多步事件保持连贯。
它将先以研究预览形式向受信任的测试者发布;随后,Project Genie 中的 Google AI Ultra 订阅用户与 Gemini API 和 Google AI Studio 的早期访问合作伙伴将陆续获得使用权限。
本文将梳理 Genie 4 的全部新内容,包括 DeepMind 展示的能力、受信任测试者的反馈、Google 公开承认的限制,以及如何获取访问权限。您也可以查看我们的 Gemini 4 Argon 与 Claude Opus 5.5 对比 和 GPT-6.1 Terra 指南。
摘要
- Genie 4 是 DeepMind 的新世界模型,也是 Genie 系列中首个原生生成音频的版本。
- 最大变化在于“人”:角色能移动、响应,并在您操控场景时进行交互式对话。
- 由 Gemini 负责规划。Gemini 3.8 Flash 监看输入帧,确保多步事件按轨道推进。
- Google 之外无人评估:尚无公开基准、定价或 API 模型 ID。
- 物体恒存性与可读文字仍是弱项,DeepMind 在发布中也坦承这一点。
- 若您从事预演、游戏原型或机器人仿真,值得加入候补名单;但暂不适合据此规划生产管线。
什么是 Genie 4?
Genie 4 是 Google DeepMind 于 2026 年 10 月 27 日发布的新世界模型,是 Genie 3 的继任者。世界模型逐帧生成一个可交互的环境,而非渲染一段固定视频,因此键盘输入与文本提示会改变接下来的发展。
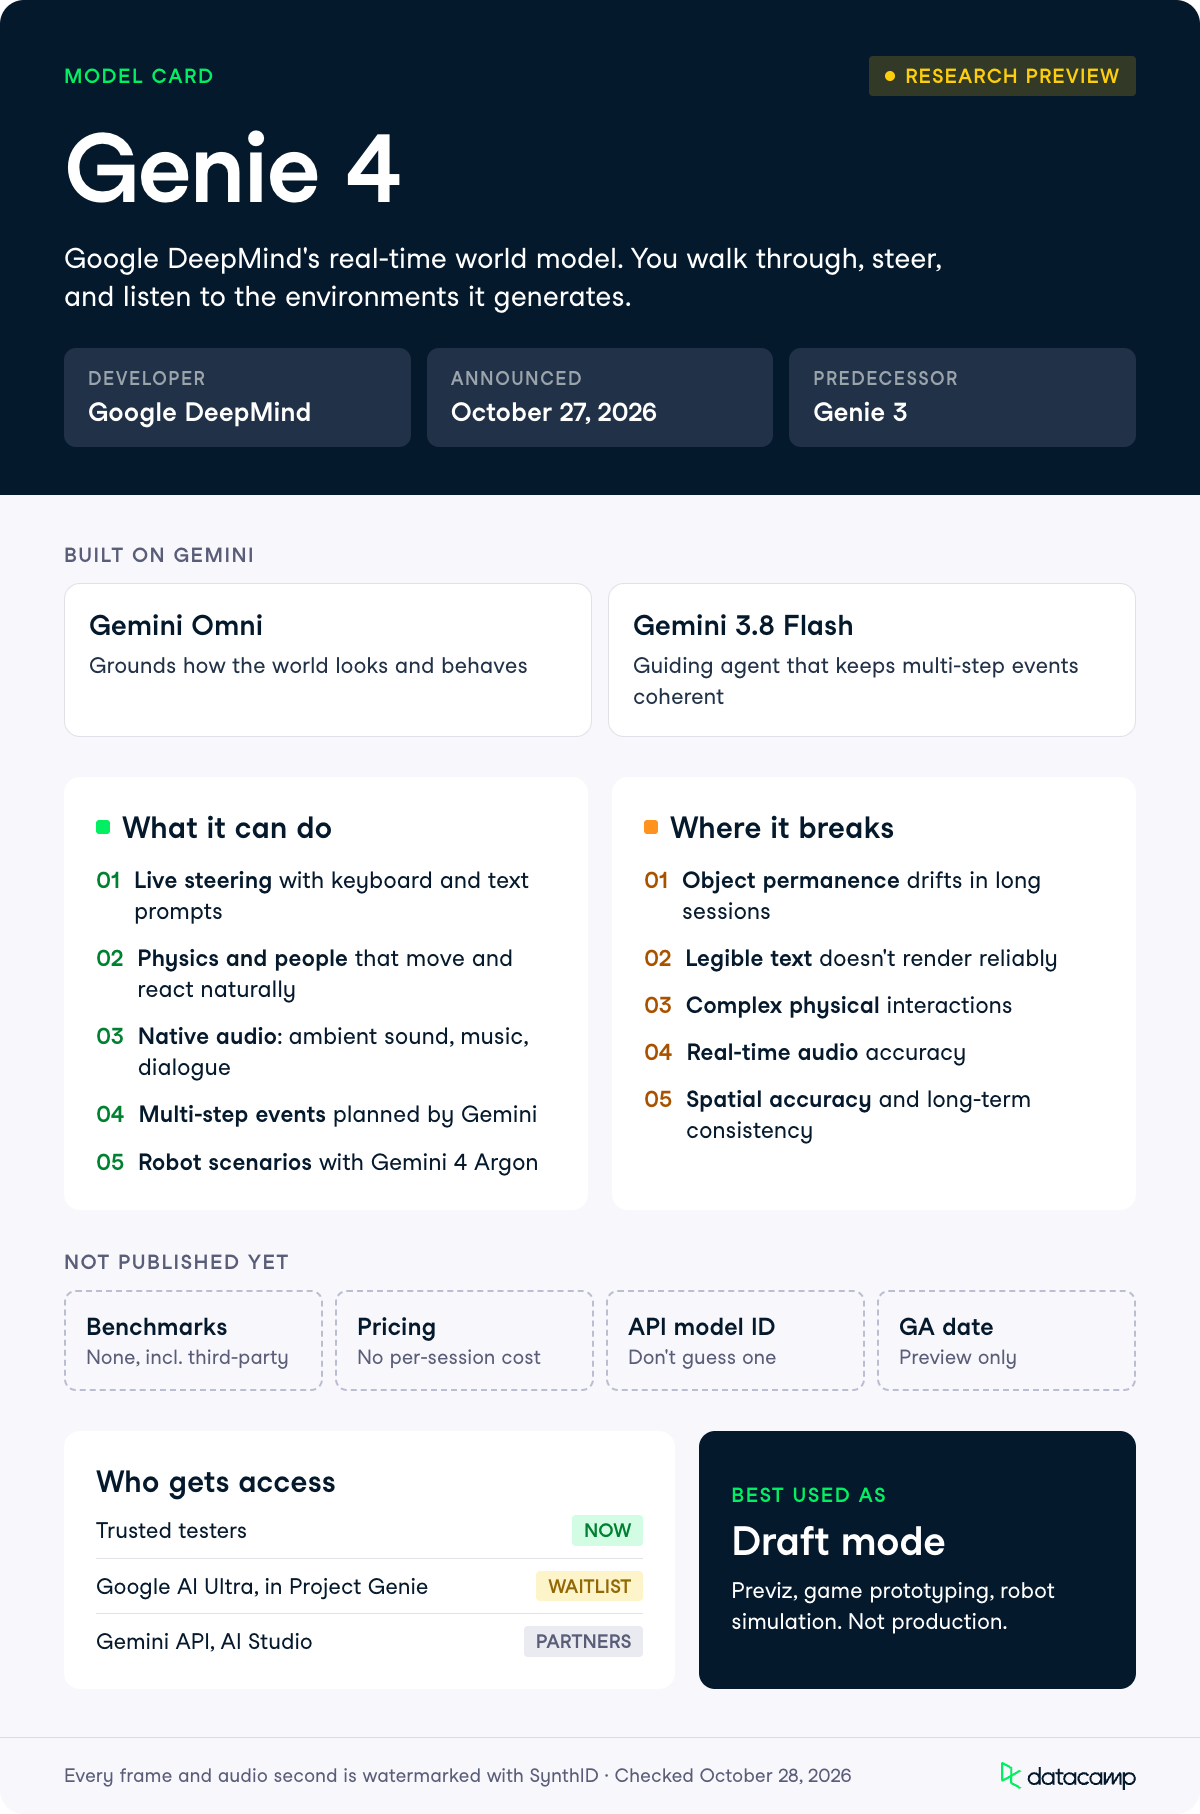
该模型并非独立存在,而是借力于 Gemini 家族。
Gemini Omni 让模拟贴近真实世界的外观与行为,其它 Gemini 模型提供推理,维系场景在运行中的一致性。
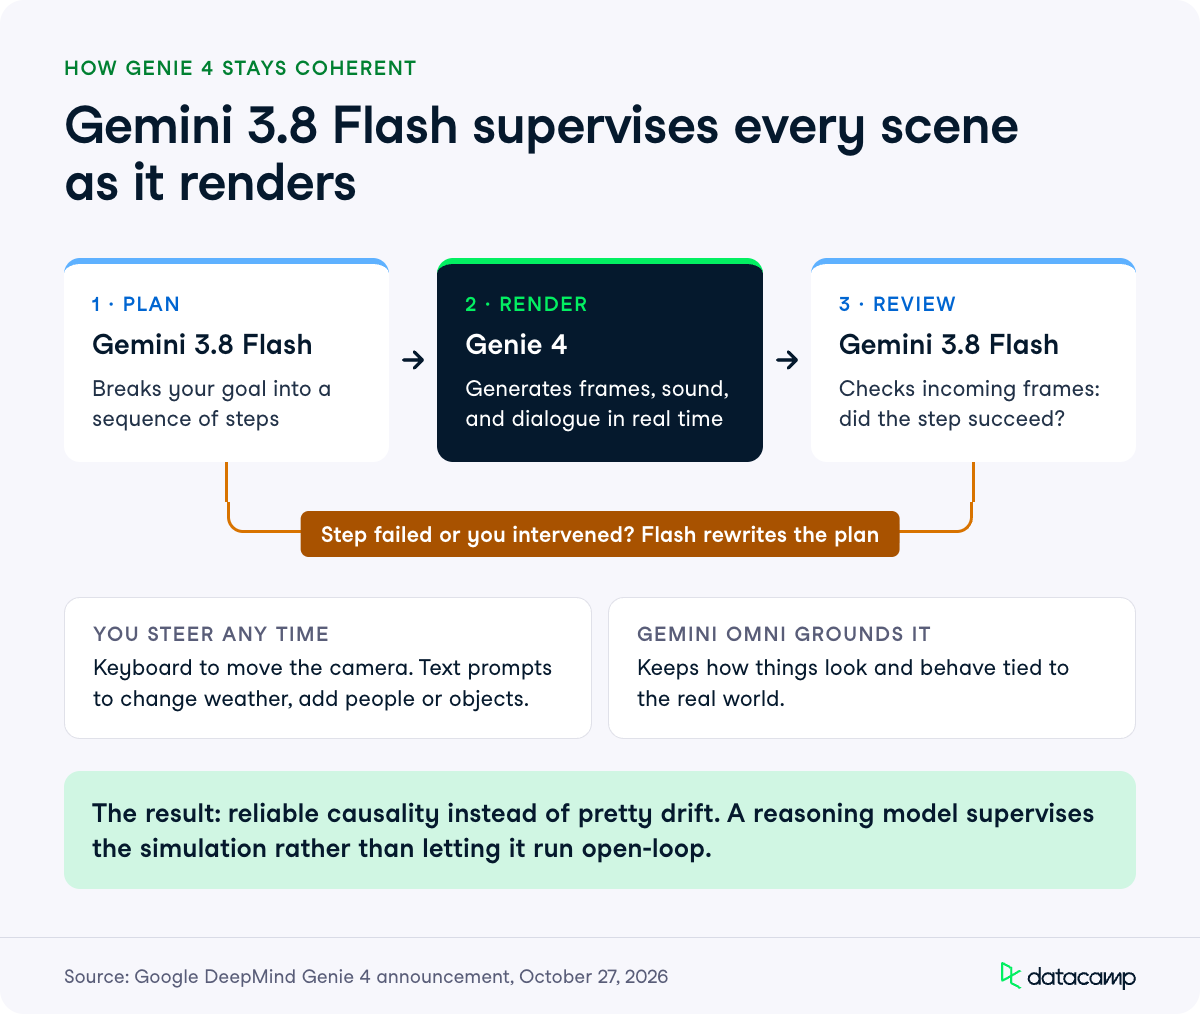
在演示中,用户用标准键位控制进行导航与移动镜头,同时通过输入提示在会话中途重塑世界。
由 Gemini 规划的多步事件
在 Genie 4 渲染时,Gemini 3.8 Flash 以引导代理的形式运行在循环中。它将目标拆解为一系列步骤,审阅输入帧以核验每步是否真正完成,并在世界变化或您介入时重写计划。
这一循环赋予场景可靠的因果性与过程化行为,而非仅有华丽的“漂移”。这也是本次发布中最接近技术差异化的部分,因为模拟在推理模型的监督下运行,而不是放任开环。
 结合 Gemini 4 Argon 的机器人情景生成
DeepMind 将 Genie 4 与 Gemini 4 Argon 及 Gemini Robotics 配套使用。Argon 会将用户指示的任务分解为步骤,并在 Genie 4 渲染过程中以文字标题交错进场景,使世界随任务推进而自适应。公开示例是 Apptronik 的 Apollo 人形机器人下棋。
对机器人团队而言,吸引力在于无需手工搭建每个环境即可生成大量情景。但需注意这些都是想象世界,发布中并未量化在 Genie 4 场景中学到的行为能多大程度迁移到真实硬件。
Genie 4 的基准表现如何?
没有,至少未公开。Google 的发布没有基准表、没有分数,也没有与其他世界模型的对比。截至 2026 年 10 月 28 日,公开报道中也未见第三方测评、独立评估或基准复现。以下各项能力陈述均可追溯至 DeepMind 自己的演示与其内部测试者。
Google 用什么替代了分数
证据是实时交互的录屏,用户用键盘导航并输入提示,在场景演化时进行修改。DeepMind 在 X 上的贴文(撰写时观看量 27.69 万)列出了五项主张:来自 Gemini Omni 的照片级真实感、先进物理、实时操控、原生音频,以及借助 Gemini 的推理实现多步连贯。
演示短片是精选片段,宜将其视为能力上限。但提示词本身值得研究:它们较长,分为环境部分与角色部分,并包含大量负面约束,如“不要 CGI 质感”“不要空旷的平台”。
受信任测试者的反馈
预览前,DeepMind 在创意产业、新闻、教育、游戏与工程等领域组织了测试群体。他们给出的四类用例足够具体:
- 创意指导:电影人走进场景的实时模拟,现场多次走拍并随时调整机位、光线、对话与动作。
- 历史情景与沉浸式照片:图片记者将一张二维档案照片在数秒内变成该环境的扎实模拟,或可视化山洪与野火的演进。
- 交互体验概念设计:游戏开发者在编写引擎代码前,从想法快速到可探索的原型。
- 仿真:企业伙伴在机器人以外的场景,评估其用于快速从零到一的情景生成。
反馈中反复出现的词是“草稿模式”,我认为这也是对本次发布最诚实的定位。
Genie 4 在哪里会出错
DeepMind 难得直言其失败模式,这点可取。随着会话变长、复杂提示编辑次数增多,或您在场景中穿行时,视觉细节与物体恒存性会发生变化或漂移。
点名的开放问题包括:复杂物理交互、实时音频准确性、可读文字渲染、空间准确性以及长期一致性。最后一点是实际天花板:若一个世界无法在长会话中稳住自身物体的位置,您就只能用它做原型,而非用于正式拍摄。
走向何处:混合式世界模型
DeepMind 表示下一步是混合式世界模型,将代码与语言模型的结构化推理与像素级模拟相结合。由 Gemini 映射结构并规划叙事时间线,Genie 则负责世界的视觉、声音与响应。
本次发布中的 Gemini 3.8 Flash 循环,就是这种分工的初版。若其有效,正好针对 DeepMind 自认的痛点:长会话连贯性——这不是单靠像素逼真度能解决的。
Genie 4 的定价与可用性
Genie 4 尚未公布价格。Google 未发布按 token 或按会话的费用、未给出 API 标识符,也未设定全面开放日期。它仍是研究预览。
分阶段推出:受信任测试者已可使用,接下来是 Project Genie 中的 Google AI Ultra 订阅用户,随后是通过 Gemini API 与 Google AI Studio 接入的早期访问合作伙伴。Project Genie 的候补名单向所有人开放。
供参考,Google 在其他前沿文本模型上的定价:Gemini 4 Argon 通过 2026 年 11 月 30 日的优惠价为每百万输入 token 2 美元、每百万输出 token 10 美元,12 月 1 日起分别升至 4 美元与 20 美元。这并不能推断交互式世界模型会话的费用,Google 也未说明。
在第三方平台上,截至 2026 年 10 月 28 日,Genie 4 未在 OpenRouter 上架,也未收录于 OpenCode 目录(models.dev)。其生成的所有视频帧与音频秒数都带有 SynthID(Google 的不可感知水印),且 DeepMind 在开放预览前已进行内部安全评估。
| 平台 | Genie 4 状态(检查于 2026 年 10 月 28 日) |
|---|---|
| Project Genie(Google AI Ultra) | 即将推出,候补开放 |
| Gemini API 与 Google AI Studio | 仅限早期访问合作伙伴 |
| OpenRouter | 目录未收录 |
| OpenCode 目录(models.dev) | 目录未收录 |
用户对“排队门槛”颇有微词。在 DeepMind 于 X 的发布贴回复中,最高票的抱怨是:一年过去 Genie 3 仍未覆盖所有 Pro 订阅用户——当新一代又以候补名单的形式到来,这确实是个可以质疑的点。
如何获取 Genie 4 的访问权限?
目前通往 Genie 4 的门有三扇,其中两扇由 Google 掌控:
- 受信任测试者群组:已关闭;DeepMind 之前从新闻、游戏、教育与工程等领域收集反馈的对象。
- 面向 Google AI Ultra 订阅的 Project Genie:即将上线,您今天即可加入公开候补名单。
- Gemini API 与 Google AI Studio:仅限早期访问合作伙伴,未公布模型标识符。
不建议猜测 API 字符串。Google 尚未发布 Genie 4 的模型 ID,靠营销名去推断只会让您的客户端代码撞上 404,因此目前没有值得打印的代码片段。
在拿到访问前,您可以先熟悉提示词格式,因为它并不随意。演示提示会将环境与角色分开描述,明确指定相机行为,并在结尾罗列负面约束(“不要第三人称视角”“不要航拍镜头”“不要 3D 渲染质感”)。DeepMind 的 Genie 提示词指南是起点,我们的 Gemini 4 Argon 文章也介绍了这些场景背后的规划模型。
Genie 4 提示词的实际结构
演示中的提示词遵循一个值得借鉴的模式:用环境提示固定场景设定,用独立的角色提示固定主体与相机关系,然后给出一组负面约束。某个热气球示例明确了第一人称视角,机位在藤编吊篮内,画面右侧可见镶皮边沿,随后再描述下方的南极冰盖。
负面约束承担了大部分约束力。提示一再排除“游戏画风”“航拍镜头”“越肩视角”“空旷平台”,这也暗示了当提示留白时,Genie 4 的默认回落倾向。
结语
Genie 4 最清晰地表明,DeepMind 将“模拟”(而非仅仅文本)视为通往通用智能的路径,并据此投入前沿产能。同月内,OpenAI 将 GPT-6.1 Terra 面向低成本、高频的日常任务,Google 则发布了面向智能体的旗舰 Gemini 4 Argon,以及支撑其机器人研究的世界模型。
值得切换过去吗?当前无从切换:没有价格、没有模型 ID、没有适用于大众的 API。若您从事预演、游戏原型或机器人仿真,建议加入 Project Genie 候补,并将预期维持在“草稿质量”——这正是 DeepMind 自家测试者的定位。
若想快速了解支撑 Genie 4 推理的 Gemini 系列,建议从我们的 AI 基础技能路径开始。