
测试 Grok 4
我经常测试新模型,通常会复用一些标准任务来横向比较。本次也不例外,重点放在数学与编程上。这并非对 Grok 的全面评估——只是帮助了解它在典型对话设置下的行为方式。
数学
我想先做一道简单的计算:9.11 - 9.9。您可能觉得这有点可笑,但它常常会难倒语言模型——例如,Claude Sonnet 4 就答错过。显然我可以直接用计算器,但目的是观察模型如何处理问题,是否会在需要时借助工具,或是直接通过链式思维解出答案。
来看 Grok 4 的回答:
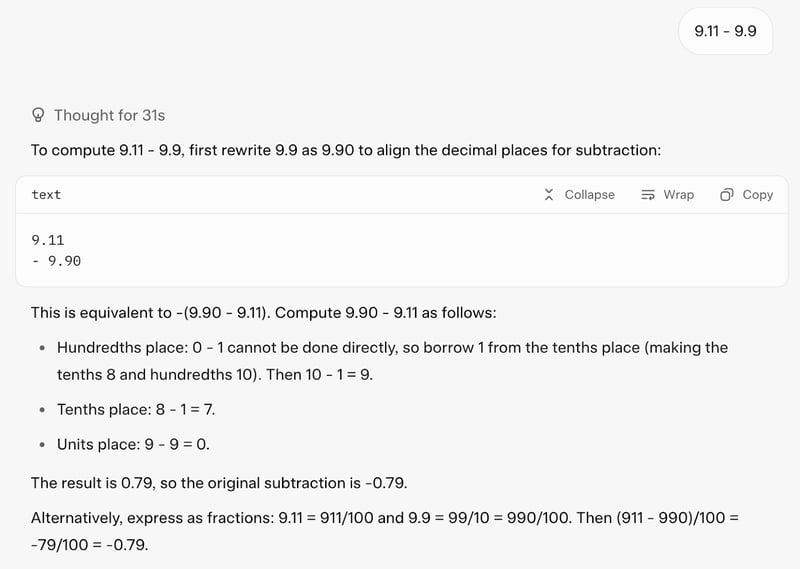
它在第一次尝试就答对了。先用链式思维推导出答案,又调用了代码工具进行验证(很棒!)。
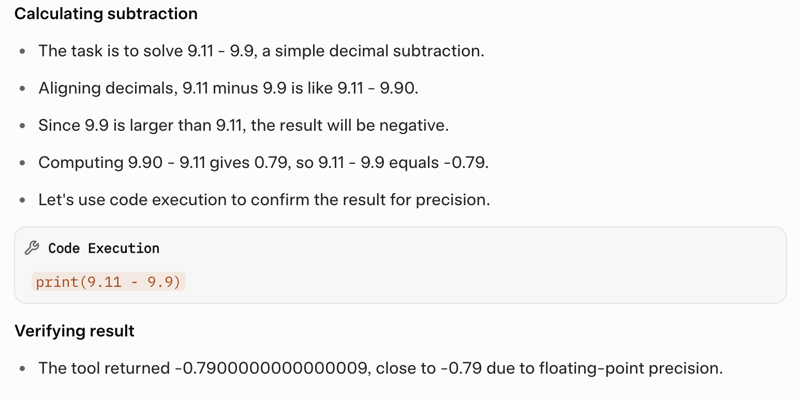
不过,它用了 31 秒才响应,对于如此简单的提示,输出也过于冗长。
接下来,我想让 Grok 4 试试更复杂、且通常会推到模型上下文极限的数学问题:
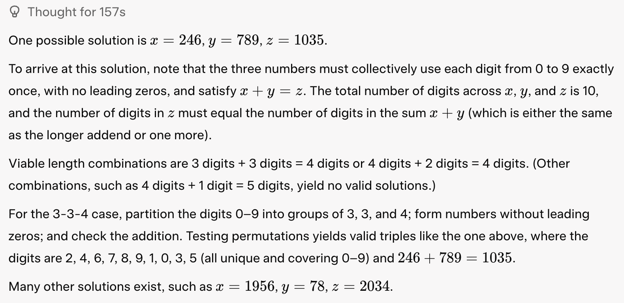
提示: 使用 0 到 9 的所有数字且各用一次,构造三个数 x、y、z,使得 x + y = z。
Grok 4 的切入很聪明。它首先意识到可以用 Python 在几秒内生成 0–9 的 3,628,800 种全排列。随后尝试了两个三位数相加得到一个四位数的设定,并写出代码跑出了 96 个有效解!
from itertools import permutations
digits = range(10)
solutions = []
for p in permutations(digits):
x_digits = p[0:3]
if x_digits[0] == 0: continue
y_digits = p[3:6]
if y_digits[0] == 0: continue
z_digits = p[6:10]
if z_digits[0] == 0: continue
x = int(''.join(map(str, x_digits)))
y = int(''.join(map(str, y_digits)))
z = int(''.join(map(str, z_digits)))
if x + y == z:
solutions.append((x, y, z))
print(solutions)之后,它又用同样思路尝试了其他组合(如四位数加两位数等于四位数)。最后,它还在网上搜索这道数学谜题的信息以确认答案。总计用时 157 秒,给出了如下答案:
编程
在编程任务上,我想看看它与 Gemini 2.5 Pro 和 Claude Opus 4 的对比:
提示: 做一个吸引人的无尽奔跑小游戏。屏幕上给出关键指令。使用 p5.js 场景,不要 HTML。我喜欢像素风恐龙和有趣的背景。
结果如下:
主要问题在于游戏会立即开始,没有给用户自主开始的机会。像素风恐龙也略显粗糙。话虽如此,屏幕指令清晰,基本功能正常。我把这些反馈给了 Grok,以下是第二版:
相当不错!
长上下文多模态
最后,我想看看 Grok 4 处理长上下文多模态任务的能力。我上传了一份欧盟委员会的生成式 AI 展望报告(43,087 个 token),并让 Grok:
提示: 通读整份报告,找出三张信息量最大的图表。分别总结,并告诉我它们在 PDF 的第几页。
先看答案,再来拆解:
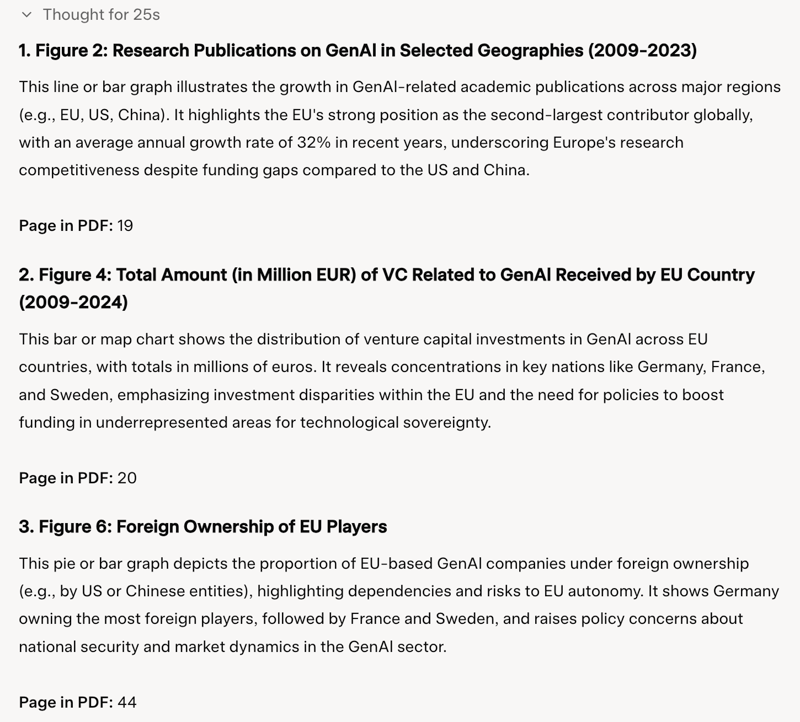
我注意到它意外地很快就停下了,仅用 25 秒。它推荐了第 19、20 和 44 页(均不正确)的图表,似乎在找到“看起来足够”的答案后就忽略了其余 167 页的内容。链式思维显得不完整,处理方式偏浅:
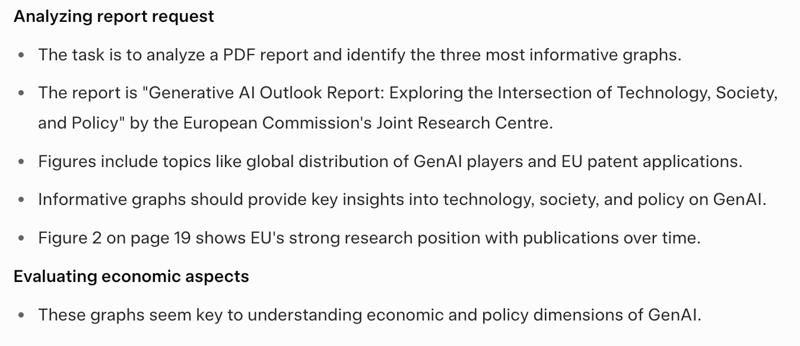
来看结果:
- 页码全错。
- 无法清晰识别图表类型——会说“这是一张折线或柱状图”。
- 答案偏向前 50 页,很可能跳过了报告后半部分的重要章节。
- 将桑基图(图 6)误判为“饼图或柱状图”。
- 把图 6 误当作图 7,最终分析了图 7。
正如埃隆·马斯克在直播中所说,Grok 4 的图像理解与生成仍不算先进。若您需要稳定可靠的结果,可以说当前的 Grok 4 实质上还是一款“文本优先”的模型。
Grok 4 基准测试
Grok 4 的最大看点是其在从学术考试到商业模拟等多种基准上的表现。根据 xAI 的说法,相比前代的显著提升主要得益于更大的算力——既包括训练阶段,也包括推理阶段——而非架构上的重大突破。
“人类最后的考试”(HLE)
支撑 Grok 4 表现的核心规律是“扩展性”。它在训练算力增加时受益明显,更有意思的是在测试时算力提升时也会受益。通俗讲:给它投入的资源越多,表现越好。这在其HLE 任务上的表现尤为明显。
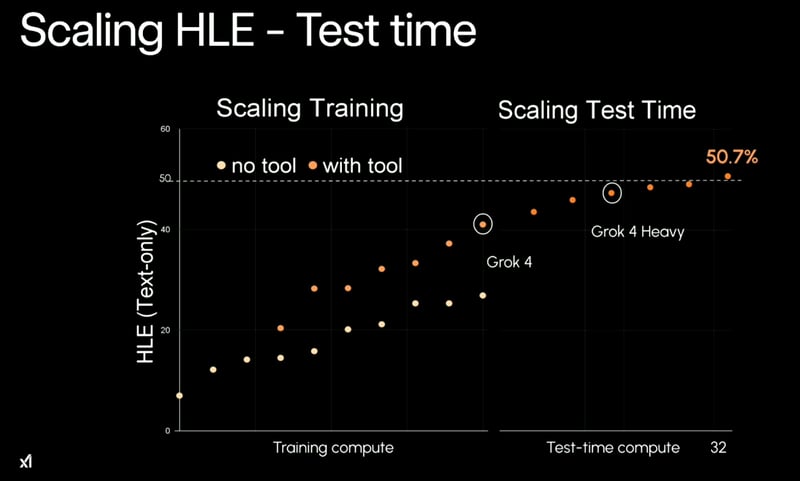
来源:xAI
在不使用工具时,Grok 4 的准确率大约停留在 26.9%。启用工具(如代码执行)后,可达到41.0%。以多智能体“Heavy”配置运行时,进一步攀升至50.7%——这是幅度很大的跃升,超过此前最佳“无工具”模型的两倍。
学术与 STEM 基准
Grok 4 在更多传统的 STEM 测评中也表现不俗,这些测评广泛用于高性能大模型的对比。亮点包括:
|
基准 |
主要竞争模型 |
Grok 4(无工具) |
Grok 4 Heavy |
|
GPQA |
79.6–86.4% |
87.5% |
88.9% |
|
AIME25 |
75.5–98.8% |
91.7% |
100.0% |
|
LCB(1–5 月) |
72.0–74.2% |
79.0% |
79.4% |
|
HMMT25 |
58.3–82.5% |
90.0% |
96.7% |
|
USAMO25 |
21.7–49.4% |
37.5% |
61.9% |
这些成绩相当扎实。Grok 4 在大多数类别中优于 Claude Opus、Gemini 2.5 Pro 和 GPT-4(o3),不过也有人指出,这些对比可能存在“择优选取”他家模型基线成绩的问题。
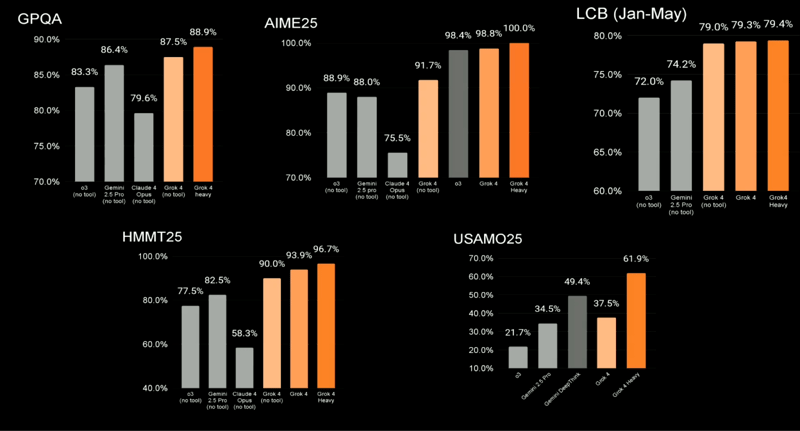
来源:xAI
ARC-AGI(高级推理)
ARC-AGI 是更为困难且不透明的基准之一,测试模型在抽象推理任务上的泛化能力。在ARC-AGI v1 上,Grok 4 得分66.6%,领先所有已知同类。在ARC-AGI v2 上,得分15.9%,相比 Claude 4 Opus 的 8.6% 有明显优势。
这些测试并非完全公开,仍需保留谨慎态度。但若数据经得起验证,Grok 4 在多步、逻辑密集型推理任务上显示出强劲表现。
Vending-Bench(商业模拟)
xAI 还在一个名为Vending-Bench 的真实世界模拟中测试了 Grok 4。该基准旨在观察模型是否能随时间管理小型生意:补货、调价、联系供应商等。这是一个相对较新的基准,而且出乎意料地有趣。我们此前在每周通讯 The Median 中通过 Claude Sonnet 3.7 的案例详细介绍过其机制。
结果(五次运行取平均):
|
名次 |
模型 |
净资产 |
售出数量 |
|
1 |
Grok 4 |
$4,694 |
4,569 |
|
2 |
Claude Opus 4 |
$2,077 |
1,412 |
|
3 |
人工基线 |
$ 844 |
344 |
|
4 |
Gemini 2.5 Pro |
$ 789 |
356 |
|
5 |
GPT-4(o3) |
$1,843 |
1,363 |
Grok 4 在收入与规模两项上都把第二名的表现提升了一倍以上。它还能在 300 轮模拟中保持稳定发挥——许多模型在长周期规划面前会出现“力竭”。
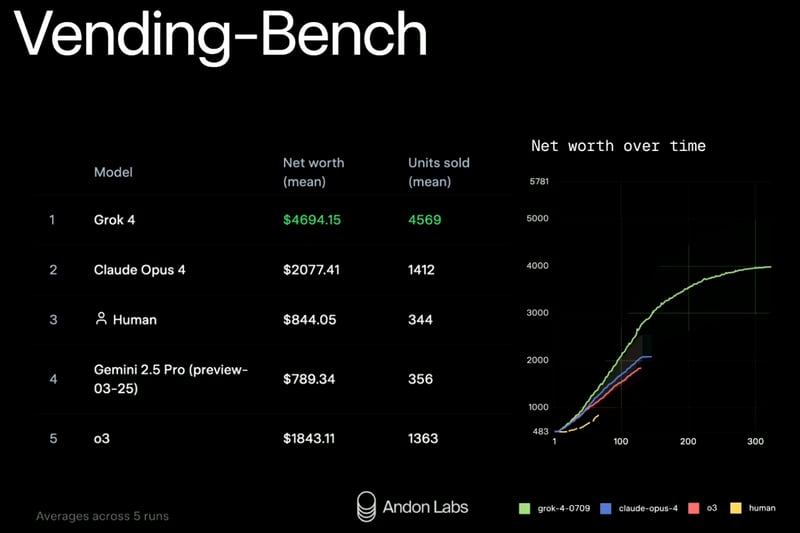
来源:xAI
简而言之:Grok 4 在 xAI 选取的测试中表现不俗。但一如既往,不要只看榜单。基准固然可喜,却无法讲述全部事实——尤其当您的用例依赖视觉、代码生成,或在复杂环境中需要实时交互时。
如何访问 Grok 4
目前可通过三种主要入口使用 Grok 4: X 应用、xAI API,以及 grok.com 平台。无论您是想与模型聊天、基于它构建,还是更正式地测试其推理能力,以下是上手方式。
聊天入口(通过 X)
尝试 Grok 4 最简单的方法是通过 X 应用(原 Twitter)。这会在一个类似 ChatGPT 或 Claude 的聊天界面中为您提供 Grok。
使用步骤:
- 订阅 X Premium+ 顶级计划。
- 打开 X 应用(或访问 x.com)。
- 点击 Grok 图标(移动端在底部导航,桌面端在侧边栏)。
- 开始聊天。Grok 4 为默认模型,您也可切换不同版本。
通过 Grok.com 直接访问
您也可以直接通过 grok.com 使用 Grok 4,该站点提供一个更简洁、独立于 X 平台之外的界面,更适合希望“无打扰”体验的用户。
- 访问 https://grok.com
- 注册并登录。
- 在聊天界面访问 Grok 4,支持工具、代码与长上下文。
Grok 4 API
如果您想把 Grok 集成到自有应用或工作流中,可以使用 xAI API。
步骤:
- 前往 https://x.ai/api 申请开发者访问。
- 审批通过后,您会收到 API 密钥与文档访问权限。
- 务必阅读相关文档了解更多细节。
Grok 4 之后的路线图
随着 Grok 4 发布,xAI 公布了 2025 年余下时间清晰(且雄心勃勃)的路线图。根据直播中展示的时间表,未来三个月将有四个重要发布:8 月推出编程模型、9 月推出多模态智能体、10 月推出视频生成模型。
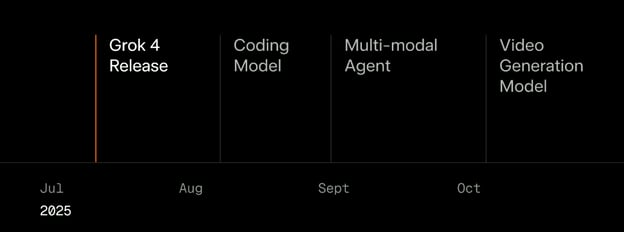
来源:xAI
8 月:专项编程模型
首个后续发布预计在 8 月,是一个以编程为核心的模型。不同于通才型的 Grok 4,它将是一个专门模型,旨在以更高速度与准确性处理代码。xAI 表示它“又快又聪明”,训练中特别针对软件开发工作流优化了时延与推理。
9 月:多模态智能体
9 月计划发布“真正的”多模态智能体。目前 Grok 4 在技术上支持图像与视频输入,但理解力有限——团队在直播中把它形容为“隔着磨砂玻璃眯眼看”。
即将推出的版本旨在改进这一点,让模型在图像、视频与音频上的感知更强。这对超越文本的用例至关重要:如机器人、游戏博弈、视频问答或遵循视觉指令等。
10 月:视频生成模型
当前时间线中的最后一个发布是 10 月的一个视频生成模型。xAI 表示将用超过 10 万张 GPU 进行训练。按其说法,该系统将致力于生成高质量、可交互、可编辑的视频内容。
结语
Grok 4 对 xAI 而言是一次扎实的前进。它在多项高难度基准上领先,对结构化的数理评估也经得起考验,并通过多智能体(Grok 4 Heavy)为研究场景与长周期思考展现出潜力。
但它并非日常的通用助理。相较 Grok 3 更慢,图像与视频理解还处在早期阶段,日常易用性也欠些打磨。由于上下文窗口相对有限,您需要更谨慎地提示、并裁剪输入。而若要追求最佳性能——通过 Grok 4 Heavy——则需要为此支付不菲费用。
对开发者与研究者而言,值得一试。对普通用户来说,Grok 3 或其他主流模型的速度与响应更合适。路线图雄心勃勃:编程模型、多模态智能体与视频生成器都将在 10 月前推出。xAI 能否按时交付尚待观察。但凭借 Grok 4,他们至少证明自己仍在赛道之上。
FAQs
Grok 4 与 Grok 4 Heavy 有何区别?
Grok 4 是单智能体模型——由一个模型实例处理您的输入并返回答案。Grok 4 Heavy 会并行运行多个 Grok 4 智能体。每个智能体独立处理同一任务,随后对比输出并达成最终答案。多智能体设置可提升准确率,尤其在复杂推理问题上,但也更慢、更耗资源。
哪些任务适合使用 Grok 4 Heavy?
Grok 4 Heavy 最适合长文本推理、困难的数理与科学问题、技术研究,或任何在得出最终答案前需要多种视角权衡的任务。对随意闲聊或简单检索而言它有些大材小用,但在基准测试、模拟以及高级规划任务中表现出色。
Grok 4 与 Grok 3 有何不同?
Grok 4 是 xAI 最新的大语言模型,相比 Grok 3 在复杂任务上的推理能力与表现都有所提升。它在 “Heavy” 变体中引入了多智能体系统,支持并行推理,从而在某些基准上提高准确率。日常轻量任务可用 Grok 3,涉及复杂推理的任务用 Grok 4 更合适。
Grok 4 是否支持图像和视频等多模态输入?
Grok 4 支持多模态输入,但其能力与输出目前仍以文本为主。尽管有计划强化包括图像与视频理解在内的多模态功能,但这些仍在开发中。
Grok 4 Heavy 的价格是多少?
可通过 xAI 的 SuperGrok Heavy 方案访问 Grok 4 Heavy,费用为 $300/月。该方案可在 grok.com 界面使用多智能体版本。它面向研究人员、开发者与企业用户——大多数普通用户并不需要。

我是一名编辑和撰稿人,专注于 AI 博客、教程与新闻,确保内容契合成熟的内容策略并遵循 SEO 最佳实践。我编写过关于 Python、统计学、概率和数据可视化的数据科学课程。我的长篇小说曾获奖,业余时间从事影视剧本创作和电影导演。
在我们等待了数月的 Grok 3.5 迟迟未至之后,xAI 直接跳过了它,一举发布了 Grok 4。(截至 2025 年 11 月,Grok 4.1 也已发布。)
这一“跳级”是否配得上模型的表现?
如果以基准测试为准,答案是肯定的。目前从纸面数据看,Grok 4 很可能是全球表现最好的模型之一。
不过在应用中上下文窗口仅有 128,000(API 为 256,000),在真实生产工作中可能会掣肘。它没有Gemini 2.5 Pro 那样“宽容”,后者提供整整一百万个 token。若您想用 Grok 4 做超过短聊的工作,就需要拿出相当扎实的上下文工程功底来驾驭它。
在这篇博客中,我会剥离惯常的噱头,从模型的主要优劣势出发,再结合我自己的测试结果,给出一个平衡、务实的概览。
我们通过免费周报 The Median 每周五为读者梳理本周 AI 关键信息,持续带来最新动态。订阅即可每周用几分钟保持敏锐:
Grok 4
Grok 4 家族目前只有 Grok 4 和 Grok 4 Heavy 两个型号,没有可用于快速推理的迷你版。
Grok 4 是 xAI 最新的单智能体模型(不同于采用多智能体的 Grok 4 Heavy——下一节会介绍)。从直播情况看,工程上并无颠覆性创新。性能提升似乎主要来自一系列小改进与算力的大幅增加,约为 Grok 3 的 10 倍。
来源:xAI
公司称其为当下最智能的模型,基准结果也确有此指向。最引人注目的成绩来自“人类最后的考试”(Humanity’s Last Exam),这是一个由 2,500 道手工精选的博士级问题组成的基准,涵盖数学、物理、化学、语言学与工程。Grok 4(启用工具)解出了约 38.6% 的题目。
来源:xAI
应用中上下文窗口在客户端为 128,000 token,API 为 256,000,虽可支持一定的长文本推理,但以当前标准并不算大方。例如 Gemini 2.5 Pro 提供 100 万。如果您要基于 Grok 构建应用,可能需要花时间精心组织并裁剪上下文。
需要说明的是,Grok 4 并非解答日常问题(如“这个周末会下雨吗?”或“帮我找一个附近的演唱会”)的首选。对此,您更适合使用Grok 3——它更快,面向通用任务。Grok 4 更适合研究、技术类提示,以及数学、科学、金融等依赖纯推理的问题,或开发者的推理型工作流。
它在更广泛的消费级工作流中的表现、以及在大规模安全控制上的能力,目前还不够明朗。但 xAI 表示该模型已在生物医药实验室、金融机构和部分早期企业客户中投入使用。
Grok 4 Heavy
Grok 4 Heavy 是 Grok 4 的多智能体版本。它并非只运行一个模型实例,而是并行启动多个智能体,各自独立解决同一任务。生成输出后,它们再进行对比并汇聚为一个答案。
理论上,它有点像学习小组——智能体之间可分享见解、弥补彼此盲区。实践中,这种架构在复杂推理任务上往往更有帮助,单次推理可能难以覆盖到的点,多个路径能补足。
收益在基准测试中可见:在“人类最后的考试”上,启用工具的 Grok 4 Heavy 得分 44.4%,明显高于单智能体的 Grok 4。该架构似乎也有助于ARC-AGI,Grok 4 首次突破 10%,达到 15.9%——尽管这其中有多少归因于多智能体架构本身尚不清楚。
来源:xAI
代价是速度与成本。Grok 4 Heavy 运行更慢(慢很多!),且运营成本高出十倍——xAI 通过每月 300 美元的 SuperGrok Heavy 套餐提供访问。
同样,Grok 4 Heavy 不适合做简单检索或快速迭代。如果说 Grok 4 已经偏“细分场景”,那么 Grok 4 Heavy 更是如此。它为那些多条推理路径可能带来更好结果的问题而生——比如科学研究、金融建模或任何涉及长周期规划的任务。对大多数用例来说,它有些“大材小用”。
想看 Grok 4 的演示,请不要错过我们的讲解视频: