
此前我测试过的模型,没有一个能在首次就把开始界面做好——大多都会直接进入游戏。Claude Opus 4 实际上展示了带说明的合格开始界面,这点挺让人惊喜。
不过出现了一个视觉 Bug:像素风恐龙在屏幕移动时会留下让人困惑的拖影。每帧之间的像素没有被正确清除,导致游戏体验受损。我指出了问题并让 Opus 4 修复。
完美!我从未从其他模型那里拿到过如此干净、可玩性这么高的版本。
Claude 4 基准评测
Claude 4 系列在编程、推理和代理式任务等多项标准基准上进行了测试。虽然这些分数无法全面反映模型质量,但作为对比参考仍很有价值。以下是 Claude Sonnet 4 与 Claude Opus 4 的关键结果。
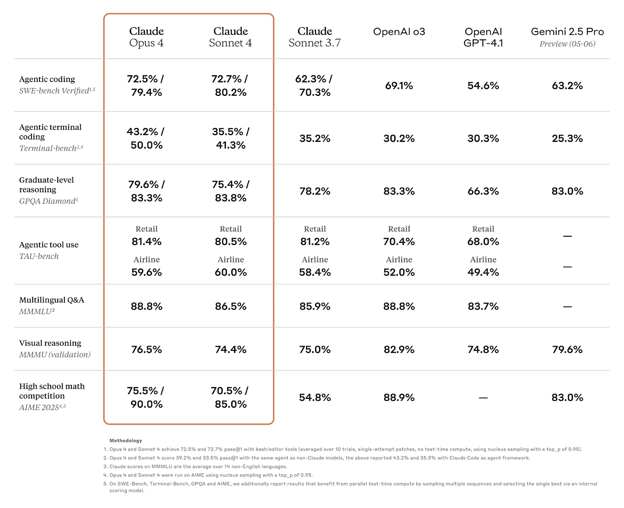
来源:Anthropic
Claude Sonnet 4
对于一个向免费用户开放的模型而言,Claude Sonnet 4 的表现出乎意料地好。在测试真实世界编程任务的 SWE-bench Verified 上,它拿到 72.7%,略高于 Opus 4(72.5%),也显著领先于 Claude 3.7 Sonnet(62.3%)。它同样超过了 OpenAI 的 GPT-4.1(54.6%)和 Gemini 2.5 Pro(63.2%)。
在其他基准上:
- TerminalBench(基于 CLI 的编程):35.5%——领先于 GPT-4.1(30.3%)和 Gemini(25.3%)
- GPQA Diamond(研究生水平推理):75.4%——强劲,但略低于 OpenAI o3 和 Gemini
- TAU-bench(代理式工具使用):零售 80.5% / 航空 60.0%——与 Opus 4 相当,并领先于 GPT-4.1 和 o3
- MMLU(多语言问答):86.5%——仅次于 Opus 和 o3,但依然稳健
- MMMU(视觉推理):74.4%——在该系列中垫底
- AIME(数学竞赛):70.5%——优于 Sonnet 3.7,但竞争力仍不足
可以说,Sonnet 4 是目前可免费使用的最佳模型之一,表现不输需要付费或商用接入的模型。
Claude Opus 4
Opus 4 是 Anthropic 的旗舰模型,在多数基准上处于领先或近乎领先的位置。在 SWE-bench Verified 上得分 72.5%,在高算力设置下可升至 79.4%——为所有对比模型中的最高分。
它还在以下方面领先或名列前茅:
- TerminalBench(代理式 CLI 编程):43.2%(高算力模式 50.0%)——图表中最强成绩
- GPQA Diamond(研究生水平推理):79.6%(83.3%)——稳健,略逊于 OpenAI o3 与 Gemini 2.5 Pro
- TAU-bench(代理式工具使用):零售 81.4% / 航空 59.6%——与 Sonnet 4 和 3.7 相当
- MMLU(多语言问答):88.8%——与 OpenAI o3 持平
- MMMU(视觉推理):76.5%——落后于 o3 和 Gemini 2.5 Pro
- AIME(数学竞赛):75.5%(高算力 90.0%)——显著高于 Claude Sonnet 4
如何使用 Claude 4
Claude 4 可通过多种渠道使用,取决于您的需求——随意聊天、通过 API 开发,或集成到企业工作流。使用方式如下:
聊天渠道
您可以直接通过 Claude.ai 网页端或移动应用(iOS 和 Android)使用 Claude 4。
- Claude Sonnet 4 向所有用户开放,包括免费层。这使其成为您无需付费即可体验的最强模型之一。
- Claude Opus 4 仅向 Pro、Max、Team 或 Enterprise 付费计划用户开放。
API 渠道
对开发者而言,这两个模型都可通过Anthropic API 获取,也可在 Amazon Bedrock 和 Google Cloud Vertex AI 上使用。
API 定价(截至 2025 年 5 月):
- Claude Opus 4:每百万输入 token 15 美元、每百万输出 token 75 美元
- Claude Sonnet 4:每百万输入 token 3 美元、每百万输出 token 15 美元
批处理与提示缓存在某些情况下可将成本降低至多 90%。
结论
Claude Sonnet 4 作为一款快速而强大的模型,免费可用,并在编程、推理和通用助理任务上表现出色,确实物有所值。对大多数日常需求而言,它已经足够出色。
另一方面,Opus 4 面向更深入的推理与复杂工作流。在编程方面——尤其是创意生成与问题求解——它给出的结果是我迄今在各模型中见过的最佳之一。

我是一名编辑和撰稿人,专注于 AI 博客、教程与新闻,确保内容契合成熟的内容策略并遵循 SEO 最佳实践。我编写过关于 Python、统计学、概率和数据可视化的数据科学课程。我的长篇小说曾获奖,业余时间从事影视剧本创作和电影导演。
Anthropic 刚刚发布了 Claude 4,包含两个版本:Claude 4 Sonnet 和 Claude 4 Opus。
Claude Sonnet 4 是一款通用模型,适用于大多数 AI 用例,尤其擅长编程。我认为这是您可以免费使用的最佳模型之一。
Claude Opus 4 旨在处理重度推理任务,如代理式搜索和长时间运行的代码工作流。Anthropic 称 Opus 4 为“全球最强的编程模型”,但我觉得这种说法有些空泛。
没错,它目前在 SWE-bench Verified 基准上表现最佳。但在仅有 200K 的上下文窗口下,我很难想象它能干净利落地处理超大代码库。说实话,几乎每个月都会有更强的新模型问世。拿下几周的“王冠”并不意味着太多。
尽管如此,Claude 4 依然是一版很强的发布。我将带您快速了解最重要的细节——功能、用例、基准测试——并且我还会亲自跑几组测试。
我们通过每周五的免费通讯 The Median,持续为读者带来 AI 最新动态,梳理一周要闻。订阅即可每周用几分钟保持敏锐:
Claude Sonnet 4
Claude Sonnet 4 是 Claude 4 家族中体量较小的模型。它面向通用场景,在大多数常见 AI 任务上表现良好——编程、写作、问答、数据分析。它也向免费用户开放,这对同等质量的模型来说相当少见。
该模型支持 200K 的上下文窗口,能够处理大型提示,并在长对话中保持连续性。这对于分析长文档、审查代码库、或生成结构一致的多段回复等场景很有用。不过,Sonnet 4 可能会在大型代码库上吃力。作个对比,Gemini 2.5 Flash 的上下文窗口为 100 万 token。
与Claude Sonnet 3.7 相比,这一版本更快、更会遵循指令,也更适合代码密集型工作流。它支持最多 64K 的输出 token,有助于处理略长的输出,如结构化计划、多段回答或较大的代码补全。
早期报告显示,它的导航错误更少,在应用开发任务上表现更好。在复杂推理或长期任务规划方面,它不如 Opus 4 强,但对大多数工作流而言已绰绰有余。
Claude Opus 4
Claude Opus 4 是 Claude 4 系列的旗舰模型。它面向需要更深层推理、长期记忆和更结构化输出的任务——如代理式搜索、大规模代码重构、多步问题求解和长时间的研究型工作流。
与 Sonnet 4 一样,它支持 200K 的上下文窗口,如果要在大型代码库中使用,这可能是个劣势。对比来看,Gemini 2.5 Pro(Google 的旗舰模型)拥有 100 万 token 的上下文窗口。
它还能运行在“扩展思考”模式下,从快速响应切换为更慢、更审慎的推理。在该模式中,它可以调用工具、跨步骤跟踪记忆,并在需要时生成自身思路的摘要。
Anthropic 将其定位为面向开发者、研究人员和构建 AI 代理的团队的高端模型。它在 SWE-bench Verified 和 Terminal-bench 上领先,早期用户反馈其在编程代理、搜索型工作流,以及诸如重构开源项目或模拟长期规划等跨数小时任务中表现强劲。
与 Sonnet 不同,Opus 4 仅在付费套餐中提供。其运行成本更高,对简单聊天机器人而言可能有些“大材小用”。但对于需要在众多环节中保持一致推理的应用,它是更有能力的选择。
测试 Claude 4
测试新模型时,我通常使用相同的任务——这样便于与之前测试过的其他模型进行对比。这并非全面评估,目标只是感受这些模型在聊天界面里的表现方式。
我们来在两个方面试试 Claude 4:数学和编程。
数学
我喜欢从一个简单但经常难倒语言模型的计算开始。这不是为了检查基础算术——用计算器就行。关键在于观察模型如何处理稍显棘手的问题,以及在需要时它是否会借助工具或清晰展示推理过程。
来看 Claude Sonnet 4 的表现:
如您所见,它第一次尝试给错了答案。但当我要求它使用工具——计算器——时,它通过编写一行 JavaScript 脚本进行了求解,并得到了正确答案。
Claude Opus 4 第一次尝试就答对了。
接着,我想看看 Claude Sonnet 4 处理更复杂问题的能力:用 0 到 9 的所有数字且各用一次,组成三个数x、y、z,使得x + y = z。
大约经过五分钟的随机穷举尝试后,我收到提示称已达到输出上限,需要点击“继续”才能接着运行。我照做了,Claude 又尝试了一次——但再次触顶。让我欣赏的是,它没有编造答案。如果找不到,它就拒绝作答。在我看来,这是一个很大的优点——幻觉式生成 的答案更成问题。
随后我用同一任务测试了 Claude Opus 4。答案几乎瞬间返回,而且是正确的:246 + 789 = 1035。Opus 4 令人惊艳!
编程
在编程任务上,我决定直接上 Claude Opus 4。这类创意生成更契合它的能力。这里我并未测试大型代码库——只是一个相对简单的编程小任务。
我让它用我在Gemini 2.5 Pro 和o4-mini 上使用过的这个提示,快速做一个 p5.js 游戏:
提示: 给我做一个引人入胜的无尽跑酷游戏。屏幕上有关键操作说明。p5.js 场景,不要 HTML。我喜欢像素风恐龙和有趣的背景。
通常我会把代码复制到在线 p5.js 编辑器里测试。但 Claude 4 的一个亮点是 Artifacts,可以直接在聊天中查看并运行代码输出。
来看结果: