
正是我想要的!当然还有很多我会修改的地方,但就我的投入(两个提示)和目标(只做个原型)而言,结果已经非常不错了。
多模态输入(视频与文本)
接着,我想测试一下 Gemin 2.5 Pro 的多模态能力。我把上面的游戏视频上传,并在 Google AI Studio 上向 Gemini 2.5 Pro 给出了这个提示(我在 Gemini 应用中没法添加视频作为输入):
Analyze the game in the video, criticize both the game and the code I will give you below, and indicate what changes I could make to this game to make it better.
Code:
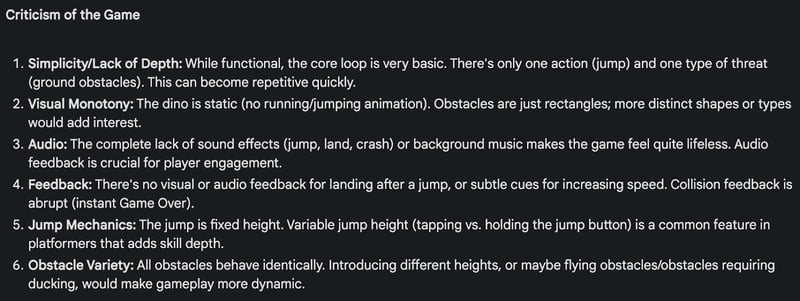
(truncated fo readability)输出相当不错!为便于阅读,我这里只展示对游戏的批评,这也间接表明它很好地理解了视频与代码:
处理大型文档
最后,我想在相对较大的文档上测试 Gemini 2.5 Pro,我选择了斯坦福《2024 人工智能指数报告》。上传这份 502 页的文档(129,517 个令牌)后,我向 Gemini 2.5 Pro 提问:
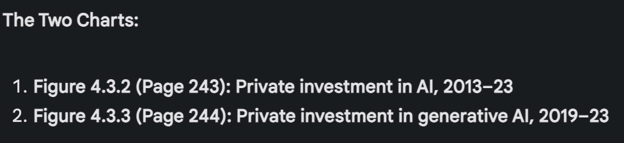
Pick two charts in this report that appear to show opposing or contradictory trends. Describe what each chart says, why the contradiction matters, and propose at least one explanation that reconciles the difference. Mention the page of the charts so I can double-check. If there's no such contradiction, don't try to artificially find one.不知为何,它无法在 Gemini 应用中直接分析 PDF 文档内的图表。我切换到 Google AI Studio 后就可以了。Gemini 2.5 Pro 找到了两张与 AI 投资相关、呈现矛盾趋势的图:尽管私营领域的生成式 AI 投资在上升,但私营 AI 总体投资却在下降。
它准确地按页码(正如我所要求的)、图号和标题定位了图表(建议您自行查看PDF进行复核并查看图表)。
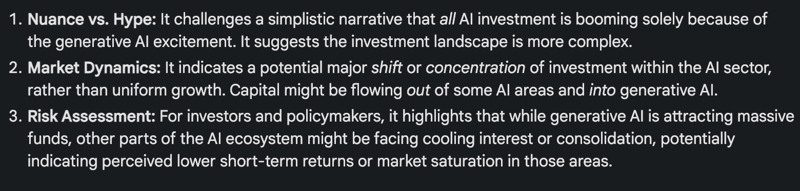
它很好地概括了这一矛盾趋势:当其最受关注、最显眼的子领域——生成式 AI 的投资在飙升时,私营 AI 总体投资为何会下降?
并解释了为何会出现这种看似矛盾的趋势:
Gemini 2.5 Pro 基准评测
Google 将 Gemini 2.5 Pro 与当今一些顶级模型进行了对比评测,其中包括Claude 3.7 Sonnet、OpenAI 的 o3-mini、DeepSeek R1 和 Grok 3。虽然不同任务上的表现有所差异,但 Gemini 2.5 Pro 在推理、编码、数学和长上下文任务上总体表现不俗。
|
类别 |
基准 |
Gemini 2.5 Pro |
最接近的竞争者 |
|
推理与通识 |
Humanity’s Last Exam(无工具) |
18.8% |
o3-mini(14%)、Claude 3.7(8.9%)、DeepSeek R1(8.6%) |
|
GPQA Diamond(pass@1) |
84.0% |
Grok 3 Beta(80.2%)、o3–mini(79.7%)、Claude 3.7 Sonnet(78.2%) | |
|
数学与逻辑 |
AIME 2024(pass@1) |
92.0% |
o3-mini(87.3%)、Grok 3 Beta(83.9%) |
|
AIME 2025(pass@1) |
86.7% |
o3-mini(86.5%)、Grok 3 Beta(77.3%) | |
|
编码 |
LiveCodeBench v5 |
70.4% |
o3-mini(74.1%)、Grok 3 Beta(70.6%) |
|
Aider Polyglot(整文件编辑) |
74.0% |
— | |
|
SWE-bench Verified |
63.8% |
Claude 3.7(70.3%) | |
|
长上下文与多模态 |
MRCR(128K 上下文) |
91.5% |
GPT-4.5(48.8%)、o3-mini(36.3%) |
|
MMMU(多模态理解;pass@1) |
81.7% |
Grok 3 Beta(76.0%)、Claude 3.7 Sonnet(75%) |
来源: Google
推理与通识
Gemini 2.5 Pro 在旨在测试多步骤推理与真实世界知识的基准上表现强劲:
- Humanity’s Last Exam(无工具):Gemini 2.5 Pro 得分 18.8%,领先于 o3-mini(14%),并显著高于 Claude 3.7(8.9%)与 DeepSeek-R1(8.6%)。该测试模拟 100 多个学科的专家级考试。
- GPQA Diamond:覆盖理工与人文学科的事实型问答基准。Gemini 2.5 Pro 在单次尝试(pass@1)下以 84.0% 领先,其次为 Grok 3 Beta 的 80.2%。
数学与逻辑
这些是 Gemini 的推理架构似乎最能发挥所长的基准:
- AIME 2024:Gemini 2.5 Pro 在单次尝试(pass@1)下取得 92.0% 的领先成绩。
- AIME 2025:Gemini 2.5 Pro 在 2025 年题集上降至 86.7%, 在单次尝试(pass@1)下以微弱优势领先,其后是 o3-mini(86.5%)。
编码
在测试代码生成、调试和多文件推理的基准上,Gemini 表现良好,但并未全面称王:
- LiveCodeBench v5(代码生成):Gemini 2.5 Pro 得分 70.4%,落后于 o3-mini(74.1%)和 Grok 3 Beta(70.6%)。
- Aider Polyglot(整文件):Gemini 达到 74.0%,表现扎实,尤其考虑到其可处理多种语言。该基准评测代码编辑能力。
- SWE-bench verified(代理式编码):Gemini 得分 63.8%,领先于 o3-mini 与 DeepSeek R1,但落后于 Claude 3.7 Sonnet(70.3%)。
长上下文与多模态任务
这是 Gemini 2.5 Pro 表现最突出的领域:
- MRCR(长上下文阅读理解):在 128,000 的上下文长度下,Gemini 2.5 Pro 达到 91.5%,远超 o3-mini(36.3%)和 GPT-4.5(48.8%)。
- MMMU(多模态理解):Gemini 2.5 Pro 以 81.7% 的成绩领跑该基准。
如何访问 Gemini 2.5 Pro
根据您是普通用户还是要构建更技术性的内容,有几种方式可以试用 Gemini 2.5 Pro。
Gemini 应用
最简单的访问方式是通过 Gemini 应用(移动端或网页)。
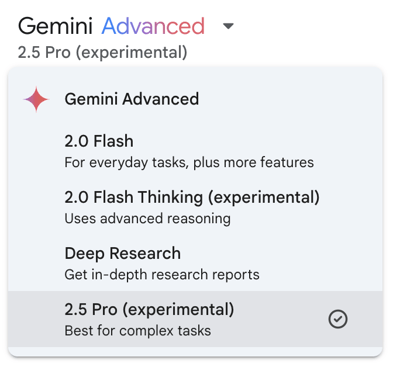
如果您是 Gemini Advanced 订阅用户,您会在模型的下拉菜单中看到 Gemini 2.5 Pro。
Google AI Studio
如果您想更好地控制输入、工具使用或多模态提示,我推荐使用Google AI Studio。
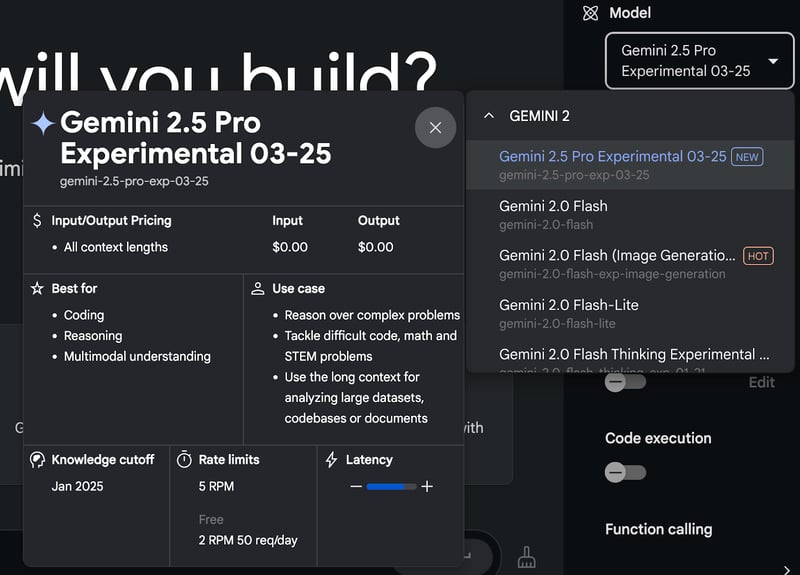
该环境目前可免费使用 Gemini 2.5 Pro,并支持文本、图像、视频和音频输入。它在上传文件或测试工具使用方面也比 Gemini 应用更好,尤其是在处理大型文档或自定义流程时。
创建账户后,您可以在模型下拉菜单中选择 Gemini 2.5 Pro。
Gemini 2.5 Pro API
若需以编程方式访问,您可以使用支持 Gemini 2.5 Pro 的 Gemini API。
如果您要将模型集成到应用或工作流中,这能带来更大灵活性。您可以直接调用启用工具使用的模型、获取结构化响应,或以自动化方式处理长文档。
更多技术信息可见此处。
Vertex AI 上的 Gemini 2.5 Pro
Google 表示,Gemini 2.5 Pro 也将很快在 Google Cloud 的 Vertex AI 中提供。直接使用 Gemini API 与通过 Vertex AI 访问的主要区别在于基础设施、规模与集成能力。
如果您只是测试或构建内部工具,AI Studio 或 API 就足够了。如果您要在生产环境中部署,对性能或安全有严格要求,一旦 Vertex AI 支持 Gemini 2.5 Pro,它将更适合。
结论
如今很难再对新模型发布感到惊艳。多数发布都遵循相同的套路:一些挑选过的示例、一些亮眼的基准,以及许多“全能最强”的宣称。但 Gemini 2.5 Pro 的确让我有几次停下来想:“好吧,这真的很有用。”
100 万令牌的上下文窗口改变了处理以往需要额外工作才能完成的任务方式——尤其是涉及长文档、复杂代码库或多步骤推理的任务。我无需拆分输入或搭建 RAG 流水线,只需上传文件、提出问题,就能获得与来源一致、连贯的回答。
如果 200 万令牌的上下文窗口很快推出,光是这一点就可能让它成为最实用的现实工作模型之一。
常见问题
Gemini 2.5 Pro 支持哪些输入类型?
Gemini 2.5 Pro 支持文本、图像、视频和音频输入。
我可以在哪里访问 Gemini 2.5 Pro?
Gemini 2.5 Pro 可通过 Google AI Studio 获取,或由 Gemini 应用的 Gemini Advanced 订阅用户使用。
Gemini 2.5 Pro 的主要使用场景是什么?
Gemini 2.5 Pro 擅长编码、复杂推理任务以及处理多模态输入。
Gemini 2.5 Pro 适用于实时应用吗?
尽管功能强大,但其实验性状态意味着在实时部署前仍应谨慎,直至进一步验证其稳定性。

我是一名编辑和撰稿人,专注于 AI 博客、教程与新闻,确保内容契合成熟的内容策略并遵循 SEO 最佳实践。我编写过关于 Python、统计学、概率和数据可视化的数据科学课程。我的长篇小说曾获奖,业余时间从事影视剧本创作和电影导演。
Google 刚刚发布了 Gemini 2.5 Pro,这是迄今为止其最强的推理模型,也是 Gemini 2.5 系列中的首款产品。(更新:截至 2025 年 11 月 18 日,Gemini 3 已上线。您可以在我们的Gemini 3 指南和Gemini 3 API 教程中了解全部信息。)
在我看来,它最大的优势是高达 100 万令牌的海量上下文窗口,并计划扩展到 200 万。将推理模型与如此大的上下文结合,能带来真正的商业价值,尤其是在大多数企业的 AI 采用仍相当有限的情况下。
换个角度看:OpenAI 的 o3-mini 支持 20 万令牌,Claude 3.7 Sonnet 也上限为 20 万,DeepSeek R1 最高 12.8 万,而 Grok 3 是目前唯一能与 Gemini 匹配至 100 万的模型。
鉴于代码生成是最常见的 AI 用例之一,能够进行代码推理并在一次通过中读取大型代码库、无需 RAG 的模型,能带来可观的商业价值。我们此前在一篇博客中已经展示过如何使用 Gemini 2.0 Flash 在不使用 RAG 的情况下处理大型文档。
在本文中,我将介绍 Gemini 2.5 Pro 提供了什么、支持哪些输入类型,以及如何访问。还会做一些动手测试,并查看它在关键基准上与 Claude、DeepSeek、Grok 和 OpenAI 最新模型的对比表现。
我们通过每周五发送的免费新闻简报 The Median 为读者带来最新 AI 动态,梳理本周要闻。订阅它,每周只需几分钟即可保持敏锐:
什么是 Gemini 2.5 Pro?
Gemini 2.5 Pro 是 Google 的 Gemini 2.5 系列中的首款模型。目前标注为实验性,可通过 Gemini Advanced 订阅方案和 Google AI Studio 使用。
据 Google 称,这是他们迄今最好的推理模型,在工具使用、多模态输入处理和长上下文表现方面都有所提升。以下是其支持能力的快速概览:
Gemini 2.5 Pro 支持工具使用,这意味着它可以调用外部函数、生成结构化输出(如 JSON)、执行代码并使用搜索。这样模型就能解决多步骤任务、调用 API,或为特定下游系统格式化响应。
作为推理模型,Gemini 2.5 Pro 在编码、数学、逻辑和科学方面尤其强大。对于大多数日常任务,您仍然可以使用像 Gemini 2.0 Flash 这样的通用型模型,因为它速度更快。
现在,让我们试试 Gemini 2.5 Pro 的实际表现。
测试 Gemini 2.5 Pro
P5js 游戏
首先,我想测试一下 Google 提供作为示例的恐龙游戏,并使用了演示视频中的同一提示(我在 Gemini 应用中尝试的):
来看一下结果: