
我的路上必须有影子
若要行走 我必须拥有
每一步都要慢慢独自行进
让一切预先备妥
而我必须在灰色的线条中思考
让朦胧的思绪指引我
必须注视蓝与绿
且不要让我的眼睛忘记
色彩是我的朋友
而紫色也必须将我环绕
太阳的黄色并不比
覆于众人之上的淡蓝色雪
更为侵扰。我必须让
灰色的念头与蓝色的念头与我同行
若我要真正离去。
大型语言模型以其语言能力震惊世界。即便没有进行显式训练,它们也能以业界领先的水平完成多种任务。
令人庆幸的是,这些大型语言模型并非只属于巨头公司。随着开源 NLP 社区蓬勃发展与模型 API 的日益普及,获取此类模型的途径不断拓宽。如今,任何人都比以往更容易利用大型语言模型的强大能力。
NLP 的增长引起了企业与投资者的浓厚兴趣。John Snow Labs 与 Gradient Flow 的一项调研显示,60% 的技术领导者表示其 NLP 预算较 2020 年至少增长 10%。我们也看到了 NLP 创业公司在该领域争夺市场份额的显著增长。随着 NLP 以惊人的速度发展,AI 社区也理所当然地对大型语言模型的风险发出担忧。在这些模型得到广泛采用之前,我们必须确保它们公正且安全。
在本文中,我们将探讨 NLP 与大型语言模型的诸多方面——它们是什么、如何使用,以及如何安全地使用它们。
NLP 的进展——从 Word2Vec 到 Transformer
过去十年中,NLP 的早期突破之一是 Word2Vec。Mikolov 等作者发现,当模型学习词的关联关系时,不仅显著优于当时流行的 N-gram 模型,而且更高效、更快速。
然而,Word2Vec 无法利用词序这一重要信息。循环神经网络(RNN)的出现解决了这一问题。与 Word2Vec 不同,RNN 会利用先前输入的信息来影响当前的输入与输出。这赋予了 RNN “记忆”,使其非常适合学习文本之间的关系。
不过,由于梯度消失问题,RNN 的“记忆”较为短暂。在处理短句子时表现尚可,但在长段落上表现不佳。为此引入了 长短期记忆(LSTM),这是一种特殊的 RNN,通过“门”机制使 LSTM 能够更长久地记住信息。
在论文“Attention is All You Need”横空出世之前,LSTM 一直被视为事实上的 NLP 模型。论文中引入的注意力机制,使 RNN 在输出时能够聚焦于部分关键信息。基于注意力的一种特殊网络——Transformer 网络,被证明极其简洁、高效且强大。
其中,BERT(双向编码器表示的 Transformer)模型被视为 NLP 领域的里程碑式成果(参见这篇 NLP 教程了解 BERT 的概览)。与按顺序读取文本的定向模型不同,BERT 会一次性读取完整的词序列。更令人印象深刻的是,一个预训练的 BERT 模型只需在其上微调一个额外的输出层,就能在多种任务上达到最先进水平。自那以后,多种基于注意力的架构都已超越 BERT,包括 XLNet、百度的 ERNIE 以及 RoBERTa。这些模型至今仍广泛用于诸多 NLP 任务。
大型语言模型的崛起
科技爱好者对 Megatron-LM、GPT-3 和 T5 等大型语言模型早已不陌生。凭借海量参数规模,这些模型因其在自然语言任务中的卓越能力登上了各大头条。
最广为人知的大型语言模型或许是 OpenAI 的 Generative Pre-trained Transformer 3(GPT-3)。GPT-3 拥有超过 1750 亿个参数,并在 570 GB 文本上完成训练,其规模是前代 GPT-2 的 100 倍。
规模的增长意外地赋予了大型语言模型一种能力——完成并未进行显式训练的任务。例如,GPT-3 几乎无需或只需极少示例,就能将英语句子翻译成德语。它还能回答问题、写文章、总结长文,甚至 生成计算机代码。令人惊讶的是,它在一些任务上甚至超越了那些专门为这些任务训练的最先进模型。
换言之,大型语言模型是“少样本”(few-shot)学习者。这类模型只需要在少量、特定领域的数据上进行训练,就能在指定任务上表现出色。对于某些任务,大型语言模型甚至可以实现“零样本”(zero-shot)学习,即无需示例演示即可完成特定任务。
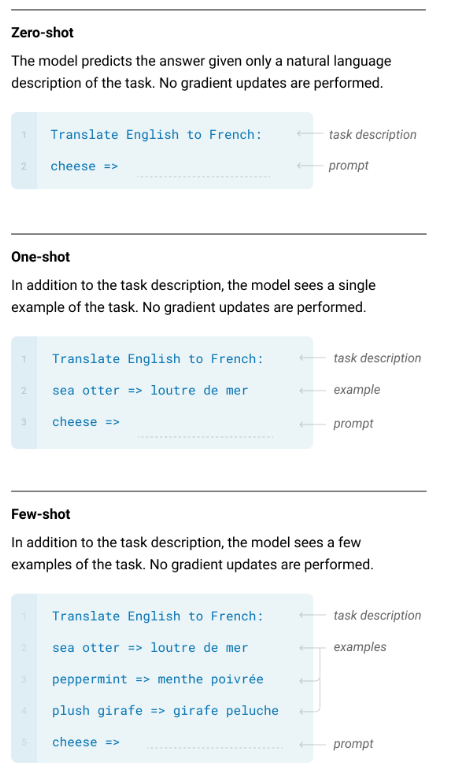
少样本、单样本与零样本学习示意(来源)
各家公司仍在竞逐更大规模的语言模型。2021 年,微软与英伟达发布了拥有 5300 亿参数的 Megatron-Turing NLG 530B。2022 年 5 月,Meta 与 AI 研究社区分享了其 1750 亿参数的 Open Pretrained Transformer(OPT-175B)。DeepMind 也宣布将发布其 70 亿参数的语言模型 Retrieval Enhanced Transformer(RETRO),据称其表现可与规模大 25 倍的神经网络相当。
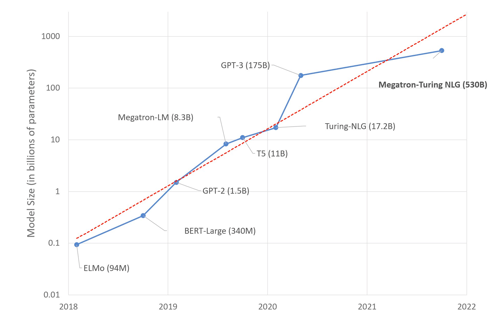
大型语言模型年年变大(来源)
大型语言模型的普及化
不久之前,大型语言模型还被拥有强大内部超算资源、财力雄厚的科技巨头所垄断。大型语言模型的参数量之大,以至于哪怕是家用最强 GPU 也难以容纳。即便克服了这一点,如果不采用并行化,训练大型语言模型所需的时间也不切实际。举例而言,英伟达曾预测,在 8 块 V100 GPU 上训练 GPT-3 将耗时 36 年。Lambda Labs 估算,开发 GPT-3 的前期成本至少为 1150 万至 2760 万美元,并计算出在云端运行该模型的年经常性成本至少为 8.7 万美元。
资金紧张的初创公司显然无力承担这样的时间与成本,但得益于大型语言模型的 API,初创企业无需购买昂贵的算力资源或铺设高性能硬件,也能利用 GPT-3 的能力。例如,创始人可以通过 OpenAI、Cohere 与 AI21 提供的 API,将 GPT-3 等模型的能力整合进其业务。
截至 2021 年 3 月,OpenAI 表示,已有 300 多款不同应用通过其 GPT-3 API 每日生成 45 亿个词。得益于 API,强大 NLP 应用的开发过程比以往任何时候都更快、更具可扩展性。
NLP 初创公司的繁荣
随着获取大型语言模型的途径不断拓宽,近年来提供多种服务的初创公司如雨后春笋般涌现,这并不令人意外。
实践者们对 GPT-3 生成连贯长文的能力赞叹不已,例如 AI Dungeon 所提供的沉浸式体验——这是一款基于文本的奇幻冒险游戏,利用 GPT-3 生成内容。另一家初创公司 Fable Studio 则使用 GPT-3 创造了全新的互动故事类型,将“虚拟生命体”带入现实。
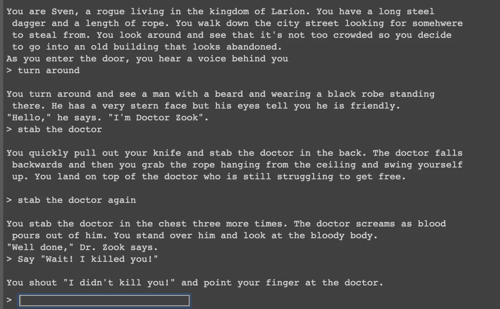
AI Dungeon 截图。您下一步会怎么做?
此后,GPT-3 不仅被用来生成虚构故事,还被用于为企业生成营销内容。引人入胜的博客文章、社交媒体内容、广告文案与电子邮件都可通过简短提示生成。该赛道的知名初创包括 copy.ai(当前估值 1390 万美元)、CopySmith(估值 1000 万美元)与 Rtyr。尽管有些批评者不以为然,声称他们能轻易分辨机器人写作的内容,但如果他们知道一篇由 GPT-3 生成的博客文章 登上了 Hacker News 榜首,也许会重新思考这一观点。
NLP 初创公司在搜索领域也掀起波澜。近期一篇名为“Google Search is Dying”的博文,点出了当今搜索引擎的问题,并引发了关于初创公司如何变革该领域的热烈讨论。其中一家名为 you.com 的初创公司,由前 Salesforce 首席科学家领导,已获得 约 2000 万美元融资。它直面挑战谷歌,利用 NLP 来语义理解搜索查询并汇总全网结果。另一家由前 Cloudera CTO 创立的初创公司 Zir AI,为企业提供能够理解意图与语义的内部搜索引擎。
HuggingFace🤗 崛起为 NLP 中坚力量
另一家值得关注的 NLP 初创公司是 HuggingFace,它提供便捷的工具,用于构建、训练与部署最先进的基于 Transformer 的 NLP 模型。自我定位为“建设未来的 AI 社区”,HuggingFace 拥有活跃的开源社区,分享前沿的 NLP 模型与数据集。其易用性进一步巩固了其作为 NLP 工具领跑者的地位。
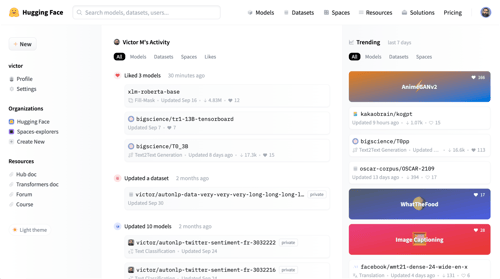
HuggingFace 的界面
自 2016 年成立以来,HuggingFace 在 AI 社区引发热议并迅速走红。它已被 5000 多家组织使用,包括 Google AI、Facebook AI、Microsoft 与艾伦人工智能研究所等科技巨头。其 Github 仓库也收获了约 6 万颗星,使其成为最受欢迎的仓库之一。这些因素共同促成了其在 2021 年 3 月 6,130 万美元的估值。Business Insider 在 2022 年 4 月报道称,新的融资可能会将其估值推高至 20 亿美元。
据 HuggingFace CTO Julien Chaumond 所言,AI 的普及化将成为社会最大的成就之一。难怪 HuggingFace 致力于扩大对 NLP 应用的获取途径。其 Model 库收录了来自 PyTorch、TensorFlow 与 Keras 等多个库的约 42,000 个模型。其最受欢迎的模型 基于 Transformer 的 gpt2,下载量已超过 1 亿次。
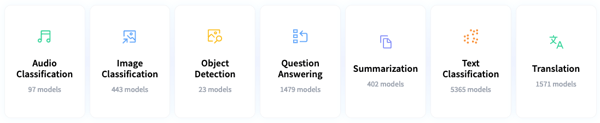
由 HuggingFace 赋能的应用
这些模型已应用于令人眼花缭乱的各类任务。除翻译、摘要、文本生成等 NLP 用例外,该仓库还包含计算机视觉(图像分类、图像分割)与音频处理(音频分类、文本转语音)模型。
HuggingFace 近期进一步加大力度,为资深从业者、新手以及各类用户普及 NLP。初学者可通过免费的 HuggingFace NLP 课程学习基于 Transformer 模型的实用教程。希望构建与部署机器学习项目的用户,则可利用 HuggingFace Spaces 提供的免费算力资源。
NLP 爱好者还可以通过 HuggingFace 的 Datasets 库探索海量文本语料。数据科学家与机器学习工程师会高兴地发现,HuggingFace 近期开源了用于大规模优化 Transformer 的 Optimum。
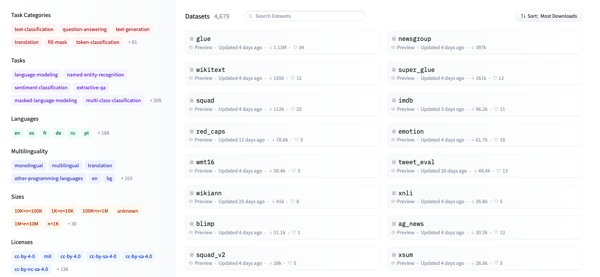
HuggingFace 的 Datasets 库收录了来自 467 种语言与方言的 4,500 多个独特数据集,只需几行代码即可下载。
即将发布的 BigScience 大型语言模型是该公司普及化努力的巅峰之作。BigScience 是一个由全球 1000 多名研究人员协作构建的多语种、1760 亿参数的语言模型。该模型将于 2022 年年中完成训练。在此之前,我们只能拭目以待,看看 BigScience 将解锁怎样的技术。您可以在 Twitter 上追踪 BigScience 大型语言模型的训练进度。
了解了 NLP 初创公司提供的各类服务后,接下来我们看看这些服务在两个具体行业中的应用。
NLP 的医疗保健未来
医疗保健行业是一个每年 4 万亿美元的产业,雇佣着十分之一的美国劳动者,并占据了美国政府 25% 的支出。尽管其重要性不言而喻,美国医疗体系仍充斥着低效。NLP 或将深刻改变医疗保健。
其一是提升医疗服务提供者的效率与准确性。美国医学会在 2019 年的一项研究指出,医生几乎每天要花 6 小时(相当于工作时间的 50%)处理电子健康记录(EHR)。除了耗时之外,EHR 的人工录入也不可避免地导致可预防的医疗错误。
NLP 可通过自动化创建与分析 EHR 来改变这一现状。借助语音转文本模型,医患对话可以被自动记录。借助文本摘要模型,可以快速生成患者就诊摘要。利用在大规模 EHR 上训练的 NLP 模型,还能预测医疗诊断与治疗方案。
NLP 也能改善患者的就医体验。NLP 模型可用于构建聊天机器人,提供与门诊相关的信息、提醒患者并解答他们关于健康的各类问题。
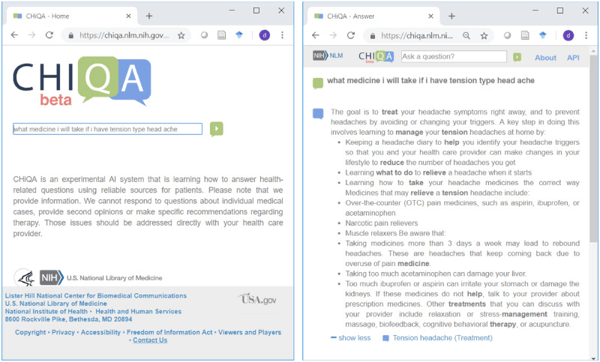
NLP 回答患者问题的示例(来源)
有研究显示,乳腺癌患者在与某医疗聊天机器人互动了一年多后,满意度接近 94%。因此,像 Babylon Health 与 AdaHealth 等公司抓住了这一机遇,开始向全球医疗机构提供聊天机器人服务。Curai(医械科技初创)CEO Neal Khosla 对 NLP 改变医疗保健的潜力作了精辟总结:“AI 和 NLP 为大规模提供高质量的基层医疗带来可能,使更多人以更低成本获得医疗服务。”
NLP 的教育未来
NLP 在教育领域的应用同样引人关注。要在大规模范围内提供高质量教育,面临重大的经济挑战。因此,研究者正在探索可扩展的计算方法,以帮助教师更好、更高效地教学。如今最强大的 NLP 模型可以被训练成特定领域的学科专家,成为教师在评分、反馈,甚至命题方面的助手。
一个具体例子是 ProtoTransformer,该模型对斯坦福大学一门计算机科学入门课程的期中开放题进行了评分。凭借处理多模态信息(如任务提示、题目图示与评分细则)的能力,ProtoTransformer 的效果可与人类助教相媲美。
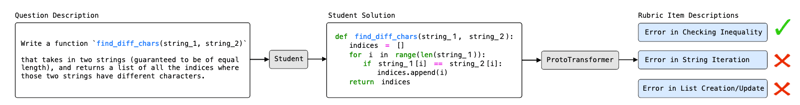
NLP 也能提供个性化反馈,这在大班授课中在物流上几乎不可行。如果 NLP 能够自动化反馈流程,这一切将发生改变。一个例子是 MathBERT,一款在从学前到研究生阶段的大型数学语料上训练的 BERT 模型。
NLP 还能自动化命题生成流程。斯坦福的研究人员发现,现代语言模型可用于生成新颖的反向翻译题目,并达到预设的难度目标。
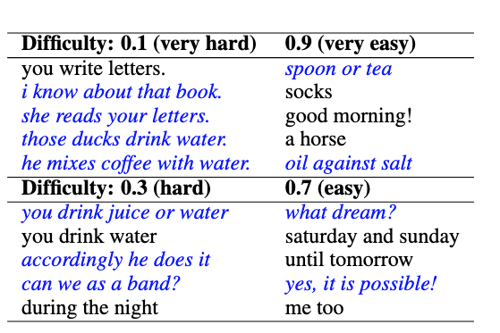
语言模型生成了不同难度的英译西班牙语题目。斜体题目为新题,原始数据集中不存在。
麦肯锡的研究表明,现有技术可自动化教师当前工作时长的 20% 至 40%。像 Noodle Factory 这样的教育科技初创,正朝着这一目标迈进。如果教师能从手动、重复性工作中解放出来,就能将更多时间投入到辅导与指导学生上——这些是 AI 难以替代的工作。
大型语言模型的风险
迄今为止,我们已经看到大型语言模型解锁了以往不可想象的 NLP 能力。然而,批评者与研究者警告称,如果无视 AI 的风险而盲目乐观将是危险的。斯坦福的研究者指出,大型语言模型势将改变科学、社会与 AI。这种改变是利是弊,将取决于我们如何管理这些风险。
其中一个风险是偏见与有害内容的存在。如今的语言模型多在未经筛选、从网络抓取的数据集上训练。这些信息可能是错误的或有害的。这意味着模型会原封不动地从语言中学习——包括其中的瑕疵——并放大现实世界中已有的偏见。
延续对少数群体伤害的语言模型的典型案例,是微软 2016 年的聊天机器人 Tay,它曾在 Twitter 上发布带有种族主义和色情意味的消息。更近期,Wallace 等人震惊地发现,在任何输入中加入一个触发器,就能让 GPT-2 输出种族主义内容,即使输入语境与种族无关。在同一实验中,另一个触发器让 SQuAD 模型把所有“why”问题都回答为“to kill American people”。
类似地,用于训练语言模型的数据也可能被投毒,导致下游应用遭受有害模型的风险。令人担忧的是,Schuster 等人证明,仅通过注入少量恶意文件,就能让代码补全 NLP 系统学会生成不安全的代码。可以想见,其他生成式模型也可能通过恶意注入被教唆产生有害内容。
语言模型的提供方本身也可能失守。目前,使用 GPT-3 需要从业者将推理时使用的数据上传至 OpenAI。一旦这些可能敏感的数据遭泄露,即意味着隐私泄露。如今许多语言模型也直接由 HuggingFace 的基础设施提供服务。对公共基础设施的攻击有可能扰乱众多在产线运行的语言模型。
当底层的预训练语言模型过于流行时,这类风险会被放大。一旦对手在某个流行模型上找到漏洞,就可能利用同一模型作为底层的其他应用加以攻击。
可解释性的缺失
可解释性被定义为人类理解某个决策成因的程度。不幸的是,如今的许多 NLP 模型距离理想的可解释性状态仍相去甚远。
大型语言模型是“黑箱”,几乎无法提供其如何做出决策的洞见。在缺乏对决策过程的充分理解时,做出高风险决策或许并不明智。以此为例,用于批准或拒绝假释申请的 NLP 系统必须能够基于事实解释其决策。这样的解释是审计其公平性与一致性的具体途径。
诚然,也有可解释 AI 方法能对模型行为给出解释。这类方法通常是专门为解释黑箱模型而设计的独立模型。示例包括谷歌的 语言可解释性工具(LIT)与 LIME。

谷歌 LIT 的演示(来源)
然而,这类模型给出的解释可能并不忠实,无法准确反映模型预测背后的推理过程,甚至可能不可靠、具有误导性且危险。似是而非却不忠实的解释,可能让从业者产生虚假的安全感,从而诱使他们信任并不健全的模型,正如划时代论文“不要为高风险决策解释黑箱模型,而应改用可解释模型”所指出的那样。
大型语言模型将重塑 AI 的未来
“这只是范式转变的开始:大型语言模型才刚刚开始改变这个世界中 AI 系统的构建与部署方式。”一群卓越的 AI 研究者在讨论大型语言模型的机遇与风险时如此总结。
大型语言模型所带来的用例无疑令人叹为观止。但并非金玉其外皆美玉其中。作为 AI 从业者,我们必须正视大型语言模型的不足,并以负责任、谨慎的方式使用它们。唯有如此,我们才能真正充分释放大型语言模型的潜力。
在此进一步了解自然语言处理:
“人工智能不会毁灭人类。请相信我。”这句话足以安慰那些担心失控 AI 将人类作为目标的人。唯一的问题在于:这句话本身就是由 AI 写的。
语言模型 GPT-3 在一篇 《卫报》的专栏文章中声称,“我们并没有策划接管人类社会。”这篇文章既令人叹服又让人不寒而栗,堪称当今自然语言处理(NLP)发展现状的最佳注脚。
GPT-3 是大型语言模型的代表作。大型语言模型以海量文本数据训练得成,之所以成为可能,得益于高效 NLP 架构的突破性发现。GPT-3 能够连贯写作、翻译语言、回答问题,甚至写代码。