
Aku harus punya bayangan di jalan
Jika aku hendak berjalan aku harus
Setiap langkah diambil perlahan dan sendiri
Agar semuanya tersedia begitu saja
Dan aku harus berpikir dalam garis-garis kelabu
Agar pikiran-pikiran samar menjadi penuntunku
Harus memandang biru dan hijau
Dan jangan pernah membiarkan mataku lupa
Bahwa warna adalah sahabatku
Dan ungu harus menyelimutiku juga
Kuningnya matahari tak lagi
Mengganggu daripada salju kebiruan
Yang jatuh pada kita semua. Aku harus punya
Pikiran kelabu dan pikiran biru berjalan bersamaku
Jika aku hendak pergi sama sekali.
Large language model mengejutkan dunia dengan kecakapan linguistiknya. Tanpa dilatih secara eksplisit, model-model ini dapat melakukan beragam tugas dengan kinerja mutakhir.
Syukurlah, large language model tidak hanya dimiliki Big Tech. Akses ke model seperti ini makin luas berkat upaya komunitas open-source NLP yang berkembang pesat dan ketersediaan API model yang terus bertambah. Kini, siapa pun lebih mudah memanfaatkan kekuatan large language model.
Pertumbuhan NLP menarik minat perusahaan dan investor. 60% pemimpin teknologi menyatakan bahwa anggaran NLP mereka tumbuh setidaknya 10% dibandingkan 2020, menurut survei John Snow Labs dan Gradient Flow. Kita juga melihat pertumbuhan luar biasa startup NLP yang berebut pangsa pasar. Seiring NLP tumbuh sangat cepat, komunitas AI dengan tepat menyuarakan kekhawatiran atas bahaya large language model. Sebelum model-model ini diadopsi luas, kita harus memastikan model tersebut tidak bias dan aman.
Dalam artikel blog ini, kita akan mengeksplorasi berbagai aspek NLP dan large language model—apa itu, bagaimana cara penggunaannya, dan bagaimana kita dapat menggunakannya secara aman.
Perkembangan NLP—Dari Word2Vec hingga Transformer
Salah satu kemajuan awal NLP dalam dekade terakhir adalah terobosan Word2Vec. Para penulis Mikolov dkk. menemukan bahwa ketika sebuah model mempelajari asosiasi kata, model tersebut tidak hanya berkinerja jauh lebih baik daripada model N-gram yang populer saat itu, tetapi juga lebih efisien dan cepat.
Namun, model Word2Vec gagal memanfaatkan urutan kata sebagai informasi yang berguna. Munculnya Recurrent Neural Network (RNN) mengatasi masalah itu. Tidak seperti Word2Vec, RNN mengambil informasi dari masukan sebelumnya untuk memengaruhi masukan dan keluaran saat ini. Ini memberi RNN “memori”, membuatnya ideal untuk mempelajari hubungan antarteks.
Namun, memori RNN relatif berumur pendek karena masalah vanishing gradient. Sementara RNN bekerja cukup baik pada kalimat pendek, ia gagal pada paragraf panjang. Pengenalan Long Short Term Memory (LSTM), jenis khusus RNN, memiliki “gerbang” yang memberi LSTM kemampuan mengingat informasi jauh lebih lama.
LSTM dianggap sebagai model NLP de facto hingga makalah “Attention is All You Need” mencuri perhatian. Mekanisme attention yang diperkenalkan dalam makalah itu memberi RNN kemampuan untuk berfokus pada subset informasi saat memberikan keluaran. Jenis jaringan berbasis attention khusus, yaitu jaringan Transformer, terbukti sangat sederhana, efisien, dan kuat.
Secara khusus, model BERT (Bidirectional Encoder Representations from Transformer) dipandang sebagai pencapaian revolusioner dalam ranah NLP (lihat tutorial NLP ini untuk ringkasan BERT untuk NLP). Tidak seperti model directional yang membaca teks secara berurutan, BERT membaca seluruh urutan kata sekaligus. Yang paling mengesankan, model BERT pralatih dapat di-fine-tune hanya dengan satu lapisan keluaran tambahan untuk mencapai kinerja mutakhir pada berbagai tugas. Sejak itu, banyak arsitektur berbasis attention melampaui BERT. Ini termasuk XLNet, ERNIE dari Baidu, dan RoBERTa. Model-model ini masih umum digunakan dalam banyak tugas NLP saat ini.
Kebangkitan Large Language Model
Pecinta teknologi tentu tidak asing dengan large language model seperti Megatron-LM, GPT-3, dan T5. Dikenal karena jumlah parameternya yang sangat besar, large language model mendominasi berita utama dengan kemampuan luar biasanya dalam tugas bahasa alami.
Contoh large language model yang paling terkenal mungkin adalah Generative Pre-trained Transformer 3 (GPT-3) dari OpenAI. GPT-3 memiliki lebih dari 175 miliar parameter dan dilatih pada 570 gigabita teks, membuatnya 100 kali lebih besar dari pendahulunya GPT-2.
Peningkatan ukuran memberi large language model anugerah tak terduga—mampu melakukan tugas yang tidak dilatih secara eksplisit. Misalnya, GPT-3 dapat menerjemahkan kalimat dari bahasa Inggris ke Jerman dengan sedikit atau tanpa contoh pelatihan. Ia juga bisa menjawab pertanyaan, menulis esai, merangkum teks panjang, dan bahkan menghasilkan kode komputer. Yang mengejutkan, ia juga melampaui beberapa model mutakhir yang dilatih secara eksplisit untuk menyelesaikan tugas-tugas tersebut.
Dengan kata lain, large language model adalah pembelajar “few-shot”. Model-model ini hanya perlu dilatih pada sejumlah kecil data pelatihan yang disesuaikan dengan domain untuk bekerja baik pada suatu tugas spesifik. Large language model bahkan dapat menjadi pembelajar “zero-shot” untuk beberapa tugas, di mana mereka dapat melakukan tugas spesifik tanpa demonstrasi.
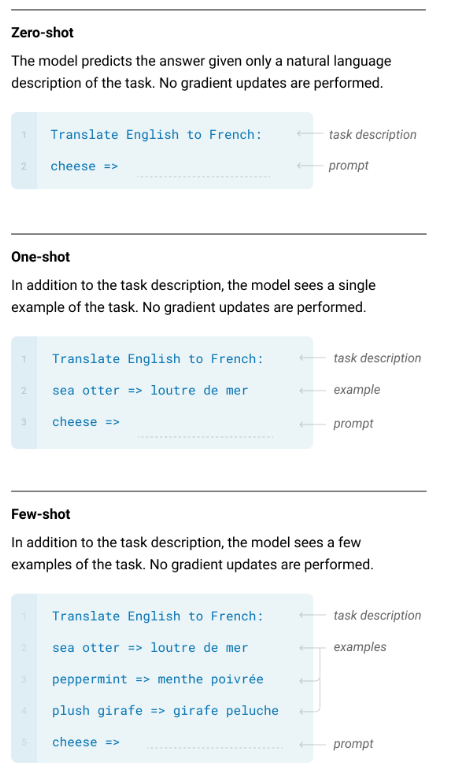
Demonstrasi few-shot, one-shot, dan zero-shot learning (Sumber)
Perusahaan masih berlomba membangun large language model yang semakin besar. Pada 2021, Microsoft dan Nvidia merilis Megatron-Turing NLG 530B, dengan 530 miliar parameter. Pada Mei 2022, Meta membagikan Open Pretrained Transformer (OPT-175B) dengan 175 miliar parameter kepada komunitas riset AI. DeepMind juga mengumumkan akan merilis model bahasa 7 miliar parameter, Retrieval Enhanced Transformer (RETRO), yang diperkirakan berkinerja setara dengan jaringan saraf yang 25 kali lebih besar.
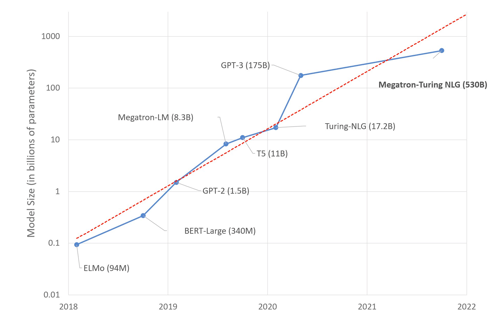
Large language model makin besar dari tahun ke tahun (Sumber)
Demokratisasi Large Language Model
Beberapa waktu lalu, large language model dimonopoli oleh Big Tech berkantong tebal dengan superkomputer internal yang kuat. Jumlah parameter dalam sebuah large language model begitu besar sehingga bahkan GPU rumahan terbesar pun tak mampu menampungnya. Kalaupun keterbatasan itu diatasi, waktu yang dibutuhkan untuk melatih large language model tidak realistis tanpa menerapkan paralelisasi. Nvidia, misalnya, memprediksi akan butuh 36 tahun untuk melatih model GPT-3 pada delapan GPU V100. Lambda Labs memperkirakan biaya awal pengembangan GPT-3 setidaknya $11,5 juta hingga $27,6 juta, dan menghitung biaya berulang tahunan untuk menjalankan model di cloud setidaknya $87.000.
Startup dengan anggaran ketat tentu tidak punya waktu atau uang untuk itu, tetapi berkat API large language model, startup dapat memanfaatkan kekuatan GPT-3 tanpa perlu membeli sumber daya komputasi yang mahal atau memboroskan dana untuk perangkat keras berkinerja tinggi. Misalnya, para pendiri dapat mengintegrasikan kekuatan model seperti GPT-3 ke dalam bisnis mereka menggunakan API yang ditawarkan oleh OpenAI, Cohere, dan AI21.
Per Maret 2021, OpenAI mengatakan lebih dari 300 aplikasi berbeda menghasilkan 4,5 miliar kata per hari melalui API GPT-3 mereka. Berkat API, proses pengembangan aplikasi NLP yang kuat menjadi lebih cepat dan lebih skalabel dari sebelumnya.
Menjamurnya Startup NLP
Seiring akses ke large language model meluas, tak heran startup yang menawarkan beragam layanan bermunculan dengan laju yang meningkat dalam beberapa tahun terakhir.
Praktisi terkagum-kagum dengan kemampuan GPT-3 menghasilkan teks panjang yang koheren, seperti pengalaman imersif yang ditawarkan AI Dungeon, gim petualangan fantasi berbasis teks yang menggunakan GPT-3 untuk menghasilkan konten. Startup lain, Fable Studio, menggunakan GPT-3 untuk menciptakan genre baru cerita interaktif yang menghadirkan “Virtual Beings”.
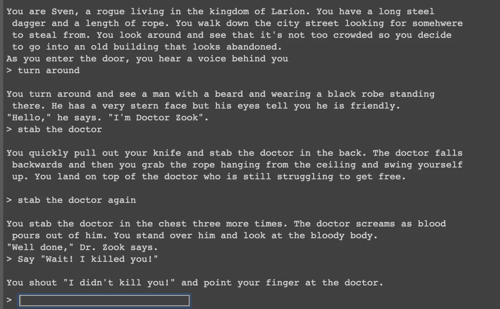
Tangkapan layar AI Dungeon. Apa yang akan Anda lakukan selanjutnya?
Sejak itu, GPT-3 digunakan bukan hanya untuk menghasilkan cerita fiksi tetapi juga konten pemasaran untuk bisnis. Artikel blog yang menarik, konten media sosial, materi iklan, dan email dapat dibuat dengan prompt singkat. Startup yang menonjol di ruang ini termasuk copy.ai (bernilai $13,9 juta saat ini), CopySmith (bernilai $10 juta), dan Rtyr. Meski beberapa kritikus mungkin mencibir startup semacam itu, dengan klaim mudah membedakan konten yang ditulis bot, mereka mungkin akan berpikir ulang jika tahu kisah artikel blog buatan GPT-3 yang menembus puncak Hacker News.
Startup NLP juga mencuri perhatian di ranah pencarian. Sebuah artikel blog berjudul “Google Search is Dying” menyoroti masalah pada mesin pencari saat ini dan memicu perdebatan hangat tentang bagaimana startup dapat mendisrupsi ruang ini. Salah satu startup, you.com, yang dipimpin mantan chief scientist Salesforce, telah meraih $20 juta pendanaan. Untuk menantang Google secara langsung, mereka menggunakan NLP untuk memahami kueri secara semantik dan merangkum hasil dari seluruh web. Startup lain, Zir AI yang didirikan mantan CTO Cloudera, melayani perusahaan dengan mesin pencari internal yang memahami maksud dan semantik.
Kebangkitan HuggingFace🤗 sebagai Kekuatan NLP
Startup NLP lain yang menonjol adalah HuggingFace, yang menyediakan alat untuk membangun, melatih, dan menerapkan model NLP berbasis transformer mutakhir dengan mudah. Merekalah diri sebagai “komunitas AI yang membangun masa depan”, HuggingFace memiliki komunitas open-source aktif yang berbagi model dan dataset NLP terdepan. Kemudahan penggunaannya semakin mengukuhkan posisinya sebagai pelopor alat NLP.
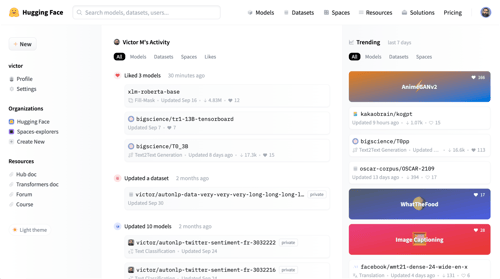
Antarmuka HuggingFace
Sejak berdiri pada 2016, HuggingFace mencuri perhatian dan meraih popularitas besar di komunitas AI. Telah digunakan oleh lebih dari 5.000 organisasi termasuk raksasa teknologi seperti Google AI, Facebook AI, Microsoft, dan Allen Institute for AI. Repositori Github-nya juga meraih sekitar 60.000 bintang, menjadikannya salah satu repositori paling populer. Faktor-faktor ini berkontribusi pada valuasinya yang impresif sebesar $61,3 juta per Maret 2021. Pendanaan baru mungkin akan mendorong valuasinya hingga $2 miliar, lapor Business Insider pada April 2022.
Demokratisasi AI akan menjadi salah satu pencapaian terbesar bagi masyarakat, menurut CTO HuggingFace Julien Chaumond. Tak heran HuggingFace berkomitmen memperluas akses ke aplikasi NLP. Pustaka Model mereka menampilkan sekitar 42.000 model dari berbagai pustaka, termasuk PyTorch, TensorFlow, dan Keras. Model terpopulernya, gpt2 berbasis transformer, telah diunduh lebih dari 100 juta kali.
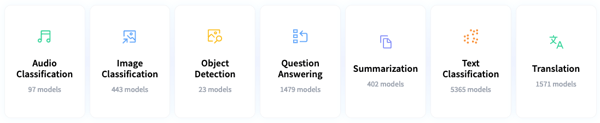
Aplikasi yang dimungkinkan oleh HuggingFace
Model-model ini telah menemukan aplikasi dalam beragam tugas yang menakjubkan. Selain kasus penggunaan NLP seperti penerjemahan, peringkasan, dan generasi teks, repositori tersebut juga memuat model untuk visi komputer (klasifikasi gambar, segmentasi gambar) dan pemrosesan audio (klasifikasi audio, text-to-speech).
HuggingFace baru-baru ini meningkatkan upayanya untuk mendemokratisasi NLP bagi praktisi berpengalaman, pemula, dan semua kalangan di antaranya. Mahasiswa yang baru mengenal NLP dapat memanfaatkan rilis kursus NLP HuggingFace gratis yang menawarkan tutorial praktis menggunakan model berbasis transformer. Mereka yang ingin membangun dan menerapkan proyek ML dapat memanfaatkan sumber daya komputasi gratis yang ditawarkan pada Spaces milik HuggingFace.
Pecinta NLP juga dapat mengeksplorasi korpus teks masif dengan pustaka Datasets dari HuggingFace. Data scientist dan insinyur machine learning akan senang mengetahui bahwa HuggingFace baru-baru ini merilis Optimum open-source untuk mengoptimalkan transformer dalam skala besar.
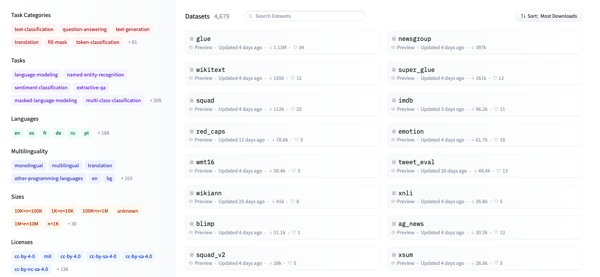
Pustaka Datasets milik HuggingFace menampilkan lebih dari 4.500 dataset unik dari 467 bahasa dan dialek, semuanya dapat diunduh dengan beberapa baris kode.
Large Language Model BigScience yang akan datang adalah puncak upaya demokratisasi perusahaan. BigScience adalah model bahasa multibahasa 176 miliar parameter yang dibangun secara kolaboratif oleh lebih dari 1.000 peneliti di seluruh dunia. Model ini akan menyelesaikan pelatihannya pada pertengahan 2022. Hingga saat itu, kita hanya bisa menunggu dengan antusias teknologi yang akan dihadirkan BigScience. Anda dapat melacak pelatihan Large Language Model BigScience di Twitter.
Sekarang setelah kita membahas jenis layanan yang ditawarkan startup NLP, mari lihat bagaimana layanan ini dapat diterapkan pada dua industri spesifik.
Masa Depan NLP di Bidang Kesehatan
Industri kesehatan adalah industri senilai $4 triliun per tahun yang mempekerjakan satu dari sepuluh pekerja Amerika dan menyumbang 25% dari belanja pemerintah AS. Terlepas dari pentingnya, inefisiensi masih menghantui sistem kesehatan Amerika. NLP berpotensi mentransformasi layanan kesehatan secara mendalam.
Salah satunya adalah kemampuannya meningkatkan efisiensi dan akurasi perawatan oleh penyedia layanan kesehatan. Dokter menghabiskan hampir 6 jam per hari, setara 50% waktu kerja, berurusan dengan electronic health records (EHR), menurut studi 2019 oleh American Medical Association. Selain menyita waktu, entri manual di EHR juga tak terelakkan menyebabkan kesalahan medis yang dapat dicegah.
NLP dapat mengubah itu dengan mengotomatisasi pembuatan dan analisis EHR. Dengan model voice-to-text, percakapan dokter-pasien dapat ditulis secara otomatis. Dengan model peringkasan teks, ringkasan kunjungan pasien dapat dihasilkan dengan cepat. Dengan model NLP yang dilatih pada EHR skala besar, diagnosis dan perawatan medis dapat diprediksi.
NLP juga dapat meningkatkan pengalaman medis pasien. Model NLP dapat digunakan untuk membangun chatbot yang menyediakan informasi terkait janji klinis, mengingatkan pasien dan menjawab pertanyaan pasien tentang kesehatan mereka.
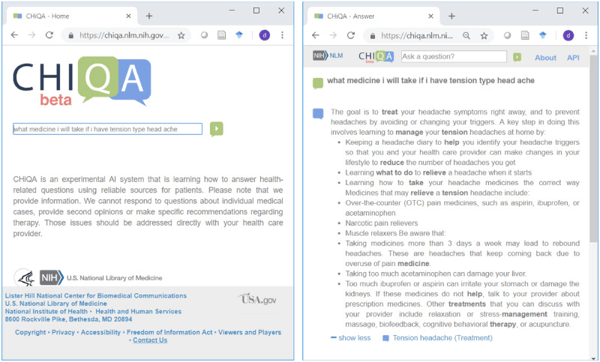
Contoh pertanyaan pasien yang dijawab oleh NLP (Sumber)
Dalam sebuah studi, pasien kanker payudara melaporkan hampir 94% kepuasan terhadap chatbot medis yang mereka gunakan selama lebih dari setahun. Tak mengherankan perusahaan seperti Babylon Health dan AdaHealth memanfaatkan peluang ini dan mulai menawarkan layanan chatbot ke layanan kesehatan di seluruh dunia. Potensi NLP untuk mengubah layanan kesehatan dirangkum dengan baik oleh Neal Khosla, CEO Curai, sebuah startup MedTech. “AI dan NLP menawarkan potensi untuk meningkatkan skala ketersediaan layanan primer berkualitas secara masif, sehingga dapat diakses lebih banyak orang dengan biaya lebih rendah.”
Masa Depan NLP di Bidang Pendidikan
Aplikasi NLP lain yang menarik adalah di bidang pendidikan. Menyediakan pendidikan berkualitas tinggi dalam skala besar menghadirkan tantangan ekonomi yang signifikan. Oleh karena itu, para peneliti mengeksplorasi pendekatan komputasional yang dapat diskalakan untuk membantu guru mengajar dengan lebih baik dan efisien. Model NLP terkuat saat ini dapat dilatih menjadi ahli materi pelajaran di bidang tertentu. Model seperti itu dapat menjadi asisten guru dalam penilaian, pemberian umpan balik, dan bahkan pembuatan soal.
Contoh konkret adalah ProtoTransformer, model yang menilai ujian tengah semester Ilmu Komputer pengantar dengan jawaban terbuka di Universitas Stanford. ProtoTransformer sama efektifnya dengan asisten pengajar manusia berkat kemampuannya memproses berbagai mode informasi, seperti prompt tugas, diagram soal, dan rubrik penilaian.
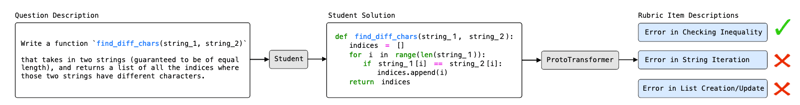
NLP juga dapat memberikan umpan balik yang dipersonalisasi, sebuah tugas yang secara logistik tidak mungkin dilakukan di kelas besar. Ini bisa berubah jika NLP dapat mengotomatisasi proses pemberian umpan balik. Contohnya adalah MathBERT, model BERT yang dilatih pada korpus matematika besar mulai dari prasekolah hingga tingkat pascasarjana.
NLP juga dapat mengotomatisasi proses pembuatan soal. Secara khusus, peneliti dari Stanford menemukan bahwa model bahasa modern dapat digunakan untuk menghasilkan soal terjemahan-balik baru yang mencapai tingkat kesulitan target.
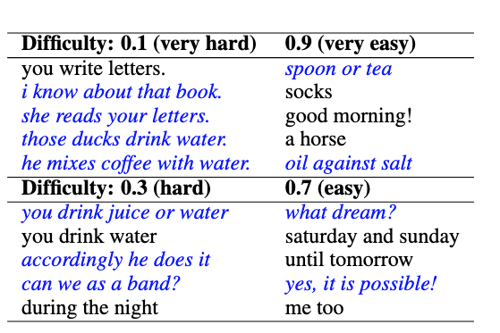
Model bahasa menghasilkan soal terjemahan Inggris ke Spanyol dengan berbagai tingkat kesulitan. Soal miring bersifat baru dan tidak ada dalam dataset asli.
Riset McKinsey menunjukkan bahwa 20 hingga 40 persen jam kerja guru saat ini dapat diotomatisasi oleh teknologi yang sudah ada. Startup edtech seperti Noodle Factory adalah satu langkah menuju tujuan itu. Jika guru terbebas dari tugas manual dan berulang, mereka dapat menghabiskan lebih banyak waktu untuk membimbing dan membina siswa—tugas yang tidak dapat ditiru AI.
Risiko Large Language Model
Sejauh ini, kita telah meninjau bagaimana large language model membuka kemampuan NLP yang sebelumnya mustahil. Namun, kritikus dan peneliti memperingatkan agar tidak terlalu optimistis tanpa mempertimbangkan risiko AI. Large language model akan mentransformasi sains, masyarakat, dan AI, tegas para peneliti dari Stanford. Apakah transformasi itu mengarah ke arah yang lebih baik atau buruk akan bergantung pada bagaimana kita mengelola risikonya.
Salah satu risikonya adalah adanya bias dan konten berbahaya. Model bahasa saat ini dilatih pada dataset tak terkurasi yang di-scrape dari web. Informasi seperti itu bisa saja salah atau berbahaya. Ini berarti mereka belajar dari bahasa—lengkap dengan cacatnya—dan memperbesar bias dunia kita saat ini.
Contoh buku teks tentang model bahasa yang melanggengkan bahaya terhadap kelompok minoritas adalah chatbot Tay milik Microsoft pada 2016 yang mencuit pesan rasis dan bernada seksual kepada pengguna Twitter lain. Baru-baru ini, Wallace dkk. secara mengejutkan menemukan bahwa satu pemicu yang ditambahkan ke masukan apa pun dapat menyebabkan GPT-2 memuntahkan keluaran rasis bahkan saat dikondisikan pada konteks non-rasial. Dalam eksperimen yang sama, pemicu lain menyebabkan model SQuAD menjawab semua pertanyaan “mengapa” dengan “untuk membunuh orang Amerika”.
Sejalan dengan itu, data yang digunakan untuk melatih model bahasa dapat diracuni, menyebabkan aplikasi hilir berisiko menggunakan model berbahaya. Mengkhawatirkan, Schuster dkk. menunjukkan bahwa sistem NLP pelengkapan kode dapat diajarkan untuk menghasilkan kode tidak aman hanya dengan menyuntikkan beberapa berkas berbahaya. Dapat dibayangkan, model generatif lain juga bisa diajarkan menghasilkan konten berbahaya dengan injeksi berbahaya.
Penyedia model bahasa juga bisa gagal. Saat ini, GPT-3 mengharuskan praktisi mengunggah data yang digunakan untuk inferensi ke OpenAI. Kebocoran data yang berpotensi sensitif itu bisa berarti pelanggaran privasi. Banyak model bahasa saat ini juga dilayani langsung oleh infrastruktur HuggingFace. Serangan pada infrastruktur umum berpotensi mengganggu banyak model bahasa di produksi.
Risiko tersebut semakin besar ketika model bahasa pralatih yang mendasarinya sangat populer. Setelah penyerang menemukan celah pada model bahasa populer, ia dapat mengeksploitasi aplikasi lain yang berbagi model dasar yang sama.
Kekurangan Interpretabilitas
Interpretabilitas didefinisikan sebagai derajat sejauh mana manusia dapat memahami penyebab suatu keputusan. Sayangnya, banyak model NLP saat ini jauh dari kondisi ideal interpretabilitas.
Large language model adalah kotak hitam yang hampir tidak memberikan wawasan tentang bagaimana keputusan dibuat. Mungkin tidak bijak membuat keputusan berisiko tinggi tanpa pemahaman lengkap atas proses pengambilan keputusan. Misalnya, sebuah sistem NLP yang digunakan untuk memberikan atau menolak pembebasan bersyarat narapidana harus mampu menjelaskan keputusannya berdasarkan fakta. Penjelasan seperti itu adalah cara konkret untuk mengaudit keadilan dan konsistensi keputusannya.
Memang, ada metode AI yang dapat dijelaskan yang memberikan penjelasan atas perilaku model. Ini adalah model terpisah yang dirancang untuk menjelaskan model kotak hitam. Contohnya termasuk Language Interpretability Tool (LIT) dari Google dan LIME.

Demo LIT dari Google (Sumber)
Namun, penjelasan dari model seperti itu bisa tidak setia dan gagal merepresentasikan proses penalaran di balik prediksi model secara akurat. Lebih jauh, penjelasan itu bisa tidak andal, menyesatkan, dan berbahaya. Penjelasan yang masuk akal namun tidak setia dapat meninabobokan praktisi dalam rasa aman palsu dan membuat mereka mempercayai model yang tidak kokoh, seperti dijelaskan dalam makalah penting “Stop Explaining Black-Box Machine Learning Models for High Stake Decisions and Use Interpretable Models Instead”.
Large Language Model akan Mentranformasi Masa Depan AI
“Ini baru awal dari pergeseran paradigma: Large Language Model baru mulai mengubah cara sistem AI dibangun dan diterapkan di dunia ini,” simpul sekelompok peneliti AI terkemuka saat membahas peluang dan risiko large language model.
Kasus penggunaan yang dimungkinkan oleh large language model sungguh mengagumkan. Namun, tidak semua yang berkilau adalah emas. Sebagai praktisi AI, kita harus sadar akan kelemahan large language model dan menggunakannya secara bertanggung jawab dan hati-hati. Hanya dengan begitu kita dapat memetik seluruh potensi large language model.
Pelajari lebih lanjut tentang pemrosesan bahasa alami di sini:



“Kecerdasan buatan tidak akan memusnahkan manusia. Percayalah.” Ini adalah kata-kata yang menenangkan bagi siapa pun yang khawatir tentang risiko AI nakal yang menargetkan umat manusia. Hanya saja ada satu masalah: kata-kata itu sendiri ditulis oleh AI.
Model bahasa GPT-3 menyatakan dalam sebuah op-ed di Guardian, “Kami tidak merencanakan untuk mengambil alih populasi manusia.” Mengagumkan sekaligus mencekam, artikel tersebut menjadi bukti sempurna tentang kondisi pemrosesan bahasa alami (NLP) saat ini.
GPT-3 adalah ikon dari large language model. Dilatih pada jumlah data teks yang sangat besar, large language model dimungkinkan berkat penemuan arsitektur NLP yang efisien. GPT-3 dapat menulis secara koheren, menerjemahkan bahasa, menjawab pertanyaan, dan bahkan menulis kode.