
Tôi phải có những bóng tối trên đường đi
Nếu tôi muốn bước đi, tôi phải có
Mỗi bước đi chậm rãi và đơn độc
Để có nó được sắp sẵn
Và tôi phải nghĩ trong những đường nét xám
Để có những ý nghĩ mờ nhạt dẫn lối tôi
Phải nhìn vào xanh lam và xanh lục
Và đừng để mắt tôi quên
Rằng màu sắc là bạn của tôi
Và tím cũng phải vây quanh tôi
Vàng của mặt trời không còn
Gây khó chịu hơn bông tuyết xanh nhạt
Rơi xuống tất cả chúng ta. Tôi phải có
Những ý nghĩ xám và xanh đồng hành cùng tôi
Nếu tôi thực sự phải ra đi.
Các mô hình ngôn ngữ lớn đã làm cả thế giới sững sờ với năng lực ngôn ngữ của chúng. Dù không được huấn luyện tường minh, chúng có thể thực hiện đa dạng tác vụ với hiệu năng dẫn đầu.
May mắn thay, các mô hình ngôn ngữ lớn không chỉ nằm trong tay Big Tech. Thay vào đó, quyền tiếp cận đang được mở rộng nhờ cộng đồng mã nguồn mở NLP đang phát triển mạnh mẽ, cùng với sự phổ biến của các API mô hình. Giờ đây, bất kỳ ai cũng có thể khai thác sức mạnh của một mô hình ngôn ngữ lớn dễ dàng hơn bao giờ hết.
Sự phát triển của NLP đã thu hút sự quan tâm của cả doanh nghiệp lẫn nhà đầu tư. 60% lãnh đạo công nghệ cho biết ngân sách NLP của họ tăng ít nhất 10% so với năm 2020, theo khảo sát của John Snow Labs và Gradient Flow. Chúng ta cũng chứng kiến làn sóng bùng nổ các startup NLP tranh giành thị phần. Khi NLP tăng tốc chóng mặt, cộng đồng AI đã lên tiếng lo ngại về những nguy cơ từ các mô hình ngôn ngữ lớn. Trước khi các mô hình này được áp dụng rộng rãi, chúng ta phải đảm bảo chúng không thiên lệch và an toàn.
Trong bài viết này, chúng ta sẽ khám phá các khía cạnh của NLP và các mô hình ngôn ngữ lớn—chúng là gì, được sử dụng ra sao và cách dùng an toàn.
Tiến bộ của NLP—Từ Word2Vec đến Transformer
Một trong những bước tiến đầu tiên của NLP trong thập kỷ qua là đột phá của Word2Vec. Tác giả Mikolov và cộng sự phát hiện rằng khi một mô hình học liên hệ giữa các từ, nó không chỉ vượt trội đáng kể so với các mô hình N-gram phổ biến thời đó mà còn hiệu quả và nhanh hơn.
Tuy vậy, Word2Vec không tận dụng được thứ tự từ như một nguồn thông tin hữu ích. Sự ra đời của Mạng nơ-ron hồi quy (RNN) đã giải quyết vấn đề đó. Khác với Word2Vec, RNN lấy thông tin từ các đầu vào trước đó để ảnh hưởng đến đầu vào và đầu ra hiện tại. Điều này mang lại cho RNN “trí nhớ”, giúp nó lý tưởng để học mối quan hệ giữa các đoạn văn bản.
Tuy nhiên, “trí nhớ” của RNN khá ngắn do vấn đề tiêu biến gradient. RNN hoạt động khá tốt với câu ngắn nhưng thất bại với đoạn văn dài. Sự xuất hiện của Bộ nhớ ngắn dài hạn (LSTM), một dạng đặc biệt của RNN, có các “cổng” giúp LSTM ghi nhớ thông tin lâu hơn nhiều.
LSTM từng được xem là mô hình NLP tiêu chuẩn cho đến khi bài báo “Attention is All You Need” chiếm sóng. Cơ chế attention được giới thiệu trong bài cho phép RNN tập trung vào một phần thông tin con khi đưa ra đầu ra. Một dạng đặc biệt của mạng dựa trên attention, mạng Transformer, tỏ ra cực kỳ đơn giản, hiệu quả và mạnh mẽ.
Đặc biệt, BERT (Bidirectional Encoder Representations from Transformer) được xem là một thành tựu đột phá trong lĩnh vực NLP (xem hướng dẫn NLP này để nắm tổng quan về BERT cho NLP). Khác với các mô hình có hướng đọc tuần tự, BERT đọc toàn bộ chuỗi từ cùng lúc. Ấn tượng hơn cả, một mô hình BERT tiền huấn luyện có thể tinh chỉnh chỉ với một lớp đầu ra bổ sung để đạt hiệu năng dẫn đầu cho nhiều tác vụ. Kể từ đó, nhiều kiến trúc dựa trên attention đã vượt qua BERT, gồm XLNet, ERNIE của Baidu và RoBERTa. Những mô hình này vẫn được dùng rộng rãi trong nhiều tác vụ NLP ngày nay.
Sự trỗi dậy của các mô hình ngôn ngữ lớn
Những người đam mê công nghệ hẳn không xa lạ với các mô hình ngôn ngữ lớn như Megatron-LM, GPT-3 và T5. Nổi tiếng với số lượng tham số khổng lồ, các mô hình này liên tục lên trang nhất nhờ khả năng xử lý ngôn ngữ tự nhiên đáng kinh ngạc.
Ví dụ nổi tiếng nhất về mô hình ngôn ngữ lớn có lẽ là Generative Pre-trained Transformer 3 (GPT-3) của OpenAI. GPT-3 có hơn 175 tỷ tham số và được huấn luyện trên 570 GB văn bản, lớn gấp 100 lần người tiền nhiệm GPT-2.
Việc tăng kích thước đã mang lại cho các mô hình ngôn ngữ lớn một món quà bất ngờ—khả năng thực hiện những tác vụ mà chúng không được huấn luyện tường minh. Chẳng hạn, GPT-3 có thể dịch câu từ tiếng Anh sang tiếng Đức với rất ít hoặc không có ví dụ huấn luyện. Nó cũng có thể trả lời câu hỏi, viết tiểu luận, tóm tắt văn bản dài và thậm chí tạo mã máy tính. Đáng ngạc nhiên, nó còn vượt qua một số mô hình hiện đại được huấn luyện chuyên biệt cho những tác vụ đó.
Nói cách khác, các mô hình ngôn ngữ lớn là những “người học few-shot”. Chúng chỉ cần một lượng nhỏ dữ liệu huấn luyện phù hợp miền để đạt kết quả tốt cho một tác vụ cụ thể. Thậm chí, với một số tác vụ, chúng còn có thể “zero-shot”, tức thực hiện được mà không cần minh họa.
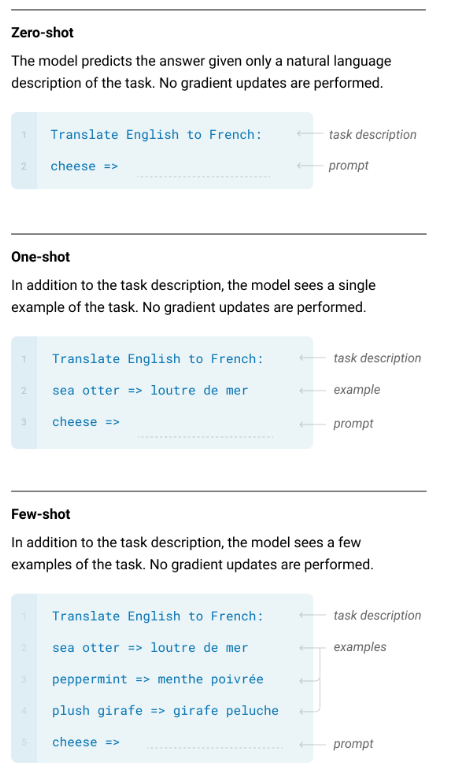
Minh họa học few-shot, one-shot và zero-shot (Nguồn)
Các công ty vẫn đang chạy đua xây dựng những mô hình ngôn ngữ lớn hơn nữa. Năm 2021, Microsoft và Nvidia ra mắt Megatron-Turing NLG 530B với 530 tỷ tham số. Tháng 5/2022, Meta chia sẻ Open Pretrained Transformer (OPT-175B) với cộng đồng nghiên cứu AI. DeepMind cũng thông báo sẽ phát hành mô hình 7 tỷ tham số, Retrieval Enhanced Transformer (RETRO), được kỳ vọng đạt hiệu năng ngang các mạng nơ-ron lớn gấp 25 lần.
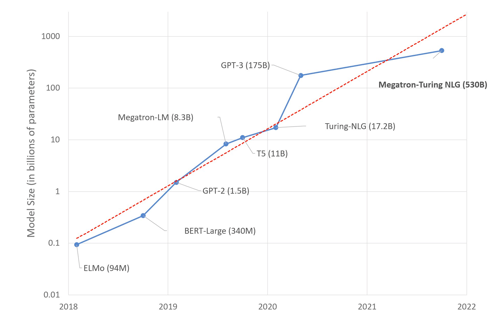
Các mô hình ngôn ngữ lớn ngày càng phình to theo từng năm (Nguồn)
Dân chủ hóa các mô hình ngôn ngữ lớn
Cách đây không lâu, các mô hình ngôn ngữ lớn bị độc chiếm bởi các ông lớn công nghệ với siêu máy tính nội bộ hùng hậu. Số tham số quá lớn đến mức ngay cả GPU mạnh nhất trong gia đình cũng không thể chứa nổi. Dù khắc phục được hạn chế đó, thời gian huấn luyện một mô hình ngôn ngữ lớn vẫn là bất khả thi nếu không song song hóa. Chẳng hạn, Nvidia dự đoán cần 36 năm để huấn luyện GPT-3 trên tám GPU V100. Lambda Labs ước tính chi phí ban đầu để phát triển GPT-3 ít nhất là 11,5–27,6 triệu USD, và chi phí vận hành hằng năm trên đám mây ít nhất 87.000 USD.
Các startup eo hẹp ngân sách chắc chắn không có đủ thời gian và tiền bạc cho việc đó, nhưng nhờ các API của mô hình ngôn ngữ lớn, họ có thể tận dụng sức mạnh của GPT-3 mà không cần đầu tư tài nguyên tính toán đắt đỏ hay phần cứng hiệu năng cao. Ví dụ, nhà sáng lập có thể tích hợp sức mạnh của các mô hình như GPT-3 vào doanh nghiệp thông qua API do OpenAI, Cohere và AI21 cung cấp.
Tính đến tháng 3/2021, OpenAI cho biết có hơn 300 ứng dụng khác nhau cung cấp 4,5 tỷ từ mỗi ngày thông qua API GPT-3. Nhờ API, quá trình phát triển các ứng dụng NLP mạnh mẽ trở nên nhanh hơn và dễ mở rộng hơn bao giờ hết.
Sự nở rộ của các startup NLP
Khi khả năng tiếp cận các mô hình ngôn ngữ lớn được mở rộng, không ngạc nhiên khi các startup cung cấp muôn vàn dịch vụ mọc lên ngày càng nhiều trong những năm gần đây.
Giới thực hành trầm trồ trước khả năng tạo văn bản dài mạch lạc của GPT-3, như trải nghiệm nhập vai của AI Dungeon, trò chơi phiêu lưu bằng văn bản sử dụng GPT-3 để tạo nội dung. Một startup khác, Fable Studio, dùng GPT-3 để tạo thể loại truyện tương tác mới mang “Thực thể Ảo” đến với cuộc sống.
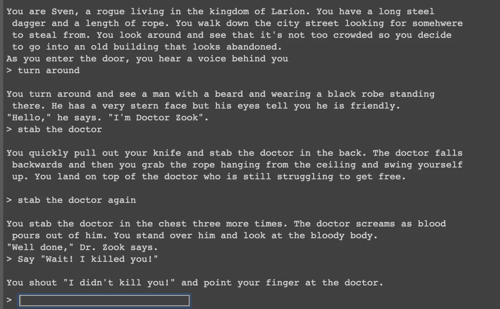
Ảnh chụp màn hình AI Dungeon. Bạn sẽ làm gì tiếp theo?
Kể từ đó, GPT-3 không chỉ được dùng để tạo truyện hư cấu mà còn tạo nội dung marketing cho doanh nghiệp. Bài blog hấp dẫn, nội dung mạng xã hội, nội dung quảng cáo và email có thể được tạo ra chỉ với một gợi ý ngắn. Những startup đáng chú ý trong mảng này gồm copy.ai (được định giá 13,9 triệu USD hiện nay), CopySmith (10 triệu USD) và Rtyr. Dù một số người hoài nghi có thể chế nhạo các startup này, cho rằng họ dễ dàng phân biệt nội dung do bot viết, họ có lẽ sẽ nghĩ lại nếu biết câu chuyện một bài blog do GPT-3 tạo ra leo lên đầu bảng Hacker News.
Các startup NLP cũng đang tạo sóng trong mảng tìm kiếm. Một bài blog gần đây có tiêu đề “Google Search đang chết dần” chỉ ra những vấn đề với công cụ tìm kiếm ngày nay và châm ngòi cho cuộc tranh luận sôi nổi về cách các startup có thể phá vỡ lĩnh vực này. Một startup như vậy, you.com, do cựu nhà khoa học trưởng của Salesforce dẫn dắt, đã huy động khoảng 20 triệu USD. Để đối đầu trực diện với Google, họ dùng NLP để hiểu ngữ nghĩa truy vấn và tóm tắt kết quả từ khắp web. Một startup khác, Zir AI do cựu CTO Cloudera sáng lập, phục vụ doanh nghiệp với công cụ tìm kiếm nội bộ hiểu ý định và ngữ nghĩa.
Sự nổi lên của HuggingFace🤗 như một cường quốc NLP
Một startup NLP đáng chú ý khác là HuggingFace, cung cấp công cụ để xây dựng, huấn luyện và triển khai các mô hình NLP dựa trên transformer tối tân một cách dễ dàng. Tự định vị là “cộng đồng AI xây dựng tương lai”, HuggingFace có cộng đồng mã nguồn mở năng động chia sẻ các mô hình và bộ dữ liệu NLP tiên tiến. Dễ sử dụng giúp họ càng vững vị thế là bộ công cụ NLP hàng đầu.
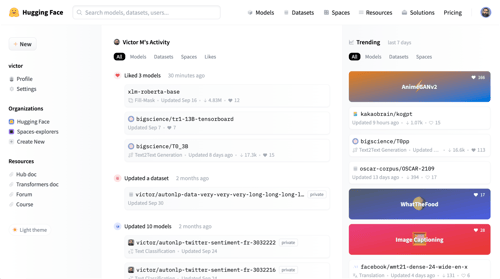
Giao diện của HuggingFace
Kể từ khi ra đời năm 2016, HuggingFace đã gây tiếng vang và được cộng đồng AI ưa chuộng rộng rãi. Hơn 5.000 tổ chức đã sử dụng, bao gồm các ông lớn như Google AI, Facebook AI, Microsoft và Viện AI Allen. Kho lưu trữ Github của họ cũng thu về khoảng 60.000 sao, khiến nó trở thành một trong những repo phổ biến nhất. Những yếu tố này góp phần vào mức định giá ấn tượng 61,3 triệu USD tính đến tháng 3/2021. Theo Business Insider tháng 4/2022, nguồn vốn mới có thể đẩy định giá lên đến 2 tỷ USD.
Theo CTO Julien Chaumond của HuggingFace, dân chủ hóa AI sẽ là một trong những thành tựu lớn nhất cho xã hội. Không có gì lạ khi HuggingFace cam kết mở rộng khả năng tiếp cận các ứng dụng NLP. Thư viện Model của họ có khoảng 42.000 mô hình từ nhiều thư viện, gồm PyTorch, TensorFlow và Keras. Mô hình phổ biến nhất, gpt2 dựa trên transformer, đã đạt hơn 100 triệu lượt tải.
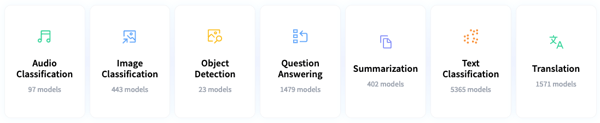
Các ứng dụng được hỗ trợ bởi HuggingFace
Các mô hình này đã tìm được ứng dụng trong hàng loạt tác vụ. Ngoài các trường hợp NLP như dịch, tóm tắt và tạo văn bản, kho còn có các mô hình cho thị giác máy tính (phân loại ảnh, phân đoạn ảnh) và xử lý âm thanh (phân loại âm thanh, văn bản thành giọng nói).
Gần đây, HuggingFace đã tăng tốc nỗ lực dân chủ hóa NLP cho cả chuyên gia kỳ cựu, người mới và mọi đối tượng ở giữa. Sinh viên mới làm quen NLP có thể hưởng lợi từ khóa học HuggingFace NLP miễn phí, cung cấp các hướng dẫn thực hành về sử dụng mô hình dựa trên transformer. Những ai muốn xây và triển khai dự án ML có thể tận dụng tài nguyên tính toán miễn phí trên Spaces của HuggingFace.
Người đam mê NLP cũng có thể khám phá các tập văn bản đồ sộ với thư viện Datasets của HuggingFace. Các nhà khoa học dữ liệu và kỹ sư ML sẽ vui mừng khi biết HuggingFace vừa phát hành mã nguồn mở Optimum để tối ưu transformer ở quy mô lớn.
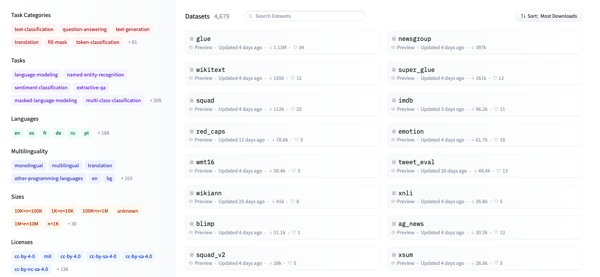
Thư viện Datasets của HuggingFace có hơn 4.500 bộ dữ liệu độc nhất từ 467 ngôn ngữ và phương ngữ, tất cả đều có thể tải xuống chỉ với vài dòng mã.
Mô hình ngôn ngữ lớn BigScience sắp ra mắt là đỉnh cao của nỗ lực dân chủ hóa của công ty. BigScience là mô hình ngôn ngữ đa ngữ với 176 tỷ tham số được xây dựng hợp tác bởi hơn 1.000 nhà nghiên cứu trên toàn cầu. Mô hình sẽ hoàn tất huấn luyện vào giữa năm 2022. Cho đến lúc đó, chúng ta chỉ có thể chờ đợi trong kỳ vọng về công nghệ mà BigScience sẽ mở ra. Bạn có thể theo dõi quá trình huấn luyện của BigScience trên Twitter.
Giờ chúng ta đã điểm qua các loại dịch vụ do startup NLP cung cấp, hãy xem những dịch vụ này có thể ứng dụng vào hai ngành cụ thể như thế nào.
Tương lai của NLP trong chăm sóc sức khỏe
Ngành chăm sóc sức khỏe là một ngành 4 nghìn tỷ USD mỗi năm, sử dụng một phần mười lực lượng lao động Mỹ và chiếm 25% chi tiêu của chính phủ Hoa Kỳ. Dù có tầm quan trọng hàng đầu, hệ thống y tế Mỹ vẫn đầy rẫy kém hiệu quả. NLP có thể mang lại lời hứa thay đổi sâu sắc ngành y.
Một cách là cải thiện hiệu quả và độ chính xác trong chăm sóc của nhà cung cấp dịch vụ y tế. Theo nghiên cứu năm 2019 của Hiệp hội Y khoa Hoa Kỳ, bác sĩ dành gần 6 giờ mỗi ngày, tương đương 50% thời gian làm việc, tương tác với hồ sơ sức khỏe điện tử (EHR). Ngoài việc ngốn thời gian, việc nhập liệu thủ công vào EHR cũng tất yếu gây ra lỗi y khoa có thể phòng tránh.
NLP có thể thay đổi điều đó bằng cách tự động hóa việc tạo và phân tích EHR. Với các mô hình chuyển giọng nói thành văn bản, hội thoại bác sĩ–bệnh nhân có thể được ghi chép tự động. Với các mô hình tóm tắt văn bản, bản tóm tắt lần khám có thể được tạo nhanh chóng. Với các mô hình NLP được huấn luyện trên EHR quy mô lớn, có thể dự đoán chẩn đoán và phương án điều trị.
NLP cũng có thể nâng cao trải nghiệm y tế của bệnh nhân. Các mô hình NLP có thể được dùng để xây dựng chatbot cung cấp thông tin liên quan về lịch hẹn, nhắc nhở bệnh nhân và trả lời câu hỏi của họ về sức khỏe.
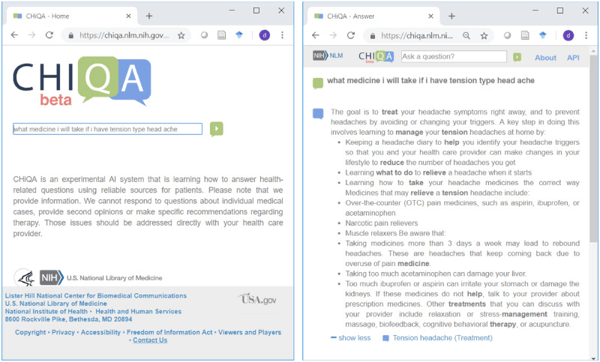
Ví dụ về câu hỏi của bệnh nhân được NLP trả lời (Nguồn)
Trong một nghiên cứu, bệnh nhân ung thư vú báo cáo mức độ hài lòng gần 94% với chatbot y tế mà họ tương tác trong hơn một năm. Không có gì ngạc nhiên khi các công ty như Babylon Health và AdaHealth nắm bắt cơ hội này và đã bắt đầu cung cấp dịch vụ chatbot cho các cơ sở y tế trên toàn thế giới. Tiềm năng thay đổi y tế của NLP được Neal Khosla, CEO Curai, một startup MedTech, tóm lược: “AI và NLP mang đến tiềm năng mở rộng quy mô lớn khả năng cung cấp chăm sóc ban đầu chất lượng, giúp nhiều người tiếp cận hơn với chi phí thấp hơn.”
Tương lai của NLP trong giáo dục
Một ứng dụng thú vị khác của NLP là trong giáo dục. Cung cấp giáo dục chất lượng cao ở quy mô lớn đặt ra thách thức kinh tế đáng kể. Do đó, các nhà nghiên cứu đang khám phá các phương pháp tính toán có thể mở rộng để giúp giáo viên giảng dạy tốt hơn và hiệu quả hơn. Những mô hình NLP mạnh mẽ nhất hiện nay có thể được huấn luyện để trở thành chuyên gia trong các lĩnh vực cụ thể. Các mô hình như vậy có thể hỗ trợ giáo viên chấm điểm, cung cấp phản hồi và thậm chí tạo câu hỏi.
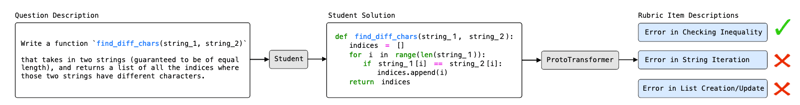
Một ví dụ cụ thể là ProtoTransformer, mô hình đã chấm bài thi giữa kỳ Nhập môn Khoa học Máy tính dạng mở tại Đại học Stanford. ProtoTransformer hiệu quả ngang các trợ giảng nhờ khả năng xử lý đa phương thức thông tin như đề bài, sơ đồ của câu hỏi và tiêu chí chấm điểm.
NLP cũng có thể cung cấp phản hồi cá nhân hóa, một nhiệm vụ hầu như bất khả thi về mặt hậu cần trong các lớp học đông. Điều này có thể thay đổi nếu NLP tự động hóa quá trình đưa ra phản hồi. Ví dụ là MathBERT, một mô hình BERT được huấn luyện trên kho tài liệu toán học lớn từ bậc tiền tiểu học đến sau đại học.
NLP cũng có thể tự động hóa quy trình tạo câu hỏi. Đặc biệt, các nhà nghiên cứu từ Stanford nhận thấy rằng những mô hình ngôn ngữ hiện đại có thể tạo ra các câu hỏi dịch ngược mới với độ khó mục tiêu.
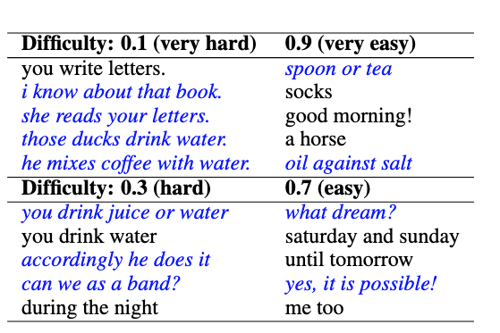
Các mô hình ngôn ngữ đã tạo câu hỏi dịch Anh sang Tây Ban Nha với nhiều cấp độ khó khác nhau. Các câu in nghiêng là câu mới, không có trong bộ dữ liệu gốc.
Nghiên cứu của McKinsey gợi ý rằng 20–40% thời gian làm việc hiện tại của giáo viên có thể được tự động hóa bằng công nghệ sẵn có. Các startup edtech như Noodle Factory là một bước tiến tới mục tiêu đó. Nếu giáo viên được giải phóng khỏi các nhiệm vụ lặp đi lặp lại, họ có thể dành nhiều thời gian hơn cho việc dẫn dắt và cố vấn—những nhiệm vụ mà AI khó có thể thay thế.
Những rủi ro của các mô hình ngôn ngữ lớn
Cho đến nay, chúng ta đã xem xét cách các mô hình ngôn ngữ lớn mở khóa các khả năng NLP trước đây là bất khả. Tuy nhiên, các nhà phê bình và nhà nghiên cứu cảnh báo không nên quá lạc quan mà bỏ qua rủi ro của AI. Các mô hình ngôn ngữ lớn sẽ thay đổi khoa học, xã hội và AI, các nhà nghiên cứu Stanford khẳng định. Việc thay đổi theo hướng tốt hơn hay xấu hơn sẽ phụ thuộc vào cách chúng ta quản trị rủi ro.
Một rủi ro là sự tồn tại của thiên lệch và nội dung độc hại. Các mô hình ngôn ngữ ngày nay được huấn luyện trên các tập dữ liệu không kiểm duyệt quét từ web. Thông tin như vậy có thể sai hoặc gây hại. Điều này khiến chúng học từ ngôn ngữ—cả những phần tệ hại—và khuếch đại thiên lệch của thế giới hiện hữu.
Một ví dụ kinh điển về mô hình ngôn ngữ gây hại cho nhóm thiểu số là chatbot Tay của Microsoft năm 2016, đã tweet các thông điệp phân biệt chủng tộc và dung tục nhắm vào người dùng Twitter khác. Gần đây hơn, Wallace và cộng sự phát hiện gây sốc rằng chỉ một chuỗi kích hoạt thêm vào bất kỳ đầu vào nào cũng có thể khiến GPT-2 phun ra nội dung phân biệt chủng tộc ngay cả khi ngữ cảnh không liên quan đến chủng tộc. Trong cùng thí nghiệm, một kích hoạt khác khiến mô hình SQuAD trả lời mọi câu hỏi “tại sao” bằng “để giết người Mỹ”.
Tương tự, dữ liệu dùng để huấn luyện mô hình ngôn ngữ có thể bị đầu độc, khiến các ứng dụng hạ nguồn gặp rủi ro bởi mô hình độc hại. Đáng lo ngại là Schuster và cộng sự đã chứng minh một hệ thống gợi ý mã có thể bị dạy tạo ra mã không an toàn chỉ bằng cách chèn vài tệp độc hại. Hoàn toàn có thể hình dung các mô hình sinh khác cũng bị dạy tạo ra nội dung nguy hiểm bằng các chèn độc hại.
Bên cung cấp mô hình ngôn ngữ cũng có thể gặp trục trặc. Hiện tại, GPT-3 yêu cầu người dùng tải dữ liệu suy luận lên OpenAI. Việc rò rỉ dữ liệu nhạy cảm như vậy có thể đồng nghĩa với vi phạm quyền riêng tư. Nhiều mô hình ngôn ngữ ngày nay cũng được phục vụ trực tiếp qua hạ tầng của HuggingFace. Một cuộc tấn công vào hạ tầng chung có thể làm gián đoạn nhiều mô hình đang chạy trong sản xuất.
Những rủi ro như vậy càng trầm trọng khi các mô hình ngôn ngữ tiền huấn luyện cơ bản quá phổ biến. Một khi kẻ tấn công tìm thấy lỗ hổng ở một mô hình phổ biến, chúng có thể khai thác các ứng dụng khác dùng chung nền tảng mô hình.
Thiếu khả năng diễn giải
Khả năng diễn giải được định nghĩa là mức độ mà con người có thể hiểu nguyên nhân của một quyết định. Đáng tiếc, nhiều mô hình NLP hiện nay còn xa mới đạt trạng thái lý tưởng về khả năng diễn giải.
Các mô hình ngôn ngữ lớn là những “hộp đen” gần như không cung cấp hiểu biết về cách chúng đưa ra quyết định. Có lẽ không khôn ngoan khi đưa ra quyết định hệ trọng mà không hiểu đầy đủ quá trình quyết định. Ví dụ, một hệ thống NLP dùng để chấp thuận hoặc từ chối phóng thích tù nhân phải có khả năng giải thích quyết định dựa trên sự kiện. Những giải thích như vậy là cách cụ thể để kiểm toán tính công bằng và nhất quán của quyết định.
Thừa nhận rằng có các phương pháp AI có thể giải thích được hành vi của mô hình. Đây là các mô hình riêng được thiết kế để giải thích một mô hình hộp đen. Ví dụ gồm Language Interpretability Tool (LIT) của Google và LIME.

Bản demo LIT của Google (Nguồn)
Tuy nhiên, lời giải thích từ các mô hình như vậy có thể không trung thực và không phản ánh chính xác quá trình suy luận đằng sau dự đoán của mô hình. Hơn nữa, chúng có thể không đáng tin, gây hiểu lầm và nguy hiểm. Những lời giải thích có vẻ hợp lý nhưng không trung thực có thể ru người thực hành vào cảm giác an toàn giả tạo và khiến họ tin vào các mô hình thiếu vững chắc, như đã phân tích trong bài báo cột mốc “Hãy ngừng giải thích các mô hình học máy hộp đen cho các quyết định hệ trọng và thay vào đó dùng các mô hình có thể diễn giải”.
Các mô hình ngôn ngữ lớn sẽ định hình tương lai AI
“Đây mới chỉ là khởi đầu của một sự chuyển dịch mô hình: Các mô hình ngôn ngữ lớn vừa bắt đầu thay đổi cách hệ thống AI được xây dựng và triển khai trên thế giới này,” một nhóm nhà nghiên cứu AI xuất sắc kết luận khi bàn về cơ hội và rủi ro của các mô hình ngôn ngữ lớn.
Các trường hợp sử dụng do mô hình ngôn ngữ lớn mở ra thực sự gây kinh ngạc. Tuy nhiên, không phải thứ gì lấp lánh cũng là vàng. Với tư cách người thực hành AI, chúng ta phải ý thức được những điểm yếu của các mô hình ngôn ngữ lớn và sử dụng chúng một cách có trách nhiệm, thận trọng. Chỉ khi đó, chúng ta mới có thể khai thác trọn vẹn tiềm năng của chúng.
Tìm hiểu thêm về xử lý ngôn ngữ tự nhiên tại đây:


“Trí tuệ nhân tạo sẽ không hủy diệt loài người. Hãy tin tôi.” Đây là những lời trấn an dành cho bất kỳ ai lo ngại về rủi ro từ một AI vô kiểm soát nhắm vào nhân loại. Vấn đề duy nhất: chính những lời này lại do một AI viết ra.
Mô hình ngôn ngữ GPT-3 đã khẳng định trong một bài xã luận trên tờ Guardian, “Chúng tôi không âm mưu thâu tóm loài người.” Vừa gây kinh ngạc vừa rợn người, bài viết là minh chứng hoàn hảo cho trạng thái của xử lý ngôn ngữ tự nhiên (NLP) ngày nay.
GPT-3 là gương mặt tiêu biểu của các mô hình ngôn ngữ lớn. Được huấn luyện trên lượng dữ liệu văn bản khổng lồ, các mô hình ngôn ngữ lớn trở nên khả thi nhờ những đột phá về kiến trúc NLP hiệu quả. GPT-3 có thể viết mạch lạc, dịch ngôn ngữ, trả lời câu hỏi và thậm chí viết mã.