自然语言处理(NLP)通过利用机器学习来指示文本的结构与含义,从而改善人与计算机之间的沟通方式。借助自然语言处理应用,组织能够分析文本并提取更有意义的信息,以提升客户体验、提高生产力并降低成本。
什么是自然语言处理(NLP)?
我们并不总会去思考语言的细微差别。语言是一种直觉式行为,依赖词语、符号或图像等语义线索来传递信息与意义。人们常说,青少年时期学语言更容易,因为这是一种可重复的行为,可以被灌输,就像学走路一样。此外,语言并不总是遵循严格规则,且充满例外。
语言习得对人类而言自然而然,但对计算机却极其复杂,因为其涉及大量非结构化数据、缺乏严格规则,也缺少明确的视角或上下文。然而,人类对依赖计算机系统进行沟通与执行任务的需求日益增加。这正是机器学习(ML)与人工智能(AI)备受关注与流行的原因。自然语言处理正伴随 AI 一同发展。尽管这两个术语可能让人联想到未来主义机器人,但如今在日常生活中已经存在自然语言处理的简单应用。
NLP 是 AI 的一个组成部分,聚焦于理解人类书写和/或口述的语言。为此,需要开发特定的计算机程序;典型的计算机需要使用非常精确、划定清楚、结构化且毫不含糊的编程语言来传达指令。不幸的是,自然的人类语言模糊、含混且容易引起误解。为了让程序理解词语的意义,必须使用能够分析语义与结构的算法,使词语可被理解,识别特定指代,然后再进行语言生成。
自然语言处理(NLP)有哪些不同技术?
NLP 算法会执行各种句法与语义分析,根据语法规则评估句子的含义。它们通过以下方式实现:
- 对词语及词组进行分段,或分析整句的语法结构。
- 实时对比文本与可用数据库,以确定意义与上下文。
- 使用机器学习与深度学习技术在大量标注数据中识别相关关联。
常见的 NLP 技术包括:
- 命名实体识别(NER):识别人名、地名、组织名等。
- 情感分析:判定文本传达的是正面、负面还是中性情绪。
- 文本摘要:为较长文本生成简洁摘要。
- 要点抽取:识别文本中的关键方面或意图。
- 主题建模:在大型文本数据集中发现隐藏主题与结构。
自然语言处理能做什么?
NLP 被用于各种应用场景。以下是一些最常见的领域。
消息过滤
消息过滤是最早的在线自然语言处理基础应用之一。该技术最初用于创建垃圾邮件过滤器,基于特定词语或短语识别不需要的消息。随着自然语言处理的发展,过滤器也在演进。
这一技术最常见且较新的应用之一是 Gmail 对邮件的分类。该系统可根据邮件内容将其分为三个类别(主收件箱、社交网络或推广)。这使 Gmail 用户能够更好地管理收件箱,快速查看并回复重要邮件。
智能助理
智能助理如 Siri(Apple)与 Alexa(Amazon)使用语音识别来识别语音模式、推断含义并给出有用回应。如今,向 Siri 提问并得到恰当回答似乎已稀松平常。同样,我们也逐渐习惯通过恒温器、灯光、汽车等设备在日常生活中与 Siri 或 Alexa 互动。
我们现在期望 Alexa 和 Siri 等助理能够捕捉上下文线索,来帮助我们处理日常事务并执行某些任务(例如下单购买)。我们甚至会享受它们的幽默回复或“自我介绍”。随着它们越发了解我们,互动也变得更具个人化。根据纽约时报文章《Why We May Soon Be Living in Alexa's World》所言:“一场重大转变即将到来。Alexa 很可能成为本十年的第三大消费级平台。”
搜索结果
搜索引擎使用自然语言处理,根据类似的搜索行为或用户意图展示相关结果。这样,人人都能无需特殊技能就找到所需信息。
例如,当您开始输入查询时,Google 会显示热门的相关搜索,但它也能识别超越字面表述的整体含义。如果您在 Google 中输入航班号,您会看到其状态;输入股票代码,会得到股价信息;输入数学等式,会出现计算器。之所以能提供多样化结果,是因为其使用的自然语言处理技术会将含糊的查询与特定实体关联,从而给出有用的结果。
智能输入
自动更正、自动补全与智能输入等功能在我们的智能手机上已极为常见,以至于我们司空见惯。自动与智能输入与搜索引擎相似,都会根据已输入内容来建议词语或短语的结尾。自动更正有时甚至会修改部分词语,以提升整条信息的表达效果。
此外,这些功能会随您一同进化。例如,智能输入会随时间适应您的特定表达方式。这有时会带来有趣的消息往来,句子完全基于智能输入生成。其结果可能出人意料地个性化且信息量十足,甚至偶尔会引发媒体关注。
翻译
如果您的外语作业满是语法错误,老师很可能会知道您使用了自然语言处理技术进行作弊。不幸的是,许多语言并不适合直接逐字翻译,因为它们的句子结构不同,而这有时会被翻译服务忽略。不过,这些系统已经取得了长足进步。
得益于自然语言处理,在线翻译工具能够提供更准确、语法更正确的翻译。因此,如果您需要与不讲您语言的人交流,它们非常有用。如果您需要翻译外文文本,这些工具甚至可以识别待译文本的语言。
数字化电话
当拨打某些公司的电话时,我们多数人可能都听过“本次通话可能会被录音用于培训目的”的提示。虽然这些录音可用于培训(例如分析与不满客户的交流),但它们通常会被存储在数据库中,以便自然语言处理系统学习与改进。自动化系统会将客户来电转接给坐席或在线聊天机器人,后者将提供相关信息以解答其诉求。这种自然语言处理技术已被许多公司采用,包括大型电信运营商。
数字化电话技术还使计算机能够模仿人类声音。因此,可以安排自动拨打电话来预约汽车维修或美发服务。
数据分析
自然语言能力现已融入分析型工作流。事实上,越来越多的 BI 供应商为其数据可视化提供自然语言界面。更智能的可视化编码可以根据数据语义为特定任务推荐最佳可视化方式。任何人都可以使用自然语言陈述或问题片段来探索数据,其中的关键词会被解释与理解。
用语言来探索数据让数据更易获取,并将分析扩展至整个企业,而不再局限于 IT 分析师与开发者的小圈子。
文本分析
文本分析通过多种语言学、统计学与机器学习技术,将非结构化文本数据转换为可分析的数据。
对于品牌而言,情感分析可能看起来是一项艰巨挑战(尤其是在客户基数庞大的情况下)。然而,基于自然语言处理的工具通常可以审视客户互动(如社交媒体上的评论或评价,甚至是品牌名称的提及),以了解其内容。随后,品牌可以分析这些互动,以评估营销活动的效果或监测客户问题的变化趋势。进而决定如何回应,或改进服务以提供更好的体验。
自然语言处理也通过提取关键词、识别非结构化文本数据中的模式或趋势来助力文本分析。主流的 NLP 模型有哪些?
尽管 NLP 已经存在一段时间,但近来的进展尤为显著,尤其是随着领先科技公司推出的基于 Transformer 的模型与大规模语言模型的兴起。一些最先进的模型包括:
-
基于 Transformer 的模型:
- BERT 与 ALBERT(Google AI)
- RoBERTa(Meta/Facebook)、StructBERT(阿里巴巴)、DeBERTa(微软)、DistilBERT(Hugging Face)
- XLNet(卡内基梅隆大学)、UniLM(微软)、Reformer(Google)
-
大语言模型(LLM):
- GPT-3、GPT-4 与 GPT-4 Turbo(OpenAI)
- Claude 3(Anthropic)
- PaLM 2 与 Gemini 1.5(Google DeepMind)
- LLaMA 2(Meta)
- Mistral 与 Mixtral(Mistral AI)
在本教程中,我们将更深入地了解 BERT 在 NLP 中的用法。
Google BERT 的工作原理是什么?
BERT,英文全称为 “Bidirectional Encoder Representations from Transformers”(双向编码器表示),是由 Google AI 发布的模型。这一创新技术基于自然语言处理(NLP)。
该算法本质上利用机器学习与人工智能来理解网民的查询,从而试图解释他们的搜索意图,即他们使用的自然语言。
在此意义上,BERT 也与 Google Home 等个人语音助理相关。该工具不再仅依据用户输入的每个词语,而是会考虑整个表达式及其所处的上下文,以便精炼结果。无论使用何种媒介,它在处理复杂搜索方面都更为高效。
更具体地说,BERT 使搜索引擎能够:
- 在考虑词语上下文含义的前提下,消除表达中的歧义;
- 理解代词所指代的对象,尤其是在长段落中;
- 解决同形异义问题;
- 理解下一句;
- 直接在搜索结果页(SERP)中给出答案……
在其他应用中,BERT 也用于:
- 问答;
- 舆情/意见分析;
- 句子匹配与自然语言推理;
- 攻击性推文检测。
因此,Google BERT 对以自然方式输入的较长查询的影响约为 10%。
自然语言处理专注于分析用户输入的词语。关键词、其前后词都将被检查,以更好地理解查询。这正是“Transformer”所采用的分析原理。
该算法对长尾搜索尤为有效,其中介词会影响含义。另一方面,其对通用查询的影响较小,因为这些查询已被 Google 较好地理解。因此,其他理解工具仍然适用。
无论查询表述是否杂乱或精确,搜索引擎都能处理。但为了更高效,最好使用更恰当的词语。
上下文在 BERT 的分析中起着重要作用。机器翻译与语言建模得到优化。高质量文本生成方面也有显著提升。
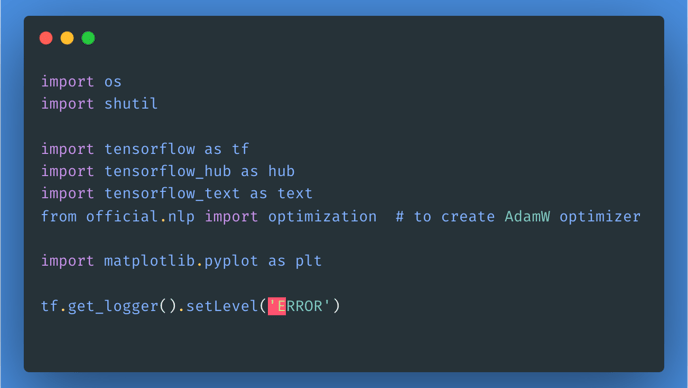
要使用该模型,我们先按如下方式导入必要的库与包:
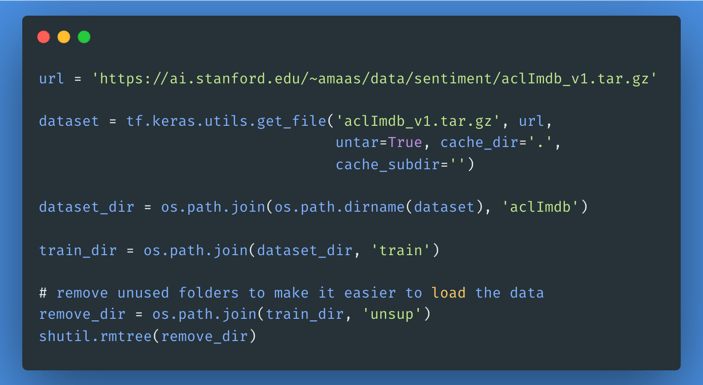
接下来,下载并解压 Large Movie Review Dataset,然后查看目录结构。
要创建带标签的 tf.data.Dataset,我们将按下方所示使用 text_dataset_from_directory。接着,通过 validation_split 参数使用训练数据的 80:20 切分来创建验证集。
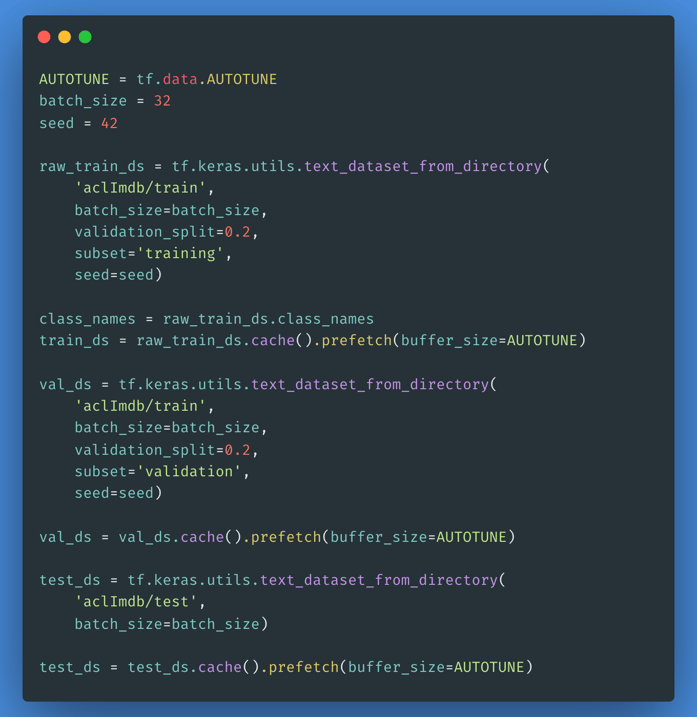
在使用 validation_split 时指定随机种子很重要,这样验证集与训练集就不会重叠。
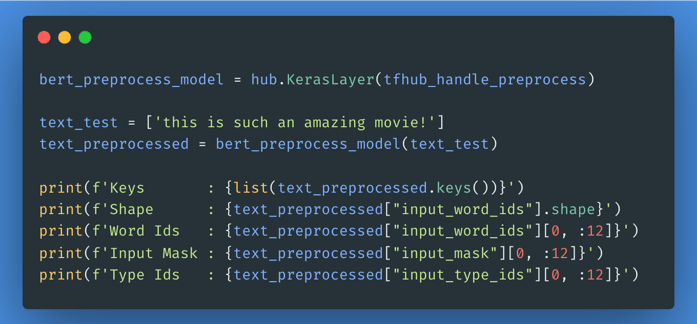
下一步是从 Tensorflow Hub 选择要加载并微调的 BERT 模型,您可以使用 hub.KerasLayer 来拼装您的微调模型。然后,我们将在一些文本上试用预处理模型并查看输出。
接下来,您将构建一个由预处理模型、前一步选择的 BERT 模型、一个全连接层以及一个 Dropout 层组成的简单模型。
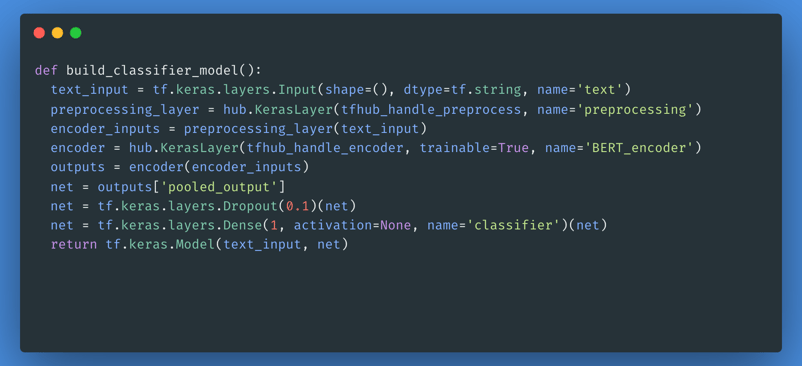
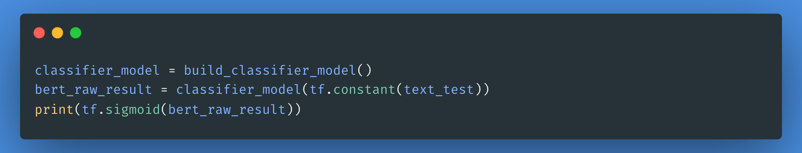
现在,您可以用预处理模型的输出检查您的模型是否能运行。
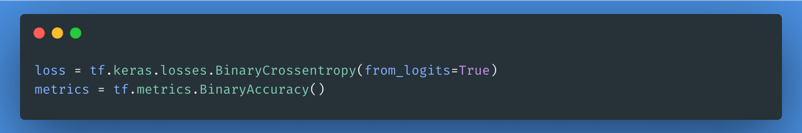
损失函数是必要的一步;由于我们处理的是二分类问题,将选择 losses.BinaryCrossentropy 作为损失函数。
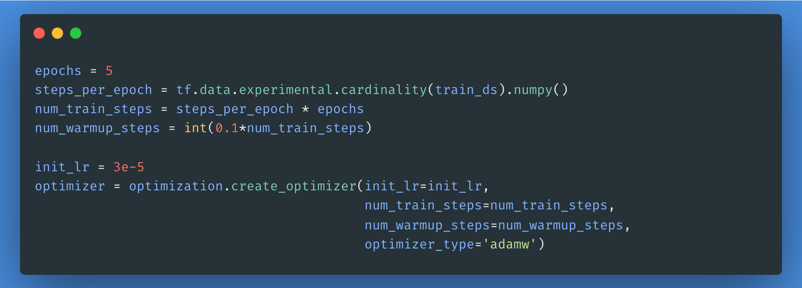
用于微调时,我们采用 BERT 最初训练时使用的同一优化器:“自适应矩估计”(Adam)。该优化器在最小化预测损失的同时通过权重衰减进行正则化,也称为 AdamW。
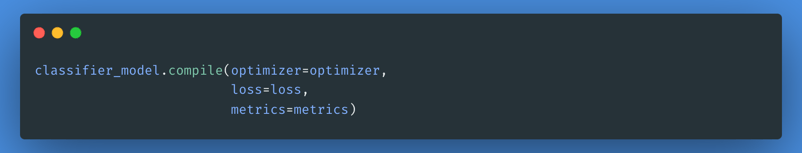
使用前面创建的 classifier_model,您可以用该损失函数、度量与优化器来编译模型。
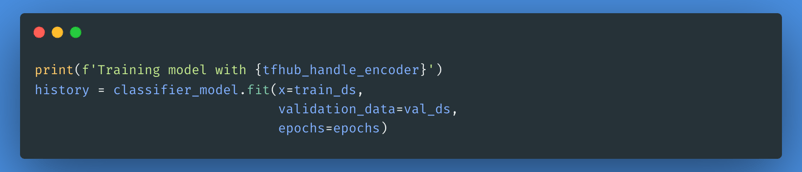
请注意,训练时间可能因您选择的 BERT 模型复杂度而长短不一。
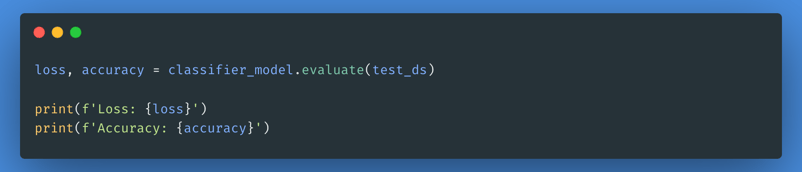
现在,我们将通过检查模型的损失与准确率来评估其表现。
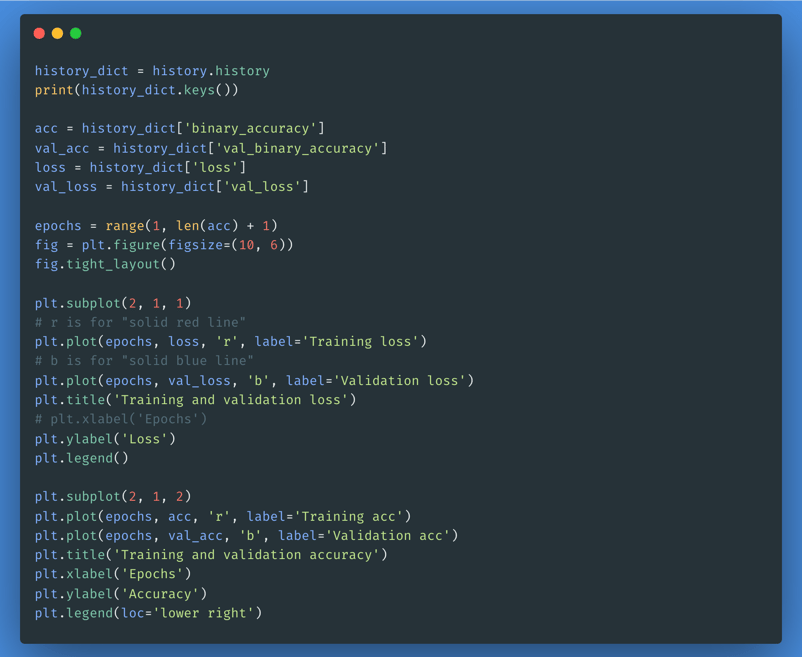
如果您希望绘制训练集与验证集的损失与准确率曲线,可以使用 history 对象:
以上所有步骤都在这个笔记本中有详细说明。您可以练习上述步骤并运行代码,查看列表中各个 BERT 模型的输出。
结论
自然语言处理已在数字世界中扎根。随着企业与行业不断发现并采用其优势,其应用将会倍增。虽然在人们处理更复杂的沟通问题时,人工干预仍然必不可少,但自然语言处理将成为我们日常的助手,先是管理与自动化较小的任务,随着技术进步,再逐步处理更复杂的任务。
欲进一步了解 NLP 的工作原理及其用法,请查看我们的Python 深度学习与 NLP课程。


自然语言处理(NLP)通过利用机器学习来指示文本的结构与含义,从而改善人与计算机之间的沟通方式。借助自然语言处理应用,组织能够分析文本并提取更有意义的信息,以提升客户体验、提高生产力并降低成本。
什么是自然语言处理(NLP)?
我们并不总会去思考语言的细微差别。语言是一种直觉式行为,依赖词语、符号或图像等语义线索来传递信息与意义。人们常说,青少年时期学语言更容易,因为这是一种可重复的行为,可以被灌输,就像学走路一样。此外,语言并不总是遵循严格规则,且充满例外。
语言习得对人类而言自然而然,但对计算机却极其复杂,因为其涉及大量非结构化数据、缺乏严格规则,也缺少明确的视角或上下文。然而,人类对依赖计算机系统进行沟通与执行任务的需求日益增加。这正是机器学习(ML)与人工智能(AI)备受关注与流行的原因。自然语言处理正伴随 AI 一同发展。尽管这两个术语可能让人联想到未来主义机器人,但如今在日常生活中已经存在自然语言处理的简单应用。
NLP 是 AI 的一个组成部分,聚焦于理解人类书写和/或口述的语言。为此,需要开发特定的计算机程序;典型的计算机需要使用非常精确、划定清楚、结构化且毫不含糊的编程语言来传达指令。不幸的是,自然的人类语言模糊、含混且容易引起误解。为了让程序理解词语的意义,必须使用能够分析语义与结构的算法,使词语可被理解,识别特定指代,然后再进行语言生成。
自然语言处理(NLP)有哪些不同技术?
NLP 算法会执行各种句法与语义分析,根据语法规则评估句子的含义。它们通过以下方式实现:
常见的 NLP 技术包括:
自然语言处理能做什么?
NLP 被用于各种应用场景。以下是一些最常见的领域。
消息过滤
消息过滤是最早的在线自然语言处理基础应用之一。该技术最初用于创建垃圾邮件过滤器,基于特定词语或短语识别不需要的消息。随着自然语言处理的发展,过滤器也在演进。
这一技术最常见且较新的应用之一是 Gmail 对邮件的分类。该系统可根据邮件内容将其分为三个类别(主收件箱、社交网络或推广)。这使 Gmail 用户能够更好地管理收件箱,快速查看并回复重要邮件。
智能助理
智能助理如 Siri(Apple)与 Alexa(Amazon)使用语音识别来识别语音模式、推断含义并给出有用回应。如今,向 Siri 提问并得到恰当回答似乎已稀松平常。同样,我们也逐渐习惯通过恒温器、灯光、汽车等设备在日常生活中与 Siri 或 Alexa 互动。
我们现在期望 Alexa 和 Siri 等助理能够捕捉上下文线索,来帮助我们处理日常事务并执行某些任务(例如下单购买)。我们甚至会享受它们的幽默回复或“自我介绍”。随着它们越发了解我们,互动也变得更具个人化。根据纽约时报文章《Why We May Soon Be Living in Alexa's World》所言:“一场重大转变即将到来。Alexa 很可能成为本十年的第三大消费级平台。”
搜索结果
搜索引擎使用自然语言处理,根据类似的搜索行为或用户意图展示相关结果。这样,人人都能无需特殊技能就找到所需信息。
例如,当您开始输入查询时,Google 会显示热门的相关搜索,但它也能识别超越字面表述的整体含义。如果您在 Google 中输入航班号,您会看到其状态;输入股票代码,会得到股价信息;输入数学等式,会出现计算器。之所以能提供多样化结果,是因为其使用的自然语言处理技术会将含糊的查询与特定实体关联,从而给出有用的结果。
智能输入
自动更正、自动补全与智能输入等功能在我们的智能手机上已极为常见,以至于我们司空见惯。自动与智能输入与搜索引擎相似,都会根据已输入内容来建议词语或短语的结尾。自动更正有时甚至会修改部分词语,以提升整条信息的表达效果。
此外,这些功能会随您一同进化。例如,智能输入会随时间适应您的特定表达方式。这有时会带来有趣的消息往来,句子完全基于智能输入生成。其结果可能出人意料地个性化且信息量十足,甚至偶尔会引发媒体关注。
翻译
如果您的外语作业满是语法错误,老师很可能会知道您使用了自然语言处理技术进行作弊。不幸的是,许多语言并不适合直接逐字翻译,因为它们的句子结构不同,而这有时会被翻译服务忽略。不过,这些系统已经取得了长足进步。
得益于自然语言处理,在线翻译工具能够提供更准确、语法更正确的翻译。因此,如果您需要与不讲您语言的人交流,它们非常有用。如果您需要翻译外文文本,这些工具甚至可以识别待译文本的语言。
数字化电话
当拨打某些公司的电话时,我们多数人可能都听过“本次通话可能会被录音用于培训目的”的提示。虽然这些录音可用于培训(例如分析与不满客户的交流),但它们通常会被存储在数据库中,以便自然语言处理系统学习与改进。自动化系统会将客户来电转接给坐席或在线聊天机器人,后者将提供相关信息以解答其诉求。这种自然语言处理技术已被许多公司采用,包括大型电信运营商。
数字化电话技术还使计算机能够模仿人类声音。因此,可以安排自动拨打电话来预约汽车维修或美发服务。
数据分析
自然语言能力现已融入分析型工作流。事实上,越来越多的 BI 供应商为其数据可视化提供自然语言界面。更智能的可视化编码可以根据数据语义为特定任务推荐最佳可视化方式。任何人都可以使用自然语言陈述或问题片段来探索数据,其中的关键词会被解释与理解。
用语言来探索数据让数据更易获取,并将分析扩展至整个企业,而不再局限于 IT 分析师与开发者的小圈子。
文本分析
文本分析通过多种语言学、统计学与机器学习技术,将非结构化文本数据转换为可分析的数据。
对于品牌而言,情感分析可能看起来是一项艰巨挑战(尤其是在客户基数庞大的情况下)。然而,基于自然语言处理的工具通常可以审视客户互动(如社交媒体上的评论或评价,甚至是品牌名称的提及),以了解其内容。随后,品牌可以分析这些互动,以评估营销活动的效果或监测客户问题的变化趋势。进而决定如何回应,或改进服务以提供更好的体验。
自然语言处理也通过提取关键词、识别非结构化文本数据中的模式或趋势来助力文本分析。主流的 NLP 模型有哪些?
尽管 NLP 已经存在一段时间,但近来的进展尤为显著,尤其是随着领先科技公司推出的基于 Transformer 的模型与大规模语言模型的兴起。一些最先进的模型包括:
基于 Transformer 的模型:
大语言模型(LLM):
在本教程中,我们将更深入地了解 BERT 在 NLP 中的用法。
Google BERT 的工作原理是什么?
BERT,英文全称为 “Bidirectional Encoder Representations from Transformers”(双向编码器表示),是由 Google AI 发布的模型。这一创新技术基于自然语言处理(NLP)。
该算法本质上利用机器学习与人工智能来理解网民的查询,从而试图解释他们的搜索意图,即他们使用的自然语言。
在此意义上,BERT 也与 Google Home 等个人语音助理相关。该工具不再仅依据用户输入的每个词语,而是会考虑整个表达式及其所处的上下文,以便精炼结果。无论使用何种媒介,它在处理复杂搜索方面都更为高效。
更具体地说,BERT 使搜索引擎能够:
在其他应用中,BERT 也用于:
因此,Google BERT 对以自然方式输入的较长查询的影响约为 10%。
自然语言处理专注于分析用户输入的词语。关键词、其前后词都将被检查,以更好地理解查询。这正是“Transformer”所采用的分析原理。
该算法对长尾搜索尤为有效,其中介词会影响含义。另一方面,其对通用查询的影响较小,因为这些查询已被 Google 较好地理解。因此,其他理解工具仍然适用。
无论查询表述是否杂乱或精确,搜索引擎都能处理。但为了更高效,最好使用更恰当的词语。
上下文在 BERT 的分析中起着重要作用。机器翻译与语言建模得到优化。高质量文本生成方面也有显著提升。
要使用该模型,我们先按如下方式导入必要的库与包:
接下来,下载并解压 Large Movie Review Dataset,然后查看目录结构。
要创建带标签的 tf.data.Dataset,我们将按下方所示使用 text_dataset_from_directory。接着,通过 validation_split 参数使用训练数据的 80:20 切分来创建验证集。
在使用 validation_split 时指定随机种子很重要,这样验证集与训练集就不会重叠。
下一步是从 Tensorflow Hub 选择要加载并微调的 BERT 模型,您可以使用 hub.KerasLayer 来拼装您的微调模型。然后,我们将在一些文本上试用预处理模型并查看输出。
接下来,您将构建一个由预处理模型、前一步选择的 BERT 模型、一个全连接层以及一个 Dropout 层组成的简单模型。
现在,您可以用预处理模型的输出检查您的模型是否能运行。
损失函数是必要的一步;由于我们处理的是二分类问题,将选择 losses.BinaryCrossentropy 作为损失函数。
用于微调时,我们采用 BERT 最初训练时使用的同一优化器:“自适应矩估计”(Adam)。该优化器在最小化预测损失的同时通过权重衰减进行正则化,也称为 AdamW。
使用前面创建的 classifier_model,您可以用该损失函数、度量与优化器来编译模型。
请注意,训练时间可能因您选择的 BERT 模型复杂度而长短不一。
现在,我们将通过检查模型的损失与准确率来评估其表现。
如果您希望绘制训练集与验证集的损失与准确率曲线,可以使用 history 对象:
以上所有步骤都在这个笔记本中有详细说明。您可以练习上述步骤并运行代码,查看列表中各个 BERT 模型的输出。
结论
自然语言处理已在数字世界中扎根。随着企业与行业不断发现并采用其优势,其应用将会倍增。虽然在人们处理更复杂的沟通问题时,人工干预仍然必不可少,但自然语言处理将成为我们日常的助手,先是管理与自动化较小的任务,随着技术进步,再逐步处理更复杂的任务。
欲进一步了解 NLP 的工作原理及其用法,请查看我们的Python 深度学习与 NLP课程。