在过去十多年里,笔记本在数据科学领域随处可见,每位数据科学家都使用过。它们通过快速创建环境、交互式输出以及可按任意顺序执行的代码片段,让数据科学家能够迅速进行实验并共享见解。
各组织一直在大力投资数据科学与分析,其中一项关键投入就是帮助数据科学家高效工作、快速尝试数据的工具。笔记本正处于这一切的核心,是当今现代数据栈中众多工具创新的组成部分。更重要的是,笔记本也在赋能公民数据科学家,推动数据洞见的普及。
本文将回顾笔记本的过去、现在与未来,以及笔记本如何打破数据工作与协作中的壁垒。
数据科学笔记本的历史
如今几乎每位数据科学家都用过笔记本,其中最受欢迎的是Jupyter Notebooks。然而,笔记本的历史要早于数据科学本身——可以追溯到上世纪80年代初。
“文学化编程”的兴起
Donald Knuth 于 1984 年提出了文学化编程,旨在以人类可读的方式构建程序。其理念是用自然语言写出程序逻辑,并将代码片段与宏作为独立注释(称为“WEB”)嵌入其中。宏与教授计算机科学时使用的伪代码类似。
随后由预处理器解析 WEB,生成源代码(“tangle”)与文档(“weave”)。文学化编程至今仍在使用,例如在Axiom中;而其核心思想也促成了与我们今天所见颇为相似的笔记本形态。
早期笔记本
早期的关键笔记本是 Wolfram Mathematica 和 Maple,于80年代末发布。它们以前端加后端内核的方式运行。下图展示了使用 Mathematica 生成的三维图,以及我们在当今笔记本中仍熟悉的 In[ ] 与 Out[ ] 标注。
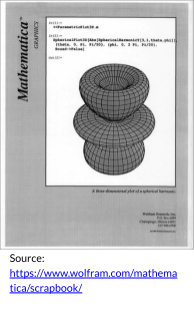
早期的 Wolfram Mathematica 笔记本
这些工具存在一些细微差异,例如运行代码使用 Enter 而非 Shift + Enter,以及数学运算的显示方式不同。但二者都包含了影响现代笔记本设计的重要理念。
推广的关键障碍在于成本,这些工具价格昂贵且需要许可。这也是整个行业的普遍问题,促成了 1998 年开源促进会(Open Source Initiative)的诞生,由此带来了许多我们今天使用的强大且免费的工具(例如 Jupyter Notebooks!)。
现代数据科学笔记本的早期基础
2001 年,IPython 与 SciPy 发布,2003 年 Matplotlib 跟进。SciPy 让 Python 能执行多种科学计算,IPython 改善了终端中的用户体验并加入分布式计算支持。与今天一样,Matplotlib 让 Python 中的数据可视化变得轻而易举。
直到 2005 年,这些开源工具(以及其他工具)才被整合进名为 SageMath 的单一工具。其目标是提供 Mathematica 与 Maple 的开源替代方案,将其他科学开源工具加以整合与拓展,并提供现代笔记本所必备的基于 Web 的功能。
2011 年,IPython 发布了其 Notebook,清晰地区分了 Web 应用前端与底层的笔记本文档。
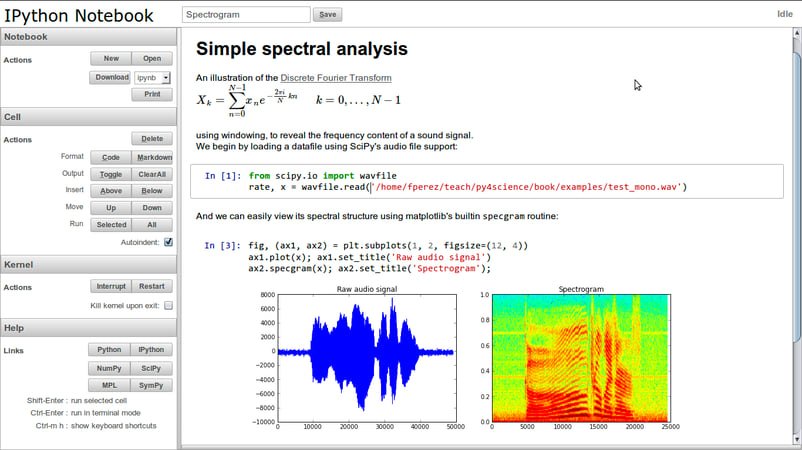
IPython Notebook
Jupyter Notebooks 的诞生
2014 年,Jupyter 从 IPython 中独立,推出笔记本界面并吸收了 IPython 中与语言无关的部分。其名称源自最初支持的语言:Julia、Python 和 R。Jupyter 笔记本如今已成为数据科学家的首选,毫无疑问是当下使用最广的笔记本界面。
近年来的一个重要发展方向,是将前端与内核分离的应用:用户通过浏览器访问前端,而内核运行在云端数据中心。一个很好的例子是DataCamp Workspace,您可以直接在浏览器中启动并使用 Jupyter Notebook 实例。
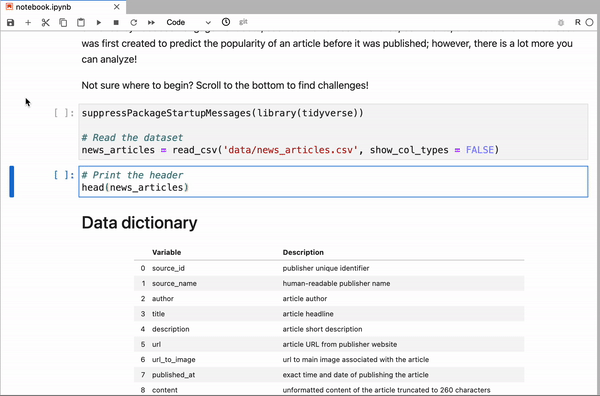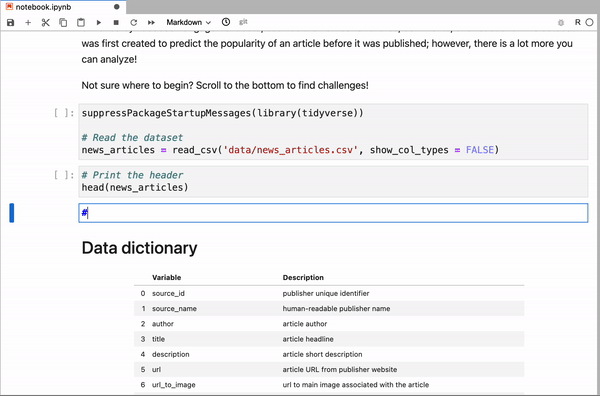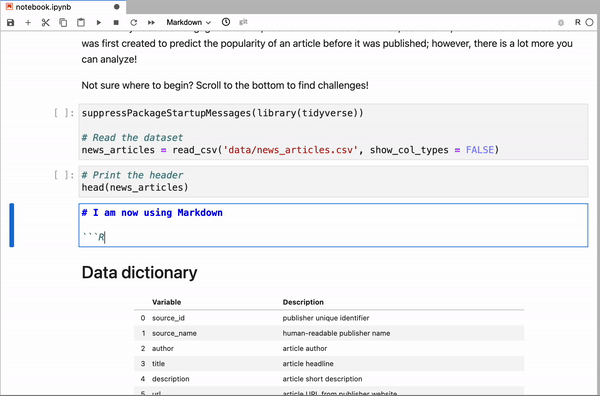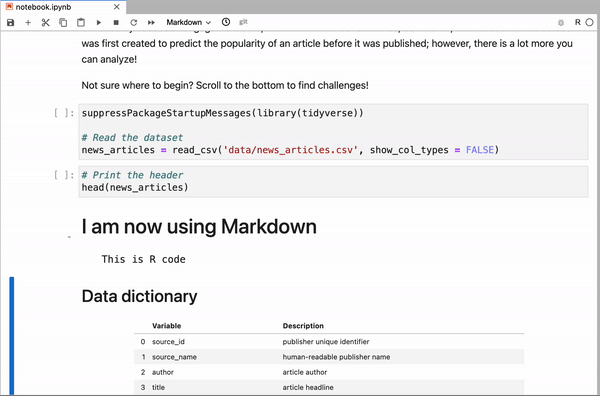
DataCamp Workspace 中的 JupyterLab
随着笔记本的普及与流行,近几年出现了一波现代笔记本界面,让任何人都能轻松处理数据。下一节我们将拆解现代笔记本如何打破数据工作的壁垒。
现代数据科学笔记本如何赋能公民数据科学家
“公民数据科学家”这一概念由Gartner 于 2016 年提出。公民数据科学家具备技术技能,但未必拥有传统的数据科学、统计学或计算机科学背景。
随着数据科学日益从一个学科拓展为解决业务问题的方法论,公民数据科学家成为现代数据驱动组织的代表。笔记本非常适合公民数据科学家,因为它们几乎没有门槛,却能支持快速实验与可共享的洞见。
笔记本一直非常适合快速探索与分析数据集,但此前在协作与分享洞见方面有所不足。到了 2022 年,这种情况已大为改观,现代笔记本及其周边生态已经覆盖了许多历史短板。以下是笔记本在提升生产力、效率与协作方面的几种方式。
现代数据科学笔记本具备协作能力
现代协作工具的一个典型例子是 Google 文档。许多用户可以共同使用与编辑文档,同时还能控制谁可以编辑、谁只能提出建议。更改会被定期保存,避免意外丢失。
类似的技术如今也可用于笔记本,例如Deepnote与Datacamp Workspace。多名用户可以编辑并运行笔记本,也可以留下评论。所有协作都在实时发生,使整个流程更加高效。
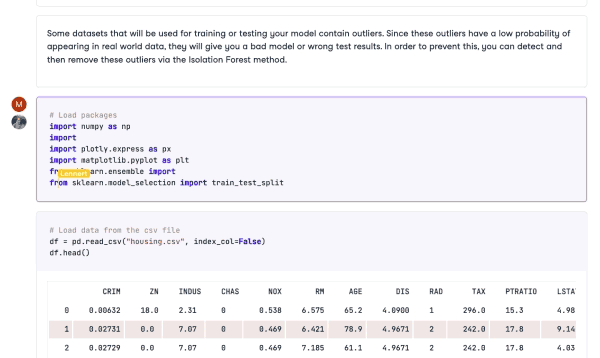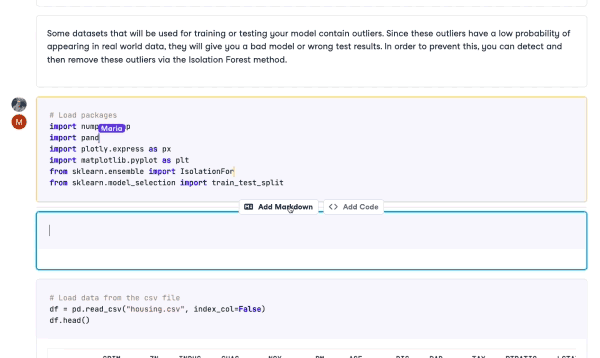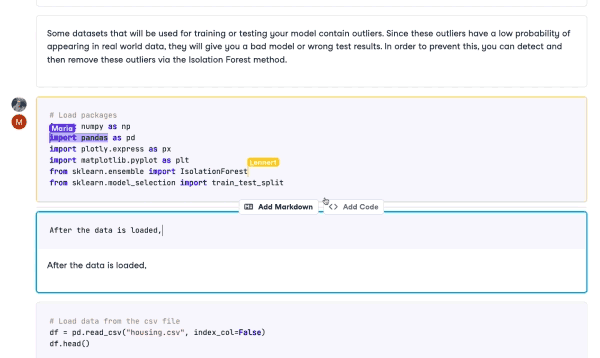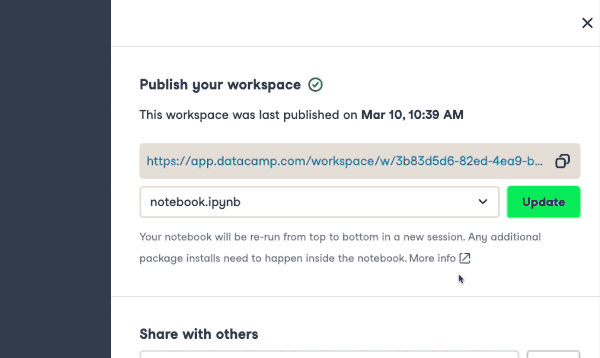
DataCamp Workspace 中的协作
协作对任何与数据打交道的人都至关重要。降低协作门槛也意味着通过共享知识与专业技能来减少数据孤岛。传统上,使用笔记本进行协作可能较为缓慢,而现代数据栈则快捷高效。许多工具能够与现有技术栈无缝集成,这意味着用户可以在熟悉的工具中工作,同时与同事协作。
它们有助于普及数据洞见
与其他用户共享分析可能很困难——无论对方是业务相关方还是更偏技术的人员。过去,从业者通常通过电子邮件、Slack、演示文稿或自建 Web 应用来分享笔记本报告中的洞见。
然而,现代笔记本通过无缝共享来实现洞见的民主化。例如,IPyWidgets 能在笔记本中加入交互式控件,这意味着用户可以拖动滑块更改图形,并更深入地与洞见互动。Binder 可将代码仓库转化为托管的交互式笔记本,使他人能够共享并运行交互式笔记本。Voila 可将笔记本转化为托管的 Web 应用,从而让用户无需看到代码即可完整交互。Datacamp Workspace 则允许用户共享笔记本,并提供模板来为数据添加故事。
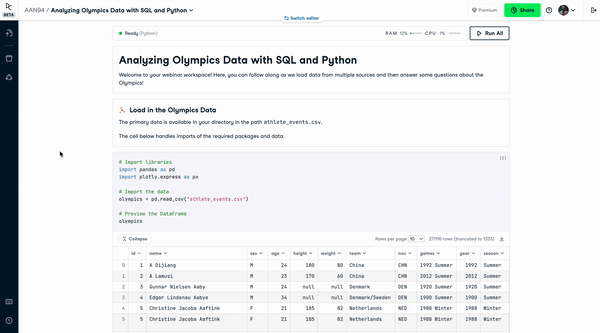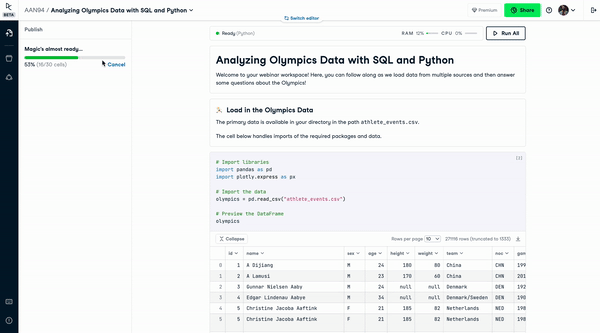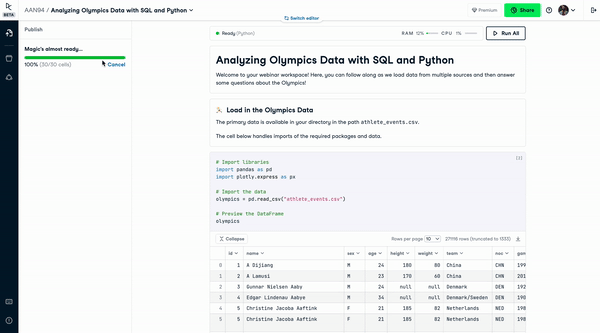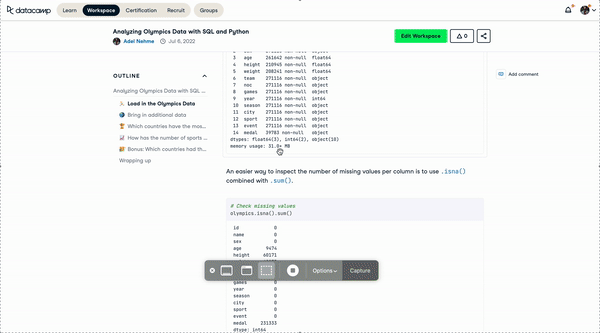
在 DataCamp Workspace 中发布报告
它们可以弥合人才鸿沟
数据科学既广且深:在众多不同领域都有大量知识需要学习。成为 NLP 专家并不意味着您是出色的数据工程师,甚至不意味着您了解计算机视觉。
连接数据科学各子领域的关键纽带是数据与基础设施。缺少优质数据,模型就难以表现出色。同样,缺少支持模型开发与数据清洗的基础设施,也很难起步。
对于公民数据科学家而言,并不需要工程技能。现代笔记本利用云端基础设施,让任何人都能迅速上手。环境与包管理完善,多数用户都能轻松更新与修改。这确保了工程技能上的缺口无需填补,从业者可以将时间投入到交付洞见上。
此外,大多数数据科学技术都能在笔记本中良好运行——可以训练模型、绘制三维图形、搭建数据管道。这样公民数据科学家就能尝试全谱系的方法,并轻松将结果传达给相关方,或与其他技术用户共享代码。
现代笔记本可与其他工具集成
我们已经看到现代笔记本如何打破团队间的数据孤岛,并降低处理数据的门槛。然而,笔记本历史上的另一个痛点,是与数据科学工作流中其他工具的集成不足,其中一个关键例子就是 SQL。
以往从业者会在 Python 中使用 `mysql.connector` 或在 R 中使用 `DBI` 等包来设置数据库连接。这些包需要手动配置数据库连接,并手动输入数据访问所需的相关凭据。
而现代笔记本则提供原生 SQL 支持。例如,在 DataCamp Workspace 中,用户可以直接从 DataCamp Notebook 编辑器安全连接到 PostgreSQL、MySQL 与 Amazon Redshift 等数据库。随后,便可使用 R 或 Python 对集成数据库中提取的数据进行分析。
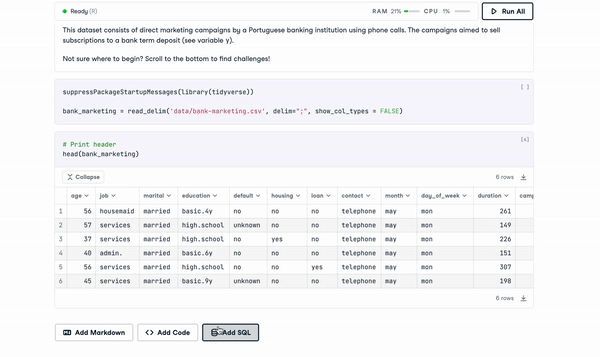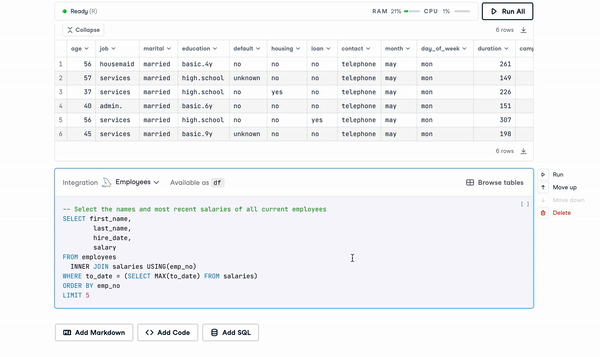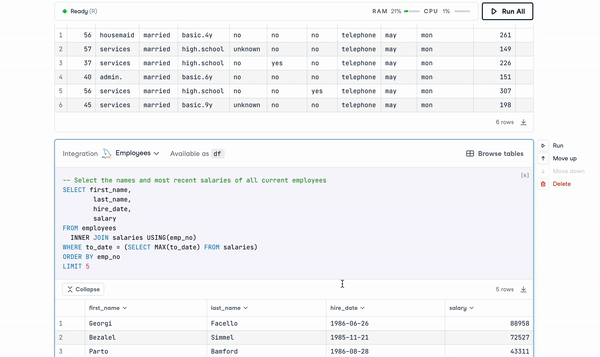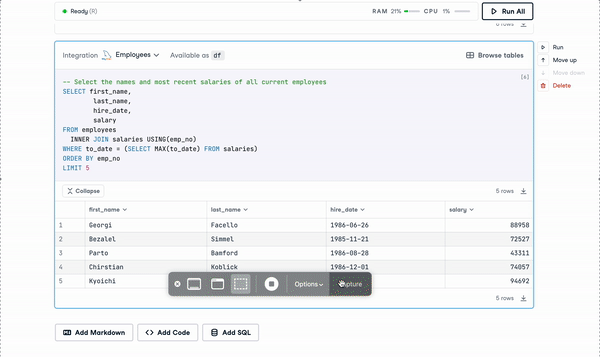
DataCamp Workspace 中的 SQL 单元格
数据科学笔记本的未来
现代笔记本位于数据革命的核心。它让具有不同技能组合的从业者能够轻松试验数据、共享洞见,并弥合业务与数据团队之间的鸿沟。此外,笔记本正在赋能公民数据科学家,推动组织内部新一轮的数据素养提升。
像 Netflix 这样的数据优先组织因其笔记本创新而闻名,笔记本是其跨角色与团队处理数据的最流行工具。笔记本的未来将由更强的敏捷性、与其余数据栈更好的集成,以及稳健的协作与分享所定义,从而实现数据洞见的普及。若想进一步了解笔记本,请查看以下资源:

在过去十多年里,笔记本在数据科学领域随处可见,每位数据科学家都使用过。它们通过快速创建环境、交互式输出以及可按任意顺序执行的代码片段,让数据科学家能够迅速进行实验并共享见解。
各组织一直在大力投资数据科学与分析,其中一项关键投入就是帮助数据科学家高效工作、快速尝试数据的工具。笔记本正处于这一切的核心,是当今现代数据栈中众多工具创新的组成部分。更重要的是,笔记本也在赋能公民数据科学家,推动数据洞见的普及。
本文将回顾笔记本的过去、现在与未来,以及笔记本如何打破数据工作与协作中的壁垒。
数据科学笔记本的历史
如今几乎每位数据科学家都用过笔记本,其中最受欢迎的是Jupyter Notebooks。然而,笔记本的历史要早于数据科学本身——可以追溯到上世纪80年代初。
“文学化编程”的兴起
Donald Knuth 于 1984 年提出了文学化编程,旨在以人类可读的方式构建程序。其理念是用自然语言写出程序逻辑,并将代码片段与宏作为独立注释(称为“WEB”)嵌入其中。宏与教授计算机科学时使用的伪代码类似。
随后由预处理器解析 WEB,生成源代码(“tangle”)与文档(“weave”)。文学化编程至今仍在使用,例如在Axiom中;而其核心思想也促成了与我们今天所见颇为相似的笔记本形态。
早期笔记本
早期的关键笔记本是 Wolfram Mathematica 和 Maple,于80年代末发布。它们以前端加后端内核的方式运行。下图展示了使用 Mathematica 生成的三维图,以及我们在当今笔记本中仍熟悉的
In[ ]与Out[ ]标注。早期的 Wolfram Mathematica 笔记本
这些工具存在一些细微差异,例如运行代码使用 Enter 而非 Shift + Enter,以及数学运算的显示方式不同。但二者都包含了影响现代笔记本设计的重要理念。
推广的关键障碍在于成本,这些工具价格昂贵且需要许可。这也是整个行业的普遍问题,促成了 1998 年开源促进会(Open Source Initiative)的诞生,由此带来了许多我们今天使用的强大且免费的工具(例如 Jupyter Notebooks!)。
现代数据科学笔记本的早期基础
2001 年,IPython 与 SciPy 发布,2003 年 Matplotlib 跟进。SciPy 让 Python 能执行多种科学计算,IPython 改善了终端中的用户体验并加入分布式计算支持。与今天一样,Matplotlib 让 Python 中的数据可视化变得轻而易举。
直到 2005 年,这些开源工具(以及其他工具)才被整合进名为 SageMath 的单一工具。其目标是提供 Mathematica 与 Maple 的开源替代方案,将其他科学开源工具加以整合与拓展,并提供现代笔记本所必备的基于 Web 的功能。
2011 年,IPython 发布了其 Notebook,清晰地区分了 Web 应用前端与底层的笔记本文档。
IPython Notebook
Jupyter Notebooks 的诞生
2014 年,Jupyter 从 IPython 中独立,推出笔记本界面并吸收了 IPython 中与语言无关的部分。其名称源自最初支持的语言:Julia、Python 和 R。Jupyter 笔记本如今已成为数据科学家的首选,毫无疑问是当下使用最广的笔记本界面。
近年来的一个重要发展方向,是将前端与内核分离的应用:用户通过浏览器访问前端,而内核运行在云端数据中心。一个很好的例子是DataCamp Workspace,您可以直接在浏览器中启动并使用 Jupyter Notebook 实例。
DataCamp Workspace 中的 JupyterLab
随着笔记本的普及与流行,近几年出现了一波现代笔记本界面,让任何人都能轻松处理数据。下一节我们将拆解现代笔记本如何打破数据工作的壁垒。
现代数据科学笔记本如何赋能公民数据科学家
“公民数据科学家”这一概念由Gartner 于 2016 年提出。公民数据科学家具备技术技能,但未必拥有传统的数据科学、统计学或计算机科学背景。
随着数据科学日益从一个学科拓展为解决业务问题的方法论,公民数据科学家成为现代数据驱动组织的代表。笔记本非常适合公民数据科学家,因为它们几乎没有门槛,却能支持快速实验与可共享的洞见。
笔记本一直非常适合快速探索与分析数据集,但此前在协作与分享洞见方面有所不足。到了 2022 年,这种情况已大为改观,现代笔记本及其周边生态已经覆盖了许多历史短板。以下是笔记本在提升生产力、效率与协作方面的几种方式。
现代数据科学笔记本具备协作能力
现代协作工具的一个典型例子是 Google 文档。许多用户可以共同使用与编辑文档,同时还能控制谁可以编辑、谁只能提出建议。更改会被定期保存,避免意外丢失。
类似的技术如今也可用于笔记本,例如Deepnote与Datacamp Workspace。多名用户可以编辑并运行笔记本,也可以留下评论。所有协作都在实时发生,使整个流程更加高效。
DataCamp Workspace 中的协作
协作对任何与数据打交道的人都至关重要。降低协作门槛也意味着通过共享知识与专业技能来减少数据孤岛。传统上,使用笔记本进行协作可能较为缓慢,而现代数据栈则快捷高效。许多工具能够与现有技术栈无缝集成,这意味着用户可以在熟悉的工具中工作,同时与同事协作。
它们有助于普及数据洞见
与其他用户共享分析可能很困难——无论对方是业务相关方还是更偏技术的人员。过去,从业者通常通过电子邮件、Slack、演示文稿或自建 Web 应用来分享笔记本报告中的洞见。
然而,现代笔记本通过无缝共享来实现洞见的民主化。例如,IPyWidgets 能在笔记本中加入交互式控件,这意味着用户可以拖动滑块更改图形,并更深入地与洞见互动。Binder 可将代码仓库转化为托管的交互式笔记本,使他人能够共享并运行交互式笔记本。Voila 可将笔记本转化为托管的 Web 应用,从而让用户无需看到代码即可完整交互。Datacamp Workspace 则允许用户共享笔记本,并提供模板来为数据添加故事。
在 DataCamp Workspace 中发布报告
它们可以弥合人才鸿沟
数据科学既广且深:在众多不同领域都有大量知识需要学习。成为 NLP 专家并不意味着您是出色的数据工程师,甚至不意味着您了解计算机视觉。
连接数据科学各子领域的关键纽带是数据与基础设施。缺少优质数据,模型就难以表现出色。同样,缺少支持模型开发与数据清洗的基础设施,也很难起步。
对于公民数据科学家而言,并不需要工程技能。现代笔记本利用云端基础设施,让任何人都能迅速上手。环境与包管理完善,多数用户都能轻松更新与修改。这确保了工程技能上的缺口无需填补,从业者可以将时间投入到交付洞见上。
此外,大多数数据科学技术都能在笔记本中良好运行——可以训练模型、绘制三维图形、搭建数据管道。这样公民数据科学家就能尝试全谱系的方法,并轻松将结果传达给相关方,或与其他技术用户共享代码。
现代笔记本可与其他工具集成
我们已经看到现代笔记本如何打破团队间的数据孤岛,并降低处理数据的门槛。然而,笔记本历史上的另一个痛点,是与数据科学工作流中其他工具的集成不足,其中一个关键例子就是 SQL。
以往从业者会在 Python 中使用
`mysql.connector`或在 R 中使用`DBI`等包来设置数据库连接。这些包需要手动配置数据库连接,并手动输入数据访问所需的相关凭据。而现代笔记本则提供原生 SQL 支持。例如,在 DataCamp Workspace 中,用户可以直接从 DataCamp Notebook 编辑器安全连接到 PostgreSQL、MySQL 与 Amazon Redshift 等数据库。随后,便可使用 R 或 Python 对集成数据库中提取的数据进行分析。
DataCamp Workspace 中的 SQL 单元格
数据科学笔记本的未来
现代笔记本位于数据革命的核心。它让具有不同技能组合的从业者能够轻松试验数据、共享洞见,并弥合业务与数据团队之间的鸿沟。此外,笔记本正在赋能公民数据科学家,推动组织内部新一轮的数据素养提升。
像 Netflix 这样的数据优先组织因其笔记本创新而闻名,笔记本是其跨角色与团队处理数据的最流行工具。笔记本的未来将由更强的敏捷性、与其余数据栈更好的集成,以及稳健的协作与分享所定义,从而实现数据洞见的普及。若想进一步了解笔记本,请查看以下资源: