什么是 Microsoft Fabric?
Microsoft Fabric 是为企业与数据专业人士打造的一体化分析平台。该平台覆盖从数据科学、实时分析到数据存储与数据迁移的全流程。它将多种工具与技术融合成一个协调一致的解决方案。
理解 Fabric 的最佳方式是把握其宗旨:简化。借助该工具,组织可将来自多个来源的数据整合到同一环境中。这种简化让数据专业人士能够专注于结果,而非所使用的技术。这也意味着数据团队不必再花费大量时间厘清 Synapse、Azure Data Factory 与 Power BI 的许可如何彼此配合。
Microsoft Fabric 的功能
微软团队将 Fabric 与市场上其他产品的差异点归纳为五大关键领域,包括:
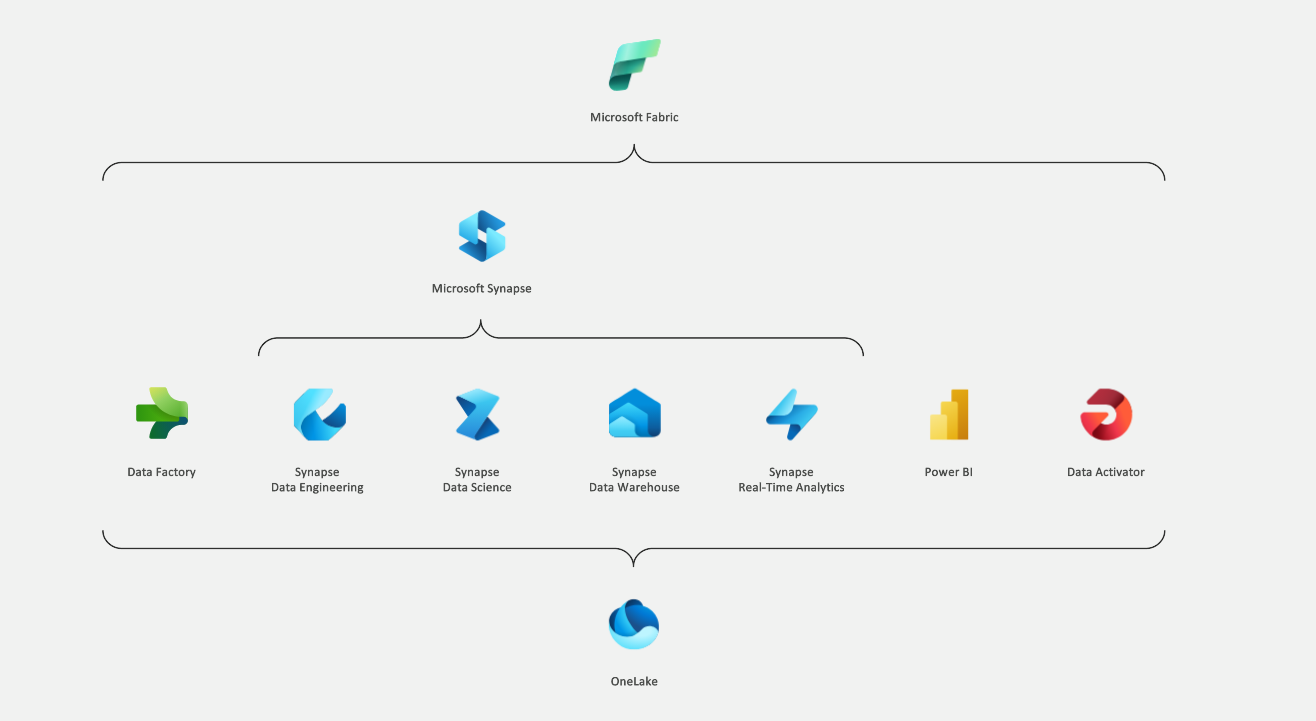
Microsoft Fabric 概览
#1 完整的一体化分析平台
每个分析项目都依赖多个支撑系统。这些系统通常各有独特需求,并常常需要多个供应商的投入。整合不同供应商的产品往往既困难、脆弱又昂贵。
这正是 Microsoft Fabric 发挥作用的地方。
Microsoft Fabric 为团队提供统一的解决方案,带来一致的用户界面、架构,以及从数据中提取并呈现洞见所需的多种工具,从而缓解上述难题。
#2 以数据湖为中心且开放
数据湖往往杂乱而复杂,构建、集成与管理都极具挑战。此外,一旦数据湖投入使用,因在同一数据湖上使用多种采用不同专有数据格式的数据产品,还会带来数据重复与供应商锁定问题。
Fabric 通过引入内置的多云软件即服务(SaaS)数据湖“OneLake”来解决这一问题。类似所有 Microsoft 365 应用会自动连接 OneDrive,Fabric 的全部工作负载也都接入 OneLake。
OneLake 的内置集成有助于消除当团队成员各自配置独立存储账户而产生的普遍且无序的数据孤岛。OneLake 为整个团队提供单一、统一的存储,使数据发现与共享变得简单。
#3 人工智能
Azure 的 OpenAI 服务在 Microsoft Fabric 的各层均有集成,帮助用户释放数据的全部潜能。这一集成还使开发者能够将生成式 AI 的能力应用于客户数据,助力业务用户发掘数据洞见。
由于 Copilot 融入了每一种 Microsoft Fabric 的数据体验,用户可以用自然对话来:
- 构建机器学习模型
- 开发数据流与数据管道
- 生成代码与完整函数
- 可视化结果
用户甚至可以创建自定义的对话式体验,将其数据与 Azure OpenAI Service 模型相结合,并以插件形式发布。
#4 赋能所有业务用户
当组织内的每个人都能借助数据做出更佳决策时,团队才能真正推动数据驱动文化。Microsoft Fabric 通过让分析人人可用来培育这种文化。更具体地说,Fabric 与日常常用的 Microsoft 365 应用深度集成,使这些应用成为发现与应用洞见的关键入口。
#5 通过统一算力降低成本
在一个项目中组合多个供应商的各种产品时,往往会出现大量浪费。这是由于在数据工程、数据仓库与商业智能等多个系统中分别预置了计算能力。一旦其中某个系统空闲,其他系统也无法利用其算力,导致资源浪费。
Fabric 通过简化资源采购与管理来缓解这一问题。借助 Fabric,您可以为所有工作负载(如数据集成、数据科学等)购买单一的计算池。该一体化模式显著降低成本,因为任一工作负载中未使用的计算资源都可被其他工作负载利用。
OneLake:Fabric 的核心
Microsoft Fabric 的核心是 OneLake。OneLake 实质上是 Fabric 中所有数据的存放之处。顾名思义,OneLake 是一个单一、统一、逻辑上的数据湖,负责支撑您所有的 Fabric 工作负载。
人们常将 OneLake 与 OneDrive 作比较。微软的说法是:“就像 Office 将 Word、Excel 和 PowerPoint 文件存储在 OneDrive 中一样,Fabric 将湖仓、数据仓库和其他项目存储在 OneLake 中。”因此,也常有人用类比来形容:OneLake 之于数据,正如 OneDrive 之于文件。
在 OneLake 出现之前,组织通常会为不同团队分别创建多个数据湖,而不是在一个数据湖上协作,即使这意味着需要额外的资源。OneLake 的引入旨在打破数据孤岛,通过简化组织数据管理来提升协作。

Microsoft OneLake 实际应用——图片来源
其关键特性包括:
快捷方式
“快捷方式”功能使用户能够将不同业务组与域中的数据整合到其虚拟数据产品中。也就是说,组织可以在无需不必要地移动或复制信息的情况下,轻松在不同用户与应用之间共享数据。“快捷方式”一词指的是存储在其他文件位置的数据,这些位置可能在同一工作区内,也可能跨不同工作区。无论位置如何,快捷方式引用都会让文件与文件夹看起来像是本地存储。
开放性
微软的 Azure Data Lake Storage(ADLS)Gen2 是构建在 Azure Blob 存储之上的大数据分析功能套件。ADLS Gen2 不仅提供海量存储,还能接收结构化与非结构化数据。这一点很重要,因为 OneLake 构建于 ADLS Gen2 之上,使其在各层面都保持开放。
OneLake 也兼容现有的 ADLS Gen2 应用(如 Azure Databricks),因为它支持相同的 ADLS Gen2 API 与 SDK。因此,访问底层数据并不需要具备 Microsoft Fabric 的专门经验;用户可以将 OneLake 中的数据视为整个组织的超大 ADLS 存储账户来进行访问。
单一数据副本
在 OneLake 中,为了让数据可供其他引擎使用而进行复制,或为与其他数据一起分析而打破孤岛的做法已不再必要。根据OneLake 文档所述,“OneLake 旨在无需数据移动或复制,即可最大化单一数据副本的价值。”
默认治理
SaaS 服务的一大独特优势在于“租户”概念。租户定义了在某软件实例上共享通用访问与特定权限的一组客户。OneLake 文档指出:“明确客户组织的边界天然形成治理与合规的界线,该界线最终由租户管理员控制。”本质上,落入 OneLake 的所有数据都默认受治理。
Fabric 的工作负载与用户体验
Microsoft Fabric 提供多种工作负载,每一种都围绕特定角色设计,并自动接入 OneLake,为每位用户带来独特的平台体验。
这些工作负载包括:
Data Factory
Data Factory 提供超过 150 个连接器,覆盖云端与本地数据源,具备编排数据管道以及拖拽式的数据转换体验。
Synapse 数据工程
数据工程工作负载内置与 Fabric 协同工作的功能,例如 Lakehouse。Lakehouse 工件存在于其自身的工作区内,并可使用 Spark 引擎实现微软所称的“出色的创作体验”。还包括其他优势,如即时启动的实时池与协作能力。
Synapse 数据仓库
数据仓库工作负载为数据工程师与分析师提供融合的 Lakehouse 与数据仓库体验。其背后是业界领先(基于开放数据格式)、统一的无服务器与专用 SQL 引擎。
Synapse 实时分析
实时分析工作负载使开发者能够从物联网(IoT)设备、遥测、日志等进行数据流式接入。由于以 Kusto 查询语言(KQL)为基础,它还能以高性能、低延迟分析大规模半结构化数据。
Synapse 数据科学
数据科学工作负载使用户能够贯穿端到端的数据科学流程。它为数据科学家提供构建复杂 AI 模型、协作项目、训练、部署与管理机器学习模型所需的多种工具。
Data Activator
Data Activator 是 Microsoft Fabric 中直观的零代码界面,旨在针对不断变化数据中识别出的模式或特定条件,自动触发相应操作。
商业智能(Power BI)
位于 Fabric 商业智能工作负载核心的是微软业界领先、由 AI 驱动的分析服务 Power BI。它使业务分析师与其他用户能够从组织数据中发现洞见。凭借与 Microsoft 365 的深度集成,组织还可直接在任一 365 产品中获取相关洞见。
