
课程
在 R 中使用 caret 的机器学习
4 小时
61K
实践并学习路径你的进步。
使用 Google 继续自助法是一种利用样本数据对总体进行推断的方法。Bradley Efron 于 1979 年在这篇论文中首次提出。自助法依赖于对样本数据进行有放回抽样。该技术可用于估计任意统计量的标准误,并为其构造置信区间(CI)。当 CI 不存在解析形式,或解析形式非常复杂时,自助法尤为有用。
设我们有一个包含 n 个元素的样本:X = {x1, x2, …, xn},且我们关注某个统计量 T = t(X) 的 CI。自助法框架很直接。我们只需重复进行 R 次以下步骤:在第 i 次重复中,从现有样本中有放回地抽取 n 个元素(其中一些会被多次抽中)。将这个新样本称为第 i 个自助样本 Xi,并计算所需统计量 Ti = t(Xi).
最终,我们会得到统计量的 R 个取值:T1, T2, …, TR。我们称它们为 T 的自助实现或 T 的自助分布。据此,我们可以计算 T 的 CI。方法有多种,取分位数似乎是最简单的一种。
我们再次使用众所周知的 iris 数据集。先看前几行:
 head(iris)

##   Sepal.Length Sepal.Width Petal.Length Petal.Width Species
## 1          5.1         3.5          1.4         0.2  setosa
## 2          4.9         3.0          1.4         0.2  setosa
## 3          4.7         3.2          1.3         0.2  setosa
## 4          4.6         3.1          1.5         0.2  setosa
## 5          5.0         3.6          1.4         0.2  setosa
## 6          5.4         3.9          1.7         0.4  setosa
假设我们想要计算中位数 Sepal.Length、中位数 Sepal.Width,以及这两者之间的斯皮尔曼等级相关系数的 CI。我们将使用 R 的 boot 包以及一个名为 boot 的函数。要使用它,我们需要创建一个函数,从重采样的数据中计算我们的统计量。该函数至少应有两个参数:一个 dataset,以及一个包含从数据集中抽取出来用于构造自助样本的元素 indices 的向量。
如果我们希望一次为多个统计量计算 CI,函数需要将它们作为单个向量返回。
在本例中,它可能像这样:
 library(boot)

foo <- function(data, indices){
  dt<-data[indices,]
  c(
    cor(dt[,1], dt[,2], method='s'),
    median(dt[,1]),
    median(dt[,2])
  )
}
foo 从 data 中选取所需元素(其编号存储在 indices 中),并计算前两列的相关系数(method='s' 表示使用斯皮尔曼等级相关系数,method='p' 则为皮尔逊相关系数)以及它们的中位数。
我们也可以添加一些额外参数,例如让用户选择相关系数的类型:
 foo <- function(data, indices, cor.type){
  dt<-data[indices,]
  c(
    cor(dt[,1], dt[,2], method=cor.type),
    median(dt[,1]),
    median(dt[,2])
  )
}
为使本教程更具普适性,下面我将使用后一种版本的 foo。
现在我们可以使用 boot 函数了。我们需要提供数据集名称、刚刚创建的函数、重复次数(R),以及我们函数的任何附加参数(如 cor.type)。下面我使用 set.seed 以保证示例可复现。
 set.seed(12345)
myBootstrap <- boot(iris, foo, R=1000, cor.type='s')
boot 函数返回一个名为(是的,您猜对了!)boot 的类对象。它有两个有趣的元素。$t 包含由自助程序生成的统计量(们)的 R 个取值(T 的自助实现):
 head(myBootstrap$t)

##             [,1] [,2] [,3]
## [1,] -0.26405188 5.70    3
## [2,] -0.12973299 5.80    3
## [3,] -0.07972066 5.75    3
## [4,] -0.16122705 6.00    3
## [5,] -0.20664808 6.00    3
## [6,] -0.12221170 5.80    3
$t0 包含在原始完整数据集中的统计量(们)取值:
 myBootstrap$t0

## [1] -0.1667777  5.8000000  3.0000000
在控制台打印 boot 对象会显示更多信息:
 myBootstrap

##
## ORDINARY NONPARAMETRIC BOOTSTRAP
##
##
## Call:
## boot(data = iris, statistic = foo, R = 1000, cor.type = "s")
##
##
## Bootstrap Statistics :
##       original       bias    std. error
## t1* -0.1667777  0.002546391  0.07573983
## t2*  5.8000000 -0.013350000  0.10295571
## t3*  3.0000000  0.007900000  0.02726414
original 与 $t0 相同。bias 是自助实现的均值(来自 $t,称为 T 的自助估计)与原始数据集中的取值(来自 $t0)之差。
 colMeans(myBootstrap$t)-myBootstrap$t0

## [1]  0.002546391 -0.013350000  0.007900000
std. error 是自助估计的标准误,等于自助实现的标准差。
 apply(myBootstrap$t,2,sd)

## [1] 0.07573983 0.10295571 0.02726414在计算 CI 之前,最好先看看自助实现的分布。我们可以使用 plot 函数,并通过 index 指定查看 foo 中计算的哪个统计量。这里 index=1 是花萼长度与宽度的斯皮尔曼相关系数,index=2 是花萼长度的中位数,index=3 是花萼宽度的中位数。
plot(myBootstrap, index=1)
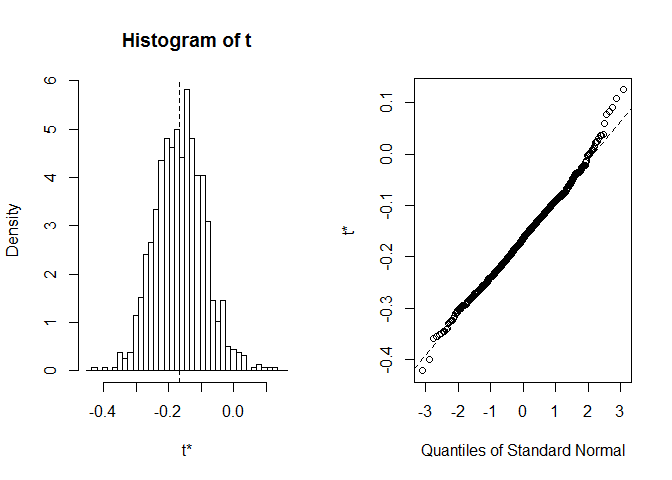
自助相关系数的分布看起来相当接近正态。让我们为其求 CI。可以使用 boot.ci。它默认计算 95% CI,但可通过 conf 参数进行调整。
 boot.ci(myBootstrap, index=1)

## Warning in boot.ci(myBootstrap, index = 1): bootstrap variances needed for
## studentized intervals

## BOOTSTRAP CONFIDENCE INTERVAL CALCULATIONS
## Based on 1000 bootstrap replicates
##
## CALL :
## boot.ci(boot.out = myBootstrap, index = 1)
##
## Intervals :
## Level      Normal              Basic
## 95%   (-0.3178, -0.0209 )   (-0.3212, -0.0329 )
##
## Level     Percentile            BCa
## 95%   (-0.3007, -0.0124 )   (-0.3005, -0.0075 )
## Calculations and Intervals on Original Scale
boot.ci 提供 5 种自助 CI。其中一种为 studentized 区间,它是特殊的,需要自助方差的估计。我们未提供该估计,因此 R 打印了一个警告:bootstrap variances needed for studentized intervals。方差估计可通过二级自助法或(更容易的)留一法(jackknife)获得。这超出了本教程范围,因此我们聚焦于其余四种自助 CI。
如果不想全部查看,可以在 type 参数中选择相关类型。可选值包括 norm、basic、stud、perc、bca,或它们的向量。
 boot.ci(myBootstrap, index=1, type=c('basic','perc'))

## BOOTSTRAP CONFIDENCE INTERVAL CALCULATIONS
## Based on 1000 bootstrap replicates
##
## CALL :
## boot.ci(boot.out = myBootstrap, type = c("basic", "perc"), index = 1)
##
## Intervals :
## Level      Basic              Percentile
## 95%   (-0.3212, -0.0329 )   (-0.3007, -0.0124 )
## Calculations and Intervals on Original Scale
boot.ci 函数会创建一个名为(是的,您又猜对了!)bootci 的对象。其元素以 type 参数中使用的 CI 类型命名。$norm 是一个包含置信水平与区间上下界的 3 元向量。
 boot.ci(myBootstrap, index=1, type='norm')$norm

##      conf
## [1,] 0.95 -0.3177714 -0.02087672$basic、$stud、$perc 和 $bca 是 5 元向量,还包含用于计算 CI 的分位数(稍后会回到这一点):
 boot.ci(myBootstrap, index=1, type='basic')$basic

##      conf
## [1,] 0.95 975.98 25.03 -0.3211981 -0.03285178为了理解不同类型 CI 的含义,我们需要引入一些符号。设:
在上述符号下,分位数 CI 为:
也就是说,只需取相应的分位数。不多也不少。
典型的 Wald CI 为:
但在自助情形下,我们应对偏差进行修正。因此变为:
$$ t_0 - b \pm z_\alpha \cdot se^\star \\ 2t_0 - t^\star \pm z_\alpha \cdot se^\star$$
分位数 CI 通常不被推荐,因为在尾部分布奇异时表现不佳。基本 CI(也称为 枢轴 或 经验 CI)要稳健得多。其原理是计算每个自助复制与 t0 的差值,并使用这些差值分布的分位数。完整细节可参见 L. Wasserman 的 All of Statistics。
基本 CI 的最终公式为:
BCα 来源于 “偏差校正、加速”(bias-corrected, accelerated)。其公式并不复杂,但有些不直观,这里略去。感兴趣可参阅 Thomas J. DiCiccio 和 Bradley Efron 的文章。
该方法名中的“加速”需要使用自助实现的特定分位数。有时这些可能是极端分位数,甚至是离群点。在这种情况下,BCα 可能不稳定。
让我们看一下花瓣宽度中位数的 BCα CI。在原始数据集中,该中位数恰好为 3。
 boot.ci(myBootstrap, index=3)

## Warning in boot.ci(myBootstrap, index = 3): bootstrap variances needed for
## studentized intervals

## Warning in norm.inter(t, adj.alpha): extreme order statistics used as
## endpoints

## BOOTSTRAP CONFIDENCE INTERVAL CALCULATIONS
## Based on 1000 bootstrap replicates
##
## CALL :
## boot.ci(boot.out = myBootstrap, index = 3)
##
## Intervals :
## Level      Normal              Basic
## 95%   ( 2.939,  3.046 )   ( 2.900,  3.000 )
##
## Level     Percentile            BCa
## 95%   ( 3.0,  3.1 )   ( 2.9,  2.9 )
## Calculations and Intervals on Original Scale
## Warning : BCa Intervals used Extreme Quantiles
## Some BCa intervals may be unstable
我们得到 BCα CI 为 (2.9, 2.9)。这有些奇怪,但好在 R 提醒了我们:extreme order statistics used as endpoints。让我们看看究竟发生了什么:
plot(myBootstrap, index=3)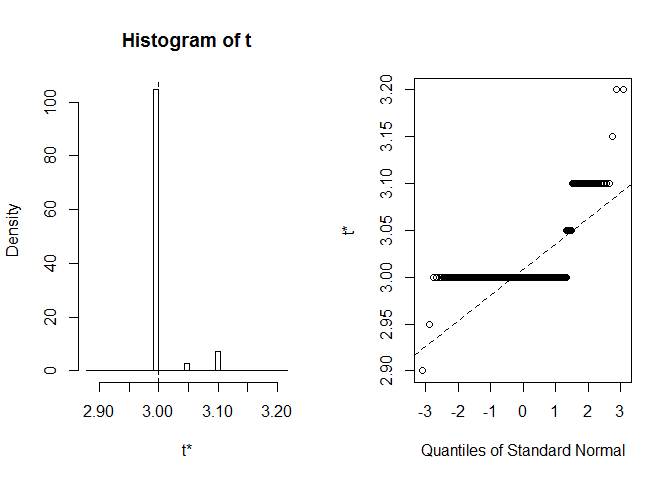
自助实现的分布并不常见。绝大多数(超过 90%)都是 3。
 table(myBootstrap$t[,3])

##
##  2.9 2.95    3 3.05  3.1 3.15  3.2
## 1 1 908 24 63 1 2在这种情况下,BCα 方法中的“加速”很容易“跳”到极端取值。此处,作为 BCα CI 基础的分位数 CI 为 (3, 3.1)。当我们“向左”扩展时,不得不使用 0.002 分位数;“向右”扩展也进入极端:0.997 分位数。
有时我们需要重建自助复制。如果可以使用 R,这不是问题,set.seed 函数即可解决。在其他软件中重建自助复制会复杂得多。而且,当 R 很大时,在 R 中重新计算也可能不可行(例如由于时间不足)。
我们可以通过保存原始数据集中构成每个自助样本的元素索引来处理该问题。这正是 boot.array 函数(配合 indices=T 参数)所做的。
tableOfIndices<-boot.array(myBootstrap, indices=T)每一行是一个自助样本。例如,我们的第一个样本包含以下元素:
 tableOfIndices[1,]

##   [1] 109  12 143  65  41  28 105  62  23 102  37  34  55  53  38   3  11
##  [18] 146  31 122  85 141 118 116 117  78 100  13  98  49  59  88  24  56
##  [35] 136   4  59  67 126 118 104 101  70  13  12  19  21 149  73 133  67
##  [52]  86   6  88 131 105 121 145 121  83  70  68  71 111  76  73 122 116
##  [69]  85 144 114 139  89 124  64  27  81  78  58  39  17  50  37 117  76
##  [86]  97 114  64  17  93 141  65 124  80 137  54  37  57  70 128  10  55
## [103]  13  53  59  45 116  14  77 118 108 138  50  78  49 104  49   1  85
## [120]  28  43  82  74  64  33  55  32  59  62 112   8  11  96  30  14  30
## [137]  38  85  66  85  97 107   4  18  76  35  31 133  27  69
将 indices=F(默认)时,我们会得到这样一个问题的答案:“原始数据集中的每个元素在每个自助样本中出现了多少次?”例如,在第一个样本中:第 1 个元素出现 1 次,第 2 个元素未出现,第 3 个元素出现 1 次,第 4 个元素出现 2 次,依此类推。
 tableOfAppearances<-boot.array(myBootstrap)
tableOfAppearances[1,]

##   [1] 1 0 1 2 0 1 0 1 0 1 2 2 3 2 0 0 2 1 1 0 1 0 1 1 0 0 2 2 0 2 2 1 1 1 1
##  [36] 0 3 2 1 0 1 0 1 0 1 0 0 0 3 2 0 0 2 1 3 1 1 1 4 0 0 2 0 3 2 1 2 1 1 3
##  [71] 1 0 2 1 0 3 1 3 0 1 1 1 1 0 5 1 0 2 1 0 0 0 1 0 0 1 2 1 0 1 1 1 0 2 2
## [106] 0 1 1 1 0 1 1 0 2 0 3 2 3 0 0 2 2 0 2 0 1 0 1 0 0 1 0 2 0 0 1 1 1 1 0
## [141] 2 0 1 1 1 1 0 0 1 0
这样的表可以让我们在 R 之外重建自助实现。或者即便在 R 中,当我们不想使用 set.seed 并再次完成所有计算时,也能重建。
onceAgain<-apply(tableOfIndices, 1, foo, data=iris, cor.type='s')检查结果是否一致:
 head(t(onceAgain))

##             [,1] [,2] [,3]
## [1,] -0.26405188 5.70    3
## [2,] -0.12973299 5.80    3
## [3,] -0.07972066 5.75    3
## [4,] -0.16122705 6.00    3
## [5,] -0.20664808 6.00    3
## [6,] -0.12221170 5.80    3

head(myBootstrap$t)

##             [,1] [,2] [,3]
## [1,] -0.26405188 5.70    3
## [2,] -0.12973299 5.80    3
## [3,] -0.07972066 5.75    3
## [4,] -0.16122705 6.00    3
## [5,] -0.20664808 6.00    3
## [6,] -0.12221170 5.80    3

all(t(onceAgain)==myBootstrap$t)

## [1] TRUE
是的,一致!
如果您想进一步学习 R 中的机器学习,请参加 DataCamp 的 Machine Learning Toolbox 课程,并查看 R 语言机器学习入门 教程。
进一步学习 R 与机器学习
课程
课程
实践并学习路径你的进步。
使用 Google 继续