Curso
Machine Learning com caret em R
4 h
60.8K
Bootstrap é um método de inferência sobre uma população usando dados amostrais. Bradley Efron o apresentou pela primeira vez neste artigo em 1979. O bootstrap se baseia em amostragem com reposição a partir dos dados da amostra. Essa técnica pode ser usada para estimar o erro-padrão de qualquer estatística e obter um intervalo de confiança (CI) para ela. O bootstrap é especialmente útil quando o CI não tem forma fechada ou é demasiadamente complexo.
Suponha que temos uma amostra de n elementos: X = {x1, x2, …, xn} e queremos um CI para alguma estatística T = t(X). O framework do bootstrap é direto: repetimos R vezes o seguinte esquema: na i-ésima repetição, amostramos com reposição n elementos da amostra disponível (alguns serão selecionados mais de uma vez). Chamamos essa nova amostra de i-ésima amostra bootstrap, Xi, e calculamos a estatística desejada Ti = t(Xi).
Como resultado, teremos R valores da nossa estatística: T1, T2, …, TR. Chamamos isso de realizações bootstrap de T ou distribuição bootstrap de T. A partir dela, podemos calcular o CI para T. Há várias formas de fazer isso; usar percentis costuma ser a mais simples.
Vamos usar (de novo) o famoso dataset iris. Veja as primeiras linhas:
 head(iris)

##   Sepal.Length Sepal.Width Petal.Length Petal.Width Species
## 1          5.1         3.5          1.4         0.2  setosa
## 2          4.9         3.0          1.4         0.2  setosa
## 3          4.7         3.2          1.3         0.2  setosa
## 4          4.6         3.1          1.5         0.2  setosa
## 5          5.0         3.6          1.4         0.2  setosa
## 6          5.4         3.9          1.7         0.4  setosa
Suponha que queremos encontrar CIs para a mediana de Sepal.Length, a mediana de Sepal.Width e o coeficiente de correlação de postos de Spearman entre as duas. Vamos usar o pacote boot do R e uma função chamada... boot. Para aproveitar seu potencial, precisamos criar uma função que calcule nossa(s) estatística(s) a partir dos dados reamostrados. Ela deve ter pelo menos dois argumentos: um dataset e um vetor com os indices dos elementos do dataset selecionados para compor a amostra bootstrap.
Se quisermos calcular CIs para mais de uma estatística de uma vez, nossa função deve retorná-las como um único vetor.
No nosso exemplo, pode ficar assim:
 library(boot)

foo <- function(data, indices){
  dt<-data[indices,]
  c(
    cor(dt[,1], dt[,2], method='s'),
    median(dt[,1]),
    median(dt[,2])
  )
}
foo escolhe os elementos desejados (cujos números estão em indices) de data e calcula o coeficiente de correlação das duas primeiras colunas (method='s' seleciona o coeficiente de Spearman; method='p' retorna o coeficiente de Pearson) e suas medianas.
Também podemos adicionar argumentos extras, por exemplo, deixar o usuário escolher o tipo de coeficiente de correlação:
 foo <- function(data, indices, cor.type){
  dt<-data[indices,]
  c(
    cor(dt[,1], dt[,2], method=cor.type),
    median(dt[,1]),
    median(dt[,2])
  )
}
Para deixar este tutorial mais geral, vou usar a segunda versão de foo.
Agora podemos usar a função boot. Precisamos informar o nome do dataset, a função que acabamos de criar, o número de repetições (R) e quaisquer argumentos adicionais da nossa função (como cor.type). Abaixo, uso set.seed para tornar o exemplo reproduzível.
 set.seed(12345)
myBootstrap <- boot(iris, foo, R=1000, cor.type='s')
A função boot retorna um objeto da classe... (sim, você acertou!) boot. Ele tem dois elementos interessantes. $t contém os R valores da(s) nossa(s) estatística(s) gerados pelo procedimento bootstrap (as realizações bootstrap de T):
 head(myBootstrap$t)

##             [,1] [,2] [,3]
## [1,] -0.26405188 5.70    3
## [2,] -0.12973299 5.80    3
## [3,] -0.07972066 5.75    3
## [4,] -0.16122705 6.00    3
## [5,] -0.20664808 6.00    3
## [6,] -0.12221170 5.80    3
$t0 contém os valores da(s) nossa(s) estatística(s) no dataset original, completo:
 myBootstrap$t0

## [1] -0.1667777  5.8000000  3.0000000
Imprimir o objeto boot no console traz mais algumas informações:
 myBootstrap

##
## ORDINARY NONPARAMETRIC BOOTSTRAP
##
##
## Call:
## boot(data = iris, statistic = foo, R = 1000, cor.type = "s")
##
##
## Bootstrap Statistics :
##       original       bias    std. error
## t1* -0.1667777  0.002546391  0.07573983
## t2*  5.8000000 -0.013350000  0.10295571
## t3*  3.0000000  0.007900000  0.02726414
original é o mesmo que $t0. bias é a diferença entre a média das realizações bootstrap (as de $t), chamada de estimativa bootstrap de T, e o valor no dataset original (o de $t0).
 colMeans(myBootstrap$t)-myBootstrap$t0

## [1]  0.002546391 -0.013350000  0.007900000
std. error é o erro-padrão da estimativa bootstrap, que é igual ao desvio-padrão das realizações bootstrap.
 apply(myBootstrap$t,2,sd)

## [1] 0.07573983 0.10295571 0.02726414Antes de partir para os CIs, sempre vale a pena olhar a distribuição das realizações bootstrap. Podemos usar a função plot, com index indicando qual estatística calculada em foo queremos analisar. Aqui, index=1 é o coeficiente de Spearman entre comprimento e largura da sépala; index=2 é a mediana do comprimento da sépala; e index=3 é a mediana da largura da sépala.
plot(myBootstrap, index=1)
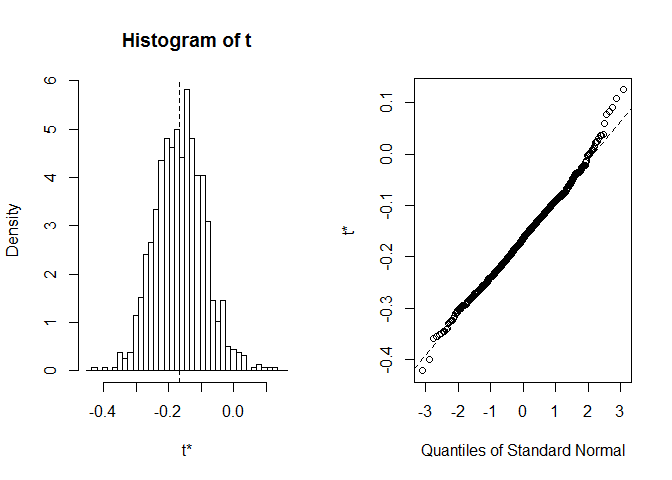
A distribuição dos coeficientes de correlação bootstrap parece bem próxima da normal. Vamos encontrar um CI para ela. Podemos usar boot.ci. O padrão é CI de 95%, mas isso pode ser alterado com o parâmetro conf.
 boot.ci(myBootstrap, index=1)

## Warning in boot.ci(myBootstrap, index = 1): bootstrap variances needed for
## studentized intervals

## BOOTSTRAP CONFIDENCE INTERVAL CALCULATIONS
## Based on 1000 bootstrap replicates
##
## CALL :
## boot.ci(boot.out = myBootstrap, index = 1)
##
## Intervals :
## Level      Normal              Basic
## 95%   (-0.3178, -0.0209 )   (-0.3212, -0.0329 )
##
## Level     Percentile            BCa
## 95%   (-0.3007, -0.0124 )   (-0.3005, -0.0075 )
## Calculations and Intervals on Original Scale
boot.ci fornece 5 tipos de CIs com bootstrap. Um deles, o intervalo studentizado, é particular: ele precisa de uma estimativa da variância bootstrap. Não a fornecemos, então o R imprime o aviso: bootstrap variances needed for studentized intervals. Estimativas de variância podem ser obtidas com um bootstrap de segundo nível ou (mais fácil) com a técnica jackknife. Isso foge um pouco do escopo deste tutorial, então vamos focar nos outros quatro tipos de CI com bootstrap.
Se não quisermos visualizar todos, podemos escolher os relevantes no argumento type. Os valores possíveis são norm, basic, stud, perc, bca ou um vetor com esses.
 boot.ci(myBootstrap, index=1, type=c('basic','perc'))

## BOOTSTRAP CONFIDENCE INTERVAL CALCULATIONS
## Based on 1000 bootstrap replicates
##
## CALL :
## boot.ci(boot.out = myBootstrap, type = c("basic", "perc"), index = 1)
##
## Intervals :
## Level      Basic              Percentile
## 95%   (-0.3212, -0.0329 )   (-0.3007, -0.0124 )
## Calculations and Intervals on Original Scale
A função boot.ci cria um objeto da classe... (acertou!) bootci. Seus elementos têm os mesmos nomes dos tipos de CI usados no argumento type. $norm é um vetor de 3 elementos com o nível de confiança e os limites do CI.
 boot.ci(myBootstrap, index=1, type='norm')$norm

##      conf
## [1,] 0.95 -0.3177714 -0.02087672$basic, $stud, $perc e $bca são vetores de 5 elementos que também incluem os percentis usados para calcular o CI (voltaremos a isso em seguida):
 boot.ci(myBootstrap, index=1, type='basic')$basic

##      conf
## [1,] 0.95 975.98 25.03 -0.3211981 -0.03285178Para entender os diferentes tipos de CI, precisamos introduzir alguma notação. Considere:
Com a notação acima, o CI por percentis é:
ou seja, basta pegar os percentis correspondentes. Simples assim.
Um CI de Wald típico seria:
mas, no caso do bootstrap, devemos corrigi-lo para o viés. Assim, ele fica:
$$ t_0 - b \pm z_\alpha \cdot se^\star \\ 2t_0 - t^\star \pm z_\alpha \cdot se^\star$$
O CI por percentis geralmente não é recomendado porque tem desempenho ruim em distribuições com caudas estranhas. O CI básico (também chamado de pivotal ou empírico) é bem mais robusto. A ideia é calcular as diferenças entre cada replicação bootstrap e t0 e usar os percentis dessa distribuição. Detalhes completos podem ser encontrados, por exemplo, em All of Statistics, de L. Wasserman.
A fórmula final para o CI básico é:
BCα vem de bias-corrected, accelerated (corrigido para viés e acelerado). A fórmula não é muito complicada, mas é pouco intuitiva, então vou pular. Veja o artigo de Thomas J. DiCiccio e Bradley Efron se quiser os detalhes.
A aceleração citada no nome do método exige usar percentis específicos das realizações bootstrap. Às vezes pode acontecer de esses percentis serem extremos, possivelmente outliers. Nesses casos, o BCα pode ficar instável.
Vamos olhar o CI BCα para a mediana da largura da pétala. No dataset original, essa mediana é exatamente 3.
 boot.ci(myBootstrap, index=3)

## Warning in boot.ci(myBootstrap, index = 3): bootstrap variances needed for
## studentized intervals

## Warning in norm.inter(t, adj.alpha): extreme order statistics used as
## endpoints

## BOOTSTRAP CONFIDENCE INTERVAL CALCULATIONS
## Based on 1000 bootstrap replicates
##
## CALL :
## boot.ci(boot.out = myBootstrap, index = 3)
##
## Intervals :
## Level      Normal              Basic
## 95%   ( 2.939,  3.046 )   ( 2.900,  3.000 )
##
## Level     Percentile            BCa
## 95%   ( 3.0,  3.1 )   ( 2.9,  2.9 )
## Calculations and Intervals on Original Scale
## Warning : BCa Intervals used Extreme Quantiles
## Some BCa intervals may be unstable
Obtivemos o CI BCα (2.9, 2.9). Estranho, mas, felizmente, o R nos alertou que extreme order statistics used as endpoints. Vamos ver o que aconteceu:
plot(myBootstrap, index=3)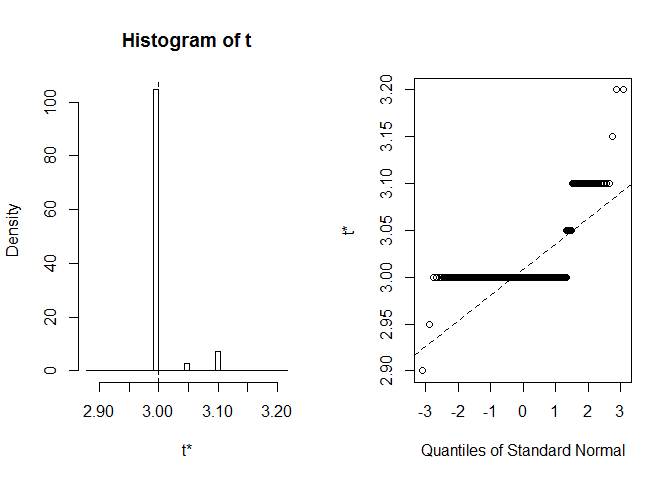
A distribuição das realizações bootstrap é atípica. Uma grande maioria delas (mais de 90%) é igual a 3.
 table(myBootstrap$t[,3])

##
##  2.9 2.95    3 3.05  3.1 3.15  3.2
##    1    1  908   24   63    1    2
Nessa situação, a "aceleração" no método BCα facilmente "salta" para valores extremos. Aqui, o CI por percentis, que serve de base para o CI BCα, é (3, 3.1). Ao expandi-lo "para a esquerda", precisamos usar o percentil 0,002. A expansão "para a direita" também vai ao extremo: percentil 0,997.
Às vezes, precisamos recriar as reamostragens do bootstrap. Se pudermos usar o R, isso não é problema: a função set.seed resolve. Reconstituir as reamostragens em outro software é bem mais complicado. Além disso, para R grande, recalcular no R também pode não ser uma opção (por falta de tempo, por exemplo).
Podemos contornar isso salvando os índices dos elementos do dataset original que formaram cada amostra bootstrap. É exatamente o que a função boot.array faz (com indices=T).
tableOfIndices<-boot.array(myBootstrap, indices=T)Cada linha é uma amostra bootstrap. Por exemplo, nossa primeira amostra contém os seguintes elementos:
 tableOfIndices[1,]

##   [1] 109  12 143  65  41  28 105  62  23 102  37  34  55  53  38   3  11
##  [18] 146  31 122  85 141 118 116 117  78 100  13  98  49  59  88  24  56
##  [35] 136   4  59  67 126 118 104 101  70  13  12  19  21 149  73 133  67
##  [52]  86   6  88 131 105 121 145 121  83  70  68  71 111  76  73 122 116
##  [69]  85 144 114 139  89 124  64  27  81  78  58  39  17  50  37 117  76
##  [86]  97 114  64  17  93 141  65 124  80 137  54  37  57  70 128  10  55
## [103]  13  53  59  45 116  14  77 118 108 138  50  78  49 104  49   1  85
## [120]  28  43  82  74  64  33  55  32  59  62 112   8  11  96  30  14  30
## [137]  38  85  66  85  97 107   4  18  76  35  31 133  27  69
Definindo indices=F (padrão), teremos a resposta para a pergunta: "Quantas vezes cada elemento do dataset original apareceu em cada amostra bootstrap?". Por exemplo, na primeira amostra: o 1º elemento do dataset apareceu uma vez, o 2º não apareceu, o 3º apareceu uma vez, o 4º duas vezes e assim por diante.
 tableOfAppearances<-boot.array(myBootstrap)
tableOfAppearances[1,]

##   [1] 1 0 1 2 0 1 0 1 0 1 2 2 3 2 0 0 2 1 1 0 1 0 1 1 0 0 2 2 0 2 2 1 1 1 1
##  [36] 0 3 2 1 0 1 0 1 0 1 0 0 0 3 2 0 0 2 1 3 1 1 1 4 0 0 2 0 3 2 1 2 1 1 3
##  [71] 1 0 2 1 0 3 1 3 0 1 1 1 1 0 5 1 0 2 1 0 0 0 1 0 0 1 2 1 0 1 1 1 0 2 2
## [106] 0 1 1 1 0 1 1 0 2 0 3 2 3 0 0 2 2 0 2 0 1 0 1 0 0 1 0 2 0 0 1 1 1 1 0
## [141] 2 0 1 1 1 1 0 0 1 0
Uma tabela como essa permite recriar as realizações bootstrap fora do R. Ou no próprio R quando não quisermos usar set.seed e refazer todos os cálculos.
onceAgain<-apply(tableOfIndices, 1, foo, data=iris, cor.type='s')Vamos conferir se os resultados batem:
 head(t(onceAgain))

##             [,1] [,2] [,3]
## [1,] -0.26405188 5.70    3
## [2,] -0.12973299 5.80    3
## [3,] -0.07972066 5.75    3
## [4,] -0.16122705 6.00    3
## [5,] -0.20664808 6.00    3
## [6,] -0.12221170 5.80    3

head(myBootstrap$t)

##             [,1] [,2] [,3]
## [1,] -0.26405188 5.70    3
## [2,] -0.12973299 5.80    3
## [3,] -0.07972066 5.75    3
## [4,] -0.16122705 6.00    3
## [5,] -0.20664808 6.00    3
## [6,] -0.12221170 5.80    3

all(t(onceAgain)==myBootstrap$t)

## [1] TRUE
Sim, são os mesmos!
Se você quiser aprender mais sobre Machine Learning em R, faça o curso Machine Learning Toolbox da DataCamp e confira o tutorial Machine Learning em R para iniciantes.
Saiba mais sobre R e machine learning
Curso
Curso
Curso
blog
Arun Nanda
15 min
Tutorial
DataCamp Team
15 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Abid Ali Awan
11 min
Tutorial
Karlijn Willems
15 min
Tutorial
Elena Kosourova
12 min


