Cours
Machine Learning avec caret en R
4 h
60.8K
Le bootstrap est une méthode d'inférence sur une population à partir de données d'échantillon. Bradley Efron l'a présentée pour la première fois dans cet article en 1979. Le bootstrap repose sur le tirage avec remise à partir de l'échantillon observé. Cette technique permet d'estimer l'erreur standard de n'importe quelle statistique et d'obtenir un intervalle de confiance (IC) pour celle-ci. Le bootstrap est particulièrement utile lorsque l'IC n'a pas de forme fermée, ou qu'elle est très compliquée.
Supposons que nous ayons un échantillon de n éléments : X = {x1, x2, …, xn} et que nous cherchions un IC pour une statistique T = t(X). Le cadre du bootstrap est simple. On répète R fois le schéma suivant : pour la i-ème répétition, on tire avec remise n éléments de l'échantillon disponible (certains seront sélectionnés plusieurs fois). On appelle ce nouvel échantillon le i-ème échantillon bootstrap, Xi, et on calcule la statistique souhaitée Ti = t(Xi).
Au final, on obtient R valeurs de notre statistique : T1, T2, …, TR. On les appelle les réalisations bootstrap de T ou la distribution bootstrap de T. À partir de celle-ci, nous pouvons calculer un IC pour T. Il existe plusieurs façons de faire, la méthode des percentiles étant la plus simple.
Utilisons (encore une fois) le célèbre jeu de données iris. Voici ses premières lignes :
 head(iris)

##   Sepal.Length Sepal.Width Petal.Length Petal.Width Species
## 1          5.1         3.5          1.4         0.2  setosa
## 2          4.9         3.0          1.4         0.2  setosa
## 3          4.7         3.2          1.3         0.2  setosa
## 4          4.6         3.1          1.5         0.2  setosa
## 5          5.0         3.6          1.4         0.2  setosa
## 6          5.4         3.9          1.7         0.4  setosa
Supposons que nous voulions estimer des IC pour la médiane de Sepal.Length, la médiane de Sepal.Width et le coefficient de corrélation de rang de Spearman entre ces deux variables. Nous allons utiliser le package boot de R et une fonction nommée... boot. Pour l'exploiter, nous devons créer une fonction qui calcule notre ou nos statistiques à partir des données rééchantillonnées. Elle doit avoir au minimum deux arguments : un dataset et un vecteur d'indices des éléments du jeu de données sélectionnés pour constituer un échantillon bootstrap.
Si nous souhaitons calculer des IC pour plusieurs statistiques en une seule fois, notre fonction doit les retourner sous la forme d'un seul vecteur.
Dans notre exemple, cela peut ressembler à ceci :
 library(boot)

foo <- function(data, indices){
  dt<-data[indices,]
  c(
    cor(dt[,1], dt[,2], method='s'),
    median(dt[,1]),
    median(dt[,2])
  )
}
foo choisit les éléments voulus (dont les numéros sont stockés dans indices) dans data et calcule le coefficient de corrélation des deux premières colonnes (method='s' sélectionne le coefficient de Spearman, method='p' donne le coefficient de Pearson) ainsi que leurs médianes.
Nous pouvons aussi ajouter des arguments supplémentaires, par exemple laisser l'utilisateur choisir le type de coefficient de corrélation :
 foo <- function(data, indices, cor.type){
  dt<-data[indices,]
  c(
    cor(dt[,1], dt[,2], method=cor.type),
    median(dt[,1]),
    median(dt[,2])
  )
}
Pour généraliser le tutoriel, j'utiliserai la seconde version de foo.
Nous pouvons maintenant utiliser la fonction boot. Il faut lui fournir le nom du jeu de données, la fonction que nous venons de créer, le nombre de répétitions (R) et tout argument additionnel de notre fonction (comme cor.type). Ci-dessous, j'utilise set.seed pour rendre l'exemple reproductible.
 set.seed(12345)
myBootstrap <- boot(iris, foo, R=1000, cor.type='s')
La fonction boot renvoie un objet de classe... (oui, vous avez deviné !) boot. Il comporte deux éléments intéressants. $t contient les R valeurs de notre ou nos statistiques générées par la procédure bootstrap (les réalisations bootstrap de T) :
 head(myBootstrap$t)

##             [,1] [,2] [,3]
## [1,] -0.26405188 5.70    3
## [2,] -0.12973299 5.80    3
## [3,] -0.07972066 5.75    3
## [4,] -0.16122705 6.00    3
## [5,] -0.20664808 6.00    3
## [6,] -0.12221170 5.80    3
$t0 contient les valeurs de nos statistiques dans le jeu de données original et complet :
 myBootstrap$t0

## [1] -0.1667777  5.8000000  3.0000000
Afficher l'objet boot dans la console donne des informations supplémentaires :
 myBootstrap

##
## ORDINARY NONPARAMETRIC BOOTSTRAP
##
##
## Call:
## boot(data = iris, statistic = foo, R = 1000, cor.type = "s")
##
##
## Bootstrap Statistics :
##       original       bias    std. error
## t1* -0.1667777  0.002546391  0.07573983
## t2*  5.8000000 -0.013350000  0.10295571
## t3*  3.0000000  0.007900000  0.02726414
original correspond à $t0. bias est la différence entre la moyenne des réalisations bootstrap (celles de $t), appelée estimation bootstrap de T, et la valeur du jeu de données original (celle de $t0).
 colMeans(myBootstrap$t)-myBootstrap$t0

## [1]  0.002546391 -0.013350000  0.007900000
std. error est l'erreur standard de l'estimation bootstrap, égale à l'écart type des réalisations bootstrap.
 apply(myBootstrap$t,2,sd)

## [1] 0.07573983 0.10295571 0.02726414Avant de passer aux IC, il est toujours utile d'examiner la distribution des réalisations bootstrap. Nous pouvons utiliser la fonction plot, avec index indiquant laquelle des statistiques calculées dans foo nous souhaitons visualiser. Ici, index=1 est le coefficient de corrélation de Spearman entre la longueur et la largeur du sépale, index=2 est la médiane de la longueur du sépale, et index=3 est la médiane de la largeur du sépale.
plot(myBootstrap, index=1)
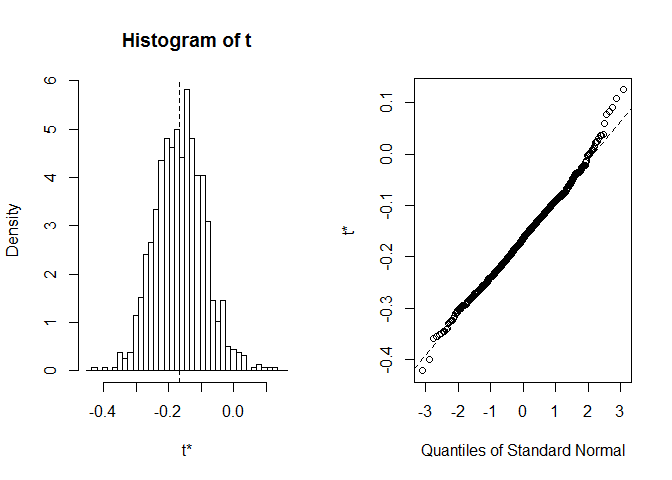
La distribution des coefficients de corrélation bootstrap semble assez proche de la normale. Trouvons son IC. Nous pouvons utiliser boot.ci. Par défaut, il calcule des IC à 95 %, mais cela peut être modifié avec le paramètre conf.
 boot.ci(myBootstrap, index=1)

## Warning in boot.ci(myBootstrap, index = 1): bootstrap variances needed for
## studentized intervals

## BOOTSTRAP CONFIDENCE INTERVAL CALCULATIONS
## Based on 1000 bootstrap replicates
##
## CALL :
## boot.ci(boot.out = myBootstrap, index = 1)
##
## Intervals :
## Level      Normal              Basic
## 95%   (-0.3178, -0.0209 )   (-0.3212, -0.0329 )
##
## Level     Percentile            BCa
## 95%   (-0.3007, -0.0124 )   (-0.3005, -0.0075 )
## Calculations and Intervals on Original Scale
boot.ci fournit 5 types d'IC bootstrap. L'un d'eux, l'intervalle studentisé, est particulier. Il nécessite une estimation de la variance bootstrap. Nous ne l'avons pas fournie, donc R affiche un avertissement : bootstrap variances needed for studentized intervals. On peut obtenir cette variance via un bootstrap de second niveau ou (plus simplement) par la technique du jackknife. Cela dépasse le cadre de ce tutoriel, concentrons-nous donc sur les quatre autres types d'IC bootstrap.
Si nous ne souhaitons pas tous les afficher, nous pouvons sélectionner les types pertinents avec l'argument type. Les valeurs possibles sont norm, basic, stud, perc, bca ou un vecteur combinant ces options.
 boot.ci(myBootstrap, index=1, type=c('basic','perc'))

## BOOTSTRAP CONFIDENCE INTERVAL CALCULATIONS
## Based on 1000 bootstrap replicates
##
## CALL :
## boot.ci(boot.out = myBootstrap, type = c("basic", "perc"), index = 1)
##
## Intervals :
## Level      Basic              Percentile
## 95%   (-0.3212, -0.0329 )   (-0.3007, -0.0124 )
## Calculations and Intervals on Original Scale
La fonction boot.ci crée un objet de classe... (vous l'avez encore deviné !) bootci. Ses éléments portent le nom des types d'IC demandés dans l'argument type. $norm est un vecteur de 3 éléments contenant le niveau de confiance et les bornes de l'IC.
 boot.ci(myBootstrap, index=1, type='norm')$norm

##      conf
## [1,] 0.95 -0.3177714 -0.02087672$basic, $stud, $perc et $bca sont des vecteurs à 5 éléments qui incluent également les percentiles utilisés pour calculer l'IC (nous y reviendrons) :
 boot.ci(myBootstrap, index=1, type='basic')$basic

##      conf
## [1,] 0.95 975.98 25.03 -0.3211981 -0.03285178Pour comprendre les différents types d'IC, introduisons quelques notations. Soit :
Avec la notation ci-dessus, l'IC par percentiles est :
il suffit donc de prendre les percentiles correspondants. Rien de plus.
Un IC de Wald classique serait :
mais dans le cas du bootstrap, on doit le corriger du biais. Il devient donc :
$$ t_0 - b \pm z_\alpha \cdot se^\star \\ 2t_0 - t^\star \pm z_\alpha \cdot se^\star$$
L'IC par percentiles est généralement déconseillé car il se comporte mal avec des distributions à queues atypiques. L'IC de base (aussi appelé pivotal ou empirique) est plus robuste. L'idée est de calculer les différences entre chaque réplication bootstrap et t0, puis d'utiliser les percentiles de leur distribution. Les détails complets se trouvent par exemple dans All of Statistics de L. Wasserman.
La formule finale de l'IC de base est :
BCα signifie bias-corrected, accelerated. Sa formule n'est pas très compliquée mais peu intuitive, nous ne la détaillerons pas ici. Voir l'article de Thomas J. DiCiccio et Bradley Efron pour les détails.
L'accélération mentionnée dans le nom de la méthode requiert l'utilisation de percentiles spécifiques des réalisations bootstrap. Il peut arriver que ces percentiles soient très extrêmes, potentiellement des valeurs aberrantes. Dans ce cas, l'IC BCα peut devenir instable.
Regardons l'IC BCα pour la médiane de la largeur des pétales. Dans le jeu de données original, cette médiane vaut exactement 3.
 boot.ci(myBootstrap, index=3)

## Warning in boot.ci(myBootstrap, index = 3): bootstrap variances needed for
## studentized intervals

## Warning in norm.inter(t, adj.alpha): extreme order statistics used as
## endpoints

## BOOTSTRAP CONFIDENCE INTERVAL CALCULATIONS
## Based on 1000 bootstrap replicates
##
## CALL :
## boot.ci(boot.out = myBootstrap, index = 3)
##
## Intervals :
## Level      Normal              Basic
## 95%   ( 2.939,  3.046 )   ( 2.900,  3.000 )
##
## Level     Percentile            BCa
## 95%   ( 3.0,  3.1 )   ( 2.9,  2.9 )
## Calculations and Intervals on Original Scale
## Warning : BCa Intervals used Extreme Quantiles
## Some BCa intervals may be unstable
Nous obtenons un IC BCα (2,9 ; 2,9). C'est surprenant, mais heureusement R nous a avertis : extreme order statistics used as endpoints. Voyons ce qui se passe précisément :
plot(myBootstrap, index=3)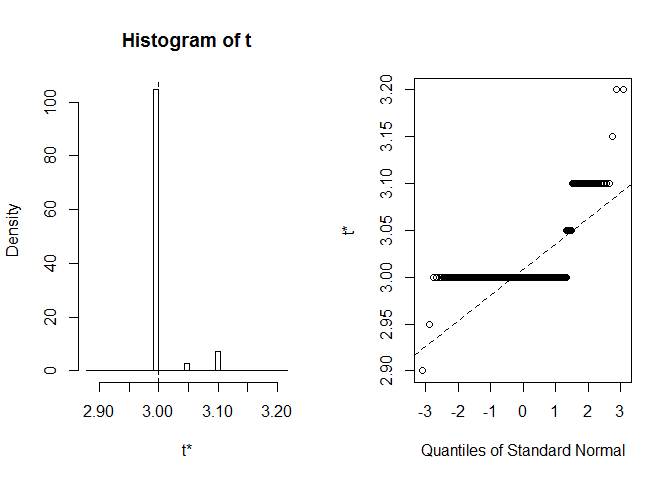
La distribution des réalisations bootstrap est inhabituelle. Une très large majorité (plus de 90 %) valent 3.
 table(myBootstrap$t[,3])

##
##  2.9 2.95    3 3.05  3.1 3.15  3.2
##    1    1  908   24   63    1    2
Dans une telle situation, l'accélération de la méthode BCα « saute » facilement vers des valeurs extrêmes. Ici, l'IC par percentiles, qui sert de base à l'IC BCα, est (3 ; 3,1). En l'étendant « vers la gauche », on doit utiliser le 0,002e percentile. L'extension « vers la droite » part aussi dans les extrêmes : le 0,997e percentile.
Parfois, nous devons recréer les réplicats bootstrap. Si nous pouvons utiliser R, aucun problème : la fonction set.seed règle la question. Recréer les réplicats dans un autre logiciel serait bien plus complexe. De plus, pour un R élevé, recalculer dans R peut aussi ne pas être envisageable (par manque de temps, par exemple).
Nous pouvons contourner ce problème en sauvegardant les indices des éléments du jeu de données initial qui constituent chaque échantillon bootstrap. C'est précisément ce que fait la fonction boot.array (avec l'argument indices=T).
tableOfIndices<-boot.array(myBootstrap, indices=T)Chaque ligne correspond à un échantillon bootstrap. Par exemple, notre premier échantillon contient les éléments suivants :
 tableOfIndices[1,]

##   [1] 109  12 143  65  41  28 105  62  23 102  37  34  55  53  38   3  11
##  [18] 146  31 122  85 141 118 116 117  78 100  13  98  49  59  88  24  56
##  [35] 136   4  59  67 126 118 104 101  70  13  12  19  21 149  73 133  67
##  [52]  86   6  88 131 105 121 145 121  83  70  68  71 111  76  73 122 116
##  [69]  85 144 114 139  89 124  64  27  81  78  58  39  17  50  37 117  76
##  [86]  97 114  64  17  93 141  65 124  80 137  54  37  57  70 128  10  55
## [103]  13  53  59  45 116  14  77 118 108 138  50  78  49 104  49   1  85
## [120]  28  43  82  74  64  33  55  32  59  62 112   8  11  96  30  14  30
## [137]  38  85  66  85  97 107   4  18  76  35  31 133  27  69
En fixant indices=F (valeur par défaut), on obtient la réponse à la question : « Combien de fois chaque élément du jeu de données original apparaît-il dans chaque échantillon bootstrap ? ». Par exemple, dans le premier échantillon : le 1er élément apparaît une fois, le 2e n'apparaît pas, le 3e apparaît une fois, le 4e deux fois, etc.
 tableOfAppearances<-boot.array(myBootstrap)
tableOfAppearances[1,]

##   [1] 1 0 1 2 0 1 0 1 0 1 2 2 3 2 0 0 2 1 1 0 1 0 1 1 0 0 2 2 0 2 2 1 1 1 1
##  [36] 0 3 2 1 0 1 0 1 0 1 0 0 0 3 2 0 0 2 1 3 1 1 1 4 0 0 2 0 3 2 1 2 1 1 3
##  [71] 1 0 2 1 0 3 1 3 0 1 1 1 1 0 5 1 0 2 1 0 0 0 1 0 0 1 2 1 0 1 1 1 0 2 2
## [106] 0 1 1 1 0 1 1 0 2 0 3 2 3 0 0 2 2 0 2 0 1 0 1 0 0 1 0 2 0 0 1 1 1 1 0
## [141] 2 0 1 1 1 1 0 0 1 0
Un tel tableau permet de recréer les réalisations bootstrap en dehors de R. Ou dans R lui-même lorsqu'on ne souhaite pas utiliser set.seed et relancer tout le calcul.
onceAgain<-apply(tableOfIndices, 1, foo, data=iris, cor.type='s')Vérifions si les résultats sont identiques :
 head(t(onceAgain))

##             [,1] [,2] [,3]
## [1,] -0.26405188 5.70    3
## [2,] -0.12973299 5.80    3
## [3,] -0.07972066 5.75    3
## [4,] -0.16122705 6.00    3
## [5,] -0.20664808 6.00    3
## [6,] -0.12221170 5.80    3

head(myBootstrap$t)

##             [,1] [,2] [,3]
## [1,] -0.26405188 5.70    3
## [2,] -0.12973299 5.80    3
## [3,] -0.07972066 5.75    3
## [4,] -0.16122705 6.00    3
## [5,] -0.20664808 6.00    3
## [6] -0.12221170 5.80    3

all(t(onceAgain)==myBootstrap$t)

## [1] TRUE
Oui, ils le sont !
Si vous souhaitez en savoir plus sur le Machine Learning en R, suivez le cours Machine Learning Toolbox de DataCamp et consultez le tutoriel Machine Learning in R for beginners.
Pour aller plus loin avec R et le machine learning
Cours
Cours
Cours