
कोर्स
Machine Learning with caret in R
4 घंटा
61K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंबूटस्ट्रैप नमूना डेटा का उपयोग करके किसी आबादी के बारे में निष्कर्ष निकालने की एक विधि है। ब्रैडली एफ्रॉन ने इसे 1979 में इस पेपर में पहली बार प्रस्तुत किया था। बूटस्ट्रैप नमूना डेटा से प्रतिस्थापन सहित सैंपलिंग पर निर्भर करता है। इस तकनीक का उपयोग किसी भी सांख्यिकीय मान का मानक त्रुटि (standard error) आंके जाने और उसके लिए कॉन्फिडेंस इंटरवल (CI) प्राप्त करने में किया जा सकता है। बूटस्ट्रैप विशेष रूप से तब उपयोगी होता है जब CI का बंद-रूप (closed form) न हो, या वह बहुत जटिल हो।
मान लीजिए हमारे पास n तत्वों का एक नमूना है: X = {x1, x2, …, xn} और हमें किसी सांख्यिकी T = t(X) के लिए CI चाहिए। बूटस्ट्रैप रूपरेखा सीधी है। हम निम्नलिखित प्रक्रिया को R बार दोहराते हैं: i-वीं पुनरावृत्ति में, उपलब्ध नमूने से प्रतिस्थापन सहित n तत्वों का चयन करें (कुछ तत्व एक से अधिक बार चुने जाएंगे)। इस नए नमूने को i-वां बूटस्ट्रैप नमूना, Xi, कहें और इच्छित सांख्यिकी की गणना करें Ti = t(Xi)।
परिणामस्वरूप, हमें अपनी सांख्यिकी के R मान मिलेंगे: T1, T2, …, TR। इन्हें हम T के बूटस्ट्रैप साकार (bootstrap realizations) या बूटस्ट्रैप वितरण कहते हैं। इसके आधार पर, हम T के लिए CI निकाल सकते हैं। इसे करने के कई तरीके हैं। परसेंटाइल लेना सबसे आसान लगता है।
आइए (एक बार फिर) प्रसिद्ध iris डेटासेट का उपयोग करें। शुरुआती कुछ पंक्तियों पर नज़र डालें:
 head(iris)

##   Sepal.Length Sepal.Width Petal.Length Petal.Width Species
## 1          5.1         3.5          1.4         0.2  setosa
## 2          4.9         3.0          1.4         0.2  setosa
## 3          4.7         3.2          1.3         0.2  setosa
## 4          4.6         3.1          1.5         0.2  setosa
## 5          5.0         3.6          1.4         0.2  setosa
## 6          5.4         3.9          1.7         0.4  setosa
मान लीजिए हम median Sepal.Length, median Sepal.Width और इन दोनों के बीच स्पीयरमैन के रैंक सहसंबंध गुणांक के लिए CIs खोजना चाहते हैं। हम R के boot पैकेज और boot नामक फ़ंक्शन का उपयोग करेंगे। इसका लाभ उठाने के लिए हमें एक ऐसा फ़ंक्शन बनाना होगा जो पुनः-नमूना (resampled) डेटा से हमारी सांख्यिकी/सांख्यिकियों की गणना करे। इसमें कम-से-कम दो आर्ग्युमेंट होने चाहिए: एक dataset और indices नामक वह वेक्टर जिसमें उस डेटासेट के उन तत्वों के इंडेक्स हों जिन्हें बूटस्ट्रैप नमूना बनाने के लिए चुना गया।
यदि हम एक साथ एक से अधिक सांख्यिकी के लिए CIs निकालना चाहते हैं, तो हमारे फ़ंक्शन को उन्हें एक ही वेक्टर के रूप में लौटाना होगा।
हमारे उदाहरण में, यह कुछ ऐसा दिख सकता है:
 library(boot)

foo <- function(data, indices){
  dt<-data[indices,]
  c(
    cor(dt[,1], dt[,2], method='s'),
    median(dt[,1]),
    median(dt[,2])
  )
}
foo data से इच्छित तत्वों (जिनके नंबर indices में संग्रहीत हैं) को चुनता है और पहली दो कॉलम का सहसंबंध गुणांक गणना करता है (method='s' स्पीयरमैन का रैंक गुणांक चुनता है, method='p' से पियरसन का गुणांक मिलेगा) और उनकी मेडियनें निकालता है।
हम कुछ अतिरिक्त आर्ग्युमेंट भी जोड़ सकते हैं, जैसे उपयोगकर्ता को सहसंबंध गुणांक के प्रकार का चुनाव करने देना:
 foo <- function(data, indices, cor.type){
  dt<-data[indices,]
  c(
    cor(dt[,1], dt[,2], method=cor.type),
    median(dt[,1]),
    median(dt[,2])
  )
}
इस ट्यूटोरियल को अधिक सामान्य बनाने के लिए, मैं foo के इसी दूसरे संस्करण का उपयोग करूंगा।
अब, हम boot फ़ंक्शन का उपयोग कर सकते हैं। हमें इसे डेटासेट का नाम, अभी बनाया गया फ़ंक्शन, पुनरावृत्तियों की संख्या (R) और हमारे फ़ंक्शन के किसी भी अतिरिक्त आर्ग्युमेंट (जैसे cor.type) देने होंगे। नीचे, मैं इस उदाहरण की पुनरुत्पादकता के लिए set.seed का उपयोग कर रहा हूं।
 set.seed(12345)
myBootstrap <- boot(iris, foo, R=1000, cor.type='s')
boot फ़ंक्शन एक ऐसे ऑब्जेक्ट को लौटाता है जिसकी क्लास का नाम भी... (जी हां, सही!) boot है। इसमें दो दिलचस्प तत्व होते हैं। $t में बूटस्ट्रैप प्रक्रिया द्वारा जनित हमारी सांख्यिकी/सांख्यिकियों के R मान होते हैं (यानी T के बूटस्ट्रैप साकार):
 head(myBootstrap$t)

##             [,1] [,2] [,3]
## [1,] -0.26405188 5.70    3
## [2,] -0.12973299 5.80    3
## [3,] -0.07972066 5.75    3
## [4,] -0.16122705 6.00    3
## [5,] -0.20664808 6.00    3
## [6,] -0.12221170 5.80    3
$t0 में मूल, पूर्ण डेटासेट में हमारी सांख्यिकी/सांख्यिकियों के मान होते हैं:
 myBootstrap$t0

## [1] -0.1667777  5.8000000  3.0000000
कंसोल पर boot ऑब्जेक्ट प्रिंट करने पर कुछ और जानकारी मिलती है:
 myBootstrap

##
## ORDINARY NONPARAMETRIC BOOTSTRAP
##
##
## Call:
## boot(data = iris, statistic = foo, R = 1000, cor.type = "s")
##
##
## Bootstrap Statistics :
##       original       bias    std. error
## t1* -0.1667777  0.002546391  0.07573983
## t2*  5.8000000 -0.013350000  0.10295571
## t3*  3.0000000  0.007900000  0.02726414
original वही है जो $t0 है। bias बूटस्ट्रैप साकारों (वे जो $t में हैं) के औसत, जिसे T का बूटस्ट्रैप अनुमानों कहा जाता है, और मूल डेटासेट में मान (जो $t0 में है) के बीच का अंतर है।
 colMeans(myBootstrap$t)-myBootstrap$t0

## [1]  0.002546391 -0.013350000  0.007900000
std. error बूटस्ट्रैप अनुमान की मानक त्रुटि है, जो बूटस्ट्रैप साकारों का मानक विचलन होता है।
 apply(myBootstrap$t,2,sd)

## [1] 0.07573983 0.10295571 0.02726414CI निकालना शुरू करने से पहले, बूटस्ट्रैप साकारों के वितरण पर नज़र डालना हमेशा फायदेमंद होता है। हम plot फ़ंक्शन का उपयोग कर सकते हैं, जिसमें index यह बताता है कि foo में गणना की गई किन सांख्यिकियों में से किसे देखना है। यहां index=1 सेपल लंबाई और चौड़ाई के बीच स्पीयरमैन सहसंबंध गुणांक है, index=2 सेपल लंबाई का मेडियन है, और index=3 सेपल चौड़ाई का मेडियन है।
plot(myBootstrap, index=1)
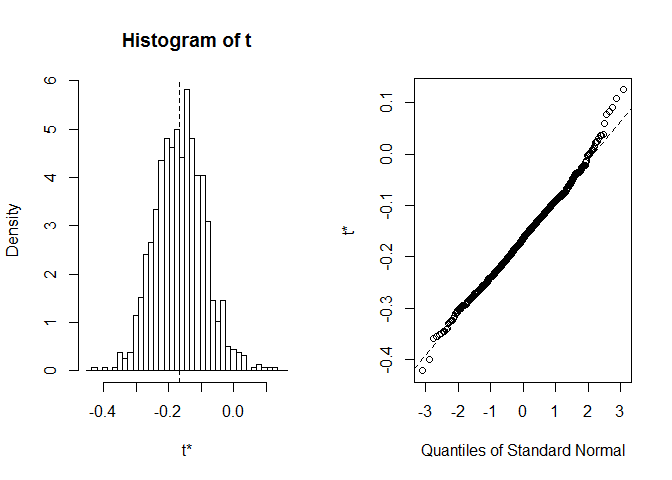
बूटस्ट्रैप सहसंबंध गुणांकों का वितरण काफी हद तक सामान्य जैसा लगता है। इसका CI निकालते हैं। हम boot.ci का उपयोग कर सकते हैं। यह डिफ़ॉल्ट रूप से 95-प्रतिशत CIs देता है, लेकिन इसे conf पैरामीटर से बदला जा सकता है।
 boot.ci(myBootstrap, index=1)

## Warning in boot.ci(myBootstrap, index = 1): bootstrap variances needed for
## studentized intervals

## BOOTSTRAP CONFIDENCE INTERVAL CALCULATIONS
## Based on 1000 bootstrap replicates
##
## CALL :
## boot.ci(boot.out = myBootstrap, index = 1)
##
## Intervals :
## Level      Normal              Basic
## 95%   (-0.3178, -0.0209 )   (-0.3212, -0.0329 )
##
## Level     Percentile            BCa
## 95%   (-0.3007, -0.0124 )   (-0.3005, -0.0075 )
## Calculations and Intervals on Original Scale
boot.ci 5 प्रकार के बूटस्ट्रैप CIs देता है। इनमें से एक, studentized इंटरवल, अलग है। इसे बूटस्ट्रैप वैरिएंस के अनुमान की आवश्यकता होती है। हमने यह उपलब्ध नहीं कराया, इसलिए R चेतावनी देता है: bootstrap variances needed for studentized intervals। वैरिएंस अनुमान दूसरे-स्तर के बूटस्ट्रैप से या (आसान) जैकनाइफ तकनीक से प्राप्त किए जा सकते हैं। यह इस ट्यूटोरियल के दायरे से कुछ बाहर है, इसलिए शेष चार प्रकार के बूटस्ट्रैप CIs पर ध्यान केंद्रित करते हैं।
यदि हम सभी को नहीं देखना चाहते, तो type आर्ग्युमेंट में प्रासंगिक वाले चुन सकते हैं। संभावित मान हैं norm, basic, stud, perc, bca या इनका कोई वेक्टर।
 boot.ci(myBootstrap, index=1, type=c('basic','perc'))

## BOOTSTRAP CONFIDENCE INTERVAL CALCULATIONS
## Based on 1000 bootstrap replicates
##
## CALL :
## boot.ci(boot.out = myBootstrap, type = c("basic", "perc"), index = 1)
##
## Intervals :
## Level      Basic              Percentile
## 95%   (-0.3212, -0.0329 )   (-0.3007, -0.0124 )
## Calculations and Intervals on Original Scale
boot.ci फ़ंक्शन bootci नामक क्लास का ऑब्जेक्ट बनाता है। इसके तत्वों के नाम type आर्ग्युमेंट में उपयोग किए गए CI प्रकारों के समान ही होते हैं। $norm एक 3-तत्वों वाला वेक्टर है जिसमें कॉन्फिडेंस स्तर और CI की सीमाएं होती हैं।
 boot.ci(myBootstrap, index=1, type='norm')$norm

##      conf
## [1,] 0.95 -0.3177714 -0.02087672$basic, $stud, $perc और $bca 5-तत्वों वाले वेक्टर होते हैं जिनमें CI की गणना के लिए उपयोग किए गए परसेंटाइल भी शामिल होते हैं (हम इस पर आगे वापस आएंगे):
 boot.ci(myBootstrap, index=1, type='basic')$basic

##      conf
## [1,] 0.95 975.98 25.03 -0.3211981 -0.03285178विभिन्न प्रकार के CI क्या हैं, इसका अंदाज़ा पाने के लिए हमें कुछ संकेतन प्रस्तुत करने होंगे। तो मान लें:
ऊपर की संकेतन के साथ, परसेंटाइल CI है:
अर्थात यह बस प्रासंगिक परसेंटाइल लेता है। इससे अधिक कुछ नहीं।
एक सामान्य वॉल्ड CI होगा:
परंतु बूटस्ट्रैप के मामले में, हमें इसे बायस के लिए संशोधित करना चाहिए। तो यह बन जाता है:
$$ t_0 - b \pm z_\alpha \cdot se^\star \\ 2t_0 - t^\star \pm z_\alpha \cdot se^\star$$
परसेंटाइल CI सामान्यतः अनुशंसित नहीं है क्योंकि यह अजीब-पूंछ वाले वितरणों के मामले में कमजोर प्रदर्शन करता है। बेसिक CI (जिसे pivotal या empirical CI भी कहते हैं) इससे कहीं अधिक मजबूत है। इसके पीछे का तर्क यह है कि प्रत्येक बूटस्ट्रैप प्रतिकृति और t0 के बीच के अंतर की गणना करें और उनके वितरण के परसेंटाइल का उपयोग करें। पूर्ण विवरण, जैसे कि एल. वासरमैन की All of Statistics में मिल सकता है।
बेसिक CI का अंतिम सूत्र है:
BCα का अर्थ है bias-corrected, accelerated। इसका सूत्र बहुत जटिल नहीं है, लेकिन कुछ हद तक अल्पबोधगम्य है, इसलिए मैं इसे छोड़ूंगा। यदि आप विवरण में रुचि रखते हैं तो थॉमस जे. डीचिचियो और ब्रैडली एफ्रॉन का लेख देखें।
विधि के नाम में उल्लिखित acceleration के लिए बूटस्ट्रैप साकारों के विशिष्ट परसेंटाइल का उपयोग करना आवश्यक है। कभी-कभी ऐसा हो सकता है कि ये कुछ चरम परसेंटाइल हों, संभवतः आउटलायर। ऐसे मामलों में BCα अस्थिर हो सकता है।
आइए पंखुड़ी की चौड़ाई (petal width) के मेडियन के लिए BCα CI देखें। मूल डेटासेट में, यह मेडियन ठीक 3 है।
 boot.ci(myBootstrap, index=3)

## Warning in boot.ci(myBootstrap, index = 3): bootstrap variances needed for
## studentized intervals

## Warning in norm.inter(t, adj.alpha): extreme order statistics used as
## endpoints

## BOOTSTRAP CONFIDENCE INTERVAL CALCULATIONS
## Based on 1000 bootstrap replicates
##
## CALL :
## boot.ci(boot.out = myBootstrap, index = 3)
##
## Intervals :
## Level      Normal              Basic
## 95%   ( 2.939,  3.046 )   ( 2.900,  3.000 )
##
## Level     Percentile            BCa
## 95%   ( 3.0,  3.1 )   ( 2.9,  2.9 )
## Calculations and Intervals on Original Scale
## Warning : BCa Intervals used Extreme Quantiles
## Some BCa intervals may be unstable
हमें BCα CI (2.9, 2.9) मिला। यह अजीब है, लेकिन सौभाग्य से R ने हमें चेताया कि extreme order statistics used as endpoints। देखें कि यहां हुआ क्या:
plot(myBootstrap, index=3)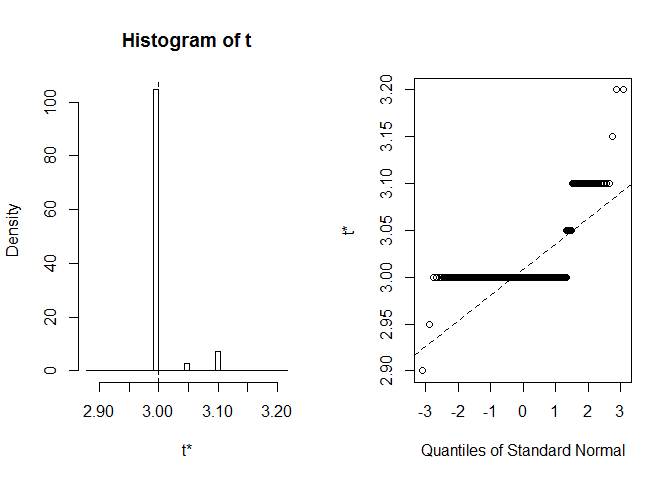
बूटस्ट्रैप साकारों का वितरण असामान्य है। इनका एक बड़ा बहुमत (90% से अधिक) 3 है।
 table(myBootstrap$t[,3])

##
##  2.9 2.95    3 3.05  3.1 3.15  3.2
##    1    1  908   24   63    1    2
ऐसी स्थिति में, BCα विधि में "acceleration" आसानी से चरम मानों पर "उछल" जाती है। यहां, परसेंटाइल CI, जो BCα CI का आधार बनता है, (3, 3.1) है। अब, जब हम इसे "बाएं" फैलाते हैं तो हमें 0.002-परसेंटाइल का उपयोग करना पड़ता है। "दाएं" विस्तार भी चरम तक जाता है: 0.997-परसेंटाइल।
कभी-कभी, हमें बूटस्ट्रैप प्रतिकृतियों को पुनः बनाना होता है। यदि हम इसके लिए R का उपयोग कर सकते हैं, तो यह कोई समस्या नहीं है। set.seed फ़ंक्शन समस्या सुलझा देता है। अन्य सॉफ्टवेयर में बूटस्ट्रैप प्रतिकृतियों को फिर से बनाना कहीं अधिक जटिल होगा। इसके अलावा, बड़े R के लिए, R में पुनर्गणना (उदाहरण के लिए समयाभाव के कारण) विकल्प भी नहीं हो सकती।
हम इस समस्या को इस प्रकार सुलझा सकते हैं कि मूल डेटासेट के उन तत्वों के इंडेक्स सहेज लें, जिन्होंने प्रत्येक बूटस्ट्रैप नमूना बनाया। यही काम boot.array फ़ंक्शन (indices=T आर्ग्युमेंट के साथ) करता है।
tableOfIndices<-boot.array(myBootstrap, indices=T)प्रत्येक पंक्ति एक बूटस्ट्रैप नमूना है। उदाहरण के तौर पर, हमारा पहला नमूना निम्नलिखित तत्वों को शामिल करता है:
 tableOfIndices[1,]

##   [1] 109  12 143  65  41  28 105  62  23 102  37  34  55  53  38   3  11
##  [18] 146  31 122  85 141 118 116 117  78 100  13  98  49  59  88  24  56
##  [35] 136   4  59  67 126 118 104 101  70  13  12  19  21 149  73 133  67
##  [52]  86   6  88 131 105 121 145 121  83  70  68  71 111  76  73 122 116
##  [69]  85 144 114 139  89 124  64  27  81  78  58  39  17  50  37 117  76
##  [86]  97 114  64  17  93 141  65 124  80 137  54  37  57  70 128  10  55
## [103]  13  53  59  45 116  14  77 118 108 138  50  78  49 104  49   1  85
## [120]  28  43  82  74  64  33  55  32  59  62 112   8  11  96  30  14  30
## [137]  38  85  66  85  97 107   4  18  76  35  31 133  27  69
indices=F (डिफ़ॉल्ट) सेट करने पर, हमें इस प्रश्न का उत्तर मिलेगा: "मूल डेटासेट का प्रत्येक तत्व प्रत्येक बूटस्ट्रैप नमूने में कितनी बार आया?"। उदाहरण के लिए, पहले नमूने में: डेटासेट का 1वां तत्व एक बार आया, 2वां तत्व आया ही नहीं, 3वां तत्व एक बार आया, 4था दो बार और इसी तरह।
 tableOfAppearances<-boot.array(myBootstrap)
tableOfAppearances[1,]

##   [1] 1 0 1 2 0 1 0 1 0 1 2 2 3 2 0 0 2 1 1 0 1 0 1 1 0 0 2 2 0 2 2 1 1 1 1
##  [36] 0 3 2 1 0 1 0 1 0 1 0 0 0 3 2 0 0 2 1 3 1 1 1 4 0 0 2 0 3 2 1 2 1 1 3
##  [71] 1 0 2 1 0 3 1 3 0 1 1 1 1 0 5 1 0 2 1 0 0 0 1 0 0 1 2 1 0 1 1 1 0 2 2
## [106] 0 1 1 1 0 1 1 0 2 0 3 2 3 0 0 2 2 0 2 0 1 0 1 0 0 1 0 2 0 0 1 1 1 1 0
## [141] 2 0 1 1 1 1 0 0 1 0
ऐसी तालिका हमें R के बाहर बूटस्ट्रैप साकार को दोबारा बनाने देती है। या R में ही, जब हम set.seed का उपयोग नहीं करना चाहते और पूरी गणना फिर से नहीं करना चाहते।
onceAgain<-apply(tableOfIndices, 1, foo, data=iris, cor.type='s')आइए जांच लें कि परिणाम वही हैं या नहीं:
 head(t(onceAgain))

##             [,1] [,2] [,3]
## [1,] -0.26405188 5.70    3
## [2,] -0.12973299 5.80    3
## [3,] -0.07972066 5.75    3
## [4,] -0.16122705 6.00    3
## [5,] -0.20664808 6.00    3
## [6,] -0.12221170 5.80    3

head(myBootstrap$t)

##             [,1] [,2] [,3]
## [1,] -0.26405188 5.70    3
## [2,] -0.12973299 5.80    3
## [3,] -0.07972066 5.75    3
## [4,] -0.16122705 6.00    3
## [5,] -0.20664808 6.00    3
## [6,] -0.12221170 5.80    3

all(t(onceAgain)==myBootstrap$t)

## [1] TRUE
हाँ, बिल्कुल!
यदि आप R में मशीन लर्निंग के बारे में और सीखना चाहें, तो DataCamp का Machine Learning Toolbox कोर्स करें और शुरुआती लोगों के लिए R में मशीन लर्निंग ट्यूटोरियल देखें।
R और मशीन लर्निंग के बारे में और जानें
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें