

机器学习模型不同于传统的软件解决方案。这些模型需要在有新数据时不断更新,才能做出准确、可靠的预测。在复杂且敏感的场景中,仅依赖单一模型可能不足以生成最优结果,这正是集成建模发挥作用的地方。
本概念性教程将介绍机器学习中的集成建模是什么,以及它如何提升整体模型性能。随后,我们将概览多种集成方法,并通过 Python 的逐步实现,演示一个真实世界的应用场景。
我们的使用 SuperLearner 的 R 集成学习教程,基于集成学习方法,讲解如何使用 R 中的 SuperLearner 包来提升机器学习效果。
机器学习中的集成模型
想象一位音乐经理要参加一场国际比赛。他可以接触到各类擅长不同领域的音乐家:
- 古典乐手,能够谱写传统乐曲。
- 电子乐手,擅长使用电子乐器。
- 爵士乐手,具备出色的即兴能力。
- 独奏乐手,能演绎复杂独奏并展现技术实力。
鉴于广泛的音乐专长与背景,经理可以将他们组合起来,打造独特而难忘的演出。
可以把集成模型看作一支音乐家组成的乐队,每个人专精钢琴、小号、鼓等特定乐器。多种技能的组合,能谱出和谐的乐章。
集成学习使用的正是相同的逻辑:
它组合多个算法,以获得优于单一模型的预测性能。并没有固定要使用多少个模型,有些业务目标可能需要更多模型。
模型误差及用集成方法降低误差
任意机器学习模型产生的误差,从数学上可以分解为三个组成部分:
偏差 + 方差 + 不可约误差
这在当前语境下为何重要?要理解集成模型背后的原理,首先需要了解模型误差的来源。
让我们看看这些误差:
偏差误差
它用于量化平均而言预测值与真实值相差多少。高偏差意味着我们有一个表现欠佳的模型,它会持续忽略重要趋势。
方差
另一方面,方差量化的是对同一观测的预测结果有多大差异。高方差模型会在训练集上过拟合,并在训练之外的观测上表现不佳。下图能帮助您更清晰地理解(假设红点是真实值,蓝点是预测):
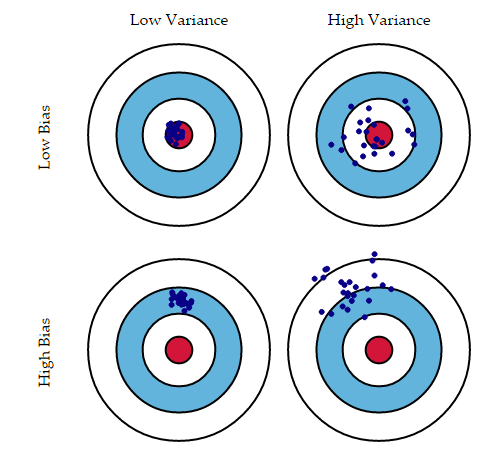
通常,随着模型复杂度提高,因偏差较低而带来的误差会下降。但这只在某个临界点之前成立。若继续增加模型复杂度,模型会开始过拟合,于是因高方差导致的误差上升。
既然您已了解集成学习的基础,我们来看看不同的集成学习技术:
集成方法的类型
集成方法有多种类型,每一种都有其优劣。本节将介绍这些方面,帮助您为各自用例做出正确选择。
在深入各方法之前,先了解什么是元学习器与基学习器,有助于后续概念的理解。
- 基学习器位于集成学习架构的第一层,每个基学习器独立训练以做出各自的预测。
- 元学习器位于第二层,它在基学习器的输出之上进行训练。
Bagging
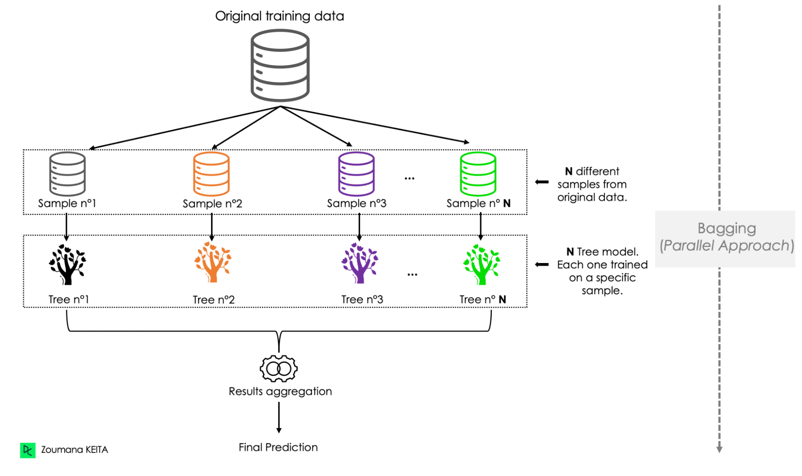
Bagging 又称自助聚合(bootstrap aggregation)。该技术与随机森林相似,但它使用全部特征,而随机森林在每棵树中只使用特征子集。
在 bagging 中,从训练集中有放回地随机抽样,这使得样本集中可以出现重复实例。下面是 bagging 的主要步骤:
- 生成多个自助(bootstrap)重采样样本。
- 在每个重采样样本上运行算法并进行预测。
- 将各模型的预测进行组合,对回归取平均、对分类取少数服从多数。
在分类或回归任务中,Bagging 具有以下关键优点与缺点。
优势
- 建模过程简单,无需深奥数学概念,且能处理缺失值。
- scikit-learn 包易于实现其核心逻辑,包含组合各基学习器预测结果的所有模块。
- 对高方差分类器的方差有显著降低效果。这在处理高维数据时很有帮助,可防止模型在新数据上的泛化能力不佳。
- Bagging 提供无偏的袋外(out-of-bag)误差估计,即这些分类器的平均错误/损失。
劣势
- 由于使用多模型,Bagging 的计算开销较大。
- 对预测结果进行平均会降低可解释性,使最终结果更难解读。
Boosting
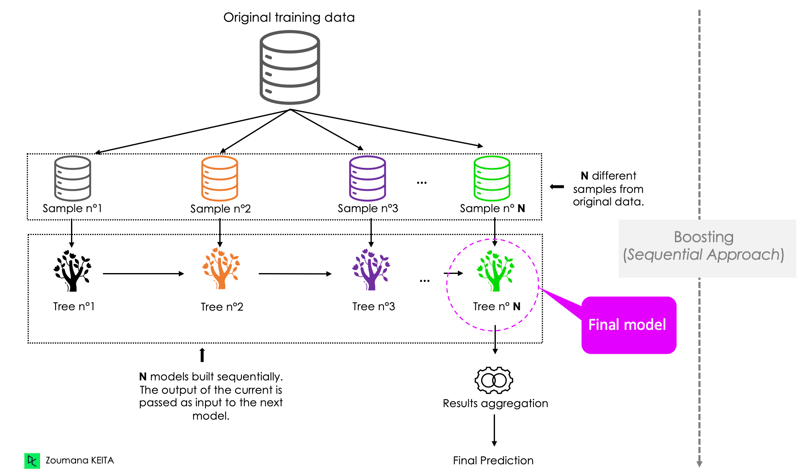
Boosting 采用序列式方法,当前模型的预测会传递给下一个模型。每个模型都会迭代地关注其前序模型误分类的观测。其一般流程如下:
优势
- 与 bagging 类似,boosting 易于理解和实现。此外,它无需预处理,并可处理数据中的缺失值。
- 能高效降低偏差。
- Boosting 算法在训练时优先选择能提升整体准确率的特征。此过程可降低数据维度,从而减少计算时间。
劣势
- Boosting 的序列特性使后续模型去纠正前序模型的错误,这会让整体模型对异常值更为敏感。
- 同样由于序列化特性,Boosting 的可扩展性较差。
Stacking
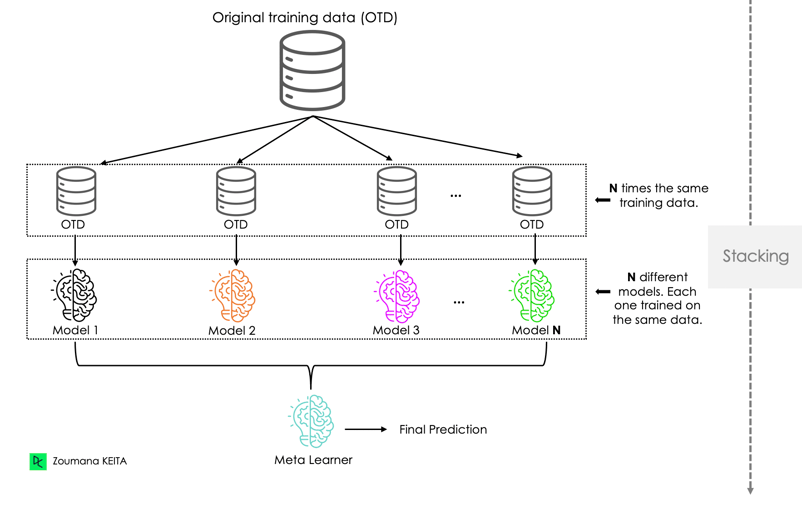
Stacking 与 boosting 相当相似。基学习器的预测被“堆叠”在一起,作为输入来训练元学习器,以生成更稳健的预测;随后由元学习器做出最终预测。Bagging 和 boosting 通常使用同质的基学习器,而 stacking 更倾向于使用异质的基学习器。
优势
- 可结合多个高性能模型的优势,适用于分类与回归任务。
- 与其他集成模型类似,stacking 能构建比单个模型更准确的模型。
劣势
- 使用复杂的基模型会增加过拟合风险。
- 模型的分层训练会使 stacking 架构更难实现。
Blending
Blending 与 Stacking 类似。在 blending 中,数据结构由训练集、留出集(hold-out)和测试集构成。元学习器在训练集上训练,然后将其预测与留出集合并,用于构建最终的元模型,最终模型再在测试集上做出最终预测。
优势
- 与 stacking 及许多其他集成方法一样,blending 在很多情况下都能提升最终模型的性能。
- 该技术的应用曾多次助力竞赛夺冠。
劣势
- 按照 blending 架构划分原始数据,会限制可用于训练基模型的数据量,从而可能导致性能下降。
- 与其他集成模型类似,由于复杂度提升,最终模型的可解释性降低,难以提炼关键业务洞见。
Voting
在投票法中,多个模型独立训练,其预测被组合为最终预测,可采用硬投票、软投票或加权投票:
- 硬投票中,最终预测为所有模型中最常见的预测结果。
- 软投票中,每个模型输出概率分布而非二元预测,然后选择概率最高的类别作为预测。
- 加权投票中,假设某些模型比其他模型更有“本领”,因此在合并预测时给予更高权重。
优势
- 与 stacking、blending 相比,投票架构更易实现,且无需复杂的微调。
- 在投票中使用多个基学习器可降低对单一模型的依赖,有助于获得更稳定、可靠的预测。
劣势
- 处理模型间预测冲突可能很困难,从而难以有意义地做出最终决策。
- 为集成投票模型增加更多模型,不一定会提升最终性能。
Cascading
Cascading 采用类似 stacking 的方法,但每一层只包含一个模型。第一层模型在完整训练数据上训练,下一层模型则在前一层模型的输出上训练。该策略旨在从数据中学习更复杂的模式,从而使模型能做出更好的预测。
优势
- 后续模型针对前一模型的输出进行专门化,能降低数据噪声。
- 对过拟合更稳健,并能在真实世界数据上表现良好。
劣势
- 实现级联较为复杂,因为需按序训练每个模型。
- 找到最优级联架构往往需要大量实验与微调。
集成算法概览
前文介绍了不同类型的集成模型。现在,我们简要回顾几个常见模型。
随机森林
随机森林是广泛使用的模型,可同时解决分类与回归问题。它由许多通过 bagging 训练的决策树组成,最终结果通过对各棵树的预测取平均来确定。
节点大小、树的数量以及抽取的特征数,是训练随机森林前需要设置的三大超参数。
随机森林中的“随机性”体现在哪里?
特征抽样(feature bagging),又称特征随机性,会对特征进行随机抽样,以确保各决策树之间相关性较低。这使随机森林有别于考虑所有可能特征划分的决策树;随机森林只考虑特征的一个子集。详见我们的随机森林分类教程。
XGBoost
极端梯度提升(Extreme Gradient Boosting),简称 XGBoost,可用于分类和回归。XGBoost 旨在实现高扩展性与高效率,并实现了梯度提升决策树框架。
它适合处理大规模数据集,并兼容 Hadoop、MPI(消息传递推断)和 SGI(Sun Grid Engine)等主流分布式环境。可在我们的XGBoost 教程中了解更多。
AdaBoost
自适应提升(Adaptive Boosting),或称 AdaBoost,是最早取得成功的二分类集成提升算法之一。它之所以“自适应”,是因为会为每个实例重新分配权重,对被误分类的实例赋予更高权重。更多内容请参阅我们的独立教程:用 Python 进行 AdaBoost 分类。
集成模型的分步实现
现在您已经理解了集成建模的核心思想及部分模型的工作方式,本节将专注于使用 Python 的技术实现。
环境准备
首先,您需要在计算机上安装Python,并安装以下库:
- pandas,用于加载数据框。
- Scikit-learn,用于使用现有的机器学习算法。
- Seaborn 和 matplotlib,用于可视化。
您可以使用 Python 包管理器 pip 按如下方式安装这些库:
pip install scikit-learn
pip install pandas
pip install matplotlib seaborn为更好地演示用例,我们将使用 DataLab 提供的贷款数据。本教程的代码也已发布在 DataLab 的此工作簿中;您可以复制为自己的工作簿,并直接在浏览器中编辑运行,无需在本地安装任何东西。
理解数据
该数据集包含 9,500 笔贷款的信息,包括贷款结构、借款人信息,以及贷款是否已全额偿还,由 not.fully.paid 列表示。前五条观测如下所示:
import pandas as pd
loan_data = pd.read_csv("loan_data.csv")
loan_data.head()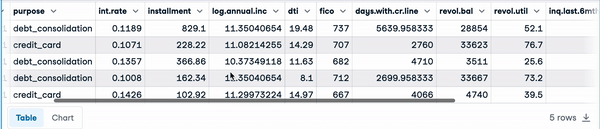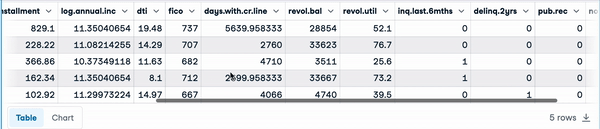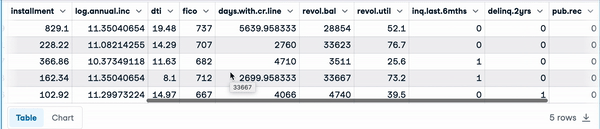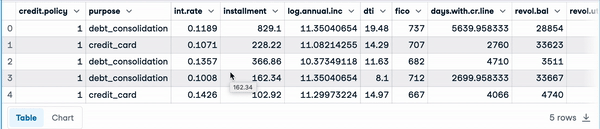
使用 info() 函数会生成如下关于数据的关键信息:
- 9,578 行(从 0 到 9577),14 列,除
purpose为object类型(给出贷款用途的文本描述)外,其余为数值类型。 non-null标记表示各列均无缺失值。
loan_data.info()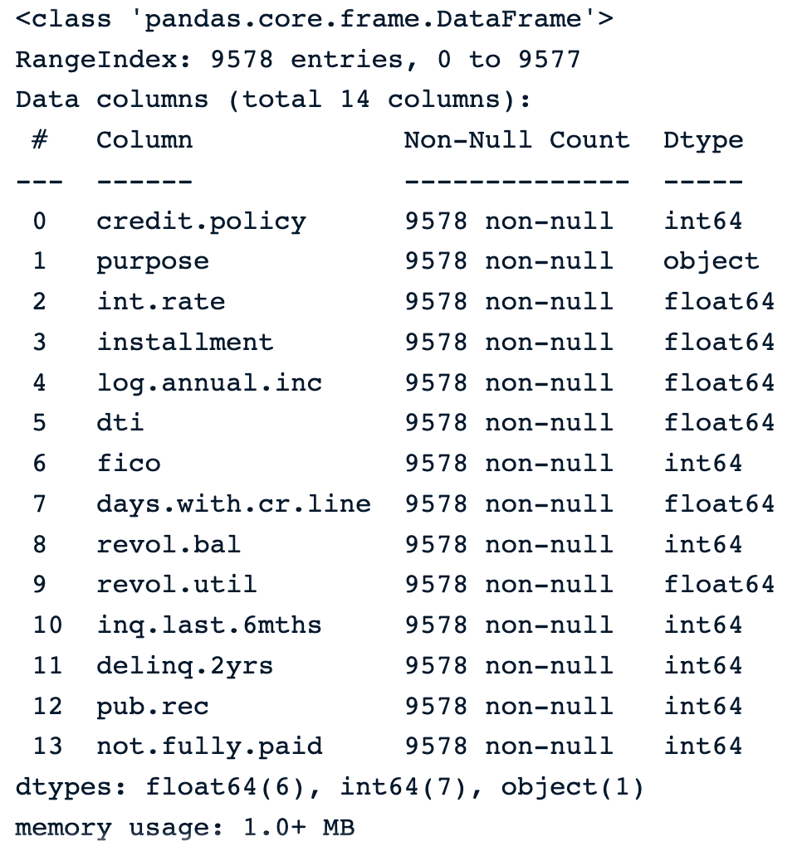
我们注意到数据存在不平衡问题:类别 0 的观测远多于类别 1(8045 比 1533)。
print(loan_data['not.fully.paid'].value_counts())
loan_data['not.fully.paid'].value_counts().plot(kind='barh')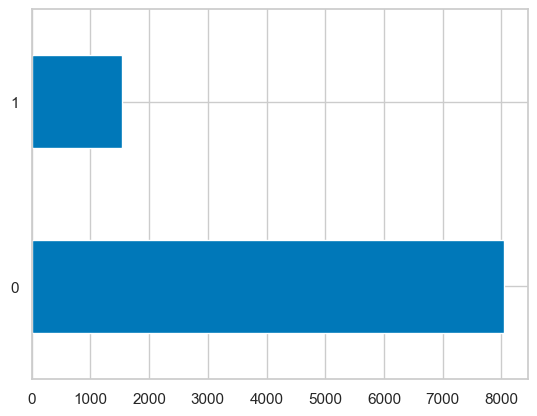
用这样的不平衡数据进行模型训练,会影响整体性能。
一种应对方法是下采样,即减少多数类(类别 0)的样本数量。在本例中,我们使类别 0 的观测数与类别 1 相同,流程如下:
-
首先获取类别 1 的数量。
-
从类别 0 中随机选择 N 条观测,N 等于类别 1 数据框的大小。
-
将上述两个数据框拼接。
loan_data_class_1 = loan_data[loan_data['not.fully.paid'] == 1]
number_class_1 = len(loan_data_class_1)
loan_data_class_0 = loan_data[loan_data['not.fully.paid'] == 0].sample(number_class_1)
final_loan_data = pd.concat([loan_data_class_1,
loan_data_class_0])
print(final_loan_data.shape)深入不平衡数据教程提供了更多关于不平衡数据集处理技术的资源。
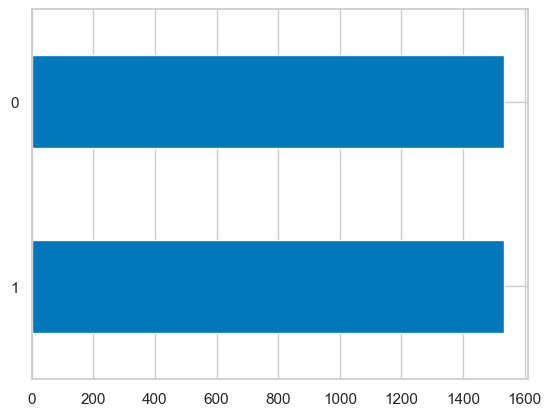
下采样后,我们得到:
- 共 3066 条观测,14 列。
最终的均衡分布如下图所示。
为训练准备数据
观察数据集可见,各特征不在同一量纲,而某些模型(如 KNN)对尺度敏感。可使用MinMaxScaler 模块将特征范围归一化到同一尺度(此处为 0 到 1)来解决。
此外,为简化起见,我们将移除 purpose 列,因为它需要额外的预处理。
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler(feature_range=(0, 1))
# Remove unwanted 'purpose' column and get the data
final_loan_data.drop('purpose', axis=1, inplace=True)
X = final_loan_data.drop('not.fully.paid', axis=1)
normalized_X = scaler.fit_transform(X)与任何预测任务一样,我们需要将数据划分为训练集与测试集。本例中,77% 用于训练,剩余 33% 用于测试。
- 随机状态参数设为固定值(此处为 2023),以确保结果可复现。
Stratify 用于确保目标变量 y 在训练集与测试集中的分布一致。
from sklearn.model_selection import train_test_split
y = final_loan_data['not.fully.paid']
r_state = 2023
t_size = 0.33
X_train, X_test, y_train, y_test = train_test_split(normalized_X, y,
test_size=t_size,
random_state=r_state,
stratify=y)所有模型都将遵循同样的流程:在训练集上训练、在测试集上预测,并评估模型性能。
Bagging 模型
本节将使用随机森林作为 bagging 模型。为简化起见,我们使用默认参数。
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import cross_val_score
# Define the model
random_forest_model = RandomForestClassifier()
# Fit the random search object to the data
random_forest_model.fit(X_train, y_train)训练完成后,使用 accuracy_score 函数评估性能如下:
# Make predictions
y_pred = random_forest_model.predict(X_test)
# Get the performance
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy:", accuracy) 上述 print 语句输出 0.6156,即 61.56%
现在让我们将此分数与 blending 聚合方法的表现进行比较。
Blending 模型
对于 blending,我们将使用两个基模型:决策树与 K 最近邻分类器。最终使用回归模型做出最终预测。
from sklearn.neighbors import KNeighborsClassifier
from sklearn.tree import DecisionTreeClassifier
from sklearn.linear_model import LogisticRegression将原始训练数据再次划分为新的训练集与验证集。基模型在训练集上训练。
X_train, X_val, y_train, y_val = train_test_split(
X_train, y_train,
test_size=t_size,
random_state=r_state)随后根据基模型的预测生成两个数据框:
- 第一个数据框:在验证集上的预测,与原始验证集拼接。
- 第二个数据框:在测试集上的预测,与原始测试集拼接。
# Decision Tree Model
dt_model = DecisionTreeClassifier()
dt_model.fit(X_train, y_train)
dt_model_pred_val = dt_model.predict(X_val)
dt_model_pred_test= dt_model.predict(X_test)
dt_model_pred_val = pd.DataFrame(dt_model_pred_val)
dt_model_pred_test = pd.DataFrame(dt_model_pred_test)
# KNN Model
knn_model = KNeighborsClassifier()
knn_model.fit(X_train,y_train)
knn_model_pred_val = knn_model.predict(X_val)
knn_model_pred_test = knn_model.predict(X_test)
knn_model_pred_val = pd.DataFrame(knn_model_pred_val)
knn_model_pred_test = pd.DataFrame(knn_model_pred_test)
最终的逻辑回归模型使用与验证集拼接后的数据进行训练,并用与测试集拼接后的数据进行评估。
x_val = pd.DataFrame(X_val)
x_test = pd.DataFrame(X_test)
df_val_lr = pd.concat([x_val, knn_model_pred_val,
dt_model_pred_val], axis=1)
df_test_lr = pd.concat([x_test, dt_model_pred_test,
knn_model_pred_test],axis=1)
# Logistic Regression Model
lr_model = LogisticRegression()
lr_model.fit(df_val_lr,y_val)
lr_model.score(df_test_lr,y_test)使用 .score() 函数默认会计算准确率,无需手动生成预测。
性能结果为 0.6383,即 63.83%,比初始随机森林高约 2%,因此 blending 模型表现更佳。
我们的课程Python 集成方法和R 中的基于树的机器学习模型,是继续您的机器学习之旅的理想下一步,分别在 Python 和 R 中深入探索集成分类器的精彩世界。
结论
本文介绍了不同类型的集成建模及其特性、优点与缺点,并简要概览了若干基于集成模型的算法示例,如随机森林、Adaboost、XGBoost、梯度提升树与梯度提升机。
在构建集成模型时,了解其利弊对于获得更好的业务洞察至关重要。
常见问题
同质学习器与异质学习器有何区别?
同质学习器指使用相同类型的算法与超参数的学习器。随机森林可被视为同质学习器的集成。
异质学习器则采用不同的算法与超参数。随机森林、神经网络与 KNN 可以作为某个集成模型的异质学习器。
集成模型相比单一模型的优势是什么?
使用集成模型通常能比单一模型做出更好的预测。
集成模型的局限是什么?
集成模型可能欠缺可解释性,即模型学到的知识难以为最终用户所理解。
何时应避免使用集成模型?
在以下情形(但不限于此)应避免使用集成模型:需要高度可解释性、数据量有限、存在实时性约束、计算成本高。
机器学习中有哪些主要的集成方法?
Bagging、Boosting、Stacking、Voting、Blending 与 Cascading 是机器学习中的主要集成方法。