

在线运行和编辑此教程中的代码
运行代码XGBoost 的安装
您可以像安装其他库一样,通过 pip 安装 XGBoost。这种安装方式还会包含对您机器上 NVIDIA GPU 的支持。如果您想安装仅 CPU 版本,可以使用 conda-forge:
$ pip install --user xgboost
# CPU only
$ conda install -c conda-forge py-xgboost-cpu
# Use NVIDIA GPU
$ conda install -c conda-forge py-xgboost-gpu建议在虚拟环境中安装 XGBoost,以免污染您的基础环境。
我们建议在启用 GPU 的机器上运行教程中的示例。如果您没有,可以考虑使用 DataLab 或 Google Colab 等替代方案。
如果您选择使用 Colab,其中预装的是旧版本的 XGBoost,因此应运行 pip install --upgrade xgboost 以获取最新版本。
加载与探索数据
在本教程中,我们将始终使用 Diamonds 数据集。它内置于 Seaborn 库中,或者您也可以从 Kaggle 下载。该数据集包含数值与类别特征的良好组合,以及超过 5 万条观测,足以从容展示 XGBoost 的全部优势。
import seaborn as sns
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import warnings
warnings.filterwarnings("ignore")
diamonds = sns.load_dataset("diamonds")
diamonds.head()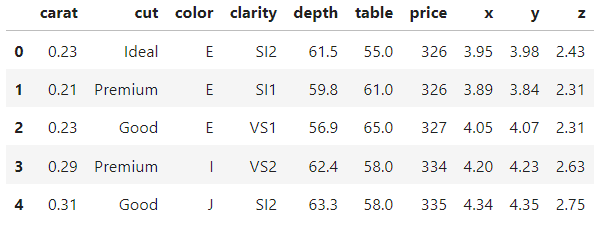
>>> diamonds.shape
(53940, 10)在典型的真实项目中,您应花更多时间探索数据集并可视化其特征。但由于该数据集由 Seaborn 内置,整体上相对干净。
因此,我们只看一下数值与类别特征的五数概览,然后开始动手。您可以先花点时间熟悉一下数据集。
diamonds.describe()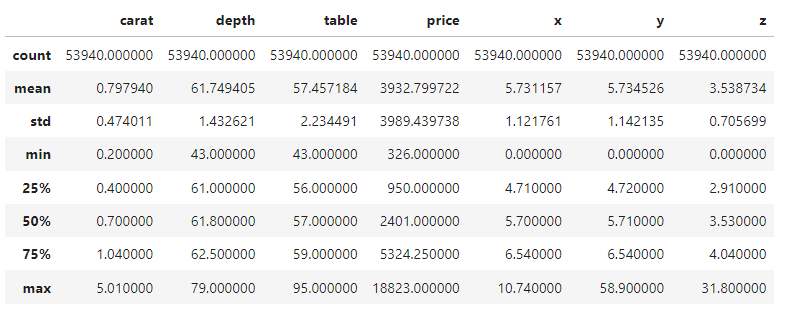
diamonds.describe(exclude=np.number)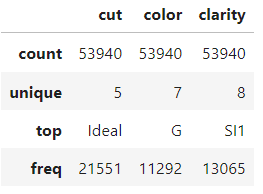
如何构建 XGBoost DMatrix
完成探索后,任何项目的第一步都是明确机器学习问题,并基于数据集提取特征与目标数组。
在本教程中,我们将首先尝试根据钻石的物理测量来预测其价格,因此目标为 price 列。
因此,我们将特征划分为 X,目标划分为 y:
from sklearn.model_selection import train_test_split
# Extract feature and target arrays
X, y = diamonds.drop('price', axis=1), diamonds[['price']]该数据集中有三列类别特征。通常,您会使用序数编码或独热编码来处理,但 XGBoost 能够在内部处理类别特征。
要启用此功能,需要将类别列转换为 Pandas 的 category 数据类型(默认情况下,它们被视为文本列):
# Extract text features
cats = X.select_dtypes(exclude=np.number).columns.tolist()
# Convert to Pandas category
for col in cats:
X[col] = X[col].astype('category')现在,当您打印 dtypes 属性时,会看到我们有三列 category 特征:
>>> X.dtypes
carat float64
cut category
color category
clarity category
depth float64
table float64
x float64
y float64
z float64
dtype: object让我们将数据划分为训练集和测试集(测试集比例为 0.25):
# Split the data
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=1)现在到关键部分:XGBoost 有一个名为 DMatrix 的数据集存储类。它对内存与速度做了高度优化。因此,对于 XGBoost 原生 API,将数据集转换为该格式是必需的:
import xgboost as xgb
# Create regression matrices
dtrain_reg = xgb.DMatrix(X_train, y_train, enable_categorical=True)
dtest_reg = xgb.DMatrix(X_test, y_test, enable_categorical=True)该类同时接收训练特征与标签。为启用对 Pandas 类别列的自动编码,我们还需将 enable_categorical 设为 True。
注意:
为何我们使用 XGBoost 的原生 API,而不是其 Scikit-learn API?虽然一开始使用 Sklearn API 可能更顺手,但您很快会发现 XGBoost 原生 API 含有一些前者不支持的优秀功能。因此,从一开始就熟悉它更好。不过,在文末我们也会展示,即便模型已训练完成,如何用一行代码在 API 之间切换。
Python 中的 XGBoost 回归
构建好 DMatrix 后,您需要为 objective 参数选择一个取值。它告诉 XGBoost 您要解决的机器学习问题,以及为解决该问题应使用哪些度量或损失函数。
例如,预测钻石价格属于回归问题,您可以使用常见的 reg:squarederror 目标。通常,目标名称也包含了该问题的损失函数名称。对于回归,常用的是均方根误差(RMSE),其最小化实际值与预测值差异平方和的平方根。以下是在 NumPy 中实现该度量的示例:
import numpy as np
mse = np.mean((actual - predicted) ** 2)
rmse = np.sqrt(mse)我们会在后文学习分类的目标函数。
关于损失函数与性能度量的区别说明:损失函数由机器学习模型用于最小化实际(真值)与预测之间的差异。而度量由机器学习工程师选择,用于衡量真值与预测之间的相似性。
简言之,损失函数应被最小化,而度量应被最大化。损失函数在训练期间使用,引导模型改进方向;度量在评估时使用,用于衡量整体性能。
训练
选定的目标函数及其他任何 XGBoost 超参数应在一个字典中指定,按惯例命名为 params:
# Define hyperparameters
params = {"objective": "reg:squarederror", "tree_method": "gpu_hist"}在这个初始的 params 中,我们还将 tree_method 设为 gpu_hist,以启用 GPU 加速。如果您没有 GPU,可以省略该参数或设为 hist。
接下来我们设置另一个参数 num_boost_round,表示提升轮次的数量。在内部,XGBoost 会以小步增量的方式(下文会详述)最小化 RMSE 损失。该参数用于指定这些轮次的数量。
理想的轮次应通过超参数调优得到。此处先将其设为 100:
# Define hyperparameters params = {"objective": "reg:squarederror", "tree_method": "gpu_hist"} n = 100 model = xgb.train( params=params, dtrain=dtrain_reg, num_boost_round=n, )当 XGBoost 在 GPU 上运行时,速度极快。如果上述代码未报错,则训练已成功!
评估
在提升轮次期间,模型对象已经尽可能学习了训练集中的各种模式。现在,我们必须在未见过的数据上测试它的性能。这正是我们的
dtest_regDMatrix 发挥作用的地方:from sklearn.metrics import mean_squared_error preds = model.predict(dtest_reg)此步骤称为模型评估(或推理)。使用 predict 生成预测后,您将其传入 Sklearn 的
mean_squared_error函数,与y_test进行比较:rmse = mean_squared_error(y_test, preds, squared=False) print(f"RMSE of the base model: {rmse:.3f}") RMSE of the base model: 543.203我们得到基础分数约 543 美元,这是使用默认参数的基础模型性能。改进它有两条路——进行交叉验证与超参数调优。但在此之前,先看看一种更快捷的 XGBoost 评估方式。
在训练中使用验证集
训练机器学习模型就像把火箭发射到太空。您可以在发射前完全掌控模型,但一旦发射,您只能旁观等待其结束。
我们当前训练流程的问题在于,甚至无法观察模型的前进方向。为解决这一点,我们将使用评估数组,让我们可以在各个提升轮次中逐步查看模型性能的改进。
首先,再次设置参数:
params = {"objective": "reg:squarederror", "tree_method": "gpu_hist"} n = 100接着,我们创建一个包含两个元组的列表,每个元组包含两个元素。第一个元素是供模型评估的数组,第二个是该数组的名称。
evals = [(dtrain_reg, "train"), (dtest_reg, "validation")]当我们将该列表传给
xgb.train的evals参数后,就能看到每个提升轮次后的模型表现:evals = [(dtrain_reg, "train"), (dtest_reg, "validation")] model = xgb.train( params=params, dtrain=dtrain_reg, num_boost_round=n, evals=evals, )您应会得到类似下方的输出(此处仅展示 10 行)。可以看到模型将分数从高达约 3931 美元降低到仅 543 美元。
更棒的是,我们可以同时查看模型在训练集与验证集上的表现。通常训练损失会低于验证损失,因为模型已经见过训练集。
[0] train-rmse:3985.18329 validation-rmse:3930.52457
[1] train-rmse:2849.72257 validation-rmse:2813.20828 [2] train-rmse:2059.86648 validation-rmse:2036.66330 [3] train-rmse:1519.32314 validation-rmse:1510.02762 [4] train-rmse:1153.68171 validation-rmse:1153.91223 ... [95] train-rmse:381.93902 validation-rmse:543.56526 [96] train-rmse:380.97024 validation-rmse:543.51413 [97] train-rmse:380.75330 validation-rmse:543.36855 [98] train-rmse:379.65918 validation-rmse:543.42558 [99] train-rmse:378.30590 validation-rmse:543.20278在真实项目中,您通常会训练上千个提升轮次,也就意味着会有很多行输出。为减少输出,可以使用
verbose_eval参数,强制 XGBoost 每隔vebose_eval轮打印一次性能更新:params = {"objective": "reg:squarederror", "tree_method": "gpu_hist"} n = 100 evals = [(dtest_reg, "validation"), (dtrain_reg, "train")] model = xgb.train( params=params, dtrain=dtrain_reg, num_boost_round=n, evals=evals, verbose_eval=10 # Every ten rounds ) [OUT]: [0] train-rmse:3985.18329 validation-rmse:3930.52457 [10] train-rmse:550.08330 validation-rmse:590.15023 [20] train-rmse:488.51248 validation-rmse:551.73431 [30] train-rmse:463.13288 validation-rmse:547.87843 [40] train-rmse:447.69788 validation-rmse:546.57096 [50] train-rmse:432.91655 validation-rmse:546.22557 [60] train-rmse:421.24046 validation-rmse:546.28601 [70] train-rmse:408.64125 validation-rmse:546.78238 [80] train-rmse:396.41125 validation-rmse:544.69846 [90] train-rmse:386.87996 validation-rmse:543.82192 [99] train-rmse:378.30590 validation-rmse:543.20278XGBoost 的早停法(Early Stopping)
到现在,您应该已经意识到提升轮次的重要性。一般来说,轮次越多,XGBoost 越能尝试最小化损失。但这并不意味着损失一定会持续下降。让我们尝试 5000 个提升轮次,并将输出频率设为每 500 轮:
params = {"objective": "reg:squarederror", "tree_method": "gpu_hist"} n = 5000 evals = [(dtest_reg, "validation"), (dtrain_reg, "train")] model = xgb.train( params=params, dtrain=dtrain_reg, num_boost_round=n, evals=evals, verbose_eval=250 ) [OUT]: [0] train-rmse:3985.18329 validation-rmse:3930.52457 [500] train-rmse:195.89184 validation-rmse:555.90367 [1000] train-rmse:122.10746 validation-rmse:563.44888 [1500] train-rmse:84.18238 validation-rmse:567.16974 [2000] train-rmse:61.66682 validation-rmse:569.52584 [2500] train-rmse:46.34923 validation-rmse:571.07632 [3000] train-rmse:37.04591 validation-rmse:571.76912 [3500] train-rmse:29.43356 validation-rmse:572.43196 [4000] train-rmse:24.00607 validation-rmse:572.81287 [4500] train-rmse:20.45021 validation-rmse:572.89062 [4999] train-rmse:17.44305 validation-rmse:573.13200我们在第 500 轮之前获得了最低的损失。此后,尽管训练损失持续下降,但验证损失(我们更关心的)却不断上升。
当设置了过多的提升轮次时,XGBoost 会开始过拟合并记忆数据集。这将导致验证性能下降,因为模型在“记忆”而非“泛化”。
请记住,我们想要的是黄金中间值:模型在训练中恰到好处地学习到足够的模式,从而在验证集上取得最高性能。那么,如何找到完美的提升轮次数量呢?
我们将使用一种名为早停的技术。早停会强制 XGBoost 关注验证损失,如果在指定轮数内不再提升,它就会自动停止训练。
这意味着,只要我们设置了合理的早停轮数,就可以将提升轮次设置得足够大。
例如,让我们使用 10000 个提升轮次,并将
early_stopping_rounds参数设为 50。这样,如果验证损失在连续 50 轮内没有改善,XGBoost 就会自动停止训练。n = 10000 model = xgb.train( params=params, dtrain=dtrain_reg, num_boost_round=n, evals=evals, verbose_eval=50, # Activate early stopping early_stopping_rounds=50 ) [OUT]: [0] train-rmse:3985.18329 validation-rmse:3930.52457 [50] train-rmse:432.91655 validation-rmse:546.22557 [100] train-rmse:377.66173 validation-rmse:542.92457 [150] train-rmse:334.27548 validation-rmse:542.79733 [167] train-rmse:321.04059 validation-rmse:543.35679如您所见,训练在第 167 轮后停止,因为在此前的 50 轮内损失未再改善。
XGBoost 的交叉验证
在教程一开始,我们将 25% 的数据集留作测试集。测试集可以让我们模拟模型在生产中的情形——它必须为未见过的数据生成预测。
但仅有一个测试集还不足以准确衡量模型在生产中的表现。例如,如果我们只用一个训练集与一个测试集进行超参数调优,有关测试集的知识仍可能“泄漏”出来。如何泄漏?
由于我们是通过比较模型在测试集上的验证表现来选择超参数的最佳取值,最终会得到一个仅在那个特定测试集上表现良好的模型。而我们更希望模型能够在各种情况下都表现优秀——也就是在任何我们抛给它的测试集上都表现良好。
一种可行的变通方法是将数据拆分为三份。模型在第一份上训练,第二份用于评估与超参数调优,第三份在投产前进行最终测试。
但当数据有限时,将数据分成三份会使训练集变得稀疏,从而损害模型性能。
以上问题的解决方案是交叉验证。交叉验证中,我们仍然有两份数据:训练与测试。
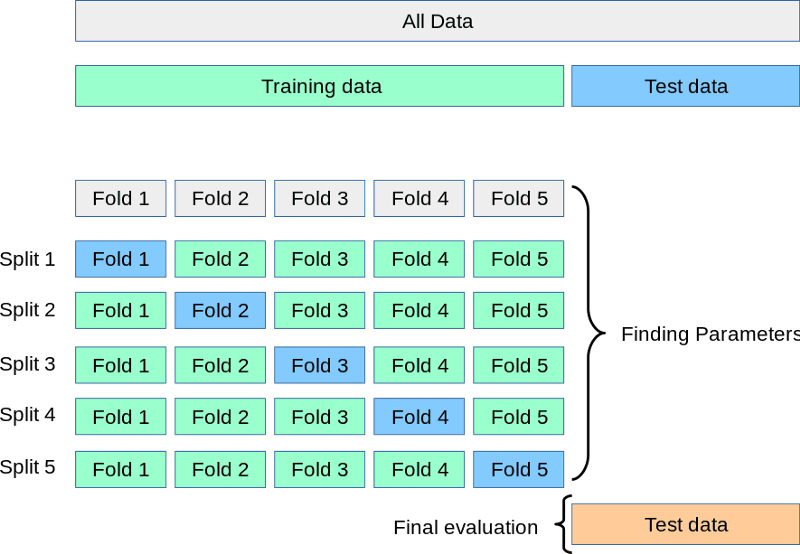
在测试集被搁置一旁时,我们将训练集再拆成 3、5、7 或 k 份(折)。然后训练模型 k 次。每次使用 k-1 份进行训练,最后第 k 份用于验证。这个过程称为 k 折交叉验证:
来源:https://scikit-learn.org/stable/modules/cross_validation.html
上图展示的是 5 折交叉验证的示意。所有折完成后,我们可以取各次评分的平均值,作为模型最贴近现实的最终性能。
让我们使用 XGB 的
cv函数在代码中完成该过程:params = {"objective": "reg:squarederror", "tree_method": "gpu_hist"} n = 1000 results = xgb.cv( params, dtrain_reg, num_boost_round=n, nfold=5, early_stopping_rounds=20 )与 train 函数的唯一区别是新增了
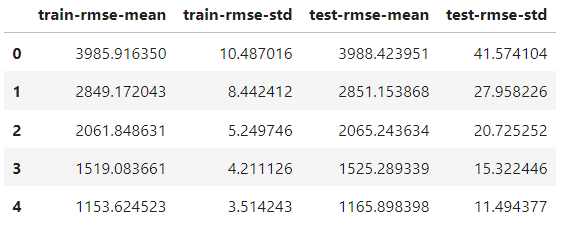
nfold参数,用于指定拆分份数。现在 results 对象是一个 DataFrame,包含每个折的结果:results.head()
其行数与提升轮次相同。每一行是该轮在所有拆分中的平均值。因此,为找到最佳分数,我们取
test-rmse-mean列的最小值:best_rmse = results['test-rmse-mean'].min() best_rmse 550.8959336674216请注意,这种交叉验证方法用于查看模型的真实性能。一旦对分数满意,您必须在完整数据上重新训练模型,然后再部署。
XGBoost 分类
构建 XGBoost 分类器只需更改目标函数;其余部分可以保持不变。
最常用的两个分类目标是:
binary:logistic—— 二分类(目标仅包含两类,如猫或狗)multi:softprob—— 多分类(目标包含两个以上类别,如苹果/橙子/香蕉)
在 XGBoost 中进行二分类与多分类几乎一致,因此我们选择后者。首先为该任务准备数据。
我们希望根据钻石的价格及其物理测量,预测其切工质量。因此相应地构建特征/目标数组:
from sklearn.preprocessing import OrdinalEncoder
X, y = diamonds.drop("cut", axis=1), diamonds[['cut']]
# Encode y to numeric
y_encoded = OrdinalEncoder().fit_transform(y)
# Extract text features
cats = X.select_dtypes(exclude=np.number).columns.tolist()
# Convert to pd.Categorical
for col in cats:
X[col] = X[col].astype('category')
# Split the data
X_train, X_test, y_train, y_test = train_test_split(X, y_encoded, random_state=1, stratify=y_encoded)唯一的区别在于,XGBoost 的目标只接受数值,因此我们使用 Sklearn 的 OrdinalEncoder 将目标中的文本类别编码为数值。
现在,构建 DMatrix……
# Create classification matrices
dtrain_clf = xgb.DMatrix(X_train, y_train, enable_categorical=True)
dtest_clf = xgb.DMatrix(X_test, y_test, enable_categorical=True)……并将目标设为 multi:softprob。该目标还要求我们设置类别数量:
params = {"objective": "multi:softprob", "tree_method": "gpu_hist", "num_class": 5}
n = 1000
results = xgb.cv(
params, dtrain_clf,
num_boost_round=n,
nfold=5,
metrics=["mlogloss", "auc", "merror"],
)在交叉验证期间,我们要求 XGBoost 关注三种分类度量,从三个不同角度报告模型表现。结果如下:
results.keys()
Index(['train-mlogloss-mean', 'train-mlogloss-std', 'train-auc-mean',
'train-auc-std', 'train-merror-mean', 'train-merror-std',
'test-mlogloss-mean', 'test-mlogloss-std', 'test-auc-mean',
'test-auc-std', 'test-merror-mean', 'test-merror-std'],
dtype='object')要查看最佳 AUC 分数,我们取 test-auc-mean 列的最大值:
>>> results['test-auc-mean'].max()
0.9402233623451636即便是默认配置,我们也获得了 94% 的表现,已经非常不错。
XGBoost 原生 API 与 Sklearn API
到目前为止,我们一直在使用 XGBoost 原生 API,但其 Sklearn API 也很受欢迎。
Sklearn 是一个庞大的框架,包含众多机器学习算法与工具,其 API 语法广受欢迎。因此,XGBoost 也提供了 XGBClassifier 与 XGBRegressor 类,以便集成进 Sklearn 生态(但会损失部分功能)。
如果您希望尽可能使用 Scikit-learn API,仅在需要额外功能时再切回原生 API,这也是可行的。
在训练好 XGBoost 分类器或回归器后,您可以通过 get_booster 方法进行转换:
import xgboost as xgb
# Train a model using the scikit-learn API
xgb_classifier = xgb.XGBClassifier(n_estimators=100, objective='binary:logistic', tree_method='hist', eta=0.1, max_depth=3, enable_categorical=True)
xgb_classifier.fit(X_train, y_train)
# Convert the model to a native API model
model = xgb_classifier.get_booster()转换后的 model 对象的行为将与本教程中所见完全一致。
结语
我们在本教程中覆盖了许多重要主题,但仍有很多内容值得学习。
您可以查看XGBoost 参数页面,学习如何配置参数,以从模型中榨取最后一分性能。
如果您在寻找一份全面的一体化学习资源,欢迎查看我们的《Extreme Gradient Boosting With XGBoost》课程。
XGBoost 是数据科学家中最受欢迎的机器学习框架之一。根据 Kaggle 的《2021 年数据科学现状调查》,将近 50% 的受访者表示他们使用 XGBoost,仅次于 TensorFlow 和 Sklearn。
https://www.kaggle.com/kaggle-survey-2021
本教程将介绍这一热门 Python 框架的关键方面,并讲解如何将其用于您自己的机器学习项目。
观看我们课程中的这段视频,进一步了解如何在 Python 中使用 XGBoost。
您将在本 Python XGBoost 教程中学到什么
在整个教程中,我们将涵盖 XGBoost 的关键内容,包括:
让我们开始吧!