

Các mô hình học máy không giống những giải pháp phần mềm truyền thống. Những mô hình này cần được cập nhật thường xuyên khi có dữ liệu mới để đưa ra dự đoán chính xác và đáng tin cậy. Trong các kịch bản phức tạp và nhạy cảm, dựa vào một mô hình đơn lẻ có thể không đủ để tạo ra kết quả tối ưu, và đây là lúc mô hình tập hợp phát huy tác dụng.
Hướng dẫn theo khái niệm này giải thích mô hình tập hợp trong học máy là gì và cách nó có thể cải thiện hiệu suất tổng thể của mô hình. Sau đó, chúng tôi sẽ điểm qua các phương pháp tập hợp khác nhau trước khi đi vào minh họa một tình huống thực tế bằng cách triển khai từng bước với Python.
Bài hướng dẫn Học Tập Hợp trong R với SuperLearner của chúng tôi giải thích cách tăng cường kết quả học máy dựa trên phương pháp học tập hợp bằng gói SuperLearner trong R.
Các mô hình Tập hợp trong Học máy
Hãy tưởng tượng một nhà quản lý âm nhạc tham gia một cuộc thi quốc tế. Họ có quyền tiếp cận nhiều nghệ sĩ với chuyên môn khác nhau:
- Nhạc công cổ điển có khả năng soạn các bản nhạc truyền thống.
- Nhạc công điện tử, chuyên sử dụng nhạc cụ điện tử.
- Nhạc công jazz với khả năng ứng tấu tuyệt vời.
- Nghệ sĩ độc tấu có thể trình diễn các đoạn solo phức tạp và làm nổi bật kỹ thuật của họ.
Với phổ chuyên môn và nền tảng âm nhạc rộng như vậy, nhà quản lý có thể kết hợp tất cả để tạo nên một màn trình diễn độc đáo và đáng nhớ.
Hãy nghĩ về mô hình tập hợp như một dàn nhạc, nơi mỗi người chuyên về một nhạc cụ cụ thể như piano, kèn trumpet, trống, và nhiều hơn nữa. Sự kết hợp các kỹ năng đó tạo ra một giai điệu hài hòa.
Học tập hợp sử dụng cùng một logic:
Nó kết hợp nhiều thuật toán để đạt hiệu suất dự đoán tốt hơn so với một mô hình đơn lẻ. Không có số lượng mô hình được xác định trước, và một số mục tiêu kinh doanh có thể cần nhiều mô hình hơn những mục tiêu khác.
Lỗi của mô hình và Giảm lỗi bằng Tập hợp
Lỗi phát sinh từ bất kỳ mô hình máy học nào có thể được phân tách thành ba thành phần về mặt toán học:
Thiên lệch + Phương sai + Lỗi không thể giảm
Tại sao điều này lại quan trọng trong ngữ cảnh hiện tại? Để hiểu điều gì diễn ra phía sau một mô hình tập hợp, trước tiên bạn cần biết điều gì gây ra lỗi trong mô hình.
Hãy xem các loại lỗi này:
Lỗi thiên lệch
Điều này hữu ích để định lượng mức độ mà, trung bình, các giá trị dự đoán khác với giá trị thực tế. Lỗi thiên lệch cao có nghĩa là chúng ta có một mô hình hoạt động kém, thường xuyên bỏ lỡ các xu hướng quan trọng.
Phương sai
Ở phía ngược lại, Phương sai định lượng mức độ khác nhau của các dự đoán được đưa ra trên cùng một quan sát. Một mô hình có phương sai cao sẽ quá khớp trên tập huấn luyện và hoạt động kém trên bất kỳ quan sát nào ngoài huấn luyện. Sơ đồ sau sẽ giúp bạn rõ hơn (giả sử chấm đỏ là giá trị thực, và chấm xanh là các dự đoán):
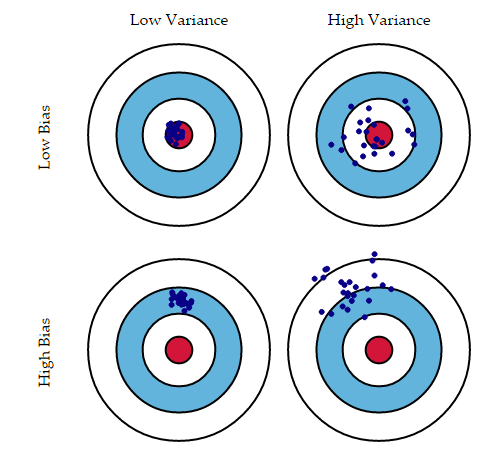
Thông thường, khi bạn tăng độ phức tạp của mô hình, bạn sẽ thấy lỗi giảm do thiên lệch thấp hơn. Tuy nhiên, điều này chỉ xảy ra đến một mức nhất định. Khi bạn tiếp tục làm mô hình phức tạp hơn, bạn sẽ làm mô hình bị quá khớp, và do đó mô hình bắt đầu chịu ảnh hưởng của phương sai cao.
Bây giờ bạn đã quen với những điều cơ bản của học tập hợp, hãy xem các kỹ thuật học tập hợp khác nhau:
Các loại Phương pháp Tập hợp
Có nhiều loại phương pháp tập hợp, và mỗi loại mang đến một bộ ưu và nhược điểm. Phần này đề cập đến những khía cạnh đó để giúp bạn đưa ra lựa chọn phù hợp cho các trường hợp sử dụng của mình.
Trước khi đi sâu vào từng phương pháp, hãy hiểu người học meta và người học cơ sở là gì để nắm rõ hơn các khái niệm tiếp theo.
- Người học cơ sở là cấp độ đầu tiên của kiến trúc học tập hợp, và mỗi người được huấn luyện để đưa ra dự đoán riêng lẻ.
- Người học meta, ngược lại, ở cấp độ thứ hai và được huấn luyện trên đầu ra của các người học cơ sở.
Bagging
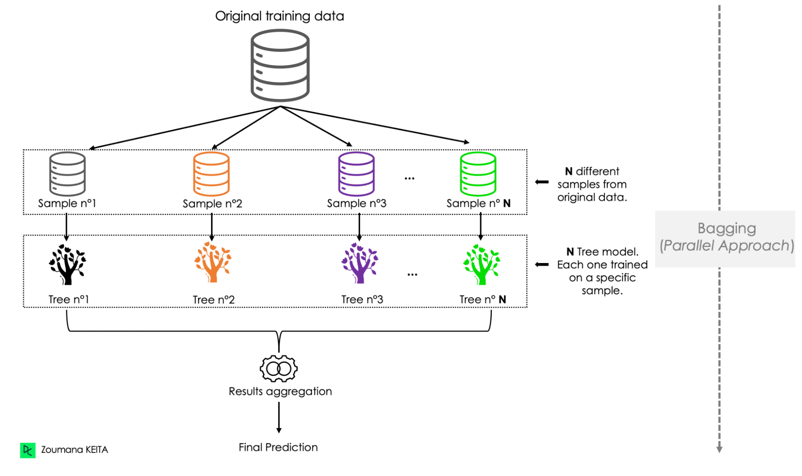
Bagging còn được gọi là bootstrap aggregation. Kỹ thuật này tương tự như random forest, nhưng nó sử dụng tất cả các biến dự báo, trong khi random forest chỉ sử dụng một tập con các biến dự báo trong mỗi cây.
Trong bagging, một mẫu ngẫu nhiên từ tập huấn luyện được chọn với hoàn lại, cho phép trùng lặp các mẫu trong một tập. Dưới đây là các bước chính trong bagging:
- Tạo nhiều mẫu bootstrap lại.
- Chạy một thuật toán trên mỗi mẫu để tạo dự đoán.
- Kết hợp các dự đoán bằng cách lấy trung bình các dự đoán hoặc lấy đa số phiếu (đối với phân loại).
Bagging có một số ưu và nhược điểm quan trọng khi dùng cho nhiệm vụ phân loại hoặc hồi quy.
Ưu điểm
- Quy trình mô hình hóa đơn giản, không đòi hỏi các khái niệm toán học sâu, và có thể xử lý giá trị thiếu.
- Gói scikit-learn giúp dễ dàng triển khai logic nền tảng. Nó chứa tất cả các mô-đun để kết hợp dự đoán của mỗi mô hình, còn gọi là người học cơ sở.
- Có tác dụng đáng kể trong việc giảm phương sai trên các bộ phân loại có phương sai cao. Điều này hữu ích khi xử lý dữ liệu chiều cao, giúp ngăn mô hình tổng quát hóa kém trên dữ liệu mới.
- Bagging cung cấp ước lượng không chệch của lỗi out-of-bag, tương ứng với lỗi/mất mát trung bình mà tất cả các bộ phân loại đó tạo ra.
Nhược điểm
- Bagging tốn kém về tính toán do sử dụng nhiều mô hình.
- Việc lấy trung bình trên các dự đoán khiến việc diễn giải kết quả cuối cùng trở nên khó khăn.
Boosting
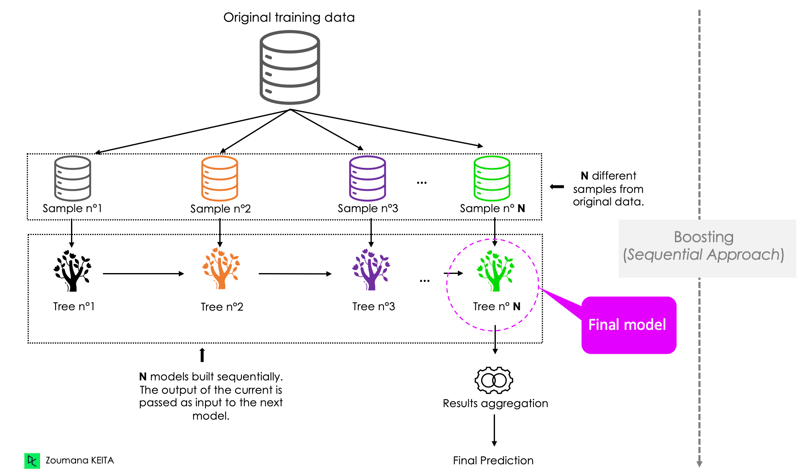
Boosting áp dụng cách tiếp cận tuần tự, trong đó dự đoán của mô hình hiện tại được chuyển cho mô hình kế tiếp. Mỗi mô hình lặp lại việc tập trung vào các quan sát bị phân loại sai bởi các tiền nhiệm của nó. Chúng tôi đã phác thảo quy trình tổng quát bên dưới:
Ưu điểm
- Tương tự bagging, boosting dễ hiểu và triển khai. Hơn nữa, nó không yêu cầu tiền xử lý và có thể xử lý giá trị thiếu trong dữ liệu.
- Hiệu quả trong việc giảm thiên lệch.
- Các thuật toán boosting ưu tiên các đặc trưng làm tăng độ chính xác tổng thể trong quá trình huấn luyện. Quá trình này giảm số chiều của dữ liệu, từ đó giảm thời gian tính toán.
Nhược điểm
- Cách tiếp cận tuần tự của boosting khiến các mô hình tiếp theo sửa lỗi của mô hình trước đó. Điều này làm cho mô hình tổng thể dễ bị ảnh hưởng bởi ngoại lệ.
- Boosting không dễ mở rộng vì cùng lý do liên quan đến tính tuần tự.
Stacking
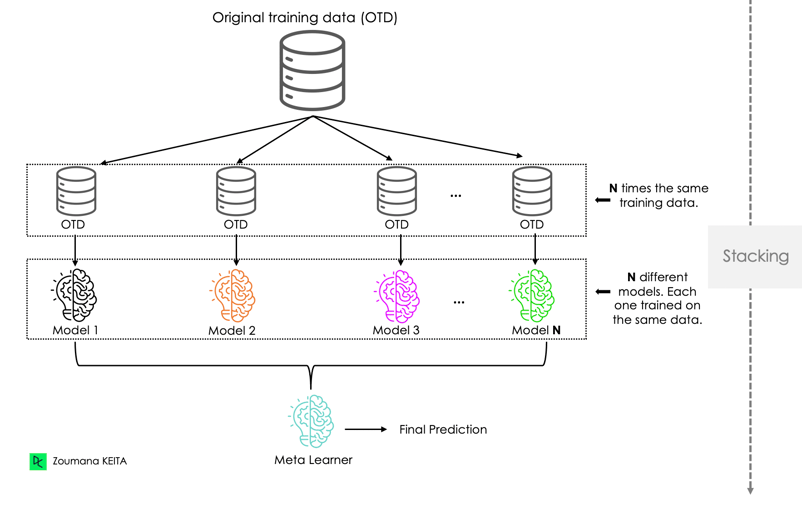
Stacking khá giống boosting. Các dự đoán từ các người học cơ sở được xếp chồng lên nhau và dùng làm đầu vào để huấn luyện người học meta nhằm tạo ra dự đoán mạnh mẽ hơn. Sau đó người học meta được dùng để đưa ra dự đoán cuối cùng. Bagging và boosting thường dùng các người học cơ sở đồng nhất, trong khi stacking có xu hướng kết hợp các người học không đồng nhất.
Ưu điểm
- Khai thác điểm mạnh của nhiều mô hình hiệu suất cao cho cả nhiệm vụ phân loại và hồi quy.
- Tương tự các mô hình tập hợp khác, stacking giúp xây dựng mô hình chính xác hơn so với các mô hình đơn lẻ.
Nhược điểm
- Sử dụng các mô hình cơ sở phức tạp có thể làm tăng nguy cơ quá khớp.
- Các cấp độ huấn luyện khác nhau có thể khiến kiến trúc stacking phức tạp khi triển khai.
Blending
Blending tương tự Stacking. Trong blending, cấu trúc dữ liệu gồm dữ liệu huấn luyện, giữ lại (hold-out) và kiểm thử. Người học meta được huấn luyện trên dữ liệu huấn luyện. Sau đó các dự đoán của họ được kết hợp với dữ liệu giữ lại để xây dựng mô hình meta cuối cùng, mô hình này dùng dữ liệu kiểm thử để đưa ra dự đoán cuối.
Ưu điểm
- Giống stacking và nhiều phương pháp tập hợp khác, blending có thể nâng cao hiệu suất mô hình cuối trong nhiều trường hợp.
- Kỹ thuật này đã được sử dụng thành công để giành chiến thắng trong nhiều cuộc thi.
Nhược điểm
- Chia dữ liệu gốc theo kiến trúc blending có thể hạn chế dữ liệu dùng để huấn luyện các mô hình cơ sở, dẫn đến hiệu suất kém.
- Giống các mô hình tập hợp khác, khả năng diễn giải của mô hình cuối cùng bị giảm do độ phức tạp tăng lên, khiến khó rút ra các insight kinh doanh quan trọng.
Voting
Trong voting, nhiều mô hình được huấn luyện độc lập, và dự đoán của chúng được kết hợp để tạo ra dự đoán cuối cùng bằng bỏ phiếu cứng, bỏ phiếu mềm hoặc bỏ phiếu có trọng số:
- Trong bỏ phiếu cứng, dự đoán cuối là dự đoán phổ biến nhất từ tất cả các mô hình.
- Với bỏ phiếu mềm, mỗi mô hình tạo ra một phân phối xác suất thay vì dự đoán nhị phân. Khi đó, lớp có xác suất cao nhất sẽ được chọn.
- Cuối cùng, trong bỏ phiếu có trọng số, giả định rằng một số mô hình có kỹ năng tốt hơn những mô hình khác, và các mô hình đó được gán mức đóng góp cao hơn khi đưa ra dự đoán.
Ưu điểm
- Kiến trúc voting đơn giản hơn để triển khai so với stacking và blending. Ngoài ra, nó không yêu cầu tinh chỉnh phức tạp.
- Việc dùng nhiều người học cơ sở trong voting giúp ít bị ảnh hưởng bởi từng mô hình riêng lẻ, góp phần tạo ra dự đoán ổn định và đáng tin cậy hơn.
Nhược điểm
- Có thể khó xử lý xung đột giữa các dự đoán của mô hình, khiến khó đưa ra quyết định cuối cùng một cách có ý nghĩa.
- Thêm nhiều mô hình vào mô hình voting không nhất thiết cải thiện hiệu suất cuối cùng.
Cascading
Cascading sử dụng cách tiếp cận stacking nhưng chỉ với một mô hình ở mỗi tầng. Mô hình đầu tiên được huấn luyện trên toàn bộ dữ liệu huấn luyện, và mô hình kế tiếp được huấn luyện trên đầu ra của mô hình trước đó. Mục tiêu của chiến lược này là học các mẫu phức tạp từ dữ liệu, từ đó cho phép mô hình dự đoán tốt hơn.
Ưu điểm
- Mô hình sau chuyên biệt hóa trên đầu ra của mô hình trước, giúp giảm nhiễu trong dữ liệu.
- Chống quá khớp tốt hơn và có thể hoạt động tốt trên dữ liệu thực tế.
Nhược điểm
- Việc triển khai cascading có thể phức tạp vì liên quan đến huấn luyện từng mô hình trong chuỗi.
- Tìm kiến trúc cascading tối ưu có thể cần nhiều thử nghiệm và tinh chỉnh.
Tổng quan về Thuật toán Tập hợp
Các phần trước đã đề cập các loại mô hình tập hợp khác nhau. Bây giờ, hãy điểm qua ngắn gọn một số mô hình phổ biến.
Random Forest
Random Forest là một mô hình thường dùng có thể giải quyết cả bài toán phân loại và hồi quy. Một rừng ngẫu nhiên gồm nhiều cây quyết định được huấn luyện bằng bagging. Kết quả được xác định bằng cách lấy trung bình dự đoán của các cây riêng lẻ.
Kích thước nút, số lượng cây và số đặc trưng được lấy mẫu là ba siêu tham số chính cần đặt trước khi huấn luyện random forest.
Tính ngẫu nhiên trong random forest là gì?
Feature bagging, hay còn gọi là ngẫu nhiên đặc trưng, tạo ra một mẫu ngẫu nhiên các đặc trưng để đảm bảo tương quan thấp giữa các cây quyết định. Cách tiếp cận này tạo nên sự khác biệt của random forest so với cây quyết định vốn xem xét tất cả các phép tách đặc trưng có thể có, trong khi random forest chỉ xem xét một tập con các đặc trưng đó. Đọc thêm trong hướng dẫn phân loại bằng random forest của chúng tôi.
XGBoost
Extreme Gradient Boosting, hay XGBoost, được dùng cho cả phân loại và hồi quy. XGBoost được thiết kế để có khả năng mở rộng và hiệu quả cao, và nó triển khai khung cây quyết định boosting theo gradient.
Nó phù hợp để xử lý các bộ dữ liệu quy mô lớn và tương thích với các môi trường phân tán chính như Hadoop, MPI (Message Passing Inference), và SGI (Sun Grid Engine). Bạn có thể tìm hiểu thêm trong hướng dẫn XGBoost của chúng tôi.
AdaBoost
Adaptive Boosting, hay AdaBoost, là một trong những bộ phân loại boosting đầu tiên và thành công cho phân loại nhị phân. Nó mang tính thích ứng vì trọng số được gán lại cho từng mẫu, và các mẫu bị phân loại sai được gán trọng số cao hơn. Đọc thêm về Phân loại AdaBoost trong Python trong bài hướng dẫn riêng của chúng tôi.
Triển khai Từng bước Các Mô hình Tập hợp
Giờ bạn đã hiểu ý tưởng chính của mô hình tập hợp và cách một số mô hình hoạt động, phần này sẽ tập trung vào triển khai kỹ thuật bằng Python.
Thiết lập môi trường
Để bắt đầu, bạn cần cài đặt Python trên máy tính, cùng với các thư viện sau:
- pandas để nạp khung dữ liệu.
- Scikit-learn để sử dụng các thuật toán học máy sẵn có.
- Seaborn và matplotlib cho mục đích trực quan hóa.
Bạn có thể cài đặt các thư viện này bằng pip, trình quản lý gói của Python, như sau:
pip install scikit-learn
pip install pandas
pip install matplotlib seabornĐể minh họa rõ hơn, chúng ta sẽ sử dụng dữ liệu khoản vay (Loan Data) có sẵn trên DataLab. Mã nguồn cho bài hướng dẫn này cũng có trên DataLab trong sổ tay này; bạn có thể tạo bản sao sổ tay của riêng mình và chỉnh sửa, chạy mã ngay trên trình duyệt mà không cần cài gì trên máy.
Hiểu dữ liệu
Bộ dữ liệu có 9.500 khoản vay với thông tin về cấu trúc khoản vay, người vay, và việc khoản vay có được trả hết hay không, được biểu diễn bởi cột not.fully.paid. Năm quan sát đầu tiên được hiển thị bên dưới:
import pandas as pd
loan_data = pd.read_csv("loan_data.csv")
loan_data.head()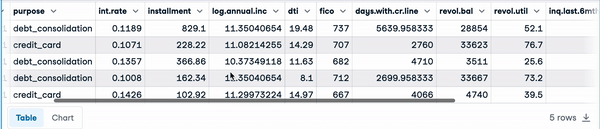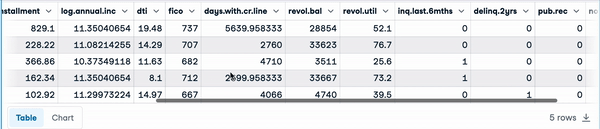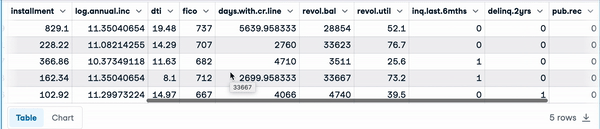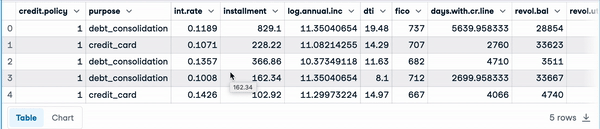
Sử dụng hàm info() tạo ra thông tin liên quan sau về dữ liệu:
- 9.578 hàng (từ 0 đến 9577), và 14 cột kiểu số ngoại trừ
purpose, có kiểuobjectvà cung cấp mô tả dạng văn bản về mục đích khoản vay. - Thẻ
non-nullcho mỗi cột có nghĩa là không có thiếu dữ liệu trong cột cụ thể đó ở bất kỳ cột nào.
loan_data.info()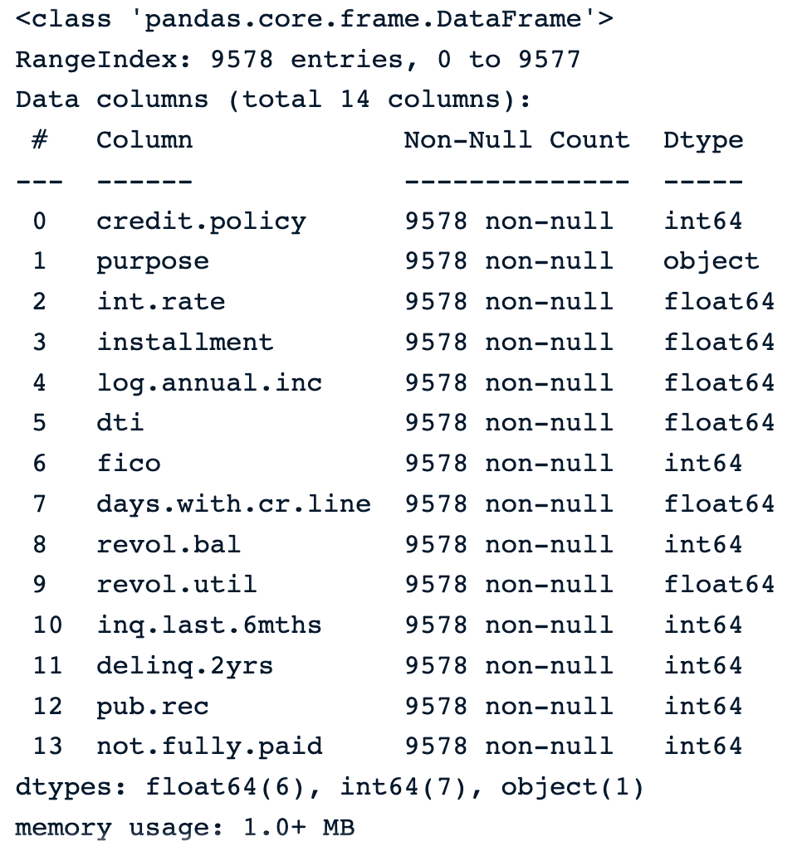
Chúng ta nhận thấy tình huống dữ liệu mất cân bằng, nơi có nhiều quan sát thuộc lớp 0 (8045 quan sát) hơn rất nhiều so với lớp 1 (chỉ 1533 quan sát).
print(loan_data['not.fully.paid'].value_counts())
loan_data['not.fully.paid'].value_counts().plot(kind='barh')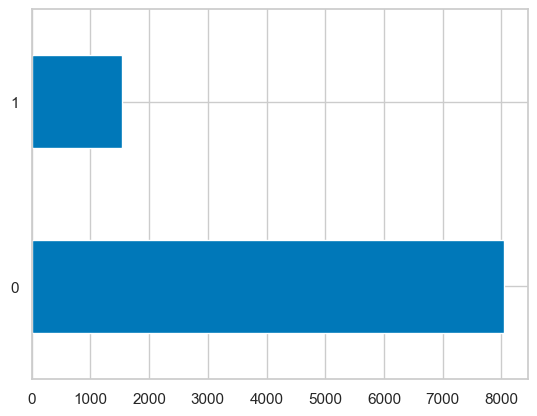
Huấn luyện mô hình với dữ liệu mất cân bằng như vậy sẽ ảnh hưởng đến hiệu suất tổng thể.
Một cách xử lý vấn đề này là dùng phương pháp lấy mẫu thiếu (undersampling), nghĩa là giảm số lượng quan sát của lớp chiếm đa số (lớp 0). Trong trường hợp này, số quan sát của lớp 0 sẽ bằng với lớp 1, và quy trình như sau:
-
Đầu tiên lấy số lượng của lớp 1.
-
Chọn ngẫu nhiên N quan sát từ lớp 0, trong đó N là kích thước của khung dữ liệu lớp 1.
-
Nối hai khung dữ liệu trước đó.
loan_data_class_1 = loan_data[loan_data['not.fully.paid'] == 1]
number_class_1 = len(loan_data_class_1)
loan_data_class_0 = loan_data[loan_data['not.fully.paid'] == 0].sample(number_class_1)
final_loan_data = pd.concat([loan_data_class_1,
loan_data_class_0])
print(final_loan_data.shape)Bài hướng dẫn Đào sâu vào Dữ liệu Mất cân bằng cung cấp thêm tài nguyên để học các kỹ thuật xử lý tập dữ liệu mất cân bằng.
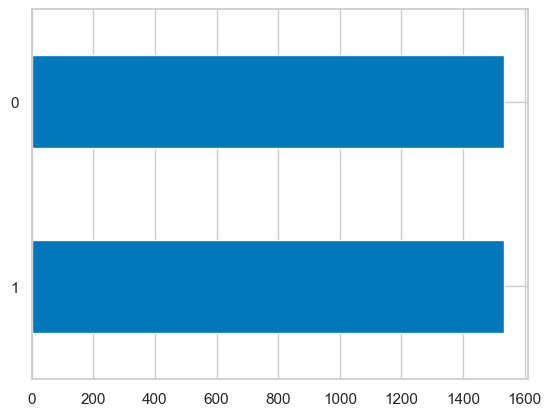
Sau khi lấy mẫu thiếu, chúng ta thu được:
- Tổng cộng 3.066 quan sát và 14 cột.
Và phân phối cân bằng cuối cùng được hiển thị bên dưới.
Chuẩn bị dữ liệu để huấn luyện
Quan sát bộ dữ liệu, chúng ta nhận thấy không phải mọi đặc trưng đều có cùng thang đo, và một số mô hình học máy như KNN nhạy cảm với việc khác thang này. Vấn đề này có thể được xử lý bằng cách chuẩn hóa phạm vi của các đặc trưng về cùng một thang bằng mô-đun MinMaxScaler. Trong trường hợp này là giữa 0 và 1.
Đồng thời, chúng ta sẽ loại bỏ cột purpose để đơn giản hóa, vì nó cần tiền xử lý bổ sung.
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler(feature_range=(0, 1))
# Remove unwanted 'purpose' column and get the data
final_loan_data.drop('purpose', axis=1, inplace=True)
X = final_loan_data.drop('not.fully.paid', axis=1)
normalized_X = scaler.fit_transform(X)Như trong mọi tác vụ dự đoán, chúng ta cần chia dữ liệu thành tập huấn luyện và kiểm thử. Ở đây, chúng ta sẽ dùng 77% cho huấn luyện và 33% còn lại cho kiểm thử.
- Thuộc tính random state được khởi tạo với một giá trị ngẫu nhiên (2023 trong trường hợp này) để đảm bảo khả năng tái lập kết quả.
Stratify được dùng để đảm bảo giá trị mục tiêu y được phân bố đều ở cả dữ liệu huấn luyện và kiểm thử.
from sklearn.model_selection import train_test_split
y = final_loan_data['not.fully.paid']
r_state = 2023
t_size = 0.33
X_train, X_test, y_train, y_test = train_test_split(normalized_X, y,
test_size=t_size,
random_state=r_state,
stratify=y)Tất cả các mô hình sẽ theo trình tự huấn luyện trên dữ liệu huấn luyện, dự đoán trên dữ liệu kiểm thử và đánh giá hiệu suất của mô hình.
Mô hình Bagging
Random Forest là mô hình bagging được dùng trong phần này. Chúng ta sẽ dùng tham số mặc định cho đơn giản.
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import cross_val_score
# Define the model
random_forest_model = RandomForestClassifier()
# Fit the random search object to the data
random_forest_model.fit(X_train, y_train)Sau khi huấn luyện mô hình, hiệu suất được tính bằng hàm accuracy_score như sau:
# Make predictions
y_pred = random_forest_model.predict(X_test)
# Get the performance
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy:", accuracy) Câu lệnh print trên tạo ra 0.6156, tức 61,56%
Bây giờ hãy so sánh điểm số này với hiệu suất của cách tổng hợp theo blending.
Mô hình Blending
Với blending, chúng ta sẽ dùng hai mô hình cơ sở: một cây quyết định và một bộ phân loại K-Nearest Neighbors. Một mô hình hồi quy cuối cùng được dùng để đưa ra dự đoán cuối.
from sklearn.neighbors import KNeighborsClassifier
from sklearn.tree import DecisionTreeClassifier
from sklearn.linear_model import LogisticRegressionDữ liệu huấn luyện gốc được chia thành một tập huấn luyện mới và một tập xác thực. Các mô hình cơ sở được huấn luyện trên dữ liệu huấn luyện.
X_train, X_val, y_train, y_val = train_test_split( X_train, y_train, test_size=t_size, random_state=r_state)Sau đó tạo hai khung dữ liệu từ các dự đoán của các mô hình cơ sở đó:
- Khung dữ liệu thứ nhất với các dự đoán trên dữ liệu xác thực được nối với dữ liệu xác thực gốc.
- Khung dữ liệu thứ hai với các dự đoán trên dữ liệu kiểm thử được nối với dữ liệu kiểm thử gốc.
# Decision Tree Model
dt_model = DecisionTreeClassifier()
dt_model.fit(X_train, y_train)
dt_model_pred_val = dt_model.predict(X_val)
dt_model_pred_test= dt_model.predict(X_test)
dt_model_pred_val = pd.DataFrame(dt_model_pred_val)
dt_model_pred_test = pd.DataFrame(dt_model_pred_test)
# KNN Model
knn_model = KNeighborsClassifier()
knn_model.fit(X_train,y_train)
knn_model_pred_val = knn_model.predict(X_val)
knn_model_pred_test = knn_model.predict(X_test)
knn_model_pred_val = pd.DataFrame(knn_model_pred_val)
knn_model_pred_test = pd.DataFrame(knn_model_pred_test)
Mô hình hồi quy logistic cuối cùng được xây dựng bằng dữ liệu xác thực đã nối, và được đánh giá bằng dữ liệu kiểm thử đã nối.
x_val = pd.DataFrame(X_val)
x_test = pd.DataFrame(X_test)
df_val_lr = pd.concat([x_val, knn_model_pred_val,
dt_model_pred_val], axis=1)
df_test_lr = pd.concat([x_test, dt_model_pred_test,
knn_model_pred_test],axis=1)
# Logistic Regression Model
lr_model = LogisticRegression()
lr_model.fit(df_val_lr,y_val)
lr_model.score(df_test_lr,y_test)Sử dụng hàm .score() sẽ tính điểm độ chính xác theo mặc định và không cần dự đoán tường minh.
Kết quả hiệu suất là 0.6383, tức 63,83% và cao hơn khoảng 2% so với random forest ban đầu; do đó mô hình blending cho hiệu suất tốt nhất.
Khóa học Ensemble Methods in Python và Machine Learning with Tree-Based Models in R của chúng tôi có thể là bước tiếp theo tuyệt vời để tiếp tục hành trình học máy của bạn bằng cách đi sâu vào thế giới phương pháp phân loại theo tập hợp, lần lượt trong Python và R.
Kết luận
Bài viết này đã đề cập các loại mô hình tập hợp khác nhau cùng với đặc điểm, ưu và nhược điểm của chúng. Đồng thời, bài viết cũng cung cấp tổng quan ngắn gọn về một số ví dụ thuật toán dựa trên mô hình tập hợp như Random Forest, Adaboost, XGBoost, Gradient Boosting Trees và Gradient Boosting Machines.
Khi xây dựng các mô hình tập hợp, điều quan trọng là nhận thức được ưu nhược điểm của chúng để có insight kinh doanh tốt hơn.
Câu hỏi thường gặp
Sự khác nhau giữa người học đồng nhất và không đồng nhất là gì?
Người học đồng nhất là các người học có cùng loại thuật toán và siêu tham số. Random forest có thể được coi là một tập hợp các người học đồng nhất.
Ngược lại, người học không đồng nhất có thuật toán và siêu tham số khác nhau. Random forest, mạng nơ-ron và KNN có thể là các người học không đồng nhất trong một mô hình tập hợp.
Ưu điểm của mô hình tập hợp so với mô hình đơn lẻ là gì?
Sử dụng các mô hình tập hợp có thể đưa ra dự đoán tốt hơn so với một mô hình đơn lẻ.
Hạn chế của các mô hình tập hợp là gì?
Các mô hình tập hợp có thể thiếu khả năng diễn giải, nghĩa là tri thức mà chúng học được không dễ hiểu đối với người dùng cuối.
Khi nào bạn nên tránh dùng mô hình tập hợp?
Nên tránh sử dụng mô hình tập hợp trong các điều kiện sau (nhưng không giới hạn): yêu cầu khả năng diễn giải cao, dữ liệu hạn chế, ràng buộc thời gian thực và chi phí tính toán cao.
Các loại phương pháp tập hợp trong học máy là gì?
Bagging, boosting, stacking, voting, blending và cascading là các loại phương pháp tập hợp chính trong học máy.

