

随机森林分类如何工作
想象您要解决一个复杂问题,于是召集来自不同领域的专家给出意见。每位专家会基于各自的专长和经验给出看法,然后大家投票得出最终结论。
在随机森林分类中,会使用数据与特征的不同随机子集创建多棵决策树。每棵决策树就像一位专家,对数据的分类给出自己的判断。预测时会汇总每棵树的预测,然后选取最受欢迎的结果(回归问题中则使用平均的方法)。
下图中,我们有一个包含 n 棵决策树的随机森林,展示了前 5 棵树及其预测(“Dog” 或 “Cat”)。每棵树接触到的特征数量和原始数据样本都不同,因此每棵树都可能不一样;每棵树都会给出一个预测。
观察前 5 棵树,可以看到其中 4/5 预测该样本为 Cat。绿色圆圈表示树到达该决策的假想路径。随机森林会统计各决策树对Cat和Dog的预测数量,并选择最受欢迎的预测。
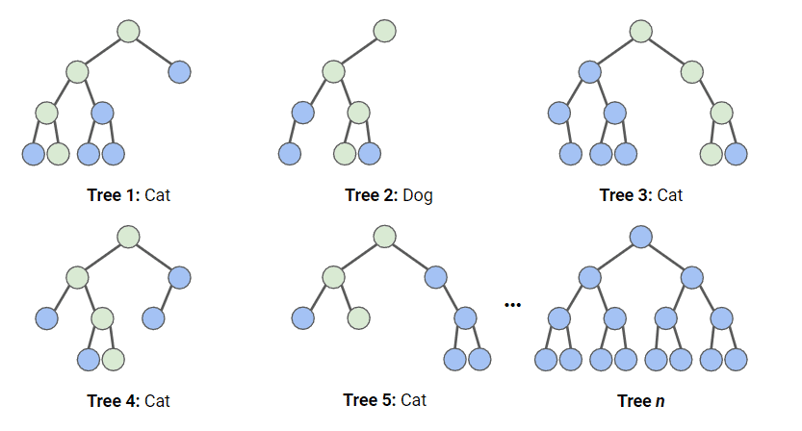 随机森林分类工作原理示意图。作者制图
加载数据集
该数据集来自一家葡萄牙银行机构通过电话进行的直销活动。活动旨在销售银行定期存款订阅。我们将把这个数据集存入名为bank_data的变量中。本教程将使用以下列:
-
age:接到电话者的年龄 -
default:该人士是否有信用违约 -
cons.price.idx:通话时的消费者物价指数得分 -
cons.conf.idx:通话时的消费者信心指数得分 -
y:是否订阅(这是我们要预测的目标)
导入包
本教程将使用以下包与函数:
# Data Processing
import pandas as pd
import numpy as np
# Modelling
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, confusion_matrix, precision_score, recall_score, ConfusionMatrixDisplay
from sklearn.model_selection import RandomizedSearchCV, train_test_split
from scipy.stats import randint
# Tree Visualisation
from sklearn.tree import export_graphviz
from IPython.display import Image
import graphviz随机森林的工作流
为了拟合并训练该模型,我们将遵循机器学习工作流信息图;不过由于我们的数据相当干净,不会执行每一个步骤。我们将会进行:
- 特征工程
- 划分数据
- 训练模型
- 超参数调优
- 评估模型表现
为随机森林分类器预处理数据
树模型相比线性模型对异常值更健壮,也不需要对变量进行归一化即可工作。因此,我们只需对数据做极少的预处理。
-
我们将把
default列中的no和yes分别映射为0和1。本示例中,我们将unknown视作no。 -
同时将目标变量
y映射为1和0。
bank_data['default'] = bank_data['default'].map({'no':0,'yes':1,'unknown':0})
bank_data['y'] = bank_data['y'].map({'no':0,'yes':1})划分数据
在训练任何监督学习模型时,将数据划分为训练集与测试集非常重要。训练数据用于拟合模型,算法通过训练数据学习特征与目标之间的关系。测试数据用于评估模型性能。
下面的代码将数据拆分为特征与目标两个变量,然后再划分为训练集与测试集。
# Split the data into features (X) and target (y)
X = bank_data.drop('y', axis=1)
y = bank_data['y']
# Split the data into training and test sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42, stratify=y)拟合并评估随机森林模型
我们先用默认参数创建一个随机森林模型实例,然后将其拟合到训练数据上。我们同时传入特征与目标变量以便模型学习。
rf = RandomForestClassifier()
rf.fit(X_train, y_train)此时我们已经得到一个训练完成的随机森林模型,但还需要判断其预测是否准确。
y_pred = rf.predict(X_test)评估该模型最简单的方法是查看准确率;即将预测与测试集中的真实值进行比对,统计模型预测正确的比例。
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy:", accuracy)输出:
Accuracy: 0.888这是个不错的分数!不过,通过优化超参数,我们或许还能进一步提升表现。
注意:仅看准确率在类别不平衡的数据上可能会产生误导。务必同时查看精确率与召回率,以理解假阳性与假阴性的权衡。
结果可视化
我们可以使用以下代码可视化前 3 棵树。
# Export the first three decision trees from the forest
for i in range(3):
tree = rf.estimators_[i]
dot_data = export_graphviz(tree,
feature_names=X_train.columns,
filled=True,
max_depth=2,
impurity=False,
proportion=True)
graph = graphviz.Source(dot_data)
display(graph)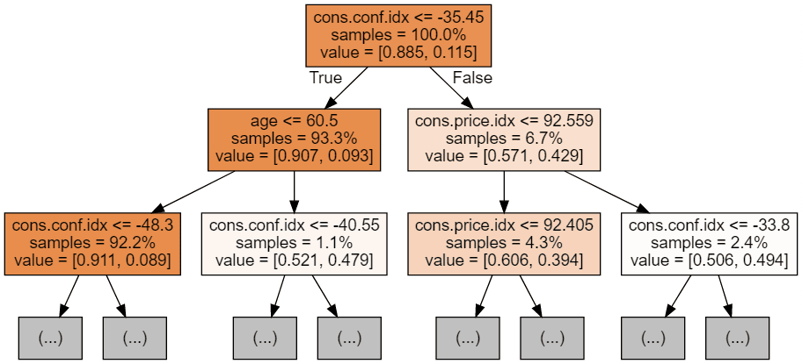
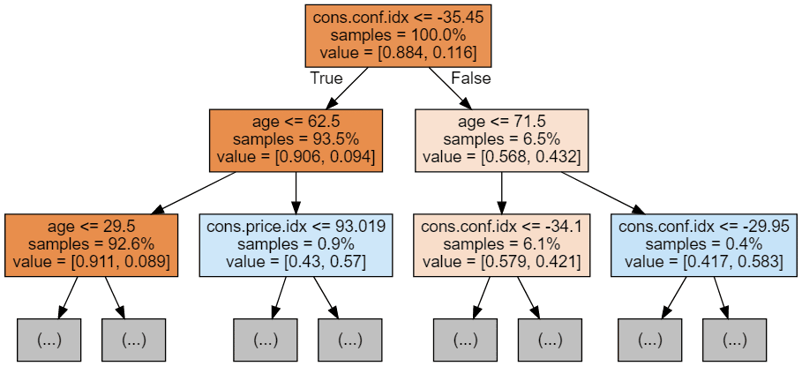
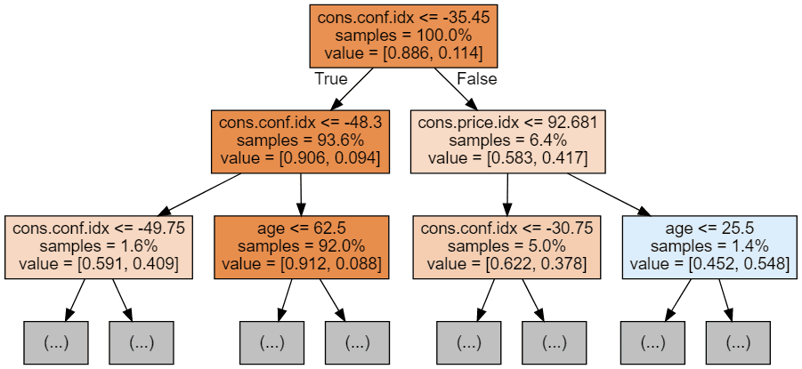
每张树图仅展示前几个节点。这些树可能非常庞大,难以完整可视化。颜色表示各节点(方框)的多数类别:红色表示多数为 0(未订阅),蓝色表示多数为 1(已订阅)。颜色越深,表示该节点越接近完全为 0 或 1。每个节点还包含以下信息:
- 用于划分的变量名与阈值
- 各分支中样本占总样本的百分比
- 各分支中类别占比
超参数调优
下面的代码使用 Scikit-Learn 的RandomizedSearchCV,它会在每个超参数的取值范围内随机搜索。我们在 param_dist 字典中定义超参数及其范围。本例中我们使用:
-
n_estimators:森林中决策树的数量。一般来说,增加该值能提升模型性能,但也会提高训练与预测的计算成本。
-
max_depth:森林中每棵决策树的最大深度。
max_depth过大可能导致过拟合,过小则可能欠拟合。
param_dist = {
'n_estimators': randint(100, 500),
'max_depth': randint(3, 15),
'min_samples_split': randint(2, 10),
'min_samples_leaf': randint(1, 5)
}
# Create a random forest classifier
rf = RandomForestClassifier(random_state=42, n_jobs=-1)
# Use random search to find the best hyperparameters
rand_search = RandomizedSearchCV(
rf, param_distributions=param_dist,
n_iter=10, cv=5, scoring='accuracy',
n_jobs=-1, random_state=42
RandomizedSearchCV将训练多个模型(由n_iter_定义)并将每个模型保存为变量。下面的代码创建最佳模型的变量并打印其超参数。
在本例中,我们未向函数传入评分体系,因此默认使用准确率。该函数还使用交叉验证,即将数据分为五个等大小分组,使用其中 4 个训练、1 个测试,循环遍历每个分组得到准确率并取平均,以找到最佳模型。
# Create a variable for the best model
best_rf = rand_search.best_estimator_
# Print the best hyperparameters
print('Best hyperparameters:', rand_search.best_params_)输出:
Best hyperparameters: {'max_depth': 5, 'n_estimators': 260}更多随机森林评估指标
我们来查看混淆矩阵。它将模型预测与真实结果对照绘制,可用于理解假阳性(右上)与假阴性(左下)之间的权衡。可用以下代码绘制混淆矩阵:
# Generate predictions with the best model
y_pred = best_rf.predict(X_test)
# Create the confusion matrix
cm = confusion_matrix(y_test, y_pred)
ConfusionMatrixDisplay(confusion_matrix=cm).plot();输出:
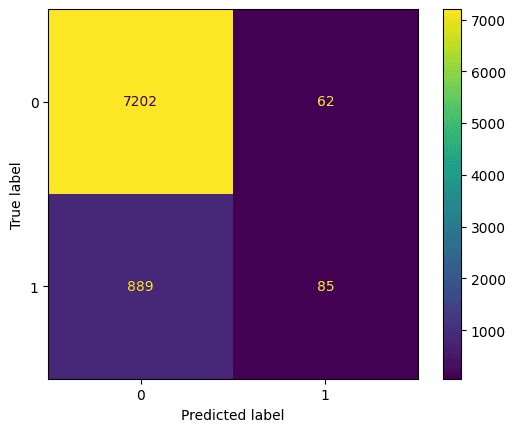
使用混淆矩阵评估随机森林分类器。作者制图
我们还应使用准确率、精确率与召回率评估最佳模型(由于存在随机性,您的结果可能有所不同)
y_pred = knn.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
precision = precision_score(y_test, y_pred)
recall = recall_score(y_test, y_pred)
print("Accuracy:", accuracy)
print("Precision:", precision)
print("Recall:", recall)输出:
Accuracy: 0.885
Precision: 0.578
Recall: 0.0873下面的代码绘制各特征的重要性,使用模型的内部评分来寻找在各决策树中划分数据的最佳方式。
# Create a series containing feature importances from the model and feature names from the training data
importances = pd.Series(best_rf.feature_importances_, index=X_train.columns)
importances.sort_values(ascending=False).plot.bar()
这表明在通话时的消费者信心指数是预测其是否订阅的最重要特征。
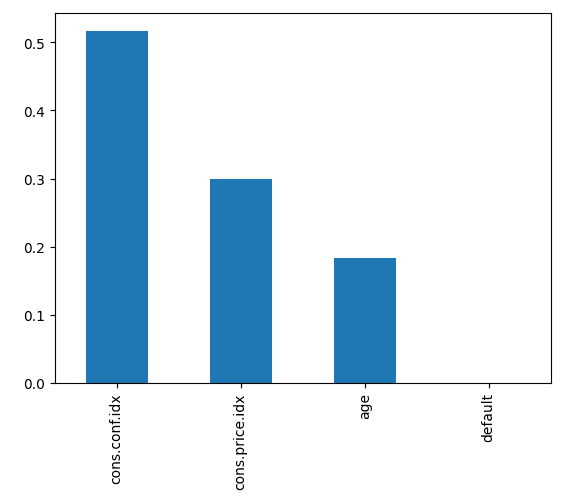
按重要性排序的随机森林分类器特征。作者制图
何时使用随机森林(以及何时不适合)
当您需要一个强有力的基线模型且开箱即用效果良好时,随机森林是很好的选择。它既能处理数值和分类型特征,又能较好地应对缺失值,并且相比单棵决策树不易过拟合。
在以下情况下使用随机森林:
- 您拥有表格型数据,且特征类型混合
- 您需要一个稳健的模型,而无需大量特征缩放或预处理
- 可解释性(如特征重要性)对您的应用很重要
然而,以下情形可能不太适合使用随机森林:
- 您需要实时预测;它可能比单一模型更慢
- 您在处理超高维数据(如文本或图像)
- 您追求结构化数据上的最先进精度,此时梯度提升方法如XGBoost或 LightGBM 往往表现更佳
进阶学习
若要开始在 Python 中学习监督式机器学习,请学习使用 scikit-learn 的监督学习。想进一步了解随机森林及其他树模型,请查看我们的Python 树模型机器学习和Python 集成方法课程。
随机森林常见问答
什么是随机森林分类?
随机森林分类是一种集成机器学习算法,它使用多棵决策树对数据进行分类。通过聚合多棵决策树的预测,它能降低过拟合并提升准确率。
随机森林如何防止过拟合?
随机森林通过在不同的数据与特征子集上创建多棵决策树来降低过拟合。随后对预测结果求平均(或投票),使模型更具泛化性,不太可能拟合训练数据中的噪声。
随机森林分类中需要调优的关键超参数有哪些?
随机森林的关键超参数包括:树的数量、每棵树的最大深度、分裂节点所需的最小样本数,以及每次分裂时考虑的特征数量。
使用随机森林分类有哪些优势?
随机森林分类具有抗过拟合、在大型数据集上表现良好、可同时处理数值与分类型特征,并且相比神经网络等算法对超参数调优不那么敏感等优点。
本教程讲解如何在 Python 中使用随机森林算法进行分类。您将学习:
为充分理解本文,您应具备 Python、pandas 和 scikit-learn 的基础知识。了解决策树如何用于分类也会有所帮助,建议先阅读我们的Python 决策树分类教程。如果您刚开始使用 scikit-learn,请查看Kaggle 教程:您的第一个机器学习模型。
随机森林既可用于分类也可用于回归,但本文将重点构建分类模型。若想更轻松地实验本文代码,请访问配套的 DataLab 工作簿。最后,您还可以试试我们的 Python 模型验证课程,在其中使用
tic_tac_toe数据集练习随机森林分类。什么是随机森林?
随机森林是一种流行的监督式机器学习算法,既能处理回归任务,也能处理分类任务。其主要特征包括: