
Our biggest-ever sale. 60% off AI & data skills
Buy Now
在线运行和编辑此教程中的代码
运行代码如果您想在 Python 方面学到更多,欢迎参加 DataCamp 的免费课程 Intro to Python for Data Science。
您一定见过各种数据集。有时它们很小,但很多时候却大得惊人。处理如此庞大的数据集会变得非常具有挑战性,至少足以造成处理瓶颈。
那么,是什么让这些数据集变得如此庞大?答案是特征。特征数量越多,数据集通常越大。当然,也不总是如此。您会发现有些数据集特征很多,但实例并不多。不过这不是我们在此讨论的重点。您可能会想,用一台普通电脑,如何不绕弯子地处理这类数据集?
在高维数据集中,往往存在一些完全无关、无足轻重、不重要的特征。实践表明,与关键特征相比,这类特征对预测建模的贡献通常更小,甚至可能完全没有贡献。这些特征会引发一系列问题,从而阻碍高效的预测建模过程——
那么,解决方案是什么?最经济的方案是特征选择。
特征选择是从给定数据集中挑选出最重要特征的过程。在许多情况下,特征选择也可以提升机器学习模型的性能。
听起来很有意思,对吧?
您已经对特征选择及其在数据科学和机器学习领域的重要性有了一个非正式的认识。本文将涵盖:
特征选择也被称为变量选择或属性选择。
本质上,它是从数据集中挑选出最重要/最相关特征的过程。
当您处理包含大量特征的数据集时,特征选择的重要性最为明显。这类数据集通常被称为高维数据集。高维性会带来许多问题,例如:显著增加机器学习模型的训练时间,使模型过于复杂,进而可能导致过拟合。
在高维特征集中,常常存在若干冗余特征,即这些特征只是其他关键特征的延伸。这些冗余特征对模型训练也没有有效贡献。因此,显然需要为数据集提取最重要、最相关的特征,以获得最有效的预测建模性能。
“变量选择的目标有三点:提升预测器的预测性能、提供更快且更具成本效益的预测器,以及更好地理解生成数据的底层过程。”
-An Introduction to Variable and Feature Selection
现在来理解一下降维与特征选择之间的区别。
有时,特征选择会被误认为是降维,但它们并不相同。两者都旨在减少数据集中的属性数量,但降维方法通过创建新的属性组合(有时称为特征变换)来实现,而特征选择方法则是在不改变属性本身的情况下对其进行取舍。
一些降维方法的例子包括主成分分析(PCA)、奇异值分解(SVD)、线性判别分析(LDA)等。
让我来为您总结一下特征选择的重要性:
在下一节中,您将学习通用的不同类型特征选择方法——过滤法(Filter)、包裹法(Wrapper)和嵌入法(Embedded)。
下面这张图最能描述基于过滤的特征选择方法:

图片来源:Analytics Vidhya
过滤法依赖于要评估数据的总体独特性来挑选特征子集,不包含任何挖掘算法。过滤法使用同一套评估标准,包括距离、信息、依赖性和一致性。过滤法采用排序技术的主要准则,并使用排序的方法进行变量选择。采用排序法的原因在于其简单且能产出优秀且相关的特征。排序法会在分类过程开始之前过滤掉无关特征。
过滤法通常用作数据预处理步骤。特征的选择独立于任何机器学习算法。特征会基于统计得分进行排序,这些得分用于判断特征与结果变量的相关性。相关性是一个强上下文概念,会因任务而异。您可以参考下表来界定不同类型数据(此处为连续型与分类型)的相关系数。
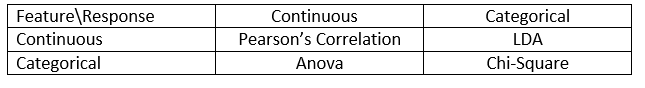
图片来源:Analytics Vidhya
一些过滤法的示例包括卡方检验(Chi-squared)、信息增益以及相关系数得分。
接下来,您将看到包裹法。
与过滤法类似,我也给您一张信息图来帮助更好地理解包裹法:
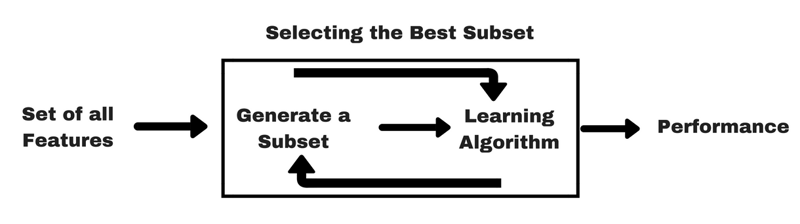
图片来源:Analytics Vidhya
如上图所示,包裹法需要一个机器学习算法,并以其性能作为评估标准。该方法会搜索最适合该机器学习算法的特征,旨在提升挖掘性能。对于分类任务,使用预测准确率来评估特征;对于聚类任务,使用聚类效果(goodness of cluster)来评估。
一些典型的包裹法包括前向特征选择、后向特征消除、递归特征消除等。
够清楚了!
现在来学习嵌入法。
嵌入法是迭代式的,会关注模型训练过程的每一次迭代,并仔细提取对该次迭代训练贡献最大的特征。正则化方法是最常用的嵌入法,它会在系数阈值的约束下对特征进行惩罚。
因此,正则化方法也被称为惩罚法,它们在预测算法(如回归算法)的优化中引入额外约束,从而将模型偏向较低复杂度(更少系数)。
常见的正则化算法包括LASSO、Elastic Net、岭回归(Ridge Regression)等。
有时在功能层面区分过滤法与包裹法会令人困惑。来看它们的不同点。
到目前为止,您已经学习了特征选择的重要性,并理解了它与降维的区别。您也了解了多种特征选择方法。很好!
现在,让我们看看在执行特征选择时您可能踩到的一些坑:
您或许已经理解了特征选择在机器学习流水线中的价值以及其集成后所提供的能力。但非常重要的是,明确应当在流水线的哪个环节集成特征选择。
简单来说,尤其当您使用诸如交叉验证等准确率估计方法时,应该在将数据送入模型训练之前加入特征选择步骤。这可以确保特征选择在模型训练之前直接在该折的数据上执行。但如果您先在全量数据上进行特征选择来准备数据,再在所选特征上进行模型选择与训练,那就会出大问题。
如果您对全部数据执行特征选择后再做交叉验证,那么交叉验证每一折中的测试数据也被用于选择特征,这会使您的机器学习模型性能产生偏倚。
理论讲得够多了!现在直接上代码。
在本案例中,您将使用 Pima Indians Diabetes 数据集。数据集说明见此处。
该数据集对应一个分类任务,您需要基于 8 个特征预测一个人是否患有糖尿病。
数据集中共有 768 条观测。首先要加载数据,以便继续。但在此之前先导入必要的依赖,后续需要时再补充其他依赖。
import pandas as pd
import numpy as np
依赖导入完成后,使用 Pandas 库将 Pima Indians 数据集加载到一个 DataFrame 对象中。
data = pd.read_csv("diabetes.csv")
数据集已成功加载到 DataFrame 对象 data 中。现在来看一下数据。
data.head()
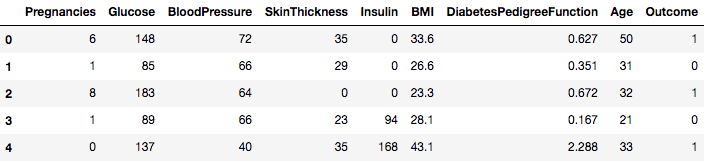
您可以看到有 8 个不同的特征,对应的标签为 1 和 0,其中 1 表示该观测患有糖尿病,0 表示未患病。该数据集已知存在缺失值。具体来说,一些列的缺失观测被标记为零值。根据这些列的定义即可推断,某些指标取 0 不合理,例如体重指数或血压为 0 是无效的。
但在本教程中,您将直接使用该数据集的预处理版本。
# load data
url = "https://raw.githubusercontent.com/jbrownlee/Datasets/master/pima-indians-diabetes.data.csv"
names = ['preg', 'plas', 'pres', 'skin', 'test', 'mass', 'pedi', 'age', 'class']
dataframe = pd.read_csv(url, names=names)
现在,您已将数据加载到名为 dataframe 的 DataFrame 对象中。
将 DataFrame 对象转换为 NumPy 数组以获得更快的计算速度。同时,将数据拆分到不同变量中,使特征与标签分开。
array = dataframe.values
X = array[:,0:8]
Y = array[:,8]
很好!数据已准备就绪。
首先,您将对非负特征实施卡方(Chi-Squared)统计检验,从数据集中选择 4 个最佳特征。您已经知道卡方检验属于过滤法。如果有人想了解卡方检验的内部机制,这段视频讲解得非常出色。
scikit-learn 提供了 SelectKBest 类,可与一系列不同的统计检验一起使用来选择特定数量的特征,此处我们使用卡方检验。
# Import the necessary libraries first
from sklearn.feature_selection import SelectKBest
from sklearn.feature_selection import chi2
您已导入运行实验所需的库。现在来看看它的实际效果。
# Feature extraction
test = SelectKBest(score_func=chi2, k=4)
fit = test.fit(X, Y)
# Summarize scores
np.set_printoptions(precision=3)
print(fit.scores_)
features = fit.transform(X)
# Summarize selected features
print(features[0:5,:])
[ 111.52 1411.887 17.605 53.108 2175.565 127.669 5.393 181.304]
[[148. 0. 33.6 50. ]
[ 85. 0. 26.6 31. ]
[183. 0. 23.3 32. ]
[ 89. 94. 28.1 21. ]
[137. 168. 43.1 33. ]]
您可以看到每个属性的得分,以及被选中的 4 个属性(得分最高的):plas、test、mass 和 age。这些得分将帮助您进一步确定用于训练模型的最佳特征。
附注:第一行表示特征名称。为方便数据预处理,名称已被数值编码。
接下来,您将实现递归特征消除(RFE),这是一种包裹式特征选择方法。
递归特征消除(RFE)的工作原理是递归地移除属性,并在剩余属性上构建模型。
它利用模型的准确率来识别哪些属性(及其组合)对预测目标属性贡献最大。
您可以在scikit-learn 文档中了解更多关于 RFE 类的信息。
# Import your necessary dependencies
from sklearn.feature_selection import RFE
from sklearn.linear_model import LogisticRegression
您将把 RFE 与 Logistic Regression 分类器结合使用来选择排名前 3 的特征。算法的选择并不那么重要,只要其具备足够的能力且表现稳定即可。
# Feature extraction
model = LogisticRegression()
rfe = RFE(model, 3)
fit = rfe.fit(X, Y)
print("Num Features: %s" % (fit.n_features_))
print("Selected Features: %s" % (fit.support_))
print("Feature Ranking: %s" % (fit.ranking_))
Num Features: 3
Selected Features: [ True False False False False True True False]
Feature Ranking: [1 2 3 5 6 1 1 4]
您可以看到,RFE 选择的前三个特征是 preg、mass 和 pedi。
在 support 数组中它们被标记为 True,在 ranking 数组中被标记为“1”。这反映了这些特征的强度。
接下来,您将使用岭回归,它本质上是一种正则化技术,同时也是嵌入式的特征选择技术。
这篇文章对岭回归进行了精彩的讲解,值得一读。
# First things first
from sklearn.linear_model import Ridge
接下来,您将使用岭回归来确定系数并计算 R2。
另请参阅 scikit-learn 官方的岭回归文档。
ridge = Ridge(alpha=1.0)
ridge.fit(X,Y)
Ridge(alpha=1.0, copy_X=True, fit_intercept=True, max_iter=None,
normalize=False, random_state=None, solver='auto', tol=0.001)
为更好地理解岭回归的结果,您将实现一个小工具函数,帮助更友好地打印结果,便于解读。
# A helper method for pretty-printing the coefficients
def pretty_print_coefs(coefs, names = None, sort = False):
if names == None:
names = ["X%s" % x for x in range(len(coefs))]
lst = zip(coefs, names)
if sort:
lst = sorted(lst, key = lambda x:-np.abs(x[0]))
return " + ".join("%s * %s" % (round(coef, 3), name)
for coef, name in lst)
接着,您将把岭回归模型的系数项传给这个小函数,看看会发生什么。
print ("Ridge model:", pretty_print_coefs(ridge.coef_))
Ridge model: 0.021 * X0 + 0.006 * X1 + -0.002 * X2 + 0.0 * X3 + -0.0 * X4 + 0.013 * X5 + 0.145 * X6 + 0.003 * X7
您可以看到所有系数项与特征变量的对应关系。这同样能帮助您选择最关键的特征。应用岭回归时应牢记以下几点:
至此,案例研究部分告一段落。上述方法将帮助您更全面地理解某个数据集的特征。让我再给出一些关于这些技术的要点:
在本文中,您学习了一个研究非常充分的统计主题——特征选择。您也熟悉了它的不同变体,并用它们来识别数据集中哪些特征是重要的。
您可以更进一步,将某种相关性度量并入包裹法,看看效果如何。在此过程中,您可能会创建出自己的特征选择机制。这正是为您自己的小研究打基础的方式。研究人员也在使用各种软计算原理来进行特征选择。这本身就是一个完整的研究领域。此外,您还应在不同数据集上尝试现有的特征选择算法,并得出自己的结论。
这个问题很自然。确实存在一些神经网络架构(例如 CNN)能够从数据中提取最重要的特征,但它们也有局限。对于没有特定性质的常规表格数据(不像图像那样具有平移性质、边缘、位置属性、轮廓等),使用 CNN 并非明智之举。而且当您的数据与资源有限时,在常规表格数据上训练 CNN 可能完全是浪费。所以在这类情况下,本文介绍的方法绝对能派上用场。
如果您想要更深入地研究这个主题,以下资源可能会有所帮助:
以下是撰写本教程时参考的资料。
如果您有任何疑问,欢迎在评论区留言!

