Stability AI 于 2024 年 2 月宣布了 Stable Diffusion 3 的早期预览。该 AI 模型仍处于预览阶段,但在 2024 年 4 月,团队宣布在与 Fireworks AI(目前市场上速度最快、可靠性最高的 API 平台)合作后,将在 Stability AI 的 开发者平台 API 上提供 Stable Diffusion 3 和 Stable Diffusion 3 Turbo。
请注意,Stable Diffusion 3 只是一系列文本到图像的生成式 AI 模型。根据 Stability AI 团队的说法,该模型在“排版与提示遵从性”方面“相当于或优于”其他文本到图像生成器,例如 OpenAI 的 DALL-E 3 和 Midjourney v6。
在本教程中,您将学习开始使用该 API 的实用步骤,从而开始生成您自己的图像。
为何选择 Stable Diffusion 3?
Stable Diffusion 3 引入了多项改进与新特性,使其有别于前代产品,并在文本到图像生成领域极具竞争力——尤其体现在更好的文本生成与提示跟随能力上。
让我们来逐一了解这些改进:
更强的提示跟随能力
- 上下文理解:Stable Diffusion 3 融合了最先进的自然语言处理(NLP)技术,能够更好地理解并解释用户提示。这使其对用户输入的响应更准确、更契合上下文。
- 提示延续性:与先前版本不同,Stable Diffusion 3 在持续跟随提示方面表现更佳,可确保生成的文本在对话过程中始终连贯且与用户输入保持一致。
改进的文本生成
- 精调语言模型:Stable Diffusion 3 采用经过大规模数据集充分训练的精调语言模型,提升了文本生成能力。这些模型对语法、句法和语义的理解更深入,从而生成更连贯、更自然的响应。
- 降低响应波动:通过改进的训练方法与模型架构,Stable Diffusion 3 降低了响应的可变性,在不同提示与情境下都能输出更一致、更高质量的结果。
高级提示扩展
- 多轮对话支持:Stable Diffusion 3 更有效地处理多轮对话,能够在用户与 AI 模型的多次交互中保持连贯性与上下文一致。
- 提示扩展技术:该模型采用先进的提示扩展技术,生成更具信息量、与上下文更相关的响应,丰富对话内容,为用户的问题提供更全面的答案。
精细的可控机制
- 参数调节:Stable Diffusion 3 提供精细的控制机制,允许用户调节响应长度、创造性水平和主题相关性等参数,从而实现更为定制化的交互体验。
- 偏见缓解:模型在文本生成中纳入了缓解偏见的措施,以促进对用户提示做出更公平、更具包容性的响应。
开始使用 Stable Diffusion 3 API
本节将带您完成启动 Stability API 的步骤。
步骤 1:创建账户。在使用 Stability AI 的 API 之前,您需要先创建账户。您可以使用用户名和密码注册,但使用 Google 账户的新用户可获赠 25 个免费点数。
步骤 2:领取您的 API 密钥。创建账户后,您需要获取一个 API 密钥。可在 API Keys 页面找到。在其文档中,Stability AI 指出:“本站记录的所有 API 都使用相同的认证机制:通过 Authorization 头传递 API 密钥。”
步骤 3:充值点数。调用 API 需要点数。点数是调用 API 时消耗的计量单位——不同模型与模态的消耗量各不相同。用完点数后,您可在 Billing 控制台以每 100 点数 1 美元的价格购买更多点数。
在本教程中,我们将使用 Google Colab 和 ComfyUI 演示如何通过 Stable Diffusion 3 API 生成图像。下一节我们将分别介绍两种工具的上手步骤。
在 Google Colab 中使用 Stable Diffusion 3 API
要开始使用 Google Colab,您需要创建一个Google 账户——点击链接并按指引完成。
如果您已拥有 Google 账户,请新建一个 Notebook,并按照以下步骤进行。
注意:此示例使用的代码来自 Stability AI 的 SD3_API 教程。
步骤 1:安装依赖。
from io import BytesIO
import IPython
import json
import os
from PIL import Image
import requests
import time
from google.colab import output技术支持
步骤 2:连接到 Stability API。
import getpass
STABILITY_KEY = getpass.getpass('Enter your API Key')技术支持
步骤 3:定义函数
def send_generation_request(
host,
params,
):
headers = {
"Accept": "image/*",
"Authorization": f"Bearer {STABILITY_KEY}"
}
files = {}
image = params.pop("image", None)
mask = params.pop("mask", None)
if image is not None and image != '':
files["image"] = open(image, 'rb')
if mask is not None and mask != '':
files["mask"] = open(mask, 'rb')
if len(files)==0:
files["none"] = ''
print(f"Sending REST request to {host}...")
response = requests.post(
host,
headers=headers,
files=files,
data=params
)
if not response.ok:
raise Exception(f"HTTP {response.status_code}: {response.text}")
return response技术支持
步骤 4:生成图像。
根据文档说明,Stable Image 服务目前只有一个已在生产环境中的产品:
- SD3:消耗 6.5 点数
- SD3 Turbo:消耗 4 点数
我们来试试它们。
在此示例中,我们将创建一张在低地热带地区的巨嘴鸟的图像。
prompt = "This dreamlike digital art captures a vibrant, Toucan bird in a lowland tropic area"
negative_prompt = ""
aspect_ratio = "1:1"
seed = 0
output_format = "jpeg"
host = f"https://api.stability.ai/v2beta/stable-image/generate/sd3"
params = {
"prompt" : prompt,
"negative_prompt" : negative_prompt,
"aspect_ratio" : aspect_ratio,
"seed" : seed,
"output_format" : output_format,
"model" : "sd3",
"mode" : "text-to-image"
}
response = send_generation_request(
host,
params
)
output_image = response.content
finish_reason = response.headers.get("finish-reason")
seed = response.headers.get("seed")
if finish_reason == 'CONTENT_FILTERED':
raise Warning("Generation failed NSFW classifier")
generated = f"generated_{seed}.{output_format}"
with open(generated, "wb") as f:
f.write(output_image)
print(f"Saved image {generated}")
output.no_vertical_scroll()
print("Result image:")
IPython.display.display(Image.open(generated))技术支持
它生成的效果如下:
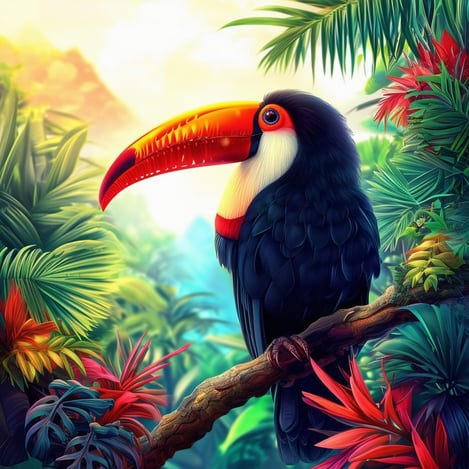
作者使用 Stable Diffusion 3 生成的图像
现在,我们使用 SD3 Turbo 创建一张由水果组成的汽车的图像:
prompt = "A car made out of fruits."
aspect_ratio = "1:1"
seed = 0
output_format = "jpeg"
host = f"https://api.stability.ai/v2beta/stable-image/generate/sd3"
params = {
"prompt" : prompt,
"aspect_ratio" : aspect_ratio,
"seed" : seed,
"output_format" : output_format,
"model" : "sd3-turbo"
}
response = send_generation_request(
host,
params
)
output_image = response.content
finish_reason = response.headers.get("finish-reason")
seed = response.headers.get("seed")
if finish_reason == 'CONTENT_FILTERED':
raise Warning("Generation failed NSFW classifier")
generated = f"generated_{seed}.{output_format}"
with open(generated, "wb") as f:
f.write(output_image)
print(f"Saved image {generated}")
output.no_vertical_scroll()
print("Result image:")
IPython.display.display(Image.open(generated))技术支持
运行上述代码后得到如下图像:
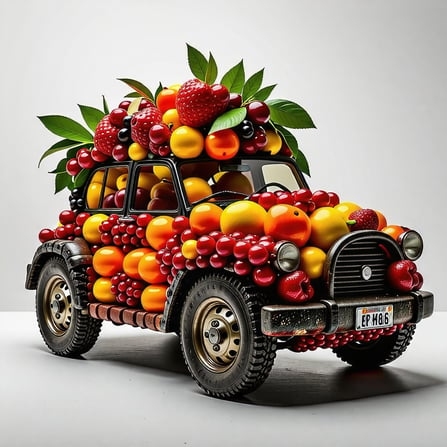
作者使用 Stable Diffusion 3 Turbo 生成的图像
在 ComfyUI 中使用该 API
ComfyUI 是一款稳健且灵活的 Stable Diffusion 图形用户界面(GUI)。它采用基于图的界面与流程图式设计,使用户能够创建并运行复杂的 Stable Diffusion 工作流。
系统要求:
- 图形处理器(GPU):合适的 NVIDIA GPU,至少 8GB 显存,例如 RTX 3060 Ti 或更高型号。
- 中央处理器(CPU):现代处理器,包括 Intel Xeon E5、i5、Ryzen 5 或更高。
- 随机存取存储器(RAM):16GB 或以上。
- 操作系统:Windows 10/11 或 Linux。
- 计算机需有足够的存储空间用于模型与生成的图像。
步骤 1:安装 ComfyUI
在 Windows 上安装 ComfyUI 的最简单方式是使用发布页中的独立安装包。该安装包包含 PyTorch 和 Hugging Face Transformers 等必要依赖,无需单独安装。
它提供了完整的一体化包,可快速在 Windows 上完成 ComfyUI 的部署,无需复杂配置。
只需下载、解压、添加模型并启动即可!
步骤 1.1:从此 GitHub 仓库下载 ComfyUI 的独立版本——点击链接即会开始下载。
步骤 1.2:下载最新的 comfyui-windows.zip 文件后,使用 7-Zip 或 WinRAR 等工具进行解压。
步骤 1.3:开始使用 ComfyUI 需要一个 checkpoint 模型。您可以从 Stable Diffusion 或 Hugging Face 下载 checkpoint 模型。将模型放入以下文件夹:
ComfyUI_windows_portable\ComfyUI\models\checkpoints技术支持
步骤 1.4:现在,运行 run_nvidia_gpu.bat(推荐)或 run_cpu.bat。ComfyUI 应会自动在您的浏览器中启动。
命令行会执行并生成一个 URL http://127.0.0.1:8188/,您可以在浏览器中打开它。
步骤 2:安装 ComfyUI Manager
在文件资源管理器中,找到您刚安装的目录。若您使用的是 Windows,它应命名为“ComfyUI_windows_portable.”随后进入 ComfyUI,再进入 custom_nodes。在该位置的地址栏中输入 cmd 并回车。
这将打开命令提示符终端,您需要输入以下命令:
git clone https://github.com/ltdrdata/ComfyUI-Manager技术支持
完成后,重启 ComfyUI。浮动面板上应出现新的“Manager”按钮。
步骤 3:安装 Stability AI API 节点
点击 Manage 按钮并进入“Install Custom Nodes”。在此处搜索“stability API”。
找到 “Stability API nodes for ComfyUI” 节点,然后点击右侧的 Install 按钮开始安装。随后会出现“Restart”按钮。点击“Restart”重启 ComfyUI。
步骤 4:设置系统范围的 API 密钥
此步骤为可选,但推荐执行。即:您可以在 Stability AI 自定义节点中为每个节点设置 Stability AI 的 API 密钥。这样可避免在每个工作流中反复输入密钥,并减少在分享工作流 JSON 文件时不慎泄露密钥的风险。
操作方法是,转到自定义节点目录:
ComfyUI_windows_portable > ComfyUI > custom_nodes > ComfyUI-SAI_API. 技术支持
创建一个名为 sai_platform_key.txt 的新文件。将您的API 密钥粘贴到文件中,保存后重启 ComfyUI。
步骤 5:加载并运行工作流
安装 Stable Diffusion 3 文生图工作流,并将其拖入 ComfyUI。
现在您就可以开始了!
故障排除与提示
与任何工具一样,您在使用过程中可能会遇到一些问题。以下是用户在使用 API 或完成设置流程时最常见的挑战及其排查步骤。
API 密钥与认证问题
问题:由于 API 密钥错误或认证凭据不正确,用户在访问 API 时可能会遇到认证错误。
排查:请仔细核对 API 密钥并确保正确复制粘贴。确认密钥中没有多余的空格或字符。确保 API 密钥已被 Stable Diffusion 3 服务器正确认证。
点数管理问题
问题:用户可能会遇到点数不足或账单错误等与点数管理相关的问题。
排查:在 Stable Diffusion 3 仪表板中检查您的点数余额,确保点数充足。核对账单信息,并就任何账单错误或差异与支持团队联系。
连接与网络问题
问题:用户可能会遇到连接问题或网络中断,导致无法访问 API。
排查:确保您的网络连接稳定且无中断。为定位问题,尝试在不同网络或设备上访问 API。若持续出现连接问题,请联系您的互联网服务提供商。
兼容性与依赖错误
问题:在安装或使用所需工具与库时,用户可能会遇到兼容性或依赖错误。
排查:检查 Stable Diffusion 3 API 的兼容性要求,确保您使用的工具与库版本兼容。更新或重装导致错误的依赖。请参考文档与社区论坛获取排障指引。
性能与响应时间
问题:在与 API 交互时,尤其在高峰期,用户可能会遇到响应缓慢或性能问题。
排查:监控 API 的性能并跟踪响应时间,以识别模式或趋势。考虑升级至更高等级订阅以获得更佳性能与优先访问。若持续出现响应缓慢,请联系支持团队。
文档与支持
问题:用户可能难以理解 API 文档,或在排查特定问题时需要帮助。
排查:有关 API 用法、故障排除和最佳实践,请参阅 Stable Diffusion 3 的文档。若仍有未解决的问题或疑问,请联系支持团队或社区论坛。
结论
Stable Diffusion 3 是一系列文本到图像的生成式 AI 模型。本文介绍了在 Google Colab 和 ComfyUI 中开始使用该 API 的实用步骤。现在,您已经具备创建自有图像的能力;请尽快实践所学内容,以免遗忘。
感谢您的阅读!
进一步学习


Stability AI 于 2024 年 2 月宣布了 Stable Diffusion 3 的早期预览。该 AI 模型仍处于预览阶段,但在 2024 年 4 月,团队宣布在与 Fireworks AI(目前市场上速度最快、可靠性最高的 API 平台)合作后,将在 Stability AI 的 开发者平台 API 上提供 Stable Diffusion 3 和 Stable Diffusion 3 Turbo。
请注意,Stable Diffusion 3 只是一系列文本到图像的生成式 AI 模型。根据 Stability AI 团队的说法,该模型在“排版与提示遵从性”方面“相当于或优于”其他文本到图像生成器,例如 OpenAI 的 DALL-E 3 和 Midjourney v6。
在本教程中,您将学习开始使用该 API 的实用步骤,从而开始生成您自己的图像。
为何选择 Stable Diffusion 3?
Stable Diffusion 3 引入了多项改进与新特性,使其有别于前代产品,并在文本到图像生成领域极具竞争力——尤其体现在更好的文本生成与提示跟随能力上。
让我们来逐一了解这些改进:
更强的提示跟随能力
改进的文本生成
高级提示扩展
精细的可控机制
开始使用 Stable Diffusion 3 API
本节将带您完成启动 Stability API 的步骤。
步骤 1:创建账户。在使用 Stability AI 的 API 之前,您需要先创建账户。您可以使用用户名和密码注册,但使用 Google 账户的新用户可获赠 25 个免费点数。
步骤 2:领取您的 API 密钥。创建账户后,您需要获取一个 API 密钥。可在 API Keys 页面找到。在其文档中,Stability AI 指出:“本站记录的所有 API 都使用相同的认证机制:通过 Authorization 头传递 API 密钥。”
步骤 3:充值点数。调用 API 需要点数。点数是调用 API 时消耗的计量单位——不同模型与模态的消耗量各不相同。用完点数后,您可在 Billing 控制台以每 100 点数 1 美元的价格购买更多点数。
在本教程中,我们将使用 Google Colab 和 ComfyUI 演示如何通过 Stable Diffusion 3 API 生成图像。下一节我们将分别介绍两种工具的上手步骤。
在 Google Colab 中使用 Stable Diffusion 3 API
要开始使用 Google Colab,您需要创建一个Google 账户——点击链接并按指引完成。
如果您已拥有 Google 账户,请新建一个 Notebook,并按照以下步骤进行。
注意:此示例使用的代码来自 Stability AI 的 SD3_API 教程。
步骤 1:安装依赖。
步骤 2:连接到 Stability API。
步骤 3:定义函数
步骤 4:生成图像。
根据文档说明,Stable Image 服务目前只有一个已在生产环境中的产品:
我们来试试它们。
在此示例中,我们将创建一张在低地热带地区的巨嘴鸟的图像。
它生成的效果如下:
作者使用 Stable Diffusion 3 生成的图像
现在,我们使用 SD3 Turbo 创建一张由水果组成的汽车的图像:
运行上述代码后得到如下图像:
作者使用 Stable Diffusion 3 Turbo 生成的图像
在 ComfyUI 中使用该 API
ComfyUI 是一款稳健且灵活的 Stable Diffusion 图形用户界面(GUI)。它采用基于图的界面与流程图式设计,使用户能够创建并运行复杂的 Stable Diffusion 工作流。
系统要求:
步骤 1:安装 ComfyUI
在 Windows 上安装 ComfyUI 的最简单方式是使用发布页中的独立安装包。该安装包包含 PyTorch 和 Hugging Face Transformers 等必要依赖,无需单独安装。
它提供了完整的一体化包,可快速在 Windows 上完成 ComfyUI 的部署,无需复杂配置。
只需下载、解压、添加模型并启动即可!
步骤 1.1:从此 GitHub 仓库下载 ComfyUI 的独立版本——点击链接即会开始下载。
步骤 1.2:下载最新的 comfyui-windows.zip 文件后,使用 7-Zip 或 WinRAR 等工具进行解压。
步骤 1.3:开始使用 ComfyUI 需要一个 checkpoint 模型。您可以从 Stable Diffusion 或 Hugging Face 下载 checkpoint 模型。将模型放入以下文件夹:
步骤 1.4:现在,运行 run_nvidia_gpu.bat(推荐)或 run_cpu.bat。ComfyUI 应会自动在您的浏览器中启动。
命令行会执行并生成一个 URL
http://127.0.0.1:8188/,您可以在浏览器中打开它。步骤 2:安装 ComfyUI Manager
在文件资源管理器中,找到您刚安装的目录。若您使用的是 Windows,它应命名为“
ComfyUI_windows_portable.”随后进入ComfyUI,再进入custom_nodes。在该位置的地址栏中输入cmd并回车。这将打开命令提示符终端,您需要输入以下命令:
完成后,重启 ComfyUI。浮动面板上应出现新的“Manager”按钮。
步骤 3:安装 Stability AI API 节点
点击 Manage 按钮并进入“Install Custom Nodes”。在此处搜索“stability API”。
找到 “Stability API nodes for ComfyUI” 节点,然后点击右侧的 Install 按钮开始安装。随后会出现“Restart”按钮。点击“Restart”重启 ComfyUI。
步骤 4:设置系统范围的 API 密钥
此步骤为可选,但推荐执行。即:您可以在 Stability AI 自定义节点中为每个节点设置 Stability AI 的 API 密钥。这样可避免在每个工作流中反复输入密钥,并减少在分享工作流 JSON 文件时不慎泄露密钥的风险。
操作方法是,转到自定义节点目录:
创建一个名为
sai_platform_key.txt的新文件。将您的API 密钥粘贴到文件中,保存后重启 ComfyUI。步骤 5:加载并运行工作流
安装 Stable Diffusion 3 文生图工作流,并将其拖入 ComfyUI。
现在您就可以开始了!
故障排除与提示
与任何工具一样,您在使用过程中可能会遇到一些问题。以下是用户在使用 API 或完成设置流程时最常见的挑战及其排查步骤。
API 密钥与认证问题
问题:由于 API 密钥错误或认证凭据不正确,用户在访问 API 时可能会遇到认证错误。
排查:请仔细核对 API 密钥并确保正确复制粘贴。确认密钥中没有多余的空格或字符。确保 API 密钥已被 Stable Diffusion 3 服务器正确认证。
点数管理问题
问题:用户可能会遇到点数不足或账单错误等与点数管理相关的问题。
排查:在 Stable Diffusion 3 仪表板中检查您的点数余额,确保点数充足。核对账单信息,并就任何账单错误或差异与支持团队联系。
连接与网络问题
问题:用户可能会遇到连接问题或网络中断,导致无法访问 API。
排查:确保您的网络连接稳定且无中断。为定位问题,尝试在不同网络或设备上访问 API。若持续出现连接问题,请联系您的互联网服务提供商。
兼容性与依赖错误
问题:在安装或使用所需工具与库时,用户可能会遇到兼容性或依赖错误。
排查:检查 Stable Diffusion 3 API 的兼容性要求,确保您使用的工具与库版本兼容。更新或重装导致错误的依赖。请参考文档与社区论坛获取排障指引。
性能与响应时间
问题:在与 API 交互时,尤其在高峰期,用户可能会遇到响应缓慢或性能问题。
排查:监控 API 的性能并跟踪响应时间,以识别模式或趋势。考虑升级至更高等级订阅以获得更佳性能与优先访问。若持续出现响应缓慢,请联系支持团队。
文档与支持
问题:用户可能难以理解 API 文档,或在排查特定问题时需要帮助。
排查:有关 API 用法、故障排除和最佳实践,请参阅 Stable Diffusion 3 的文档。若仍有未解决的问题或疑问,请联系支持团队或社区论坛。
结论
Stable Diffusion 3 是一系列文本到图像的生成式 AI 模型。本文介绍了在 Google Colab 和 ComfyUI 中开始使用该 API 的实用步骤。现在,您已经具备创建自有图像的能力;请尽快实践所学内容,以免遗忘。
感谢您的阅读!
进一步学习