Stability AI 宣布推出其文生图生成式 AI 模型 Stable Diffusion 3 的早期预览版。与上周 OpenAI 发布的 Sora 文生视频不同,本次仅有限度地展示了模型的新功能,但披露了一些细节。本文将探讨此次发布意味着什么、新模型的工作原理,以及对图像生成发展的潜在影响。
什么是 Stable Diffusion 3?
Stable Diffusion 是一系列文生图生成式 AI 模型。也就是说,您写下所需图像的提示词,模型就会生成与之匹配的图片。其还提供了网页用户界面,便于使用该 AI。
与 OpenAI 的竞品 DALL·E 不同的一大之处在于它具备“开放权重”。也就是说,支撑模型计算的神经网络细节是公开可得的。这带来一定程度的工作机制透明性,也使研究人员能够在 Stability AI 的工作基础上进行改造与拓展。
Stable Diffusion 3 不是单一模型,而是一个模型家族,规模从 8 亿参数到 80 亿参数不等。参数越多,输出质量通常越高,但副作用是生成图像成本更高、耗时更长。参数较少的版本更适合生成简单图像,参数较多的版本则更适合生成更高质量或更复杂的图像。
Stable Diffusion 3 的工作原理是什么?
Stable Diffusion 3 采用与 Sora 类似的扩散-Transformer 架构。此前版本的 Stable Diffusion——以及目前大多数图像生成 AI——使用的是扩散模型。用于文本生成的大型语言模型(如 GPT)采用的是 Transformer 架构。能够将两者结合是近期的创新,有望兼具两种架构的优势。
扩散模型擅长在小区域内创造细节,但不擅长生成图像的整体布局;相反,Transformer 擅长布局,但在细节生成上表现一般。因此,Stable Diffusion 很可能先用 Transformer 规划整体画面,再用扩散器生成各个图块。
这意味着我们可以期待 Stable Diffusion 3 在组织复杂场景方面比前代表现更好。
公告还提到 Stable Diffusion 3 使用了一种名为 flow matching 的技术。与当前的扩散路径技术相比,它是一种在训练模型以及由模型生成图像时更具计算效率的方法。这意味着训练该 AI 的成本更低,用该 AI 生成图像的成本也更低,从而总体降低了使用成本。
Stable Diffusion 3 有哪些局限?
当前图像生成 AI 的一个局限是生成文本的能力。值得注意的是,Stability AI 的公告开头配图就包含了模型名称“Stable Diffusion 3”。其中的文字字母位置较好但并不完美:例如,Stable 一词中 “B” 与 “L” 之间的间距比 “L” 与 “E” 之间更宽。类似地,Diffusion 一词中的两个 “F” 靠得过近。不过,总体而言,这较上一代模型已有明显改进。
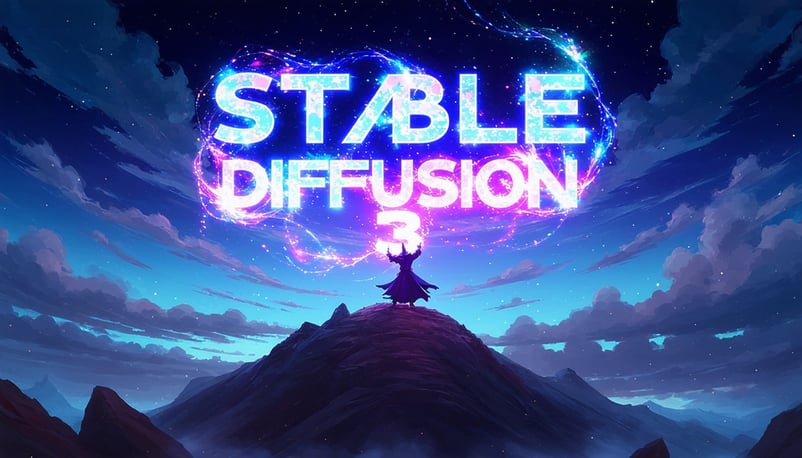
提示词:在夜晚山峰之巅的法师施展宇宙魔法,黑暗天空中显现“Stable Diffusion 3”字样的史诗级动漫画作,由五彩能量构成
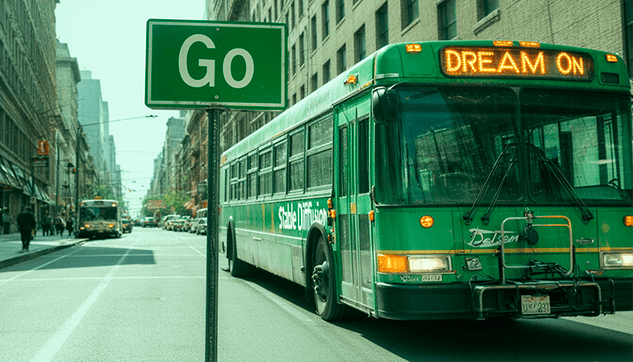
模型的另一个问题是,由于扩散器会分别生成图像的各个图块,图像不同区域之间可能出现不一致。这在尝试生成逼真图像时尤为明显。公告没有包含太多写实示例,但一张城市街道上巴士的图片就暴露了几处此类问题。注意,巴士底部的阴影暗示光源来自巴士后方,而街道上建筑投下的阴影却指示光源来自图像左侧。类似地,图像右上方建筑的窗户在不同区域的排布也略有不一致。巴士也没有司机,不过这也许可以通过更精细的提示词来修正。
如何访问 Stable Diffusion 3?
Stable Diffusion 3 目前处于“早期预览”阶段。这意味着它仅向研究人员开放用于测试。预览阶段旨在让 Stability AI 在公开发布前收集关于模型性能与安全性的反馈。
您可以在此处加入等待名单以获取访问权限。
Stable Diffusion 3 的使用场景有哪些?
图像生成 AI 已经在插图、平面设计和营销物料等领域有了众多用例。Stable Diffusion 预计也可用于这些场景,并有望在生成更复杂布局的图像方面具备优势。
Stable Diffusion 3 的风险是什么?
用于训练 Stable Diffusion 的数据集中包含了一些受版权保护的图像,已引发了数起尚未解决的诉讼。这些诉讼的结果尚不明确,但从理论上讲,任何由 Stable Diffusion 生成的图像也可能被视为侵犯版权。
我们尚未知晓的有哪些?
Stable Diffusion 3 的完整技术细节尚未公布,尤其是目前无法测试该 AI 的性能。一旦模型公开可用并建立起基准测试,就能确定它相较前代有多大提升。生成图像所需的时间与成本等因素也将随之明朗。
OpenAI 在其 DALL·E 3 论文中大力倡导的一项技术进展——但在 Stability AI 的公告中未被提及——是“重述标注(recaptioning)”。这是一种自动化提示词工程:将用户撰写的文本重组并补充细节,以向模型提供更清晰的指令。目前尚不清楚 Stable Diffusion 3 是否采用了该技术。
结语
Stable Diffusion 3 有望成为文生图生成式 AI 进程中的又一进步。待其公开发布后,我们将能够进一步测试并发掘新的用例。若您急于开启生成式 AI 之旅,我们的AI 基础技能路径将帮助您快速掌握机器学习、深度学习、NLP、生成式模型等核心内容。
如需获取更多有关 AI 最新动态的资源,请查看下方列表:
Stability AI 宣布推出其文生图生成式 AI 模型 Stable Diffusion 3 的早期预览版。与上周 OpenAI 发布的 Sora 文生视频不同,本次仅有限度地展示了模型的新功能,但披露了一些细节。本文将探讨此次发布意味着什么、新模型的工作原理,以及对图像生成发展的潜在影响。
什么是 Stable Diffusion 3?
Stable Diffusion 是一系列文生图生成式 AI 模型。也就是说,您写下所需图像的提示词,模型就会生成与之匹配的图片。其还提供了网页用户界面,便于使用该 AI。
与 OpenAI 的竞品 DALL·E 不同的一大之处在于它具备“开放权重”。也就是说,支撑模型计算的神经网络细节是公开可得的。这带来一定程度的工作机制透明性,也使研究人员能够在 Stability AI 的工作基础上进行改造与拓展。
Stable Diffusion 3 不是单一模型,而是一个模型家族,规模从 8 亿参数到 80 亿参数不等。参数越多,输出质量通常越高,但副作用是生成图像成本更高、耗时更长。参数较少的版本更适合生成简单图像,参数较多的版本则更适合生成更高质量或更复杂的图像。
Stable Diffusion 3 的工作原理是什么?
Stable Diffusion 3 采用与 Sora 类似的扩散-Transformer 架构。此前版本的 Stable Diffusion——以及目前大多数图像生成 AI——使用的是扩散模型。用于文本生成的大型语言模型(如 GPT)采用的是 Transformer 架构。能够将两者结合是近期的创新,有望兼具两种架构的优势。
扩散模型擅长在小区域内创造细节,但不擅长生成图像的整体布局;相反,Transformer 擅长布局,但在细节生成上表现一般。因此,Stable Diffusion 很可能先用 Transformer 规划整体画面,再用扩散器生成各个图块。
这意味着我们可以期待 Stable Diffusion 3 在组织复杂场景方面比前代表现更好。
公告还提到 Stable Diffusion 3 使用了一种名为 flow matching 的技术。与当前的扩散路径技术相比,它是一种在训练模型以及由模型生成图像时更具计算效率的方法。这意味着训练该 AI 的成本更低,用该 AI 生成图像的成本也更低,从而总体降低了使用成本。
Stable Diffusion 3 有哪些局限?
当前图像生成 AI 的一个局限是生成文本的能力。值得注意的是,Stability AI 的公告开头配图就包含了模型名称“Stable Diffusion 3”。其中的文字字母位置较好但并不完美:例如,Stable 一词中 “B” 与 “L” 之间的间距比 “L” 与 “E” 之间更宽。类似地,Diffusion 一词中的两个 “F” 靠得过近。不过,总体而言,这较上一代模型已有明显改进。
提示词:在夜晚山峰之巅的法师施展宇宙魔法,黑暗天空中显现“Stable Diffusion 3”字样的史诗级动漫画作,由五彩能量构成
模型的另一个问题是,由于扩散器会分别生成图像的各个图块,图像不同区域之间可能出现不一致。这在尝试生成逼真图像时尤为明显。公告没有包含太多写实示例,但一张城市街道上巴士的图片就暴露了几处此类问题。注意,巴士底部的阴影暗示光源来自巴士后方,而街道上建筑投下的阴影却指示光源来自图像左侧。类似地,图像右上方建筑的窗户在不同区域的排布也略有不一致。巴士也没有司机,不过这也许可以通过更精细的提示词来修正。
如何访问 Stable Diffusion 3?
Stable Diffusion 3 目前处于“早期预览”阶段。这意味着它仅向研究人员开放用于测试。预览阶段旨在让 Stability AI 在公开发布前收集关于模型性能与安全性的反馈。
您可以在此处加入等待名单以获取访问权限。
Stable Diffusion 3 的使用场景有哪些?
图像生成 AI 已经在插图、平面设计和营销物料等领域有了众多用例。Stable Diffusion 预计也可用于这些场景,并有望在生成更复杂布局的图像方面具备优势。
Stable Diffusion 3 的风险是什么?
用于训练 Stable Diffusion 的数据集中包含了一些受版权保护的图像,已引发了数起尚未解决的诉讼。这些诉讼的结果尚不明确,但从理论上讲,任何由 Stable Diffusion 生成的图像也可能被视为侵犯版权。
我们尚未知晓的有哪些?
Stable Diffusion 3 的完整技术细节尚未公布,尤其是目前无法测试该 AI 的性能。一旦模型公开可用并建立起基准测试,就能确定它相较前代有多大提升。生成图像所需的时间与成本等因素也将随之明朗。
OpenAI 在其 DALL·E 3 论文中大力倡导的一项技术进展——但在 Stability AI 的公告中未被提及——是“重述标注(recaptioning)”。这是一种自动化提示词工程:将用户撰写的文本重组并补充细节,以向模型提供更清晰的指令。目前尚不清楚 Stable Diffusion 3 是否采用了该技术。
结语
Stable Diffusion 3 有望成为文生图生成式 AI 进程中的又一进步。待其公开发布后,我们将能够进一步测试并发掘新的用例。若您急于开启生成式 AI 之旅,我们的AI 基础技能路径将帮助您快速掌握机器学习、深度学习、NLP、生成式模型等核心内容。
如需获取更多有关 AI 最新动态的资源,请查看下方列表: