
课程
Python 网络分析入门
4 小时
74.6K
实践并学习路径你的进步。
使用 Google 继续
通过本教程,您将处理图论中的一个经典问题——中国邮差问题(Chinese Postman Problem)。该算法的一些组成部分在概念上很简单,但在计算上却相当严苛。不过,就本教程而言,您只需具备一些Python的基础知识即可:不需要严格的数学、计算机科学或图论背景。
本教程将首先介绍图的基本构件(节点、边、路径等),并使用 Python 中的 NetworkX 库在一个真实图(州立公园的步道网络)上解决问题。您将专注于核心概念和实现。对于感兴趣的读者,文末还提供了更深入的优化机制阅读材料。
您可能听说过旅行商问题,其目标是找到连接一组节点(比如城市)的最短路线(比如公路)。虽然知名度较低,但中国邮差问题(CPP),也称为路线检查问题或弧路由问题,与之非常相似。CPP 的目标是在图上找到一条至少覆盖所有连接(道路)一次的最短路径。如果能在不重复走同一条路的情况下完成,那就再好不过了;这是理想情形,问题也相对简单。然而,如果某些道路必须走不止一次,您就需要一些数学方法来找出一条以最低总里程覆盖每条道路至少一次的最短路线。
(以下是一段个人说明:略显煽情和打趣,但对学习 Python 中的图优化并非必要)
我在现实中确实有一个应用场景:要获得 Giantmaster Marathoner 的称号。
什么是 Giantmaster?Giantmaster 指在其一生中(犬类或人类皆可)走完了康涅狄格州汉登(靠近我家乡沃灵福德)的 Sleeping Giant 州立公园所有步道的人。而 Giantmaster Marathoner 则是在一天之内走完所有这些步道的人。
感谢 Sleeping Giant Park Association 对记录的严格管理,所有 Giantmaster 及其完成级别的完整名单可在此处找到。我必须承认,这很大程度上激励我启动这个副项目并走上步道奔跑。虽然我本人早在 2006 年冬天,还是 Sleeping Giant Trail Crew 的青年志愿者时就达成了 Giantmaster(并高兴地看到被记录在SG 档案中),但此后又出现了新的挑战。虽然 12 个月和 4 季度的 Giantmaster 分类既令人印象深刻又很诱人,但与我现在的家(华盛顿特区)相比,这也需要我更频繁地往返于我成长的家(康州),超出我能合理安排的范围……而且从图优化角度看也没那么有趣,所以就选 Giantmaster Marathon 吧!
作为另一个参考,下面提供了 Sleeping Giant 的步道地图:
关于图的好处在于其概念和术语通常直观易懂。尽管如此,还是先过一遍一些基本用语:
图是一种刻画对象间关系的结构。在本教程中,这些对象称为节点,它们之间的连接称为边。需要注意的是,边和节点通常也会以其他术语表示,但通常含义相同:
node == vertex == point
edge == arc == link
起始图是无向的。也就是说,边没有方向:它们是双向的。例如:A<--->B == B<--->A。
相比之下,您可能为计算走遍每条步道的最短路径而创建的图会是有向图,其中边的次序和方向很重要。例如:A--->B != B--->A。
该图还是一个加权边图,每对相邻节点之间的距离(英里)代表边的权重。这通过名为“distance”的边属性来处理。
度是指与某个节点关联(接触)的边的数量。当该数为奇数时,该节点称为奇度节点,为偶数时则为偶度节点。
本次 CPP 问题的解将是一个欧拉回路:存在一个从某一节点出发再回到自身、恰好经过每条边一次且不回溯的环。欧拉回路也有其他称谓:
Eulerian tour == Eulerian circuit == Eulerian cycle
匹配是边的一个子集,其中没有任何节点出现两次。最小权匹配是在所有匹配中,找到边权和尽可能小的那个。
NetworkX 是最流行的 Python 图操作与分析包。还有一些其他包也提供相同层次的图操作能力,尤其是 igraph,它还支持 R 和 C++ 绑定。然而,我发现 NetworkX 提供了解决 CPP 所需的最强大的图算法。
如果您在 Python 中做过任何数据分析或安装了 Anaconda 发行版,我猜您很可能已有 pandas 和 matplotlib。不过,您可能还没有 networkx。它们应该是本教程中唯一需要的、超出 Python 标准库的依赖。使用 pip 安装很简单:
pip install pandas
pip install networkx
pip install matplotlib
目前这应该就是您所需的全部包。在最后用于创建 CPP 解的 GIF 动画时还导入了 imageio 和 numpy。由于动画已嵌入本文,这些包是可选的。
import itertools
import copy
import networkx as nx
import pandas as pd
import matplotlib.pyplot as plt边列表是一种用于创建图的简单数据结构。每一行代表图中的一条边及其一些属性。
# Grab edge list data hosted on Gist
edgelist = pd.read_csv('https://gist.githubusercontent.com/brooksandrew/e570c38bcc72a8d102422f2af836513b/raw/89c76b2563dbc0e88384719a35cba0dfc04cd522/edgelist_sleeping_giant.csv')
# Preview edgelist
edgelist.head(10)
| node1 | node2 | trail | distance | color | estimate | |
|---|---|---|---|---|---|---|
| 0 | rs_end_north | v_rs | rs | 0.30 | red | 0 |
| 1 | v_rs | b_rs | rs | 0.21 | red | 0 |
| 2 | b_rs | g_rs | rs | 0.11 | red | 0 |
| 3 | g_rs | w_rs | rs | 0.18 | red | 0 |
| 4 | w_rs | o_rs | rs | 0.21 | red | 0 |
| 5 | o_rs | y_rs | rs | 0.12 | red | 0 |
| 6 | y_rs | rs_end_south | rs | 0.39 | red | 0 |
| 7 | rc_end_north | v_rc | rc | 0.70 | red | 0 |
| 8 | v_rc | b_rc | rc | 0.04 | red | 0 |
| 9 | b_rc | g_rc | rc | 0.15 | red | 0 |
当已提供边列表时,在 networkx 和其他图库中,通常节点列表是可选的,因为边列表的前两列已包含节点名称。不过在本例中,我们希望添加一些节点属性:节点(步道交叉点)的 X、Y 坐标,便于按照步道地图的布局绘制图。
我花了一个下午,用 GIMP 沿着图像描点手工标注:
创建节点名称也花了一些手工工作。每个节点表示两个或更多步道的交叉处。在可能的情况下,节点命名为 trail1_trail2,其中 trail1 在字母序上位于 trail2 之前。
当相同步道彼此相交多次时,情况会更复杂。例如橙色和白色步道。在这些情况下,我在节点名后附加 _2 或 _3。例如,橙色与白色两次不同的交叉点有两个不同的节点名:o_w 和 o_w_2。
这过程包含大量试错,并将用 X、Y 坐标生成的图与真实步道图进行比较。
# Grab node list data hosted on Gist
nodelist = pd.read_csv('https://gist.githubusercontent.com/brooksandrew/f989e10af17fb4c85b11409fea47895b/raw/a3a8da0fa5b094f1ca9d82e1642b384889ae16e8/nodelist_sleeping_giant.csv')
# Preview nodelist
nodelist.head(5)
| id | X | Y | |
|---|---|---|---|
| 0 | b_bv | 1486 | 732 |
| 1 | b_bw | 716 | 1357 |
| 2 | b_end_east | 3164 | 1111 |
| 3 | b_end_west | 141 | 1938 |
| 4 | b_g | 1725 | 771 |
现在,您可以使用边列表和节点列表在 networkx 中创建一个图对象。
# Create empty graph
g = nx.Graph()
遍历边列表的每一行,并将每条边及其对应属性添加到图 g 中。
# Add edges and edge attributes
for i, elrow in edgelist.iterrows():
    g.add_edge(elrow[0], elrow[1], attr_dict=elrow[2:].to_dict())
为便于理解,让我们打印出刚刚添加到图 g 的边列表最后一行的值:
# Edge list example
print(elrow[0]) # node1
print(elrow[1]) # node2
print(elrow[2:].to_dict()) # edge attribute dict
o_gy2
y_gy2
{'color': 'yellowgreen', 'estimate': 0, 'trail': 'gy2', 'distance': 0.12}
同样地,遍历节点列表的每一行并添加这些节点属性。
# Add node attributes
for i, nlrow in nodelist.iterrows():
    g.node[nlrow['id']] = nlrow[1:].to_dict()
下面是节点列表最后一行的示例:
# Node list example
print(nlrow)
id    y_rt
X      977
Y     1666
Name: 76, dtype: object图中的边用长度为 3 的元组列表表示。前两个元素是由边连接的节点名称。第三个元素是边属性的字典。
# Preview first 5 edges
g.edges(data=True)[0:5]
[('rs_end_south',
  'y_rs',
  {'color': 'red', 'distance': 0.39, 'estimate': 0, 'trail': 'rs'}),
 ('w_gy2',
  'park_east',
  {'color': 'gray', 'distance': 0.12, 'estimate': 0, 'trail': 'w'}),
 ('w_gy2',
  'g_gy2',
  {'color': 'yellowgreen', 'distance': 0.05, 'estimate': 0, 'trail': 'gy2'}),
 ('w_gy2',
  'b_w',
  {'color': 'gray', 'distance': 0.42, 'estimate': 0, 'trail': 'w'}),
 ('w_gy2',
  'b_gy2',
  {'color': 'yellowgreen', 'distance': 0.03, 'estimate': 1, 'trail': 'gy2'})]
同样,节点用长度为 2 的元组列表表示。第一个元素是节点 ID,后面是节点属性的字典。
# Preview first 10 nodes
g.nodes(data=True)[0:10]
[('rs_end_south', {'X': 1865, 'Y': 1598}),
 ('w_gy2', {'X': 2000, 'Y': 954}),
 ('rd_end_south_dupe', {'X': 273, 'Y': 1869}),
 ('w_gy1', {'X': 1184, 'Y': 1445}),
 ('g_rt', {'X': 908, 'Y': 1378}),
 ('v_rd', {'X': 258, 'Y': 1684}),
 ('g_rs', {'X': 1676, 'Y': 775}),
 ('rc_end_north', {'X': 867, 'Y': 618}),
 ('v_end_east', {'X': 2131, 'Y': 921}),
 ('rh_end_south', {'X': 721, 'Y': 1925})]
在可视化图之前,先打印一些汇总统计信息。
print('# of edges: {}'.format(g.number_of_edges()))
print('# of nodes: {}'.format(g.number_of_nodes()))
# of edges: 123
# of nodes: 77位置:首先需要将图中的节点位置转换为一个字典。这样可以用与实际步道地图相同的布局重建图。Y 使用取反以将坐标系的 Y 轴原点从左上角转换为左下角。
# Define node positions data structure (dict) for plotting
node_positions = {node[0]: (node[1]['X'], -node[1]['Y']) for node in g.nodes(data=True)}

# Preview of node_positions with a bit of hack (there is no head/slice method for dictionaries).
dict(list(node_positions.items())[0:5])
{'b_rd': (268, -1744),
 'g_rt': (908, -1378),
 'o_gy1': (1130, -1297),
 'rh_end_tt_2': (550, -1608),
 'rs_end_south': (1865, -1598)}
颜色:现在将图中的边颜色提取为一个简单列表,以便按颜色可视化步道。
# Define data structure (list) of edge colors for plotting
edge_colors = [e[2]['color'] for e in g.edges(data=True)]

# Preview first 10
edge_colors[0:10]
['red',
 'gray',
 'yellowgreen',
 'gray',
 'yellowgreen',
 'blue',
 'black',
 'yellowgreen',
 'gray',
 'gray']
现在可以绘制一个与 Sleeping Giant 步道地图很好对齐的图:
plt.figure(figsize=(8, 6))
nx.draw(g, pos=node_positions, edge_color=edge_colors, node_size=10, node_color='black')
plt.title('Graph Representation of Sleeping Giant Trail Map', size=15)
plt.show()
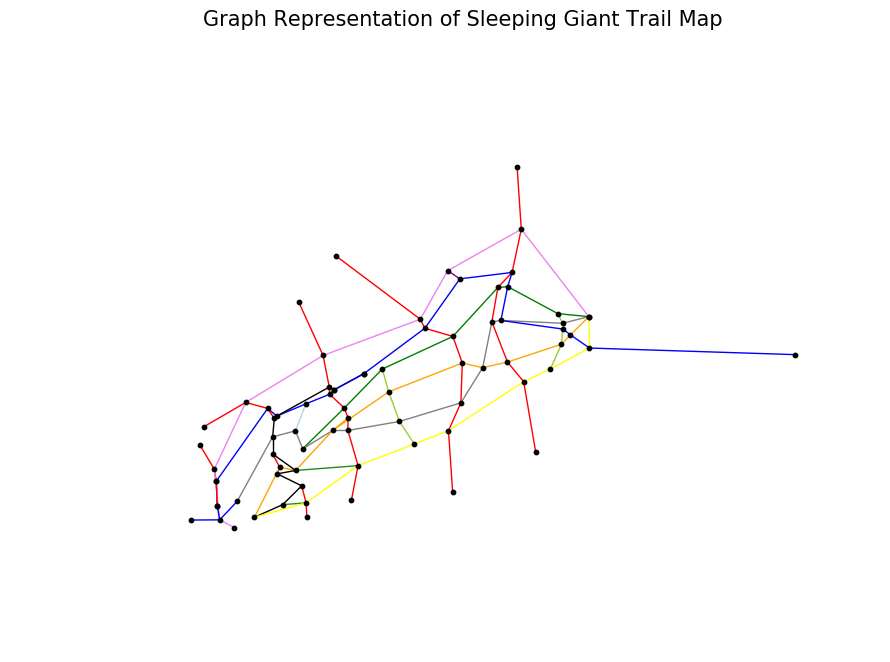
这种图的表示方式显然无法展现步道的所有弯曲与曲折,但不必担心:这些都已准确体现在用于计算的边属性 distance 中。该可视化确实体现了节点(步道交叉点)之间的直线距离,看起来是一个不错的近似。
好了,现在您已经定义了术语并创建了图,接下来如何在图上找到最短路径?
从概念上讲,解决中国邮差问题相当简单:
找出所有奇度节点(非常容易)。
(找出所有步道交叉点,其中接触该交叉点的步道数为奇数)
向图中添加边,使所有奇度节点变为偶度。这些新增边必须是原图中的重复边(本问题中我们假设不抄近道穿林)。所添加边的集合应使总距离之和最小(困难……严格来说是 NP-hard)。
(简单说,就是在覆盖每条步道的前提下,将“折返”的总距离最小化)
给定起点,在扩展后的数据集上找到欧拉回路(中等难度)。
(一旦知道哪些步道需要折返,实际上从头到尾计算出整条路线)
虽然放宽以下假设可以生成更短且更精确的路径,但这会增加教程范围之外的复杂度,而本教程聚焦于 CPP 本身。
假设 1:仅包含必选步道
从上面的步道图可以看到,公园边界沿线有道路可用于连接步道,尤其是红色步道。此外,还有一些步道(马蹄形和无标记的标记)并非 Giantmaster 记录要求,但可用于避免较长的折返。纳入可选步道实际上是 CPP 的一个已建立变体,称为乡村邮差问题(Rural Postman Problem)。在本教程中我们忽略可选步道,仅聚焦必选步道。
假设 2:上坡 == 下坡
CPP 假设走一条步道的代价等同于其距离,而不考虑行走方向。然而,其中一些步道起伏较大,向上比向下需要更多能量。可以在 CPP 的一个扩展——有风邮差问题(Windy Postman Problem)——中引入结合距离与海拔变化的度量,并在有向图上建模。
假设 3:无平行边(步道)
虽然可以包含平行边(多个步道连接相同两节点),但这会增加计算复杂度。幸运的是,这里仅在两处发生(蓝色 ⇔ 红菱形 和 蓝色 ⇔ Tower Trail)。这通过对边列表的一点小技巧来处理:加入带有 _dupe 后缀的重复节点,在保持边唯一性的同时捕获每一条步道。如果您想在包含许多平行边的自有图上解决 CPP,我编写的 postman_problems 包中的 CPP 实现能更优雅且稳健地处理平行边。
这一步相当直观,属于计数计算。您会看到在 76 个节点中有 36 个是奇度节点。它们大多是步道尽头(度为 1)以及三条步道的交叉点。还有少量度为 5 的节点。
# Calculate list of nodes with odd degree
nodes_odd_degree = [v for v, d in g.degree_iter() if d % 2 == 1]

# Preview
nodes_odd_degree[0:5]
['rs_end_south', 'rc_end_north', 'v_end_east', 'rh_end_south', 'b_end_east']
# Counts
print('Number of nodes of odd degree: {}'.format(len(nodes_odd_degree)))
print('Number of total nodes: {}'.format(len(g.nodes())))
Number of nodes of odd degree: 36
Number of total nodes: 77
这是真正的重点。我们将其分解为 5 部分:
使用 itertools combination 函数计算所有奇度节点的配对。图是无向的,因此不关心顺序:例如,(a,b) == (b,a)。
# Compute all pairs of odd nodes. in a list of tuples
odd_node_pairs = list(itertools.combinations(nodes_odd_degree, 2))

# Preview pairs of odd degree nodes
odd_node_pairs[0:10]
[('rs_end_south', 'rc_end_north'),
 ('rs_end_south', 'v_end_east'),
 ('rs_end_south', 'rh_end_south'),
 ('rs_end_south', 'b_end_east'),
 ('rs_end_south', 'b_bv'),
 ('rs_end_south', 'rt_end_south'),
 ('rs_end_south', 'o_rt'),
 ('rs_end_south', 'y_rt'),
 ('rs_end_south', 'g_gy2'),
 ('rs_end_south', 'b_tt_3')]
# Counts
print('Number of pairs: {}'.format(len(odd_node_pairs)))
Number of pairs: 630
让我们用下面的组合公式确认这个配对数量正确。幸运的是,您只需处理 630 对。解决这个 CPP 示例的计算时间很短(几秒钟)。
然而,如果有 3,600 个奇度节点配对,那么将有约 650 万对需要优化。在输入规模增加 100 倍的情况下,输出规模却增加了约 10,000 倍。
这是第一个涉及实际计算的步骤。幸运的是,networkx 提供了方便的Dijkstra 算法实现来计算两个节点之间的最短路径。您将该函数应用于上文 odd_node_pairs 中的每一对(共 630 对)。
def get_shortest_paths_distances(graph, pairs, edge_weight_name):
    """Compute shortest distance between each pair of nodes in a graph.  Return a dictionary keyed on node pairs (tuples)."""
    distances = {}
    for pair in pairs:
        distances[pair] = nx.dijkstra_path_length(graph, pair[0], pair[1], weight=edge_weight_name)
    return distances
# Compute shortest paths.  Return a dictionary with node pairs keys and a single value equal to shortest path distance.
odd_node_pairs_shortest_paths = get_shortest_paths_distances(g, odd_node_pairs, 'distance')

# Preview with a bit of hack (there is no head/slice method for dictionaries).
dict(list(odd_node_pairs_shortest_paths.items())[0:10])
{('b_bv', 'y_gy1'): 1.22,
 ('b_bw', 'rc_end_south'): 1.35,
 ('b_end_east', 'b_bw'): 3.0400000000000005,
 ('b_end_east', 'rd_end_north'): 3.83,
 ('g_gy1', 'nature_end_west'): 0.9900000000000001,
 ('o_rt', 'y_gy1'): 0.53,
 ('rc_end_north', 'rd_end_south'): 2.21,
 ('rc_end_north', 'rs_end_north'): 1.79,
 ('rs_end_north', 'o_tt'): 2.0999999999999996,
 ('w_bw', 'rd_end_north'): 1.02}
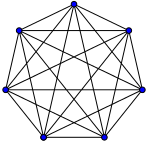
完全图就是每个节点都通过一条唯一的边连接到其他所有节点的图。
下面是维基百科上的一个基本示例:包含 7 个节点和 21 条边(7 选 2)的完全图:
您在下面创建的图包含 36 个节点和 630 条边,并带有相应的边权(距离)。
定义了 create_complete_graph 来进行计算。参数 flip_weights 用于将 distance 转换为 weight 属性,其中小数值表示长距离,大数值表示短距离。听起来有些反直觉,但这一步是为了第 2.4 步在完全图上计算最大权匹配所必需的。
理想情况下,您会直接计算最小权匹配,但 NetworkX 只实现了 max_weight_matching 函数(最大化边权,而非最小化)。我们通过对 distance 属性取相反数(乘以 -1)得到 weight 来“曲线救国”。这样可保证距离的顺序和尺度被保留但方向相反。
def create_complete_graph(pair_weights, flip_weights=True):
    """
    Create a completely connected graph using a list of vertex pairs and the shortest path distances between them
    Parameters:
        pair_weights: list[tuple] from the output of get_shortest_paths_distances
        flip_weights: Boolean. Should we negate the edge attribute in pair_weights?
    """
    g = nx.Graph()
    for k, v in pair_weights.items():
        wt_i = - v if flip_weights else v
        g.add_edge(k[0], k[1], attr_dict={'distance': v, 'weight': wt_i})
    return g
# Generate the complete graph
g_odd_complete = create_complete_graph(odd_node_pairs_shortest_paths, flip_weights=True)

# Counts
print('Number of nodes: {}'.format(len(g_odd_complete.nodes())))
print('Number of edges: {}'.format(len(g_odd_complete.edges())))
Number of nodes: 36
Number of edges: 630
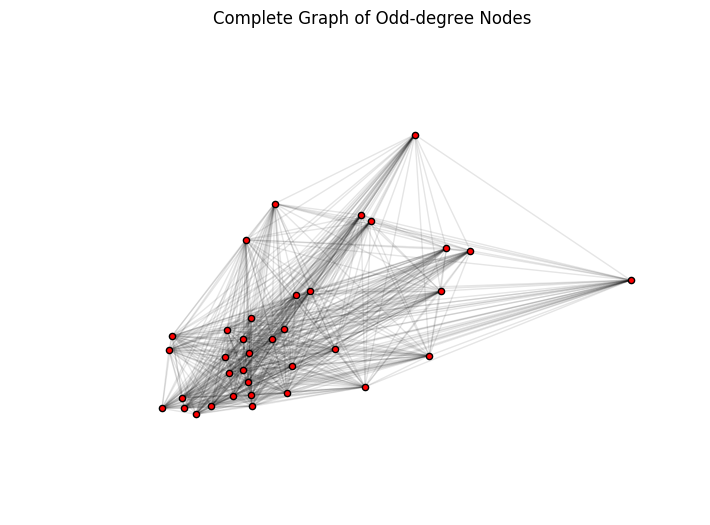
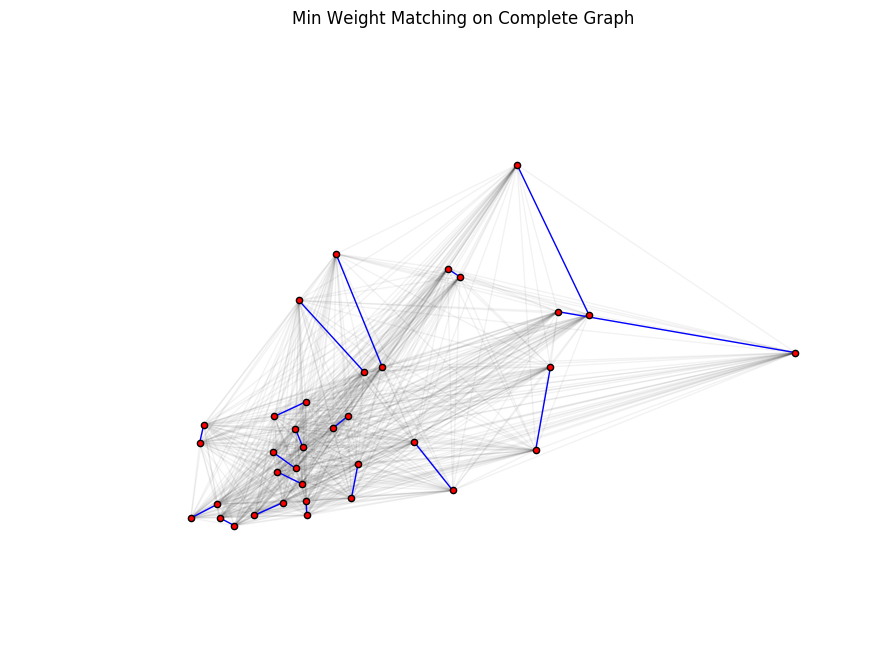
作为一个视觉辅助,下面绘制了奇度节点对的完全图。注意您保留了每个节点的 X、Y 坐标,但这些边不一定代表实际的步道。例如,在该图中两个节点之间可能由一条边相连,但它们之间的最短路径可能需要通过若干个偶度节点(此处未显示)跨越 5 段。
# Plot the complete graph of odd-degree nodes
plt.figure(figsize=(8, 6))
pos_random = nx.random_layout(g_odd_complete)
nx.draw_networkx_nodes(g_odd_complete, node_positions, node_size=20, node_color="red")
nx.draw_networkx_edges(g_odd_complete, node_positions, alpha=0.1)
plt.axis('off')
plt.title('Complete Graph of Odd-degree Nodes')
plt.show()
这是 CPP 中最复杂的一步。您需要找到那些奇度节点配对,使得它们(配对间距离)的总和尽可能小。就您的问题而言,这归结为从第 2.3 步产生的“毛线团”图中,选择最优的 18 条边(36 个奇度节点 / 2)。
无论从实现还是直觉理解,这类优化都超出了本教程的范围……相关代码多达800 多行,背后还有大量学术文献。
不过,给感兴趣的读者一个简短旁注:
非常感谢 Joris van Rantwijk 早在 2008 年就在他的博客上写出了最初的实现。我也是以类似方式接触这个问题,并抱有与 Joris 相同的初衷。引自 Joris 2008 年的文章:
因为我找不到任何 Perl 的最大加权匹配实现,我一时冲动决定自己写点代码。结果发现我低估了这个问题,但当我意识到自己的错误时,我已经对这个问题着了迷,拒绝放弃。
不过,我确实放弃了。幸运的是,Joris 没有。
这个最大权匹配实现后来被合并进 NetworkX 包并持续维护。也要感谢GitHub 上 10 多位贡献者对这一庞大代码库的维护。
这是一个困难且计算密集的问题。1965 年的第一项突破证明了最大匹配问题可以在多项式时间内解决。该成果由 Jack Edmonds 发表,论文标题或许是史上最优雅之一:“Paths, trees, and flowers”[1]。此后大量文献在此基础上改进了优化过程。NetworkX 中的 max_weight_matching 函数基于 Galil, Zvi (1986) [2] 的 O(n3) 算法。
# Compute min weight matching.
# Note: max_weight_matching uses the 'weight' attribute by default as the attribute to maximize.
odd_matching_dupes = nx.algorithms.max_weight_matching(g_odd_complete, True)

print('Number of edges in matching: {}'.format(len(odd_matching_dupes)))
Number of edges in matching: 36
匹配输出(odd_matching_dupes)是一个字典。尽管该匹配中包含 36 条边,但您只需要 18 条。每一对边在字典中出现两次(一次以节点 1 为键,另一次以节点 2 为键)。
# Preview of matching with dupes
odd_matching_dupes
{'b_bv': 'v_bv',
 'b_bw': 'rh_end_tt_1',
 'b_end_east': 'g_gy2',
 'b_end_west': 'rd_end_south',
 'b_tt_3': 'rt_end_north',
 'b_v': 'v_end_west',
 'g_gy1': 'rc_end_north',
 'g_gy2': 'b_end_east',
 'g_w': 'w_bw',
 'nature_end_west': 'o_y_tt_end_west',
 'o_rt': 'o_w_1',
 'o_tt': 'rh_end_tt_2',
 'o_w_1': 'o_rt',
 'o_y_tt_end_west': 'nature_end_west',
 'rc_end_north': 'g_gy1',
 'rc_end_south': 'y_gy1',
 'rd_end_north': 'rh_end_north',
 'rd_end_south': 'b_end_west',
 'rh_end_north': 'rd_end_north',
 'rh_end_south': 'y_rh',
 'rh_end_tt_1': 'b_bw',
 'rh_end_tt_2': 'o_tt',
 'rh_end_tt_3': 'rh_end_tt_4',
 'rh_end_tt_4': 'rh_end_tt_3',
 'rs_end_north': 'v_end_east',
 'rs_end_south': 'y_gy2',
 'rt_end_north': 'b_tt_3',
 'rt_end_south': 'y_rt',
 'v_bv': 'b_bv',
 'v_end_east': 'rs_end_north',
 'v_end_west': 'b_v',
 'w_bw': 'g_w',
 'y_gy1': 'rc_end_south',
 'y_gy2': 'rs_end_south',
 'y_rh': 'rh_end_south',
 'y_rt': 'rt_end_south'}
由于图是无向的且不关心顺序,您将这个字典转换为元组列表。去重后得到 18 对唯一边,它们的总距离之和最小。
# Convert matching to list of deduped tuples
odd_matching = list(pd.unique([tuple(sorted([k, v])) for k, v in odd_matching_dupes.items()]))

# Counts
print('Number of edges in matching (deduped): {}'.format(len(odd_matching)))
Number of edges in matching (deduped): 18
# Preview of deduped matching
odd_matching
[('rs_end_south', 'y_gy2'),
 ('b_end_west', 'rd_end_south'),
 ('b_bv', 'v_bv'),
 ('rh_end_tt_3', 'rh_end_tt_4'),
 ('b_bw', 'rh_end_tt_1'),
 ('o_tt', 'rh_end_tt_2'),
 ('g_w', 'w_bw'),
 ('b_end_east', 'g_gy2'),
 ('nature_end_west', 'o_y_tt_end_west'),
 ('g_gy1', 'rc_end_north'),
 ('o_rt', 'o_w_1'),
 ('rs_end_north', 'v_end_east'),
 ('rc_end_south', 'y_gy1'),
 ('rh_end_south', 'y_rh'),
 ('rt_end_south', 'y_rt'),
 ('b_tt_3', 'rt_end_north'),
 ('rd_end_north', 'rh_end_north'),
 ('b_v', 'v_end_west')]
让我们在第 2.3 步绘制的完全图上可视化这些配对。与之前一样,这里的节点位置反映真实图(步道图),但所示的边距离(蓝线)是直线距离。两节点之间的实际最短路线可能由多条边组成,曲折蜿蜒、距离也会更长。
plt.figure(figsize=(8, 6))

# Plot the complete graph of odd-degree nodes
nx.draw(g_odd_complete, pos=node_positions, node_size=20, alpha=0.05)

# Create a new graph to overlay on g_odd_complete with just the edges from the min weight matching
g_odd_complete_min_edges = nx.Graph(odd_matching)
nx.draw(g_odd_complete_min_edges, pos=node_positions, node_size=20, edge_color='blue', node_color='red')

plt.title('Min Weight Matching on Complete Graph')
plt.show()
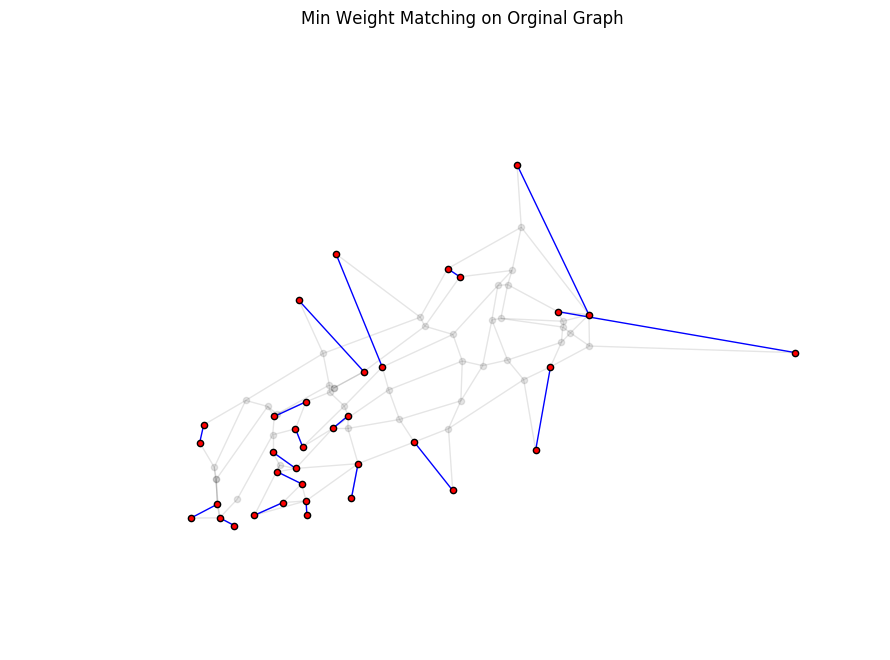
为展示这与原图的关系,您将相同的最小权配对(蓝线)叠加在(淡化的)步道图上,而不是完全图。再次注意,蓝线代表“抄近路”的直线连接(并非真实步道)。第 3. 步仍需一些工作,找出每对节点之间由实际存在的边构成的最短路径。
plt.figure(figsize=(8, 6))

# Plot the original trail map graph
nx.draw(g, pos=node_positions, node_size=20, alpha=0.1, node_color='black')

# Plot graph to overlay with just the edges from the min weight matching
nx.draw(g_odd_complete_min_edges, pos=node_positions, node_size=20, alpha=1, node_color='red', edge_color='blue')

plt.title('Min Weight Matching on Orginal Graph')
plt.show()
现在用第 2.4 步计算得到的匹配边来扩展原始图。下面定义了一个简单的函数来完成这件事,同时也标注这些新边来源于扩展图。您将在第 3. 步真正构建欧拉回路时用到这些信息。
def add_augmenting_path_to_graph(graph, min_weight_pairs):
    """
    Add the min weight matching edges to the original graph
    Parameters:
        graph: NetworkX graph (original graph from trailmap)
        min_weight_pairs: list[tuples] of node pairs from min weight matching
    Returns:
        augmented NetworkX graph
    """

    # We need to make the augmented graph a MultiGraph so we can add parallel edges
    graph_aug = nx.MultiGraph(graph.copy())
    for pair in min_weight_pairs:
        graph_aug.add_edge(pair[0],
                           pair[1],
                           attr_dict={'distance': nx.dijkstra_path_length(graph, pair[0], pair[1]),
                                      'trail': 'augmented'}
                          )
    return graph_aug
让我们确认扩展图中新增的边数(18)是否符合预期:
# Create augmented graph: add the min weight matching edges to g
g_aug = add_augmenting_path_to_graph(g, odd_matching)

# Counts
print('Number of edges in original graph: {}'.format(len(g.edges())))
print('Number of edges in augmented graph: {}'.format(len(g_aug.edges())))
Number of edges in original graph: 123
Number of edges in augmented graph: 141
再确认一下现在每个节点的度是否都为偶数:
pd.value_counts(g_aug.degree())
4    54
2    18
6     5
dtype: int64
既然您已经得到了一个所有节点均为偶度的图,困难的优化工作就结束了。正如欧拉在 1736 年著名的柯尼斯堡七桥问题中所提出的:如果所有节点都是偶度,就存在一条恰好经过每条边一次的路径。Carl Hierholzer 随后在 1870 年代对该结果进行了正式证明。
可构造的欧拉回路有很多条且距离相同。使用 NetworkX 的 eulerian_circuit 函数可以搞定 90% 的工作。不过它也有一些限制。
您将要修复的限制:
扩展图中可能(且很可能)包含原图中不存在的边。为了得到(不抄近路的)回路,您必须将这些扩展边细分为通过实际存在的边构成的最短路径。
eulerian_circuit 仅返回我们访问每个节点的顺序。它不会返回完成回路所需的边属性。但这是必要的,因为当两个节点之间存在多条边时,您需要跟踪哪些边已经走过。
您不会修复的限制:
尽管如此,先从一个简单但不完整的解法开始:
naive_euler_circuit = list(nx.eulerian_circuit(g_aug, source='b_end_east'))
如预期,朴素欧拉回路的长度等于扩展图的边数。
print('Length of eulerian circuit: {}'.format(len(naive_euler_circuit)))
Length of eulerian circuit: 141
输出只是一个表示节点对的元组列表。注意每个元组的第一个节点与前一个元组的第二个节点相同。
# Preview naive Euler circuit
naive_euler_circuit[0:10]
[('b_end_east', 'g_gy2'),
 ('g_gy2', 'b_g'),
 ('b_g', 'b_w'),
 ('b_w', 'b_gy2'),
 ('b_gy2', 'w_gy2'),
 ('w_gy2', 'b_w'),
 ('b_w', 'w_rs'),
 ('w_rs', 'g_rs'),
 ('g_rs', 'b_g'),
 ('b_g', 'b_rs')]
现在定义一个函数,利用原始图告诉您从节点 A 到节点 B 应该走哪些步道。虽然代码显得啰嗦,但逻辑很简单。您只需将包含原图中不存在之边的朴素回路,转换为仅使用原图中存在之边的欧拉回路。
遍历朴素欧拉回路(naive_euler_circuit)中的每一条边。凡是遇到原图中不存在的边,就用原图中该节点对之间的最短路径所包含的一系列边替换之。
def create_eulerian_circuit(graph_augmented, graph_original, starting_node=None):
    """Create the eulerian path using only edges from the original graph."""
    euler_circuit = []
    naive_circuit = list(nx.eulerian_circuit(graph_augmented, source=starting_node))

    for edge in naive_circuit:
        edge_data = graph_augmented.get_edge_data(edge[0], edge[1])

        if edge_data[0]['trail'] != 'augmented':
            # If `edge` exists in original graph, grab the edge attributes and add to eulerian circuit.
            edge_att = graph_original[edge[0]][edge[1]]
            euler_circuit.append((edge[0], edge[1], edge_att))
        else:
            aug_path = nx.shortest_path(graph_original, edge[0], edge[1], weight='distance')
            aug_path_pairs = list(zip(aug_path[:-1], aug_path[1:]))

            print('Filling in edges for augmented edge: {}'.format(edge))
            print('Augmenting path: {}'.format(' => '.join(aug_path)))
            print('Augmenting path pairs: {}\n'.format(aug_path_pairs))

            # If `edge` does not exist in original graph, find the shortest path between its nodes and
            #  add the edge attributes for each link in the shortest path.
            for edge_aug in aug_path_pairs:
                edge_aug_att = graph_original[edge_aug[0]][edge_aug[1]]
                euler_circuit.append((edge_aug[0], edge_aug[1], edge_aug_att))

    return euler_circuit
针对限制 3,我们做了个小 hack:将欧拉回路的起点设在公园最东端的蓝色步道(节点 “b_end_east”)。实际跑这条路线时,您可以直接跳过最后那一步折返的指引。
添加了详细的打印语句,以说明当您用实际存在的边的最短路径替换扩展图中不存在的边时会发生什么。
# Create the Eulerian circuit
euler_circuit = create_eulerian_circuit(g_aug, g, 'b_end_east')
Filling in edges for augmented edge: ('b_end_east', 'g_gy2')
Augmenting path: b_end_east => b_y => b_o => b_gy2 => w_gy2 => g_gy2
Augmenting path pairs: [('b_end_east', 'b_y'), ('b_y', 'b_o'), ('b_o', 'b_gy2'), ('b_gy2', 'w_gy2'), ('w_gy2', 'g_gy2')]

Filling in edges for augmented edge: ('b_bw', 'rh_end_tt_1')
Augmenting path: b_bw => b_tt_1 => rh_end_tt_1
Augmenting path pairs: [('b_bw', 'b_tt_1'), ('b_tt_1', 'rh_end_tt_1')]

Filling in edges for augmented edge: ('b_tt_3', 'rt_end_north')
Augmenting path: b_tt_3 => b_tt_2 => tt_rt => v_rt => rt_end_north
Augmenting path pairs: [('b_tt_3', 'b_tt_2'), ('b_tt_2', 'tt_rt'), ('tt_rt', 'v_rt'), ('v_rt', 'rt_end_north')]

Filling in edges for augmented edge: ('rc_end_north', 'g_gy1')
Augmenting path: rc_end_north => v_rc => b_rc => g_rc => g_gy1
Augmenting path pairs: [('rc_end_north', 'v_rc'), ('v_rc', 'b_rc'), ('b_rc', 'g_rc'), ('g_rc', 'g_gy1')]

Filling in edges for augmented edge: ('y_gy1', 'rc_end_south')
Augmenting path: y_gy1 => y_rc => rc_end_south
Augmenting path pairs: [('y_gy1', 'y_rc'), ('y_rc', 'rc_end_south')]

Filling in edges for augmented edge: ('b_end_west', 'rd_end_south')
Augmenting path: b_end_west => b_v => rd_end_south
Augmenting path pairs: [('b_end_west', 'b_v'), ('b_v', 'rd_end_south')]

Filling in edges for augmented edge: ('rh_end_north', 'rd_end_north')
Augmenting path: rh_end_north => v_rh => v_rd => rd_end_north
Augmenting path pairs: [('rh_end_north', 'v_rh'), ('v_rh', 'v_rd'), ('v_rd', 'rd_end_north')]

Filling in edges for augmented edge: ('v_end_east', 'rs_end_north')
Augmenting path: v_end_east => v_rs => rs_end_north
Augmenting path pairs: [('v_end_east', 'v_rs'), ('v_rs', 'rs_end_north')]

Filling in edges for augmented edge: ('y_gy2', 'rs_end_south')
Augmenting path: y_gy2 => y_rs => rs_end_south
Augmenting path pairs: [('y_gy2', 'y_rs'), ('y_rs', 'rs_end_south')]
您会看到欧拉回路的长度比朴素回路更长,这是合理的。
print('Length of Eulerian circuit: {}'.format(len(euler_circuit)))
Length of Eulerian circuit: 158
下面是文本形式的解的打印输出:
# Preview first 20 directions of CPP solution
for i, edge in enumerate(euler_circuit[0:20]):
    print(i, edge)
0 ('b_end_east', 'b_y', {'color': 'blue', 'estimate': 0, 'trail': 'b', 'distance': 1.32})
1 ('b_y', 'b_o', {'color': 'blue', 'estimate': 0, 'trail': 'b', 'distance': 0.08})
2 ('b_o', 'b_gy2', {'color': 'blue', 'estimate': 1, 'trail': 'b', 'distance': 0.05})
3 ('b_gy2', 'w_gy2', {'color': 'yellowgreen', 'estimate': 1, 'trail': 'gy2', 'distance': 0.03})
4 ('w_gy2', 'g_gy2', {'color': 'yellowgreen', 'estimate': 0, 'trail': 'gy2', 'distance': 0.05})
5 ('g_gy2', 'b_g', {'color': 'green', 'estimate': 0, 'trail': 'g', 'distance': 0.45})
6 ('b_g', 'b_w', {'color': 'blue', 'estimate': 0, 'trail': 'b', 'distance': 0.16})
7 ('b_w', 'b_gy2', {'color': 'blue', 'estimate': 0, 'trail': 'b', 'distance': 0.41})
8 ('b_gy2', 'w_gy2', {'color': 'yellowgreen', 'estimate': 1, 'trail': 'gy2', 'distance': 0.03})
9 ('w_gy2', 'b_w', {'color': 'gray', 'estimate': 0, 'trail': 'w', 'distance': 0.42})
10 ('b_w', 'w_rs', {'color': 'gray', 'estimate': 1, 'trail': 'w', 'distance': 0.06})
11 ('w_rs', 'g_rs', {'color': 'red', 'estimate': 0, 'trail': 'rs', 'distance': 0.18})
12 ('g_rs', 'b_g', {'color': 'green', 'estimate': 1, 'trail': 'g', 'distance': 0.05})
13 ('b_g', 'b_rs', {'color': 'blue', 'estimate': 0, 'trail': 'b', 'distance': 0.07})
14 ('b_rs', 'g_rs', {'color': 'red', 'estimate': 0, 'trail': 'rs', 'distance': 0.11})
15 ('g_rs', 'g_rc', {'color': 'green', 'estimate': 0, 'trail': 'g', 'distance': 0.45})
16 ('g_rc', 'g_gy1', {'color': 'green', 'estimate': 0, 'trail': 'g', 'distance': 0.37})
17 ('g_gy1', 'g_rt', {'color': 'green', 'estimate': 0, 'trail': 'g', 'distance': 0.26})
18 ('g_rt', 'g_w', {'color': 'green', 'estimate': 0, 'trail': 'g', 'distance': 0.31})
19 ('g_w', 'o_w_1', {'color': 'gray', 'estimate': 0, 'trail': 'w', 'distance': 0.18})
您很快就会发现,该算法对任何特定步道都不太“忠诚”,在不同步道间跳转得很快。该方法的一个扩展是可以在目标函数中引入“步道忠诚度”的概念,使实际跑这条路线更易于管理。
让我们窥探一下解答的合理性如何。
(无需纠结这些啰嗦的代码,只看打印输出即可)
# Computing some stats
total_mileage_of_circuit = sum([edge[2]['distance'] for edge in euler_circuit])
total_mileage_on_orig_trail_map = sum(nx.get_edge_attributes(g, 'distance').values())
_vcn = pd.value_counts(pd.value_counts([(e[0]) for e in euler_circuit]), sort=False)
node_visits = pd.DataFrame({'n_visits': _vcn.index, 'n_nodes': _vcn.values})
_vce = pd.value_counts(pd.value_counts([sorted(e)[0] + sorted(e)[1] for e in nx.MultiDiGraph(euler_circuit).edges()]))
edge_visits = pd.DataFrame({'n_visits': _vce.index, 'n_edges': _vce.values})

# Printing stats
print('Mileage of circuit: {0:.2f}'.format(total_mileage_of_circuit))
print('Mileage on original trail map: {0:.2f}'.format(total_mileage_on_orig_trail_map))
print('Mileage retracing edges: {0:.2f}'.format(total_mileage_of_circuit-total_mileage_on_orig_trail_map))
print('Percent of mileage retraced: {0:.2f}%\n'.format((1-total_mileage_of_circuit/total_mileage_on_orig_trail_map)*-100))

print('Number of edges in circuit: {}'.format(len(euler_circuit)))
print('Number of edges in original graph: {}'.format(len(g.edges())))
print('Number of nodes in original graph: {}\n'.format(len(g.nodes())))

print('Number of edges traversed more than once: {}\n'.format(len(euler_circuit)-len(g.edges())))

print('Number of times visiting each node:')
print(node_visits.to_string(index=False))

print('\nNumber of times visiting each edge:')
print(edge_visits.to_string(index=False))
Mileage of circuit: 33.59
Mileage on original trail map: 25.76
Mileage retracing edges: 7.83
Percent of mileage retraced: 30.40%

Number of edges in circuit: 158
Number of edges in original graph: 123
Number of nodes in original graph: 77

Number of edges traversed more than once: 35

Number of times visiting each node:
n_nodes  n_visits
     18         1
     38         2
     20         3
      1         4

Number of times visiting each edge:
n_edges  n_visits
     88         1
     35         2
虽然 NetworkX 也提供了图形可视化的功能,但它在这方面相当谦虚:
NetworkX 提供了用于可视化图形的基础功能,但其主要目标是实现图分析,而非图可视化。未来,图可视化功能可能会从 NetworkX 中移除,或仅以附加包的形式提供。
高质量的图可视化并不容易,我们强烈建议使用专门用于该任务的工具进行可视化。值得注意且功能全面的图可视化工具包括 Cytoscape、Gephi、Graphviz,以及用于 LaTeX 排版的 PGF/TikZ。
话虽如此,NetworkX 基于 matplotlib 的内置绘图功能已足以用于目测与探索基础图形,因此本教程仍使用 NetworkX 的 draw。
我在自己的 Python 包 postman_problems 中使用了 graphviz 和 dot 图描述语言可视化解。虽然需要一些工作将 NetworkX 的图结构转换为 dot 图,但这确实带来了更高的可视化质量与控制力。
第一步是将欧拉回路中需要行走的边列表转换为带有更易绘图属性的边列表。
create_cpp_edgelist 创建一个带有一些额外属性的边列表,供绘图使用:
def create_cpp_edgelist(euler_circuit):
    """
    Create the edgelist without parallel edge for the visualization
    Combine duplicate edges and keep track of their sequence and # of walks
    Parameters:
        euler_circuit: list[tuple] from create_eulerian_circuit
    """
    cpp_edgelist = {}

    for i, e in enumerate(euler_circuit):
        edge = frozenset([e[0], e[1]])

        if edge in cpp_edgelist:
            cpp_edgelist[edge][2]['sequence'] += ', ' + str(i)
            cpp_edgelist[edge][2]['visits'] += 1

        else:
            cpp_edgelist[edge] = e
            cpp_edgelist[edge][2]['sequence'] = str(i)
            cpp_edgelist[edge][2]['visits'] = 1

    return list(cpp_edgelist.values())
创建 CPP 边列表:
cpp_edgelist = create_cpp_edgelist(euler_circuit)
如预期,您的边列表与原始图的边数相同。
print('Number of edges in CPP edge list: {}'.format(len(cpp_edgelist)))
Number of edges in CPP edge list: 123
CPP 边列表看起来与 euler_circuit 类似,只是多了几个属性。
# Preview CPP plot-friendly edge list
cpp_edgelist[0:3]
[('rh_end_tt_4',
  'nature_end_west',
  {'color': 'black',
   'distance': 0.2,
   'estimate': 0,
   'sequence': '73',
   'trail': 'tt',
   'visits': 1}),
 ('rd_end_south',
  'b_rd',
  {'color': 'red',
   'distance': 0.13,
   'estimate': 0,
   'sequence': '95',
   'trail': 'rd',
   'visits': 1}),
 ('w_gy1',
  'w_rc',
  {'color': 'gray',
   'distance': 0.33,
   'estimate': 0,
   'sequence': '151',
   'trail': 'w',
   'visits': 1})]
现在创建图:
# Create CPP solution graph
g_cpp = nx.Graph(cpp_edgelist)
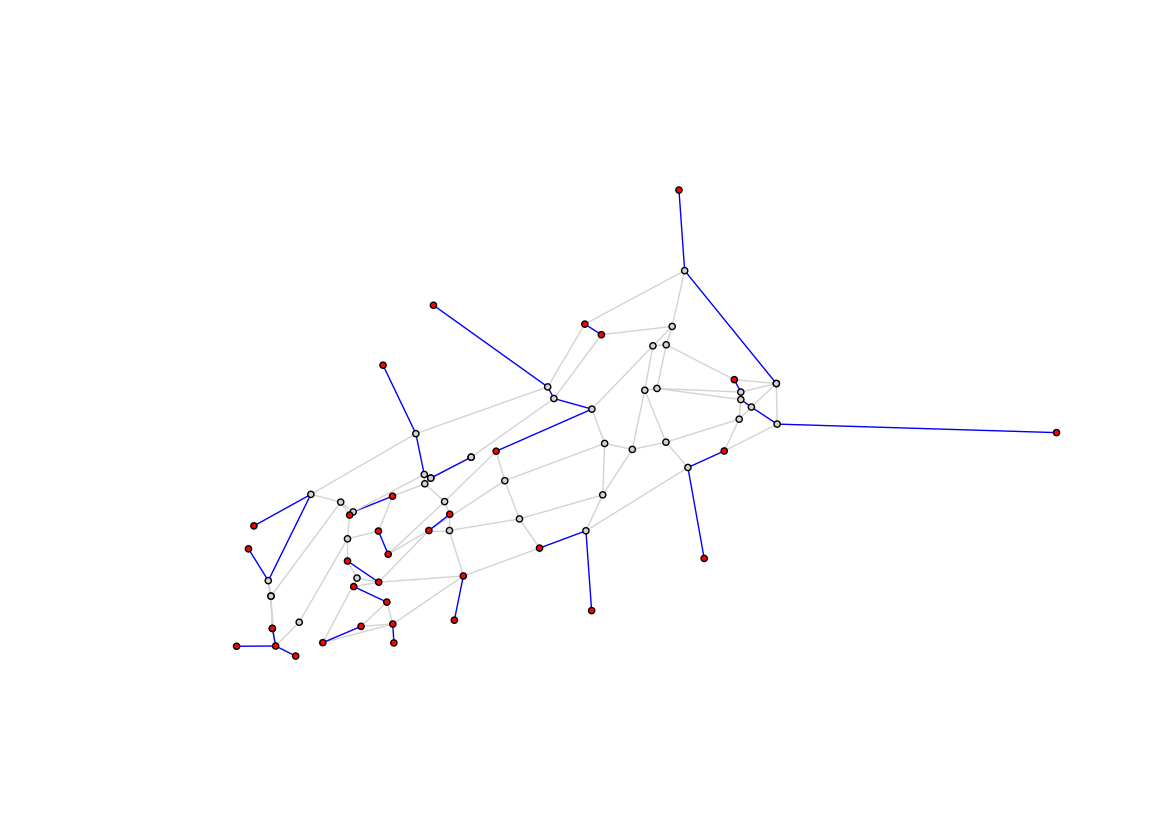
这里展示哪些边走了一次(灰色)以及哪些边走了多于一次(蓝色)。这是第 2.4 步可视化的“修正”版本,先前展示的是奇度节点对之间的朴素(直线)连接(红色)。现在通过在实际存在的边上追踪每一对奇度节点的最短路径,对其进行了修正。
如果优化做得好,这些蓝线就代表了需要折返的最短距离。更具体地说,即使得奇度节点匹配所需的最小距离。
plt.figure(figsize=(14, 10))

visit_colors = {1:'lightgray', 2:'blue'}
edge_colors = [visit_colors[e[2]['visits']] for e in g_cpp.edges(data=True)]
node_colors = ['red'  if node in nodes_odd_degree else 'lightgray' for node in g_cpp.nodes()]

nx.draw_networkx(g_cpp, pos=node_positions, node_size=20, node_color=node_colors, edge_color=edge_colors, with_labels=False)
plt.axis('off')
plt.show()
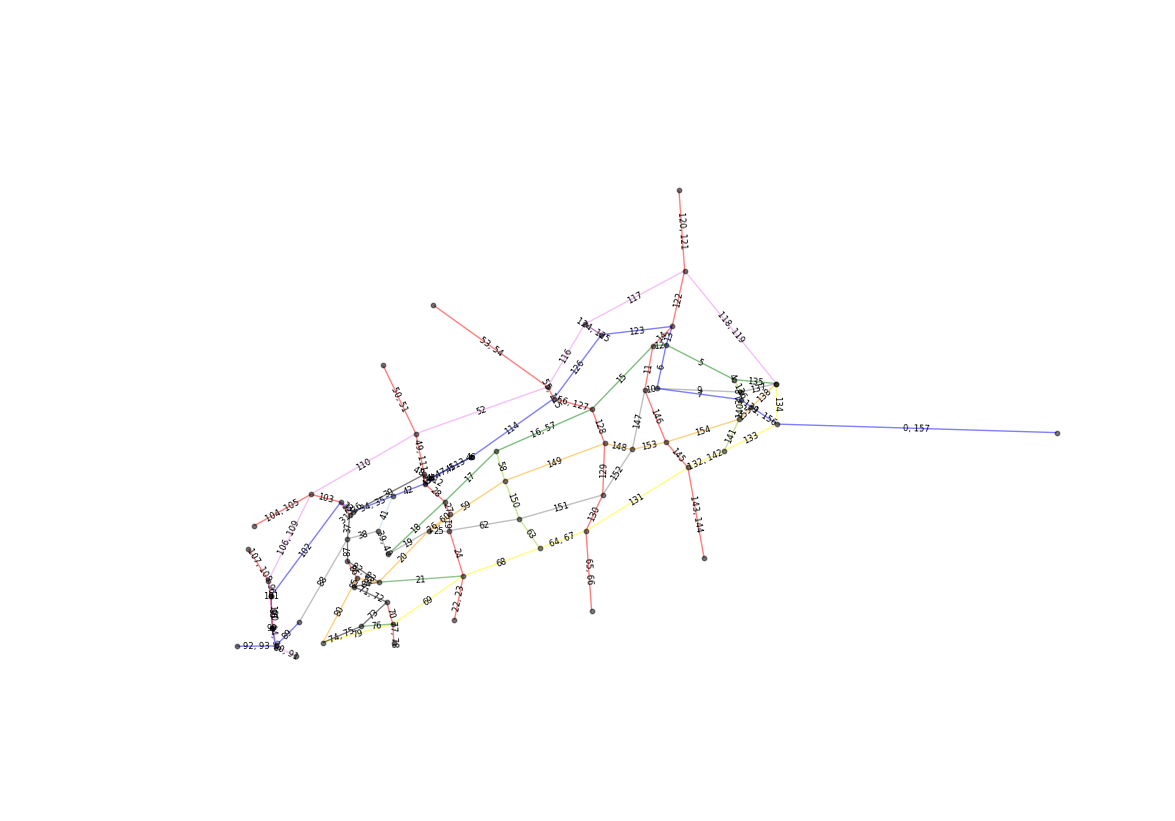
这里在原始图(步道图)上标注我们按 CPP 解行走步道的顺序编号。多次编号表示需要折返的步道。
您从右下角的蓝色步道出发(第 0 步和第 157 步方向)。
plt.figure(figsize=(14, 10))

edge_colors = [e[2]['color'] for e in g_cpp.edges(data=True)]
nx.draw_networkx(g_cpp, pos=node_positions, node_size=10, node_color='black', edge_color=edge_colors, with_labels=False, alpha=0.5)

bbox = {'ec':[1,1,1,0], 'fc':[1,1,1,0]}  # hack to label edges over line (rather than breaking up line)
edge_labels = nx.get_edge_attributes(g_cpp, 'sequence')
nx.draw_networkx_edge_labels(g_cpp, pos=node_positions, edge_labels=edge_labels, bbox=bbox, font_size=6)

plt.axis('off')
plt.show()
下面嵌入的动画从头到尾跟踪欧拉回路。边第一次经过时为黑色,第二次经过时为红色。
请注意,该 gif 无法对重叠或过短以至于无法很好可视化的边做到完全呈现。更强大的可视化库(如 graphviz)可以通过在节点间绘制样条曲线而非直线来改进这一点。
其生成代码如下,供参考。

首先为 CPP 解中的每一步(行走的边)生成一张 PNG 图片。
visit_colors = {1:'black', 2:'red'}
edge_cnter = {}
g_i_edge_colors = []
for i, e in enumerate(euler_circuit, start=1):

    edge = frozenset([e[0], e[1]])
    if edge in edge_cnter:
        edge_cnter[edge] += 1
    else:
        edge_cnter[edge] = 1

    # Full graph (faded in background)
    nx.draw_networkx(g_cpp, pos=node_positions, node_size=6, node_color='gray', with_labels=False, alpha=0.07)

    # Edges walked as of iteration i
    euler_circuit_i = copy.deepcopy(euler_circuit[0:i])
    for i in range(len(euler_circuit_i)):
        edge_i = frozenset([euler_circuit_i[i][0], euler_circuit_i[i][1]])
        euler_circuit_i[i][2]['visits_i'] = edge_cnter[edge_i]
    g_i = nx.Graph(euler_circuit_i)
    g_i_edge_colors = [visit_colors[e[2]['visits_i']] for e in g_i.edges(data=True)]

    nx.draw_networkx_nodes(g_i, pos=node_positions, node_size=6, alpha=0.6, node_color='lightgray', with_labels=False, linewidths=0.1)
    nx.draw_networkx_edges(g_i, pos=node_positions, edge_color=g_i_edge_colors, alpha=0.8)

    plt.axis('off')
    plt.savefig('fig/png/img{}.png'.format(i), dpi=120, bbox_inches='tight')
    plt.close()
然后将这些 PNG 图片拼接成上面的 gif。
先按 0 到 157 的顺序排序 PNG,再使用 imageio 以每秒 3 帧拼接生成 gif。
import glob
import numpy as np
import imageio
import os

def make_circuit_video(image_path, movie_filename, fps=5):
    # sorting filenames in order
    filenames = glob.glob(image_path + 'img*.png')
    filenames_sort_indices = np.argsort([int(os.path.basename(filename).split('.')[0][3:]) for filename in filenames])
    filenames = [filenames[i] for i in filenames_sort_indices]

    # make movie
    with imageio.get_writer(movie_filename, mode='I', fps=fps) as writer:
        for filename in filenames:
            image = imageio.imread(filename)
            writer.append_data(image)

make_circuit_video('fig/png/', 'fig/gif/cpp_route_animation.gif', fps=3)恭喜您完成了本教程,并在 Python 中解决了中国邮差问题。在本教程中,您已经覆盖了大量内容(确切地说是 33.6 英里的步道)。若想更深入了解网络基础,您可能会对 Datacamp 的 Network Analysis in Python 课程感兴趣,该课程更全面地讲解核心概念。
欢迎查阅 NetworkX 文档,进一步了解如何创建、操作和遍历这些复杂网络。文档内容全面,包含不少示例和一系列教程。
如果您有兴趣在自己的图上解决 CPP,我已将本教程中的功能封装到 Github 上的 Python 包 postman_problems 中。您也可以用不同的边与节点列表拼接本教程中的代码块,但使用 postman_problems 包通常更快捷更干净。
未来我计划在此实现 CPP 的扩展(Rural 与 Windy Postman Problem)。我也有宏伟的计划,在我的博客这里撰文分享这些扩展与在步道上测试路线的体验。另一个我计划探索并撰写的应用是结合经纬度坐标,开发(或使用)一种机制将逐路口导航发送到我的 Garmin 手表。
当然,还有最后一步:走出门去,把这条路线跑起来!
如果您想进一步学习 Python 中的网络,欢迎查看这些 DataCamp 课程:
Introduction to Network Analysis in Python
Intermediate Network Analysis in Python
1:Edmonds, Jack (1965). "Paths, trees, and flowers". Canad. J. Math. 17: 449–467。
2:Galil, Z. (1986). "Efficient algorithms for finding maximum matching in graphs". ACM Computing Surveys. Vol. 18, No. 1: 23-38。
进一步学习 Python
课程
课程
实践并学习路径你的进步。
使用 Google 继续