Kurs
Einstieg in die Netzwerkanalyse mit Python
4 Std.
74.5K
In diesem Tutorial packst du ein klassisches Problem der Graphentheorie an: das Chinese Postman Problem. Einige Bausteine des Algorithmus sind konzeptionell einfach, werden rechnerisch aber anspruchsvoll. Für dieses Tutorial brauchst du jedoch nur Grundkenntnisse in Python – keine strenge Mathematik, Informatik- oder Graphentheorie-Vorkenntnisse.
Wir starten mit den Grundbausteinen von Graphen (Knoten, Kanten, Pfade etc.) und lösen das Problem auf einem realen Graphen (Wegenetz eines State Parks) mit der NetworkX-Bibliothek in Python. Der Fokus liegt auf Kernkonzepten und Umsetzung. Für Neugierige gibt es weiterführende Lektüre zu den Optimierungsdetails.
Du hast sicher vom Travelling Salesman Problem gehört: die kürzeste Route (z. B. Straßen) zu finden, die eine Menge Knoten (z. B. Städte) verbindet. Weniger bekannt, aber sehr verwandt ist das Chinese Postman Problem (CPP), auch Route Inspection oder Arc Routing genannt. Ziel ist es, den kürzesten Pfad zu finden, der alle Kanten (Straßen) in einem Graphen mindestens einmal abdeckt. Wenn das gelingt, ohne eine Straße doppelt zu begehen – umso besser, dann ist es simpel. Müssen jedoch manche Straßen mehrfach begangen werden, brauchst du etwas Mathematik, um die kürzeste Route zu finden, die jede Straße mindestens einmal mit minimaler Gesamtdistanz abdeckt.
(Eine persönliche Anmerkung: ein bisschen kitschig, ein bisschen augenzwinkernd und für das Verständnis der Graphenoptimierung in Python nicht nötig)
Ich hatte einen echten Anwendungsfall: den Titel Giantmaster Marathoner zu erreichen.
Was ist ein Giantmaster? Ein Giantmaster ist jemand (Hund oder Mensch), der in seinem Leben jeden Trail im Sleeping Giant State Park in Hamden, CT (Nachbarort meiner Heimatstadt Wallingford) gegangen ist. Ein Giantmaster Marathoner hat all diese Trails an einem einzigen Tag absolviert.
Dank der akribischen Aufzeichnungen der Sleeping Giant Park Association findest du die komplette Liste der Giantmaster und ihren Status hier. Ich gebe zu, das hat mich motiviert, dieses Side-Projekt zu starten und raus auf die Trails zu gehen. Ich selbst habe den Giantmaster-Status im Winter 2006 erreicht, als ich frisch im Sleeping Giant Trail Crew freiwillig geholfen habe (was im SG-Archiv verzeichnet ist). Seither kamen neue Herausforderungen dazu. Die Kategorien „12 Monate“ und „4 Jahreszeiten“ sind beeindruckend, würden aber mehr Reisen von meinem jetzigen Wohnort (DC) in meine alte Heimat (CT) erfordern, als ich realistisch schaffe — und für Graphenoptimierung sind sie weniger spannend. Also: Giantmaster Marathon it is!
Zur Orientierung findest du unten die Sleeping-Giant-Trailkarte:
Das Schöne an Graphen: Begriffe und Konzepte sind meist intuitiv. Hier das Basis-Vokabular:
Graphen bilden Beziehungen zwischen Objekten ab. Die Objekte heißen in diesem Tutorial Knoten, die Verbindungen zwischen ihnen Kanten. Knoten und Kanten haben mehrere gängige Synonyme, die dasselbe bedeuten:
node == vertex == point
edge == arc == link
Der Ausgangsgraph ist ungerichtet, Kanten haben also keine Orientierung: Sie sind bidirektional. Beispiel: A<--->B == B<--->A.
Im Gegensatz dazu könnte der Graph für die tatsächlich kürzeste Route, um alle Trails zu gehen, ein gerichteter Graph sein, bei dem Reihenfolge und Richtung der Kanten zählen. Beispiel: A--->B != B--->A.
Der Graph ist außerdem ein kantengewichteter Graph, bei dem die Distanz (in Meilen) zwischen benachbarten Knoten das Kantengewicht darstellt. Das ist als Kantenattribut namens "distance" hinterlegt.
Grad bezeichnet die Anzahl der Kanten, die an einen Knoten angrenzen. Knoten heißen ungerader Grad, wenn diese Zahl ungerade ist, und gerader Grad, wenn sie gerade ist.
Die Lösung unseres CPP ist eine Euler-Tour: Ein Zyklus, der jede Kante genau einmal durchläuft und am Startknoten endet (ohne Zurückverfolgen). Eine Euler-Tour ist auch bekannt als:
Eulerian tour == Eulerian circuit == Eulerian cycle
Ein Matching ist eine Teilmenge von Kanten, in der kein Knoten mehrfach vorkommt. Ein Minimum-Weight-Matching findet das Matching mit der geringstmöglichen Summe der Kantengewichte.
NetworkX ist das populärste Python-Paket zur Manipulation und Analyse von Graphen. Es gibt weitere Pakete mit ähnlicher Basisfunktionalität, etwa igraph (auch für R und C++). Für das CPP bot NetworkX jedoch die stärksten Algorithmen, die ich brauchte.
Wenn du schon Datenanalyse in Python gemacht hast oder Anaconda nutzt, hast du vermutlich pandas und matplotlib installiert. networkx fehlt dir eventuell. Das sollten die einzigen Abhängigkeiten außerhalb der Python-Standardbibliothek sein, die du hier brauchst. Installation mit pip ist einfach:
pip install pandas
pip install networkx
pip install matplotlib
Das reicht fürs Erste. imageio und numpy importieren wir ganz am Ende, um die GIF-Animation der CPP-Lösung zu erstellen. Die Animation ist in diesem Beitrag eingebettet, die Pakete sind also optional.
import itertools
import copy
import networkx as nx
import pandas as pd
import matplotlib.pyplot as pltDie Kantenliste ist eine einfache Datenstruktur, mit der du den Graphen erstellst. Jede Zeile steht für eine Kante mit zugehörigen Attributen.
# Grab edge list data hosted on Gist
edgelist = pd.read_csv('https://gist.githubusercontent.com/brooksandrew/e570c38bcc72a8d102422f2af836513b/raw/89c76b2563dbc0e88384719a35cba0dfc04cd522/edgelist_sleeping_giant.csv')
# Preview edgelist
edgelist.head(10)
| node1 | node2 | trail | distance | color | estimate | |
|---|---|---|---|---|---|---|
| 0 | rs_end_north | v_rs | rs | 0.30 | red | 0 |
| 1 | v_rs | b_rs | rs | 0.21 | red | 0 |
| 2 | b_rs | g_rs | rs | 0.11 | red | 0 |
| 3 | g_rs | w_rs | rs | 0.18 | red | 0 |
| 4 | w_rs | o_rs | rs | 0.21 | red | 0 |
| 5 | o_rs | y_rs | rs | 0.12 | red | 0 |
| 6 | y_rs | rs_end_south | rs | 0.39 | red | 0 |
| 7 | rc_end_north | v_rc | rc | 0.70 | red | 0 |
| 8 | v_rc | b_rc | rc | 0.04 | red | 0 |
| 9 | b_rc | g_rc | rc | 0.15 | red | 0 |
Knotenlisten sind in networkx und anderen Bibliotheken oft optional, wenn eine Kantenliste vorhanden ist, da die Knotennamen in den ersten beiden Spalten der Kantenliste stehen. Hier möchten wir aber Knotenattribute hinzufügen: X- und Y-Koordinaten der Knoten (Trailkreuzungen), damit du den Graphen im selben Layout wie die Trailkarte plotten kannst.
Ich habe einen Nachmittag damit verbracht, sie manuell mit GIMP aus der Karte abzunehmen:
Auch die Knotennamen erforderten Handarbeit. Jeder Knoten steht für die Kreuzung von zwei oder mehr Trails. Wo möglich, heißt der Knoten trail1_trail2, wobei trail1 alphabetisch vor trail2 steht.
Schwieriger wurde es, wenn sich dieselben Trails mehrfach kreuzen, z. B. Orange und White. Dann habe ich _2 oder _3 an den Knotennamen angehängt. So hast du zwei eigene Knotennamen für zwei verschiedene Kreuzungen von Orange und White: o_w und o_w_2.
Das war viel Try-and-Error und Abgleich der mit X,Y geplotteten Graphen mit der echten Trailkarte.
# Grab node list data hosted on Gist
nodelist = pd.read_csv('https://gist.githubusercontent.com/brooksandrew/f989e10af17fb4c85b11409fea47895b/raw/a3a8da0fa5b094f1ca9d82e1642b384889ae16e8/nodelist_sleeping_giant.csv')
# Preview nodelist
nodelist.head(5)
| id | X | Y | |
|---|---|---|---|
| 0 | b_bv | 1486 | 732 |
| 1 | b_bw | 716 | 1357 |
| 2 | b_end_east | 3164 | 1111 |
| 3 | b_end_west | 141 | 1938 |
| 4 | b_g | 1725 | 771 |
Jetzt nutzt du Kanten- und Knotenliste, um in networkx ein Graph-Objekt zu erzeugen.
# Create empty graph
g = nx.Graph()
Iteriere durch die Kantenliste und füge jede Kante mit ihren Attributen dem Graphen g hinzu.
# Add edges and edge attributes
for i, elrow in edgelist.iterrows():
    g.add_edge(elrow[0], elrow[1], attr_dict=elrow[2:].to_dict())
Zur Veranschaulichung geben wir die Werte der letzten hinzugefügten Kante aus der Kantenliste für g aus:
# Edge list example
print(elrow[0]) # node1
print(elrow[1]) # node2
print(elrow[2:].to_dict()) # edge attribute dict
o_gy2
y_gy2
{'color': 'yellowgreen', 'estimate': 0, 'trail': 'gy2', 'distance': 0.12}
Analog fügst du die Knotenattribute hinzu.
# Add node attributes
for i, nlrow in nodelist.iterrows():
    g.node[nlrow['id']] = nlrow[1:].to_dict()
Beispiel aus der letzten Zeile der Knotenliste:
# Node list example
print(nlrow)
id    y_rt
X      977
Y     1666
Name: 76, dtype: objectDie Kanten erscheinen als Liste von 3er-Tupeln. Die ersten beiden Elemente sind die Knotennamen, das dritte ist das Attribut-Dictionary.
# Preview first 5 edges
g.edges(data=True)[0:5]
[('rs_end_south',
  'y_rs',
  {'color': 'red', 'distance': 0.39, 'estimate': 0, 'trail': 'rs'}),
 ('w_gy2',
  'park_east',
  {'color': 'gray', 'distance': 0.12, 'estimate': 0, 'trail': 'w'}),
 ('w_gy2',
  'g_gy2',
  {'color': 'yellowgreen', 'distance': 0.05, 'estimate': 0, 'trail': 'gy2'}),
 ('w_gy2',
  'b_w',
  {'color': 'gray', 'distance': 0.42, 'estimate': 0, 'trail': 'w'}),
 ('w_gy2',
  'b_gy2',
  {'color': 'yellowgreen', 'distance': 0.03, 'estimate': 1, 'trail': 'gy2'})]
Die Knoten erscheinen als Liste von 2er-Tupeln. Erst die Knoten-ID, dann das Attribut-Dictionary.
# Preview first 10 nodes
g.nodes(data=True)[0:10]
[('rs_end_south', {'X': 1865, 'Y': 1598}),
 ('w_gy2', {'X': 2000, 'Y': 954}),
 ('rd_end_south_dupe', {'X': 273, 'Y': 1869}),
 ('w_gy1', {'X': 1184, 'Y': 1445}),
 ('g_rt', {'X': 908, 'Y': 1378}),
 ('v_rd', {'X': 258, 'Y': 1684}),
 ('g_rs', {'X': 1676, 'Y': 775}),
 ('rc_end_north', {'X': 867, 'Y': 618}),
 ('v_end_east', {'X': 2131, 'Y': 921}),
 ('rh_end_south', {'X': 721, 'Y': 1925})]
Vor der Visualisierung ein paar Kennzahlen:
print('# of edges: {}'.format(g.number_of_edges()))
print('# of nodes: {}'.format(g.number_of_nodes()))
# of edges: 123
# of nodes: 77Positionen: Zuerst wandelst du die Knotenpositionen in ein Dictionary um. So kannst du das Layout der Trailkarte nachbilden. Y wird negiert, um den Ursprung der Y-Achse von oben links nach unten links zu verschieben.
# Define node positions data structure (dict) for plotting
node_positions = {node[0]: (node[1]['X'], -node[1]['Y']) for node in g.nodes(data=True)}

# Preview of node_positions with a bit of hack (there is no head/slice method for dictionaries).
dict(list(node_positions.items())[0:5])
{'b_rd': (268, -1744),
 'g_rt': (908, -1378),
 'o_gy1': (1130, -1297),
 'rh_end_tt_2': (550, -1608),
 'rs_end_south': (1865, -1598)}
Farben: Dann extrahierst du die Kantenfarben in eine einfache Liste, um die Trails farblich darzustellen.
# Define data structure (list) of edge colors for plotting
edge_colors = [e[2]['color'] for e in g.edges(data=True)]

# Preview first 10
edge_colors[0:10]
['red',
 'gray',
 'yellowgreen',
 'gray',
 'yellowgreen',
 'blue',
 'black',
 'yellowgreen',
 'gray',
 'gray']
Jetzt erstellst du einen Plot, der gut mit der Trailkarte des Sleeping Giant harmoniert:
plt.figure(figsize=(8, 6))
nx.draw(g, pos=node_positions, edge_color=edge_colors, node_size=10, node_color='black')
plt.title('Graph Representation of Sleeping Giant Trail Map', size=15)
plt.show()
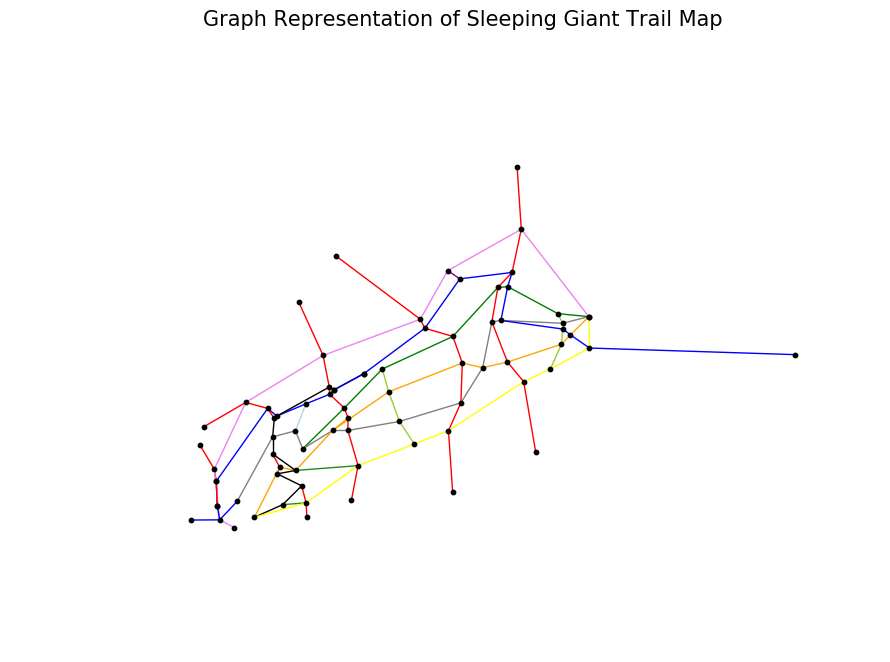
Diese Darstellung zeigt natürlich nicht jede Biegung der Trails. Das ist unkritisch: Die exakten Längen liegen im Kantenattribut distance, das für die Berechnung genutzt wird. Visuell wird die Luftlinien-Distanz zwischen Knoten (Trailkreuzungen) abgebildet – eine brauchbare Annäherung.
Wie findest du nun den kürzesten Pfad durch den Graphen?
Konzeptionell ist das Chinese Postman Problem simpel:
Finde alle Knoten mit ungeradem Grad (sehr leicht).
(Finde alle Trailkreuzungen, an denen eine ungerade Zahl an Trails zusammentrifft)
Füge Kanten hinzu, sodass alle ungeraden Knoten gerade werden. Diese zusätzlichen Kanten müssen Duplikate aus dem Originalgraphen sein (wir gehen nicht querfeldein). Die Summe der hinzugefügten Kanten soll minimal sein (schwierig… NP-schwer).
(Einfacher: Minimiere das Zurücklaufen auf einer Route, die alle Trails trifft)
Finde von einem Startpunkt aus die Euler-Tour über den augmentierten Graphen (mäßig leicht).
(Wenn klar ist, wo wir doppelt laufen, berechne die Route von Anfang bis Ende)
Mit lockereren Annahmen ließe sich eine noch kürzere, präzisere Route berechnen. Das würde aber den Rahmen sprengen – hier geht es um das CPP.
Annahme 1: Nur Pflicht-Trails
Wie die Karte zeigt, gibt es Straßen am Parkrand, die Trails verbinden könnten, besonders die roten. Es gibt auch Trails (Horseshoe und unmarkierte), die laut Giantmaster-Log nicht erforderlich sind, aber langes Zurücklaufen vermeiden könnten. Die Einbeziehung optionaler Trails ist eine bekannte Variante des CPP, das Rural Postman Problem. Wir ignorieren optionale Trails und konzentrieren uns auf Pflicht-Trails.
Annahme 2: Bergauf == bergab
Das CPP nimmt an, dass die Kosten nur von der Distanz abhängen, egal in welche Richtung man läuft. Einige Trails sind allerdings hügelig, bergauf kostet mehr Energie als bergab. Eine Metrik aus Distanz und Höhenmetern über einen gerichteten Graphen führt zur Erweiterung Windy Postman Problem.
Annahme 3: Keine parallelen Kanten (Trails)
Parallele Kanten (mehrere Trails zwischen denselben Knoten) erhöhen die Komplexität. Hier tritt es glücklicherweise nur zweimal auf (Blue <=> Red Diamond und Blue <=> Tower Trail). In der Kantenliste wird das mit einem kleinen Hack gelöst: Duplikatknoten mit dem Suffix _dupe, um alle Trails abzubilden und Kanten eindeutig zu halten. Das CPP im Paket postman_problems, das ich geschrieben habe, behandelt parallele Kanten robuster.
Das ist einfaches Zählen. 36 der 76 Knoten sind ungerade. Das sind meist Sackgassen (Grad 1) und Kreuzungen mit 3 Trails, vereinzelt Grad 5.
# Calculate list of nodes with odd degree
nodes_odd_degree = [v for v, d in g.degree_iter() if d % 2 == 1]

# Preview
nodes_odd_degree[0:5]
['rs_end_south', 'rc_end_north', 'v_end_east', 'rh_end_south', 'b_end_east']
# Counts
print('Number of nodes of odd degree: {}'.format(len(nodes_odd_degree)))
print('Number of total nodes: {}'.format(len(g.nodes())))
Number of nodes of odd degree: 36
Number of total nodes: 77
Hier steckt die Hauptarbeit. Wir teilen in 5 Teile:
Mit itertools combination erzeugst du alle möglichen Paare ungerader Knoten. Der Graph ist ungerichtet, Reihenfolge ist egal: (a,b) == (b,a).
# Compute all pairs of odd nodes. in a list of tuples
odd_node_pairs = list(itertools.combinations(nodes_odd_degree, 2))

# Preview pairs of odd degree nodes
odd_node_pairs[0:10]
[('rs_end_south', 'rc_end_north'),
 ('rs_end_south', 'v_end_east'),
 ('rs_end_south', 'rh_end_south'),
 ('rs_end_south', 'b_end_east'),
 ('rs_end_south', 'b_bv'),
 ('rs_end_south', 'rt_end_south'),
 ('rs_end_south', 'o_rt'),
 ('rs_end_south', 'y_rt'),
 ('rs_end_south', 'g_gy2'),
 ('rs_end_south', 'b_tt_3')]
# Counts
print('Number of pairs: {}'.format(len(odd_node_pairs)))
Number of pairs: 630
Prüfen wir die Zahl per Kombinatorik. Glücklicherweise sind es nur 630 Paare – die Rechenzeit ist hier vernachlässigbar (Sekunden).
Hättest du statt 36 ungeraden Knotenpaaren 3.600, gäbe es ~6,5 Mio. Paare zu optimieren. Das wäre eine ~10.000-fache Ergebnisgröße bei 100-facher Eingabegröße.
Hier beginnt die eigentliche Berechnung. Zum Glück bietet networkx eine praktische Implementierung von Dijkstras Algorithmus, um kürzeste Pfade zu finden. Wir wenden ihn auf alle 630 Paare in odd_node_pairs an.
def get_shortest_paths_distances(graph, pairs, edge_weight_name):
    """Compute shortest distance between each pair of nodes in a graph.  Return a dictionary keyed on node pairs (tuples)."""
    distances = {}
    for pair in pairs:
        distances[pair] = nx.dijkstra_path_length(graph, pair[0], pair[1], weight=edge_weight_name)
    return distances
# Compute shortest paths.  Return a dictionary with node pairs keys and a single value equal to shortest path distance.
odd_node_pairs_shortest_paths = get_shortest_paths_distances(g, odd_node_pairs, 'distance')

# Preview with a bit of hack (there is no head/slice method for dictionaries).
dict(list(odd_node_pairs_shortest_paths.items())[0:10])
{('b_bv', 'y_gy1'): 1.22,
 ('b_bw', 'rc_end_south'): 1.35,
 ('b_end_east', 'b_bw'): 3.0400000000000005,
 ('b_end_east', 'rd_end_north'): 3.83,
 ('g_gy1', 'nature_end_west'): 0.9900000000000001,
 ('o_rt', 'y_gy1'): 0.53,
 ('rc_end_north', 'rd_end_south'): 2.21,
 ('rc_end_north', 'rs_end_north'): 1.79,
 ('rs_end_north', 'o_tt'): 2.0999999999999996,
 ('w_bw', 'rd_end_north'): 1.02}
Ein vollständiger Graph verbindet jeden Knoten mit jedem anderen durch genau eine Kante.
Hier ein einfaches Beispiel aus Wikipedia: 7 Knoten, 21 Kanten (7 über 2):
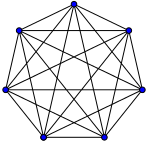
Unser Graph hat 36 Knoten und 630 Kanten mit den jeweiligen Gewichten (Distanz).
create_complete_graph übernimmt die Erstellung. Der Parameter flip_weights wandelt distance ins Attribut weight um, indem kleine Distanzen große Gewichte werden und umgekehrt. Das klingt kontraintuitiv, ist aber für Schritt 2.4 nötig, wo wir das Maximum- statt Minimum-Weight-Matching von NetworkX nutzen.
Ideal wäre ein Minimum-Weight-Matching, NetworkX bietet aber nur max_weight_matching. Mit dem Trick, die distance zu negieren, wird minimieren zu maximieren – die Reihenfolge bleibt erhalten, nur umgekehrt.
def create_complete_graph(pair_weights, flip_weights=True):
    """
    Create a completely connected graph using a list of vertex pairs and the shortest path distances between them
    Parameters:
        pair_weights: list[tuple] from the output of get_shortest_paths_distances
        flip_weights: Boolean. Should we negate the edge attribute in pair_weights?
    """
    g = nx.Graph()
    for k, v in pair_weights.items():
        wt_i = - v if flip_weights else v
        g.add_edge(k[0], k[1], attr_dict={'distance': v, 'weight': wt_i})
    return g
# Generate the complete graph
g_odd_complete = create_complete_graph(odd_node_pairs_shortest_paths, flip_weights=True)

# Counts
print('Number of nodes: {}'.format(len(g_odd_complete.nodes())))
print('Number of edges: {}'.format(len(g_odd_complete.edges())))
Number of nodes: 36
Number of edges: 630
Zur Veranschaulichung plotten wir den vollständig verbundenen Graphen der ungeraden Knoten. Die X-/Y-Positionen bleiben erhalten, aber die Kanten entsprechen nicht zwingend echten Trails. Zwei Knoten können hier direkt verbunden sein, während der reale kürzeste Pfad fünf Zwischenschritte über gerade Knoten hat (hier nicht gezeigt).
# Plot the complete graph of odd-degree nodes
plt.figure(figsize=(8, 6))
pos_random = nx.random_layout(g_odd_complete)
nx.draw_networkx_nodes(g_odd_complete, node_positions, node_size=20, node_color="red")
nx.draw_networkx_edges(g_odd_complete, node_positions, alpha=0.1)
plt.axis('off')
plt.title('Complete Graph of Odd-degree Nodes')
plt.show()
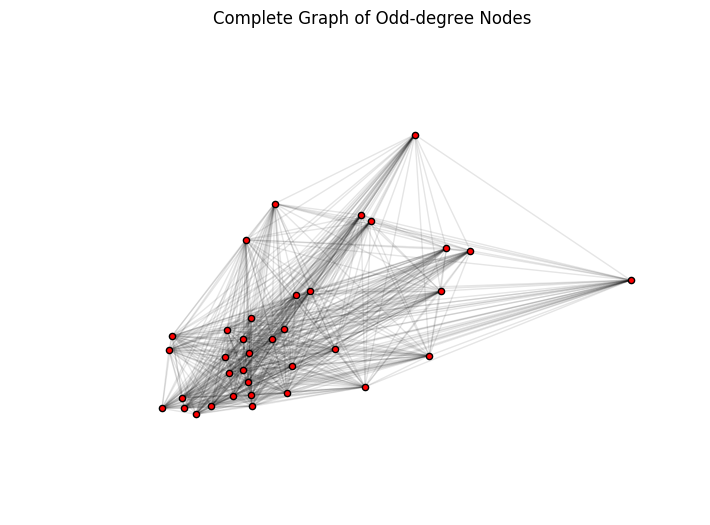
Das ist der komplexeste Schritt. Wir müssen die Paare ungerader Knoten finden, deren Gesamtdistanz minimal ist. Konkret wählen wir die optimalen 18 Kanten (36 ungerade Knoten / 2) aus dem „Haarknäuel“ aus Schritt 2.3.
Die Implementation und die Intuition dahinter sind umfangreich – 800+ Zeilen Code und eine Menge Fachliteratur.
Ein kurzer Exkurs für Interessierte:
Großen Dank an Joris van Rantwijk für die ursprüngliche Implementierung auf seinem Blog 2008. Ich bin ähnlich in das Problem gestolpert. Aus Joris’ Post von 2008:
Since I did not find any Perl implementations of maximum weighted matching, I lightly decided to write some code myself. It turned out that I had underestimated the problem, but by the time I realized my mistake, I was so obsessed with the problem that I refused to give up.
Ich habe aufgegeben. Zum Glück Joris nicht.
Diese Maximum-Weight-Matching-Implementierung ist inzwischen Teil von NetworkX. Danke auch an die 10+ Mitwirkenden auf GitHub, die den Code pflegen.
Das ist harte Rechenarbeit. Den Durchbruch 1965 lieferte Jack Edmonds, der zeigte, dass das Maximum-Matching-Problem in Polynomialzeit lösbar ist: "Paths, trees, and flowers" [1]. Darauf baut seither viel Literatur auf. Die in NetworkX genutzte Funktion max_weight_matching basiert auf Galil, Zvi (1986) [2] mit einem O(n3)-Algorithmus.
# Compute min weight matching.
# Note: max_weight_matching uses the 'weight' attribute by default as the attribute to maximize.
odd_matching_dupes = nx.algorithms.max_weight_matching(g_odd_complete, True)

print('Number of edges in matching: {}'.format(len(odd_matching_dupes)))
Number of edges in matching: 36
Die Ausgabe (odd_matching_dupes) ist ein Dictionary. Obwohl 36 Kanten enthalten sind, brauchen wir nur 18, weil jedes Paar doppelt auftaucht (einmal mit Knoten 1 als Key, einmal mit Knoten 2).
# Preview of matching with dupes
odd_matching_dupes
{'b_bv': 'v_bv',
 'b_bw': 'rh_end_tt_1',
 'b_end_east': 'g_gy2',
 'b_end_west': 'rd_end_south',
 'b_tt_3': 'rt_end_north',
 'b_v': 'v_end_west',
 'g_gy1': 'rc_end_north',
 'g_gy2': 'b_end_east',
 'g_w': 'w_bw',
 'nature_end_west': 'o_y_tt_end_west',
 'o_rt': 'o_w_1',
 'o_tt': 'rh_end_tt_2',
 'o_w_1': 'o_rt',
 'o_y_tt_end_west': 'nature_end_west',
 'rc_end_north': 'g_gy1',
 'rc_end_south': 'y_gy1',
 'rd_end_north': 'rh_end_north',
 'rd_end_south': 'b_end_west',
 'rh_end_north': 'rd_end_north',
 'rh_end_south': 'y_rh',
 'rh_end_tt_1': 'b_bw',
 'rh_end_tt_2': 'o_tt',
 'rh_end_tt_3': 'rh_end_tt_4',
 'rh_end_tt_4': 'rh_end_tt_3',
 'rs_end_north': 'v_end_east',
 'rs_end_south': 'y_gy2',
 'rt_end_north': 'b_tt_3',
 'rt_end_south': 'y_rt',
 'v_bv': 'b_bv',
 'v_end_east': 'rs_end_north',
 'v_end_west': 'b_v',
 'w_bw': 'g_w',
 'y_gy1': 'rc_end_south',
 'y_gy2': 'rs_end_south',
 'y_rh': 'rh_end_south',
 'y_rt': 'rt_end_south'}
Wir wandeln in eine Liste von Tupeln um, da der Graph ungerichtet ist. Nach Deduplizierung bleiben die 18 einzigartigen Paare mit minimaler Gesamtdistanz.
# Convert matching to list of deduped tuples
odd_matching = list(pd.unique([tuple(sorted([k, v])) for k, v in odd_matching_dupes.items()]))

# Counts
print('Number of edges in matching (deduped): {}'.format(len(odd_matching)))
Number of edges in matching (deduped): 18
# Preview of deduped matching
odd_matching
[('rs_end_south', 'y_gy2'),
 ('b_end_west', 'rd_end_south'),
 ('b_bv', 'v_bv'),
 ('rh_end_tt_3', 'rh_end_tt_4'),
 ('b_bw', 'rh_end_tt_1'),
 ('o_tt', 'rh_end_tt_2'),
 ('g_w', 'w_bw'),
 ('b_end_east', 'g_gy2'),
 ('nature_end_west', 'o_y_tt_end_west'),
 ('g_gy1', 'rc_end_north'),
 ('o_rt', 'o_w_1'),
 ('rs_end_north', 'v_end_east'),
 ('rc_end_south', 'y_gy1'),
 ('rh_end_south', 'y_rh'),
 ('rt_end_south', 'y_rt'),
 ('b_tt_3', 'rt_end_north'),
 ('rd_end_north', 'rh_end_north'),
 ('b_v', 'v_end_west')]
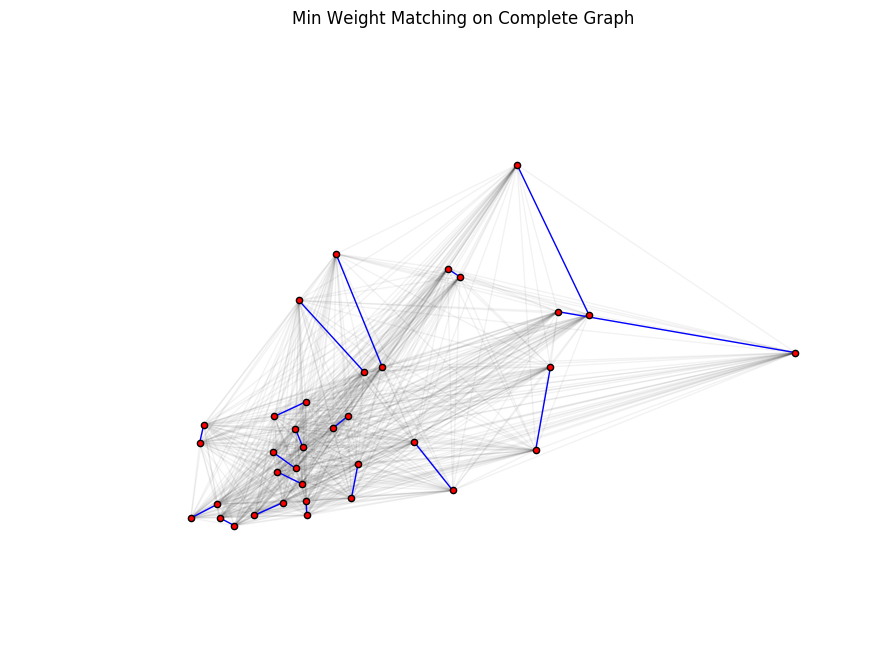
Visualisieren wir diese Paare auf dem vollständigen Graphen aus 2.3. Wie zuvor repräsentieren die Knotenpositionen den realen Graphen (Trailkarte), die blauen Kanten allerdings Luftlinie. Der tatsächliche kürzeste Pfad kann mehrere, gewundene Kanten umfassen.
plt.figure(figsize=(8, 6))

# Plot the complete graph of odd-degree nodes
nx.draw(g_odd_complete, pos=node_positions, node_size=20, alpha=0.05)

# Create a new graph to overlay on g_odd_complete with just the edges from the min weight matching
g_odd_complete_min_edges = nx.Graph(odd_matching)
nx.draw(g_odd_complete_min_edges, pos=node_positions, node_size=20, edge_color='blue', node_color='red')

plt.title('Min Weight Matching on Complete Graph')
plt.show()
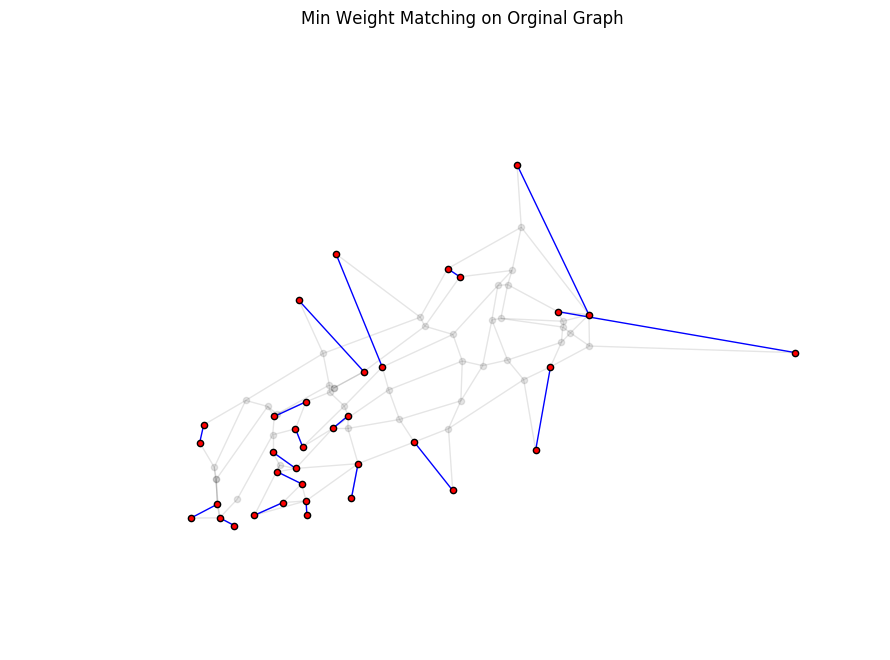
Um den Bezug zum Originalgraphen zu zeigen, plotten wir die gleichen Minimalpaare (blau) über die Trailkarte (ausgeblendet). Beachte: Blau ist „querfeldein“ (Luftlinie, keine echten Trails). In Schritt 3. ersetzen wir diese durch tatsächliche kürzeste Wege.
plt.figure(figsize=(8, 6))

# Plot the original trail map graph
nx.draw(g, pos=node_positions, node_size=20, alpha=0.1, node_color='black')

# Plot graph to overlay with just the edges from the min weight matching
nx.draw(g_odd_complete_min_edges, pos=node_positions, node_size=20, alpha=1, node_color='red', edge_color='blue')

plt.title('Min Weight Matching on Orginal Graph')
plt.show()
Nun ergänzen wir den Originalgraphen um die Kanten aus 2.4. Die folgende Funktion fügt sie hinzu und markiert sie als aus dem augmentierten Graphen stammend. Das brauchen wir in 3., wenn wir die Euler-Tour konstruieren.
def add_augmenting_path_to_graph(graph, min_weight_pairs):
    """
    Add the min weight matching edges to the original graph
    Parameters:
        graph: NetworkX graph (original graph from trailmap)
        min_weight_pairs: list[tuples] of node pairs from min weight matching
    Returns:
        augmented NetworkX graph
    """

    # We need to make the augmented graph a MultiGraph so we can add parallel edges
    graph_aug = nx.MultiGraph(graph.copy())
    for pair in min_weight_pairs:
        graph_aug.add_edge(pair[0],
                           pair[1],
                           attr_dict={'distance': nx.dijkstra_path_length(graph, pair[0], pair[1]),
                                      'trail': 'augmented'}
                          )
    return graph_aug
Prüfen wir, dass 18 Kanten hinzugekommen sind:
# Create augmented graph: add the min weight matching edges to g
g_aug = add_augmenting_path_to_graph(g, odd_matching)

# Counts
print('Number of edges in original graph: {}'.format(len(g.edges())))
print('Number of edges in augmented graph: {}'.format(len(g_aug.edges())))
Number of edges in original graph: 123
Number of edges in augmented graph: 141
Und dass nun alle Knoten geraden Grad haben:
pd.value_counts(g_aug.degree())
4    54
2    18
6     5
dtype: int64
Jetzt, da alle Knoten geraden Grad haben, ist die schwere Optimierung geschafft. Wie Euler 1736 im Problem der Sieben Brücken von Königsberg postulierte (später in den 1870ern von Carl Hierholzer formal bewiesen): Es existiert ein Pfad, der jede Kante genau einmal besucht, wenn alle Knoten geraden Grad haben.
Es gibt viele Euler-Touren mit gleicher Distanz. Mit NetworkX’ eulerian_circuit kommst du 90% ans Ziel. Es gibt jedoch Einschränkungen.
Einschränkungen, die wir beheben:
Der augmentierte Graph enthält Kanten, die es im Original nicht gab. Für die Tour ohne Querfeldeinlauf müssen diese durch die kürzesten Pfade über echte Kanten ersetzt werden.
eulerian_circuit liefert nur die Besuchsreihenfolge der Knoten, nicht die Kantenattribute. Die brauchen wir, um zu wissen, welche Kanten bereits begangen wurden, wenn mehrere Kanten zwischen zwei Knoten existieren.
Einschränkung, die wir nicht beheben:
Starten wir mit der einfachen, aber noch unvollständigen Lösung:
naive_euler_circuit = list(nx.eulerian_circuit(g_aug, source='b_end_east'))
Wie erwartet ist die Länge der naiven Euler-Tour gleich der Anzahl der Kanten im augmentierten Graphen.
print('Length of eulerian circuit: {}'.format(len(naive_euler_circuit)))
Length of eulerian circuit: 141
Die Ausgabe ist eine Liste von Tupeln, die Knotenpaare darstellen. Der erste Knoten jedes Paares ist identisch mit dem zweiten Knoten des vorherigen Paares.
# Preview naive Euler circuit
naive_euler_circuit[0:10]
[('b_end_east', 'g_gy2'),
 ('g_gy2', 'b_g'),
 ('b_g', 'b_w'),
 ('b_w', 'b_gy2'),
 ('b_gy2', 'w_gy2'),
 ('w_gy2', 'b_w'),
 ('b_w', 'w_rs'),
 ('w_rs', 'g_rs'),
 ('g_rs', 'b_g'),
 ('b_g', 'b_rs')]
Jetzt definieren wir eine Funktion, die mithilfe des Originalgraphen angibt, welche Trails du zwischen zwei Knoten nutzen sollst. Der Code ist ausführlich, die Logik einfach: Wir transformieren die naive Tour (mit Kanten, die im Original fehlen) in eine Euler-Tour, die nur Originalkanten nutzt.
Wir gehen jede Kante in naive_euler_circuit durch. Wo die Kante im Original nicht existiert, ersetzen wir sie durch die Kantenfolge des kürzesten Pfads im Originalgraphen.
def create_eulerian_circuit(graph_augmented, graph_original, starting_node=None):
    """Create the eulerian path using only edges from the original graph."""
    euler_circuit = []
    naive_circuit = list(nx.eulerian_circuit(graph_augmented, source=starting_node))

    for edge in naive_circuit:
        edge_data = graph_augmented.get_edge_data(edge[0], edge[1])

        if edge_data[0]['trail'] != 'augmented':
            # If `edge` exists in original graph, grab the edge attributes and add to eulerian circuit.
            edge_att = graph_original[edge[0]][edge[1]]
            euler_circuit.append((edge[0], edge[1], edge_att))
        else:
            aug_path = nx.shortest_path(graph_original, edge[0], edge[1], weight='distance')
            aug_path_pairs = list(zip(aug_path[:-1], aug_path[1:]))

            print('Filling in edges for augmented edge: {}'.format(edge))
            print('Augmenting path: {}'.format(' => '.join(aug_path)))
            print('Augmenting path pairs: {}\n'.format(aug_path_pairs))

            # If `edge` does not exist in original graph, find the shortest path between its nodes and
            #  add the edge attributes for each link in the shortest path.
            for edge_aug in aug_path_pairs:
                edge_aug_att = graph_original[edge_aug[0]][edge_aug[1]]
                euler_circuit.append((edge_aug[0], edge_aug[1], edge_aug_att))

    return euler_circuit
Einschränkung 3 umgehen wir pragmatisch, indem wir im äußersten Osten des Parks auf dem Blue Trail starten (Knoten „b_end_east“). Beim Laufen kannst du die letzte Anweisung, die dorthin zurückführt, einfach auslassen.
Ausführliche Prints zeigen, wie nicht vorhandene Kanten durch kürzeste Pfade mit echten Kanten ersetzt werden.
# Create the Eulerian circuit
euler_circuit = create_eulerian_circuit(g_aug, g, 'b_end_east')
Filling in edges for augmented edge: ('b_end_east', 'g_gy2')
Augmenting path: b_end_east => b_y => b_o => b_gy2 => w_gy2 => g_gy2
Augmenting path pairs: [('b_end_east', 'b_y'), ('b_y', 'b_o'), ('b_o', 'b_gy2'), ('b_gy2', 'w_gy2'), ('w_gy2', 'g_gy2')]

Filling in edges for augmented edge: ('b_bw', 'rh_end_tt_1')
Augmenting path: b_bw => b_tt_1 => rh_end_tt_1
Augmenting path pairs: [('b_bw', 'b_tt_1'), ('b_tt_1', 'rh_end_tt_1')]

Filling in edges for augmented edge: ('b_tt_3', 'rt_end_north')
Augmenting path: b_tt_3 => b_tt_2 => tt_rt => v_rt => rt_end_north
Augmenting path pairs: [('b_tt_3', 'b_tt_2'), ('b_tt_2', 'tt_rt'), ('tt_rt', 'v_rt'), ('v_rt', 'rt_end_north')]

Filling in edges for augmented edge: ('rc_end_north', 'g_gy1')
Augmenting path: rc_end_north => v_rc => b_rc => g_rc => g_gy1
Augmenting path pairs: [('rc_end_north', 'v_rc'), ('v_rc', 'b_rc'), ('b_rc', 'g_rc'), ('g_rc', 'g_gy1')]

Filling in edges for augmented edge: ('y_gy1', 'rc_end_south')
Augmenting path: y_gy1 => y_rc => rc_end_south
Augmenting path pairs: [('y_gy1', 'y_rc'), ('y_rc', 'rc_end_south')]

Filling in edges for augmented edge: ('b_end_west', 'rd_end_south')
Augmenting path: b_end_west => b_v => rd_end_south
Augmenting path pairs: [('b_end_west', 'b_v'), ('b_v', 'rd_end_south')]

Filling in edges for augmented edge: ('rh_end_north', 'rd_end_north')
Augmenting path: rh_end_north => v_rh => v_rd => rd_end_north
Augmenting path pairs: [('rh_end_north', 'v_rh'), ('v_rh', 'v_rd'), ('v_rd', 'rd_end_north')]

Filling in edges for augmented edge: ('v_end_east', 'rs_end_north')
Augmenting path: v_end_east => v_rs => rs_end_north
Augmenting path pairs: [('v_end_east', 'v_rs'), ('v_rs', 'rs_end_north')]

Filling in edges for augmented edge: ('y_gy2', 'rs_end_south')
Augmenting path: y_gy2 => y_rs => rs_end_south
Augmenting path pairs: [('y_gy2', 'y_rs'), ('y_rs', 'rs_end_south')]
Die Euler-Tour ist länger als die naive – logisch.
print('Length of Eulerian circuit: {}'.format(len(euler_circuit)))
Length of Eulerian circuit: 158
Hier die Lösung als Textausgabe:
# Preview first 20 directions of CPP solution
for i, edge in enumerate(euler_circuit[0:20]):
    print(i, edge)
0 ('b_end_east', 'b_y', {'color': 'blue', 'estimate': 0, 'trail': 'b', 'distance': 1.32})
1 ('b_y', 'b_o', {'color': 'blue', 'estimate': 0, 'trail': 'b', 'distance': 0.08})
2 ('b_o', 'b_gy2', {'color': 'blue', 'estimate': 1, 'trail': 'b', 'distance': 0.05})
3 ('b_gy2', 'w_gy2', {'color': 'yellowgreen', 'estimate': 1, 'trail': 'gy2', 'distance': 0.03})
4 ('w_gy2', 'g_gy2', {'color': 'yellowgreen', 'estimate': 0, 'trail': 'gy2', 'distance': 0.05})
5 ('g_gy2', 'b_g', {'color': 'green', 'estimate': 0, 'trail': 'g', 'distance': 0.45})
6 ('b_g', 'b_w', {'color': 'blue', 'estimate': 0, 'trail': 'b', 'distance': 0.16})
7 ('b_w', 'b_gy2', {'color': 'blue', 'estimate': 0, 'trail': 'b', 'distance': 0.41})
8 ('b_gy2', 'w_gy2', {'color': 'yellowgreen', 'estimate': 1, 'trail': 'gy2', 'distance': 0.03})
9 ('w_gy2', 'b_w', {'color': 'gray', 'estimate': 0, 'trail': 'w', 'distance': 0.42})
10 ('b_w', 'w_rs', {'color': 'gray', 'estimate': 1, 'trail': 'w', 'distance': 0.06})
11 ('w_rs', 'g_rs', {'color': 'red', 'estimate': 0, 'trail': 'rs', 'distance': 0.18})
12 ('g_rs', 'b_g', {'color': 'green', 'estimate': 1, 'trail': 'g', 'distance': 0.05})
13 ('b_g', 'b_rs', {'color': 'blue', 'estimate': 0, 'trail': 'b', 'distance': 0.07})
14 ('b_rs', 'g_rs', {'color': 'red', 'estimate': 0, 'trail': 'rs', 'distance': 0.11})
15 ('g_rs', 'g_rc', {'color': 'green', 'estimate': 0, 'trail': 'g', 'distance': 0.45})
16 ('g_rc', 'g_gy1', {'color': 'green', 'estimate': 0, 'trail': 'g', 'distance': 0.37})
17 ('g_gy1', 'g_rt', {'color': 'green', 'estimate': 0, 'trail': 'g', 'distance': 0.26})
18 ('g_rt', 'g_w', {'color': 'green', 'estimate': 0, 'trail': 'g', 'distance': 0.31})
19 ('g_w', 'o_w_1', {'color': 'gray', 'estimate': 0, 'trail': 'w', 'distance': 0.18})
Man sieht schnell: Der Algorithmus bleibt keinem Trail lange treu, sondern springt zügig. Eine Erweiterung könnte „Trail-Treue“ in die Zielfunktion integrieren, um die Route lauffreundlicher zu machen.
Werfen wir einen Blick, ob die Lösung plausibel wirkt.
(Der ausführliche Code ist hier weniger wichtig als die Ausgabe)
# Computing some stats
total_mileage_of_circuit = sum([edge[2]['distance'] for edge in euler_circuit])
total_mileage_on_orig_trail_map = sum(nx.get_edge_attributes(g, 'distance').values())
_vcn = pd.value_counts(pd.value_counts([(e[0]) for e in euler_circuit]), sort=False)
node_visits = pd.DataFrame({'n_visits': _vcn.index, 'n_nodes': _vcn.values})
_vce = pd.value_counts(pd.value_counts([sorted(e)[0] + sorted(e)[1] for e in nx.MultiDiGraph(euler_circuit).edges()]))
edge_visits = pd.DataFrame({'n_visits': _vce.index, 'n_edges': _vce.values})

# Printing stats
print('Mileage of circuit: {0:.2f}'.format(total_mileage_of_circuit))
print('Mileage on original trail map: {0:.2f}'.format(total_mileage_on_orig_trail_map))
print('Mileage retracing edges: {0:.2f}'.format(total_mileage_of_circuit-total_mileage_on_orig_trail_map))
print('Percent of mileage retraced: {0:.2f}%\n'.format((1-total_mileage_of_circuit/total_mileage_on_orig_trail_map)*-100))

print('Number of edges in circuit: {}'.format(len(euler_circuit)))
print('Number of edges in original graph: {}'.format(len(g.edges())))
print('Number of nodes in original graph: {}\n'.format(len(g.nodes())))

print('Number of edges traversed more than once: {}\n'.format(len(euler_circuit)-len(g.edges())))

print('Number of times visiting each node:')
print(node_visits.to_string(index=False))

print('\nNumber of times visiting each edge:')
print(edge_visits.to_string(index=False))
Mileage of circuit: 33.59
Mileage on original trail map: 25.76
Mileage retracing edges: 7.83
Percent of mileage retraced: 30.40%

Number of edges in circuit: 158
Number of edges in original graph: 123
Number of nodes in original graph: 77

Number of edges traversed more than once: 35

Number of times visiting each node:
n_nodes  n_visits
     18         1
     38         2
     20         3
      1         4

Number of times visiting each edge:
n_edges  n_visits
     88         1
     35         2
NetworkX kann Graphen auch visualisieren, ist dabei aber bewusst zurückhaltend:
NetworkX provides basic functionality for visualizing graphs, but its main goal is to enable graph analysis rather than perform graph visualization. In the future, graph visualization functionality may be removed from NetworkX or only available as an add-on package.
Proper graph visualization is hard, and we highly recommend that people visualize their graphs with tools dedicated to that task. Notable examples of dedicated and fully-featured graph visualization tools are Cytoscape, Gephi, Graphviz and, for LaTeX typesetting, PGF/TikZ.
Trotzdem reicht die NetworkX-Zeichenfunktion mit matplotlib fürs Erkunden einfacher Graphen, daher bleiben wir in diesem Tutorial bei draw.
Ich habe graphviz und die dot-Sprache genutzt, um die Lösung in meinem Python-Paket postman_problems zu visualisieren. Der Umbau der NetworkX-Struktur in dot kostete etwas Mühe, ermöglicht aber deutlich mehr Kontrolle und Qualität.
Als Erstes wandelst du die Kantenliste der Euler-Tour in eine für den Plot passende Kantenliste um.
create_cpp_edgelist erzeugt eine Kantenliste mit Zusatzattributen für die Visualisierung:
def create_cpp_edgelist(euler_circuit):
    """
    Create the edgelist without parallel edge for the visualization
    Combine duplicate edges and keep track of their sequence and # of walks
    Parameters:
        euler_circuit: list[tuple] from create_eulerian_circuit
    """
    cpp_edgelist = {}

    for i, e in enumerate(euler_circuit):
        edge = frozenset([e[0], e[1]])

        if edge in cpp_edgelist:
            cpp_edgelist[edge][2]['sequence'] += ', ' + str(i)
            cpp_edgelist[edge][2]['visits'] += 1

        else:
            cpp_edgelist[edge] = e
            cpp_edgelist[edge][2]['sequence'] = str(i)
            cpp_edgelist[edge][2]['visits'] = 1

    return list(cpp_edgelist.values())
Erstellen wir die CPP-Kantenliste:
cpp_edgelist = create_cpp_edgelist(euler_circuit)
Wie erwartet hat sie die gleiche Anzahl Kanten wie der Originalgraph.
print('Number of edges in CPP edge list: {}'.format(len(cpp_edgelist)))
Number of edges in CPP edge list: 123
Die CPP-Kantenliste ähnelt euler_circuit, hat aber zusätzliche Attribute.
# Preview CPP plot-friendly edge list
cpp_edgelist[0:3]
[('rh_end_tt_4',
  'nature_end_west',
  {'color': 'black',
   'distance': 0.2,
   'estimate': 0,
   'sequence': '73',
   'trail': 'tt',
   'visits': 1}),
 ('rd_end_south',
  'b_rd',
  {'color': 'red',
   'distance': 0.13,
   'estimate': 0,
   'sequence': '95',
   'trail': 'rd',
   'visits': 1}),
 ('w_gy1',
  'w_rc',
  {'color': 'gray',
   'distance': 0.33,
   'estimate': 0,
   'sequence': '151',
   'trail': 'w',
   'visits': 1})]
Nun bauen wir den Graphen:
# Create CPP solution graph
g_cpp = nx.Graph(cpp_edgelist)
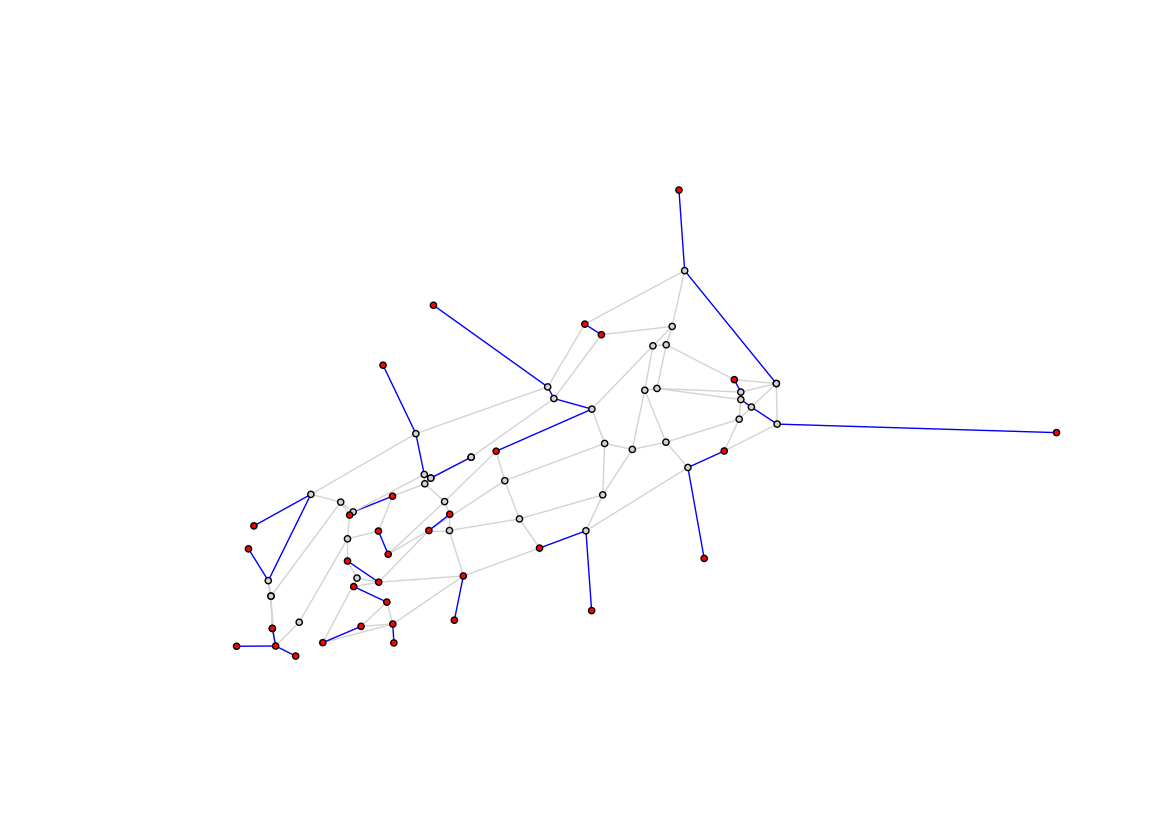
Hier zeigen wir, welche Kanten einmal (grau) und welche mehrfach (blau) begangen werden. Das ist die „korrekte“ Variante der Visualisierung aus 2.4 (dort waren die roten Luftlinien zwischen ungeraden Paaren zu sehen). Jetzt sind die Luftlinien durch tatsächliche kürzeste Pfade ersetzt.
Wenn die Optimierung gut ist, sollten die blauen Kanten die minimal nötige Zusatzdistanz darstellen, um ein Matching der ungeraden Knoten zu erzeugen.
plt.figure(figsize=(14, 10))

visit_colors = {1:'lightgray', 2:'blue'}
edge_colors = [visit_colors[e[2]['visits']] for e in g_cpp.edges(data=True)]
node_colors = ['red'  if node in nodes_odd_degree else 'lightgray' for node in g_cpp.nodes()]

nx.draw_networkx(g_cpp, pos=node_positions, node_size=20, node_color=node_colors, edge_color=edge_colors, with_labels=False)
plt.axis('off')
plt.show()
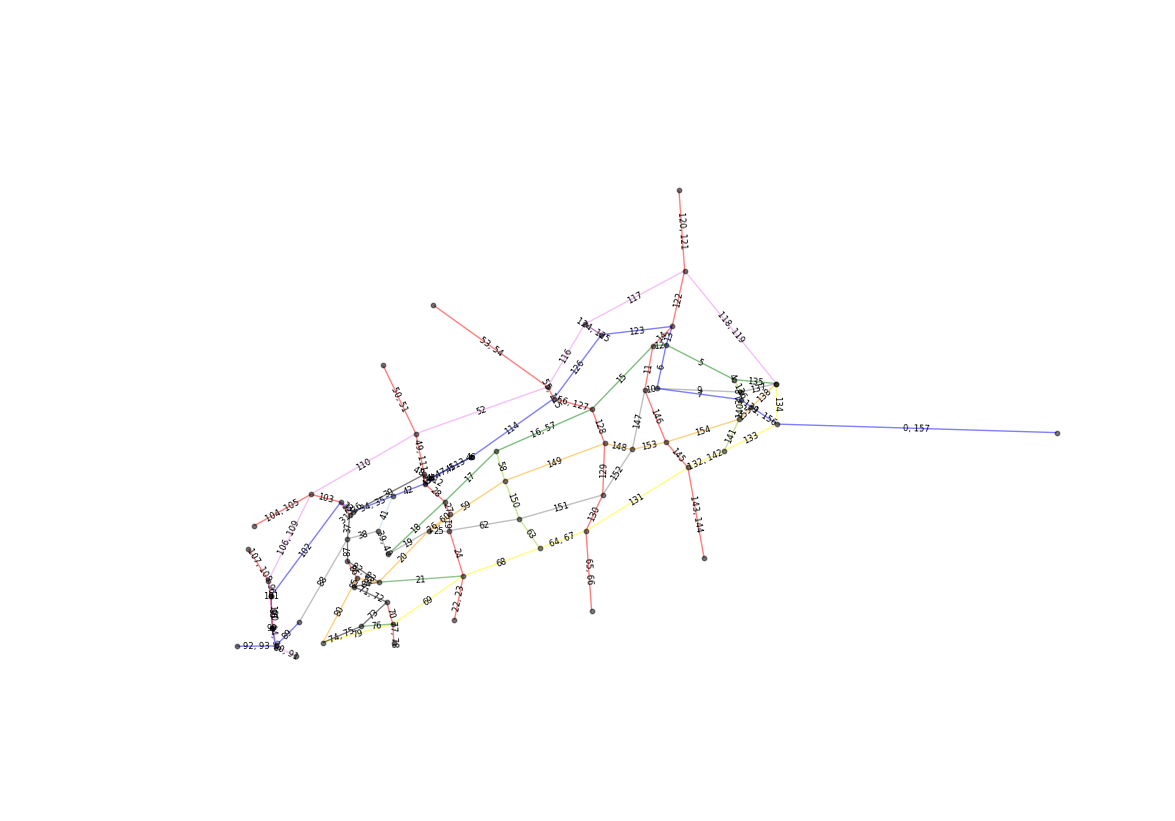
Hier plotten wir den Originalgraphen (Trailkarte) mit den Sequenznummern, in denen die Trails laut CPP-Lösung begangen werden. Mehrere Nummern bedeuten, dass wir zurücklaufen müssen.
Du startest unten rechts auf dem Blue Trail (0. und 157. Schritt).
plt.figure(figsize=(14, 10))

edge_colors = [e[2]['color'] for e in g_cpp.edges(data=True)]
nx.draw_networkx(g_cpp, pos=node_positions, node_size=10, node_color='black', edge_color=edge_colors, with_labels=False, alpha=0.5)

bbox = {'ec':[1,1,1,0], 'fc':[1,1,1,0]}  # hack to label edges over line (rather than breaking up line)
edge_labels = nx.get_edge_attributes(g_cpp, 'sequence')
nx.draw_networkx_edge_labels(g_cpp, pos=node_positions, edge_labels=edge_labels, bbox=bbox, font_size=6)

plt.axis('off')
plt.show()
Unten ist eine Animation der Euler-Tour vom Start bis zum Ende. Kanten werden beim ersten Begehen schwarz und beim zweiten Mal rot eingefärbt.
Beachte: Das GIF zeigt überlagerte oder sehr kurze Kanten nicht immer ideal. Eine robustere Bibliothek wie graphviz könnte Splines statt gerader Linien zeichnen.
Der Code dazu dient als Referenz.

Zuerst erzeugen wir für jede Anweisung (jede begangene Kante) ein PNG.
visit_colors = {1:'black', 2:'red'}
edge_cnter = {}
g_i_edge_colors = []
for i, e in enumerate(euler_circuit, start=1):

    edge = frozenset([e[0], e[1]])
    if edge in edge_cnter:
        edge_cnter[edge] += 1
    else:
        edge_cnter[edge] = 1

    # Full graph (faded in background)
    nx.draw_networkx(g_cpp, pos=node_positions, node_size=6, node_color='gray', with_labels=False, alpha=0.07)

    # Edges walked as of iteration i
    euler_circuit_i = copy.deepcopy(euler_circuit[0:i])
    for i in range(len(euler_circuit_i)):
        edge_i = frozenset([euler_circuit_i[i][0], euler_circuit_i[i][1]])
        euler_circuit_i[i][2]['visits_i'] = edge_cnter[edge_i]
    g_i = nx.Graph(euler_circuit_i)
    g_i_edge_colors = [visit_colors[e[2]['visits_i']] for e in g_i.edges(data=True)]

    nx.draw_networkx_nodes(g_i, pos=node_positions, node_size=6, alpha=0.6, node_color='lightgray', with_labels=False, linewidths=0.1)
    nx.draw_networkx_edges(g_i, pos=node_positions, edge_color=g_i_edge_colors, alpha=0.8)

    plt.axis('off')
    plt.savefig('fig/png/img{}.png'.format(i), dpi=120, bbox_inches='tight')
    plt.close()
Dann werden die PNGs zu einem GIF zusammengesetzt.
Die PNGs werden von 0 bis 157 sortiert und mit imageio bei 3 fps zu einem GIF verbunden.
import glob
import numpy as np
import imageio
import os

def make_circuit_video(image_path, movie_filename, fps=5):
    # sorting filenames in order
    filenames = glob.glob(image_path + 'img*.png')
    filenames_sort_indices = np.argsort([int(os.path.basename(filename).split('.')[0][3:]) for filename in filenames])
    filenames = [filenames[i] for i in filenames_sort_indices]

    # make movie
    with imageio.get_writer(movie_filename, mode='I', fps=fps) as writer:
        for filename in filenames:
            image = imageio.imread(filename)
            writer.append_data(image)

make_circuit_video('fig/png/', 'fig/gif/cpp_route_animation.gif', fps=3)Glückwunsch, du hast das Chinese Postman Problem in Python gelöst. In diesem Tutorial hast du viel Strecke gemacht (genau 33,6 Meilen Trails). Für einen tieferen Einstieg in Netzwerk-Grundlagen empfehlen wir den Datacamp-Kurs Network Analysis in Python, der die Kernkonzepte ausführlicher behandelt.
Sieh dir auch die NetworkX-Dokumentation an, um mehr über das Erstellen, Bearbeiten und Traversieren komplexer Netzwerke zu lernen. Die Doku ist umfassend, mit vielen Beispielen und einer Reihe von Tutorials.
Wenn du das CPP auf deinem eigenen Graphen lösen willst, findest du die Funktionalität aus diesem Tutorial im Python-Paket postman_problems auf Github. Du kannst die Code-Blöcke aus diesem Tutorial auch mit anderen Kanten- und Knotenlisten kombinieren – mit dem Paket geht es meist schneller und sauberer.
Irgendwann plane ich, die CPP-Erweiterungen (Rural und Windy Postman Problem) hier ebenfalls zu implementieren. Außerdem will ich über diese Erweiterungen und Erfahrungen auf den Trails in meinem Blog hier schreiben. Eine weitere Idee: Längen-/Breitengrade einbinden, um Turn-by-Turn-Anweisungen an meine Garmin-Uhr zu senden.
Und natürlich der letzte Schritt: rausgehen und die Route laufen!
Wenn du mehr über Netzwerke in Python lernen möchtest, sieh dir diese DataCamp-Kurse an:
Introduction to Network Analysis in Python
Intermediate Network Analysis in Python
1: Edmonds, Jack (1965). "Paths, trees, and flowers". Canad. J. Math. 17: 449–467.
2: Galil, Z. (1986). "Efficient algorithms for finding maximum matching in graphs". ACM Computing Surveys. Vol. 18, No. 1: 23-38.
Erfahre mehr über Python
Kurs
Kurs
Kurs
Tutorial
DataCamp Team
5 Min.
Tutorial
Adel Nehme
6 Min.
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
DataCamp Team
3 Min.
Tutorial
Matt Crabtree
5 Min.