Corso
Introduzione all'analisi delle reti in Python
4 ore
74.5K
Con questo tutorial affronterai un problema classico della teoria dei grafi chiamato Chinese Postman Problem. Alcune componenti dell’algoritmo, pur essendo concettualmente semplici, risultano computazionalmente impegnative. Tuttavia, per seguire questo tutorial ti basta conoscere un po’ di Python: non servono basi rigorose di matematica, informatica o teoria dei grafi.
Il tutorial partirà dai mattoni di base dei grafi (nodi, archi, cammini, ecc.) e risolverà il problema su un grafo reale (la rete di sentieri di un parco statale) usando la libreria NetworkX in Python. Ci concentreremo sui concetti chiave e sull’implementazione. Per chi volesse approfondire, sono indicati riferimenti per capire meglio i dettagli dell’ottimizzazione.
Probabilmente hai sentito parlare del Problema del commesso viaggiatore, che consiste nel trovare il percorso più corto (ad esempio, tra strade) che collega un insieme di nodi (ad esempio, città). Meno noto ma molto simile è il Chinese Postman Problem (CPP), chiamato anche problema dell’ispezione dei percorsi o dell’instradamento sugli archi. L’obiettivo del CPP è trovare il percorso più breve che copra tutti i collegamenti (strade) di un grafo almeno una volta. Se questo è possibile senza ripassare due volte sulla stessa strada, ottimo: è lo scenario ideale e il problema è piuttosto semplice. Se invece alcune strade devono essere percorse più di una volta, serve un po’ di matematica per trovare il percorso più corto che tocchi ogni strada almeno una volta con il minor chilometraggio totale.
(Quanto segue è una nota personale: un po’ zuccherosa, birichina e al 100% non necessaria per imparare l’ottimizzazione su grafi in Python)
Ho avuto un’applicazione reale di questo problema: ottenere il grado di Giantmaster Marathoner.
Cos’è un Giantmaster? Un Giantmaster è chi (canide o umano) ha percorso tutti i sentieri dello Sleeping Giant State Park a Hamden, CT (vicino alla mia città natale, Wallingford)... nell’arco della propria vita. Un Giantmaster Marathoner è chi ha percorso tutti questi sentieri in un solo giorno.
Grazie al meticoloso archivio della Sleeping Giant Park Association, l’elenco completo dei Giantmaster e del loro livello di Giantmastering si trova qui. Devo ammettere che questo mi ha dato non poca motivazione per avviare il progetto parallelo e uscire a correre sui sentieri. Io stesso ho raggiunto lo status di Giantmaster nell’inverno 2006, quando ero un giovane volontario della Sleeping Giant Trail Crew (con mia soddisfazione registrato nell’archivio SG), ma da allora sono emerse nuove sfide. Sebbene le categorie Giantmaster a 12 mesi e 4 stagioni siano impressionanti e allettanti, richiederebbero anche più viaggi dalla mia attuale casa (DC) alla mia casa formativa (CT) di quanti io riesca a gestire ragionevolmente... e sono meno interessanti per l’ottimizzazione su grafi, quindi via con la Giantmaster Marathon!
Per ulteriore riferimento, di seguito trovi la mappa dei sentieri dello Sleeping Giant:
La cosa bella dei grafi è che i concetti e la terminologia sono in genere intuitivi. Ecco comunque un po’ di lessico di base:
I grafi sono strutture che mappano le relazioni tra oggetti. In questo tutorial gli oggetti sono chiamati nodi e le connessioni tra loro archi. Nota che archi e nodi sono spesso chiamati con vari nomi che in genere significano esattamente la stessa cosa:
node == vertex == point
edge == arc == link
Il grafo di partenza è non orientato. Cioè, i tuoi archi non hanno direzione: sono bidirezionali. Per esempio: A<--->B == B<--->A.
Al contrario, il grafo che potresti creare per specificare il percorso più breve per percorrere ogni sentiero può essere un grafo orientato, dove contano ordine e direzione degli archi. Per esempio: A--->B != B--->A.
Il grafo è anche un grafo con pesi sugli archi, dove la distanza (in miglia) tra ogni coppia di nodi adiacenti rappresenta il peso di un arco. Questo è gestito come un attributo dell’arco chiamato "distance".
Il grado è il numero di archi incidenti su (che toccano) un nodo. I nodi sono detti a grado dispari quando questo numero è dispari e a grado pari quando è pari.
La soluzione di questo CPP sarà un tour euleriano: un grafo in cui è possibile costruire un ciclo che passa per ogni arco esattamente una volta e torna dal nodo di partenza a se stesso (senza tornare indietro). Un Euler Tour è conosciuto anche con diversi nomi:
Eulerian tour == Eulerian circuit == Eulerian cycle
Un matching è un sottoinsieme di archi in cui nessun nodo compare più di una volta. Un matching di peso minimo trova il matching con la somma dei pesi degli archi più bassa possibile.
NetworkX è il pacchetto Python più popolare per manipolare e analizzare grafi. Diversi pacchetti offrono un livello base simile di manipolazione, in particolare igraph che ha binding anche per R e C++. Tuttavia, ho trovato che NetworkX offrisse gli algoritmi su grafi più solidi di cui avevo bisogno per risolvere il CPP.
Se hai già fatto analisi dati in Python o usi la distribuzione Anaconda, probabilmente hai già pandas e matplotlib. Potresti però non avere networkx. Queste dovrebbero essere le uniche dipendenze esterne alla Python Standard Library necessarie per seguire il tutorial. Si installano facilmente con pip:
pip install pandas
pip install networkx
pip install matplotlib
Per ora dovrebbero bastare questi pacchetti. imageio e numpy vengono importati solo alla fine per creare l’animazione GIF della soluzione del CPP. L’animazione è incorporata in questo post, quindi questi pacchetti sono opzionali.
import itertools
import copy
import networkx as nx
import pandas as pd
import matplotlib.pyplot as pltLa lista degli archi è una semplice struttura dati che userai per creare il grafo. Ogni riga rappresenta un singolo arco del grafo con alcuni attributi dell’arco.
# Grab edge list data hosted on Gist
edgelist = pd.read_csv('https://gist.githubusercontent.com/brooksandrew/e570c38bcc72a8d102422f2af836513b/raw/89c76b2563dbc0e88384719a35cba0dfc04cd522/edgelist_sleeping_giant.csv')
# Preview edgelist
edgelist.head(10)
| node1 | node2 | trail | distance | color | estimate | |
|---|---|---|---|---|---|---|
| 0 | rs_end_north | v_rs | rs | 0.30 | red | 0 |
| 1 | v_rs | b_rs | rs | 0.21 | red | 0 |
| 2 | b_rs | g_rs | rs | 0.11 | red | 0 |
| 3 | g_rs | w_rs | rs | 0.18 | red | 0 |
| 4 | w_rs | o_rs | rs | 0.21 | red | 0 |
| 5 | o_rs | y_rs | rs | 0.12 | red | 0 |
| 6 | y_rs | rs_end_south | rs | 0.39 | red | 0 |
| 7 | rc_end_north | v_rc | rc | 0.70 | red | 0 |
| 8 | v_rc | b_rc | rc | 0.04 | red | 0 |
| 9 | b_rc | g_rc | rc | 0.15 | red | 0 |
Le liste di nodi sono di solito opzionali in networkx e in altre librerie per grafi quando si forniscono le liste degli archi, perché i nomi dei nodi compaiono nelle prime due colonne della lista degli archi. In questo caso, però, vogliamo aggiungere alcuni attributi dei nodi: le coordinate X e Y dei nodi (incroci dei sentieri) per poter tracciare il grafo con lo stesso layout della mappa dei sentieri.
Ho passato un pomeriggio ad annotarle manualmente ricalcando l’immagine con GIMP:
Creare i nomi dei nodi ha richiesto anche un po’ di lavoro manuale. Ogni nodo rappresenta un incrocio di due o più sentieri. Quando possibile, il nodo è nominato come trail1_trail2, dove trail1 precede trail2 in ordine alfabetico.
Le cose si complicano quando gli stessi sentieri si incrociano più di una volta. Per esempio, i sentieri arancione e bianco. In questi casi, ho aggiunto un suffisso _2 o _3 al nome del nodo. Per esempio, hai due nomi di nodo distinti per i due incroci diversi tra arancione e bianco: o_w e o_w_2.
Questo ha richiesto molti tentativi ed errori e il confronto tra i grafici generati con le coordinate X,Y e la mappa reale dei sentieri.
# Grab node list data hosted on Gist
nodelist = pd.read_csv('https://gist.githubusercontent.com/brooksandrew/f989e10af17fb4c85b11409fea47895b/raw/a3a8da0fa5b094f1ca9d82e1642b384889ae16e8/nodelist_sleeping_giant.csv')
# Preview nodelist
nodelist.head(5)
| id | X | Y | |
|---|---|---|---|
| 0 | b_bv | 1486 | 732 |
| 1 | b_bw | 716 | 1357 |
| 2 | b_end_east | 3164 | 1111 |
| 3 | b_end_west | 141 | 1938 |
| 4 | b_g | 1725 | 771 |
Ora usi la lista degli archi e la lista dei nodi per creare un oggetto grafo in networkx.
# Create empty graph
g = nx.Graph()
Itera sulle righe della lista degli archi e aggiungi ogni arco e i relativi attributi al grafo g.
# Add edges and edge attributes
for i, elrow in edgelist.iterrows():
    g.add_edge(elrow[0], elrow[1], attr_dict=elrow[2:].to_dict())
Per illustrare cosa succede, stampiamo i valori dell’ultima riga della lista degli archi che è stata aggiunta al grafo g:
# Edge list example
print(elrow[0]) # node1
print(elrow[1]) # node2
print(elrow[2:].to_dict()) # edge attribute dict
o_gy2
y_gy2
{'color': 'yellowgreen', 'estimate': 0, 'trail': 'gy2', 'distance': 0.12}
Allo stesso modo, iteri sulle righe della lista dei nodi e aggiungi questi attributi di nodo.
# Add node attributes
for i, nlrow in nodelist.iterrows():
    g.node[nlrow['id']] = nlrow[1:].to_dict()
Ecco un esempio dall’ultima riga della lista dei nodi:
# Node list example
print(nlrow)
id    y_rt
X      977
Y     1666
Name: 76, dtype: objectGli archi del grafo sono rappresentati da una lista di tuple di lunghezza 3. I primi due elementi sono i nomi dei nodi collegati dall’arco. Il terzo è il dizionario degli attributi dell’arco.
# Preview first 5 edges
g.edges(data=True)[0:5]
[('rs_end_south',
  'y_rs',
  {'color': 'red', 'distance': 0.39, 'estimate': 0, 'trail': 'rs'}),
 ('w_gy2',
  'park_east',
  {'color': 'gray', 'distance': 0.12, 'estimate': 0, 'trail': 'w'}),
 ('w_gy2',
  'g_gy2',
  {'color': 'yellowgreen', 'distance': 0.05, 'estimate': 0, 'trail': 'gy2'}),
 ('w_gy2',
  'b_w',
  {'color': 'gray', 'distance': 0.42, 'estimate': 0, 'trail': 'w'}),
 ('w_gy2',
  'b_gy2',
  {'color': 'yellowgreen', 'distance': 0.03, 'estimate': 1, 'trail': 'gy2'})]
Analogamente, i nodi sono rappresentati da una lista di tuple di lunghezza 2. Il primo elemento è l’ID del nodo, seguito dal dizionario degli attributi del nodo.
# Preview first 10 nodes
g.nodes(data=True)[0:10]
[('rs_end_south', {'X': 1865, 'Y': 1598}),
 ('w_gy2', {'X': 2000, 'Y': 954}),
 ('rd_end_south_dupe', {'X': 273, 'Y': 1869}),
 ('w_gy1', {'X': 1184, 'Y': 1445}),
 ('g_rt', {'X': 908, 'Y': 1378}),
 ('v_rd', {'X': 258, 'Y': 1684}),
 ('g_rs', {'X': 1676, 'Y': 775}),
 ('rc_end_north', {'X': 867, 'Y': 618}),
 ('v_end_east', {'X': 2131, 'Y': 921}),
 ('rh_end_south', {'X': 721, 'Y': 1925})]
Stampa alcune statistiche di sintesi prima di visualizzare il grafo.
print('# of edges: {}'.format(g.number_of_edges()))
print('# of nodes: {}'.format(g.number_of_nodes()))
# of edges: 123
# of nodes: 77Posizioni: Per prima cosa devi trasformare le posizioni dei nodi del grafo in un dizionario. Questo ti permetterà di ricreare il grafo usando lo stesso layout della mappa dei sentieri. Y viene negata per spostare l’origine dell’asse Y dall’alto a sinistra al basso a sinistra.
# Define node positions data structure (dict) for plotting
node_positions = {node[0]: (node[1]['X'], -node[1]['Y']) for node in g.nodes(data=True)}

# Preview of node_positions with a bit of hack (there is no head/slice method for dictionaries).
dict(list(node_positions.items())[0:5])
{'b_rd': (268, -1744),
 'g_rt': (908, -1378),
 'o_gy1': (1130, -1297),
 'rh_end_tt_2': (550, -1608),
 'rs_end_south': (1865, -1598)}
Colori: Ora trasformi i colori degli archi del grafo in una semplice lista per visualizzare i sentieri in base al loro colore.
# Define data structure (list) of edge colors for plotting
edge_colors = [e[2]['color'] for e in g.edges(data=True)]

# Preview first 10
edge_colors[0:10]
['red',
 'gray',
 'yellowgreen',
 'gray',
 'yellowgreen',
 'blue',
 'black',
 'yellowgreen',
 'gray',
 'gray']
Ora puoi creare un bel grafico che si sovrappone bene alla mappa dei sentieri dello Sleeping Giant:
plt.figure(figsize=(8, 6))
nx.draw(g, pos=node_positions, edge_color=edge_colors, node_size=10, node_color='black')
plt.title('Graph Representation of Sleeping Giant Trail Map', size=15)
plt.show()
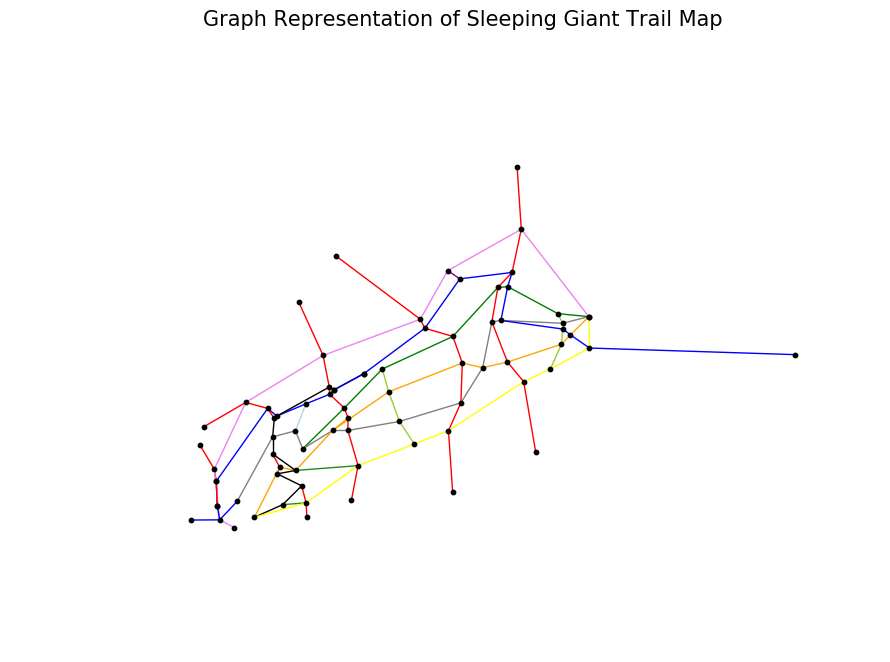
Questa rappresentazione ovviamente non cattura tutte le curve e gli svolazzi dei sentieri, ma niente paura: sono rappresentati accuratamente nell’attributo distance degli archi, usato nei calcoli. La visualizzazione cattura la distanza tra i nodi (incroci dei sentieri) in linea d’aria, che sembra essere una buona approssimazione.
Ok, ora che hai definito alcuni termini e creato il grafo, come trovi il percorso più corto al suo interno?
Risolvere il Chinese Postman Problem è concettualmente piuttosto semplice:
Trova tutti i nodi con grado dispari (facilissimo).
(Trova tutti gli incroci in cui il numero di sentieri che toccano quell’incrocio è dispari)
Aggiungi archi al grafo in modo che tutti i nodi di grado dispari diventino pari. Questi archi aggiunti devono essere duplicati dal grafo originale (assumiamo niente scorciatoie fuori sentiero in questo problema). L’insieme di archi aggiunti deve sommare la distanza minima possibile (difficile... per la precisione, np-hard).
(In parole semplici, minimizza il tratto da ripercorrere in un itinerario che tocchi ogni sentiero)
Dato un punto di partenza, trova il tour euleriano sul dataset aumentato (moderatamente facile).
(Una volta saputo su quali sentieri dovremo tornare indietro, calcola effettivamente il percorso dall’inizio alla fine)
Allentare le assunzioni seguenti potrebbe generare un percorso più corto e preciso, ma aggiungerebbe complessità oltre lo scopo di questo tutorial, che è focalizzato sul CPP.
Assunzione 1: Solo sentieri richiesti
Come si vede dalla mappa, ci sono strade lungo i bordi del parco che potrebbero collegare i sentieri, in particolare quelli rossi. Ci sono anche alcuni sentieri (Horseshoe e non segnati) che non sono richiesti dal registro Giantmaster, ma potrebbero essere utili per evitare lunghi rientri. L’inclusione di sentieri opzionali è in realtà una variante nota del CPP chiamata Rural Postman Problem. In questo tutorial ignoriamo i sentieri opzionali e ci concentriamo solo su quelli richiesti.
Assunzione 2: In salita == in discesa
Il CPP assume che il costo di percorrere un sentiero equivalga alla sua distanza, indipendentemente dalla direzione. Tuttavia, alcuni di questi sentieri sono piuttosto collinari e richiedono più energia in salita che in discesa. Si potrebbe incorporare una metrica che combini distanza e dislivello su un grafo orientato in un’estensione del CPP chiamata Windy Postman Problem.
Assunzione 3: Niente archi paralleli (sentieri)
Anche se possibile, includere archi paralleli (più sentieri che collegano gli stessi due nodi) aggiunge complessità al calcolo. Fortunatamente qui succede solo due volte (Blu <=> Rombo Rosso e Blu <=> Tower Trail). Questo è gestito con un piccolo trucco alla lista degli archi: sono inclusi nodi duplicati con suffisso _dupe per catturare ogni sentiero mantenendo l’unicità degli archi. L’implementazione del CPP nel pacchetto postman_problems che ho scritto gestisce in modo robusto gli archi paralleli in maniera più elegante, se vuoi risolvere il CPP su un tuo grafo con molti archi paralleli.
È un semplice conteggio. Si vede che 36 dei 76 nodi hanno grado dispari. Sono per lo più sentieri senza sbocco (grado 1) e incroci di 3 sentieri. Ci sono anche alcuni nodi di grado 5.
# Calculate list of nodes with odd degree
nodes_odd_degree = [v for v, d in g.degree_iter() if d % 2 == 1]

# Preview
nodes_odd_degree[0:5]
['rs_end_south', 'rc_end_north', 'v_end_east', 'rh_end_south', 'b_end_east']
# Counts
print('Number of nodes of odd degree: {}'.format(len(nodes_odd_degree)))
print('Number of total nodes: {}'.format(len(g.nodes())))
Number of nodes of odd degree: 36
Number of total nodes: 77
Questa è davvero la parte centrale del problema. La scomporrai in 5 parti:
Usi la funzione itertools combination per calcolare tutte le possibili coppie dei nodi a grado dispari. Il grafo è non orientato, quindi l’ordine non conta: per esempio, (a,b) == (b,a).
# Compute all pairs of odd nodes. in a list of tuples
odd_node_pairs = list(itertools.combinations(nodes_odd_degree, 2))

# Preview pairs of odd degree nodes
odd_node_pairs[0:10]
[('rs_end_south', 'rc_end_north'),
 ('rs_end_south', 'v_end_east'),
 ('rs_end_south', 'rh_end_south'),
 ('rs_end_south', 'b_end_east'),
 ('rs_end_south', 'b_bv'),
 ('rs_end_south', 'rt_end_south'),
 ('rs_end_south', 'o_rt'),
 ('rs_end_south', 'y_rt'),
 ('rs_end_south', 'g_gy2'),
 ('rs_end_south', 'b_tt_3')]
# Counts
print('Number of pairs: {}'.format(len(odd_node_pairs)))
Number of pairs: 630
Confermiamo che questo numero di coppie è corretto con la seguente combinatoria. Fortunatamente, hai solo 630 coppie di cui preoccuparti. Il tempo di calcolo per risolvere questo esempio di CPP è trascurabile (pochi secondi).
Se però avessi 3.600 nodi dispari, avresti ~6,5 milioni di coppie da ottimizzare. È un aumento ~10.000x dell’output a fronte di un aumento 100x dell’input.
Questo è il primo passo che implica un vero calcolo. Per fortuna networkx ha un’implementazione comoda dell’algoritmo di Dijkstra per calcolare il cammino più corto tra due nodi. Applichi questa funzione a ogni coppia (tutte le 630) calcolata sopra in odd_node_pairs.
def get_shortest_paths_distances(graph, pairs, edge_weight_name):
    """Compute shortest distance between each pair of nodes in a graph.  Return a dictionary keyed on node pairs (tuples)."""
    distances = {}
    for pair in pairs:
        distances[pair] = nx.dijkstra_path_length(graph, pair[0], pair[1], weight=edge_weight_name)
    return distances
# Compute shortest paths.  Return a dictionary with node pairs keys and a single value equal to shortest path distance.
odd_node_pairs_shortest_paths = get_shortest_paths_distances(g, odd_node_pairs, 'distance')

# Preview with a bit of hack (there is no head/slice method for dictionaries).
dict(list(odd_node_pairs_shortest_paths.items())[0:10])
{('b_bv', 'y_gy1'): 1.22,
 ('b_bw', 'rc_end_south'): 1.35,
 ('b_end_east', 'b_bw'): 3.0400000000000005,
 ('b_end_east', 'rd_end_north'): 3.83,
 ('g_gy1', 'nature_end_west'): 0.9900000000000001,
 ('o_rt', 'y_gy1'): 0.53,
 ('rc_end_north', 'rd_end_south'): 2.21,
 ('rc_end_north', 'rs_end_north'): 1.79,
 ('rs_end_north', 'o_tt'): 2.0999999999999996,
 ('w_bw', 'rd_end_north'): 1.02}
Un grafo completo è semplicemente un grafo in cui ogni nodo è connesso a tutti gli altri da un arco unico.
Ecco un esempio base da Wikipedia di un grafo completo con 7 nodi e 21 archi (7 su 2):
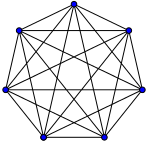
Il grafo che crei sotto ha 36 nodi e 630 archi con il relativo peso (distanza).
create_complete_graph è definita per calcolarlo. Il parametro flip_weights serve a trasformare l’attributo distance in weight dove i numeri piccoli riflettono grandi distanze e i numeri alti distanze brevi. Sembra controintuitivo, ma è necessario per il Passo 2.4 in cui calcoli il matching di peso minimo sul grafo completo.
Idealmente calcoleresti direttamente il matching di peso minimo, ma NetworkX implementa solo max_weight_matching, che massimizza invece di minimizzare il peso. Aggiriamo la cosa negando (moltiplicando per -1) l’attributo distance per ottenere weight. In questo modo l’ordine e la scala per distanza sono preservati, ma invertiti.
def create_complete_graph(pair_weights, flip_weights=True):
    """
    Create a completely connected graph using a list of vertex pairs and the shortest path distances between them
    Parameters:
        pair_weights: list[tuple] from the output of get_shortest_paths_distances
        flip_weights: Boolean. Should we negate the edge attribute in pair_weights?
    """
    g = nx.Graph()
    for k, v in pair_weights.items():
        wt_i = - v if flip_weights else v
        g.add_edge(k[0], k[1], attr_dict={'distance': v, 'weight': wt_i})
    return g
# Generate the complete graph
g_odd_complete = create_complete_graph(odd_node_pairs_shortest_paths, flip_weights=True)

# Counts
print('Number of nodes: {}'.format(len(g_odd_complete.nodes())))
print('Number of edges: {}'.format(len(g_odd_complete.edges())))
Number of nodes: 36
Number of edges: 630
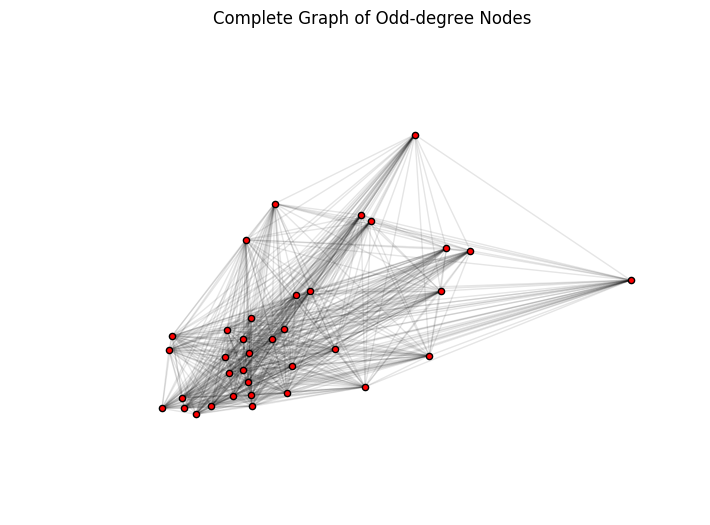
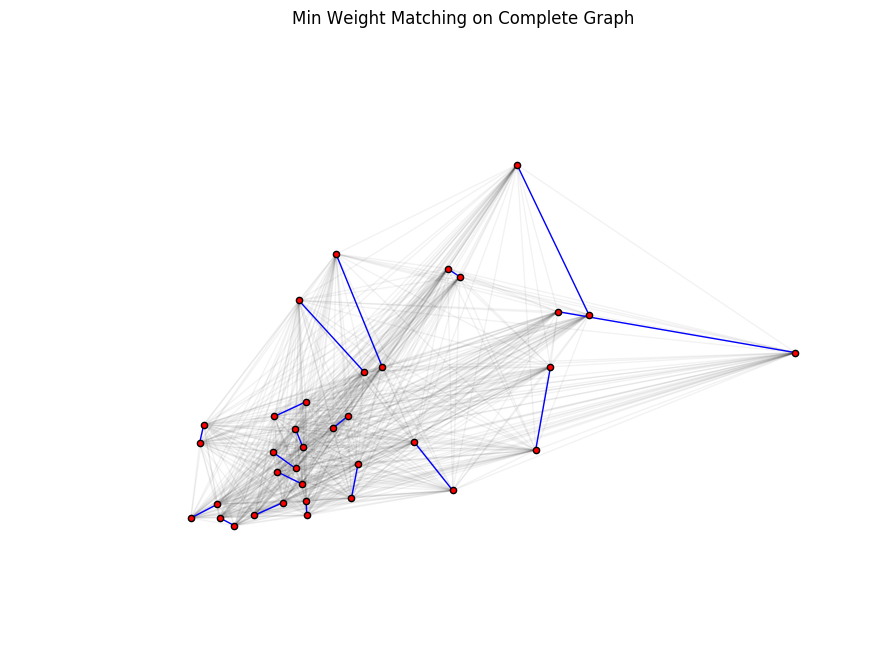
Per un supporto visivo, sotto è tracciato il grafo completamente connesso delle coppie di nodi a grado dispari. Nota che preservi le coordinate X, Y di ogni nodo, ma gli archi non rappresentano necessariamente sentieri reali. Per esempio, due nodi potrebbero essere collegati da un singolo arco in questo grafo, ma il cammino più corto tra loro potrebbe essere di 5 salti attraverso nodi di grado pari (non mostrati qui).
# Plot the complete graph of odd-degree nodes
plt.figure(figsize=(8, 6))
pos_random = nx.random_layout(g_odd_complete)
nx.draw_networkx_nodes(g_odd_complete, node_positions, node_size=20, node_color="red")
nx.draw_networkx_edges(g_odd_complete, node_positions, alpha=0.1)
plt.axis('off')
plt.title('Complete Graph of Odd-degree Nodes')
plt.show()
Questo è il passo più complesso del CPP. Devi trovare le coppie di nodi a grado dispari la cui somma (della distanza tra loro) sia la più piccola possibile. Per il tuo problema, si tratta di selezionare i 18 archi ottimali (36 nodi dispari / 2) dal groviglio di grafo generato al punto 2.3.
Sia l’implementazione sia l’intuizione di questa ottimizzazione vanno oltre lo scopo del tutorial... parliamo di 800+ righe di codice e un corpo di letteratura accademica non banale.
Una breve digressione per chi è interessato:
Un enorme grazie a Joris van Rantwijk per aver scritto l’implementazione originale sul suo blog nel lontano 2008. Mi sono imbattuto nel problema in modo simile e con la stessa intenzione di Joris. Dal post del 2008 di Joris:
Dato che non ho trovato implementazioni in Perl del maximum weighted matching, ho preso alla leggera la decisione di scrivere un po’ di codice da solo. Si è rivelato più difficile del previsto, ma quando me ne sono reso conto ero così preso dal problema che mi sono rifiutato di mollare.
Io invece ho mollato. Per fortuna Joris no.
Questo Maximum Weight Matching è stato poi integrato e mantenuto all’interno di NetworkX. Un altro grande grazie ai 10+ contributori su GitHub che hanno mantenuto questa corposa base di codice.
È un calcolo difficile e intensivo. Il primo grande risultato nel 1965 ha dimostrato che il problema del Maximum Matching poteva essere risolto in tempo polinomiale. Fu pubblicato da Jack Edmonds con forse uno dei titoli più belli mai visti in un paper: "Paths, trees, and flowers" [1]. Da allora una letteratura ha migliorato la procedura di ottimizzazione. Il codice implementato nella funzione di NetworkX max_weight_matching si basa su Galil, Zvi (1986) [2] e impiega un algoritmo con complessità O(n3).
# Compute min weight matching.
# Note: max_weight_matching uses the 'weight' attribute by default as the attribute to maximize.
odd_matching_dupes = nx.algorithms.max_weight_matching(g_odd_complete, True)

print('Number of edges in matching: {}'.format(len(odd_matching_dupes)))
Number of edges in matching: 36
L’output del matching (odd_matching_dupes) è un dizionario. Anche se ci sono 36 archi in questo matching, te ne servono solo 18. Ogni coppia di archi compare due volte (una con il nodo 1 come chiave e una seconda con il nodo 2 come chiave del dizionario).
# Preview of matching with dupes
odd_matching_dupes
{'b_bv': 'v_bv',
 'b_bw': 'rh_end_tt_1',
 'b_end_east': 'g_gy2',
 'b_end_west': 'rd_end_south',
 'b_tt_3': 'rt_end_north',
 'b_v': 'v_end_west',
 'g_gy1': 'rc_end_north',
 'g_gy2': 'b_end_east',
 'g_w': 'w_bw',
 'nature_end_west': 'o_y_tt_end_west',
 'o_rt': 'o_w_1',
 'o_tt': 'rh_end_tt_2',
 'o_w_1': 'o_rt',
 'o_y_tt_end_west': 'nature_end_west',
 'rc_end_north': 'g_gy1',
 'rc_end_south': 'y_gy1',
 'rd_end_north': 'rh_end_north',
 'rd_end_south': 'b_end_west',
 'rh_end_north': 'rd_end_north',
 'rh_end_south': 'y_rh',
 'rh_end_tt_1': 'b_bw',
 'rh_end_tt_2': 'o_tt',
 'rh_end_tt_3': 'rh_end_tt_4',
 'rh_end_tt_4': 'rh_end_tt_3',
 'rs_end_north': 'v_end_east',
 'rs_end_south': 'y_gy2',
 'rt_end_north': 'b_tt_3',
 'rt_end_south': 'y_rt',
 'v_bv': 'b_bv',
 'v_end_east': 'rs_end_north',
 'v_end_west': 'b_v',
 'w_bw': 'g_w',
 'y_gy1': 'rc_end_south',
 'y_gy2': 'rs_end_south',
 'y_rh': 'rh_end_south',
 'y_rt': 'rt_end_south'}
Converti questo dizionario in una lista di tuple dato che il grafo è non orientato e l’ordine non conta. Rimuovendo i duplicati ottieni le 18 coppie di archi uniche che sommano cumulativamente la minor distanza possibile.
# Convert matching to list of deduped tuples
odd_matching = list(pd.unique([tuple(sorted([k, v])) for k, v in odd_matching_dupes.items()]))

# Counts
print('Number of edges in matching (deduped): {}'.format(len(odd_matching)))
Number of edges in matching (deduped): 18
# Preview of deduped matching
odd_matching
[('rs_end_south', 'y_gy2'),
 ('b_end_west', 'rd_end_south'),
 ('b_bv', 'v_bv'),
 ('rh_end_tt_3', 'rh_end_tt_4'),
 ('b_bw', 'rh_end_tt_1'),
 ('o_tt', 'rh_end_tt_2'),
 ('g_w', 'w_bw'),
 ('b_end_east', 'g_gy2'),
 ('nature_end_west', 'o_y_tt_end_west'),
 ('g_gy1', 'rc_end_north'),
 ('o_rt', 'o_w_1'),
 ('rs_end_north', 'v_end_east'),
 ('rc_end_south', 'y_gy1'),
 ('rh_end_south', 'y_rh'),
 ('rt_end_south', 'y_rt'),
 ('b_tt_3', 'rt_end_north'),
 ('rd_end_north', 'rh_end_north'),
 ('b_v', 'v_end_west')]
Visualizziamo queste coppie sul grafo completo tracciato prima al passo 2.3. Come prima, le posizioni dei nodi riflettono il grafo reale (mappa dei sentieri), ma le distanze degli archi mostrati (linee blu) sono in linea d’aria. Il percorso più corto effettivo tra due nodi potrebbe coinvolgere più archi che si snodano con una distanza considerevolmente maggiore.
plt.figure(figsize=(8, 6))

# Plot the complete graph of odd-degree nodes
nx.draw(g_odd_complete, pos=node_positions, node_size=20, alpha=0.05)

# Create a new graph to overlay on g_odd_complete with just the edges from the min weight matching
g_odd_complete_min_edges = nx.Graph(odd_matching)
nx.draw(g_odd_complete_min_edges, pos=node_positions, node_size=20, edge_color='blue', node_color='red')

plt.title('Min Weight Matching on Complete Graph')
plt.show()
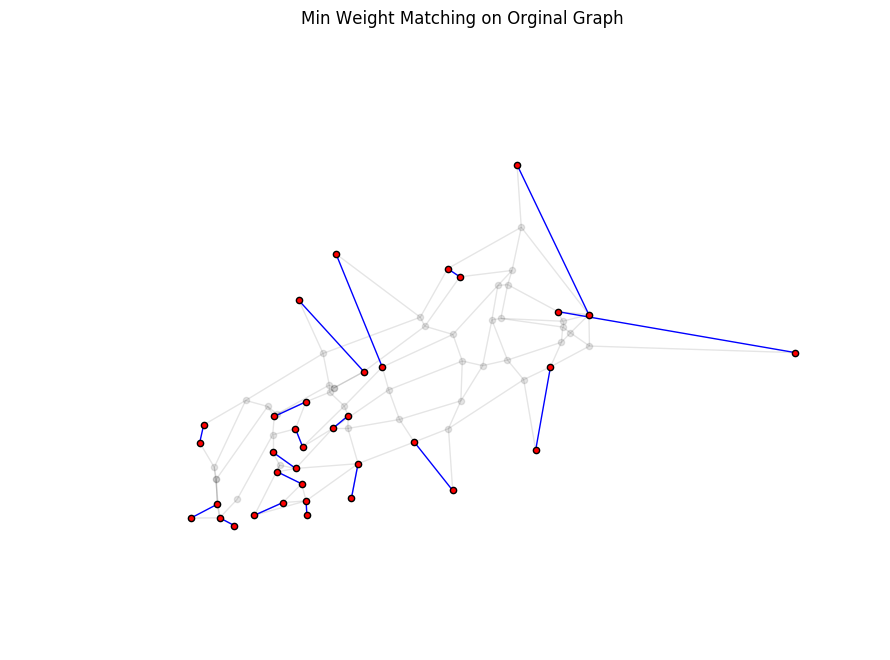
Per mostrare come si inserisce nel grafo originale, tracci le stesse coppie minime (linee blu) ma sulla mappa dei sentieri (in trasparenza) invece che sul grafo completo. Di nuovo, nota che le linee blu sono tragitti "a taglio" (archi in linea d’aria, non sentieri reali). Ti resta ancora un po’ di lavoro per trovare gli archi che compongono il percorso più breve tra ogni coppia nel Passo 3.
plt.figure(figsize=(8, 6))

# Plot the original trail map graph
nx.draw(g, pos=node_positions, node_size=20, alpha=0.1, node_color='black')

# Plot graph to overlay with just the edges from the min weight matching
nx.draw(g_odd_complete_min_edges, pos=node_positions, node_size=20, alpha=1, node_color='red', edge_color='blue')

plt.title('Min Weight Matching on Orginal Graph')
plt.show()
Ora aumenti il grafo originale con gli archi del matching calcolato al punto 2.4. Di seguito è definita una semplice funzione per farlo, che annota anche che questi nuovi archi provengono dal grafo aumentato. Ti servirà saperlo al punto 3. quando creerai il circuito euleriano attraverso il grafo.
def add_augmenting_path_to_graph(graph, min_weight_pairs):
    """
    Add the min weight matching edges to the original graph
    Parameters:
        graph: NetworkX graph (original graph from trailmap)
        min_weight_pairs: list[tuples] of node pairs from min weight matching
    Returns:
        augmented NetworkX graph
    """

    # We need to make the augmented graph a MultiGraph so we can add parallel edges
    graph_aug = nx.MultiGraph(graph.copy())
    for pair in min_weight_pairs:
        graph_aug.add_edge(pair[0],
                           pair[1],
                           attr_dict={'distance': nx.dijkstra_path_length(graph, pair[0], pair[1]),
                                      'trail': 'augmented'}
                          )
    return graph_aug
Confermiamo che il grafo aumentato aggiunge il numero atteso (18) di archi:
# Create augmented graph: add the min weight matching edges to g
g_aug = add_augmenting_path_to_graph(g, odd_matching)

# Counts
print('Number of edges in original graph: {}'.format(len(g.edges())))
print('Number of edges in augmented graph: {}'.format(len(g_aug.edges())))
Number of edges in original graph: 123
Number of edges in augmented graph: 141
Verifichiamo anche che ora ogni nodo abbia grado pari:
pd.value_counts(g_aug.degree())
4    54
2    18
6     5
dtype: int64
Ora che hai un grafo con gradi pari, il duro lavoro di ottimizzazione è finito. Come ha postulato Euler nel 1736 con il problema dei Sette ponti di Königsberg, esiste un percorso che visita ogni arco esattamente una volta se tutti i nodi hanno grado pari. Carl Hierholzer dimostrò formalmente il risultato negli anni 1870.
Esistono molti circuiti euleriani con la stessa distanza. Puoi arrivare al 90% con la funzione eulerian_circuit di NetworkX. Tuttavia ci sono alcune limitazioni.
Limitazioni che correggerai:
Il grafo aumentato potrebbe (e probabilmente lo farà) contenere archi che non esistevano nel grafo originale. Per ottenere il circuito (senza "tagliare"), devi scomporre questi archi aumentati nel cammino più breve attraverso archi che esistono davvero.
eulerian_circuit restituisce solo l’ordine in cui tocchiamo ogni nodo. Non restituisce gli attributi degli archi necessari a completare il circuito. Questo è necessario perché devi tenere traccia degli archi già percorsi quando esistono archi multipli tra due nodi.
Limitazioni che non correggerai:
Cominciamo comunque dalla soluzione semplice ma incompleta:
naive_euler_circuit = list(nx.eulerian_circuit(g_aug, source='b_end_east'))
Come previsto, la lunghezza del circuito euleriano ingenuo è pari al numero di archi nel grafo aumentato.
print('Length of eulerian circuit: {}'.format(len(naive_euler_circuit)))
Length of eulerian circuit: 141
L’output è solo una lista di tuple che rappresentano coppie di nodi. Nota che il primo nodo di ogni coppia coincide con il secondo nodo della coppia precedente.
# Preview naive Euler circuit
naive_euler_circuit[0:10]
[('b_end_east', 'g_gy2'),
 ('g_gy2', 'b_g'),
 ('b_g', 'b_w'),
 ('b_w', 'b_gy2'),
 ('b_gy2', 'w_gy2'),
 ('w_gy2', 'b_w'),
 ('b_w', 'w_rs'),
 ('w_rs', 'g_rs'),
 ('g_rs', 'b_g'),
 ('b_g', 'b_rs')]
Definiamo ora una funzione che sfrutta il grafo originale per dirti quali sentieri usare per andare dal nodo A al nodo B. Anche se il codice è verboso, la logica è semplice. Trasformi il circuito ingenuo, che includeva archi inesistenti nel grafo originale, in un circuito euleriano usando soltanto archi esistenti nel grafo originale.
Iteri su ogni arco del circuito euleriano ingenuo (naive_euler_circuit). Ovunque incontri un arco che non esiste nel grafo originale, lo sostituisci con la sequenza di archi che compongono il cammino più breve tra i suoi nodi usando il grafo originale.
def create_eulerian_circuit(graph_augmented, graph_original, starting_node=None):
    """Create the eulerian path using only edges from the original graph."""
    euler_circuit = []
    naive_circuit = list(nx.eulerian_circuit(graph_augmented, source=starting_node))

    for edge in naive_circuit:
        edge_data = graph_augmented.get_edge_data(edge[0], edge[1])

        if edge_data[0]['trail'] != 'augmented':
            # If `edge` exists in original graph, grab the edge attributes and add to eulerian circuit.
            edge_att = graph_original[edge[0]][edge[1]]
            euler_circuit.append((edge[0], edge[1], edge_att))
        else:
            aug_path = nx.shortest_path(graph_original, edge[0], edge[1], weight='distance')
            aug_path_pairs = list(zip(aug_path[:-1], aug_path[1:]))

            print('Filling in edges for augmented edge: {}'.format(edge))
            print('Augmenting path: {}'.format(' => '.join(aug_path)))
            print('Augmenting path pairs: {}\n'.format(aug_path_pairs))

            # If `edge` does not exist in original graph, find the shortest path between its nodes and
            #  add the edge attributes for each link in the shortest path.
            for edge_aug in aug_path_pairs:
                edge_aug_att = graph_original[edge_aug[0]][edge_aug[1]]
                euler_circuit.append((edge_aug[0], edge_aug[1], edge_aug_att))

    return euler_circuit
Aggiustiamo un po’ la limitazione 3 partendo con il circuito euleriano all’estremità est del parco sul sentiero blu (nodo "b_end_east"). Quando esegui davvero il percorso, puoi semplicemente saltare l’ultima indicazione che torna indietro.
Sono stati aggiunti print verbose per mostrare cosa succede quando sostituisci gli archi inesistenti del grafo aumentato con il cammino più breve che usa archi reali.
# Create the Eulerian circuit
euler_circuit = create_eulerian_circuit(g_aug, g, 'b_end_east')
Filling in edges for augmented edge: ('b_end_east', 'g_gy2')
Augmenting path: b_end_east => b_y => b_o => b_gy2 => w_gy2 => g_gy2
Augmenting path pairs: [('b_end_east', 'b_y'), ('b_y', 'b_o'), ('b_o', 'b_gy2'), ('b_gy2', 'w_gy2'), ('w_gy2', 'g_gy2')]

Filling in edges for augmented edge: ('b_bw', 'rh_end_tt_1')
Augmenting path: b_bw => b_tt_1 => rh_end_tt_1
Augmenting path pairs: [('b_bw', 'b_tt_1'), ('b_tt_1', 'rh_end_tt_1')]

Filling in edges for augmented edge: ('b_tt_3', 'rt_end_north')
Augmenting path: b_tt_3 => b_tt_2 => tt_rt => v_rt => rt_end_north
Augmenting path pairs: [('b_tt_3', 'b_tt_2'), ('b_tt_2', 'tt_rt'), ('tt_rt', 'v_rt'), ('v_rt', 'rt_end_north')]

Filling in edges for augmented edge: ('rc_end_north', 'g_gy1')
Augmenting path: rc_end_north => v_rc => b_rc => g_rc => g_gy1
Augmenting path pairs: [('rc_end_north', 'v_rc'), ('v_rc', 'b_rc'), ('b_rc', 'g_rc'), ('g_rc', 'g_gy1')]

Filling in edges for augmented edge: ('y_gy1', 'rc_end_south')
Augmenting path: y_gy1 => y_rc => rc_end_south
Augmenting path pairs: [('y_gy1', 'y_rc'), ('y_rc', 'rc_end_south')]

Filling in edges for augmented edge: ('b_end_west', 'rd_end_south')
Augmenting path: b_end_west => b_v => rd_end_south
Augmenting path pairs: [('b_end_west', 'b_v'), ('b_v', 'rd_end_south')]

Filling in edges for augmented edge: ('rh_end_north', 'rd_end_north')
Augmenting path: rh_end_north => v_rh => v_rd => rd_end_north
Augmenting path pairs: [('rh_end_north', 'v_rh'), ('v_rh', 'v_rd'), ('v_rd', 'rd_end_north')]

Filling in edges for augmented edge: ('v_end_east', 'rs_end_north')
Augmenting path: v_end_east => v_rs => rs_end_north
Augmenting path pairs: [('v_end_east', 'v_rs'), ('v_rs', 'rs_end_north')]

Filling in edges for augmented edge: ('y_gy2', 'rs_end_south')
Augmenting path: y_gy2 => y_rs => rs_end_south
Augmenting path pairs: [('y_gy2', 'y_rs'), ('y_rs', 'rs_end_south')]
Si vede che la lunghezza del circuito euleriano è maggiore del circuito ingenuo, il che ha senso.
print('Length of Eulerian circuit: {}'.format(len(euler_circuit)))
Length of Eulerian circuit: 158
Ecco una stampa della soluzione in formato testuale:
# Preview first 20 directions of CPP solution
for i, edge in enumerate(euler_circuit[0:20]):
    print(i, edge)
0 ('b_end_east', 'b_y', {'color': 'blue', 'estimate': 0, 'trail': 'b', 'distance': 1.32})
1 ('b_y', 'b_o', {'color': 'blue', 'estimate': 0, 'trail': 'b', 'distance': 0.08})
2 ('b_o', 'b_gy2', {'color': 'blue', 'estimate': 1, 'trail': 'b', 'distance': 0.05})
3 ('b_gy2', 'w_gy2', {'color': 'yellowgreen', 'estimate': 1, 'trail': 'gy2', 'distance': 0.03})
4 ('w_gy2', 'g_gy2', {'color': 'yellowgreen', 'estimate': 0, 'trail': 'gy2', 'distance': 0.05})
5 ('g_gy2', 'b_g', {'color': 'green', 'estimate': 0, 'trail': 'g', 'distance': 0.45})
6 ('b_g', 'b_w', {'color': 'blue', 'estimate': 0, 'trail': 'b', 'distance': 0.16})
7 ('b_w', 'b_gy2', {'color': 'blue', 'estimate': 0, 'trail': 'b', 'distance': 0.41})
8 ('b_gy2', 'w_gy2', {'color': 'yellowgreen', 'estimate': 1, 'trail': 'gy2', 'distance': 0.03})
9 ('w_gy2', 'b_w', {'color': 'gray', 'estimate': 0, 'trail': 'w', 'distance': 0.42})
10 ('b_w', 'w_rs', {'color': 'gray', 'estimate': 1, 'trail': 'w', 'distance': 0.06})
11 ('w_rs', 'g_rs', {'color': 'red', 'estimate': 0, 'trail': 'rs', 'distance': 0.18})
12 ('g_rs', 'b_g', {'color': 'green', 'estimate': 1, 'trail': 'g', 'distance': 0.05})
13 ('b_g', 'b_rs', {'color': 'blue', 'estimate': 0, 'trail': 'b', 'distance': 0.07})
14 ('b_rs', 'g_rs', {'color': 'red', 'estimate': 0, 'trail': 'rs', 'distance': 0.11})
15 ('g_rs', 'g_rc', {'color': 'green', 'estimate': 0, 'trail': 'g', 'distance': 0.45})
16 ('g_rc', 'g_gy1', {'color': 'green', 'estimate': 0, 'trail': 'g', 'distance': 0.37})
17 ('g_gy1', 'g_rt', {'color': 'green', 'estimate': 0, 'trail': 'g', 'distance': 0.26})
18 ('g_rt', 'g_w', {'color': 'green', 'estimate': 0, 'trail': 'g', 'distance': 0.31})
19 ('g_w', 'o_w_1', {'color': 'gray', 'estimate': 0, 'trail': 'w', 'distance': 0.18})
Si capisce in fretta che l’algoritmo non è molto fedele a un singolo sentiero, saltando dall’uno all’altro piuttosto rapidamente. Un’estensione di questo approccio potrebbe introdurre una nozione di "fedeltà al sentiero" nella funzione obiettivo per rendere più gestibile l’effettiva corsa del percorso.
Diamo un’occhiata alla soluzione per vedere quanto è ragionevole.
(Non è importante soffermarsi su questo codice prolisso, quanto sul risultato stampato)
# Computing some stats
total_mileage_of_circuit = sum([edge[2]['distance'] for edge in euler_circuit])
total_mileage_on_orig_trail_map = sum(nx.get_edge_attributes(g, 'distance').values())
_vcn = pd.value_counts(pd.value_counts([(e[0]) for e in euler_circuit]), sort=False)
node_visits = pd.DataFrame({'n_visits': _vcn.index, 'n_nodes': _vcn.values})
_vce = pd.value_counts(pd.value_counts([sorted(e)[0] + sorted(e)[1] for e in nx.MultiDiGraph(euler_circuit).edges()]))
edge_visits = pd.DataFrame({'n_visits': _vce.index, 'n_edges': _vce.values})

# Printing stats
print('Mileage of circuit: {0:.2f}'.format(total_mileage_of_circuit))
print('Mileage on original trail map: {0:.2f}'.format(total_mileage_on_orig_trail_map))
print('Mileage retracing edges: {0:.2f}'.format(total_mileage_of_circuit-total_mileage_on_orig_trail_map))
print('Percent of mileage retraced: {0:.2f}%\n'.format((1-total_mileage_of_circuit/total_mileage_on_orig_trail_map)*-100))

print('Number of edges in circuit: {}'.format(len(euler_circuit)))
print('Number of edges in original graph: {}'.format(len(g.edges())))
print('Number of nodes in original graph: {}\n'.format(len(g.nodes())))

print('Number of edges traversed more than once: {}\n'.format(len(euler_circuit)-len(g.edges())))

print('Number of times visiting each node:')
print(node_visits.to_string(index=False))

print('\nNumber of times visiting each edge:')
print(edge_visits.to_string(index=False))
Mileage of circuit: 33.59
Mileage on original trail map: 25.76
Mileage retracing edges: 7.83
Percent of mileage retraced: 30.40%

Number of edges in circuit: 158
Number of edges in original graph: 123
Number of nodes in original graph: 77

Number of edges traversed more than once: 35

Number of times visiting each node:
n_nodes  n_visits
     18         1
     38         2
     20         3
      1         4

Number of times visiting each edge:
n_edges  n_visits
     88         1
     35         2
Sebbene NetworkX offra anche funzionalità per visualizzare i grafi, in questo ambito è notoriamente umile:
NetworkX fornisce funzionalità di base per visualizzare i grafi, ma il suo obiettivo principale è abilitare l’analisi, non la visualizzazione. In futuro, le funzionalità di visualizzazione potrebbero essere rimosse o disponibili solo come pacchetto aggiuntivo.
Una buona visualizzazione dei grafi è difficile e consigliamo caldamente di usare strumenti dedicati. Esempi notevoli sono Cytoscape, Gephi, Graphviz e, per il typesetting LaTeX, PGF/TikZ.
Detto questo, il disegno integrato di NetworkX con matplotlib è abbastanza potente per dare un’occhiata e esplorare visivamente grafi di base, quindi in questo tutorial restiamo con draw di NetworkX.
Ho usato graphviz e il linguaggio di descrizione dei grafi dot per visualizzare la soluzione nel mio pacchetto Python postman_problems. Anche se è servito un po’ di lavoro per convertire la struttura del grafo di NetworkX in un grafo dot, questo sblocca una qualità e un controllo migliori delle visualizzazioni.
Il primo passo è convertire la lista degli archi da percorrere nel circuito euleriano in una lista di archi con attributi adatti al plotting.
create_cpp_edgelist Crea una lista di archi con alcuni attributi aggiuntivi che userai per il plotting:
def create_cpp_edgelist(euler_circuit):
    """
    Create the edgelist without parallel edge for the visualization
    Combine duplicate edges and keep track of their sequence and # of walks
    Parameters:
        euler_circuit: list[tuple] from create_eulerian_circuit
    """
    cpp_edgelist = {}

    for i, e in enumerate(euler_circuit):
        edge = frozenset([e[0], e[1]])

        if edge in cpp_edgelist:
            cpp_edgelist[edge][2]['sequence'] += ', ' + str(i)
            cpp_edgelist[edge][2]['visits'] += 1

        else:
            cpp_edgelist[edge] = e
            cpp_edgelist[edge][2]['sequence'] = str(i)
            cpp_edgelist[edge][2]['visits'] = 1

    return list(cpp_edgelist.values())
Creiamo la lista degli archi del CPP:
cpp_edgelist = create_cpp_edgelist(euler_circuit)
Come previsto, la tua lista di archi ha lo stesso numero di archi del grafo originale.
print('Number of edges in CPP edge list: {}'.format(len(cpp_edgelist)))
Number of edges in CPP edge list: 123
La lista degli archi del CPP assomiglia a euler_circuit, solo con qualche attributo in più.
# Preview CPP plot-friendly edge list
cpp_edgelist[0:3]
[('rh_end_tt_4',
  'nature_end_west',
  {'color': 'black',
   'distance': 0.2,
   'estimate': 0,
   'sequence': '73',
   'trail': 'tt',
   'visits': 1}),
 ('rd_end_south',
  'b_rd',
  {'color': 'red',
   'distance': 0.13,
   'estimate': 0,
   'sequence': '95',
   'trail': 'rd',
   'visits': 1}),
 ('w_gy1',
  'w_rc',
  {'color': 'gray',
   'distance': 0.33,
   'estimate': 0,
   'sequence': '151',
   'trail': 'w',
   'visits': 1})]
Ora creiamo il grafo:
# Create CPP solution graph
g_cpp = nx.Graph(cpp_edgelist)
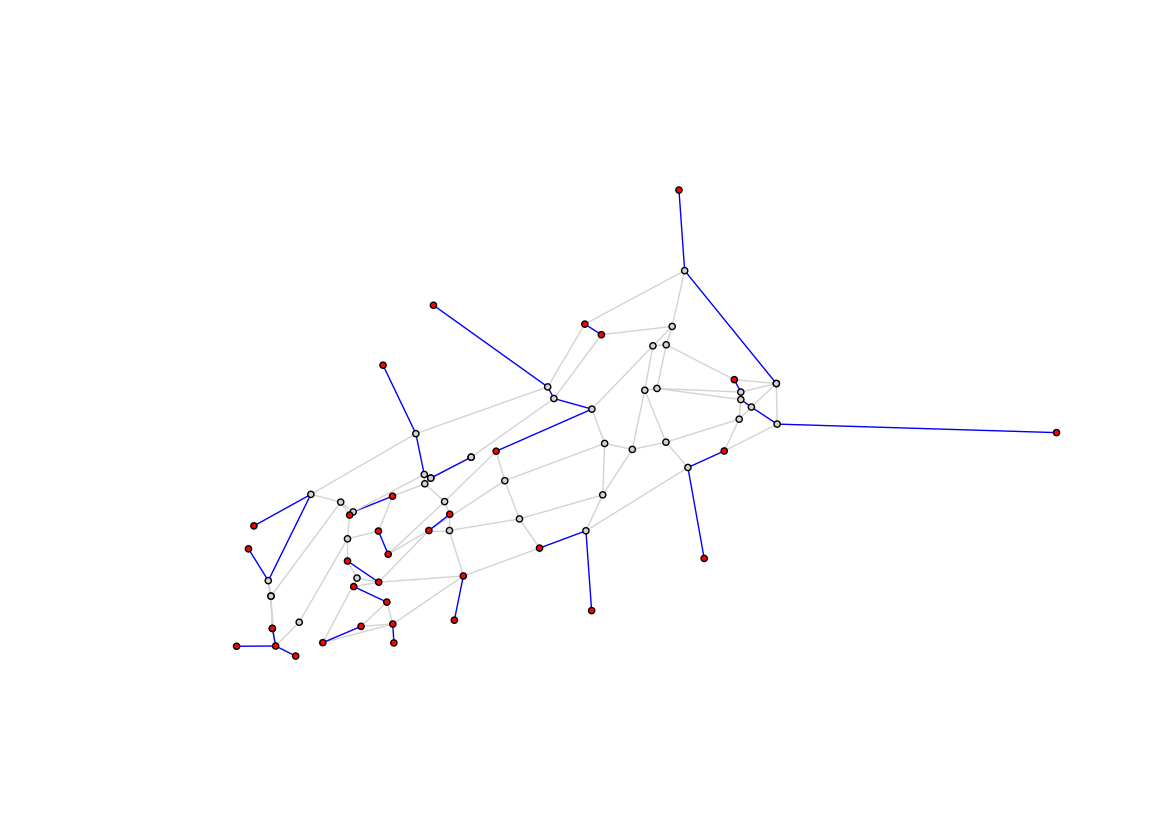
Qui illustri quali archi sono percorsi una volta (grigio) e più di una (blu). Questa è la versione "corretta" della visualizzazione creata al punto 2.4 che mostrava i collegamenti ingenui (in linea d’aria) tra le coppie di nodi dispari (rosso). Qui si corregge tracciando il cammino più breve attraverso archi che esistono davvero per ciascuna coppia di nodi a grado dispari.
Se l’ottimizzazione è valida, queste linee blu dovrebbero rappresentare la minima distanza possibile. In particolare, la distanza minima necessaria a generare un matching dei nodi a grado dispari.
plt.figure(figsize=(14, 10))

visit_colors = {1:'lightgray', 2:'blue'}
edge_colors = [visit_colors[e[2]['visits']] for e in g_cpp.edges(data=True)]
node_colors = ['red'  if node in nodes_odd_degree else 'lightgray' for node in g_cpp.nodes()]

nx.draw_networkx(g_cpp, pos=node_positions, node_size=20, node_color=node_colors, edge_color=edge_colors, with_labels=False)
plt.axis('off')
plt.show()
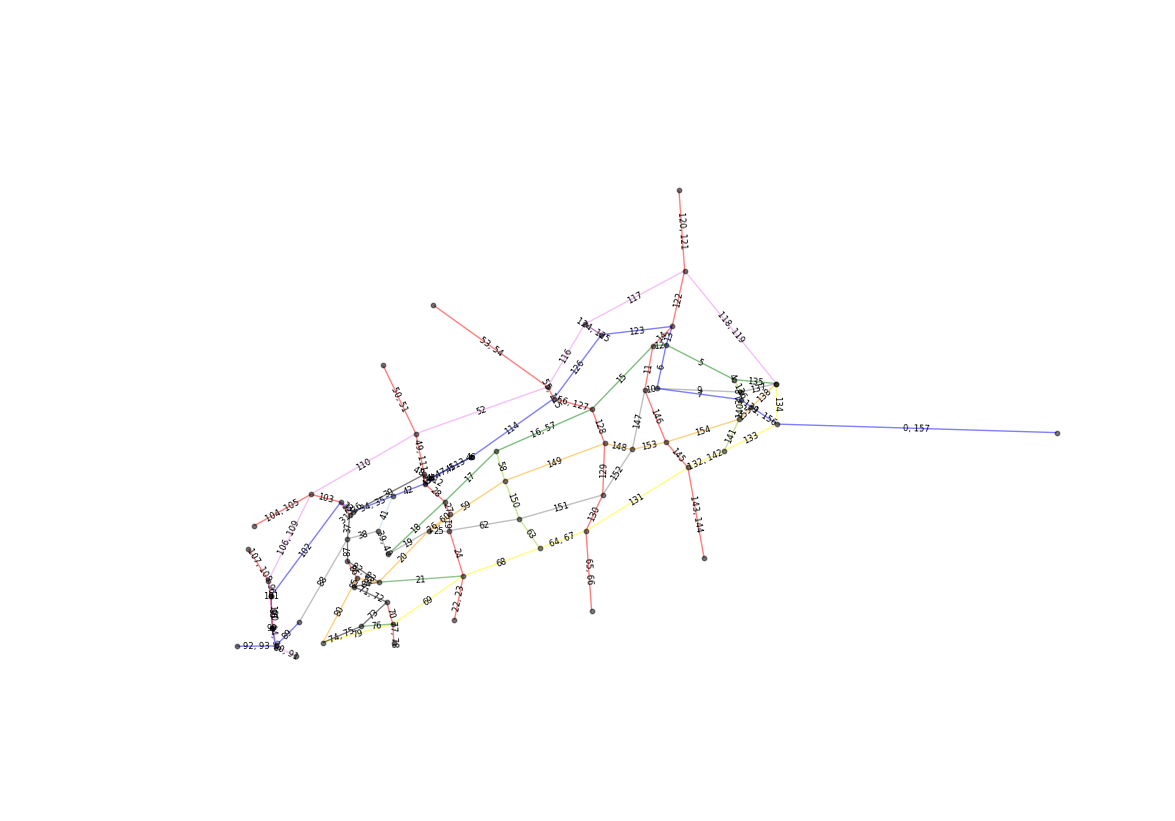
Qui tracci il grafo originale (mappa dei sentieri) annotato con i numeri di sequenza con cui percorriamo i sentieri secondo la soluzione CPP. Numeri multipli indicano i sentieri su cui dobbiamo tornare indietro.
Parti dal sentiero blu in basso a destra (0ª e 157ª indicazione).
plt.figure(figsize=(14, 10))

edge_colors = [e[2]['color'] for e in g_cpp.edges(data=True)]
nx.draw_networkx(g_cpp, pos=node_positions, node_size=10, node_color='black', edge_color=edge_colors, with_labels=False, alpha=0.5)

bbox = {'ec':[1,1,1,0], 'fc':[1,1,1,0]}  # hack to label edges over line (rather than breaking up line)
edge_labels = nx.get_edge_attributes(g_cpp, 'sequence')
nx.draw_networkx_edge_labels(g_cpp, pos=node_positions, edge_labels=edge_labels, bbox=bbox, font_size=6)

plt.axis('off')
plt.show()
Il filmato che segue traccia il circuito euleriano dall’inizio alla fine. Gli archi sono colorati in nero la prima volta che li si percorre e in rosso la seconda.
Nota che questa gif non rende piena giustizia visiva agli archi che si sovrappongono o sono troppo piccoli per essere visualizzati correttamente. Una libreria di visualizzazione più robusta come graphviz potrebbe risolvere tracciando spline invece di linee rette tra i nodi.
Il codice che la crea è riportato sotto come riferimento.

Per prima cosa viene prodotta un’immagine PNG per ogni direzione (arco percorso) della soluzione CPP.
visit_colors = {1:'black', 2:'red'}
edge_cnter = {}
g_i_edge_colors = []
for i, e in enumerate(euler_circuit, start=1):

    edge = frozenset([e[0], e[1]])
    if edge in edge_cnter:
        edge_cnter[edge] += 1
    else:
        edge_cnter[edge] = 1

    # Full graph (faded in background)
    nx.draw_networkx(g_cpp, pos=node_positions, node_size=6, node_color='gray', with_labels=False, alpha=0.07)

    # Edges walked as of iteration i
    euler_circuit_i = copy.deepcopy(euler_circuit[0:i])
    for i in range(len(euler_circuit_i)):
        edge_i = frozenset([euler_circuit_i[i][0], euler_circuit_i[i][1]])
        euler_circuit_i[i][2]['visits_i'] = edge_cnter[edge_i]
    g_i = nx.Graph(euler_circuit_i)
    g_i_edge_colors = [visit_colors[e[2]['visits_i']] for e in g_i.edges(data=True)]

    nx.draw_networkx_nodes(g_i, pos=node_positions, node_size=6, alpha=0.6, node_color='lightgray', with_labels=False, linewidths=0.1)
    nx.draw_networkx_edges(g_i, pos=node_positions, edge_color=g_i_edge_colors, alpha=0.8)

    plt.axis('off')
    plt.savefig('fig/png/img{}.png'.format(i), dpi=120, bbox_inches='tight')
    plt.close()
Poi le immagini PNG vengono unite per creare la gif qui sopra.
Prima i PNG vengono ordinati da 0 a 157. Poi, con imageio a 3 frame al secondo, vengono uniti per creare la gif.
import glob
import numpy as np
import imageio
import os

def make_circuit_video(image_path, movie_filename, fps=5):
    # sorting filenames in order
    filenames = glob.glob(image_path + 'img*.png')
    filenames_sort_indices = np.argsort([int(os.path.basename(filename).split('.')[0][3:]) for filename in filenames])
    filenames = [filenames[i] for i in filenames_sort_indices]

    # make movie
    with imageio.get_writer(movie_filename, mode='I', fps=fps) as writer:
        for filename in filenames:
            image = imageio.imread(filename)
            writer.append_data(image)

make_circuit_video('fig/png/', 'fig/gif/cpp_route_animation.gif', fps=3)Complimenti, hai terminato questo tutorial risolvendo il Chinese Postman Problem in Python. Abbiamo coperto parecchia strada (33,6 miglia di sentieri, per l’esattezza). Per un approfondimento sui fondamenti delle reti, ti potrebbe interessare il corso di Datacamp Network Analysis in Python, che tratta in modo più completo i concetti di base.
Non esitare a consultare la documentazione di NetworkX per saperne di più su come creare, manipolare e attraversare queste reti complesse. La documentazione è completa, con un buon numero di esempi e una serie di tutorial.
Se ti interessa risolvere il CPP su un tuo grafo, ho impacchettato le funzionalità di questo tutorial nel pacchetto Python postman_problems su Github. Puoi anche mettere insieme i blocchi di codice del tutorial con una diversa lista di archi e nodi, ma il pacchetto postman_problems probabilmente ti porterà al risultato più rapidamente e in modo più pulito.
Un giorno conto di implementare anche le estensioni del CPP (Rural e Windy Postman Problem). Ho anche grandi ambizioni di scrivere di queste estensioni e delle esperienze di test dei percorsi sul mio blog qui. Un’altra applicazione che voglio esplorare e raccontare è l’integrazione di coordinate lat/long per sviluppare (o usare) un meccanismo che invii indicazioni turn-by-turn al mio orologio Garmin.
E naturalmente un ultimo prossimo passo: uscire e correre il percorso!
Se vuoi saperne di più sulle reti in Python, dai un’occhiata a questi corsi di DataCamp:
Introduction to Network Analysis in Python
Intermediate Network Analysis in Python
1: Edmonds, Jack (1965). "Paths, trees, and flowers". Canad. J. Math. 17: 449–467.
2: Galil, Z. (1986). "Efficient algorithms for finding maximum matching in graphs". ACM Computing Surveys. Vol. 18, No. 1: 23-38.
Scopri di più su Python
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



