Cours
Introduction à l’analyse de réseaux en Python
4 h
74.5K
Dans ce tutoriel, vous allez vous attaquer à un problème classique de la théorie des graphes, le problème du facteur chinois (Chinese Postman Problem). Certaines composantes de l’algorithme, bien que simples sur le plan conceptuel, s’avèrent exigeantes sur le plan computationnel. Cependant, pour ce tutoriel, seules des notions de base en Python sont nécessaires : pas besoin de bagage poussé en mathématiques, informatique ou théorie des graphes.
Nous commencerons par les briques de base des graphes (nœuds, arêtes, chemins, etc.) puis nous résoudrons le problème sur un graphe réel (réseau de sentiers d’un parc d’État) en utilisant la bibliothèque NetworkX en Python. L’accent est mis sur les concepts essentiels et leur implémentation. Pour aller plus loin, des ressources complémentaires sur les mécanismes d’optimisation sont proposées.
Vous avez sans doute déjà entendu parler du problème du voyageur de commerce, qui revient à trouver l’itinéraire le plus court (par exemple des routes) reliant un ensemble de nœuds (par exemple des villes). Moins connu, le problème du facteur chinois (CPP), aussi appelé problème d’inspection d’itinéraires ou de routage sur arcs, est assez proche. L’objectif du CPP est de trouver le plus court chemin qui couvre tous les liens (routes) d’un graphe au moins une fois. Si c’est possible sans repasser deux fois sur la même route, parfait ; c’est le scénario idéal et le problème est assez simple. En revanche, si certaines routes doivent être empruntées plusieurs fois, un peu de mathématiques s’impose pour déterminer l’itinéraire le plus court qui passe au moins une fois par chaque route avec la distance totale minimale.
(Note personnelle : un peu kitsch, malicieuse et 100 % non indispensable pour apprendre l’optimisation de graphes en Python)
J’avais une application concrète à résoudre : décrocher le titre de Giantmaster Marathoner.
Qu’est-ce qu’un Giantmaster ? Un Giantmaster est une personne (canine ou humaine) qui a parcouru l’intégralité des sentiers du Sleeping Giant State Park à Hamden (Connecticut, juste à côté de ma ville natale, Wallingford)… au cours de sa vie. Un Giantmaster Marathoner est celui ou celle qui a parcouru tous ces sentiers en une seule journée.
Grâce à la tenue de registres méticuleuse de la Sleeping Giant Park Association, la liste complète des Giantmasters et leur niveau est disponible ici. Je dois avouer que cela m’a pas mal motivé à lancer ce projet annexe et à aller courir sur les sentiers. J’ai moi-même atteint le statut de Giantmaster à l’hiver 2006, quand j’étais un jeune bénévole de la Sleeping Giant Trail Crew (ce qui est consigné dans les archives SG). De nouveaux défis se sont depuis présentés. Bien que les catégories sur 12 mois et 4 saisons soient impressionnantes et tentantes, elles exigeraient plus d’allers-retours entre ma maison actuelle (DC) et ma terre d’origine (CT) que je ne peux raisonnablement gérer… et elles sont moins pertinentes pour l’optimisation de graphes. Cap donc sur le marathon Giantmaster !
Pour référence, voici la carte des sentiers de Sleeping Giant :
Ce qui est agréable avec les graphes, c’est que les concepts et la terminologie sont généralement intuitifs. Voici néanmoins quelques notions de base :
Les graphes représentent des relations entre des objets. Les objets sont appelés nœuds et les connexions entre eux des arêtes dans ce tutoriel. Notez que les arêtes et les nœuds sont souvent désignés par plusieurs termes équivalents :
node == vertex == point
edge == arc == link
Le graphe de départ est non orienté. Autrement dit, vos arêtes n’ont pas de sens : elles sont bidirectionnelles. Par exemple : A<--->B == B<--->A.
À l’inverse, le graphe que vous pourriez créer pour spécifier le plus court chemin couvrant tous les sentiers peut être un graphe orienté, où l’ordre et le sens des arêtes comptent. Par exemple : A--->B != B--->A.
Le graphe est aussi un graphe pondéré sur les arêtes où la distance (en miles) entre chaque paire de nœuds adjacents représente le poids d’une arête. C’est géré comme un attribut d’arête nommé "distance".
Le degré désigne le nombre d’arêtes incidentes (qui touchent) un nœud. Les nœuds sont dits de degré impair lorsque ce nombre est impair et de degré pair lorsqu’il est pair.
La solution de ce CPP sera une tournée eulérienne : un graphe dans lequel on peut former un cycle qui passe exactement une fois par chaque arête et revient au nœud de départ (sans revenir en arrière). Une tournée eulérienne est aussi connue sous plusieurs noms :
Eulerian tour == Eulerian circuit == Eulerian cycle
Un appairage (matching) est un sous-ensemble d’arêtes où chaque nœud apparaît au plus une fois. Un appairage de poids minimal recherche l’appairage dont la somme des poids d’arêtes est minimale.
NetworkX est la bibliothèque Python la plus populaire pour manipuler et analyser des graphes. Plusieurs packages offrent des fonctionnalités similaires, notamment igraph (avec des liaisons R et C++). Toutefois, j’ai trouvé que NetworkX proposait les algorithmes de graphe les plus adaptés pour résoudre le CPP.
Si vous avez déjà fait de l’analyse de données en Python ou utilisez la distribution Anaconda, vous avez probablement pandas et matplotlib. En revanche, vous n’avez peut-être pas networkx. Ce sont les seules dépendances hors bibliothèque standard Python dont vous aurez besoin pour ce tutoriel. Elles s’installent facilement avec pip :
pip install pandas
pip install networkx
pip install matplotlib
Ces packages suffisent pour l’instant. imageio et numpy sont importés à la toute fin pour créer l’animation GIF de la solution du CPP. L’animation est intégrée dans cet article ; ces packages sont donc facultatifs.
import itertools
import copy
import networkx as nx
import pandas as pd
import matplotlib.pyplot as pltLa liste d’arêtes est une structure de données simple que vous utiliserez pour créer le graphe. Chaque ligne représente une arête du graphe avec quelques attributs d’arête.
# Grab edge list data hosted on Gist
edgelist = pd.read_csv('https://gist.githubusercontent.com/brooksandrew/e570c38bcc72a8d102422f2af836513b/raw/89c76b2563dbc0e88384719a35cba0dfc04cd522/edgelist_sleeping_giant.csv')
# Preview edgelist
edgelist.head(10)
| node1 | node2 | trail | distance | color | estimate | |
|---|---|---|---|---|---|---|
| 0 | rs_end_north | v_rs | rs | 0.30 | red | 0 |
| 1 | v_rs | b_rs | rs | 0.21 | red | 0 |
| 2 | b_rs | g_rs | rs | 0.11 | red | 0 |
| 3 | g_rs | w_rs | rs | 0.18 | red | 0 |
| 4 | w_rs | o_rs | rs | 0.21 | red | 0 |
| 5 | o_rs | y_rs | rs | 0.12 | red | 0 |
| 6 | y_rs | rs_end_south | rs | 0.39 | red | 0 |
| 7 | rc_end_north | v_rc | rc | 0.70 | red | 0 |
| 8 | v_rc | b_rc | rc | 0.04 | red | 0 |
| 9 | b_rc | g_rc | rc | 0.15 | red | 0 |
Dans networkx et d’autres bibliothèques de graphes, la liste de nœuds est généralement facultative quand la liste d’arêtes est fournie, car les noms de nœuds se trouvent dans les deux premières colonnes. Ici toutefois, nous voulons ajouter des attributs de nœuds : les coordonnées X, Y des nœuds (intersections de sentiers) afin d’afficher le graphe avec la même disposition que la carte.
J’ai passé un après-midi à les annoter manuellement en retraçant l’image avec GIMP :
La création des noms de nœuds a également demandé un peu de travail manuel. Chaque nœud représente une intersection de deux sentiers ou plus. Lorsque c’était possible, le nœud est nommé trail1_trail2, où trail1 précède trail2 par ordre alphabétique.
Les choses se compliquent quand les mêmes sentiers se croisent à plusieurs endroits (par exemple Orange et White). Dans ces cas, j’ai ajouté un suffixe _2 ou _3 au nom du nœud. Par exemple, vous avez deux noms distincts pour les deux intersections Orange/White : o_w et o_w_2.
Cela a demandé pas mal d’essais/erreurs et de comparaisons entre les tracés générés avec les coordonnées X,Y et la carte des sentiers.
# Grab node list data hosted on Gist
nodelist = pd.read_csv('https://gist.githubusercontent.com/brooksandrew/f989e10af17fb4c85b11409fea47895b/raw/a3a8da0fa5b094f1ca9d82e1642b384889ae16e8/nodelist_sleeping_giant.csv')
# Preview nodelist
nodelist.head(5)
| id | X | Y | |
|---|---|---|---|
| 0 | b_bv | 1486 | 732 |
| 1 | b_bw | 716 | 1357 |
| 2 | b_end_east | 3164 | 1111 |
| 3 | b_end_west | 141 | 1938 |
| 4 | b_g | 1725 | 771 |
Nous allons maintenant utiliser la liste d’arêtes et la liste de nœuds pour créer un objet graphe dans networkx.
# Create empty graph
g = nx.Graph()
Parcourez les lignes de la liste d’arêtes et ajoutez chaque arête et ses attributs au graphe g.
# Add edges and edge attributes
for i, elrow in edgelist.iterrows():
    g.add_edge(elrow[0], elrow[1], attr_dict=elrow[2:].to_dict())
Pour illustrer ce qui se passe ici, affichons les valeurs de la dernière ligne de la liste d’arêtes ajoutée au graphe g :
# Edge list example
print(elrow[0]) # node1
print(elrow[1]) # node2
print(elrow[2:].to_dict()) # edge attribute dict
o_gy2
y_gy2
{'color': 'yellowgreen', 'estimate': 0, 'trail': 'gy2', 'distance': 0.12}
De la même manière, parcourez les lignes de la liste de nœuds et ajoutez leurs attributs.
# Add node attributes
for i, nlrow in nodelist.iterrows():
    g.node[nlrow['id']] = nlrow[1:].to_dict()
Exemple issu de la dernière ligne de la liste de nœuds :
# Node list example
print(nlrow)
id    y_rt
X      977
Y     1666
Name: 76, dtype: objectLes arêtes de votre graphe sont représentées par une liste de tuples de longueur 3. Les deux premiers éléments sont les noms des nœuds reliés par l’arête. Le troisième est le dictionnaire des attributs d’arête.
# Preview first 5 edges
g.edges(data=True)[0:5]
[('rs_end_south',
  'y_rs',
  {'color': 'red', 'distance': 0.39, 'estimate': 0, 'trail': 'rs'}),
 ('w_gy2',
  'park_east',
  {'color': 'gray', 'distance': 0.12, 'estimate': 0, 'trail': 'w'}),
 ('w_gy2',
  'g_gy2',
  {'color': 'yellowgreen', 'distance': 0.05, 'estimate': 0, 'trail': 'gy2'}),
 ('w_gy2',
  'b_w',
  {'color': 'gray', 'distance': 0.42, 'estimate': 0, 'trail': 'w'}),
 ('w_gy2',
  'b_gy2',
  {'color': 'yellowgreen', 'distance': 0.03, 'estimate': 1, 'trail': 'gy2'})]
De même, vos nœuds sont représentés par une liste de tuples de longueur 2. Le premier élément est l’ID du nœud, suivi du dictionnaire de ses attributs.
# Preview first 10 nodes
g.nodes(data=True)[0:10]
[('rs_end_south', {'X': 1865, 'Y': 1598}),
 ('w_gy2', {'X': 2000, 'Y': 954}),
 ('rd_end_south_dupe', {'X': 273, 'Y': 1869}),
 ('w_gy1', {'X': 1184, 'Y': 1445}),
 ('g_rt', {'X': 908, 'Y': 1378}),
 ('v_rd', {'X': 258, 'Y': 1684}),
 ('g_rs', {'X': 1676, 'Y': 775}),
 ('rc_end_north', {'X': 867, 'Y': 618}),
 ('v_end_east', {'X': 2131, 'Y': 921}),
 ('rh_end_south', {'X': 721, 'Y': 1925})]
Affichons quelques statistiques avant de visualiser le graphe.
print('# of edges: {}'.format(g.number_of_edges()))
print('# of nodes: {}'.format(g.number_of_nodes()))
# of edges: 123
# of nodes: 77Positions : Commencez par extraire les positions des nœuds du graphe dans un dictionnaire. Cela vous permettra de reproduire le graphe avec la même disposition que la carte des sentiers. On prend l’opposé de Y pour déplacer l’origine de l’axe vertical du coin supérieur gauche vers le coin inférieur gauche.
# Define node positions data structure (dict) for plotting
node_positions = {node[0]: (node[1]['X'], -node[1]['Y']) for node in g.nodes(data=True)}

# Preview of node_positions with a bit of hack (there is no head/slice method for dictionaries).
dict(list(node_positions.items())[0:5])
{'b_rd': (268, -1744),
 'g_rt': (908, -1378),
 'o_gy1': (1130, -1297),
 'rh_end_tt_2': (550, -1608),
 'rs_end_south': (1865, -1598)}
Couleurs : Transformez maintenant les couleurs des arêtes du graphe en une simple liste afin de pouvoir visualiser les sentiers par couleur.
# Define data structure (list) of edge colors for plotting
edge_colors = [e[2]['color'] for e in g.edges(data=True)]

# Preview first 10
edge_colors[0:10]
['red',
 'gray',
 'yellowgreen',
 'gray',
 'yellowgreen',
 'blue',
 'black',
 'yellowgreen',
 'gray',
 'gray']
Vous pouvez maintenant produire un tracé qui s’aligne bien avec la carte des sentiers de Sleeping Giant :
plt.figure(figsize=(8, 6))
nx.draw(g, pos=node_positions, edge_color=edge_colors, node_size=10, node_color='black')
plt.title('Graph Representation of Sleeping Giant Trail Map', size=15)
plt.show()
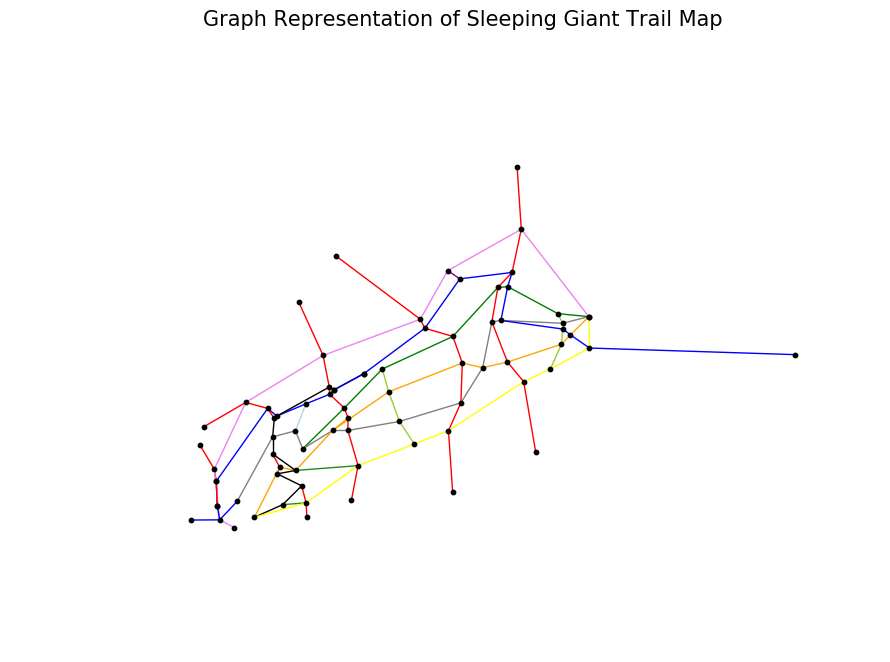
Cette représentation graphique ne reflète évidemment pas toutes les courbes et sinuosités des sentiers, mais pas d’inquiétude : elles sont bien prises en compte par l’attribut distance des arêtes, utilisé pour le calcul. La vue représente plutôt la distance « à vol d’oiseau » entre les nœuds (intersections), ce qui s’avère une approximation convenable.
Très bien, maintenant que vous avez défini quelques termes et créé le graphe, comment trouver le plus court chemin qui le parcourt ?
Résoudre le problème du facteur chinois est conceptuellement assez simple :
Trouver tous les nœuds de degré impair (très facile).
(Trouver toutes les intersections où un nombre impair de sentiers se rencontrent)
Ajouter des arêtes au graphe de sorte que tous les nœuds de degré impair deviennent pairs. Ces arêtes ajoutées doivent être des doublons d’arêtes du graphe original (pas de hors-piste dans ce problème). L’ensemble des arêtes ajoutées doit avoir une distance totale minimale (difficile… NP-difficile pour être précis).
(En termes simples, minimiser le « retour en arrière » sur un itinéraire qui couvre tous les sentiers)
Étant donné un point de départ, trouver la tournée eulérienne sur le graphe augmenté (modérément facile).
(Une fois que l’on sait sur quels sentiers on devra repasser, calculer l’itinéraire de bout en bout)
On pourrait obtenir un trajet plus court et plus précis en assouplissant les hypothèses ci-dessous, mais cela ajouterait une complexité au-delà du périmètre de ce tutoriel, centré sur le CPP.
Hypothèse 1 : uniquement les sentiers requis
Comme vous pouvez le voir sur la carte, des routes longent les frontières du parc et pourraient être utilisées pour relier des sentiers, notamment les rouges. Il existe aussi des sentiers (Horseshoe et marques non officielles) non requis selon le registre Giantmaster, mais utiles pour éviter de longs retours. L’inclusion de sentiers optionnels constitue une variante connue du CPP : le Rural Postman Problem. Nous les ignorons ici et nous concentrons sur les sentiers requis uniquement.
Hypothèse 2 : montée == descente
Le CPP suppose que le coût de marche d’un sentier équivaut à sa distance, quel que soit le sens. Or certains sentiers sont pentus et demandent plus d’énergie à la montée qu’à la descente. Une métrique combinant distance et dénivelé sur un graphe orienté pourrait être intégrée via une extension appelée Windy Postman Problem.
Hypothèse 3 : pas d’arêtes parallèles (sentiers parallèles)
C’est possible, mais l’inclusion d’arêtes parallèles (plusieurs sentiers reliant la même paire de nœuds) complique les calculs. Heureusement cela n’arrive ici que deux fois (Blue <=> Red Diamond et Blue <=> Tower Trail). Nous traitons cela par un petit « hack » dans la liste d’arêtes : des nœuds dupliqués avec un suffixe _dupe sont ajoutés pour capturer chaque sentier tout en conservant l’unicité des arêtes. L’implémentation du CPP dans le package postman_problems que j’ai écrit gère les arêtes parallèles de manière plus élégante si vous souhaitez résoudre le CPP sur un graphe comportant de nombreux parallèles.
C’est un simple comptage. On observe que 36 nœuds sur 76 ont un degré impair. Ce sont principalement des impasses (degré 1) et des intersections de 3 sentiers. Il y a aussi quelques nœuds de degré 5.
# Calculate list of nodes with odd degree
nodes_odd_degree = [v for v, d in g.degree_iter() if d % 2 == 1]

# Preview
nodes_odd_degree[0:5]
['rs_end_south', 'rc_end_north', 'v_end_east', 'rh_end_south', 'b_end_east']
# Counts
print('Number of nodes of odd degree: {}'.format(len(nodes_odd_degree)))
print('Number of total nodes: {}'.format(len(g.nodes())))
Number of nodes of odd degree: 36
Number of total nodes: 77
C’est le cœur du problème. On le décompose en 5 parties :
On utilise la fonction itertools.combinations pour calculer toutes les paires possibles de nœuds impairs. Le graphe est non orienté, donc l’ordre n’a pas d’importance : par exemple (a,b) == (b,a).
# Compute all pairs of odd nodes. in a list of tuples
odd_node_pairs = list(itertools.combinations(nodes_odd_degree, 2))

# Preview pairs of odd degree nodes
odd_node_pairs[0:10]
[('rs_end_south', 'rc_end_north'),
 ('rs_end_south', 'v_end_east'),
 ('rs_end_south', 'rh_end_south'),
 ('rs_end_south', 'b_end_east'),
 ('rs_end_south', 'b_bv'),
 ('rs_end_south', 'rt_end_south'),
 ('rs_end_south', 'o_rt'),
 ('rs_end_south', 'y_rt'),
 ('rs_end_south', 'g_gy2'),
 ('rs_end_south', 'b_tt_3')]
# Counts
print('Number of pairs: {}'.format(len(odd_node_pairs)))
Number of pairs: 630
Vérifions que ce nombre est correct par un petit calcul combinatoire. Heureusement, il n’y a « que » 630 paires. Le temps de calcul de cet exemple CPP est négligeable (quelques secondes).
En revanche, si vous aviez 3 600 nœuds impairs, vous auriez environ 6,5 millions de paires à optimiser. Soit ~10 000× plus de sorties pour 100× plus d’entrées.
C’est la première étape avec du calcul réel. Heureusement, networkx propose une implémentation pratique de l’algorithme de Dijkstra pour calculer le plus court chemin entre deux nœuds. Vous appliquez cette fonction à toutes les paires (les 630) de odd_node_pairs.
def get_shortest_paths_distances(graph, pairs, edge_weight_name):
    """Compute shortest distance between each pair of nodes in a graph.  Return a dictionary keyed on node pairs (tuples)."""
    distances = {}
    for pair in pairs:
        distances[pair] = nx.dijkstra_path_length(graph, pair[0], pair[1], weight=edge_weight_name)
    return distances
# Compute shortest paths.  Return a dictionary with node pairs keys and a single value equal to shortest path distance.
odd_node_pairs_shortest_paths = get_shortest_paths_distances(g, odd_node_pairs, 'distance')

# Preview with a bit of hack (there is no head/slice method for dictionaries).
dict(list(odd_node_pairs_shortest_paths.items())[0:10])
{('b_bv', 'y_gy1'): 1.22,
 ('b_bw', 'rc_end_south'): 1.35,
 ('b_end_east', 'b_bw'): 3.0400000000000005,
 ('b_end_east', 'rd_end_north'): 3.83,
 ('g_gy1', 'nature_end_west'): 0.9900000000000001,
 ('o_rt', 'y_gy1'): 0.53,
 ('rc_end_north', 'rd_end_south'): 2.21,
 ('rc_end_north', 'rs_end_north'): 1.79,
 ('rs_end_north', 'o_tt'): 2.0999999999999996,
 ('w_bw', 'rd_end_north'): 1.02}
Un graphe complet est un graphe où chaque nœud est relié à tous les autres par une arête unique.
Voici un exemple de Wikipédia : un graphe complet à 7 nœuds avec 21 arêtes (7 parmi 2) :
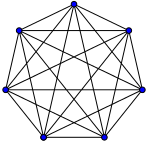
Le graphe que vous créez ci-dessous a 36 nœuds et 630 arêtes avec leur poids (distance) associé.
La fonction create_complete_graph s’en charge. Le paramètre flip_weights sert à transformer l’attribut distance en attribut weight où les petites valeurs reflètent de grandes distances et les grandes valeurs de courtes distances. Cela peut sembler contre-intuitif, mais c’est nécessaire pour l’étape 2.4 où l’on calcule le maximum de poids du matching sur le graphe complet.
Idéalement, on calculerait directement l’appairage de poids minimal, mais NetworkX n’implémente qu’une fonction max_weight_matching qui maximise, plutôt que minimise, le poids. On contourne en prenant l’opposé (multiplication par -1) de distance pour obtenir weight. L’ordre et l’échelle sont préservés, mais inversés.
def create_complete_graph(pair_weights, flip_weights=True):
    """
    Create a completely connected graph using a list of vertex pairs and the shortest path distances between them
    Parameters:
        pair_weights: list[tuple] from the output of get_shortest_paths_distances
        flip_weights: Boolean. Should we negate the edge attribute in pair_weights?
    """
    g = nx.Graph()
    for k, v in pair_weights.items():
        wt_i = - v if flip_weights else v
        g.add_edge(k[0], k[1], attr_dict={'distance': v, 'weight': wt_i})
    return g
# Generate the complete graph
g_odd_complete = create_complete_graph(odd_node_pairs_shortest_paths, flip_weights=True)

# Counts
print('Number of nodes: {}'.format(len(g_odd_complete.nodes())))
print('Number of edges: {}'.format(len(g_odd_complete.edges())))
Number of nodes: 36
Number of edges: 630
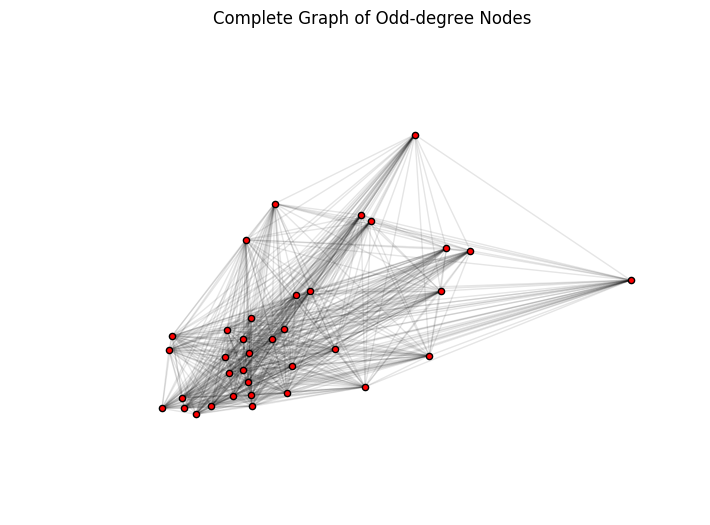
Pour illustrer, le graphe entièrement connecté des paires de nœuds impairs est tracé ci-dessous. Notez que vous conservez les coordonnées X, Y de chaque nœud, mais les arêtes ne représentent pas forcément des sentiers réels. Par exemple, deux nœuds peuvent être reliés par une seule arête sur ce graphe, alors que le plus court chemin réel peut compter 5 sauts via des nœuds de degré pair (non représentés ici).
# Plot the complete graph of odd-degree nodes
plt.figure(figsize=(8, 6))
pos_random = nx.random_layout(g_odd_complete)
nx.draw_networkx_nodes(g_odd_complete, node_positions, node_size=20, node_color="red")
nx.draw_networkx_edges(g_odd_complete, node_positions, alpha=0.1)
plt.axis('off')
plt.title('Complete Graph of Odd-degree Nodes')
plt.show()
C’est l’étape la plus complexe du CPP. Il faut trouver les paires de nœuds impairs dont la somme des distances est minimale. Dans notre cas, il s’agit de sélectionner 18 arêtes optimales (36 nœuds impairs / 2) dans le « paquet de nœuds » généré en 2.3.
L’implémentation et l’intuition derrière cette optimisation dépassent le cadre de ce tutoriel… on parle de 800+ lignes de code et d’une littérature académique conséquente.
Petite parenthèse pour les curieux :
Un grand merci à Joris van Rantwijk pour l’implémentation originale publiée sur son blog en 2008. Je suis tombé sur le problème d’une façon similaire et avec la même intention que Joris. Extrait de son billet de 2008 :
Since I did not find any Perl implementations of maximum weighted matching, I lightly decided to write some code myself. It turned out that I had underestimated the problem, but by the time I realized my mistake, I was so obsessed with the problem that I refused to give up.
Moi, j’ai fini par abandonner. Heureusement, pas Joris.
Ce Maximum Weight Matching a depuis été intégré et maintenu dans NetworkX. Merci aussi aux 10+ contributeurs sur GitHub qui entretiennent ce code massif.
C’est un calcul difficile et intensif. La première percée en 1965 a prouvé que le problème du maximum matching pouvait être résolu en temps polynomial. Il a été publié par Jack Edmonds, avec l’un des plus beaux titres d’article qui soient : « Paths, trees, and flowers » [1]. Depuis, de nombreux travaux ont amélioré la procédure d’optimisation. Le code utilisé dans la fonction NetworkX max_weight_matching s’appuie sur Galil, Zvi (1986) [2] avec un algorithme en O(n3).
# Compute min weight matching.
# Note: max_weight_matching uses the 'weight' attribute by default as the attribute to maximize.
odd_matching_dupes = nx.algorithms.max_weight_matching(g_odd_complete, True)

print('Number of edges in matching: {}'.format(len(odd_matching_dupes)))
Number of edges in matching: 36
La sortie (odd_matching_dupes) est un dictionnaire. Bien qu’il y ait 36 arêtes dans cet appairage, nous n’en voulons que 18. Chaque paire apparaît deux fois (une fois avec le nœud 1 comme clé, et une seconde fois avec le nœud 2 comme clé).
# Preview of matching with dupes
odd_matching_dupes
{'b_bv': 'v_bv',
 'b_bw': 'rh_end_tt_1',
 'b_end_east': 'g_gy2',
 'b_end_west': 'rd_end_south',
 'b_tt_3': 'rt_end_north',
 'b_v': 'v_end_west',
 'g_gy1': 'rc_end_north',
 'g_gy2': 'b_end_east',
 'g_w': 'w_bw',
 'nature_end_west': 'o_y_tt_end_west',
 'o_rt': 'o_w_1',
 'o_tt': 'rh_end_tt_2',
 'o_w_1': 'o_rt',
 'o_y_tt_end_west': 'nature_end_west',
 'rc_end_north': 'g_gy1',
 'rc_end_south': 'y_gy1',
 'rd_end_north': 'rh_end_north',
 'rd_end_south': 'b_end_west',
 'rh_end_north': 'rd_end_north',
 'rh_end_south': 'y_rh',
 'rh_end_tt_1': 'b_bw',
 'rh_end_tt_2': 'o_tt',
 'rh_end_tt_3': 'rh_end_tt_4',
 'rh_end_tt_4': 'rh_end_tt_3',
 'rs_end_north': 'v_end_east',
 'rs_end_south': 'y_gy2',
 'rt_end_north': 'b_tt_3',
 'rt_end_south': 'y_rt',
 'v_bv': 'b_bv',
 'v_end_east': 'rs_end_north',
 'v_end_west': 'b_v',
 'w_bw': 'g_w',
 'y_gy1': 'rc_end_south',
 'y_gy2': 'rs_end_south',
 'y_rh': 'rh_end_south',
 'y_rt': 'rt_end_south'}
Convertissez ce dictionnaire en liste de tuples puisque le graphe est non orienté et l’ordre importe peu. En supprimant les doublons, vous obtenez les 18 paires uniques dont la somme des distances est minimale.
# Convert matching to list of deduped tuples
odd_matching = list(pd.unique([tuple(sorted([k, v])) for k, v in odd_matching_dupes.items()]))

# Counts
print('Number of edges in matching (deduped): {}'.format(len(odd_matching)))
Number of edges in matching (deduped): 18
# Preview of deduped matching
odd_matching
[('rs_end_south', 'y_gy2'),
 ('b_end_west', 'rd_end_south'),
 ('b_bv', 'v_bv'),
 ('rh_end_tt_3', 'rh_end_tt_4'),
 ('b_bw', 'rh_end_tt_1'),
 ('o_tt', 'rh_end_tt_2'),
 ('g_w', 'w_bw'),
 ('b_end_east', 'g_gy2'),
 ('nature_end_west', 'o_y_tt_end_west'),
 ('g_gy1', 'rc_end_north'),
 ('o_rt', 'o_w_1'),
 ('rs_end_north', 'v_end_east'),
 ('rc_end_south', 'y_gy1'),
 ('rh_end_south', 'y_rh'),
 ('rt_end_south', 'y_rt'),
 ('b_tt_3', 'rt_end_north'),
 ('rd_end_north', 'rh_end_north'),
 ('b_v', 'v_end_west')]
Visualisons ces paires sur le graphe complet tracé en 2.3. Comme précédemment, les positions des nœuds reflètent le graphe réel (la carte des sentiers), mais les distances d’arêtes affichées (lignes bleues) sont à vol d’oiseau. Le plus court trajet réel peut impliquer plusieurs arêtes sinueuses, et donc être plus long.
plt.figure(figsize=(8, 6))

# Plot the complete graph of odd-degree nodes
nx.draw(g_odd_complete, pos=node_positions, node_size=20, alpha=0.05)

# Create a new graph to overlay on g_odd_complete with just the edges from the min weight matching
g_odd_complete_min_edges = nx.Graph(odd_matching)
nx.draw(g_odd_complete_min_edges, pos=node_positions, node_size=20, edge_color='blue', node_color='red')

plt.title('Min Weight Matching on Complete Graph')
plt.show()
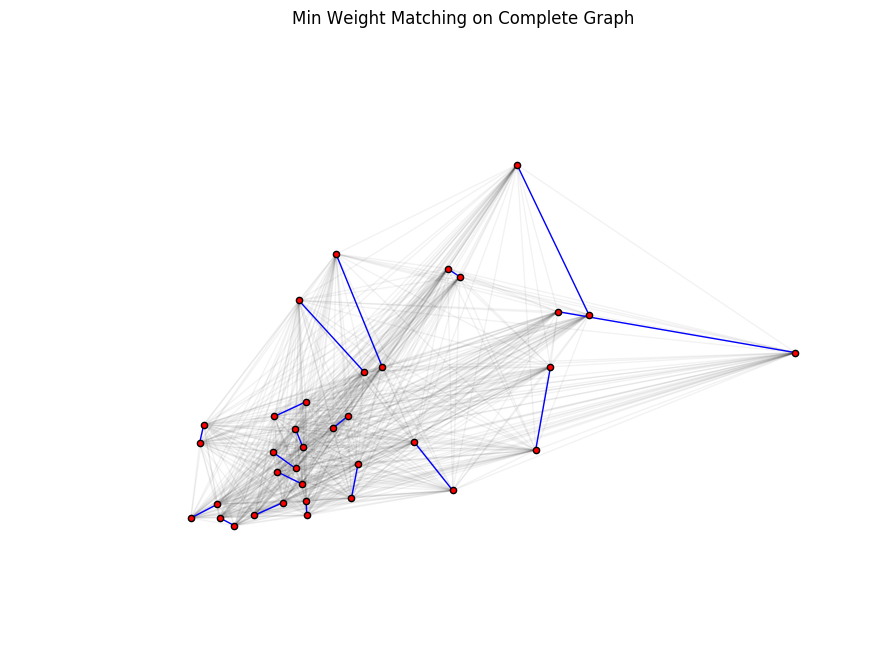
Pour montrer comment cela se superpose au graphe original, tracez les mêmes paires minimales (en bleu) au-dessus de la carte des sentiers (estompée) plutôt que du graphe complet. À nouveau, les lignes bleues représentent un « passage hors sentier » (liaisons à vol d’oiseau, pas des sentiers réels). Il reste un peu de travail pour retrouver les arêtes qui composent le plus court chemin entre chaque paire à l’étape 3.
plt.figure(figsize=(8, 6))

# Plot the original trail map graph
nx.draw(g, pos=node_positions, node_size=20, alpha=0.1, node_color='black')

# Plot graph to overlay with just the edges from the min weight matching
nx.draw(g_odd_complete_min_edges, pos=node_positions, node_size=20, alpha=1, node_color='red', edge_color='blue')

plt.title('Min Weight Matching on Orginal Graph')
plt.show()
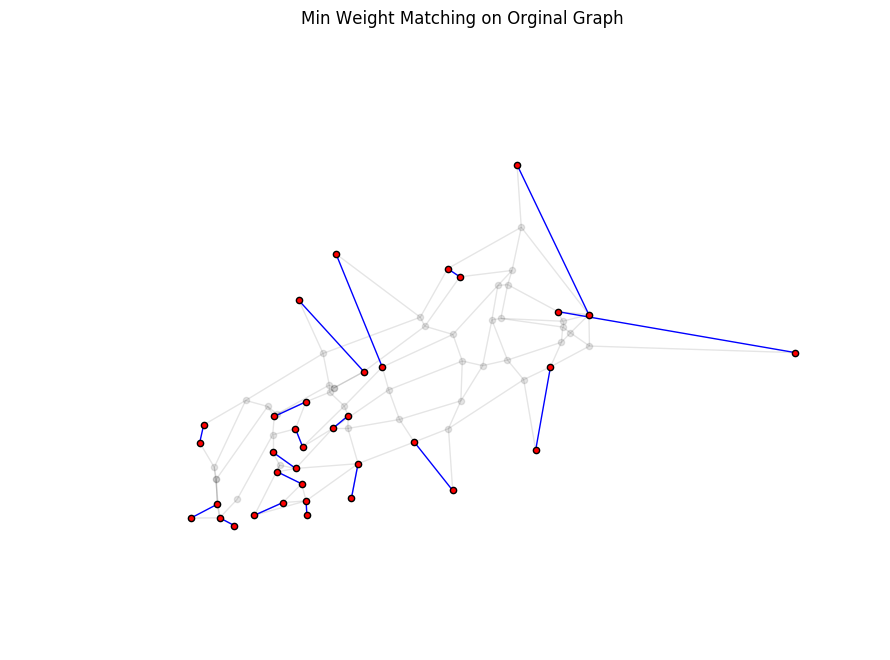
Vous allez maintenant augmenter le graphe original avec les arêtes issues du matching calculé en 2.4. La fonction ci-dessous ajoute ces nouvelles arêtes et précise qu’elles proviennent du graphe augmenté. Vous en aurez besoin en 3. pour construire la tournée eulérienne.
def add_augmenting_path_to_graph(graph, min_weight_pairs):
    """
    Add the min weight matching edges to the original graph
    Parameters:
        graph: NetworkX graph (original graph from trailmap)
        min_weight_pairs: list[tuples] of node pairs from min weight matching
    Returns:
        augmented NetworkX graph
    """

    # We need to make the augmented graph a MultiGraph so we can add parallel edges
    graph_aug = nx.MultiGraph(graph.copy())
    for pair in min_weight_pairs:
        graph_aug.add_edge(pair[0],
                           pair[1],
                           attr_dict={'distance': nx.dijkstra_path_length(graph, pair[0], pair[1]),
                                      'trail': 'augmented'}
                          )
    return graph_aug
Vérifions que votre graphe augmenté ajoute le nombre attendu (18) d’arêtes :
# Create augmented graph: add the min weight matching edges to g
g_aug = add_augmenting_path_to_graph(g, odd_matching)

# Counts
print('Number of edges in original graph: {}'.format(len(g.edges())))
print('Number of edges in augmented graph: {}'.format(len(g_aug.edges())))
Number of edges in original graph: 123
Number of edges in augmented graph: 141
Vérifions aussi que chaque nœud a désormais un degré pair :
pd.value_counts(g_aug.degree())
4    54
2    18
6     5
dtype: int64
Maintenant que le graphe est de degré pair, le plus dur est fait. Comme Euler l’a postulé en 1736 avec le problème des Sept ponts de Königsberg, il existe un chemin qui visite chaque arête exactement une fois si tous les nœuds sont de degré pair. Carl Hierholzer en a donné une preuve formelle dans les années 1870.
Plusieurs tournées eulériennes de même distance peuvent exister. Vous pouvez couvrir 90 % du besoin avec la fonction eulerian_circuit de NetworkX. Il y a toutefois des limites.
Limites que nous allons corriger :
Le graphe augmenté peut (et va probablement) contenir des arêtes absentes du graphe original. Pour obtenir la tournée (sans hors-piste), vous devez décomposer ces arêtes augmentées en plus courts chemins composés d’arêtes existant réellement.
eulerian_circuit ne renvoie que l’ordre des nœuds parcourus. Elle ne renvoie pas les attributs d’arêtes nécessaires pour compléter la tournée. Or, il faut savoir quelles arêtes ont déjà été parcourues quand plusieurs arêtes existent entre deux nœuds.
Limites que nous n’allons pas corriger :
Commençons par la solution simple mais incomplète :
naive_euler_circuit = list(nx.eulerian_circuit(g_aug, source='b_end_east'))
Comme prévu, la longueur de la tournée eulérienne naïve est égale au nombre d’arêtes du graphe augmenté.
print('Length of eulerian circuit: {}'.format(len(naive_euler_circuit)))
Length of eulerian circuit: 141
La sortie est simplement une liste de tuples représentant des paires de nœuds. Notez que le premier nœud de chaque paire est le même que le second nœud de la paire précédente.
# Preview naive Euler circuit
naive_euler_circuit[0:10]
[('b_end_east', 'g_gy2'),
 ('g_gy2', 'b_g'),
 ('b_g', 'b_w'),
 ('b_w', 'b_gy2'),
 ('b_gy2', 'w_gy2'),
 ('w_gy2', 'b_w'),
 ('b_w', 'w_rs'),
 ('w_rs', 'g_rs'),
 ('g_rs', 'b_g'),
 ('b_g', 'b_rs')]
Définissons maintenant une fonction qui s’appuie sur le graphe original pour indiquer quels sentiers emprunter pour aller du nœud A au nœud B. Bien que verbeux, le raisonnement est simple : on transforme la tournée naïve, qui inclut des arêtes absentes du graphe original, en une tournée eulérienne n’utilisant que des arêtes existantes.
On parcourt chaque arête de la tournée naïve (naive_euler_circuit). Chaque fois qu’une arête n’existe pas dans le graphe original, on la remplace par la séquence d’arêtes formant le plus court chemin entre ces nœuds dans le graphe original.
def create_eulerian_circuit(graph_augmented, graph_original, starting_node=None):
    """Create the eulerian path using only edges from the original graph."""
    euler_circuit = []
    naive_circuit = list(nx.eulerian_circuit(graph_augmented, source=starting_node))

    for edge in naive_circuit:
        edge_data = graph_augmented.get_edge_data(edge[0], edge[1])

        if edge_data[0]['trail'] != 'augmented':
            # If `edge` exists in original graph, grab the edge attributes and add to eulerian circuit.
            edge_att = graph_original[edge[0]][edge[1]]
            euler_circuit.append((edge[0], edge[1], edge_att))
        else:
            aug_path = nx.shortest_path(graph_original, edge[0], edge[1], weight='distance')
            aug_path_pairs = list(zip(aug_path[:-1], aug_path[1:]))

            print('Filling in edges for augmented edge: {}'.format(edge))
            print('Augmenting path: {}'.format(' => '.join(aug_path)))
            print('Augmenting path pairs: {}\n'.format(aug_path_pairs))

            # If `edge` does not exist in original graph, find the shortest path between its nodes and
            #  add the edge attributes for each link in the shortest path.
            for edge_aug in aug_path_pairs:
                edge_aug_att = graph_original[edge_aug[0]][edge_aug[1]]
                euler_circuit.append((edge_aug[0], edge_aug[1], edge_aug_att))

    return euler_circuit
Nous contournons légèrement la limite 3 en démarrant la tournée eulérienne à l’extrémité est du parc sur le sentier bleu (nœud "b_end_east"). En pratique, vous pourriez ignorer la dernière instruction qui y revient.
Des impressions détaillées ont été ajoutées pour montrer ce qu’il se passe lorsqu’on remplace des arêtes inexistantes du graphe augmenté par le plus court chemin via des arêtes réelles.
# Create the Eulerian circuit
euler_circuit = create_eulerian_circuit(g_aug, g, 'b_end_east')
Filling in edges for augmented edge: ('b_end_east', 'g_gy2')
Augmenting path: b_end_east => b_y => b_o => b_gy2 => w_gy2 => g_gy2
Augmenting path pairs: [('b_end_east', 'b_y'), ('b_y', 'b_o'), ('b_o', 'b_gy2'), ('b_gy2', 'w_gy2'), ('w_gy2', 'g_gy2')]

Filling in edges for augmented edge: ('b_bw', 'rh_end_tt_1')
Augmenting path: b_bw => b_tt_1 => rh_end_tt_1
Augmenting path pairs: [('b_bw', 'b_tt_1'), ('b_tt_1', 'rh_end_tt_1')]

Filling in edges for augmented edge: ('b_tt_3', 'rt_end_north')
Augmenting path: b_tt_3 => b_tt_2 => tt_rt => v_rt => rt_end_north
Augmenting path pairs: [('b_tt_3', 'b_tt_2'), ('b_tt_2', 'tt_rt'), ('tt_rt', 'v_rt'), ('v_rt', 'rt_end_north')]

Filling in edges for augmented edge: ('rc_end_north', 'g_gy1')
Augmenting path: rc_end_north => v_rc => b_rc => g_rc => g_gy1
Augmenting path pairs: [('rc_end_north', 'v_rc'), ('v_rc', 'b_rc'), ('b_rc', 'g_rc'), ('g_rc', 'g_gy1')]

Filling in edges for augmented edge: ('y_gy1', 'rc_end_south')
Augmenting path: y_gy1 => y_rc => rc_end_south
Augmenting path pairs: [('y_gy1', 'y_rc'), ('y_rc', 'rc_end_south')]

Filling in edges for augmented edge: ('b_end_west', 'rd_end_south')
Augmenting path: b_end_west => b_v => rd_end_south
Augmenting path pairs: [('b_end_west', 'b_v'), ('b_v', 'rd_end_south')]

Filling in edges for augmented edge: ('rh_end_north', 'rd_end_north')
Augmenting path: rh_end_north => v_rh => v_rd => rd_end_north
Augmenting path pairs: [('rh_end_north', 'v_rh'), ('v_rh', 'v_rd'), ('v_rd', 'rd_end_north')]

Filling in edges for augmented edge: ('v_end_east', 'rs_end_north')
Augmenting path: v_end_east => v_rs => rs_end_north
Augmenting path pairs: [('v_end_east', 'v_rs'), ('v_rs', 'rs_end_north')]

Filling in edges for augmented edge: ('y_gy2', 'rs_end_south')
Augmenting path: y_gy2 => y_rs => rs_end_south
Augmenting path pairs: [('y_gy2', 'y_rs'), ('y_rs', 'rs_end_south')]
La tournée eulérienne est plus longue que la tournée naïve, ce qui est logique.
print('Length of Eulerian circuit: {}'.format(len(euler_circuit)))
Length of Eulerian circuit: 158
Voici un aperçu textuel de la solution :
# Preview first 20 directions of CPP solution
for i, edge in enumerate(euler_circuit[0:20]):
    print(i, edge)
0 ('b_end_east', 'b_y', {'color': 'blue', 'estimate': 0, 'trail': 'b', 'distance': 1.32})
1 ('b_y', 'b_o', {'color': 'blue', 'estimate': 0, 'trail': 'b', 'distance': 0.08})
2 ('b_o', 'b_gy2', {'color': 'blue', 'estimate': 1, 'trail': 'b', 'distance': 0.05})
3 ('b_gy2', 'w_gy2', {'color': 'yellowgreen', 'estimate': 1, 'trail': 'gy2', 'distance': 0.03})
4 ('w_gy2', 'g_gy2', {'color': 'yellowgreen', 'estimate': 0, 'trail': 'gy2', 'distance': 0.05})
5 ('g_gy2', 'b_g', {'color': 'green', 'estimate': 0, 'trail': 'g', 'distance': 0.45})
6 ('b_g', 'b_w', {'color': 'blue', 'estimate': 0, 'trail': 'b', 'distance': 0.16})
7 ('b_w', 'b_gy2', {'color': 'blue', 'estimate': 0, 'trail': 'b', 'distance': 0.41})
8 ('b_gy2', 'w_gy2', {'color': 'yellowgreen', 'estimate': 1, 'trail': 'gy2', 'distance': 0.03})
9 ('w_gy2', 'b_w', {'color': 'gray', 'estimate': 0, 'trail': 'w', 'distance': 0.42})
10 ('b_w', 'w_rs', {'color': 'gray', 'estimate': 1, 'trail': 'w', 'distance': 0.06})
11 ('w_rs', 'g_rs', {'color': 'red', 'estimate': 0, 'trail': 'rs', 'distance': 0.18})
12 ('g_rs', 'b_g', {'color': 'green', 'estimate': 1, 'trail': 'g', 'distance': 0.05})
13 ('b_g', 'b_rs', {'color': 'blue', 'estimate': 0, 'trail': 'b', 'distance': 0.07})
14 ('b_rs', 'g_rs', {'color': 'red', 'estimate': 0, 'trail': 'rs', 'distance': 0.11})
15 ('g_rs', 'g_rc', {'color': 'green', 'estimate': 0, 'trail': 'g', 'distance': 0.45})
16 ('g_rc', 'g_gy1', {'color': 'green', 'estimate': 0, 'trail': 'g', 'distance': 0.37})
17 ('g_gy1', 'g_rt', {'color': 'green', 'estimate': 0, 'trail': 'g', 'distance': 0.26})
18 ('g_rt', 'g_w', {'color': 'green', 'estimate': 0, 'trail': 'g', 'distance': 0.31})
19 ('g_w', 'o_w_1', {'color': 'gray', 'estimate': 0, 'trail': 'w', 'distance': 0.18})
On voit vite que l’algorithme n’est pas « fidèle » à un sentier donné : il change souvent. Une extension pourrait intégrer une notion de « fidélité au sentier » dans la fonction objectif pour rendre l’itinéraire plus confortable à parcourir.
Jetons un œil à votre solution pour en évaluer la plausibilité.
(Le code verbeux n’est pas l’essentiel ici ; concentrez-vous sur la sortie)
# Computing some stats
total_mileage_of_circuit = sum([edge[2]['distance'] for edge in euler_circuit])
total_mileage_on_orig_trail_map = sum(nx.get_edge_attributes(g, 'distance').values())
_vcn = pd.value_counts(pd.value_counts([(e[0]) for e in euler_circuit]), sort=False)
node_visits = pd.DataFrame({'n_visits': _vcn.index, 'n_nodes': _vcn.values})
_vce = pd.value_counts(pd.value_counts([sorted(e)[0] + sorted(e)[1] for e in nx.MultiDiGraph(euler_circuit).edges()]))
edge_visits = pd.DataFrame({'n_visits': _vce.index, 'n_edges': _vce.values})

# Printing stats
print('Mileage of circuit: {0:.2f}'.format(total_mileage_of_circuit))
print('Mileage on original trail map: {0:.2f}'.format(total_mileage_on_orig_trail_map))
print('Mileage retracing edges: {0:.2f}'.format(total_mileage_of_circuit-total_mileage_on_orig_trail_map))
print('Percent of mileage retraced: {0:.2f}%\n'.format((1-total_mileage_of_circuit/total_mileage_on_orig_trail_map)*-100))

print('Number of edges in circuit: {}'.format(len(euler_circuit)))
print('Number of edges in original graph: {}'.format(len(g.edges())))
print('Number of nodes in original graph: {}\n'.format(len(g.nodes())))

print('Number of edges traversed more than once: {}\n'.format(len(euler_circuit)-len(g.edges())))

print('Number of times visiting each node:')
print(node_visits.to_string(index=False))

print('\nNumber of times visiting each edge:')
print(edge_visits.to_string(index=False))
Mileage of circuit: 33.59
Mileage on original trail map: 25.76
Mileage retracing edges: 7.83
Percent of mileage retraced: 30.40%

Number of edges in circuit: 158
Number of edges in original graph: 123
Number of nodes in original graph: 77

Number of edges traversed more than once: 35

Number of times visiting each node:
n_nodes  n_visits
     18         1
     38         2
     20         3
      1         4

Number of times visiting each edge:
n_edges  n_visits
     88         1
     35         2
NetworkX offre aussi des fonctions de visualisation, mais elles restent volontairement modestes :
NetworkX provides basic functionality for visualizing graphs, but its main goal is to enable graph analysis rather than perform graph visualization. In the future, graph visualization functionality may be removed from NetworkX or only available as an add-on package.
Proper graph visualization is hard, and we highly recommend that people visualize their graphs with tools dedicated to that task. Notable examples of dedicated and fully-featured graph visualization tools are Cytoscape, Gephi, Graphviz and, for LaTeX typesetting, PGF/TikZ.
Cela dit, la fonction de tracé intégrée de NetworkX avec matplotlib est suffisante pour explorer visuellement des graphes basiques, donc nous l’utiliserons ici.
J’ai utilisé graphviz et le langage de description dot pour visualiser la solution dans mon package Python postman_problems. La conversion de la structure NetworkX vers dot demande un peu de travail, mais elle offre une meilleure qualité et un meilleur contrôle.
Première étape : convertir la liste d’arêtes de la tournée eulérienne en liste d’arêtes avec des attributs adaptés au tracé.
create_cpp_edgelist crée une liste d’arêtes avec des attributs additionnels utiles pour la visualisation :
def create_cpp_edgelist(euler_circuit):
    """
    Create the edgelist without parallel edge for the visualization
    Combine duplicate edges and keep track of their sequence and # of walks
    Parameters:
        euler_circuit: list[tuple] from create_eulerian_circuit
    """
    cpp_edgelist = {}

    for i, e in enumerate(euler_circuit):
        edge = frozenset([e[0], e[1]])

        if edge in cpp_edgelist:
            cpp_edgelist[edge][2]['sequence'] += ', ' + str(i)
            cpp_edgelist[edge][2]['visits'] += 1

        else:
            cpp_edgelist[edge] = e
            cpp_edgelist[edge][2]['sequence'] = str(i)
            cpp_edgelist[edge][2]['visits'] = 1

    return list(cpp_edgelist.values())
Créons la liste d’arêtes du CPP :
cpp_edgelist = create_cpp_edgelist(euler_circuit)
Comme prévu, la liste d’arêtes contient le même nombre d’arêtes que le graphe original.
print('Number of edges in CPP edge list: {}'.format(len(cpp_edgelist)))
Number of edges in CPP edge list: 123
La liste d’arêtes du CPP ressemble à euler_circuit, avec quelques attributs supplémentaires.
# Preview CPP plot-friendly edge list
cpp_edgelist[0:3]
[('rh_end_tt_4',
  'nature_end_west',
  {'color': 'black',
   'distance': 0.2,
   'estimate': 0,
   'sequence': '73',
   'trail': 'tt',
   'visits': 1}),
 ('rd_end_south',
  'b_rd',
  {'color': 'red',
   'distance': 0.13,
   'estimate': 0,
   'sequence': '95',
   'trail': 'rd',
   'visits': 1}),
 ('w_gy1',
  'w_rc',
  {'color': 'gray',
   'distance': 0.33,
   'estimate': 0,
   'sequence': '151',
   'trail': 'w',
   'visits': 1})]
Passons au graphe :
# Create CPP solution graph
g_cpp = nx.Graph(cpp_edgelist)
Ici, on illustre quelles arêtes sont parcourues une seule fois (gris) et plusieurs fois (bleu). C’est la version « correcte » de la visualisation créée en 2.4, qui montrait les liaisons naïves (à vol d’oiseau) entre paires de nœuds impairs (rouge). On corrige ici en retraçant les plus courts chemins via des arêtes existantes.
Si l’optimisation est bonne, ces lignes bleues doivent représenter la distance minimale nécessaire, c’est-à-dire l’appairage minimal des nœuds impairs.
plt.figure(figsize=(14, 10))

visit_colors = {1:'lightgray', 2:'blue'}
edge_colors = [visit_colors[e[2]['visits']] for e in g_cpp.edges(data=True)]
node_colors = ['red'  if node in nodes_odd_degree else 'lightgray' for node in g_cpp.nodes()]

nx.draw_networkx(g_cpp, pos=node_positions, node_size=20, node_color=node_colors, edge_color=edge_colors, with_labels=False)
plt.axis('off')
plt.show()
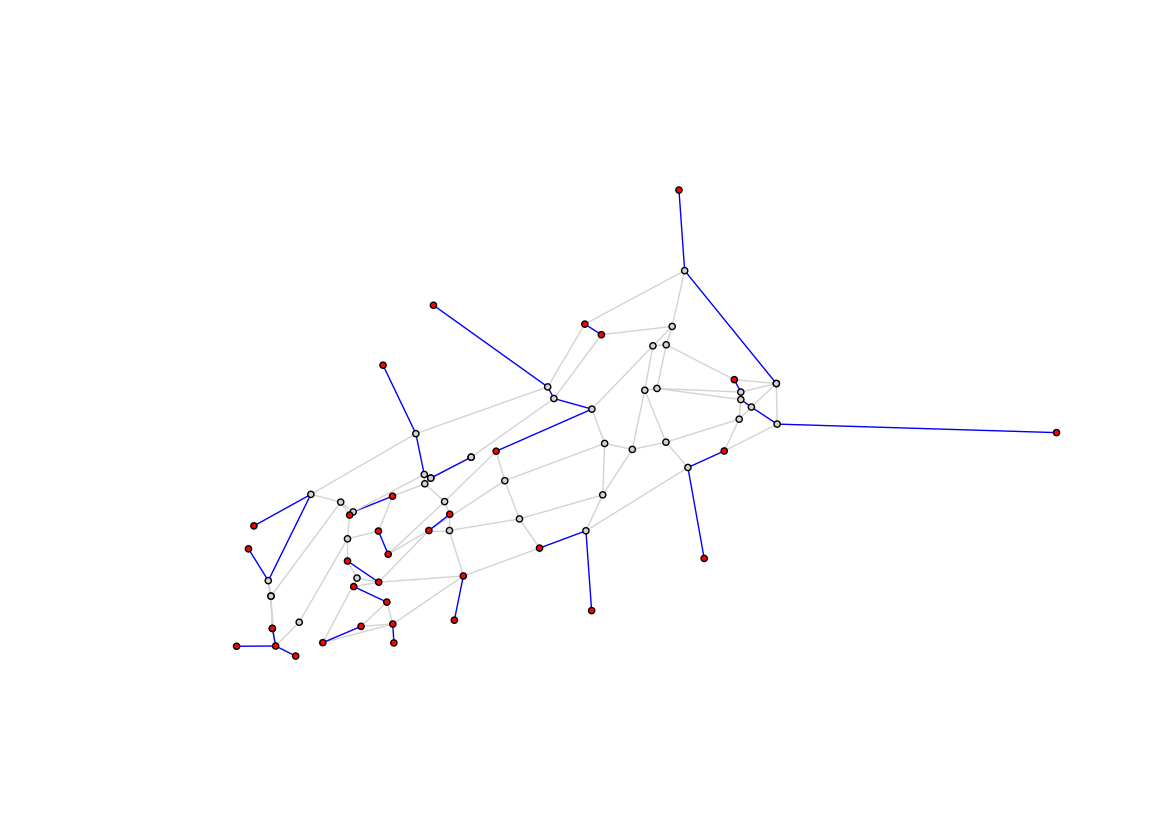
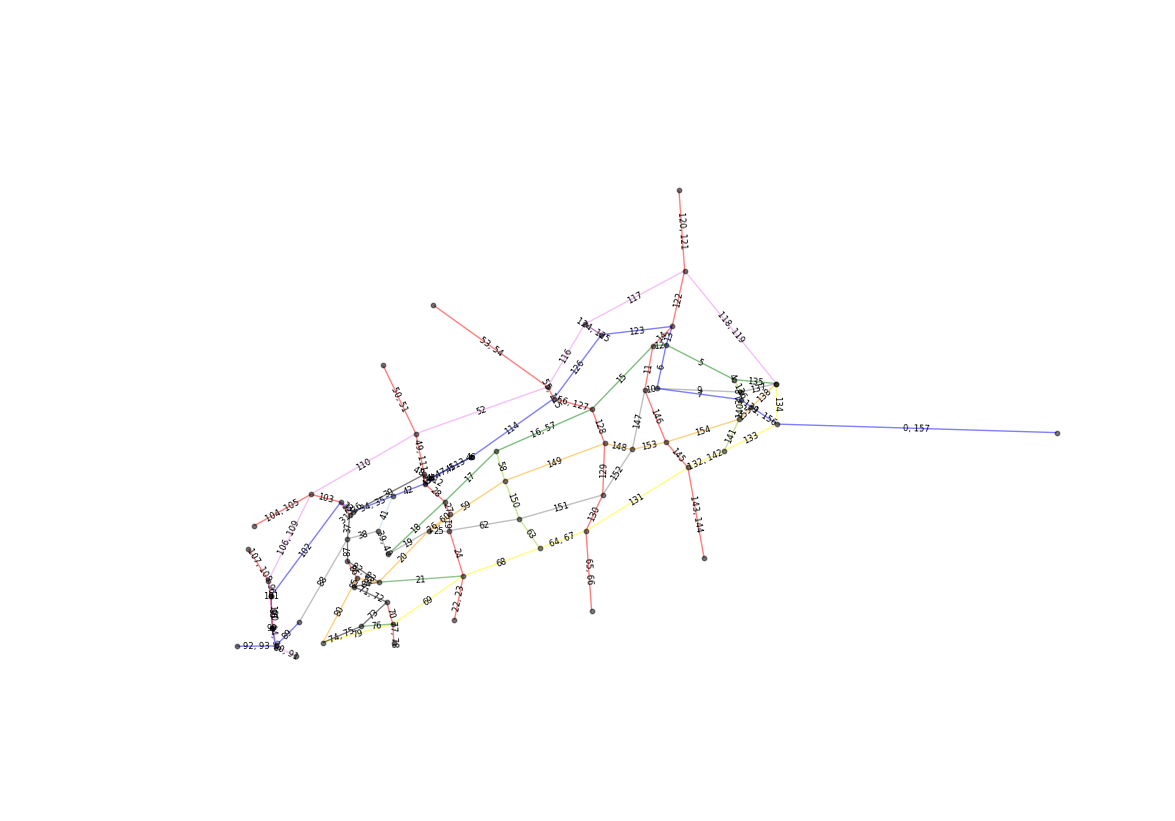
Ici, on trace le graphe original (carte des sentiers) annoté des numéros d’ordre dans lesquels les sentiers sont parcourus selon la solution CPP. Des numéros multiples indiquent les sentiers sur lesquels on repasse.
Vous démarrez sur le sentier bleu en bas à droite (0e et 157e instruction).
plt.figure(figsize=(14, 10))

edge_colors = [e[2]['color'] for e in g_cpp.edges(data=True)]
nx.draw_networkx(g_cpp, pos=node_positions, node_size=10, node_color='black', edge_color=edge_colors, with_labels=False, alpha=0.5)

bbox = {'ec':[1,1,1,0], 'fc':[1,1,1,0]}  # hack to label edges over line (rather than breaking up line)
edge_labels = nx.get_edge_attributes(g_cpp, 'sequence')
nx.draw_networkx_edge_labels(g_cpp, pos=node_positions, edge_labels=edge_labels, bbox=bbox, font_size=6)

plt.axis('off')
plt.show()
Le film ci-dessous retrace la tournée eulérienne du début à la fin. Les arêtes sont en noir au premier passage et en rouge au second.
Notez que ce gif ne rend pas parfaitement les arêtes qui se superposent ou sont trop petites pour être visibles. Une bibliothèque plus robuste comme graphviz pourrait y remédier en traçant des splines plutôt que des segments droits.
Le code de génération est donné ci-dessous à titre de référence.

On commence par produire une image PNG pour chaque instruction (arête parcourue) de la solution CPP.
visit_colors = {1:'black', 2:'red'}
edge_cnter = {}
g_i_edge_colors = []
for i, e in enumerate(euler_circuit, start=1):

    edge = frozenset([e[0], e[1]])
    if edge in edge_cnter:
        edge_cnter[edge] += 1
    else:
        edge_cnter[edge] = 1

    # Full graph (faded in background)
    nx.draw_networkx(g_cpp, pos=node_positions, node_size=6, node_color='gray', with_labels=False, alpha=0.07)

    # Edges walked as of iteration i
    euler_circuit_i = copy.deepcopy(euler_circuit[0:i])
    for i in range(len(euler_circuit_i)):
        edge_i = frozenset([euler_circuit_i[i][0], euler_circuit_i[i][1]])
        euler_circuit_i[i][2]['visits_i'] = edge_cnter[edge_i]
    g_i = nx.Graph(euler_circuit_i)
    g_i_edge_colors = [visit_colors[e[2]['visits_i']] for e in g_i.edges(data=True)]

    nx.draw_networkx_nodes(g_i, pos=node_positions, node_size=6, alpha=0.6, node_color='lightgray', with_labels=False, linewidths=0.1)
    nx.draw_networkx_edges(g_i, pos=node_positions, edge_color=g_i_edge_colors, alpha=0.8)

    plt.axis('off')
    plt.savefig('fig/png/img{}.png'.format(i), dpi=120, bbox_inches='tight')
    plt.close()
Ensuite, les PNG sont assemblés pour créer le gif ci-dessus.
On trie d’abord les PNG dans l’ordre de 0 à 157. Puis on les assemble avec imageio à 3 images par seconde.
import glob
import numpy as np
import imageio
import os

def make_circuit_video(image_path, movie_filename, fps=5):
    # sorting filenames in order
    filenames = glob.glob(image_path + 'img*.png')
    filenames_sort_indices = np.argsort([int(os.path.basename(filename).split('.')[0][3:]) for filename in filenames])
    filenames = [filenames[i] for i in filenames_sort_indices]

    # make movie
    with imageio.get_writer(movie_filename, mode='I', fps=fps) as writer:
        for filename in filenames:
            image = imageio.imread(filename)
            writer.append_data(image)

make_circuit_video('fig/png/', 'fig/gif/cpp_route_animation.gif', fps=3)Bravo, vous avez terminé ce tutoriel en résolvant le problème du facteur chinois en Python. Vous avez couvert pas mal de terrain (33,6 miles de sentiers pour être précis). Pour approfondir les fondamentaux des réseaux, vous pouvez suivre le cours Network Analysis in Python de DataCamp, qui traite plus en détail les concepts clés.
N’hésitez pas à consulter la documentation NetworkX pour en savoir plus sur la création, la manipulation et le parcours de ces réseaux complexes. Les docs sont complètes, avec de nombreux exemples et une série de tutoriels.
Si vous souhaitez résoudre le CPP sur votre propre graphe, j’ai empaqueté les fonctionnalités de ce tutoriel dans le package Python postman_problems sur GitHub. Vous pouvez aussi réutiliser les blocs de code avec une autre liste d’arêtes et de nœuds, mais le package postman_problems vous fera gagner du temps et de la clarté.
Un jour, je prévois d’implémenter ici les extensions du CPP (Rural et Windy Postman Problem). J’ai aussi pour ambition d’écrire sur ces extensions et mes retours d’expérience sur les sentiers sur mon blog ici. Une autre piste : intégrer des coordonnées lat/long pour développer (ou utiliser) un mécanisme d’envoi d’instructions virage par virage à ma montre Garmin.
Et bien sûr, une dernière étape : sortir et courir l’itinéraire !
Pour en apprendre davantage sur les réseaux en Python, découvrez ces cours DataCamp :
Introduction to Network Analysis in Python
Intermediate Network Analysis in Python
1 : Edmonds, Jack (1965). « Paths, trees, and flowers ». Canad. J. Math. 17 : 449–467.
2 : Galil, Z. (1986). « Efficient algorithms for finding maximum matching in graphs ». ACM Computing Surveys. Vol. 18, no 1 : 23-38.
En savoir plus sur Python
Cours
Cours
Cours