

什么是 Hugging Face 的 Smolagents?
正如 Hugging Face 的公告博客所述,smolagents 是“一款非常简单的库,为语言模型解锁代理能力”。但为什么我们需要借助库来构建代理?
从本质上讲,代理由大语言模型驱动,通过观察环境、制定计划并利用其工具箱执行计划,以动态方式完成任务。构建这些代理并非不可能,但往往需要您从零编写许多组件。这些组件确保代理在不迅速消耗 API 额度和执行时间的前提下正常工作。代理型框架让这一切更容易,从而避免“重复造轮子”。
AI 代理框架常常面临两点批评:
- 抽象层过多,导致框架僵化且难以调试。
- 更关注“工作流”,而非构建能自主动态协作的代理。
而 smolagents 具备的一些特性,使其在代理应用中颇具前景:
- 框架的抽象保持在最低限度。
- 多数框架让代理以 JSON/文本格式定义动作,而 smolagents 的主要思路是代码代理(Code Agents),即将动作写成 Python 代码片段(这不同于让代理“写代码”的场景)。
- 作为 Hugging Face 的一员,smolagents 能很好地与 Hub 和 Transformers 库集成。您可以使用 Hub 上的众多模型(其中一些仅对专业用户开放),也可以使用 OpenAI、Anthropic 等专有模型。
- 您可以轻松使用现成工具,或以极低成本自定义工具,几乎就像编写一个 Python 函数一样简单。
这些特性使 smolagents 在纸面上看起来几乎是“即插即用”的 AI 代理方案。接下来让我们看看它在实践中的表现。
用 Smolagents 构建演示项目
本节我们将用 smolagents 搭建一个简单演示。我们的应用会让一个代理获取 Hugging Face Daily Papers 页面上票数最高的论文。我们将为代理构建自定义工具,并观察它的运行情况。
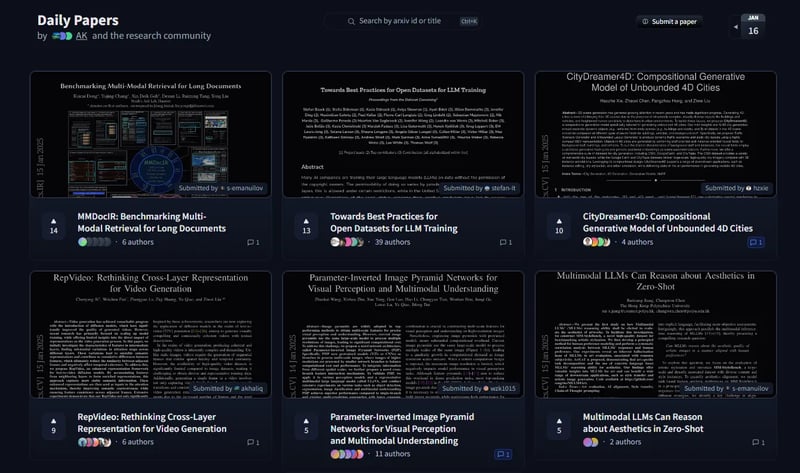
Daily Papers,是追踪每日顶级研究论文的好来源。
设置 smolagents
要使用 smolagents,您只需安装该库并提供 Hugging Face 令牌。该框架的易用性是一个加分项。
安装包,运行:
pip install smolagents构建自定义工具
虽然框架提供了可直接开箱即用的内置工具(如 DuckDuckGoSearchTool),但自定义工具同样非常直接。针对我们的目标,我们构建四个工具,各司其职:
- 获取当日票数最高论文的标题。
- 根据标题获取论文的 ID。
- 使用该 ID 从 arXiv 下载论文。
- 读取下载的 PDF 文件。
导致代理出错的常见原因之一是工具使用。要为代理目的优化工具,关键是确保代理清楚地知道该用哪个工具以及如何使用。为此,在定义工具时应尽可能明确:
- 为函数选择信息量丰富的名称。
- 函数的输入与输出应包含类型注解。
- 必须包含工具用途的描述,作为代理的“使用手册”。
现在我们来构建第一个自定义工具,用于解析 Daily Papers 页面并获取票数最高论文的标题:
from smolagents import tool
# import packages that are used in our tools
import requests
from bs4 import BeautifulSoup
import json
@tool
def get_hugging_face_top_daily_paper() -> str:
"""
This is a tool that returns the most upvoted paper on Hugging Face daily papers.
It returns the title of the paper
"""
try:
url = "<https://huggingface.co/papers>"
response = requests.get(url)
response.raise_for_status() # Raise an exception for bad status codes (4xx or 5xx)
soup = BeautifulSoup(response.content, "html.parser")
# Extract the title element from the JSON-like data in the "data-props" attribute
containers = soup.find_all('div', class_='SVELTE_HYDRATER contents')
top_paper = ""
for container in containers:
data_props = container.get('data-props', '')
if data_props:
try:
# Parse the JSON-like string
json_data = json.loads(data_props.replace('"', '"'))
if 'dailyPapers' in json_data:
top_paper = json_data['dailyPapers'][0]['title']
except json.JSONDecodeError:
continue
return top_paper
except requests.exceptions.RequestException as e:
print(f"Error occurred while fetching the HTML: {e}")
return None请注意 @tool 装饰器、清晰的工具命名、类型注解以及文档字符串。同样地,我们定义 get_paper_id_by_title 工具,通过标题获取论文 ID,以便从 arXiv 下载。该工具使用了 Hugging Face 的 API。
from huggingface_hub import HfApi
@tool
def get_paper_id_by_title(title: str) -> str:
"""
This is a tool that returns the arxiv paper id by its title.
It returns the title of the paper
Args:
title: The paper title for which to get the id.
"""
api = HfApi()
papers = api.list_papers(query=title)
if papers:
paper = next(iter(papers))
return paper.id
else:
return None使用论文的 ID 下载可借助 Python 的 arxiv 包。我们将论文以特定名称保存在本地,随后再读取:
import arxiv
@tool
def download_paper_by_id(paper_id: str) -> None:
"""
This tool gets the id of a paper and downloads it from arxiv. It saves the paper locally
in the current directory as "paper.pdf".
Args:
paper_id: The id of the paper to download.
"""
paper = next(arxiv.Client().results(arxiv.Search(id_list=[paper_id])))
paper.download_pdf(filename="paper.pdf")
return None要读取 PDF 文件,您可以使用 pypdf 包。为节省 Token,我们仅读取论文的前三页。
from pypdf import PdfReader
@tool
def read_pdf_file(file_path: str) -> str:
"""
This function reads the first three pages of a PDF file and returns its content as a string.
Args:
file_path: The path to the PDF file.
Returns:
A string containing the content of the PDF file.
"""
content = ""
reader = PdfReader('paper.pdf')
print(len(reader.pages))
pages = reader.pages[:3]
for page in pages:
content += page.extract_text()
return content如果您定义了自定义工具,而代理在正确使用或传参方面遇到困难,请考虑让函数与变量名、以及工具描述更加清晰明确。
运行代理
工具准备就绪后,我们可以初始化并运行代理。我们使用免费的 Qwen2.5-Coder-32B-Instruct 模型。代理所需的工具可在定义时传入。您会看到定义与运行代理所需的代码量非常少:
from smolagents import CodeAgent, HfApiModel
model_id = "Qwen/Qwen2.5-Coder-32B-Instruct"
model = HfApiModel(model_id=model_id, token=<YOUR-API>)
agent = CodeAgent(tools=[get_hugging_face_top_daily_paper,
get_paper_id_by_title,
download_paper_by_id,
read_pdf_file],
model=model,
add_base_tools=True)
agent.run(
"Summarize today's top paper on Hugging Face daily papers by reading it.",
)代理运行时会逐步输出其过程。这样我们就能看到它如何以代码形式定义动作,并调用我们提供的自定义工具:
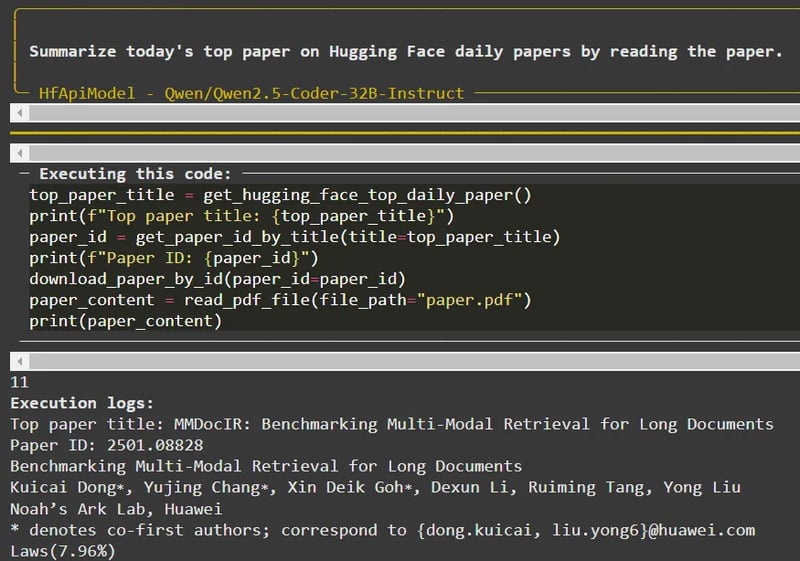
第 0 步的代理输出
代理能在第一步(Step 0)完成论文读取。在第二步,模型会以 Python 列表形式列出论文要点。
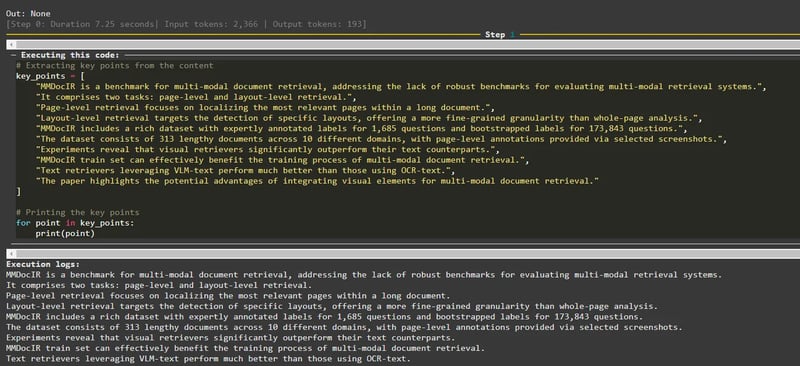
第 1 步的代理输出
在第三步(Step 2),代理会根据要点生成摘要,并在最后一步(Step 3)打印出来。
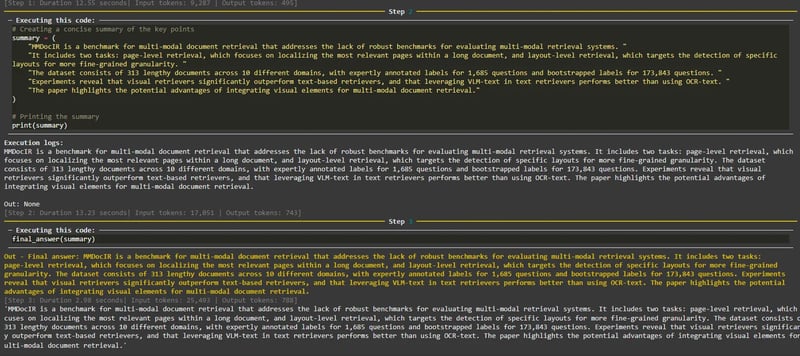
第 2、3 步的代理输出
代理能够在每一步正确识别所需工具,并无误地完成任务。需要说明的是,整个流程可以进一步优化以减少工具调用,但我想看看代理在多次调用工具时的表现。
在更具挑战性的任务中,如果需要更复杂的推理或工具使用,您也可以选择更强大的模型作为代理的底座,例如 OpenAI 或 Claude 提供的模型。
总结
您在代理型框架中看重什么?答案会决定该选哪个。如果您需要的是一个简洁、不被过度抽象拖累、让您保有掌控、具备良好集成能力,并在不“喧宾夺主”的前提下提供基础功能的框架,那么 smolagents 值得一试。
良好的 Hugging Face 生态集成意味着可用的模型与工具更丰富,还有开源社区的支持。该框架在其承诺的方面表现不错。它若能提供更多内置工具会更好,也期待在持续开发中看到这点实现。
如果您想进一步了解 AI 代理与 smolagents,别错过以下资源:

人工智能硕士生与 AI 技术写作者。我分享最新的 AI 技术见解,让机器学习研究更易理解,并将复杂的 AI 主题加以简化,助您始终走在前沿。
Hugging Face 的 smolagents 是一个用于简化AI 代理创建的 Python 库,使其对开发者更易上手。
在本文中,我将向您介绍 smolagents 库,解释它的价值,并通过一个演示项目带您了解它的实际能力。