

Hugging Face का Smolagents क्या है?
Hugging Face के घोषणा ब्लॉग में वर्णित अनुसार, smolagents “एक बहुत सरल लाइब्रेरी है जो भाषा मॉडलों के लिए एजेंटिक क्षमताओं को अनलॉक करती है।” लेकिन हमें एजेंट बनाने के लिए लाइब्रेरी की आवश्यकता क्यों है?
मूलतः, एजेंट LLMs द्वारा संचालित होते हैं जो अपने परिवेश का अवलोकन करके, योजनाएँ बनाकर, और अपने टूलबॉक्स के आधार पर उन्हें निष्पादित करके किसी कार्य को गतिशील रूप से हल करते हैं। इन एजेंटों का निर्माण, भले ही असंभव न हो, आपको कई घटक शून्य से लिखने पड़ते हैं। ये घटक सुनिश्चित करते हैं कि एजेंट सही ढंग से काम करें, बिना आपके API क्रेडिट और निष्पादन समय को बर्बाद किए। एजेंटिक फ्रेमवर्क इसे आसान बना देते हैं ताकि आपको पहिया दोबारा न बनाना पड़े।
AI एजेंट फ्रेमवर्क पर अक्सर दो बिंदुओं के साथ आलोचना होती है:
- वे बहुत अधिक अमूर्तन परतें बनाते हैं, जिससे वे कठोर हो जाते हैं और डीबग करना कठिन हो जाता है।
- वे “वर्कफ़्लोज़” पर ध्यान केंद्रित करते हैं, बजाय इसके कि ऐसे एजेंट बनाएँ जो स्वयं गतिशील रूप से सहयोग कर सकें।
दूसरी ओर, smolagents में ऐसी खूबियाँ हैं जो इसे इन एजेंटिक अनुप्रयोगों के लिए बहुत आशाजनक बनाती हैं:
- फ्रेमवर्क के अमूर्तन न्यूनतम रखे गए हैं।
- जहाँ अधिकांश फ्रेमवर्क एजेंटों से अपनी कार्रवाइयों को JSON/टेक्स्ट फ़ॉर्मेट में परिभाषित कराते हैं, smolagents का मुख्य दृष्टिकोण Code Agents है, जिसमें कार्रवाइयाँ Python कोड स्निपेट्स के रूप में लिखी जाती हैं (यह उन एजेंटों से भिन्न है जो स्वयं कोड लिखते हैं)।
- Hugging Face फ्रेमवर्क होने के नाते, smolagents का Hub और Transformers लाइब्रेरी के साथ अच्छा एकीकरण है। आप हब के कई मॉडलों का उपयोग कर सकते हैं (जिनमें से कुछ केवल Pro उपयोगकर्ता के रूप में उपयोग किए जा सकते हैं), और आप OpenAI, Anthropic आदि के स्वामित्व वाले मॉडलों के साथ भी काम कर सकते हैं।
- आप उपलब्ध उपकरणों का आसानी से उपयोग कर सकते हैं, या न्यूनतम प्रयास में अपने कस्टम टूल परिभाषित कर सकते हैं—लगभग उतना ही सरल जितना एक Python फ़ंक्शन लिखना।
ये खूबियाँ कागज़ पर smolagents को कम प्रयास में AI एजेंटों के साथ प्लग-एंड-प्ले बनाती हैं, तो आइए देखें कि व्यवहार में ये कितना कारगर हैं।
Smolagents के साथ एक डेमो प्रोजेक्ट बनाना
इस खंड में, हम smolagents के साथ एक सरल डेमो बनाएँगे। हमारा अनुप्रयोग एक एजेंट से Hugging Face की Daily Papers पेज पर सबसे अधिक अपवोटेड पेपर प्राप्त कराएगा। हम एजेंट के लिए अपने कस्टम टूल बनाएँगे और इसे काम करते हुए देखेंगे।
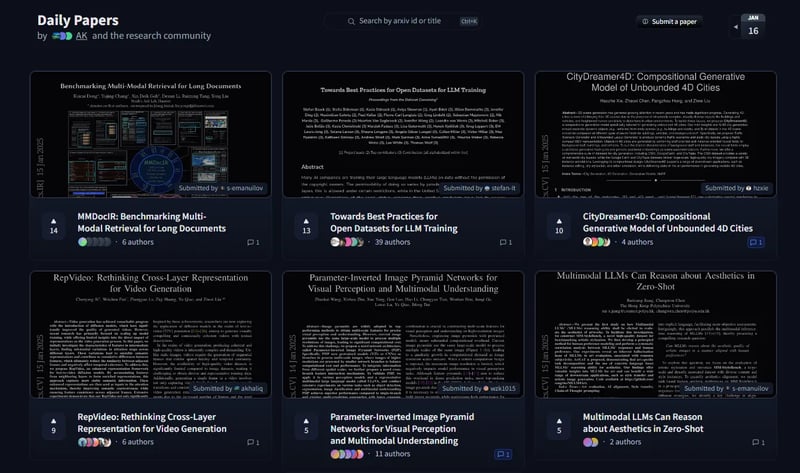
Daily Papers, रोज़ाना के शीर्ष शोधपत्रों पर नज़र रखने का एक अच्छा स्रोत।
smolagents सेट करना
smolagents का उपयोग करने के लिए, आपको केवल लाइब्रेरी इंस्टॉल करनी है और एक Hugging Face टोकन प्रदान करना है। फ्रेमवर्क की सेटअप में सरलता एक सकारात्मक बिंदु है।
पैकेज इंस्टॉल करने के लिए, यह चलाएँ:
pip install smolagentsकस्टम टूल बनाना
हालाँकि फ्रेमवर्क बॉक्स से बाहर उपयोग के लिए बिल्ट-इन टूल देता है (जैसे DuckDuckGoSearchTool), अपने कस्टम टूल बनाना भी उतना ही सीधा है। हमारे उद्देश्य के लिए, हम चार टूल बनाएँगे, प्रत्येक एक विशिष्ट काम के लिए:
- टॉप डेली पेपर का शीर्षक प्राप्त करना।
- शीर्षक के आधार पर पेपर का ID प्राप्त करना।
- उस ID के साथ arXiv से पेपर डाउनलोड करना।
- डाउनलोड की गई PDF फ़ाइल पढ़ना।
एजेंट त्रुटियों का एक सामान्य कारण टूल का उपयोग है। टूल्स को एजेंटिक उद्देश्यों के लिए अनुकूलित करने के लिए, यह सुनिश्चित करना महत्वपूर्ण है कि एजेंट स्पष्ट रूप से समझें कि किस टूल का उपयोग कब और कैसे करना है। इसके लिए, इन टूल्स को परिभाषित करते समय यथासंभव स्पष्ट रहें:
- फ़ंक्शन के लिए सूचनात्मक नाम चुनें।
- फ़ंक्शन के इनपुट और आउटपुट में टाइप हिंट होने चाहिए।
- टूल का उद्देश्य बताने वाला विवरण अवश्य जोड़ें। यह एजेंट के लिए मैनुअल का काम करता है।
अब आइए अपना पहला कस्टम टूल बनाएँ जो डेली पेपर्स पेज को पार्स करे और शीर्ष पेपर का शीर्षक निकाले:
from smolagents import tool
# import packages that are used in our tools
import requests
from bs4 import BeautifulSoup
import json
@tool
def get_hugging_face_top_daily_paper() -> str:
"""
This is a tool that returns the most upvoted paper on Hugging Face daily papers.
It returns the title of the paper
"""
try:
url = "<https://huggingface.co/papers>"
response = requests.get(url)
response.raise_for_status() # Raise an exception for bad status codes (4xx or 5xx)
soup = BeautifulSoup(response.content, "html.parser")
# Extract the title element from the JSON-like data in the "data-props" attribute
containers = soup.find_all('div', class_='SVELTE_HYDRATER contents')
top_paper = ""
for container in containers:
data_props = container.get('data-props', '')
if data_props:
try:
# Parse the JSON-like string
json_data = json.loads(data_props.replace('"', '"'))
if 'dailyPapers' in json_data:
top_paper = json_data['dailyPapers'][0]['title']
except json.JSONDecodeError:
continue
return top_paper
except requests.exceptions.RequestException as e:
print(f"Error occurred while fetching the HTML: {e}")
return Noneध्यान दें @tool डेकोरेटर, टूल का स्पष्ट नामकरण, टाइप हिंट्स, और डॉकस्ट्रिंग। इसी तरह, हम get_paper_id_by_title टूल परिभाषित करते हैं ताकि शीर्षक के आधार पर पेपर का ID मिल सके, जिससे हम उसे arXiv से डाउनलोड कर सकें। इस टूल के लिए, हम Hugging Face की API का उपयोग करते हैं।
from huggingface_hub import HfApi
@tool
def get_paper_id_by_title(title: str) -> str:
"""
This is a tool that returns the arxiv paper id by its title.
It returns the title of the paper
Args:
title: The paper title for which to get the id.
"""
api = HfApi()
papers = api.list_papers(query=title)
if papers:
paper = next(iter(papers))
return paper.id
else:
return NoneID का उपयोग कर पेपर डाउनलोड करना Python के arxiv पैकेज से किया जा सकता है। हम पेपर को एक तय नाम से लोकली सेव करते हैं, जिसे बाद में पढ़ने के लिए उपयोग करेंगे:
import arxiv
@tool
def download_paper_by_id(paper_id: str) -> None:
"""
This tool gets the id of a paper and downloads it from arxiv. It saves the paper locally
in the current directory as "paper.pdf".
Args:
paper_id: The id of the paper to download.
"""
paper = next(arxiv.Client().results(arxiv.Search(id_list=[paper_id])))
paper.download_pdf(filename="paper.pdf")
return NonePDF फ़ाइल पढ़ने के लिए, आप pypdf पैकेज का उपयोग कर सकते हैं। हम टोकन उपयोग बचाने के लिए पेपर के केवल पहले तीन पृष्ठ पढ़ेंगे।
from pypdf import PdfReader
@tool
def read_pdf_file(file_path: str) -> str:
"""
This function reads the first three pages of a PDF file and returns its content as a string.
Args:
file_path: The path to the PDF file.
Returns:
A string containing the content of the PDF file.
"""
content = ""
reader = PdfReader('paper.pdf')
print(len(reader.pages))
pages = reader.pages[:3]
for page in pages:
content += page.extract_text()
return contentयदि आप कस्टम टूल परिभाषित करते हैं और एजेंट उन्हें सही ढंग से उपयोग करने या सही आर्ग्यूमेंट पास करने में संघर्ष करता है, तो फ़ंक्शन वेरिएबल नामों और टूल विवरणों को और अधिक स्पष्ट व सुस्पष्ट बनाने पर विचार करें।
एजेंट चलाना
हमारे टूल तैयार होने के साथ, अब हम अपने एजेंट को इनिशियलाइज़ और रन कर सकते हैं। हम Qwen2.5-Coder-32B-Instruct मॉडल का उपयोग करते हैं, जो उपयोग के लिए निःशुल्क है। किसी एजेंट को जिन टूल्स की आवश्यकता होती है, वे एजेंट को परिभाषित करते समय पास किए जा सकते हैं। आप देख सकते हैं कि किसी एजेंट को परिभाषित करना और चलाना न्यूनतम कोड मांगता है:
from smolagents import CodeAgent, HfApiModel
model_id = "Qwen/Qwen2.5-Coder-32B-Instruct"
model = HfApiModel(model_id=model_id, token=<YOUR-API>)
agent = CodeAgent(tools=[get_hugging_face_top_daily_paper,
get_paper_id_by_title,
download_paper_by_id,
read_pdf_file],
model=model,
add_base_tools=True)
agent.run(
"Summarize today's top paper on Hugging Face daily papers by reading it.",
)जैसे ही एजेंट कार्य करता है, वह अपना प्रोसेस चरण-दर-चरण आउटपुट करता है। यह हमें दिखाता है कि वह हमारे दिए गए कस्टम टूल का उपयोग करते हुए अपनी कार्रवाइयों को कोड में कैसे परिभाषित करता है:
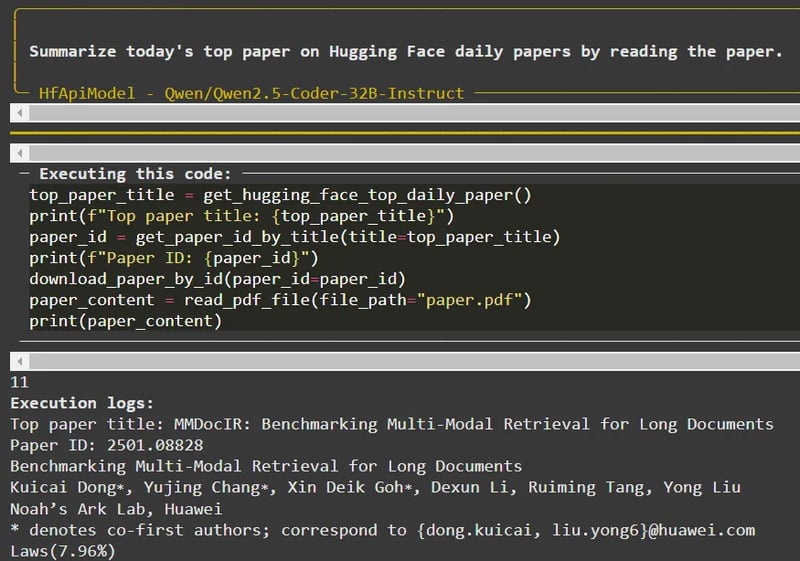
स्टेप 0 में एजेंट आउटपुट
एजेंट पहले चरण (स्टेप 0) में पेपर पढ़ना समाप्त कर सकता है। दूसरे चरण में, मॉडल पेपर के मुख्य बिंदुओं को फिर से एक Python सूची में प्रस्तुत करता है।
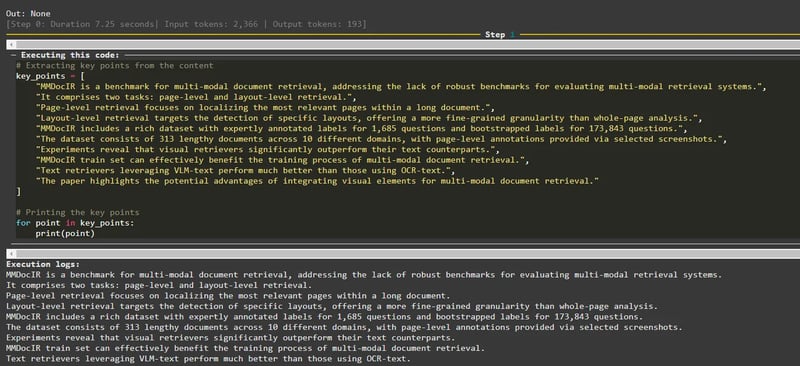
स्टेप 1 में एजेंट आउटपुट
तीसरे चरण (स्टेप 2) में, एजेंट मुख्य बिंदुओं का सारांश बनाता है और अंतिम चरण (स्टेप 3) में उसे प्रिंट करता है।
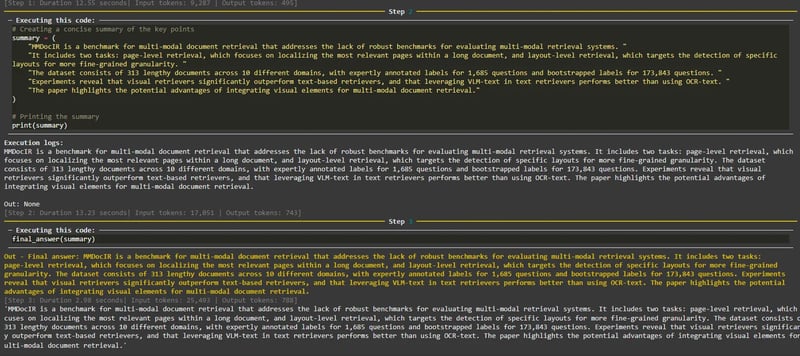
स्टेप 2, 3 में एजेंट आउटपुट
एजेंट हर चरण में किस टूल का उपयोग करना है, यह पहचानने में सक्षम था और बिना किसी त्रुटि के कार्य पूरा किया। ध्यान दें कि पूरी पाइपलाइन को कम टूल्स के साथ ऑप्टिमाइज़ किया जा सकता था, लेकिन मैं यह देखने को उत्सुक था कि एजेंट कई टूल कॉल्स का उपयोग कैसे करता है।
अधिक चुनौतीपूर्ण कार्यों में, जहाँ जटिल तर्क या टूल उपयोग की आवश्यकता होती है, आप अपने एजेंट्स की रीढ़ के रूप में अधिक सक्षम मॉडलों का भी उपयोग कर सकते हैं, जैसे OpenAI या Claude द्वारा प्रदान किए गए मॉडल।
निष्कर्ष
आप किसी एजेंटिक फ्रेमवर्क में क्या देखते हैं? आपका जवाब यह स्पष्ट कर देता है कि किसे उपयोग करना चाहिए, लेकिन यदि आप ऐसा सरल फ्रेमवर्क चाहते हैं जो अमूर्तताओं से बोझिल न हो, आपको नियंत्रण दे, अच्छी इंटीग्रेशंस दे, और बुनियादी सुविधाएँ प्रदान करे बिना पूरी बागडोर अपने हाथ में लिए, तो smolagents एक अच्छा विकल्प है।
Hugging Face इकोसिस्टम में अच्छी तरह एकीकृत होने का मतलब है कि आपके पास अधिक मॉडल और टूल्स उपलब्ध हैं, साथ ही ओपन-सोर्स समुदाय का समर्थन भी। फ्रेमवर्क अपने दावों पर खरा उतरता है। इसमें और अधिक बिल्ट-इन टूल्स जुड़ने से लाभ होगा, और इसके विकास के साथ हम इसके होने की उम्मीद कर सकते हैं।
यदि आप AI एजेंट्स और smolagents के बारे में और पढ़ना चाहते हैं, तो इन संसाधनों को न चूकें:

कृत्रिम बुद्धिमत्ता में मास्टर'स छात्र और एआई तकनीकी लेखक। मैं नवीनतम एआई तकनीक पर अंतर्दृष्टि साझा करता/करती हूँ, एमएल शोध को सुलभ बनाता/बनाती हूँ, और जटिल एआई विषयों को सरल करता/करती हूँ ताकि आप हमेशा अग्रिम पंक्ति में बने रहें।
Hugging Face की smolagents एक Python लाइब्रेरी है जो AI एजेंट्स का निर्माण सरल बनाती है, जिससे वे डेवलपर्स के लिए अधिक सुलभ हो जाते हैं।
इस ब्लॉग में, मैं आपको smolagents लाइब्रेरी से परिचित कराऊंगा, यह क्यों उपयोगी है समझाऊंगा, और इसकी क्षमताओं को प्रदर्शित करने के लिए एक डेमो प्रोजेक्ट के माध्यम से मार्गदर्शन करूंगा।