在关系型数据库中,主键在确保表内数据的唯一性和完整性方面起着至关重要的作用。主键是一种约束,用于唯一标识表中的每条记录,是索引、强制实体完整性以及建立表间关系的基础要素。
在本教程中,我将带您深入探索 SQL 主键,涵盖核心原理、实现方法与优化技巧。我还会介绍一些常见错误与最佳实践,以及真实场景。如果您仍在学习 SQL,建议查看我们的SQL 路线图并学习 SQL 基础技能路径。
什么是 SQL 主键?
SQL 主键是一个或一组列,用于唯一标识表中的每一行。这意味着不能有两行具有相同的主键值。一个表只能有一个主键,它可以由一个或多个列组成。
主键对于强制数据完整性和实现高效查询至关重要。我们先来看一些基础方面。
主键是数据库规范化与关系完整性的关键。
主键的关键属性
- 唯一性:确保主键列中的每个值都是唯一的。
- 非空性:主键列不能包含 NULL 值。
- 不变性:理想情况下,主键值在其生命周期内应保持不变,以避免引用表中的不一致。
约束与索引
当定义主键时,数据库会自动创建唯一索引以强制该约束。该索引会加速查询性能,尤其是查找操作。
通过这一索引机制,主键有助于数据库引擎优化执行计划,从而让您的查询运行得更快。
主键常见数据类型
主键可以使用多种数据类型。以下是常见类型:
INTEGER 或 SERIAL:高效且最常用。BIGINT:适用于预计存储数十亿行的表。UUID:适合分布式系统,且可避免顺序可预测性。CHAR/VARCHAR:谨慎使用,通常用于必要的自然键。
SQL 主键的类型与架构
根据结构和来源,主键可以分为多种类型。例如:
- 自然键:源自已有数据(如社会保障号、电子邮件),易于理解且通常对业务用户有意义。但这带来更新、重复以及潜在隐私问题的风险。
- 代理键:人工键,如系统生成的 ID,通常使用
SERIAL、BIGSERIAL 或 UUID 实现。使用此类键可提供稳定性、隐私性以及更易维护性。
基于特性进行对比,我们可以在以下汇总表中看到它们的差异:
|
Feature
|
Natural Key
|
Surrogate Key
|
|
Business Meaning
|
Yes
|
No
|
|
Stability
|
Often unstable
|
Highly stable
|
|
Performance
|
May require large fields
|
Generally compact
|
|
Privacy Concerns
|
Higher
|
Lower
|
复合主键架构
复合主键是表中生成唯一键的一种常见方式。该键通常来自两个或多个列中的数据。
此类键在连接表或关联表中很常见,其中关系本身需要唯一性。
- 示例:表
course_enrollments 可能使用由 student_id 和 course_id 组成的复合键。
注意事项:
- 最小化:避免在复合键中包含不必要的列。
- 复杂性:连接和外键引用会更复杂。
- 索引大小:索引可能变大并影响性能。
数据库中使用的其他键
除了主键外,还有其他几种可用的键,例如:
- 候选键:能够唯一标识一行的一组属性。
- 超键:候选键的任意超集(包含额外列)。
- 备用键:未被选作主键的候选键。
如果您在决定将哪个数据字段用作主键,可以考虑以下因素:
- 数据变更频率:数据变更有多频繁?
- 列的数据类型与大小:数据类型是否适合建立索引?
- 预期查询模式:该字段是否适合查询?
在 SQL 中定义与修改主键
接下来,我们看看如何使用 SQL 命令在 PostgreSQL 中声明和管理主键。
我们将演示多种场景,包括创建表、修改现有表以及管理约束行为。
声明与修改语法
在创建表时
在创建表阶段,您应创建可能会使用的字段。在此示例中,我们将生成由唯一整数构成的员工 ID。
CREATE TABLE employees (
employee_id SERIAL PRIMARY KEY,
name TEXT NOT NULL,
email TEXT UNIQUE
);技术支持
更多 SQL 命令请参阅我们的SQL 基础速查表。
该示例演示了使用 SERIAL 伪类型内联定义主键。PostgreSQL 将 SERIAL 视为自增整数列,非常适合作为代理键。email 列还设置了 UNIQUE 约束,可作为备用键使用。
使用 ALTER TABLE
现在,让我们将 employee_id 设置为主键。
ALTER TABLE employees ADD PRIMARY KEY (employee_id);技术支持
当表已创建但没有主键,且您想事后添加主键时,可使用该命令。请确保要添加主键的列不包含 NULL 或重复值,否则命令会失败。
删除主键
在设置好主键后,您也可以删除主键约束。
ALTER TABLE employees DROP CONSTRAINT employees_pkey;技术支持
使用此语句可移除现有主键约束。约束名 employees_pkey 遵循 PostgreSQL 的默认命名约定(<table>_pkey)。当重新设计表结构或切换到不同的主键列时,这很有用。
在 PostgreSQL 中,主键的默认约束名为 table_name_pkey。
通过我们的速查表了解更多 PostgreSQL 知识。
空值处理与冲突管理
主键列不允许出现 NULL 值。重复值也会导致约束违规错误。
管理策略包括:
- 使用
INSERT ... ON CONFLICT 避免重复。
- 使用事务在插入前检查键是否可用。
自增与全局标识策略
PostgreSQL 的 SERIAL、BIGSERIAL 和 IDENTITY 类型简化了 ID 生成。
此外,UUID 提供安全的全局标识符。其非顺序、不可预测的特性也增强了安全性,尤其能防止枚举攻击。
以下演示了如何创建并将 UUID 用作主键
CREATE EXTENSION IF NOT EXISTS "pgcrypto";
CREATE TABLE users (
    user_id UUID DEFAULT gen_random_uuid() PRIMARY KEY,
    username TEXT NOT NULL
);技术支持
关系中的主键与性能提升
主键对于确保关系表间的一致性以及提升性能至关重要。
实体完整性约束
通过不允许 NULL 与重复,主键可强制实体完整性。拥有唯一标识符有助于在插入/更新操作中防止数据异常。
外键与参照完整性
外键必须匹配被引用表中已存在的主键值。参照完整性确保表间所有引用都有效,并防止出现引用不存在数据的“孤儿记录”。
当被引用的主键发生变化时,级联操作可保持一致性。
这可能包括以下常见级联操作:
ON DELETE CASCADEON UPDATE CASCADESET NULL 与 SET DEFAULT
索引与查询优化
主键上的唯一索引可加速 SELECT 与 JOIN 查询。然而,糟糕的键设计会导致索引臃肿并降低性能。
如果查询很慢且怀疑由糟糕的索引引起,请使用 EXPLAIN ANALYZE 检查查询计划并评估索引使用情况。
设计最佳实践与潜在陷阱
良好的键设计有助于维护性、性能和可扩展性。我们来看一些最佳实践与常见错误。
键选择指南
- 选择短、小且定长的数据类型(如
INT、UUID)。
- 避免可能会更改的键。
- 确保键不包含业务含义,以避免逻辑耦合。
- 为简化与规范化使用代理键。
常见实现错误
- 使用多个主键(每个表只允许一个)。
- 将唯一约束误作主键。
- 未定义主键,导致出现孤儿记录。
修复方式包括:
- 通过
ALTER TABLE 添加缺失的键。
- 规范化架构设计。
- 使用一致的命名约定。
可扩展性考量
在构建可扩展的数据库方案时,尽量使用代理键以在大型数据集间保持一致性。除非必要,避免在分布式系统中使用复合键。同时也必须定期监控表/索引大小。
高级实现场景
在复杂系统(如分布式数据库或遗留系统)中处理主键,需要采用高级策略。
分布式数据库系统
分布式数据库更具挑战。您需要确保跨节点的键生成无冲突。为此,您可以尝试使用 UUID 和集中式密钥管理服务。
分区注意事项:
- 确保键不会造成热点。
- 分片时使用哈希或随机化的键。
遗留系统迁移
从遗留数据库进行系统迁移时,先识别现有的唯一标识符。接着,逐步在自然键旁引入代理键。
采取谨慎策略,在完全切换前运行双键支持。
迁移流程:
- 添加代理键列。
- 为现有记录填充键值。
- 修改应用查询。
- 验证后删除旧的自然键。
使用 PostgreSQL 演示主键
在创建表并插入数据之前,您需要一个可用的 PostgreSQL 环境。本节先简要介绍 PostgreSQL 的设置,然后提供定义和使用示例数据集的步骤,以练习主键相关概念。
步骤 1:PostgreSQL 初始设置
如果您尚未安装 PostgreSQL,请按以下步骤开始:
- 安装 PostgreSQL
- 启动 PostgreSQL 服务
- 安装完成后,PostgreSQL 服务通常会自动启动。
- 您也可以通过操作系统的服务管理器手动启动(例如 Windows 的“服务”或 Linux 上的
systemctl)。
- 启动 pgAdmin 或通过 CLI 连接
- 使用
pgAdmin 可直观管理和查询数据库。
- 或者,打开终端并使用以下命令连接:psql -U postgres
- 如果不同,请将
postgres 替换为您的实际 PostgreSQL 用户名。
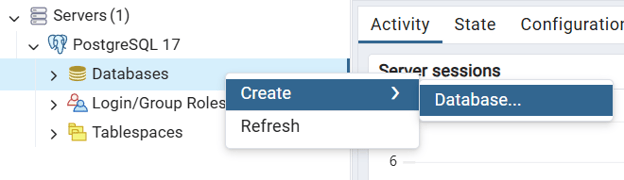
- 创建新数据库
- 在
pgAdmin 中,右键单击“Databases”,选择“Create > Database”。
CREATE DATABASE pk_tutorial;
Connect to the new database in psql with:```bash
\c pk_tutorial技术支持
环境就绪后,您即可按照教程中已概述的内容完成其余数据集设置。
接下来,我们来看使用 PostgreSQL 创建示例数据集的分步指南。该数据集包含两个相关表:customers 与 orders。
customers 表为简化起见使用代理键,而 orders 表使用基于 UUID 的主键以展示全局唯一性。
步骤 2:创建表
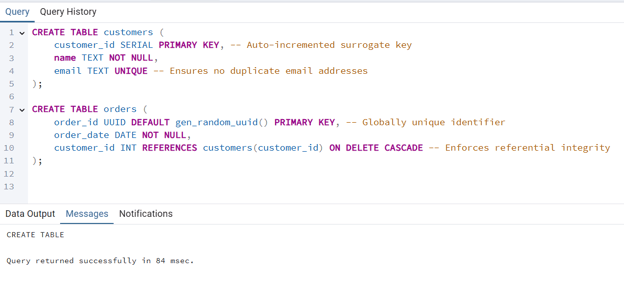
第一步是定义模式,并为两个表建立主键约束。我们还定义了 orders.customer_id 与 customers.customer_id 之间的外键关系,以演示关系完整性。
对于 customers 表,主键为 customer_id。
对于 orders 表,主键为 order_id。
CREATE TABLE customers (
customer_id SERIAL PRIMARY KEY,
name TEXT NOT NULL,
email TEXT UNIQUE
);
CREATE TABLE orders (
order_id UUID DEFAULT gen_random_uuid() PRIMARY KEY,
order_date DATE NOT NULL,
customer_id INT REFERENCES customers(customer_id) ON DELETE CASCADE
);技术支持
说明:
customer_id 使用 SERIAL 关键字自动生成唯一 ID。email 具有 UNIQUE 约束以防止重复。order_id 是通过 gen_random_uuid() 自动生成的 UUID。ON DELETE CASCADE 子句确保删除客户时同步删除其关联订单。
以下是在 pgAdmin 界面中的示例效果:
步骤 3:插入示例数据
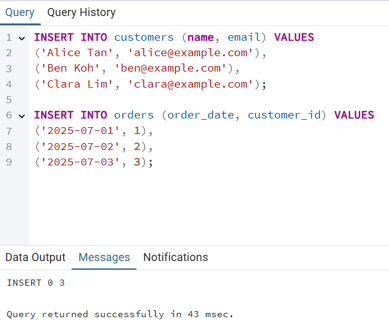
接下来,我们向表中填充示例记录,观察主键与外键在典型插入操作中的表现。该数据模拟基础电商场景。
INSERT INTO customers (name, email) VALUES
('Alice Tan', '[email protected]'),
('Ben Koh', '[email protected]'),
('Clara Lim', '[email protected]');

INSERT INTO orders (order_date, customer_id) VALUES
('2025-07-01', 1),
('2025-07-02', 2),
('2025-07-03', 3);技术支持
以下是在 pgAdmin 界面中的示例效果:
步骤 4:查询数据
最后,我们执行一条 SQL JOIN 查询,从两个表中检索信息,展示外键如何在订单与客户之间实现流畅的关系连接。
我们将运行以下代码:
SELECT o.order_id, o.order_date, c.name, c.email
FROM orders o
JOIN customers c ON o.customer_id = c.customer_id;技术支持
以下是示例输出:
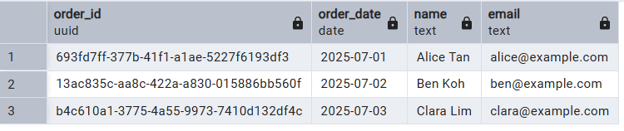
如上图所示,输出表展示了来自两个表的数据。例如,连接后的表同时包含 orders 表中的 order_date 字段与 customers 表中的 name 字段。
结论
SQL 主键是关系型数据库的基石,负责强制唯一性、支持高效查询并保障数据完整性。
我们已涵盖 SQL 主键的原理、分类、语法、最佳实践以及高级策略。想要获取更多学习资源,请查看我们的 Introduction to Relational Databases in SQL 课程或 Joining Data in SQL 课程。
如果您更喜欢阅读式教程,SQL 约束完整性指南或 SQL Joins 速查表也将非常有帮助。


在关系型数据库中,主键在确保表内数据的唯一性和完整性方面起着至关重要的作用。主键是一种约束,用于唯一标识表中的每条记录,是索引、强制实体完整性以及建立表间关系的基础要素。
在本教程中,我将带您深入探索 SQL 主键,涵盖核心原理、实现方法与优化技巧。我还会介绍一些常见错误与最佳实践,以及真实场景。如果您仍在学习 SQL,建议查看我们的SQL 路线图并学习 SQL 基础技能路径。
什么是 SQL 主键?
SQL 主键是一个或一组列,用于唯一标识表中的每一行。这意味着不能有两行具有相同的主键值。一个表只能有一个主键,它可以由一个或多个列组成。
主键对于强制数据完整性和实现高效查询至关重要。我们先来看一些基础方面。
主键是数据库规范化与关系完整性的关键。
主键的关键属性
约束与索引
当定义主键时,数据库会自动创建唯一索引以强制该约束。该索引会加速查询性能,尤其是查找操作。
通过这一索引机制,主键有助于数据库引擎优化执行计划,从而让您的查询运行得更快。
主键常见数据类型
主键可以使用多种数据类型。以下是常见类型:
INTEGER或SERIAL:高效且最常用。BIGINT:适用于预计存储数十亿行的表。UUID:适合分布式系统,且可避免顺序可预测性。CHAR/VARCHAR:谨慎使用,通常用于必要的自然键。SQL 主键的类型与架构
根据结构和来源,主键可以分为多种类型。例如:
SERIAL、BIGSERIAL或UUID实现。使用此类键可提供稳定性、隐私性以及更易维护性。基于特性进行对比,我们可以在以下汇总表中看到它们的差异:
Feature
Natural Key
Surrogate Key
Business Meaning
Yes
No
Stability
Often unstable
Highly stable
Performance
May require large fields
Generally compact
Privacy Concerns
Higher
Lower
复合主键架构
复合主键是表中生成唯一键的一种常见方式。该键通常来自两个或多个列中的数据。
此类键在连接表或关联表中很常见,其中关系本身需要唯一性。
course_enrollments可能使用由student_id和course_id组成的复合键。注意事项:
数据库中使用的其他键
除了主键外,还有其他几种可用的键,例如:
如果您在决定将哪个数据字段用作主键,可以考虑以下因素:
在 SQL 中定义与修改主键
接下来,我们看看如何使用 SQL 命令在 PostgreSQL 中声明和管理主键。
我们将演示多种场景,包括创建表、修改现有表以及管理约束行为。
声明与修改语法
在创建表时
在创建表阶段,您应创建可能会使用的字段。在此示例中,我们将生成由唯一整数构成的员工 ID。
更多 SQL 命令请参阅我们的SQL 基础速查表。
该示例演示了使用 SERIAL 伪类型内联定义主键。PostgreSQL 将 SERIAL 视为自增整数列,非常适合作为代理键。email 列还设置了 UNIQUE 约束,可作为备用键使用。
使用 ALTER TABLE
现在,让我们将
employee_id设置为主键。当表已创建但没有主键,且您想事后添加主键时,可使用该命令。请确保要添加主键的列不包含 NULL 或重复值,否则命令会失败。
删除主键
在设置好主键后,您也可以删除主键约束。
使用此语句可移除现有主键约束。约束名
employees_pkey遵循 PostgreSQL 的默认命名约定(<table>_pkey)。当重新设计表结构或切换到不同的主键列时,这很有用。在 PostgreSQL 中,主键的默认约束名为
table_name_pkey。通过我们的速查表了解更多 PostgreSQL 知识。
空值处理与冲突管理
主键列不允许出现 NULL 值。重复值也会导致约束违规错误。
管理策略包括:
INSERT ... ON CONFLICT避免重复。自增与全局标识策略
PostgreSQL 的
SERIAL、BIGSERIAL和IDENTITY类型简化了 ID 生成。此外,UUID 提供安全的全局标识符。其非顺序、不可预测的特性也增强了安全性,尤其能防止枚举攻击。
以下演示了如何创建并将 UUID 用作主键
关系中的主键与性能提升
主键对于确保关系表间的一致性以及提升性能至关重要。
实体完整性约束
通过不允许 NULL 与重复,主键可强制实体完整性。拥有唯一标识符有助于在插入/更新操作中防止数据异常。
外键与参照完整性
外键必须匹配被引用表中已存在的主键值。参照完整性确保表间所有引用都有效,并防止出现引用不存在数据的“孤儿记录”。
当被引用的主键发生变化时,级联操作可保持一致性。
这可能包括以下常见级联操作:
ON DELETE CASCADEON UPDATE CASCADESET NULL与SET DEFAULT索引与查询优化
主键上的唯一索引可加速
SELECT与JOIN查询。然而,糟糕的键设计会导致索引臃肿并降低性能。如果查询很慢且怀疑由糟糕的索引引起,请使用
EXPLAIN ANALYZE检查查询计划并评估索引使用情况。设计最佳实践与潜在陷阱
良好的键设计有助于维护性、性能和可扩展性。我们来看一些最佳实践与常见错误。
键选择指南
INT、UUID)。常见实现错误
修复方式包括:
ALTER TABLE添加缺失的键。可扩展性考量
在构建可扩展的数据库方案时,尽量使用代理键以在大型数据集间保持一致性。除非必要,避免在分布式系统中使用复合键。同时也必须定期监控表/索引大小。
高级实现场景
在复杂系统(如分布式数据库或遗留系统)中处理主键,需要采用高级策略。
分布式数据库系统
分布式数据库更具挑战。您需要确保跨节点的键生成无冲突。为此,您可以尝试使用 UUID 和集中式密钥管理服务。
分区注意事项:
遗留系统迁移
从遗留数据库进行系统迁移时,先识别现有的唯一标识符。接着,逐步在自然键旁引入代理键。
采取谨慎策略,在完全切换前运行双键支持。
迁移流程:
使用 PostgreSQL 演示主键
在创建表并插入数据之前,您需要一个可用的 PostgreSQL 环境。本节先简要介绍 PostgreSQL 的设置,然后提供定义和使用示例数据集的步骤,以练习主键相关概念。
步骤 1:PostgreSQL 初始设置
如果您尚未安装 PostgreSQL,请按以下步骤开始:
pgAdmin(图形界面)。systemctl)。pgAdmin可直观管理和查询数据库。postgres替换为您的实际 PostgreSQL 用户名。pgAdmin中,右键单击“Databases”,选择“Create > Database”。CREATE DATABASE pk_tutorial;
环境就绪后,您即可按照教程中已概述的内容完成其余数据集设置。
接下来,我们来看使用 PostgreSQL 创建示例数据集的分步指南。该数据集包含两个相关表:
customers与orders。customers表为简化起见使用代理键,而orders表使用基于 UUID 的主键以展示全局唯一性。步骤 2:创建表
第一步是定义模式,并为两个表建立主键约束。我们还定义了
orders.customer_id与customers.customer_id之间的外键关系,以演示关系完整性。对于
customers表,主键为customer_id。对于
orders表,主键为order_id。说明:
customer_id使用SERIAL关键字自动生成唯一 ID。email具有UNIQUE约束以防止重复。order_id是通过gen_random_uuid()自动生成的UUID。ON DELETE CASCADE子句确保删除客户时同步删除其关联订单。以下是在 pgAdmin 界面中的示例效果:
步骤 3:插入示例数据
接下来,我们向表中填充示例记录,观察主键与外键在典型插入操作中的表现。该数据模拟基础电商场景。
以下是在 pgAdmin 界面中的示例效果:
步骤 4:查询数据
最后,我们执行一条 SQL
JOIN查询,从两个表中检索信息,展示外键如何在订单与客户之间实现流畅的关系连接。我们将运行以下代码:
以下是示例输出:
如上图所示,输出表展示了来自两个表的数据。例如,连接后的表同时包含
orders表中的order_date字段与customers表中的name字段。结论
SQL 主键是关系型数据库的基石,负责强制唯一性、支持高效查询并保障数据完整性。
我们已涵盖 SQL 主键的原理、分类、语法、最佳实践以及高级策略。想要获取更多学习资源,请查看我们的 Introduction to Relational Databases in SQL 课程或 Joining Data in SQL 课程。
如果您更喜欢阅读式教程,SQL 约束完整性指南或 SQL Joins 速查表也将非常有帮助。