Découvrez ce qu'est une clé primaire SQL, son rôle dans les relations entre bases de données et son impact sur les performances des requêtes dans ce tutoriel technique.
Dans les bases de données relationnelles, la clé primaire joue un rôle crucial pour garantir l'unicité et l'intégrité des données d'un tableau. Une clé primaire est une contrainte qui identifie de manière unique chaque enregistrement d'un tableau. Elle sert d'élément fondamental pour l'indexation, le renforcement de l'intégrité des entités et l'établissement de relations entre les tableaux.
Dans ce tutoriel, je vous guiderai à travers une exploration approfondie des clés primaires SQL, en couvrant les principes fondamentaux, les méthodes de mise en œuvre et les techniques d'optimisation. Je présenterai également quelques erreurs courantes et les meilleures pratiques, ainsi que des scénarios concrets. Si vous êtes encore en train d'apprendre le langage SQL, je vous recommande de consulter notre feuille de route SQL complète et de suivre notre cursus sur les fondamentaux du langage SQL.
Qu'est-ce qu'une clé primaire SQL ?
Une clé primaire SQL est une colonne ou un ensemble de colonnes qui identifie de manière unique chaque ligne d'un tableau. Cela signifie qu'aucune ligne ne peut avoir la même valeur de clé primaire. Un tableau ne peut avoir qu'une seule clé primaire, qui peut être constituée d'une ou plusieurs colonnes.
Les clés primaires sont essentielles pour garantir l'intégrité des données et permettre des requêtes efficaces. Examinons quelques aspects fondamentaux.
Les clés primaires sont indispensables à la normalisation des bases de données et à l'intégrité relationnelle.
Propriétés clés des clés primaires
s d'unicité: Garantit que chaque valeur dans la ou les colonnes de clé primaire est unique.
Non-nullabilité: Les colonnes de clé primaire ne peuvent pas contenir de valeurs NULL.
s d'immuabilité: Idéalement, les valeurs des clés primaires devraient rester inchangées tout au long de leur durée de vie afin d'éviter toute incohérence dans les références aux tableaux.
Contraintes et indexation
Lorsqu'une clé primaire est définie, la base de données crée automatiquement un index unique afin d'appliquer la contrainte. Cet index accélère les performances des requêtes, en particulier pour les opérations de recherche.
Grâce à ce système d'indexation, les clés primaires facilitent l'optimisation du plan d'exécution du moteur de base de données. Cela permettra d'accélérer l'exécution de vos requêtes.
Types de données courants pour les clés primaires
Les clés primaires peuvent être de plusieurs types. Voici quelques types utilisés :
INTEGER ou SERIAL: Efficace et le plus couramment utilisé.
BIGINT: Utile pour les tableaux susceptibles de stocker des milliards de lignes.
UUID: Idéal pour les systèmes distribués et pour éviter la prévisibilité séquentielle.
CHAR/VARCHAR: À utiliser avec précaution, généralement dans les tonalités naturelles lorsque cela est nécessaire.
Types et architecture des clés primaires SQL
Les clés primaires peuvent être classées en différents types en fonction de leur structure et de leur origine. Voici quelques exemples :
Clés naturelles: Dérivées de données existantes (par exemple, numéro de sécurité sociale, adresse e-mail), elles sont faciles à comprendre et souvent significatives pour les utilisateurs professionnels. Cependant, cela comporte des risques liés aux mises à jour, aux doublons et à d'éventuels problèmes de confidentialité.
Clés de substitution: Les clés artificielles, telles que les identifiants générés par le système, sont généralement mises en œuvre avec l'SERIAL, l'BIGSERIAL ou l'UUID. L'utilisation de telles clés offre stabilité, confidentialité et facilité de maintenance.
En les comparant sur la base de leurs caractéristiques, nous pouvons mettre en évidence leurs différences dans le tableau récapitulatif suivant :
Caractéristique
Clé naturelle
Clé de substitution
Signification commerciale
Oui
Non
Stabilité
Souvent instable
Très stable
Performance
Peut nécessiter de grands champs
Généralement compact
Préoccupations relatives à la confidentialité
Supérieur
Plus bas
Architecture de clé primaire composite
Une clé primaire composite est une méthode courante pour générer une clé unique dans les tableaux. La clé est généralement dérivée des données trouvées dans deux colonnes ou plus.
Exemple : Un tableau course_enrollments pourrait utiliser une clé composite composée de student_id et course_id.
Considérations :
Minimalisme : Évitez les colonnes inutiles dans la clé composite.
Complexité : Les jointures et les références de clés étrangères deviennent plus complexes.
Taille de l'index : Les index peuvent devenir volumineux et affecter les performances.
Clés supplémentaires utilisées dans les bases de données
Outre la clé primaire, plusieurs autres clés peuvent être utilisées, telles que :
Clé du candidat : Ensemble d'attributs permettant d'identifier de manière unique une ligne.
Super clé : Tout sur-ensemble d'une clé candidate (y compris les colonnes supplémentaires).
Touche alternative : Une clé candidate qui n'est pas sélectionnée comme clé primaire.
Si vous hésitez sur le champ de données à utiliser comme clé primaire, vous pouvez tenir compte des facteurs suivants :
Fréquence de modification des données : À quelle fréquence les données sont-elles mises à jour ?
Type et taille des données de colonne : Le type de données est-il adapté à l'indexation ?
Modèles de requêtes attendus : Ce champ sera-t-il adapté aux requêtes ?
Définition et modification des clés primaires dans SQL
Ensuite, examinons comment déclarer et gérer les clés primaires dans PostgreSQL à l'aide de commandes SQL.
Nous examinerons divers scénarios, notamment la création de tableaux, la modification de tableaux existants et la gestion du comportement des contraintes.
Déclaration et modification Syntaxe
Lors de la création du tableau
Lors de la création des tableaux, il est recommandé de créer des champs susceptibles d'être trouvés. Dans ce cas, nous allons générer un identifiant d'employé composé d'entiers uniques.
CREATETABLE employees (
employee_id SERIALPRIMARYKEY,-- Automatically generates unique integers
name TEXTNOTNULL,-- Basic text field, required
email TEXTUNIQUE-- Unique constraint to prevent duplicate emails);Propulsé par
Cet exemple illustre la définition d'une clé primaire en ligne à l'aide du pseudo-type SERIAL. PostgreSQL traite SERIAL comme une colonne entière à incrémentation automatique, idéale pour les clés de substitution. La colonne « email » est également soumise à une contrainte UNIQUE, ce qui lui permet de servir de clé alternative.
Utilisation de ALTER TABLE
Maintenant, définissons l'employee_id e comme clé primaire.
ALTERTABLE employees ADDPRIMARYKEY(employee_id);Propulsé par
Cette commande est utilisée lorsqu'un tableau a déjà été créé sans clé primaire et que vous souhaitez en ajouter une par la suite. Veuillez vous assurer que la colonne à laquelle vous ajoutez la clé primaire ne contient pas de valeurs NULL ou de valeurs en double, sinon la commande échouera.
Suppression de la clé primaire
Maintenant que notre clé primaire est définie, vous pouvez également supprimer la contrainte de clé primaire.
ALTERTABLE employees DROPCONSTRAINT employees_pkey;Propulsé par
Utilisez cette instruction pour supprimer une contrainte de clé primaire existante. Le nom de la contrainte « employees_pkey » respecte la convention de nommage par défaut de PostgreSQL (_pkey). Ceci est utile lors de la refonte du schéma du tableau ou lors du passage à une autre colonne de clé primaire.
Dans PostgreSQL, le nom de contrainte par défaut pour les clés primaires est « table_name_pkey ».
Pour en savoir plus sur PostgreSQL, veuillez consulter notre fiche pratique.
Gestion des valeurs nulles et des collisions
Les valeurs NULL ne sont pas autorisées dans les colonnes de clé primaire. Les valeurs en double entraîneront également des erreurs de violation de contrainte.
Voici quelques stratégies pour gérer cette situation :
Utilisation de INSERT ... ON CONFLICT pour éviter les doublons.
Utilisation des transactions pour vérifier la disponibilité des clés avant les insertions.
Stratégies d'auto-incrémentation et d'identifiant global
Les types PostgreSQL « SERIAL », « BIGSERIAL » et « IDENTITY » simplifient la génération d'identifiants.
De plus, les UUID fournissent des identifiants globaux sécurisés. Leur nature non séquentielle et imprévisible renforce également la sécurité, en particulier dans la prévention des attaques par énumération.
Voici une implémentation illustrant comment créer un UUID et l'utiliser comme clé primaire.
Clés primaires dans les relations et amélioration des performances
Les clés primaires sont indispensables pour garantir la cohérence entre les tableaux relationnels et améliorer les performances.
Application de l'intégrité des entités
L'intégrité des entités est garantie par des clés primaires qui interdisent les valeurs NULL et les doublons. Disposer d'un identifiant unique permet d'éviter les anomalies dans les données lors des opérations d'insertion/mise à jour.
Clés étrangères et intégrité référentielle
Les clés étrangères doivent correspondre aux valeurs de clé primaire existantes dans le tableau référencé. L'intégrité référentielle garantit que toutes les références entre les tableaux restent valides et empêche les « enregistrements orphelins » où les enregistrements font référence à des données inexistantes.
Les actions en cascade garantissent la cohérence lorsque les clés primaires référencées changent.
Cela peut inclure des fonctions en cascade courantes telles que :
ON DELETE CASCADE
ON UPDATE CASCADE
SET NULL et SET DEFAULT
Indexation et optimisation des requêtes
Les index uniques sur les clés primaires accélèrent les requêtes d'SELECT t et de JOIN. Cependant, une conception inadéquate des clés peut entraîner des index volumineux et une dégradation des performances.
Si vos requêtes sont lentes et que vous soupçonnez une mauvaise indexation, veuillez utiliser EXPLAIN ANALYZE pour inspecter les plans de requête et évaluer l'utilisation des index.
Meilleures pratiques en matière de conception et pièges potentiels
Une conception efficace des clés favorise la maintenabilité, les performances et l'évolutivité. Examinons quelques bonnes pratiques et erreurs courantes.
Principales lignes directrices pour la sélection
Optez pour des types de données courts et de longueur fixe (par exemple, INT, UUID).
Évitez les clés susceptibles de changer.
Veuillez vous assurer que la clé n'a aucune signification commerciale afin d'éviter toute confusion logique.
Utilisez des clés de substitution pour simplifier et normaliser.
Erreurs courantes de mise en œuvre
Utilisation de clés primaires multiples (une seule est autorisée par tableau).
Étiqueter de manière incorrecte des contraintes uniques comme clés primaires.
Définition incorrecte des clés primaires, entraînant des enregistrements orphelins.
Les corrections incluent :
Ajout des clés manquantes via l'ALTER TABLE.
Normalisation de la conception du schéma.
Utiliser des conventions de dénomination cohérentes.
Considérations relatives à l'évolutivité
Lorsque vous créez une solution de base de données évolutive, essayez d'utiliser des clés de substitution afin de garantir l'uniformité des grands ensembles de données. Évitez les clés composites dans les systèmes distribués, sauf si cela est nécessaire. Il est également indispensable de surveiller régulièrement la taille de vos tableaux/index.
Scénarios de mise en œuvre avancés
La gestion des clés primaires dans des systèmes complexes, tels que les bases de données distribuées ou les systèmes hérités, nécessite des stratégies avancées.
Systèmes de bases de données distribuées
Les bases de données distribuées sont plus complexes. Vous devrez vous assurer que la génération de clés ne présente aucun conflit entre les nœuds. Pour ce faire, vous pouvez essayer d'utiliser des UUID et des services de gestion centralisée des clés.
Considérations relatives au partitionnement :
Veuillez vous assurer que les touches ne créent pas de points chauds.
Veuillez utiliser des clés hachées ou aléatoires lors du partitionnement.
Migration des systèmes existants
Lors de la migration d'un système à partir d'une base de données existante, veuillez commencer par identifier les identifiants uniques existants. Ensuite, introduisez progressivement des clés de substitution parallèlement aux clés naturelles.
Adoptez une approche prudente en activant la prise en charge de la double clé avant de procéder à la transition complète.
Processus de migration :
Ajouter une colonne de clé de substitution.
Remplissez les clés pour les enregistrements existants.
Modifiez les requêtes de l'application.
Supprimer les anciennes clés naturelles après vérification.
Démonstration des clés primaires à l'aide de PostgreSQL
Avant de créer des tableaux et d'y insérer des données, vous devez disposer d'un environnement PostgreSQL opérationnel. Cette section commence par un guide succinct sur la configuration de PostgreSQL, suivi d'instructions pour définir et utiliser un exemple de jeu de données afin de mettre en pratique les concepts de base.
Étape 1 : Configuration initiale de PostgreSQL
Si vous n'avez pas encore installé PostgreSQL, veuillez suivre ces étapes pour commencer :
Veuillez sélectionner votre système d'exploitation (Windows, macOS ou Linux).
Veuillez télécharger et exécuter le programme d'installation, en veillant à installer pgAdmin (une interface graphique) avec le serveur PostgreSQL.
Démarrez le service PostgreSQL.
Une fois installé, le service PostgreSQL démarre généralement automatiquement.
Vous pouvez également le démarrer manuellement via le gestionnaire de services de votre système d'exploitation (par exemple, Services sous Windows ou systemctl sous Linux).
Veuillez lancer pgAdmin ou vous connecter via l'interface CLI.
Veuillez utiliser pgAdmin pour gérer et interroger visuellement les bases de données.
Vous pouvez également ouvrir un terminal et vous connecter à l'aide de la commande suivante :psql -U postgres
Veuillez remplacer postgres par votre nom d'utilisateur PostgreSQL réel s'il est différent.
Créer une nouvelle base de données
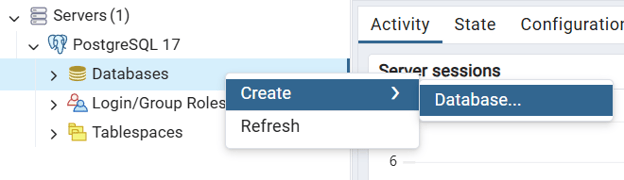
Dans l'pgAdmin, cliquez avec le bouton droit sur « Bases de données » et sélectionnez « Créer > Base de données ».
Ou utilisez la commande SQL suivante :```sql
CRÉER UNE BASE DE DONNÉES pk_tutorial ;
Connect to the new database in psql with:```bash
\c pk_tutorialPropulsé par
Une fois votre environnement prêt, vous pouvez poursuivre la configuration du jeu de données comme indiqué dans le tutoriel.
Ensuite, nous allons examiner un guide étape par étape pour créer un exemple d'ensemble de données à l'aide de PostgreSQL. L'ensemble de données se compose de deux tableaux connexes : customers et orders.
Le tableau « customers » utilise une clé de substitution pour plus de simplicité, tandis que le tableau « orders » utilise une clé primaire basée sur un UUID pour illustrer l'unicité globale.
Étape 2 : Création de tableaux
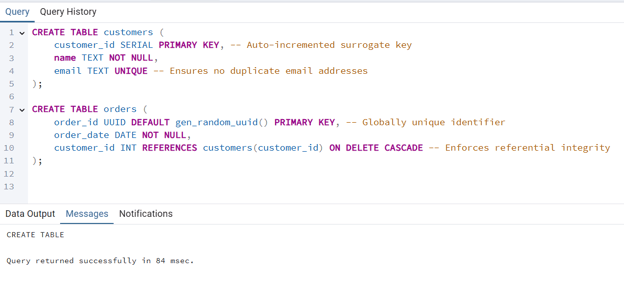
La première étape consiste à définir le schéma et à établir les contraintes de clé primaire pour les deux tableaux. Nous définissons également une relation de clé étrangère entre orders.customer_id et customers.customer_id afin de démontrer l'intégrité relationnelle.
Pour le tableau customers, la clé primaire est customer_id.
Pour le tableau orders, la clé primaire est order_id.
customer_id utilise le mot-clé « SERIAL » pour générer automatiquement des identifiants uniques.
email dispose d'une contrainte d'UNIQUE pour éviter les doublons.
order_id Il s'agit d'un fichier de configuration ( UUID ) généré automatiquement via gen_random_uuid().
La clause « ON DELETE CASCADE » garantit que la suppression d'un client entraîne également la suppression des commandes qui lui sont associées.
Voici à quoi cela devrait ressembler dans l'interface pgAdmin :
Étape 3 : Insertion de données d'exemple
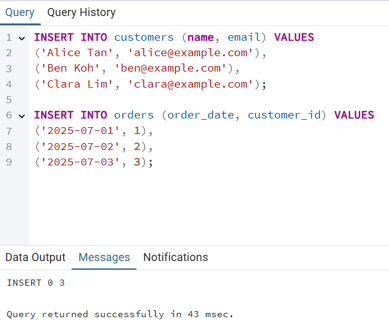
Ensuite, nous remplissons les tableaux avec des exemples d'enregistrements afin d'observer le comportement des clés primaires et étrangères lors d'opérations d'insertion typiques. Ces données simulent un scénario de commerce électronique de base.
Voici à quoi cela devrait ressembler dans l'interface pgAdmin :
Étape 4 : Requête de données
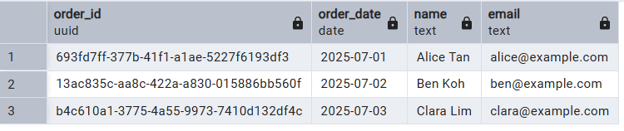
Enfin, nous effectuons une requête SQL « JOIN » pour récupérer les informations des deux tableaux, démontrant ainsi comment la clé étrangère permet des jointures relationnelles transparentes entre les commandes et les clients.
Voici le code que nous allons exécuter :
SELECT o.order_id, o.order_date, c.name, c.email
FROM orders o
JOIN customers c ON o.customer_id = c.customer_id;Propulsé par
Voici un exemple de résultat :
Comme vous pouvez le constater sur l'image ci-dessus, le tableau de sortie affiche les données des deux tableaux. Par exemple, le tableau joint comprend le champ « order_date » du tableau « orders » et le champ « name » du tableau « customers ».
Conclusion
Les clés primaires SQL sont fondamentales pour les bases de données relationnelles. Elles garantissent l'unicité, permettent des requêtes efficaces et assurent l'intégrité des données.
Quelles sont les différences entre les clés naturelles et les clés surrogates ?⌄
Les clés naturelles sont dérivées de données réelles existantes (par exemple, une adresse e-mail ou un numéro d'identification national), tandis que les clés de substitution sont des valeurs générées par le système (par exemple, des identifiants auto-incrémentés) utilisées uniquement pour identifier de manière unique des lignes.
Comment les clés primaires composites améliorent-elles la conception des bases de données ?⌄
Les clés primaires composites utilisent plusieurs colonnes pour garantir l'unicité, ce qui permet de mieux modéliser les relations dans les tables de jonction et d'appliquer l'unicité multi-attributs dans les relations plusieurs-à-plusieurs.
Quelles sont les meilleures pratiques pour choisir une clé primaire ?⌄
Une bonne clé primaire doit être unique, stable (ne pas changer au fil du temps), de taille minimale et, idéalement, numérique pour garantir des performances et une efficacité d'indexation optimales.
Comment les clés primaires contribuent-elles à l'intégrité des données ?⌄
Les clés primaires garantissent que chaque ligne d'un tableau est identifiable de manière unique, ce qui évite les enregistrements en double et permet un référencement précis grâce à des clés étrangères.
Pourriez-vous expliquer le rôle des clés primaires dans l'établissement de relations entre les tableaux ?⌄
Les clés primaires servent de points de référence pour les clés étrangères dans d'autres tableaux, ce qui permet d'assurer l'intégrité relationnelle et de prendre en charge les relations un-à-plusieurs ou plusieurs-à-plusieurs dans un schéma normalisé.
Je m'appelle Austin, je suis blogueur et rédacteur technique et j'ai des années d'expérience en tant que data scientist et data analyst dans le domaine de la santé. J'ai commencé mon parcours technologique avec une formation en biologie et j'aide maintenant les autres à faire la même transition grâce à mon blog technologique. Ma passion pour la technologie m'a conduit à écrire pour des dizaines d'entreprises SaaS, inspirant les autres et partageant mes expériences.
Apprenez l'essentiel de l'architecture d'un entrepôt de données, des composants clés aux meilleures pratiques, pour construire un système de données évolutif et efficace !
Initiez-vous aux structures de données de Python : apprenez-en plus sur les types de données et les structures de données primitives et non primitives, telles que les chaînes de caractères, les listes, les piles, etc.
Découvrez les principales différences, les applications et la mise en œuvre de la normalisation et de la standardisation dans le prétraitement des données pour l’apprentissage automatique.
Maîtrisez les principes fondamentaux du langage SQL nécessaires aux entreprises, apprenez à écrire des requêtes SQL et commencez à analyser vos données à l'aide de ce puissant langage.





Dans les bases de données relationnelles, la clé primaire joue un rôle crucial pour garantir l'unicité et l'intégrité des données d'un tableau. Une clé primaire est une contrainte qui identifie de manière unique chaque enregistrement d'un tableau. Elle sert d'élément fondamental pour l'indexation, le renforcement de l'intégrité des entités et l'établissement de relations entre les tableaux.
Dans ce tutoriel, je vous guiderai à travers une exploration approfondie des clés primaires SQL, en couvrant les principes fondamentaux, les méthodes de mise en œuvre et les techniques d'optimisation. Je présenterai également quelques erreurs courantes et les meilleures pratiques, ainsi que des scénarios concrets. Si vous êtes encore en train d'apprendre le langage SQL, je vous recommande de consulter notre feuille de route SQL complète et de suivre notre cursus sur les fondamentaux du langage SQL.
Qu'est-ce qu'une clé primaire SQL ?
Une clé primaire SQL est une colonne ou un ensemble de colonnes qui identifie de manière unique chaque ligne d'un tableau. Cela signifie qu'aucune ligne ne peut avoir la même valeur de clé primaire. Un tableau ne peut avoir qu'une seule clé primaire, qui peut être constituée d'une ou plusieurs colonnes.
Les clés primaires sont essentielles pour garantir l'intégrité des données et permettre des requêtes efficaces. Examinons quelques aspects fondamentaux.
Les clés primaires sont indispensables à la normalisation des bases de données et à l'intégrité relationnelle.
Propriétés clés des clés primaires
Contraintes et indexation
Lorsqu'une clé primaire est définie, la base de données crée automatiquement un index unique afin d'appliquer la contrainte. Cet index accélère les performances des requêtes, en particulier pour les opérations de recherche.
Grâce à ce système d'indexation, les clés primaires facilitent l'optimisation du plan d'exécution du moteur de base de données. Cela permettra d'accélérer l'exécution de vos requêtes.
Types de données courants pour les clés primaires
Les clés primaires peuvent être de plusieurs types. Voici quelques types utilisés :
INTEGERouSERIAL: Efficace et le plus couramment utilisé.BIGINT: Utile pour les tableaux susceptibles de stocker des milliards de lignes.UUID: Idéal pour les systèmes distribués et pour éviter la prévisibilité séquentielle.CHAR/VARCHAR: À utiliser avec précaution, généralement dans les tonalités naturelles lorsque cela est nécessaire.Types et architecture des clés primaires SQL
Les clés primaires peuvent être classées en différents types en fonction de leur structure et de leur origine. Voici quelques exemples :
SERIAL, l'BIGSERIALou l'UUID. L'utilisation de telles clés offre stabilité, confidentialité et facilité de maintenance.En les comparant sur la base de leurs caractéristiques, nous pouvons mettre en évidence leurs différences dans le tableau récapitulatif suivant :
Caractéristique
Clé naturelle
Clé de substitution
Signification commerciale
Oui
Non
Stabilité
Souvent instable
Très stable
Performance
Peut nécessiter de grands champs
Généralement compact
Préoccupations relatives à la confidentialité
Supérieur
Plus bas
Architecture de clé primaire composite
Une clé primaire composite est une méthode courante pour générer une clé unique dans les tableaux. La clé est généralement dérivée des données trouvées dans deux colonnes ou plus.
Ces clés sont courantes dans les tables de jonction ou associatives où la relation elle-même exige l'unicité.
course_enrollmentspourrait utiliser une clé composite composée destudent_idetcourse_id.Considérations :
Clés supplémentaires utilisées dans les bases de données
Outre la clé primaire, plusieurs autres clés peuvent être utilisées, telles que :
Si vous hésitez sur le champ de données à utiliser comme clé primaire, vous pouvez tenir compte des facteurs suivants :
Définition et modification des clés primaires dans SQL
Ensuite, examinons comment déclarer et gérer les clés primaires dans PostgreSQL à l'aide de commandes SQL.
Nous examinerons divers scénarios, notamment la création de tableaux, la modification de tableaux existants et la gestion du comportement des contraintes.
Déclaration et modification Syntaxe
Lors de la création du tableau
Lors de la création des tableaux, il est recommandé de créer des champs susceptibles d'être trouvés. Dans ce cas, nous allons générer un identifiant d'employé composé d'entiers uniques.
Pour en savoir plus sur les commandes SQL, veuillez consulter notre aide-mémoire sur les bases du SQL.
Cet exemple illustre la définition d'une clé primaire en ligne à l'aide du pseudo-type SERIAL. PostgreSQL traite SERIAL comme une colonne entière à incrémentation automatique, idéale pour les clés de substitution. La colonne « email » est également soumise à une contrainte UNIQUE, ce qui lui permet de servir de clé alternative.
Utilisation de ALTER TABLE
Maintenant, définissons l'
employee_ide comme clé primaire.Cette commande est utilisée lorsqu'un tableau a déjà été créé sans clé primaire et que vous souhaitez en ajouter une par la suite. Veuillez vous assurer que la colonne à laquelle vous ajoutez la clé primaire ne contient pas de valeurs NULL ou de valeurs en double, sinon la commande échouera.
Suppression de la clé primaire
Maintenant que notre clé primaire est définie, vous pouvez également supprimer la contrainte de clé primaire.
Utilisez cette instruction pour supprimer une contrainte de clé primaire existante. Le nom de la contrainte «
employees_pkey» respecte la convention de nommage par défaut de PostgreSQL (_pkey). Ceci est utile lors de la refonte du schéma du tableau ou lors du passage à une autre colonne de clé primaire.
- Utilisation de
- Utilisation des transactions pour vérifier la disponibilité des clés avant les insertions.
- Optez pour des types de données courts et de longueur fixe (par exemple,
- Évitez les clés susceptibles de changer.
- Veuillez vous assurer que la clé n'a aucune signification commerciale afin d'éviter toute confusion logique.
- Utilisez des clés de substitution pour simplifier et normaliser.
- Utilisation de clés primaires multiples (une seule est autorisée par tableau).
- Étiqueter de manière incorrecte des contraintes uniques comme clés primaires.
- Définition incorrecte des clés primaires, entraînant des enregistrements orphelins.
- Ajout des clés manquantes via l'
- Normalisation de la conception du schéma.
- Utiliser des conventions de dénomination cohérentes.
- Veuillez vous assurer que les touches ne créent pas de points chauds.
- Veuillez utiliser des clés hachées ou aléatoires lors du partitionnement.
- Ajouter une colonne de clé de substitution.
- Remplissez les clés pour les enregistrements existants.
- Modifiez les requêtes de l'application.
- Supprimer les anciennes clés naturelles après vérification.
- Installer PostgreSQL
- Veuillez consulter le site officiel : https://www.postgresql.org/download/
- Veuillez sélectionner votre système d'exploitation (Windows, macOS ou Linux).
- Veuillez télécharger et exécuter le programme d'installation, en veillant à installer
- Démarrez le service PostgreSQL.
- Une fois installé, le service PostgreSQL démarre généralement automatiquement.
- Vous pouvez également le démarrer manuellement via le gestionnaire de services de votre système d'exploitation (par exemple, Services sous Windows ou
- Veuillez lancer pgAdmin ou vous connecter via l'interface CLI.
- Veuillez utiliser
- Vous pouvez également ouvrir un terminal et vous connecter à l'aide de la commande suivante :psql -U postgres
- Veuillez remplacer
- Créer une nouvelle base de données
- Dans l'
- Ou utilisez la commande SQL suivante :```sql
- La clause «
Dans PostgreSQL, le nom de contrainte par défaut pour les clés primaires est «
table_name_pkey».Pour en savoir plus sur PostgreSQL, veuillez consulter notre fiche pratique.
Gestion des valeurs nulles et des collisions
Les valeurs NULL ne sont pas autorisées dans les colonnes de clé primaire. Les valeurs en double entraîneront également des erreurs de violation de contrainte.
Voici quelques stratégies pour gérer cette situation :
INSERT ... ON CONFLICTpour éviter les doublons.Stratégies d'auto-incrémentation et d'identifiant global
Les types PostgreSQL «
SERIAL», «BIGSERIAL» et «IDENTITY» simplifient la génération d'identifiants.De plus, les UUID fournissent des identifiants globaux sécurisés. Leur nature non séquentielle et imprévisible renforce également la sécurité, en particulier dans la prévention des attaques par énumération.
Voici une implémentation illustrant comment créer un UUID et l'utiliser comme clé primaire.
Clés primaires dans les relations et amélioration des performances
Les clés primaires sont indispensables pour garantir la cohérence entre les tableaux relationnels et améliorer les performances.
Application de l'intégrité des entités
L'intégrité des entités est garantie par des clés primaires qui interdisent les valeurs NULL et les doublons. Disposer d'un identifiant unique permet d'éviter les anomalies dans les données lors des opérations d'insertion/mise à jour.
Clés étrangères et intégrité référentielle
Les clés étrangères doivent correspondre aux valeurs de clé primaire existantes dans le tableau référencé. L'intégrité référentielle garantit que toutes les références entre les tableaux restent valides et empêche les « enregistrements orphelins » où les enregistrements font référence à des données inexistantes.
Les actions en cascade garantissent la cohérence lorsque les clés primaires référencées changent.
Cela peut inclure des fonctions en cascade courantes telles que :
ON DELETE CASCADEON UPDATE CASCADESET NULLetSET DEFAULTIndexation et optimisation des requêtes
Les index uniques sur les clés primaires accélèrent les requêtes d'
SELECTt et deJOIN. Cependant, une conception inadéquate des clés peut entraîner des index volumineux et une dégradation des performances.Si vos requêtes sont lentes et que vous soupçonnez une mauvaise indexation, veuillez utiliser
EXPLAIN ANALYZEpour inspecter les plans de requête et évaluer l'utilisation des index.Meilleures pratiques en matière de conception et pièges potentiels
Une conception efficace des clés favorise la maintenabilité, les performances et l'évolutivité. Examinons quelques bonnes pratiques et erreurs courantes.
Principales lignes directrices pour la sélection
INT,UUID).Erreurs courantes de mise en œuvre
Les corrections incluent :
ALTER TABLE.Considérations relatives à l'évolutivité
Lorsque vous créez une solution de base de données évolutive, essayez d'utiliser des clés de substitution afin de garantir l'uniformité des grands ensembles de données. Évitez les clés composites dans les systèmes distribués, sauf si cela est nécessaire. Il est également indispensable de surveiller régulièrement la taille de vos tableaux/index.
Scénarios de mise en œuvre avancés
La gestion des clés primaires dans des systèmes complexes, tels que les bases de données distribuées ou les systèmes hérités, nécessite des stratégies avancées.
Systèmes de bases de données distribuées
Les bases de données distribuées sont plus complexes. Vous devrez vous assurer que la génération de clés ne présente aucun conflit entre les nœuds. Pour ce faire, vous pouvez essayer d'utiliser des UUID et des services de gestion centralisée des clés.
Considérations relatives au partitionnement :
Migration des systèmes existants
Lors de la migration d'un système à partir d'une base de données existante, veuillez commencer par identifier les identifiants uniques existants. Ensuite, introduisez progressivement des clés de substitution parallèlement aux clés naturelles.
Adoptez une approche prudente en activant la prise en charge de la double clé avant de procéder à la transition complète.
Processus de migration :
Démonstration des clés primaires à l'aide de PostgreSQL
Avant de créer des tableaux et d'y insérer des données, vous devez disposer d'un environnement PostgreSQL opérationnel. Cette section commence par un guide succinct sur la configuration de PostgreSQL, suivi d'instructions pour définir et utiliser un exemple de jeu de données afin de mettre en pratique les concepts de base.
Étape 1 : Configuration initiale de PostgreSQL
Si vous n'avez pas encore installé PostgreSQL, veuillez suivre ces étapes pour commencer :
pgAdmin(une interface graphique) avec le serveur PostgreSQL.systemctlsous Linux).pgAdminpour gérer et interroger visuellement les bases de données.postgrespar votre nom d'utilisateur PostgreSQL réel s'il est différent.pgAdmin, cliquez avec le bouton droit sur « Bases de données » et sélectionnez « Créer > Base de données ».CRÉER UNE BASE DE DONNÉES pk_tutorial ;
Une fois votre environnement prêt, vous pouvez poursuivre la configuration du jeu de données comme indiqué dans le tutoriel.
Ensuite, nous allons examiner un guide étape par étape pour créer un exemple d'ensemble de données à l'aide de PostgreSQL. L'ensemble de données se compose de deux tableaux connexes :
customersetorders.Le tableau «
customers» utilise une clé de substitution pour plus de simplicité, tandis que le tableau «orders» utilise une clé primaire basée sur un UUID pour illustrer l'unicité globale.Étape 2 : Création de tableaux
La première étape consiste à définir le schéma et à établir les contraintes de clé primaire pour les deux tableaux. Nous définissons également une relation de clé étrangère entre
orders.customer_idetcustomers.customer_idafin de démontrer l'intégrité relationnelle.Pour le tableau
customers, la clé primaire estcustomer_id.Pour le tableau
orders, la clé primaire estorder_id.Explication :
customer_idutilise le mot-clé «SERIAL» pour générer automatiquement des identifiants uniques.emaildispose d'une contrainte d'UNIQUEpour éviter les doublons.order_idIl s'agit d'un fichier de configuration (UUID) généré automatiquement viagen_random_uuid().ON DELETE CASCADE» garantit que la suppression d'un client entraîne également la suppression des commandes qui lui sont associées.Voici à quoi cela devrait ressembler dans l'interface pgAdmin :
Étape 3 : Insertion de données d'exemple
Ensuite, nous remplissons les tableaux avec des exemples d'enregistrements afin d'observer le comportement des clés primaires et étrangères lors d'opérations d'insertion typiques. Ces données simulent un scénario de commerce électronique de base.
Voici à quoi cela devrait ressembler dans l'interface pgAdmin :
Étape 4 : Requête de données
Enfin, nous effectuons une requête SQL «
JOIN» pour récupérer les informations des deux tableaux, démontrant ainsi comment la clé étrangère permet des jointures relationnelles transparentes entre les commandes et les clients.Voici le code que nous allons exécuter :
Voici un exemple de résultat :
Comme vous pouvez le constater sur l'image ci-dessus, le tableau de sortie affiche les données des deux tableaux. Par exemple, le tableau joint comprend le champ «
order_date» du tableau «orders» et le champ «name» du tableau «customers».Conclusion
Les clés primaires SQL sont fondamentales pour les bases de données relationnelles. Elles garantissent l'unicité, permettent des requêtes efficaces et assurent l'intégrité des données.
Nous avons abordé les principes, les classifications, la syntaxe, les meilleures pratiques et les stratégies avancées relatives aux clés primaires SQL. Pour plus de ressources d'apprentissage, veuillez consulter notre cours Introduction aux bases de données relationnelles en SQL ou le cours Joindre des données en SQL.
Si vous préférez les tutoriels, le guide Contraintes d'intégrité dans SQL ou l'aide-mémoire SQL Joins devraient également vous être très utiles.