Curso
Conceptos de NoSQL
2 h
19K
Bienvenido al mundo de DynamoDB, donde la eficiencia y la escalabilidad sin límites convergen en una sola tabla. En este tutorial completo, vamos a emprender un recorrido estimulante para desvelar el verdadero potencial del diseño de bases de datos NoSQL de tabla única.
Descubre el arte de simplificar modelos de datos complejos mientras aprovechas toda la potencia de una estructura unificada, capaz de adaptarse sin esfuerzo a tus necesidades crecientes.
Tanto si ya eres un desarrollador con experiencia en bases de datos NoSQL como si acabas de empezar en este mundo, prepárate para llevar la escalabilidad de tus aplicaciones a otro nivel con una arquitectura de datos potente.
Antes de empezar, es importante entender la diferencia entre NoSQL y las bases de datos relacionales, en qué escenarios usaríamos cada una y por qué se inventaron estas tecnologías. Para ello, conviene repasar brevemente la historia del procesamiento de datos.
Puedes leer más sobre la importancia de las bases de datos NoSQL en ciencia de datos en otra entrada del blog.
La base de datos relacional es una tecnología conocida y muy extendida que existe desde la década de 1970. Dos de los principales problemas que resuelve son el almacenamiento y la integridad referencial.
Los datos se "normalizan", normalmente hasta la tercera forma normal, lo que reduce la huella de almacenamiento y garantiza que cualquier actualización se mantenga coherente con el resto de los datos.
El tamaño de los datos persistidos era crucial porque, históricamente, el componente más caro del centro de datos era el disco duro. Hoy ya no es así: lo más costoso suele ser la CPU y el almacenamiento se ha abaratado de forma drástica. Esto no significa que la base de datos relacional sea obsoleta; sigue teniendo aplicaciones muy válidas en:
La "presión de datos" es la capacidad de un sistema para procesar una cantidad determinada de datos a un coste y/o en un tiempo razonables.
Las bases de datos NoSQL surgieron a finales de los 90 para abordar los problemas de presión de datos que afectaban al rendimiento de las bases de datos relacionales debido al crecimiento continuo del volumen de datos de las aplicaciones.
En una base de datos relacional, la CPU puede convertirse en uno de los principales cuellos de botella, ya que el servidor relacional se esfuerza por recuperar y recomponer datos normalizados en vistas desnormalizadas que son las que suelen consumir las aplicaciones.
Esto puede mitigarse añadiendo réplicas de lectura, pero NoSQL adopta otro enfoque: almacena los datos de la aplicación en forma desnormalizada y lista para consumir. Esto implica que la huella de datos es mayor que en una base relacional, pero aligera la carga de la CPU, convirtiendo de facto el servidor de base de datos en un simple enrutador que usa un algoritmo de hash para señalar una ubicación en disco en el centro de datos. Usos típicos de NoSQL:
Numerosos estudios aportan datos objetivos suficientes como para representar gráficamente el rendimiento de SQL frente a NoSQL a escala.
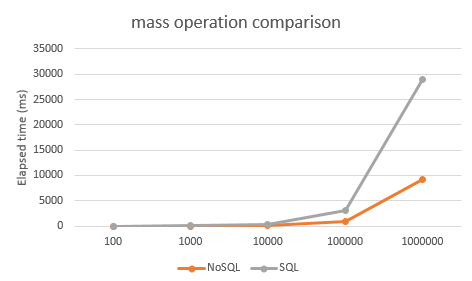
La última idea a remarcar es que los datos almacenados en una base NoSQL siguen siendo datos relacionales. Si no lo fueran, los guardaríamos en un simple almacenador de archivos.
No modelamos una base NoSQL igual que una relacional, así que es un antipatrón trasladar un diseño normalizado directamente a NoSQL usando múltiples tablas unidas, porque NoSQL no tiene operador de join ni integridad referencial.
Una tabla en NoSQL equivale a un catálogo en una base relacional. En su lugar, modela los datos para almacenarlos desnormalizados y listos para que las aplicaciones los consuman.
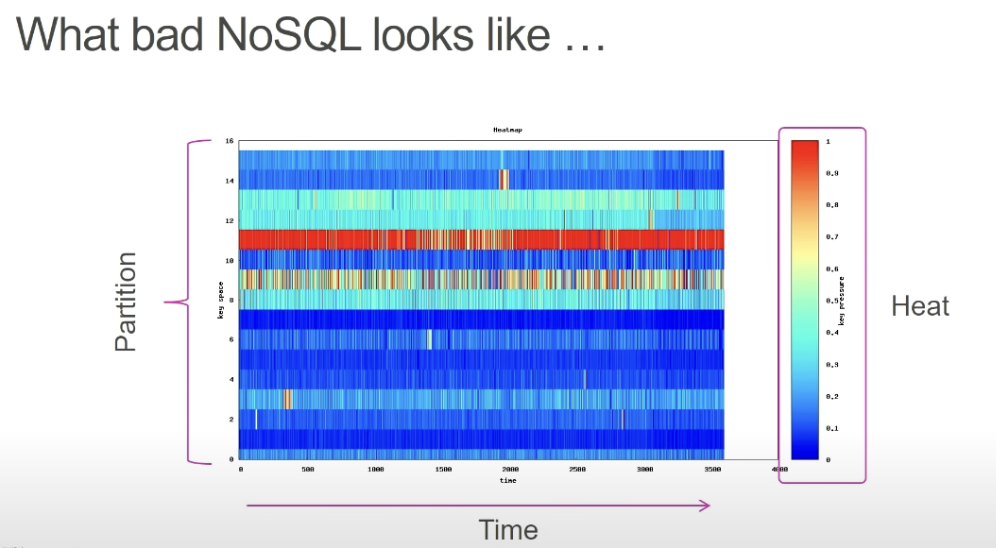
Otro antipatrón son las Hot Keys. Significa que la mayoría, si no todas, las peticiones de acceso golpean un único nodo de almacenamiento, síntoma de que el espacio de claves no está bien diseñado.
El mapa de calor de acceso tendría un aspecto similar a este:
AWS DynamoDB es un almacén clave-valor de columnas anchas, totalmente gestionado y serverless. Esto significa que admite muchos ítems o filas en una tabla, pero esos ítems no tienen por qué compartir los mismos atributos. Los tipos de datos compatibles son:
Como ya comentamos, NoSQL debe utilizarse cuando los patrones de acceso de la aplicación están bien definidos y hay que soportar un gran número de TPS. DynamoDB puede escalar a cualquier carga de trabajo y ofrece tiempos de respuesta rápidos y predecibles de hasta 4 millones de TPS con baja latencia (10 - 20 ms).
Cada ítem (o fila) tiene una clave de partición que lo identifica de forma única y determina la distribución de los datos en el almacenamiento subyacente.
Opcionalmente, los ítems pueden tener una clave de ordenación, que determina el orden en que se almacenan en disco dentro de una partición. Las claves de ordenación permiten consultar particiones con operaciones de rango y filtrado complejas (aunque los filtros se aplican en la capa de cliente, no en la base de datos).
La clave de partición se usa para crear un índice hash y, después, cada ítem se distribuye según ese hash en un espacio de claves virtual. Este espacio virtual se divide en segmentos que se asignan a dispositivos de almacenamiento físico y pueden crecer o reducirse dinámicamente según el volumen de datos almacenados.
Por eso DynamoDB es rápido y consistente a cualquier escala: porque el motor actúa como un servicio de enrutamiento que va de claves hasheadas al almacenamiento físico.
En este tutorial, modelaremos una tienda online llamada Daintree.com.
(Dato curioso: la selva tropical de Daintree, en Queensland (Australia), es una de las más antiguas del planeta, con unos 180 millones de años.)
Primero, vamos a crear un diagrama entidad-relación (ERD) muy simplificado para visualizar qué vamos a modelar.
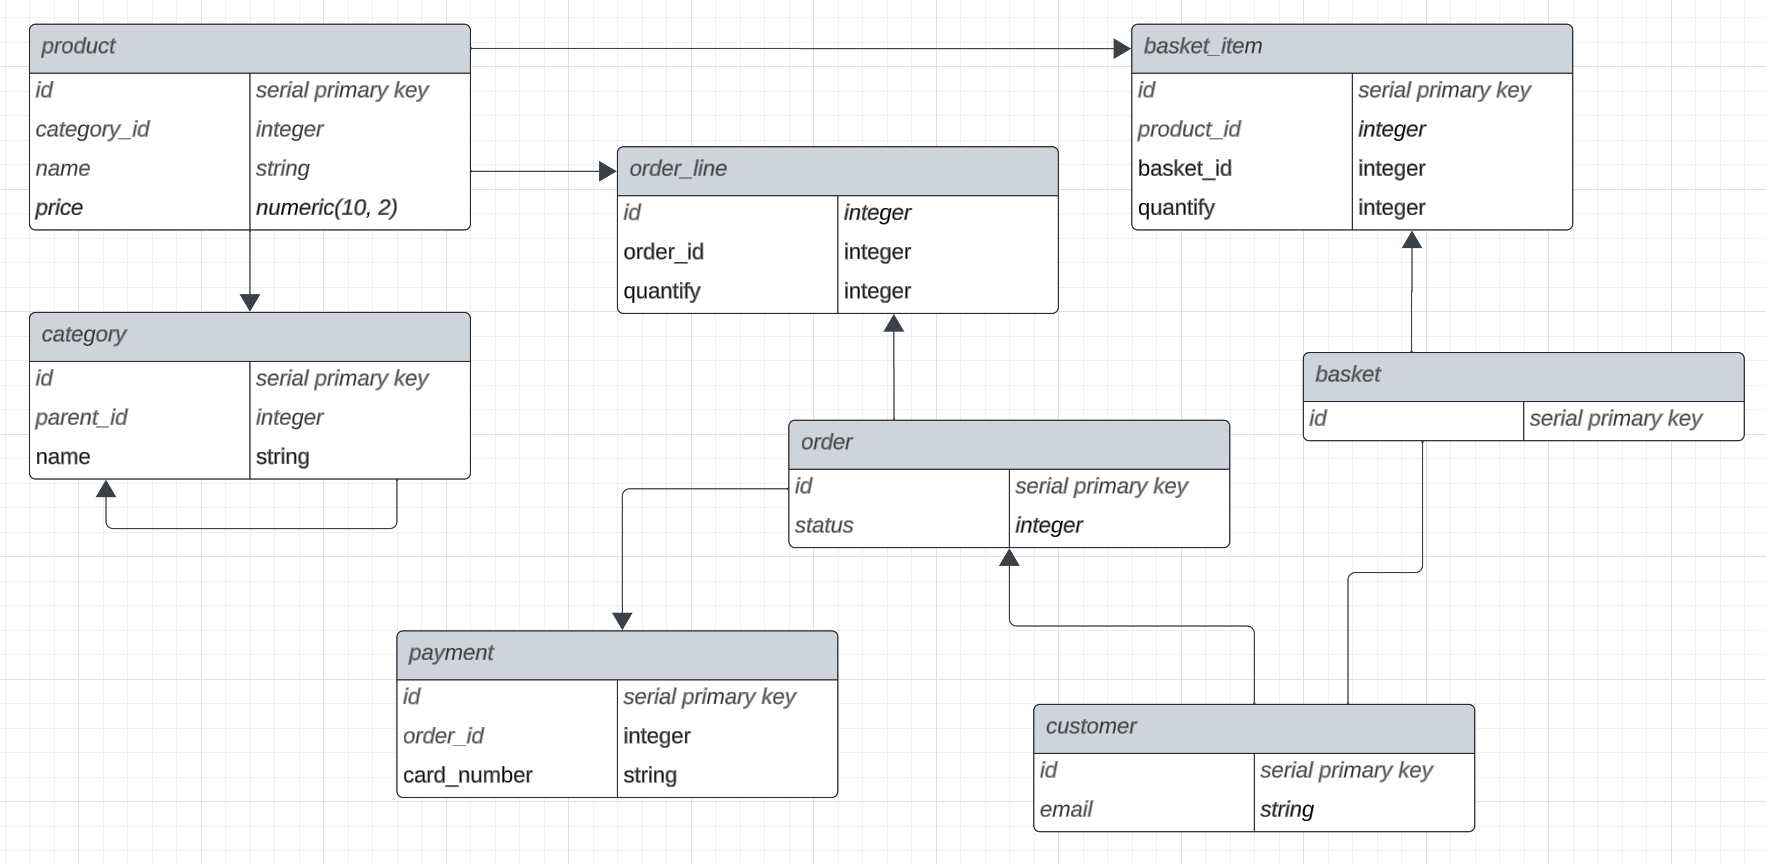
De aquí deducimos que un cliente puede crear una cesta y añadir varios productos con cantidades distintas.
Un producto tiene una categoría, que a su vez puede tener categorías padre.
Las cestas pueden convertirse en pedidos que a su vez pueden dividirse en varios pagos.
Como ya hemos dicho, esta es una vista muy simplificada de las relaciones y atributos de las entidades que componen una aplicación de compra online, pero nos sirve para el objetivo del tutorial.
Este paso no suele preocuparnos al implementar una base relacional. SQL es un lenguaje potentísimo que, siempre que el esquema esté bien diseñado, nos da flexibilidad para consultar y manipular los datos como queramos. En un diseño de tabla única en NoSQL no es así, porque debemos almacenar los datos desnormalizados y listos para que la aplicación los consuma directamente.
Estos son los patrones de acceso que quizá queramos cubrir en nuestra aplicación de compras:
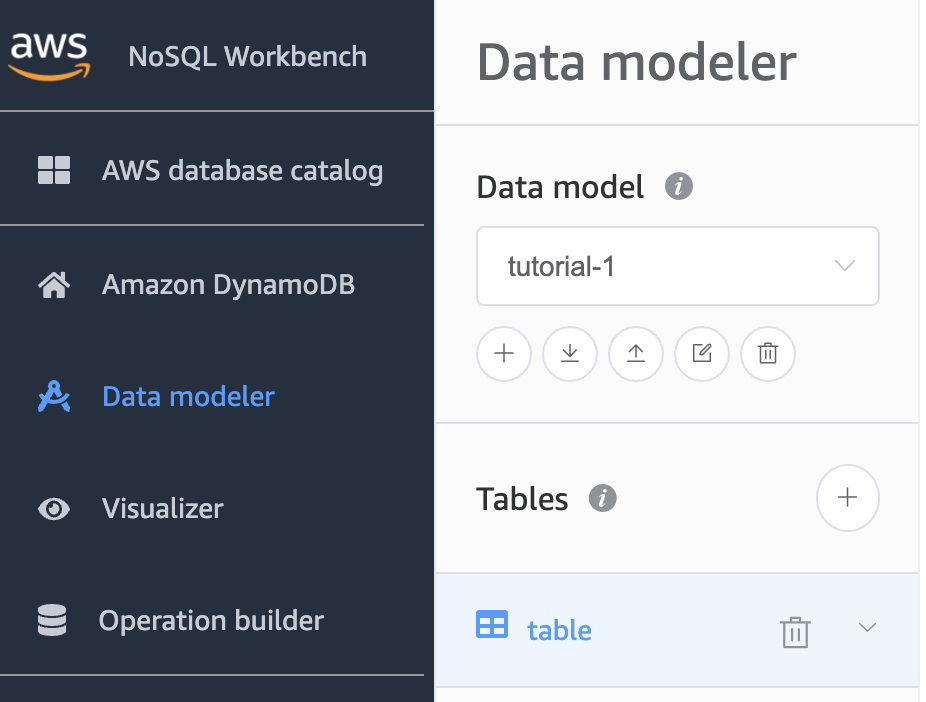
NoSQL workbench es una herramienta gratuita de AWS para modelar tablas NoSQL para DynamoDB.
Ve a Data modeler y crea un nuevo modelo de datos con una tabla nueva:
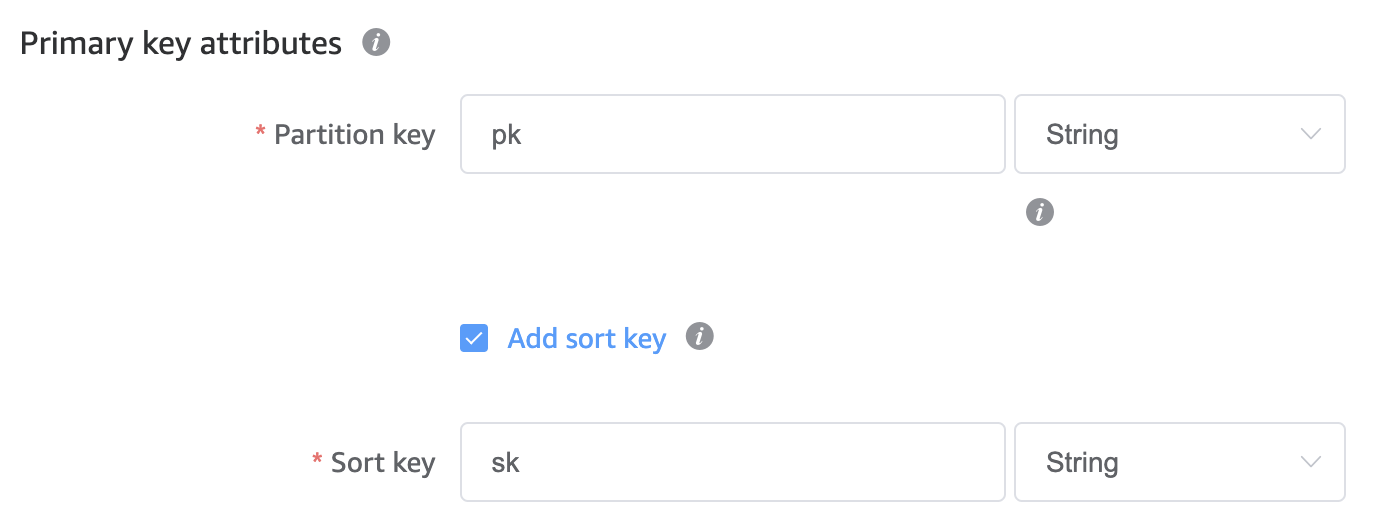
Vamos a mantener los atributos de la clave primaria como strings genéricos PK y SK:
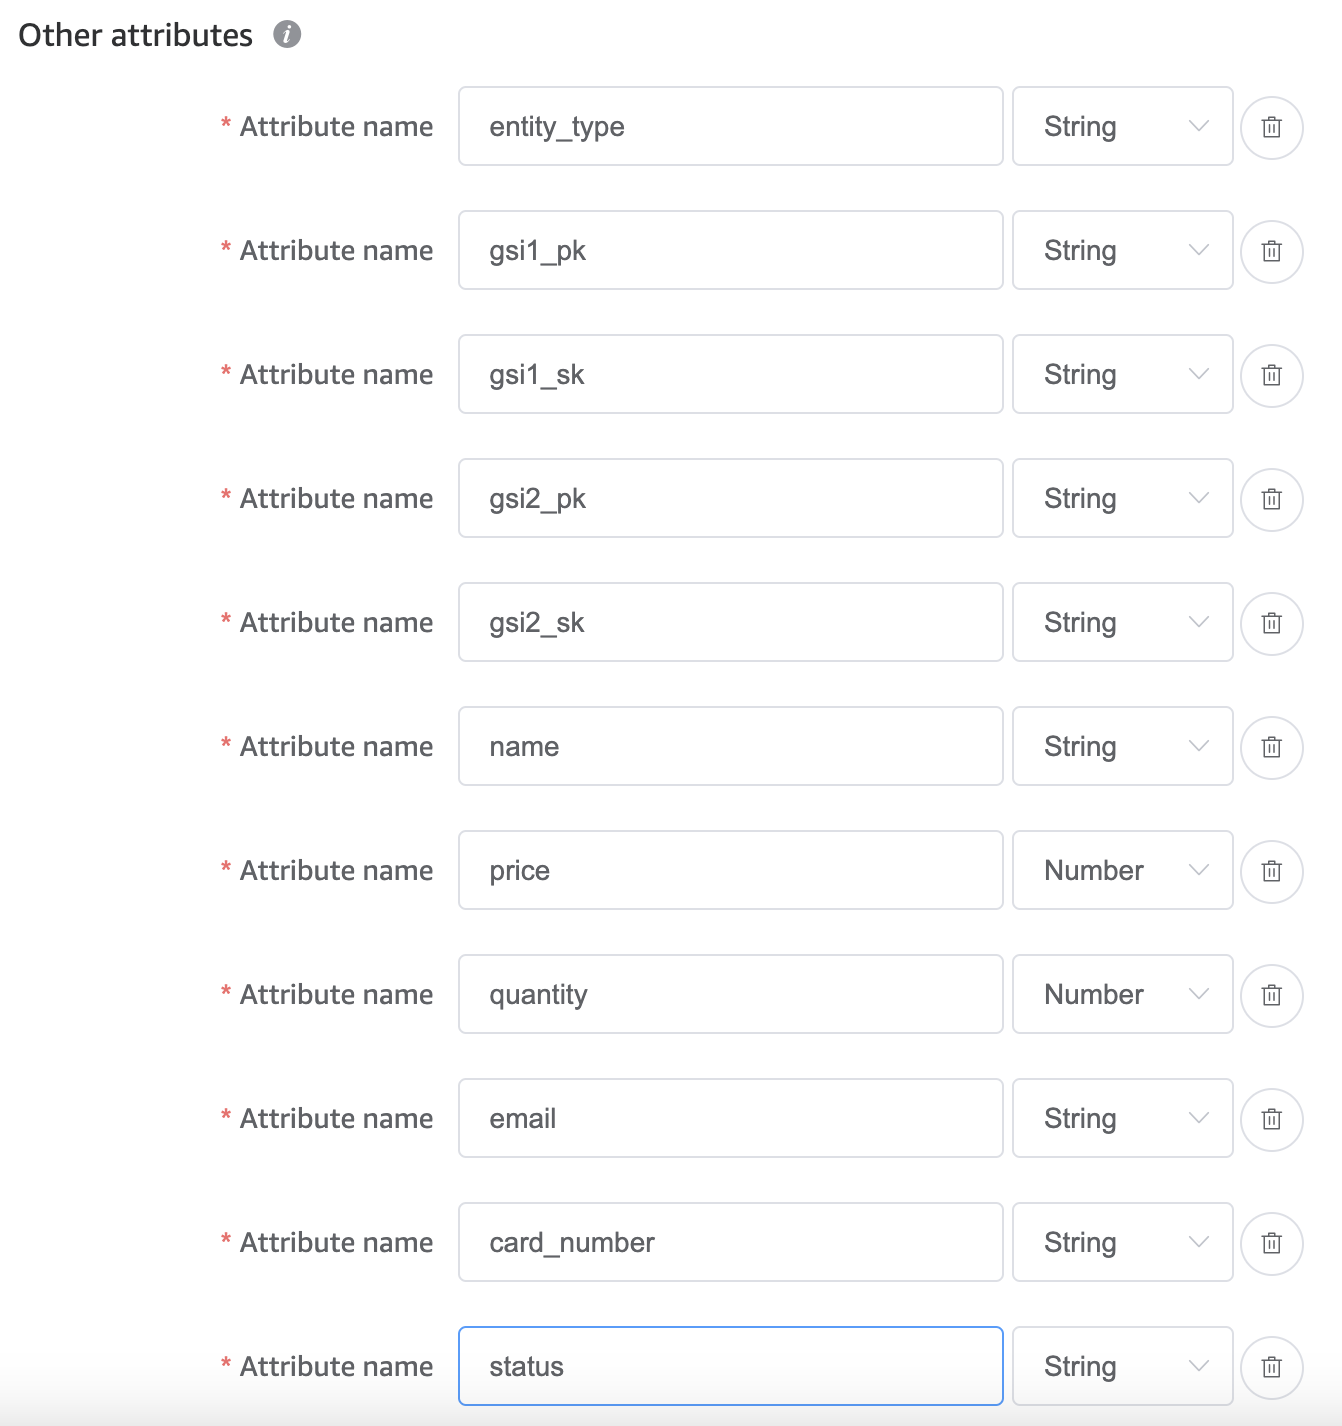
Para atributos adicionales, guardaremos el entity_type junto con dos atributos de clave primaria para GSI PK y SK.
Un GSI es un índice secundario global, es decir, una copia de tu tabla que DynamoDB mantiene sincronizada (¡de forma asíncrona!) pero almacenada con pares de claves primarias alternativos. Este es el mecanismo clave que permite a una sola tabla soportar múltiples patrones de acceso. Hablaremos más de esto después; por ahora, basta con entender que estas claves almacenarán las claves primarias de entidades relacionadas.
Los otros atributos adicionales que debemos añadir son todos los no clave de nuestros datos (ten en cuenta que este paso solo es necesario en la fase de diseño y no se definirá explícitamente al aprovisionar la tabla real):
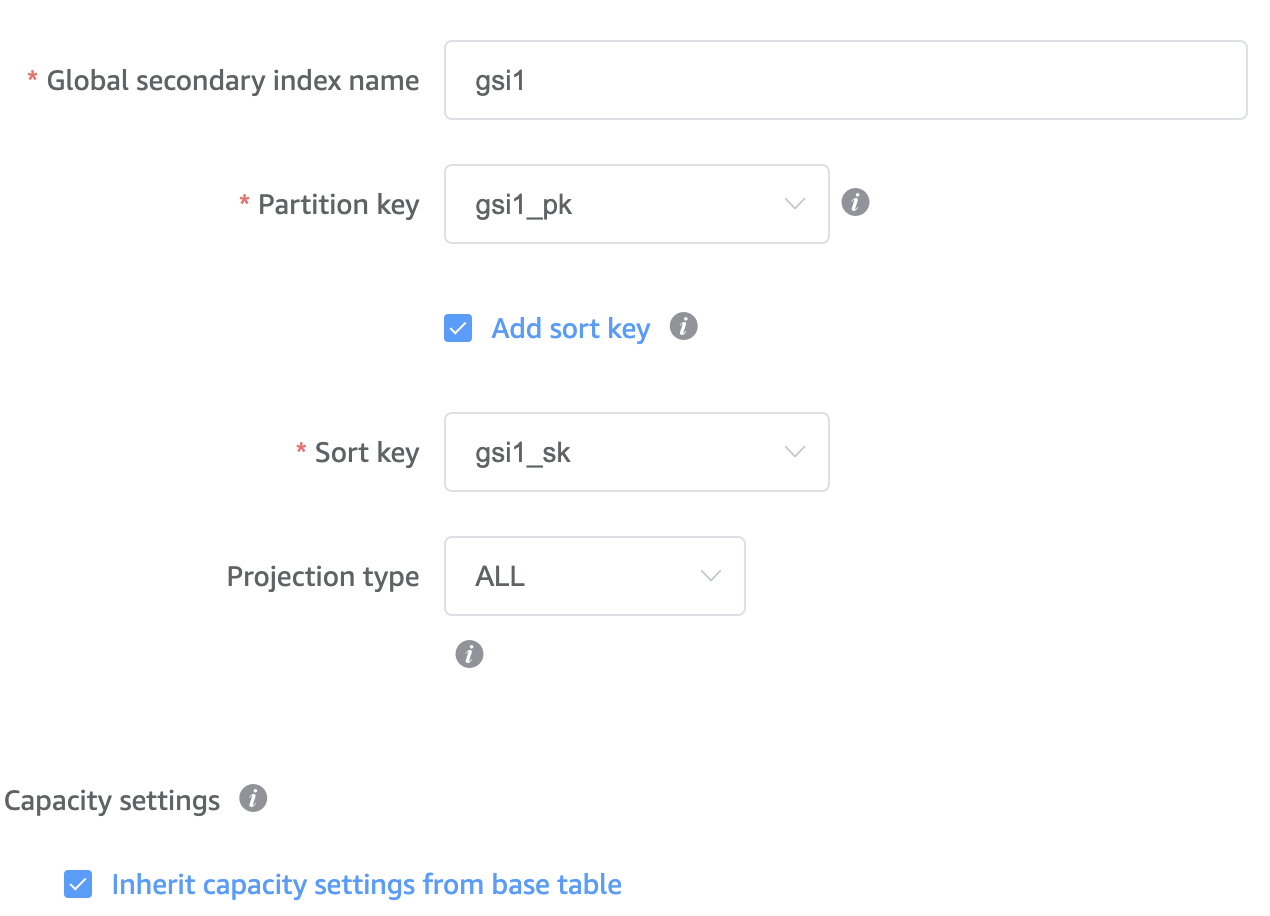
A continuación, añadimos los dos GSI usando las claves que definimos en el paso anterior:
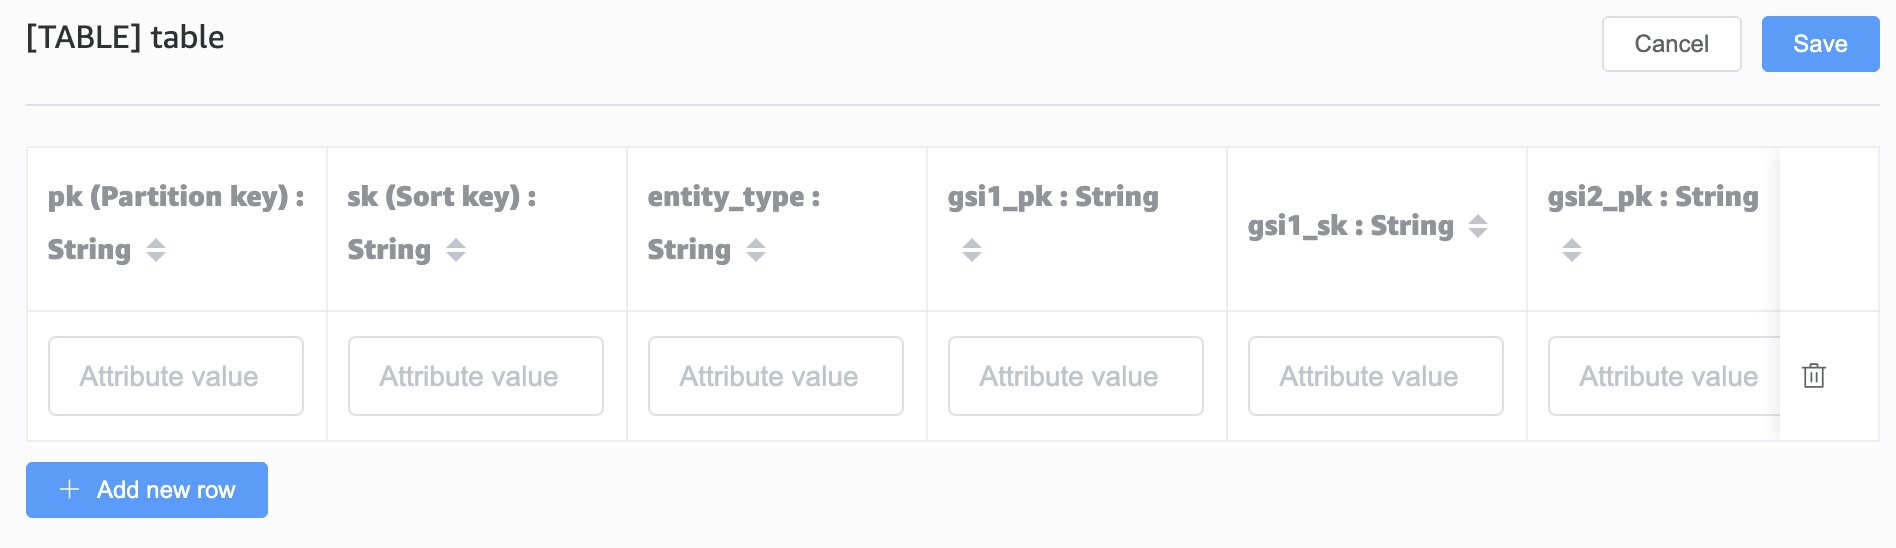
Guarda y luego haz clic en visualize the data model. Deberías ver tu tabla recién creada pero vacía. Haz clic en edit table y, en la esquina superior derecha, edit data; esto te permitirá añadir nuevas filas:
Antes de empezar a añadir datos, necesitamos definir los prefijos de clave primaria para cada entidad:
|
product |
p# |
|
category |
c# |
|
customer (user) |
u# |
|
basket |
b# |
|
basket item |
bi# |
|
order |
o# |
|
order line |
ol# |
|
payment |
py# |
|
invoice |
i# |
La mayoría de patrones de acceso giran en torno al cliente, así que en nuestro índice primario usaremos el ID de cliente como partición principal, y el propio registro de cliente se identificará con la clave de ordenación siendo también el ID de cliente.
Así podemos añadir fácilmente relaciones de clientes con pedidos y de clientes con cestas usando la misma clave de partición pero con una clave de ordenación única.
Nuestra vista agregada queda así:
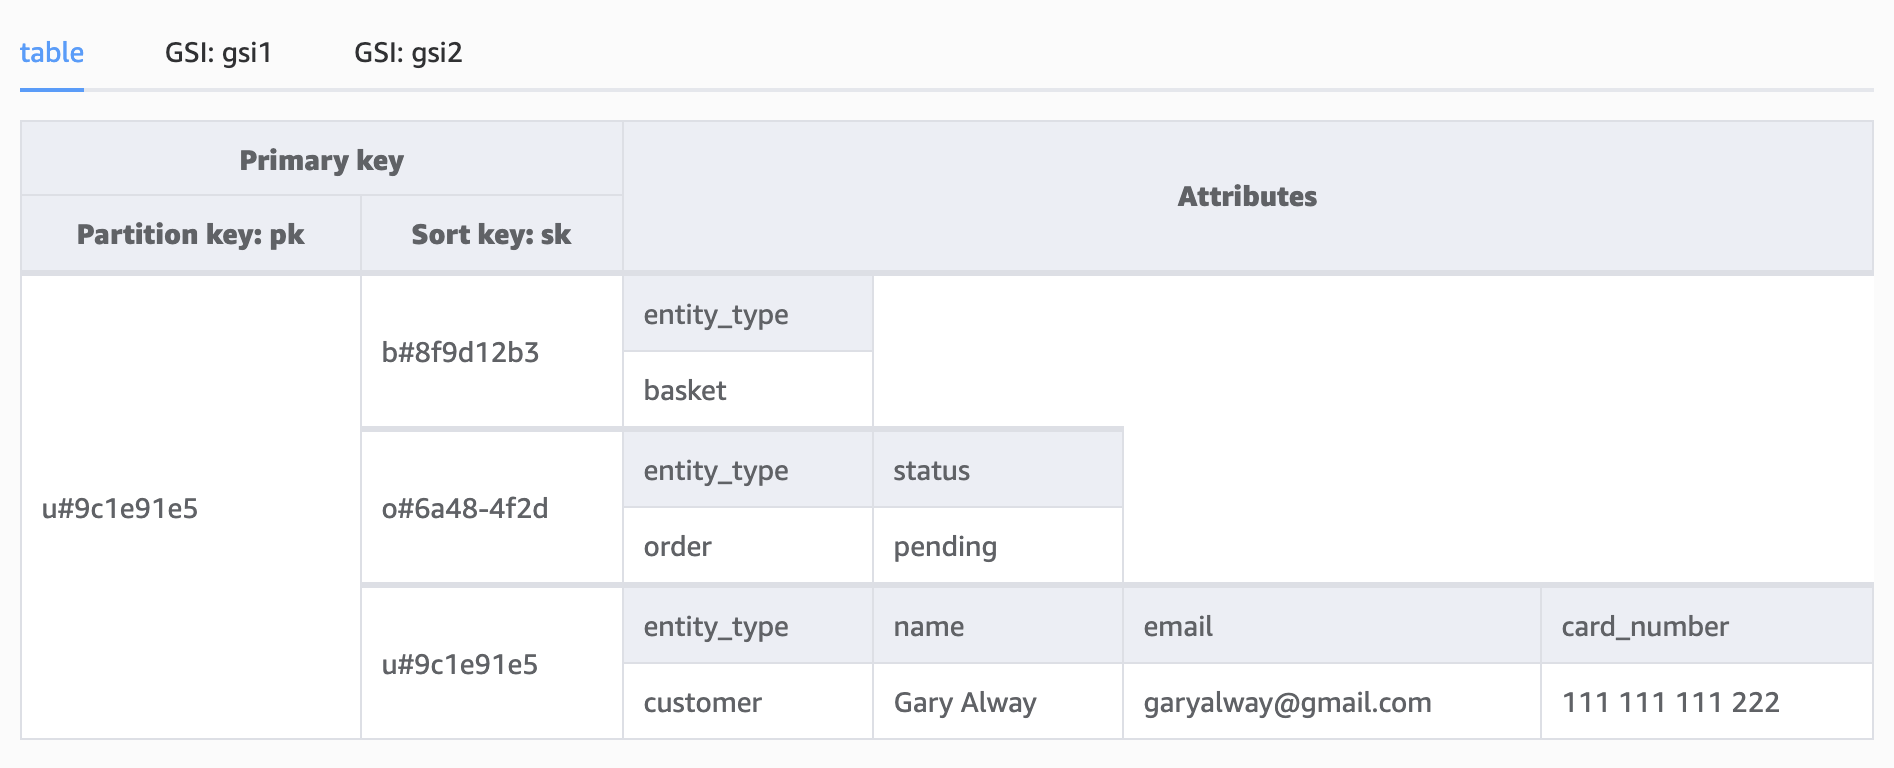
Ahora podemos consultar los tres registros en un único comando, consultando toda la partición del cliente:
export const getAllCustomerRecords = async (id: string) =>
  dynamoClient
    .query({
      TableName: TABLE_NAME,
      KeyConditionExpression: "pk=:pk",
      ExpressionAttributeValues: {
        ":pk": valueToAttributeValue(addPrefix(id, CUSTOMER_PREFIX)),
      },
    })
    .then((result) => result.Items);
A medida que la tabla crezca, este tipo de consulta quizá no sea la más eficiente, ya que devolverá todos los pedidos de ese cliente junto con otros registros como cestas y facturas, pero es útil saber que podemos acceder a todos los datos del cliente en una sola consulta si lo necesitamos.
Con un pequeño ajuste en los valores de la expresión, usando una coincidencia parcial (begins_with) sobre la clave de ordenación, podemos consultar:
La idea clave es cómo modelar relaciones uno a uno y uno a muchos en NoSQL.
Estas entidades representan otra relación uno a muchos, donde una categoría puede contener muchos productos.
Además, las categorías tienen una jerarquía: una categoría puede tener muchas subcategorías, de modo que los productos pueden existir en cualquier nivel del árbol.
Vamos a modelarlo con libros divididos en ficción y no ficción.
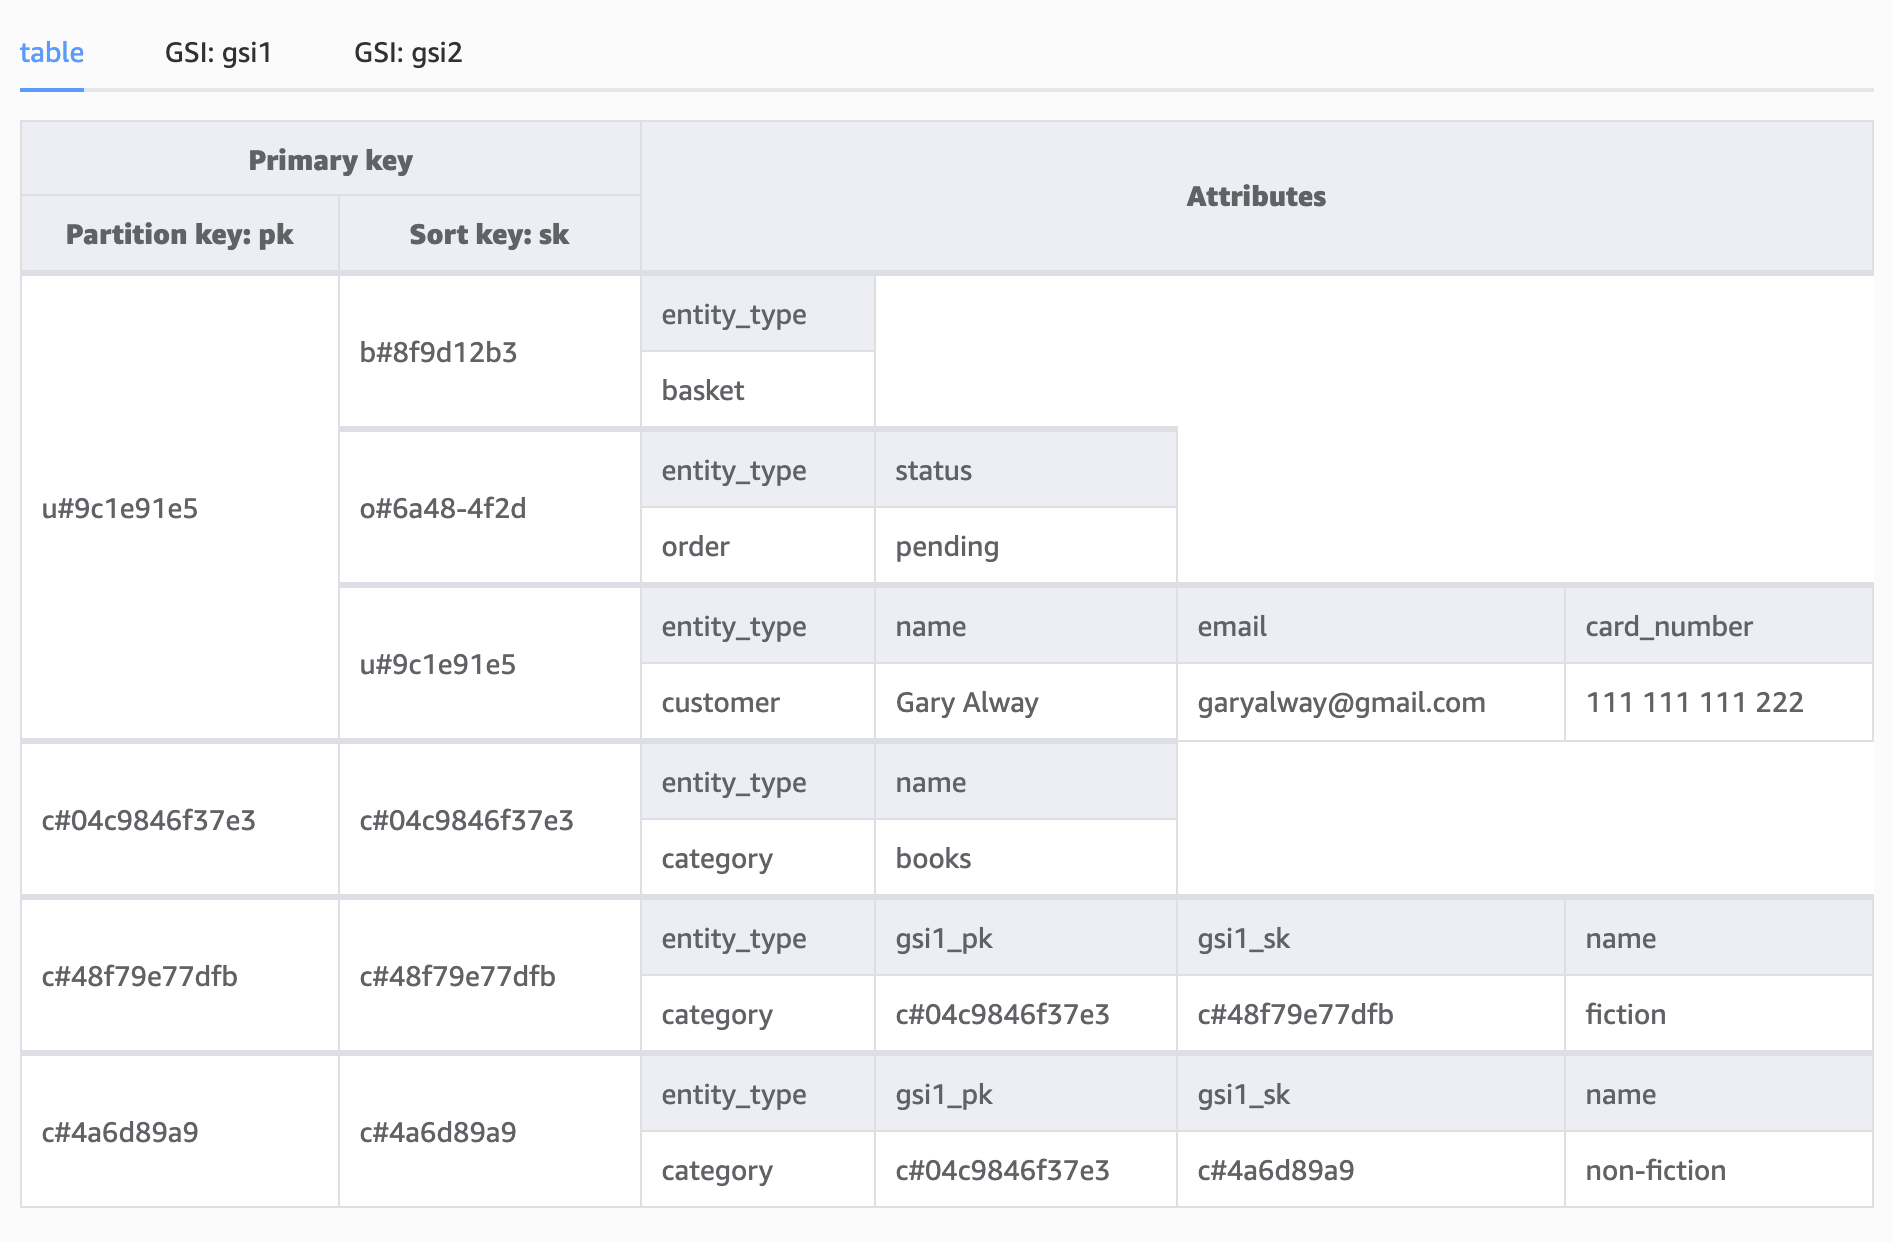
Fíjate en que hemos rellenado las claves de atributos del GSI para las subcategorías, estableciendo GSI1_PK como el ID de la categoría padre y GSI1_SK como el ID de la subcategoría. Esto nos permite consultar todas las subcategorías por categoría usando GSI1:
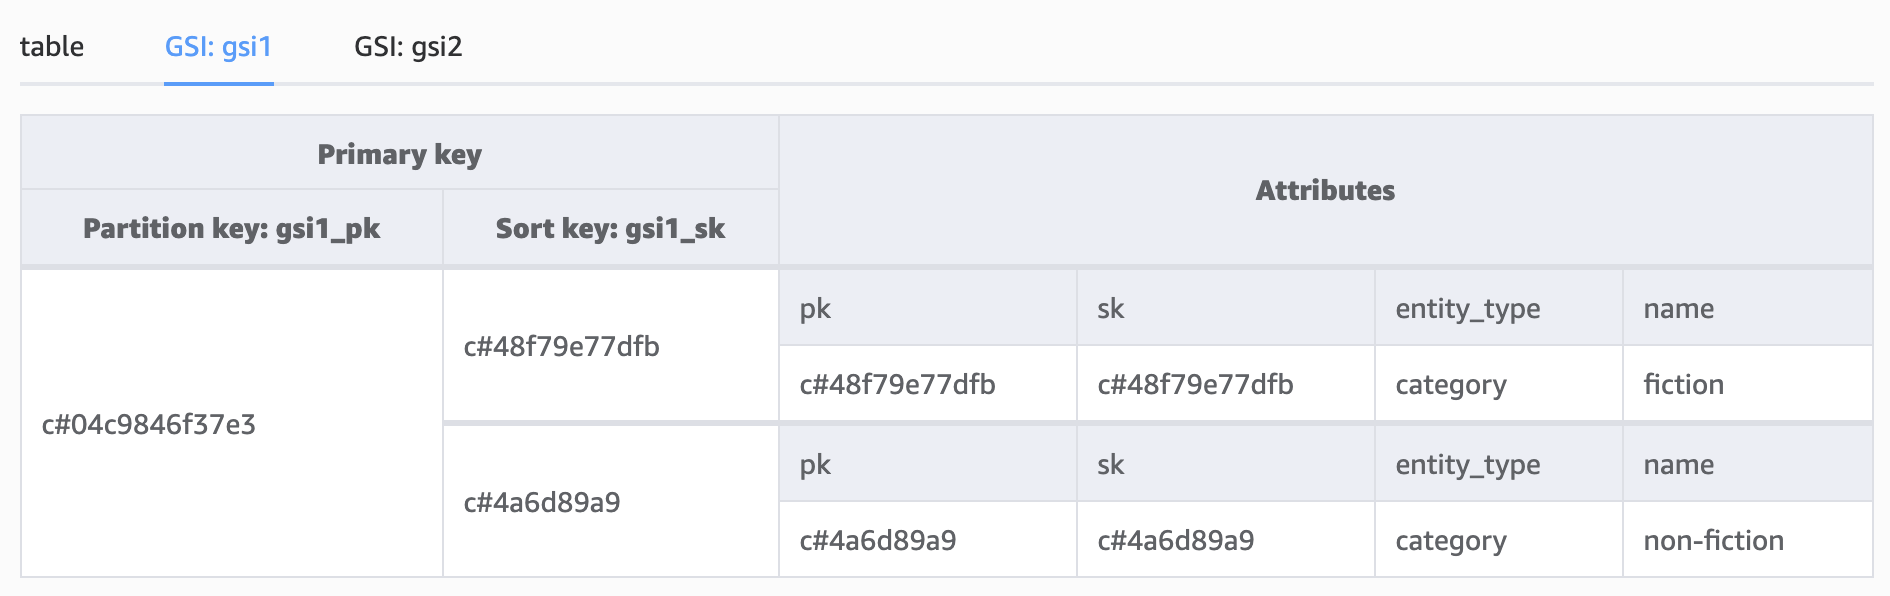
El mismo índice, GSI1, no solo sirve para mapear relaciones uno a muchos. Por ejemplo, si queremos buscar un cliente por email, el modelo actual no lo soporta directamente a menos que cambiemos ligeramente cómo guardamos los datos:
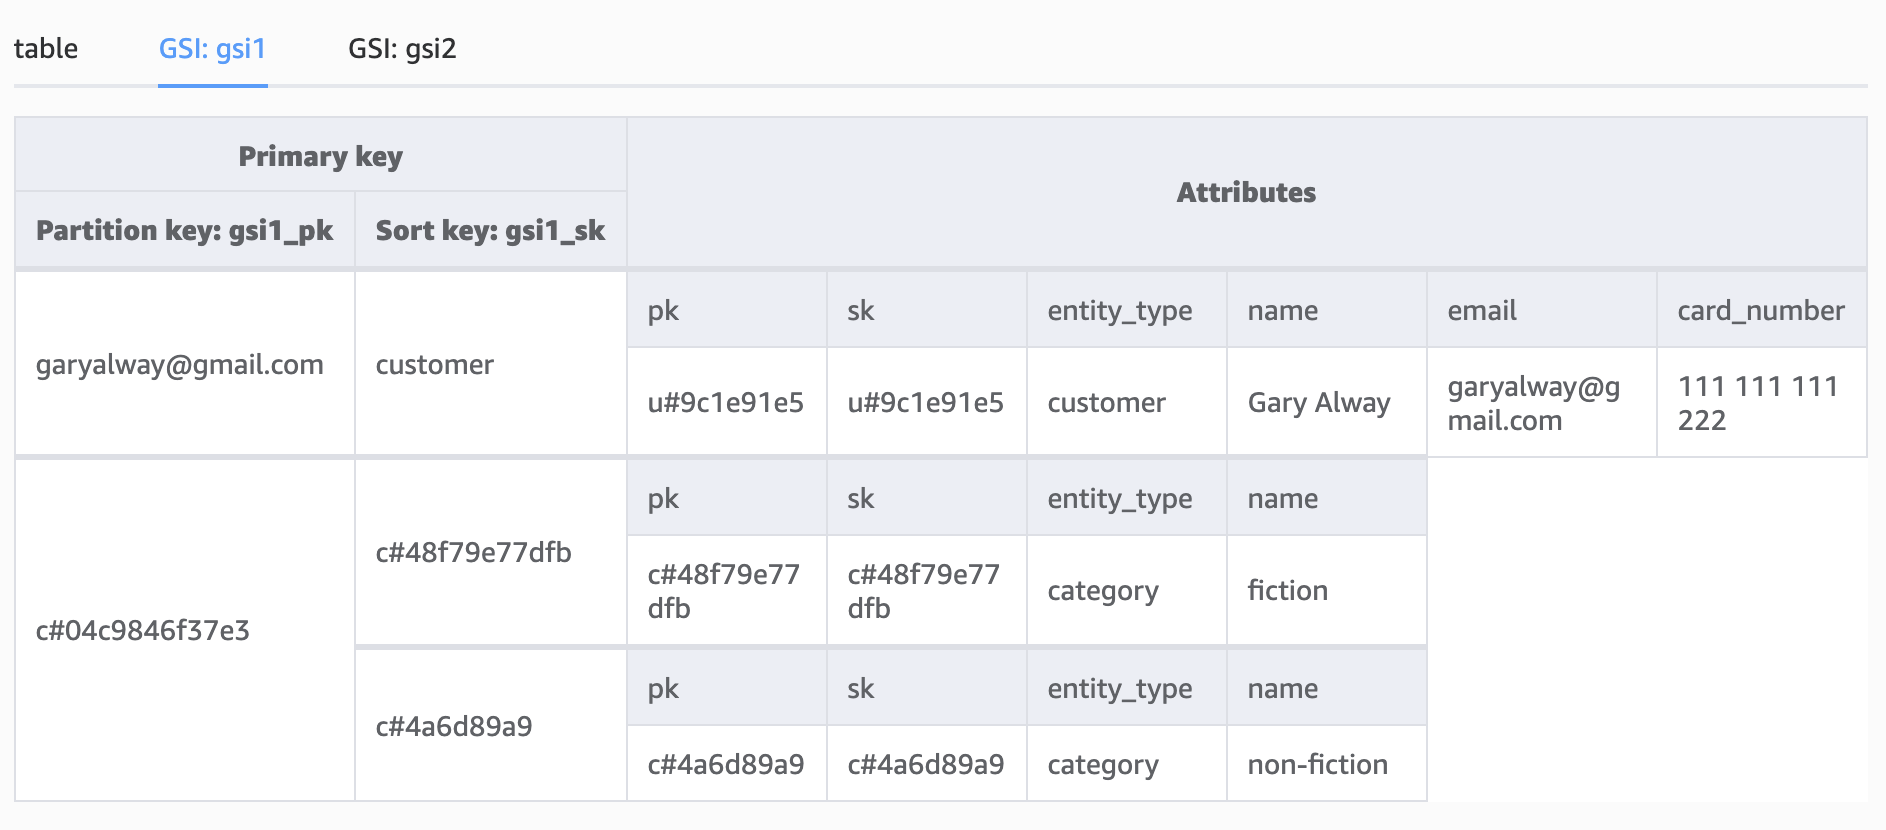
Almacenar la dirección de email del cliente y el tipo de entidad como GSI PK y SK:
Para ayudar a la distribución de datos en DynamoDB, podríamos ir un paso más y almacenar el email como un hash.
export const getCustomerByEmail = async (email: string) =>
  dynamoClient
    .query({
      TableName: TABLE_NAME,
      IndexName: "gsi1",
      KeyConditionExpression: "gsi1_pk = :email AND gsi1_sk = :entityType",
      ExpressionAttributeValues: {
        ":email": valueToAttributeValue(email),
        ":entityType": valueToAttributeValue(entityType),
      },
    })
    .then(({ Items }) => Items?.[0]);
Hasta ahora, quizá te preguntabas por qué todos los índices tenían nombres genéricos y atributos de clave llamados simplemente PK y SK. La respuesta ya debería estar clara: los datos que almacenamos y los índices que mantenemos son flexibles y capaces de soportar múltiples patrones de acceso según el tipo de entidad.
El terraform de la tabla que hemos usado hasta ahora es el siguiente:
resource "aws_dynamodb_table" "tutorial-1" {
  name = "tutorial-1"
  billing_mode = "PAY_PER_REQUEST"
  hash_key = "pk"
  range_key = "sk"


  attribute {
    name = "pk"
    type = "S"
  }


  attribute {
    name = "sk"
    type = "S"
  }


  attribute {
    name = "gsi1_pk"
    type = "S"
  }


  attribute {
    name = "gsi1_sk"
    type = "S"
  }


  attribute {
    name = "gsi2_pk"
    type = "S"
  }


  attribute {
    name = "gsi2_sk"
    type = "S"
  }


  global_secondary_index {
    name = "gsi1"
    hash_key = "gsi1_pk"
    range_key = "gsi1_sk"
    projection_type = "ALL"
  }


  global_secondary_index {
    name = "gsi2"
    hash_key = "gsi2_pk"
    range_key = "gsi2_sk"
    projection_type = "ALL"
  }
}
El almacenamiento de productos sigue el mismo patrón uno a muchos, donde la clave de partición es el ID de categoría y la clave de ordenación es el ID de producto:
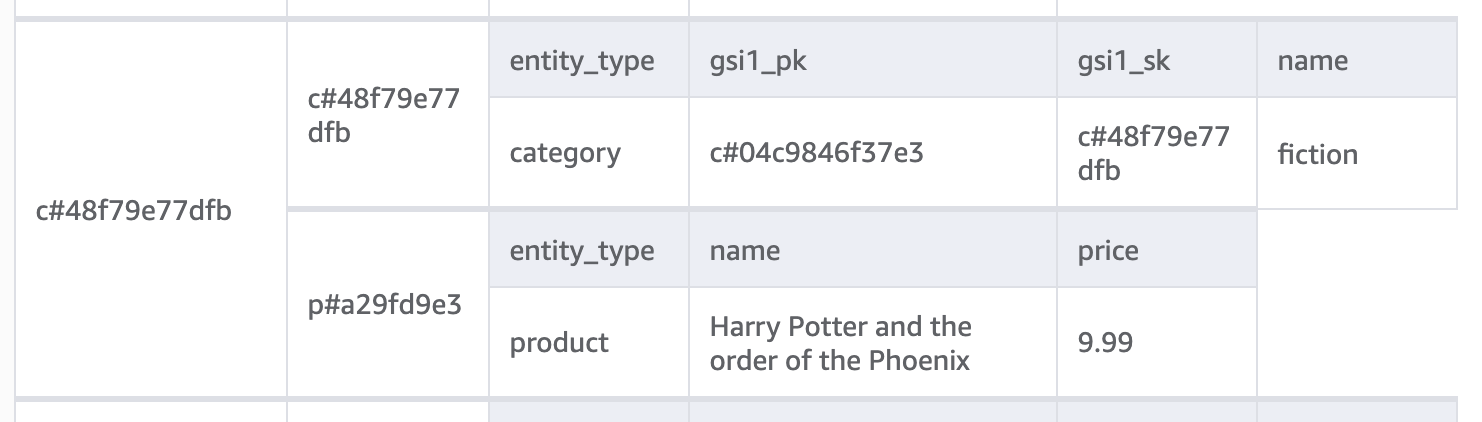
Añadir la categoría padre a GSI1 nos permite consultar todos los libros de nuestra base de datos:
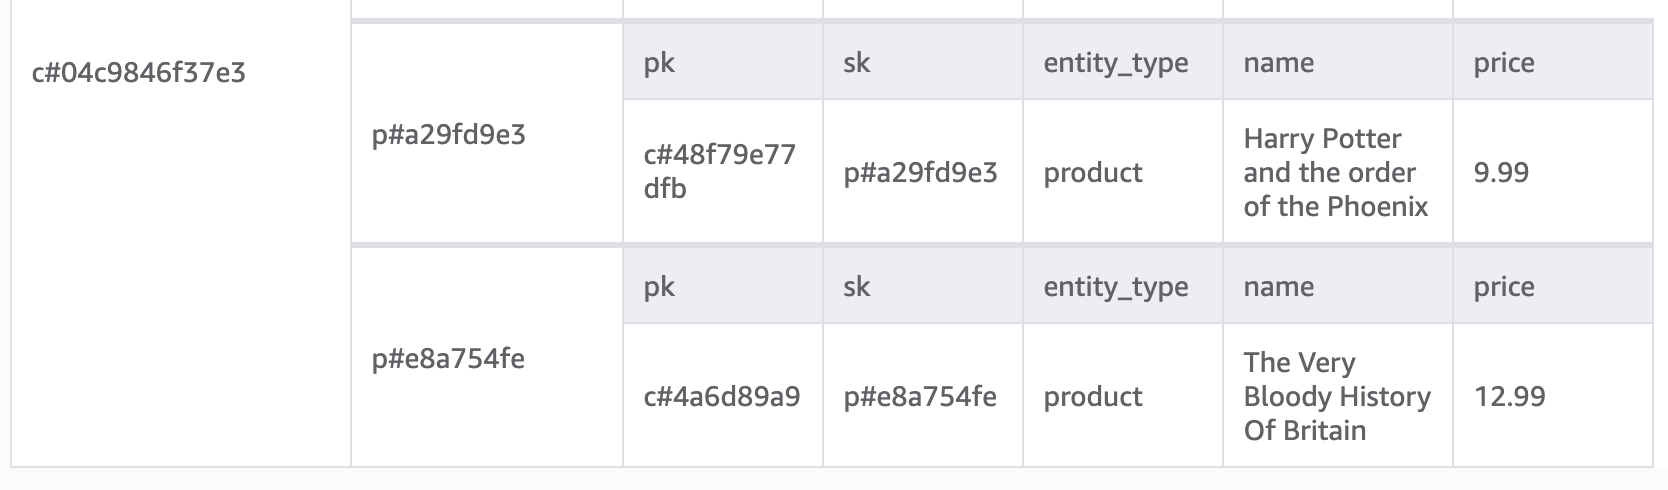
En una aplicación en producción, podemos usar DynamoDB Streams para enviar datos a un clúster de Elasticsearch y así poder buscar por título del libro. Pero, ¿cómo podríamos usar el modelo actual para consultar por título de producto?
Ya hemos usado GSI1, así que podríamos emplear GSI2 para esto:
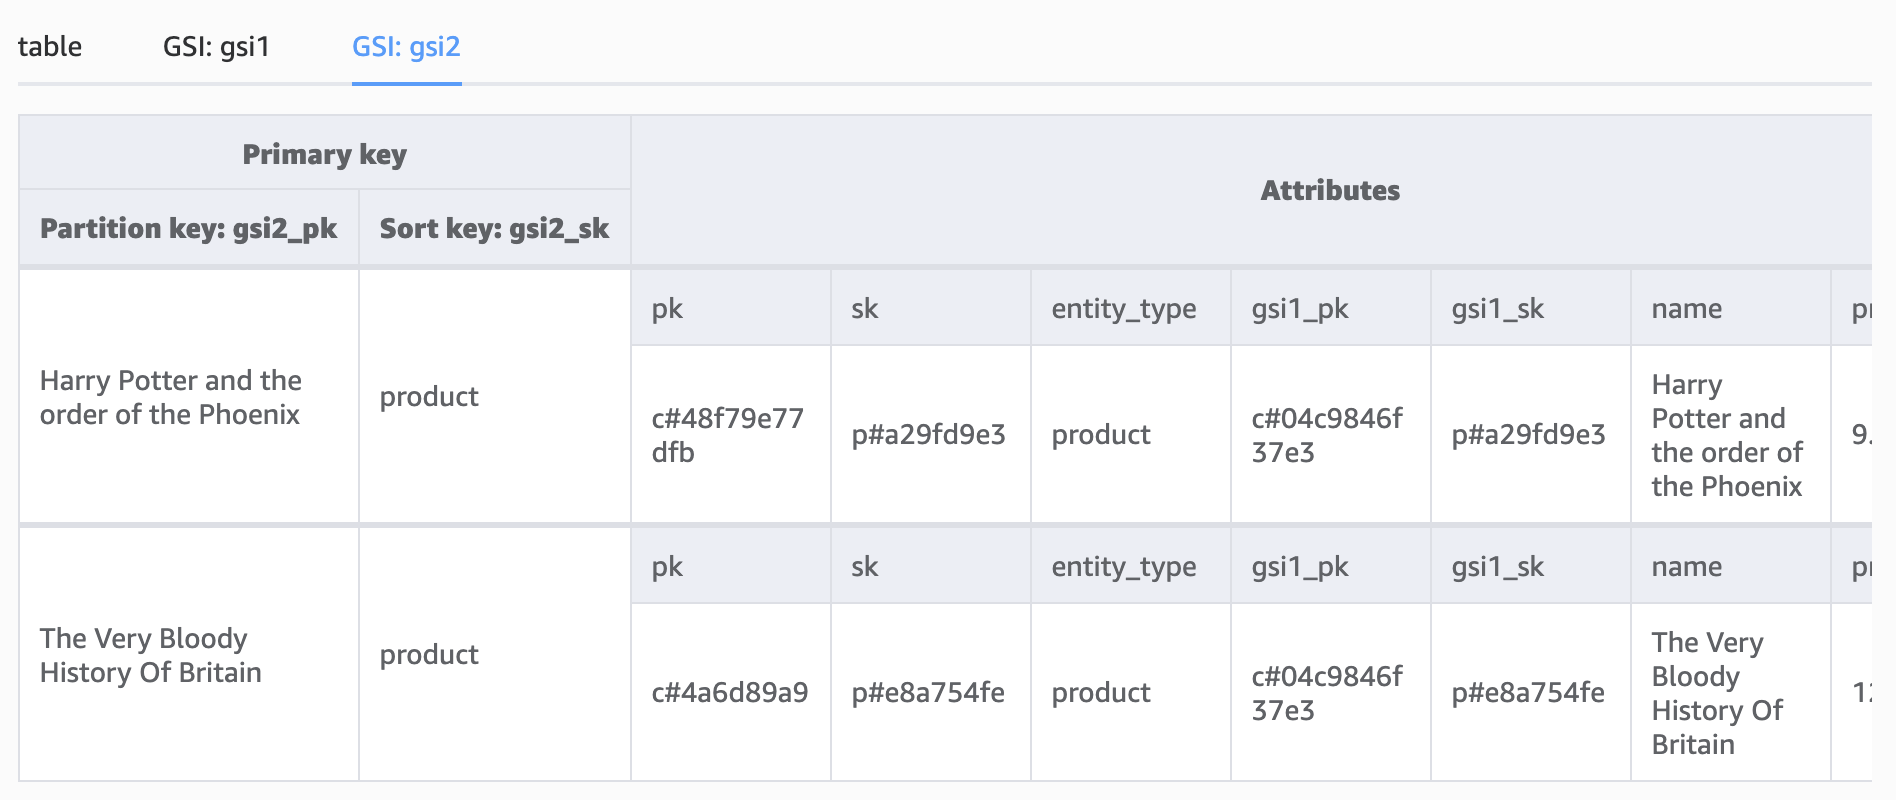
Recuerda que, al consultar DynamoDB, debes proporcionar la clave de partición exacta completa. Aunque esta implementación quizá no sea la óptima, ilustra cómo tres índices pueden usarse para distintos patrones de acceso.
En mi próximo tutorial, te mostraré cómo resolver esto integrándolo con un índice de búsqueda.
Tanto los artículos de la cesta como las líneas de pedido se almacenan en la partición del cliente; podemos usar los GSI para consultar todos los productos de una cesta, todos los productos de un pedido y todos los productos que un cliente ha comprado alguna vez.
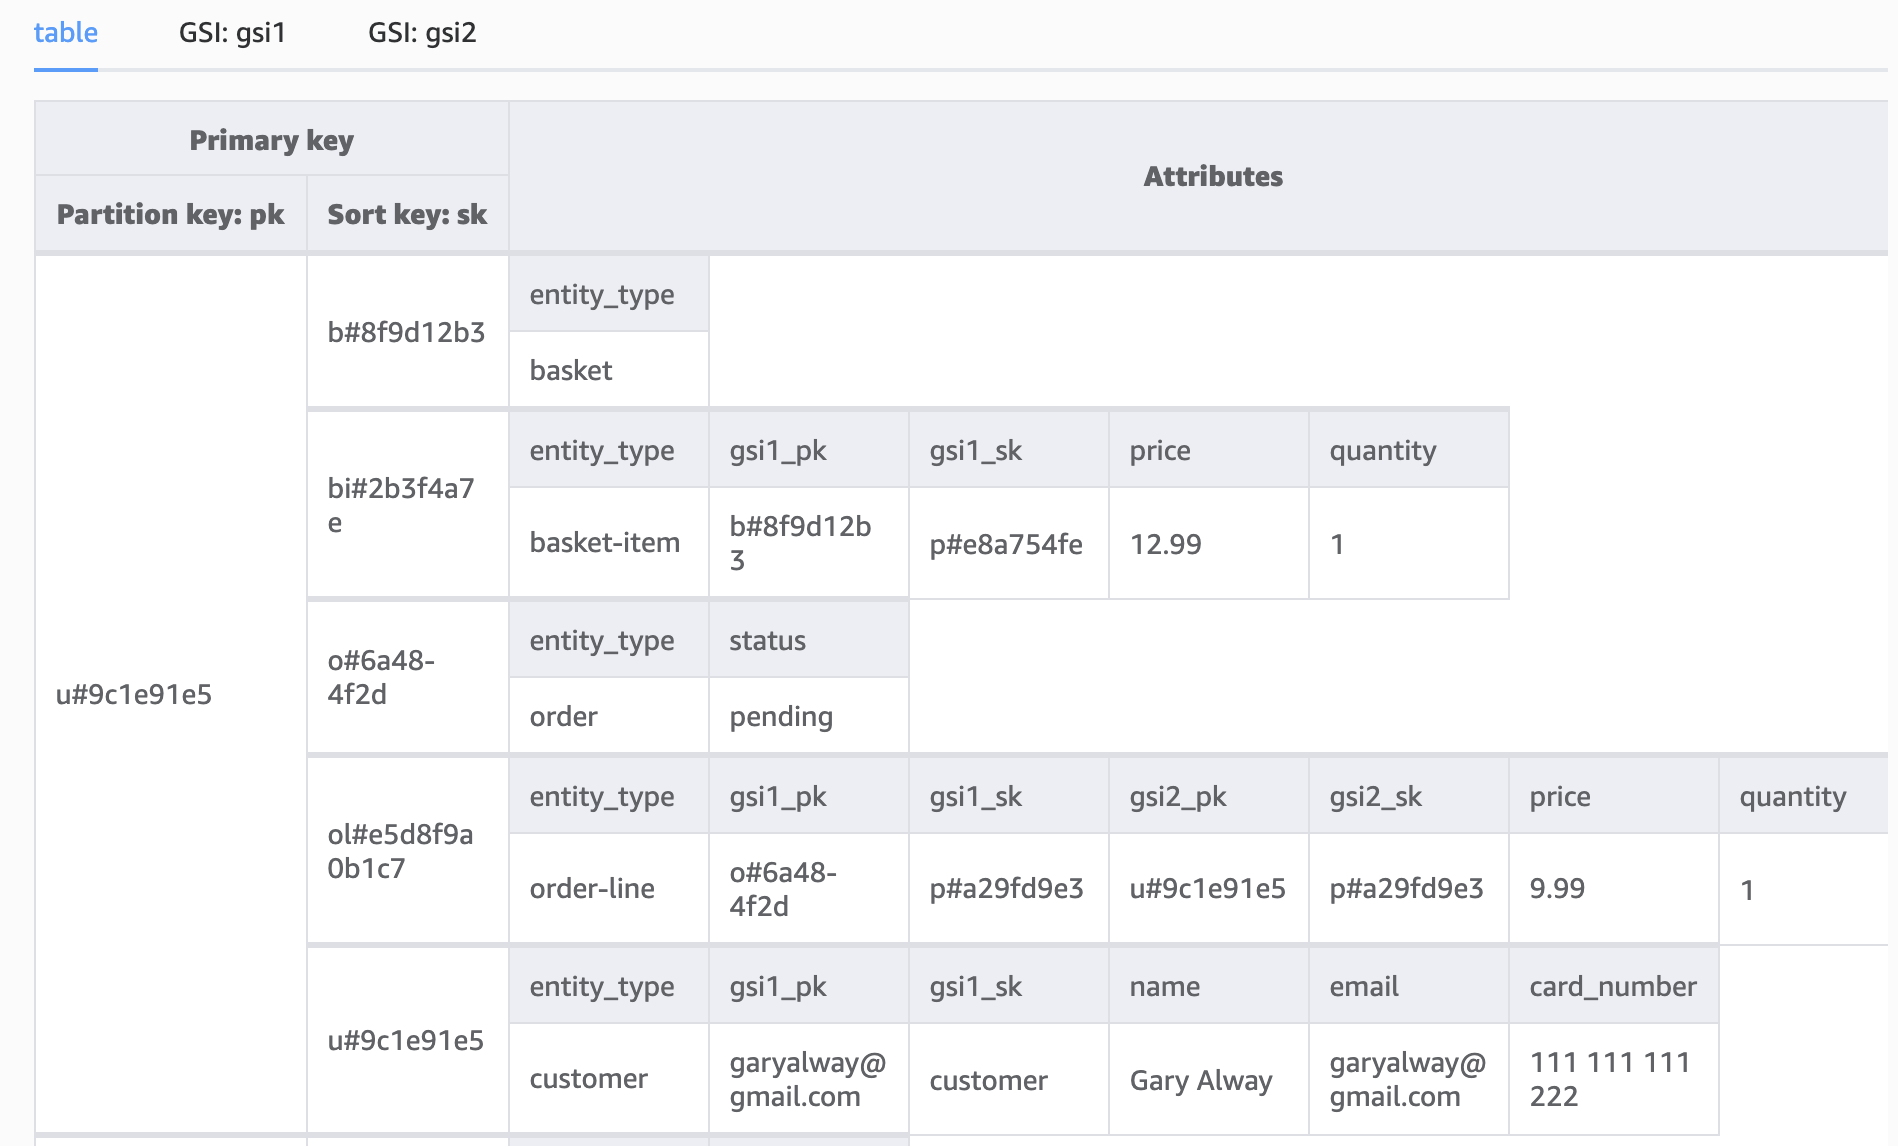
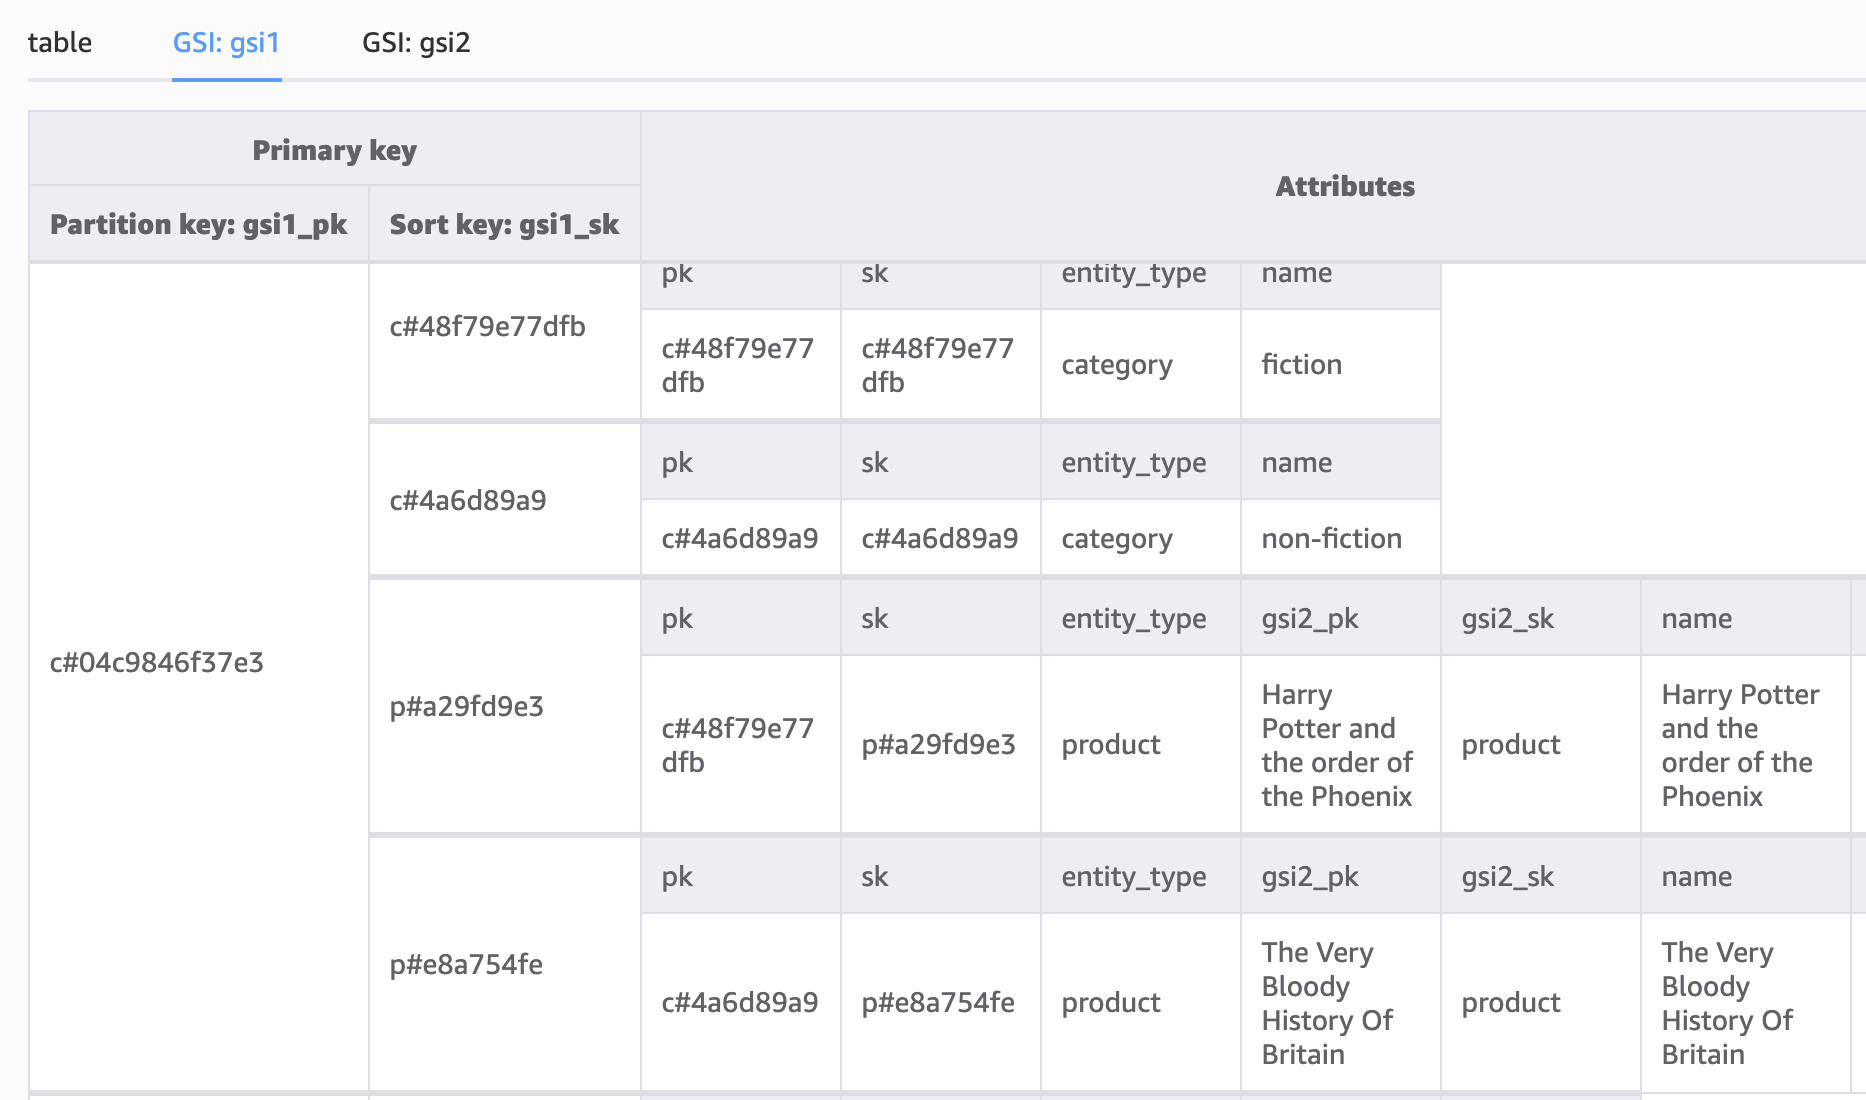
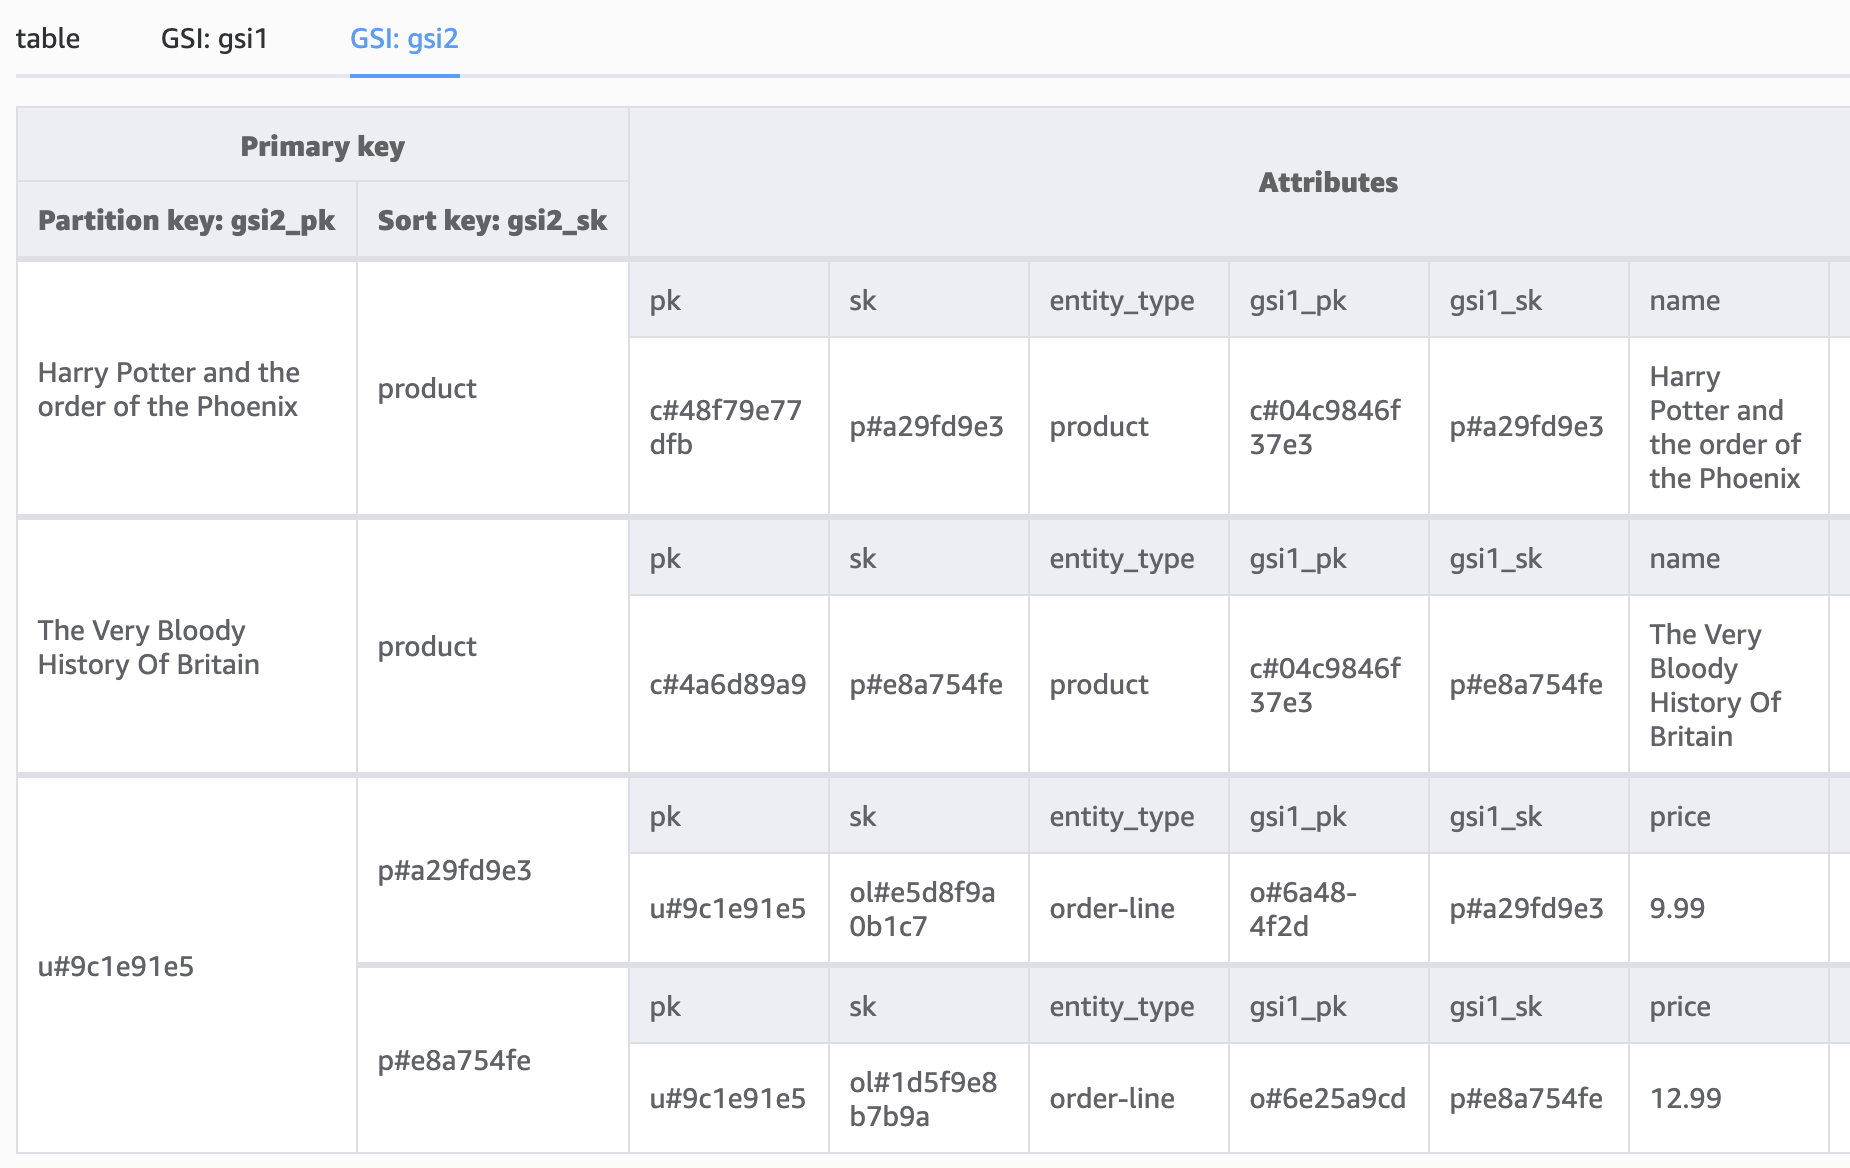
Este último ejemplo muestra el historial de pedidos de un cliente con dos productos realizados en dos pedidos distintos.
Si te interesa cómo funciona el modelado de datos en bases relacionales, nuestro webinar de Data Modeling in SQL ofrece información valiosa que complementa el modelado de datos en NoSQL.
Usar un diseño de tabla única con DynamoDB aporta muchas ventajas, pero también presenta varios retos y consideraciones:
Gestionar todos tus datos en una sola tabla puede volverse complejo, especialmente a medida que tu aplicación crece y evoluciona.
Debes planificar y estructurar los datos con cuidado para dar cabida a diversos patrones de consulta. Además, la eficacia del diseño de tabla única está muy ligada a la lógica de tu aplicación; es clave para garantizar un acceso fluido y consultas eficientes.
Una buena reflexión sobre la estructura de datos y la lógica de aplicación es esencial para que un diseño de tabla única funcione bien.
Aunque DynamoDB permite Índices Secundarios Globales para soportar distintos patrones de consulta, debes aprovisionarlos y mantenerlos, lo que puede aumentar costes y complejidad.
Elegir bien la clave de partición es fundamental para una distribución uniforme de datos y un buen rendimiento en las consultas. Una clave inadecuada puede generar particiones calientes y cuellos de botella.
A medida que aumenta el volumen de datos, tu tabla única puede crecer considerablemente. Esto puede afectar tanto al coste de almacenamiento como al de lectura y escritura.
DynamoDB no ofrece búsqueda de texto completo de forma nativa, por lo que para implementarla hay que integrarse con otros servicios como Elasticsearch.
Modificar el esquema de tu tabla puede ser complicado, especialmente en sistemas en producción. Puede que necesites migrar datos existentes o ajustar la lógica de tu aplicación para acomodar los cambios.
Según el tipo de consistencia de lectura que elijas (fuerte o eventual), tendrás que gestionar posibles retos de consistencia, recordando que los GSI se replican de forma asíncrona.
Las capacidades de consulta de DynamoDB son potentes, pero no tan flexibles como las de SQL.
Para aprender a diseñar bases de datos de forma eficaz y sortear estos retos, echa un vistazo a nuestro curso de Database Design.
Al trabajar con una base NoSQL, es clave salir del terreno conocido de los patrones relacionales: toca desaprender para volver a aprender.
Optar por el patrón de tabla única te ofrece una base de datos con escalabilidad global, preparada para grandes volúmenes de tráfico con un rendimiento fiable y predecible.
Sin embargo, esta ventaja de rendimiento no sale gratis: exige una planificación meticulosa y una implementación cuidadosa de la estructura de la base de datos y de la lógica de la aplicación desde el principio.
Refuerza lo aprendido con nuestro curso de NoSQL concepts.
¡Empieza hoy tu camino en datos!
Curso
Curso
Curso
blog
Mike Shakhomirov
11 min
blog
Moez Ali
14 min
blog
Javier Canales Luna
12 min
Tutorial
DataCamp Team
3 min
Tutorial
Joleen Bothma
9 min
Tutorial
Tim Lu
15 min