Kurs
NoSQL-Konzepte
2 Std.
19K
Willkommen in der Welt von DynamoDB, wo Effizienz und nahezu grenzenlose Skalierbarkeit in einer einzigen Tabelle zusammenfinden. In diesem umfassenden Tutorial begeben wir uns auf eine Reise, die dir das wahre Potenzial des NoSQL-Single-Table-Designs zeigt.
Entdecke, wie du komplexe Datenmodelle vereinfachst und gleichzeitig die volle Power einer einheitlichen Struktur nutzt, die deine wachsenden Anforderungen mühelos auffängt.
Egal, ob du als erfahrene(r) Entwickler(in) mit NoSQL vertraut bist oder erst in die Datenbankwelt einsteigst: Mach dich bereit, die Skalierbarkeit deiner Anwendungen mit einer starken Datenarchitektur auf das nächste Level zu heben!
Bevor wir starten, ist es wichtig, den Unterschied zwischen NoSQL und relationalen Datenbanken zu verstehen, in welchen Szenarien welche Technologie Sinn ergibt und warum sie überhaupt entwickelt wurden. Dazu hilft ein kurzer Blick in die Geschichte der Datenverarbeitung.
Mehr zur Bedeutung von NoSQL-Datenbanken in der Data Science findest du in einem separaten Blogpost.
Die relationale Datenbank ist eine etablierte, weit verbreitete Technologie, die es seit den 1970er-Jahren gibt. Zwei zentrale Probleme, die sie löst, sind Speicherung und referenzielle Integrität.
Die Daten werden „normalisiert“, typischerweise bis zur 3. Normalform. Das verringert den Speicherbedarf und stellt sicher, dass Aktualisierungen konsistent bleiben.
Historisch war die Größe des persistierten Datenbestands kritisch, weil Festplatten die teuerste Komponente im Rechenzentrum waren. Heute gilt das nicht mehr: CPUs sind teurer, Speicher ist deutlich günstiger geworden. Das macht relationale Datenbanken nicht obsolet; sie sind weiterhin sinnvoll für:
Druck auf die Datenverarbeitung beschreibt die Fähigkeit eines Systems, eine bestimmte Datenmenge zu vertretbaren Kosten und/oder in vertretbarer Zeit zu verarbeiten.
NoSQL-Datenbanken wurden Ende der 1990er-Jahre entwickelt, um die durch stetig wachsende Datenmengen verursachten Performance-Probleme relationaler Datenbanken zu adressieren.
Die CPU einer relationalen Datenbank wird schnell zum Engpass: Der Server muss normalisierte Daten abrufen und zu den denormalisierten Sichten zusammenfügen, die Anwendungen typischerweise benötigen.
Lesereplikate können helfen, doch NoSQL geht anders vor: Anwendungsdaten werden denormalisiert gespeichert und sind sofort konsumierbar. Das vergrößert zwar den Datenfußabdruck gegenüber relationalen Systemen, entlastet aber die CPU. Der Datenbankserver fungiert im Kern als Router, der per Hash-Algorithmus auf Speicherorte auf Festplatten zeigt. Typische Einsatzgebiete von NoSQL sind:
Zahlreiche Studien liefern genug objektive Daten, um die Performance von SQL vs. NoSQL in großem Maßstab zu veranschaulichen.
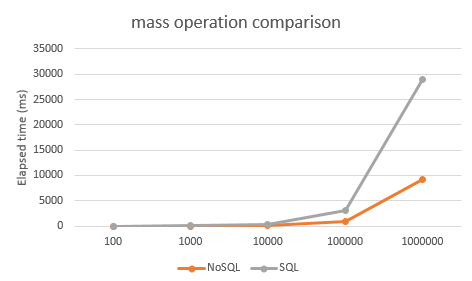
Wichtig: Die in einer NoSQL-Datenbank gespeicherten Daten sind weiterhin relationale Daten. Wären sie es nicht, würden wir sie schlicht in einem Filestore ablegen.
Wir modellieren NoSQL nicht wie relationale Datenbanken. Ein normalisiertes Design 1:1 in NoSQL mit mehreren verknüpften Tabellen zu übertragen, ist ein Anti-Pattern: NoSQL kennt weder Join-Operatoren noch referenzielle Integrität.
Eine Tabelle in NoSQL entspricht eher einem Katalog in einer relationalen Datenbank. Modelle die Daten stattdessen denormalisiert und anwendungsnah.
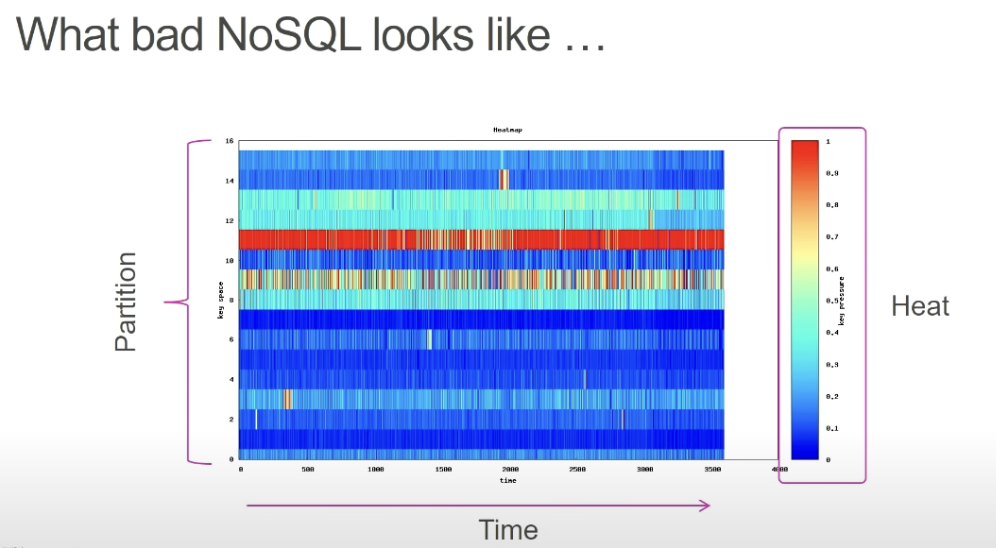
Ein weiteres Anti-Pattern sind „Hot Keys“: Wenn der Großteil der Anfragen auf einem einzigen Speicherknoten landet, ist der Keyspace falsch entworfen.
Die Zugriff-Heatmap sieht dann etwa so aus:
AWS DynamoDB ist ein vollständig verwalteter, serverloser Wide-Column-Key-Value-Store. Das heißt: Eine Tabelle kann viele Items (Zeilen) enthalten, deren Attribute sich unterscheiden dürfen. Unterstützte Datentypen sind:
Wie erwähnt, eignet sich NoSQL, wenn Zugriffsmuster gut bekannt sind und viele Transaktionen pro Sekunde (TPS) unterstützt werden müssen. DynamoDB skaliert auf jede Last und liefert vorhersagbar schnelle, konsistente Antworten von bis zu 4 Mio. TPS bei geringer Latenz (10–20 ms).
Jedes Item (Zeile) besitzt einen Partitionsschlüssel, der es eindeutig identifiziert und die Datenverteilung im zugrunde liegenden Speicher bestimmt.
Optional gibt es einen Sortierschlüssel, der die Reihenfolge der Speicherung innerhalb einer Partition festlegt. Sortierschlüssel erlauben komplexe Range- und Filterabfragen auf Partitionen (Filter werden allerdings auf Client-, nicht auf Datenbankebene angewendet).
Aus dem Partitionsschlüssel wird ein Hash-Index erzeugt. Jedes Item wird anhand dieses Hashes über einen virtuellen Keyspace verteilt. Dieser wird in Segmente geteilt, die auf physische Speichermedien abgebildet sind und sich dynamisch mit der Datenmenge vergrößern oder verkleinern.
Daher ist DynamoDB in jedem Maßstab schnell und konsistent: Die Engine routet gehashte Keys zu physischen Speicherorten.
In diesem Tutorial modellieren wir einen Onlineshop namens Daintree.com.
(Fun fact: Der Daintree-Regenwald in Queensland, Australien, gilt mit rund 180 Millionen Jahren als einer der ältesten Regenwälder der Erde!)
Zunächst erstellen wir ein stark vereinfachtes Entity-Relationship-Diagramm (ERD), um das Zielmodell zu visualisieren.
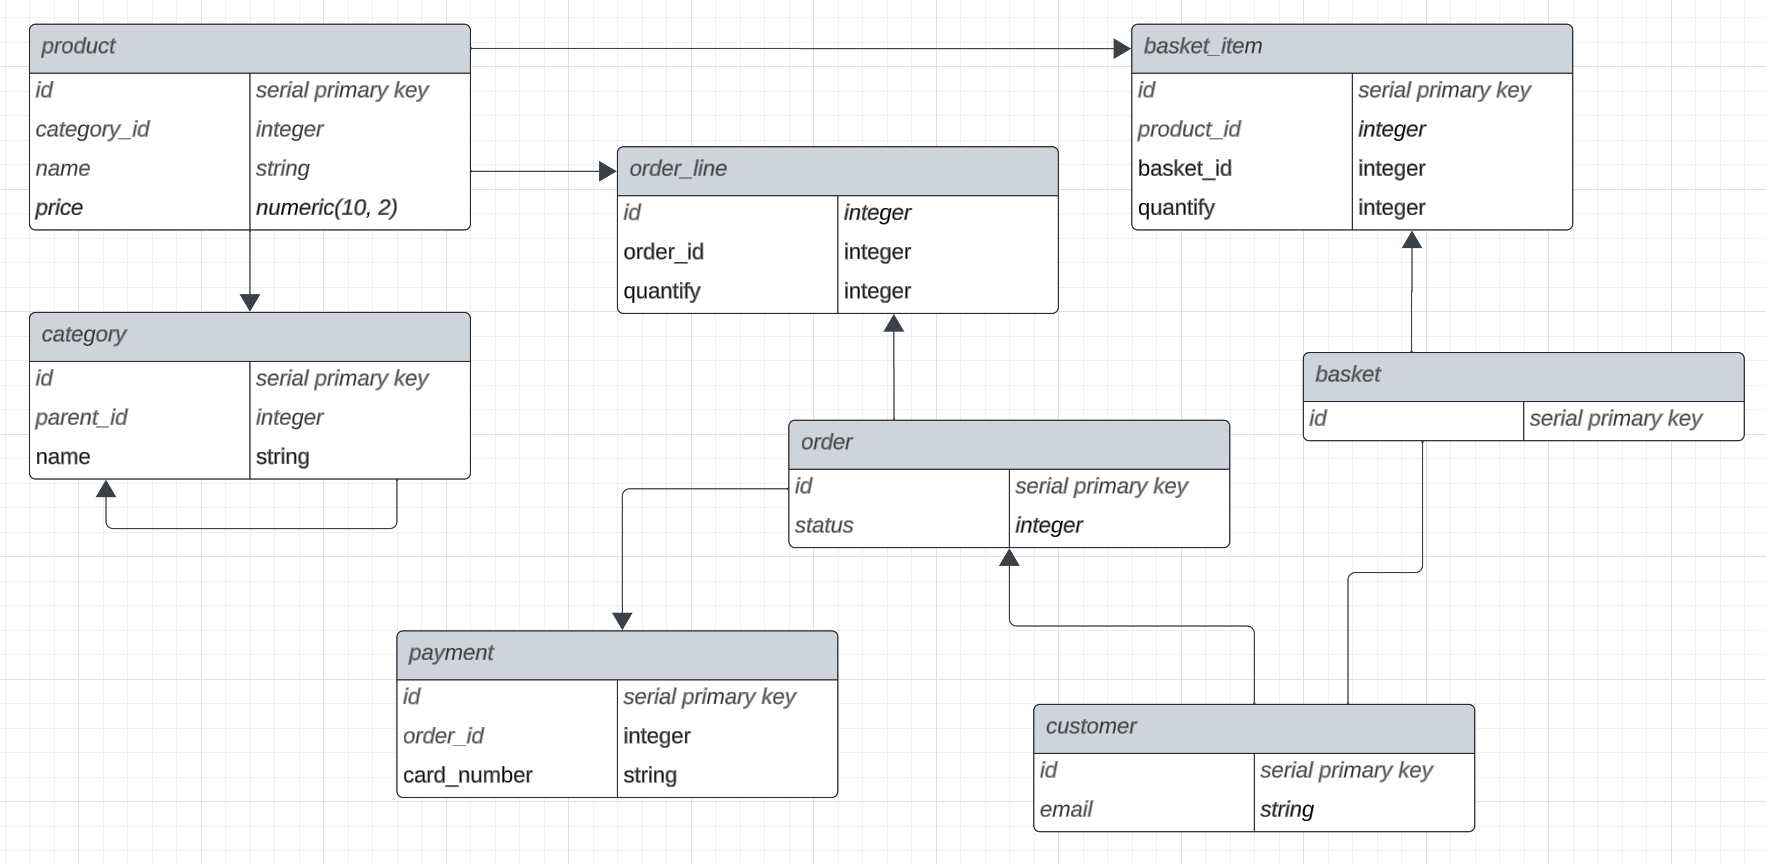
Daraus folgt: Ein Kunde kann einen Warenkorb anlegen und mehrere Produkte in variablen Mengen hinzufügen.
Ein Produkt gehört zu einer Kategorie, die wiederum über Oberkategorien verfügen kann.
Warenkörbe können zu Bestellungen werden, die sich auf mehrere Zahlungen aufteilen lassen.
Das ist eine stark vereinfachte Sicht auf Beziehungen und Attribute eines Onlineshops, genügt aber für unser Tutorial.
Bei relationalen Datenbanken müssen wir diesen Schritt kaum bedenken: SQL ist äußerst mächtig und erlaubt bei sauberem Schema fast jede Abfrage und Manipulation. Beim Single-Table-Design in NoSQL gilt das nicht, denn wir müssen Daten denormalisiert und anwendungsnah speichern.
Mögliche Zugriffsmuster für unseren Shop sind:
NoSQL Workbench ist ein kostenloses AWS-Tool, um NoSQL-Tabellen für DynamoDB zu modellieren.
Wechsle in den Data Modeler und erstelle ein neues Datenmodell mit einer neuen Tabelle:
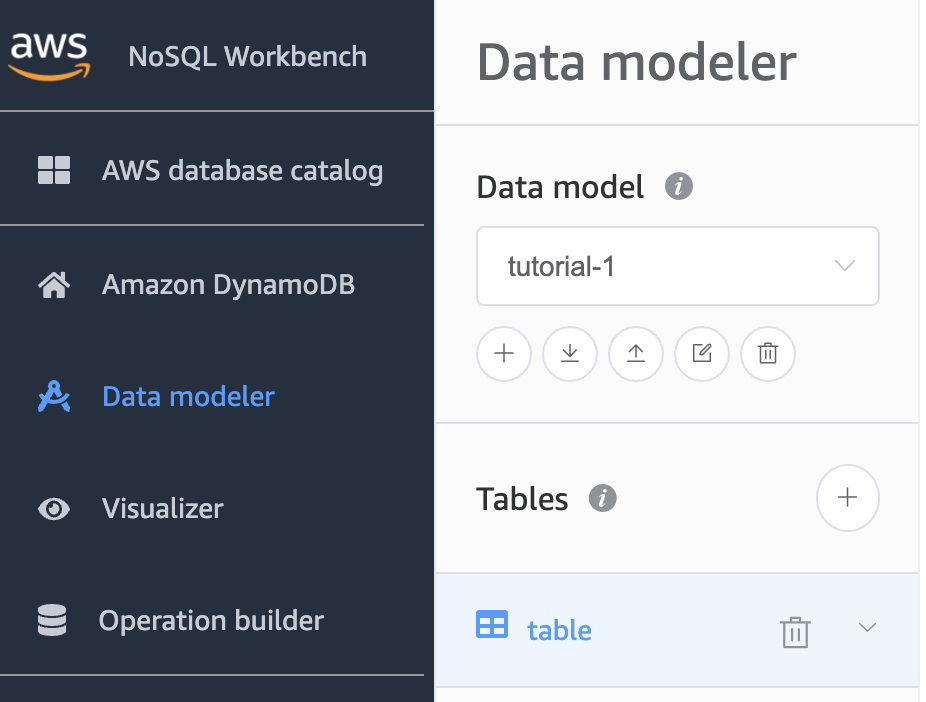
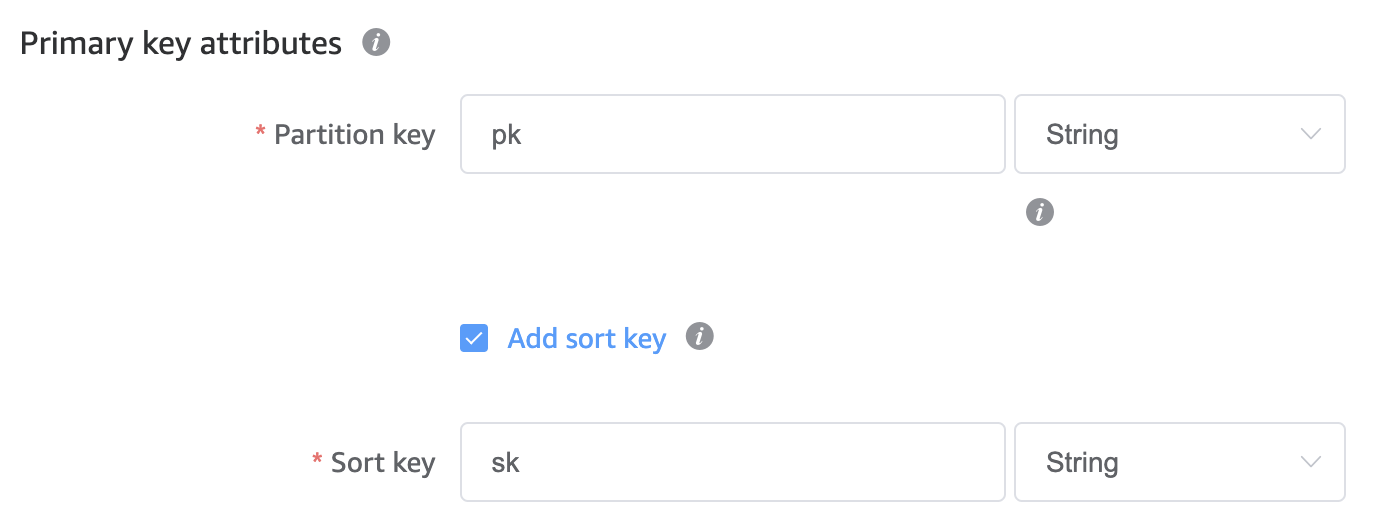
Wir behalten generische Strings für die Primärschlüsselattribute bei: PK und SK:
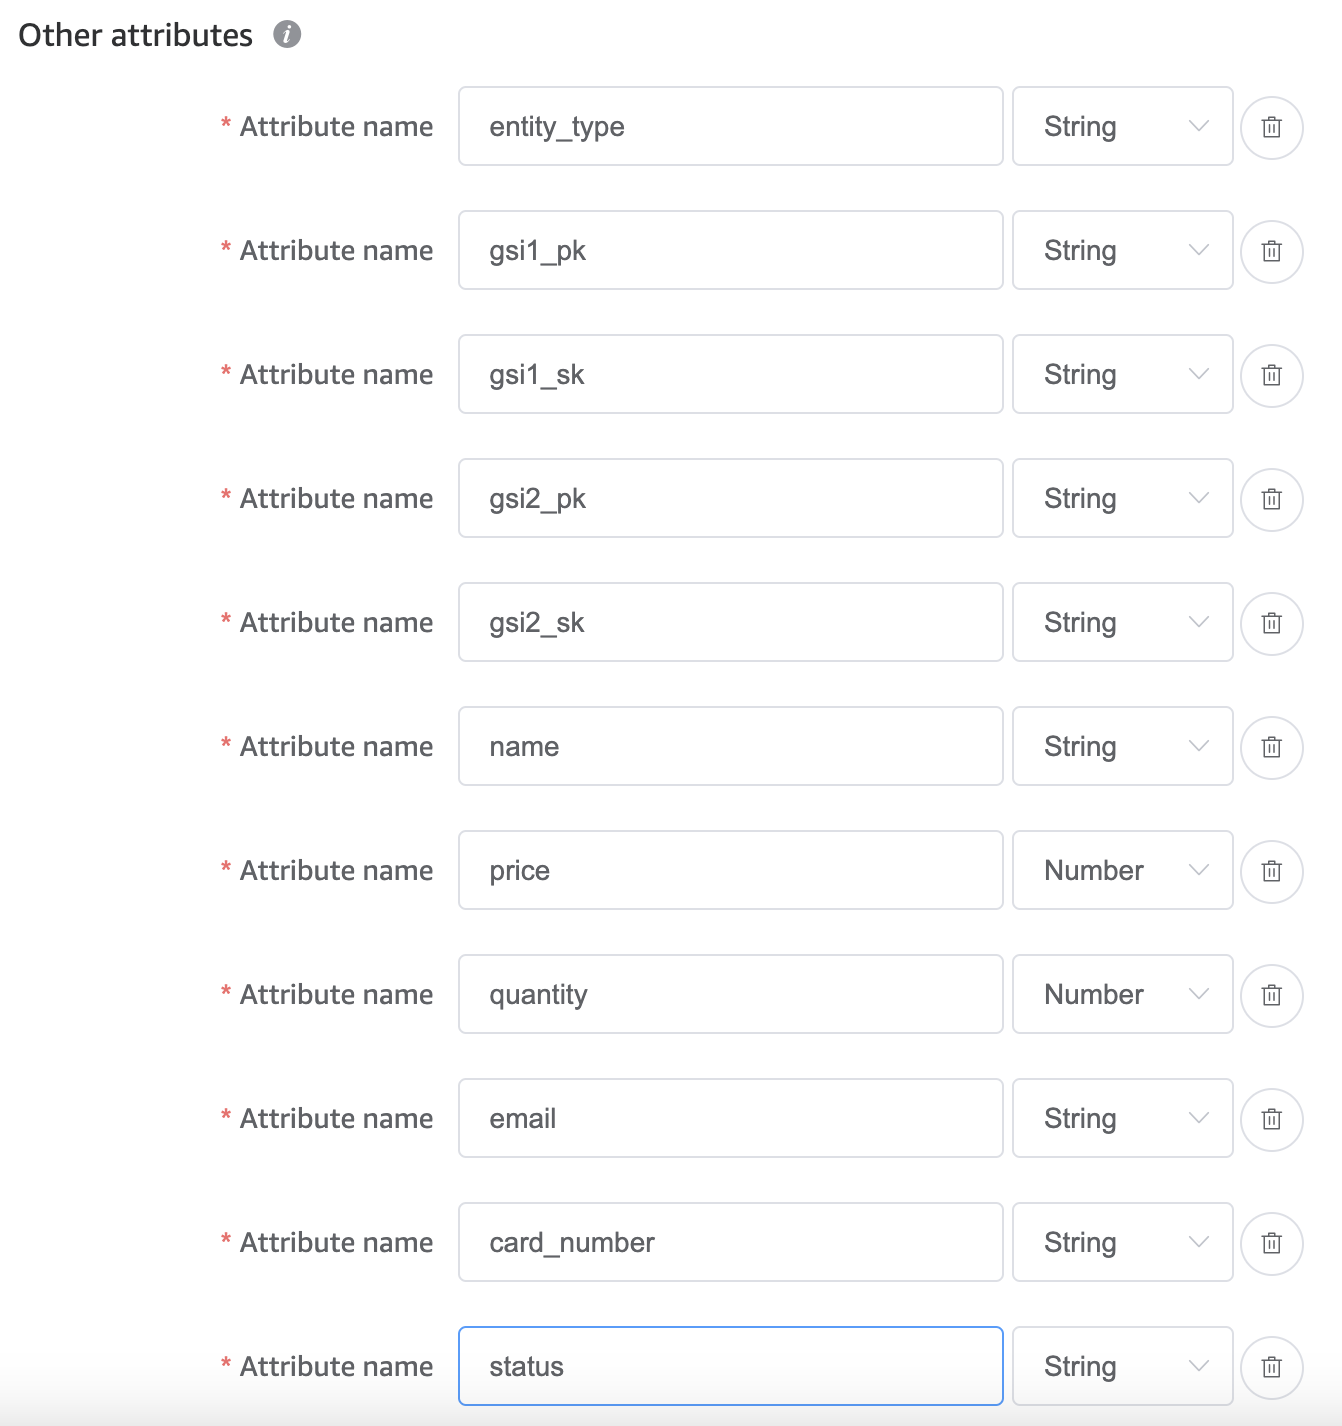
Als zusätzliche Attribute speichern wir den entity_type sowie zwei primäre Schlüsselattribute für GSI PK und SK.
Ein GSI ist ein Global Secondary Index – eine von DynamoDB asynchron synchron gehaltene Kopie deiner Tabelle mit alternativen Primärschlüssel-Paaren. So kann eine Single-Table mehrere Zugriffsmuster unterstützen. Später mehr dazu; vorerst genügt: Diese Keys speichern die Primärschlüssel verwandter Entitäten.
Weitere zusätzliche Attribute sind alle Nicht-Schlüsselattribute unserer Daten (nur für die Designphase erforderlich; bei der eigentlichen Bereitstellung werden sie nicht explizit definiert):
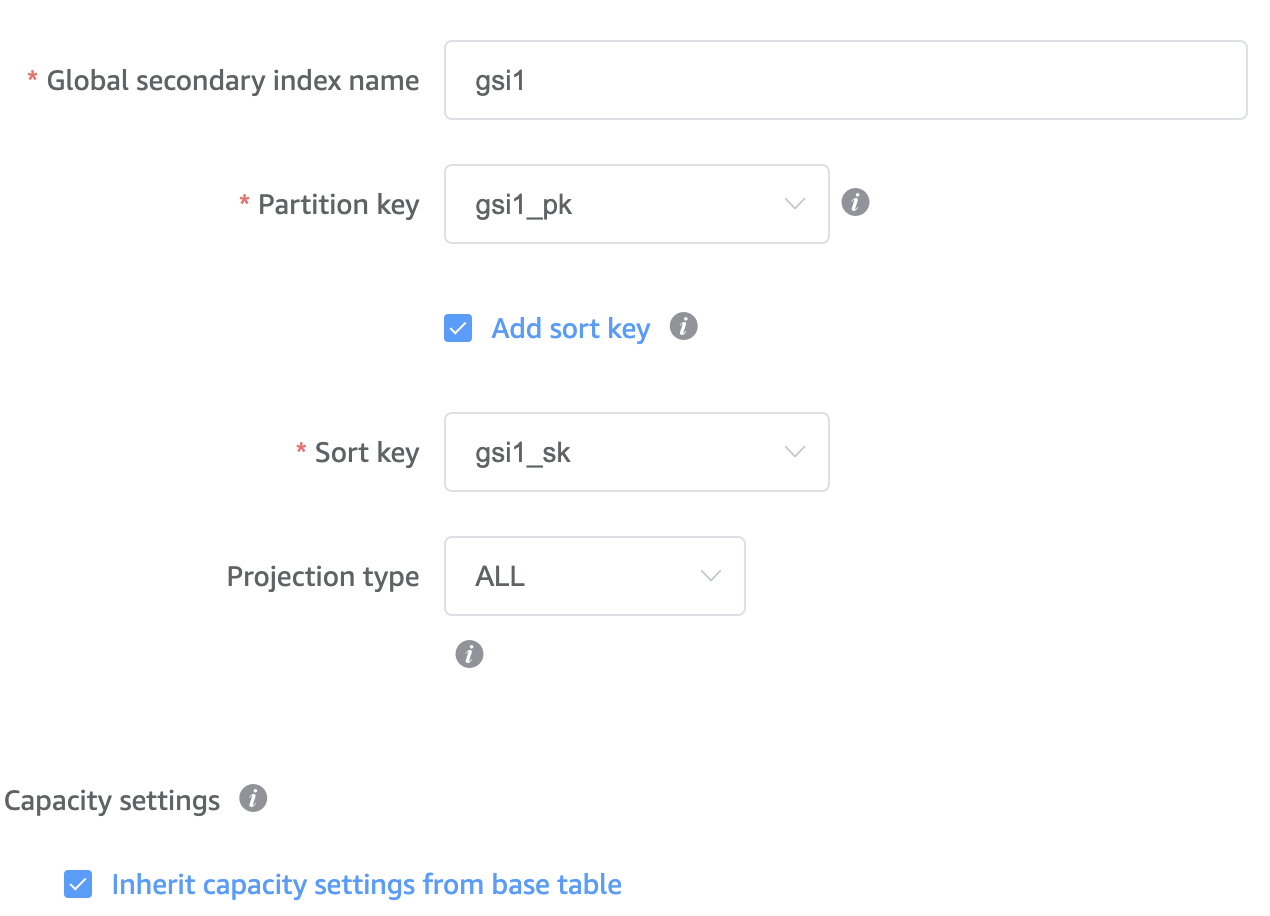
Als Nächstes fügen wir die beiden GSIs mit den zuvor definierten Schlüsseln hinzu:
Speichere und klicke dann auf Datenmodell visualisieren. Du siehst jetzt deine neu erstellte, noch leere Tabelle. Klicke auf Tabelle bearbeiten und oben rechts auf Daten bearbeiten, um neue Zeilen hinzuzufügen:
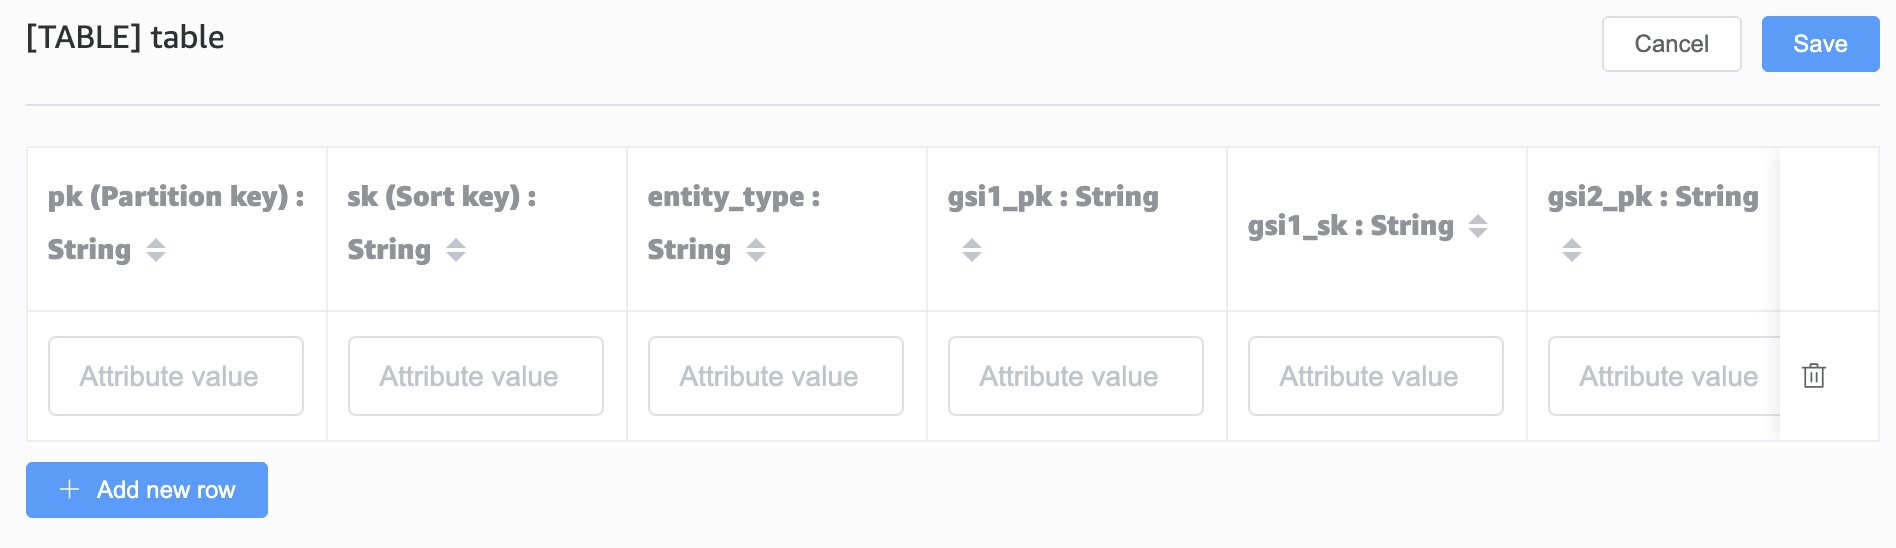
Bevor wir Daten hinzufügen, definieren wir die Primärschlüssel-Präfixe je Entität:
|
product |
p# |
|
category |
c# |
|
customer (user) |
u# |
|
basket |
b# |
|
basket item |
bi# |
|
order |
o# |
|
order line |
ol# |
|
payment |
py# |
|
invoice |
i# |
Die meisten Zugriffsmuster drehen sich um den Kunden. Deshalb nutzen wir für den Primärindex die Kunden-ID als Partition Key; der eigentliche Kundendatensatz ist über den Sort Key identifizierbar, der ebenfalls die Kunden-ID ist.
So können wir Beziehungen wie Kunde–Bestellung und Kunde–Warenkorb einfach modellieren: gleicher Partition Key, unterschiedlicher Sort Key.
Die aggregierte Sicht sieht nun so aus:
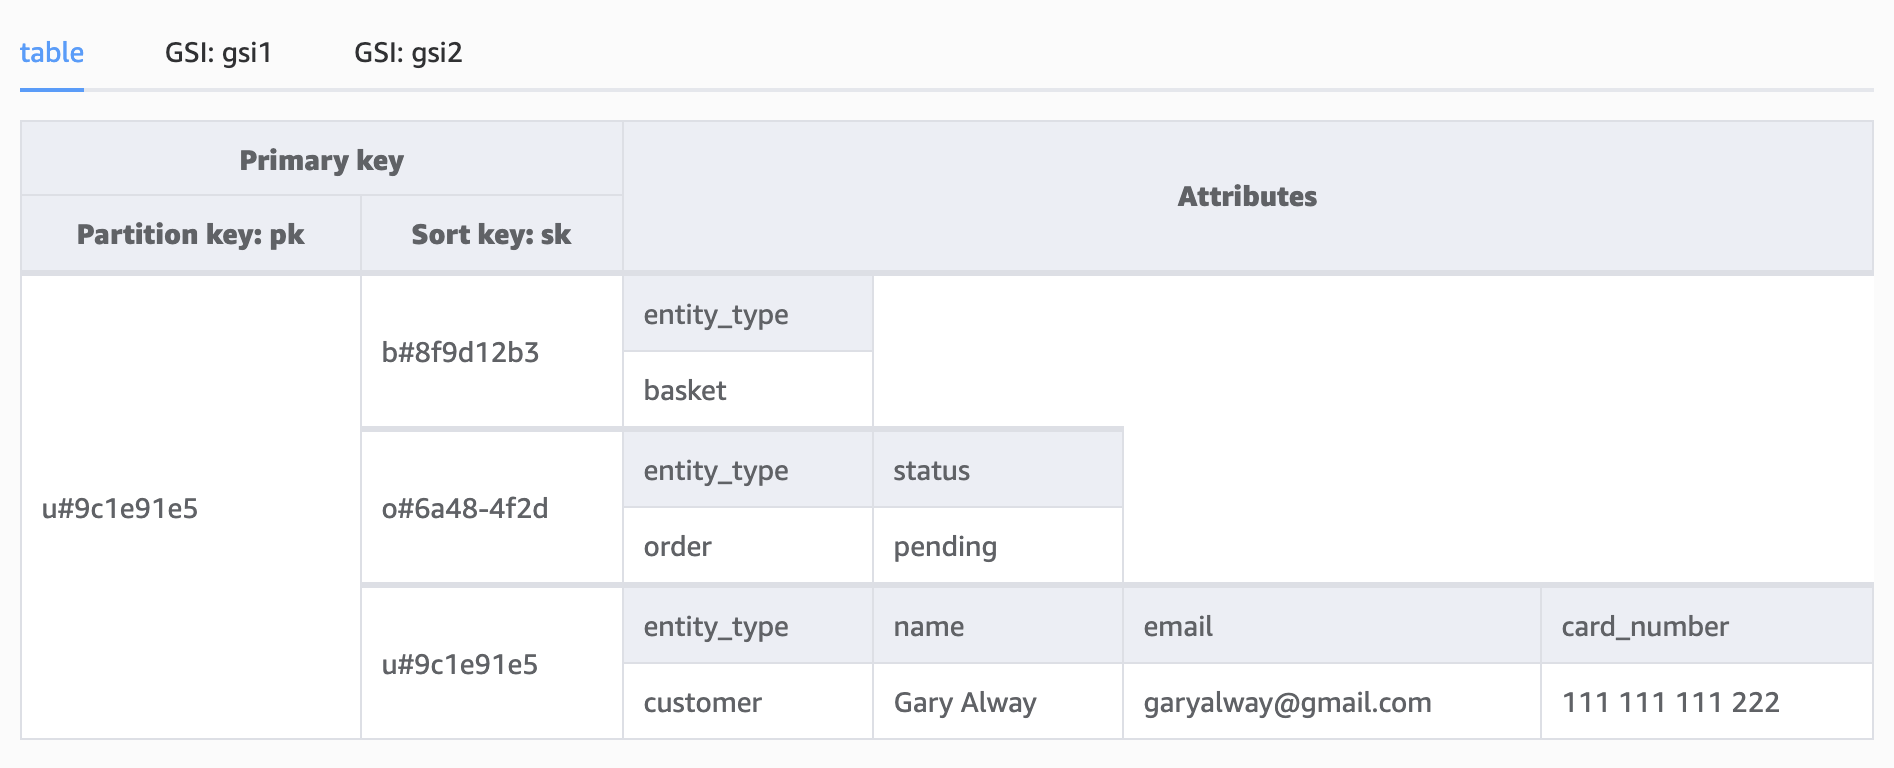
Wir können alle drei Datensätze in einem einzigen Befehl abfragen, indem wir die gesamte Kunden-Partition lesen:
export const getAllCustomerRecords = async (id: string) =>
  dynamoClient
    .query({
      TableName: TABLE_NAME,
      KeyConditionExpression: "pk=:pk",
      ExpressionAttributeValues: {
        ":pk": valueToAttributeValue(addPrefix(id, CUSTOMER_PREFIX)),
      },
    })
    .then((result) => result.Items);
Mit wachsender Tabelle ist diese Abfrage nicht immer effizient, da sie jede Bestellung des Kunden sowie weitere Datensätze wie Warenkörbe und Rechnungen zurückliefert. Aber gut zu wissen: Bei Bedarf können wir alle Kundendaten in einer Abfrage ziehen.
Mit einer kleinen Anpassung – einer Teilübereinstimmung (begins_with) auf dem Sort Key – können wir abfragen:
Wichtig ist, wie wir 1:1- und 1:n-Beziehungen in NoSQL modellieren.
Diese Entitäten bilden ebenfalls eine 1:n-Beziehung: Eine Kategorie kann viele Produkte enthalten.
Kategorien sind hierarchisch: Eine Kategorie kann viele Unterkategorien haben; Produkte können an jeder Stelle im Kategoriebaum liegen.
Wir modellieren das Beispiel mit Büchern, aufgeteilt in Fiction und Non-Fiction.
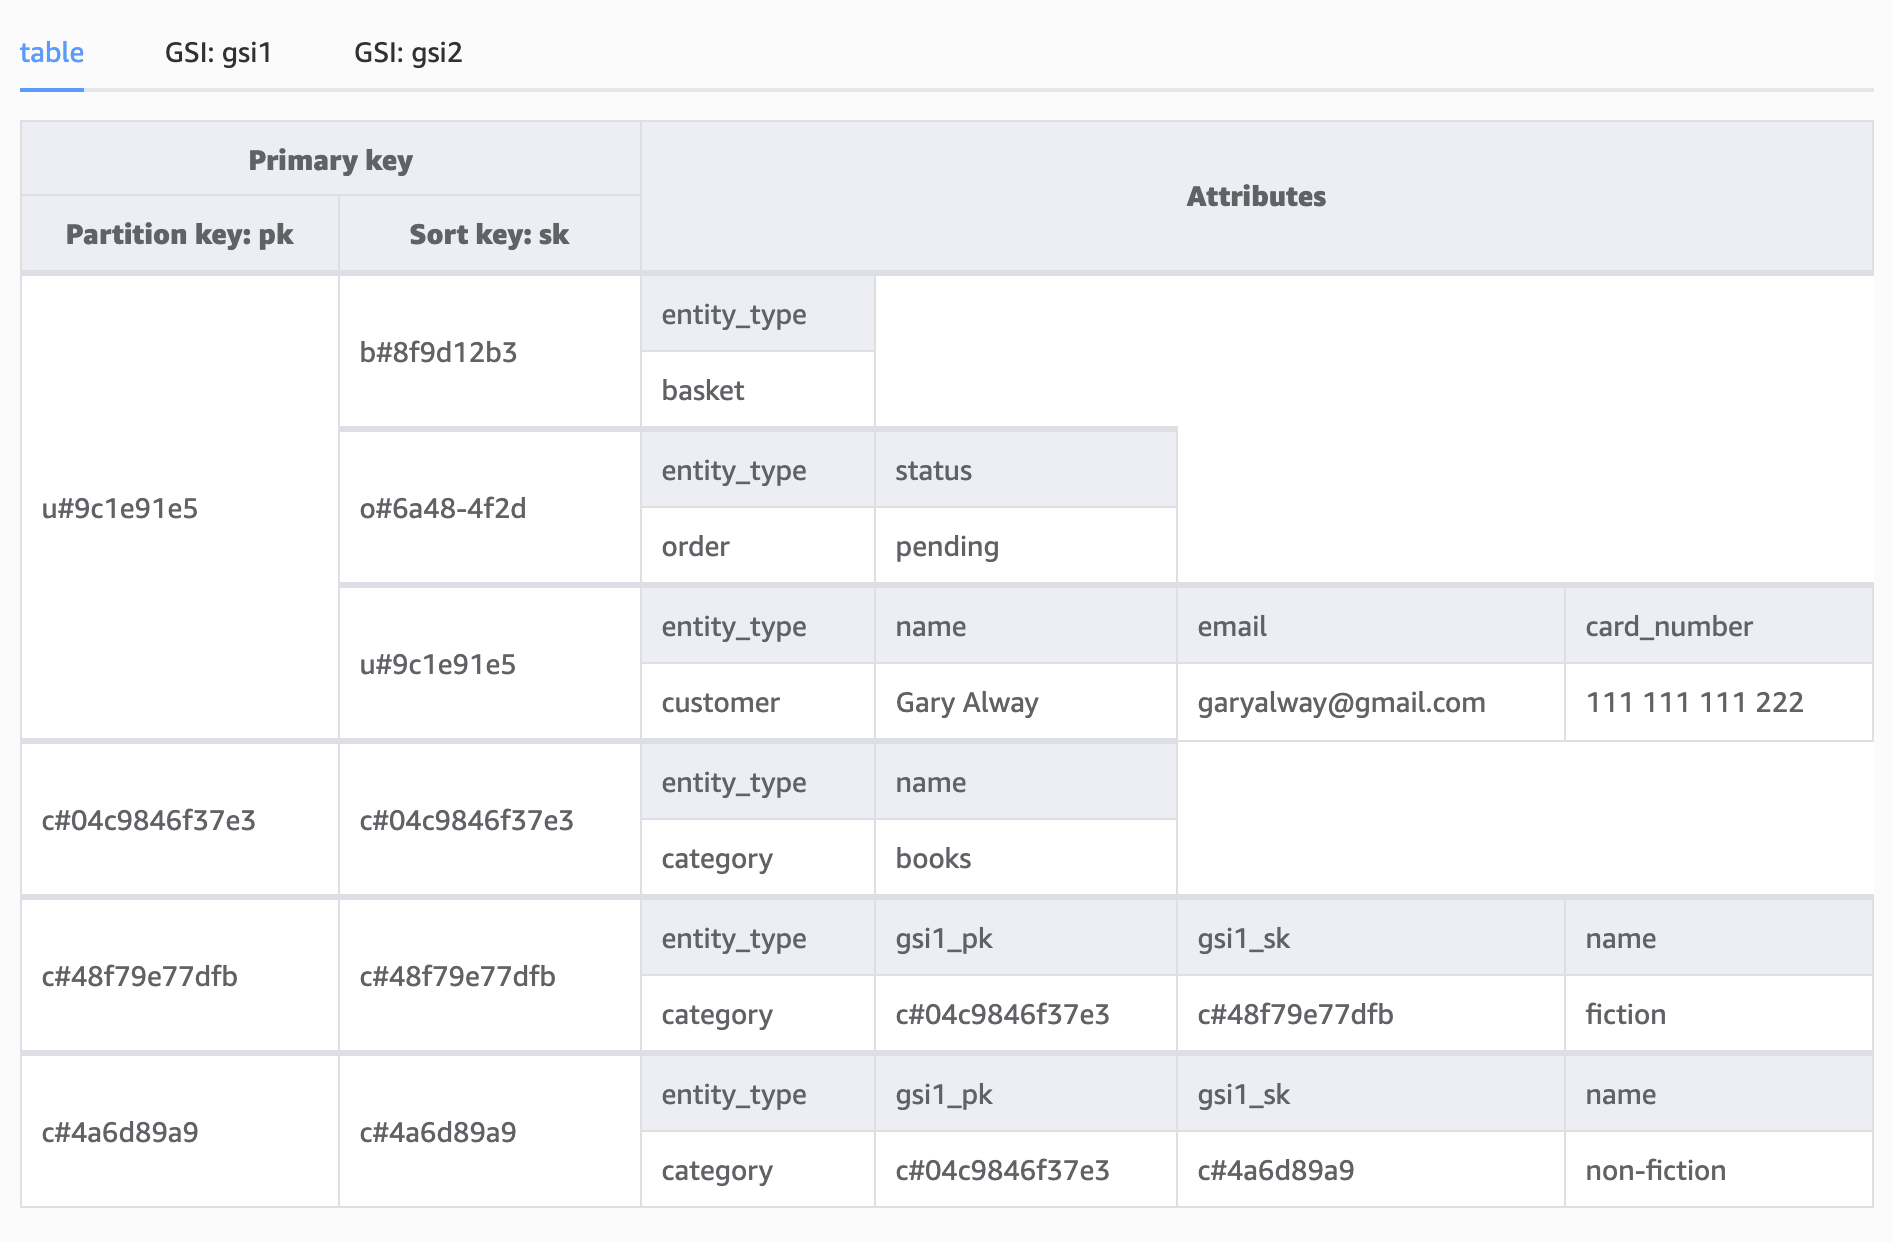
Beachte: Für Unterkategorien befüllen wir die GSI-Attributschlüssel, setzen GSI1_PK auf die ID der Oberkategorie und GSI1_SK auf die ID der Unterkategorie. Damit können wir alle Unterkategorien je Kategorie über GSI1 abfragen:
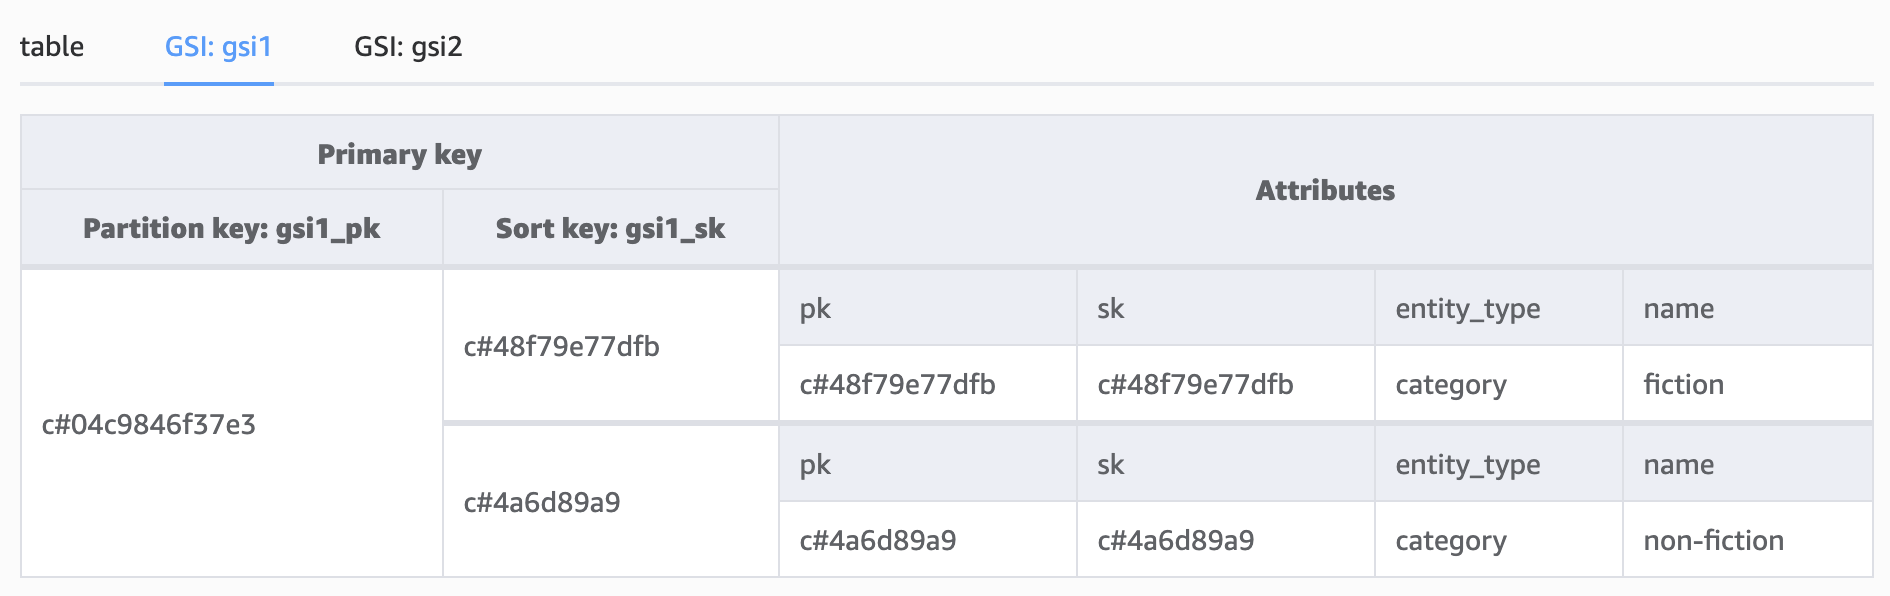
Derselbe Index, GSI1, kann mehr als 1:n-Mappings abbilden. Möchten wir z. B. Kunden per E-Mail finden, unterstützt das aktuelle Modell das nur, wenn wir die Speicherung leicht anpassen:
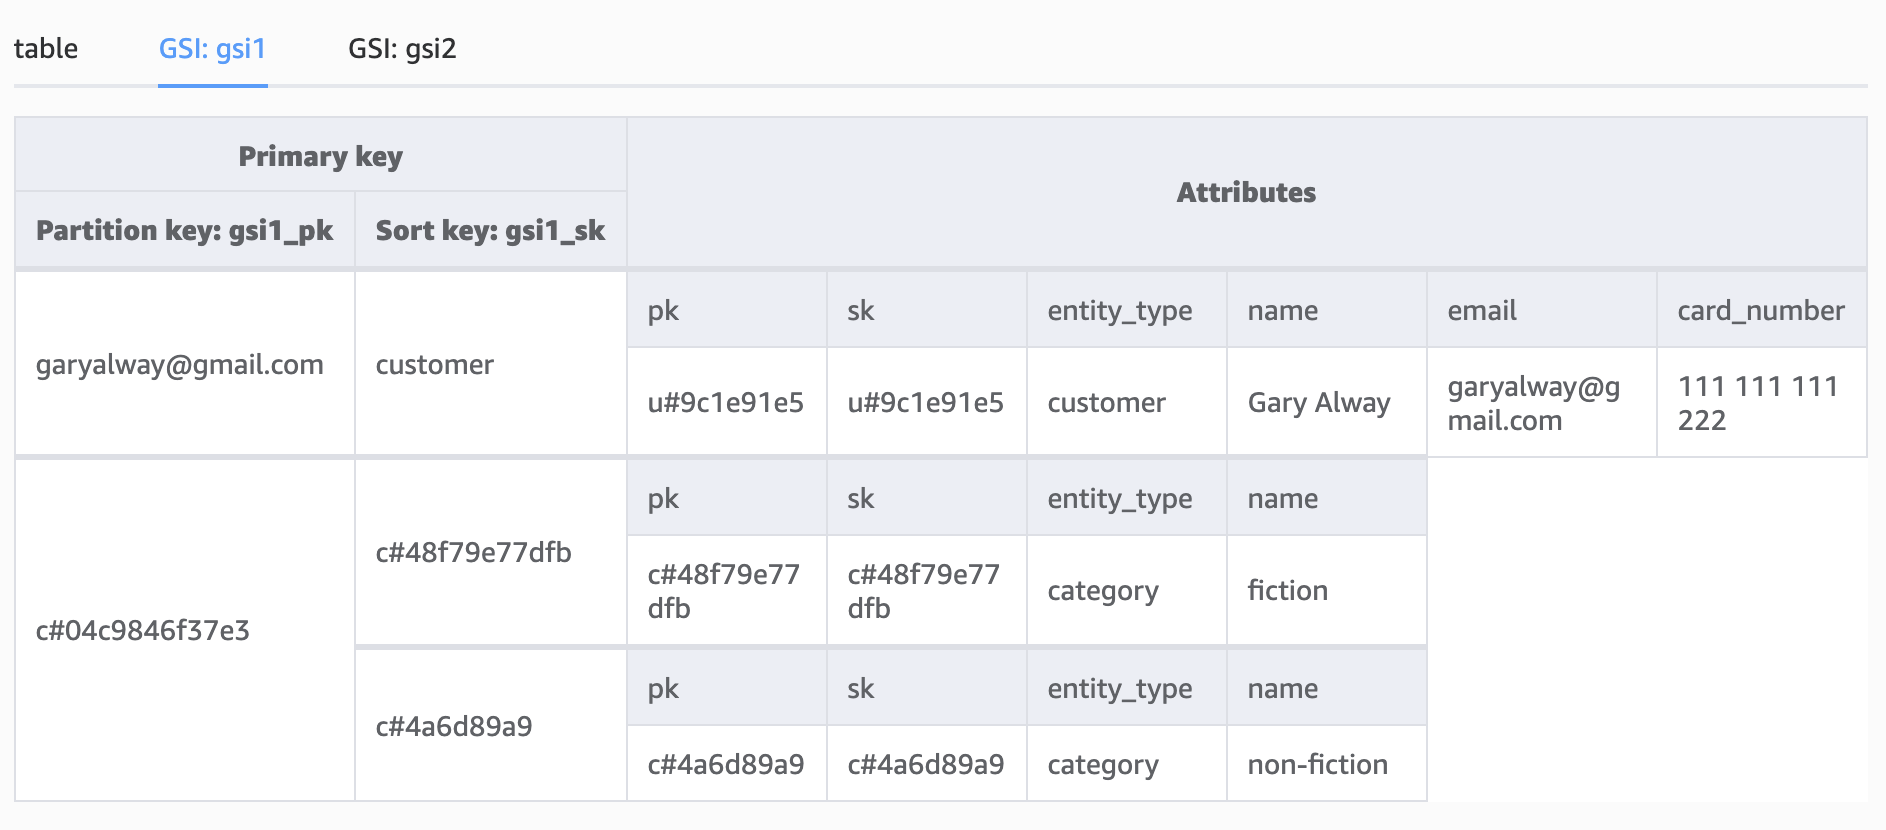
Speichern wir E-Mail-Adresse des Kunden und Entity-Typ als GSI PK und SK, dann:
Zur besseren Verteilung in DynamoDB könnten wir die E-Mail zusätzlich als Hash speichern.
export const getCustomerByEmail = async (email: string) =>
  dynamoClient
    .query({
      TableName: TABLE_NAME,
      IndexName: "gsi1",
      KeyConditionExpression: "gsi1_pk = :email AND gsi1_sk = :entityType",
      ExpressionAttributeValues: {
        ":email": valueToAttributeValue(email),
        ":entityType": valueToAttributeValue(entityType),
      },
    })
    .then(({ Items }) => Items?.[0]);
Vielleicht hast du dich gefragt, warum alle Indizes generische Namen und Schlüsselattribute wie PK und SK tragen. Die Antwort: Daten und Indizes bleiben flexibel und können – je nach Entitätstyp – mehrere Zugriffsmuster unterstützen.
Das Terraform für die bislang genutzte Tabelle sieht so aus:
resource "aws_dynamodb_table" "tutorial-1" {
  name = "tutorial-1"
  billing_mode = "PAY_PER_REQUEST"
  hash_key = "pk"
  range_key = "sk"


  attribute {
    name = "pk"
    type = "S"
  }


  attribute {
    name = "sk"
    type = "S"
  }


  attribute {
    name = "gsi1_pk"
    type = "S"
  }


  attribute {
    name = "gsi1_sk"
    type = "S"
  }


  attribute {
    name = "gsi2_pk"
    type = "S"
  }


  attribute {
    name = "gsi2_sk"
    type = "S"
  }


  global_secondary_index {
    name = "gsi1"
    hash_key = "gsi1_pk"
    range_key = "gsi1_sk"
    projection_type = "ALL"
  }


  global_secondary_index {
    name = "gsi2"
    hash_key = "gsi2_pk"
    range_key = "gsi2_sk"
    projection_type = "ALL"
  }
}
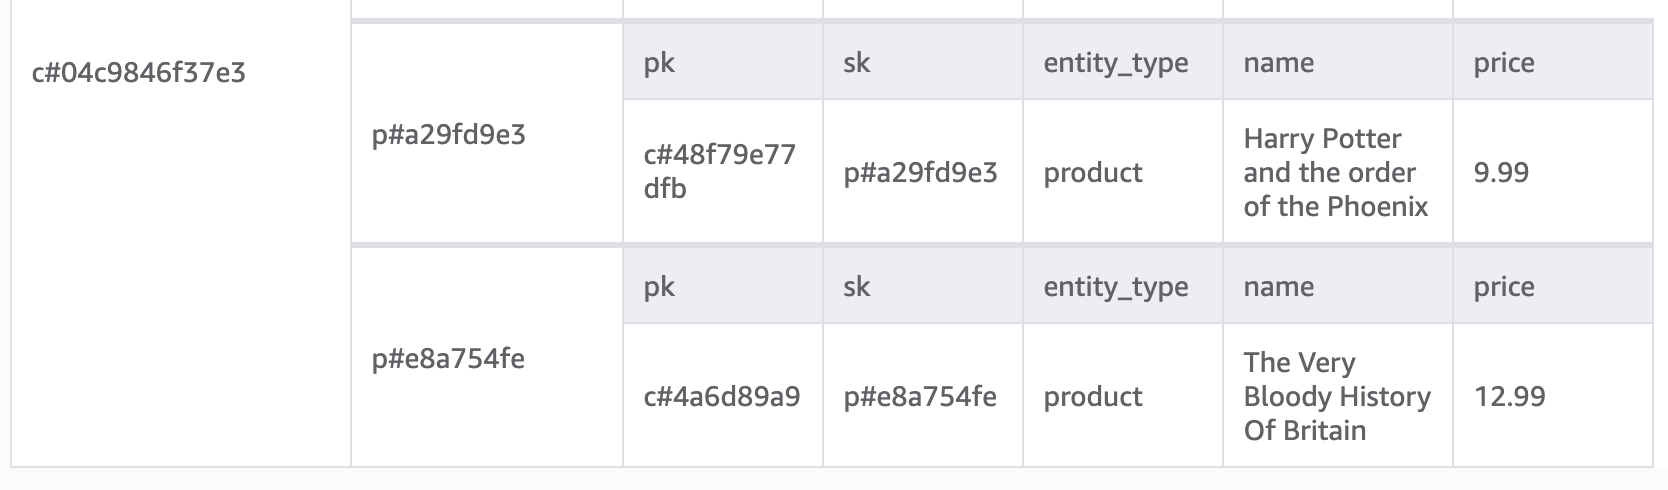
Die Speicherung von Produkten folgt demselben 1:n-Muster: Der Partition Key ist die Kategorie-ID, der Sort Key die Produkt-ID:
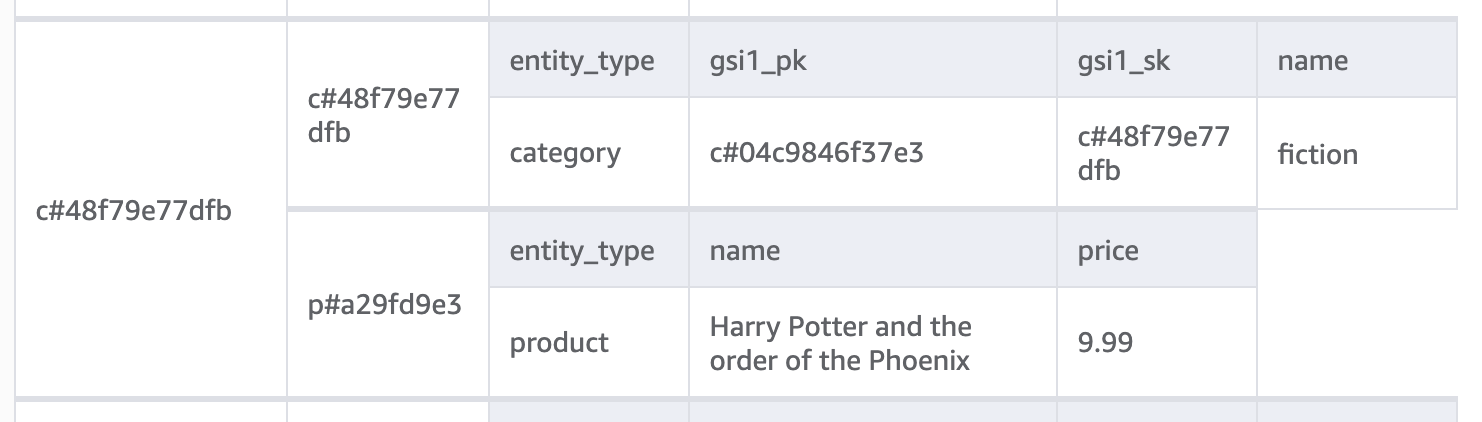
Wenn wir die Oberkategorie in GSI1 aufnehmen, können wir alle Bücher in unserer Datenbank abfragen:
In produktiven Anwendungen können wir DynamoDB Streams nutzen, um Daten in einen Elasticsearch-Cluster zu pushen und damit z. B. nach Buchtitel zu suchen. Wie könnten wir mit dem bestehenden Modell nach Produkttiteln suchen?
GSI1 ist bereits belegt – also nutzen wir GSI2 dafür:
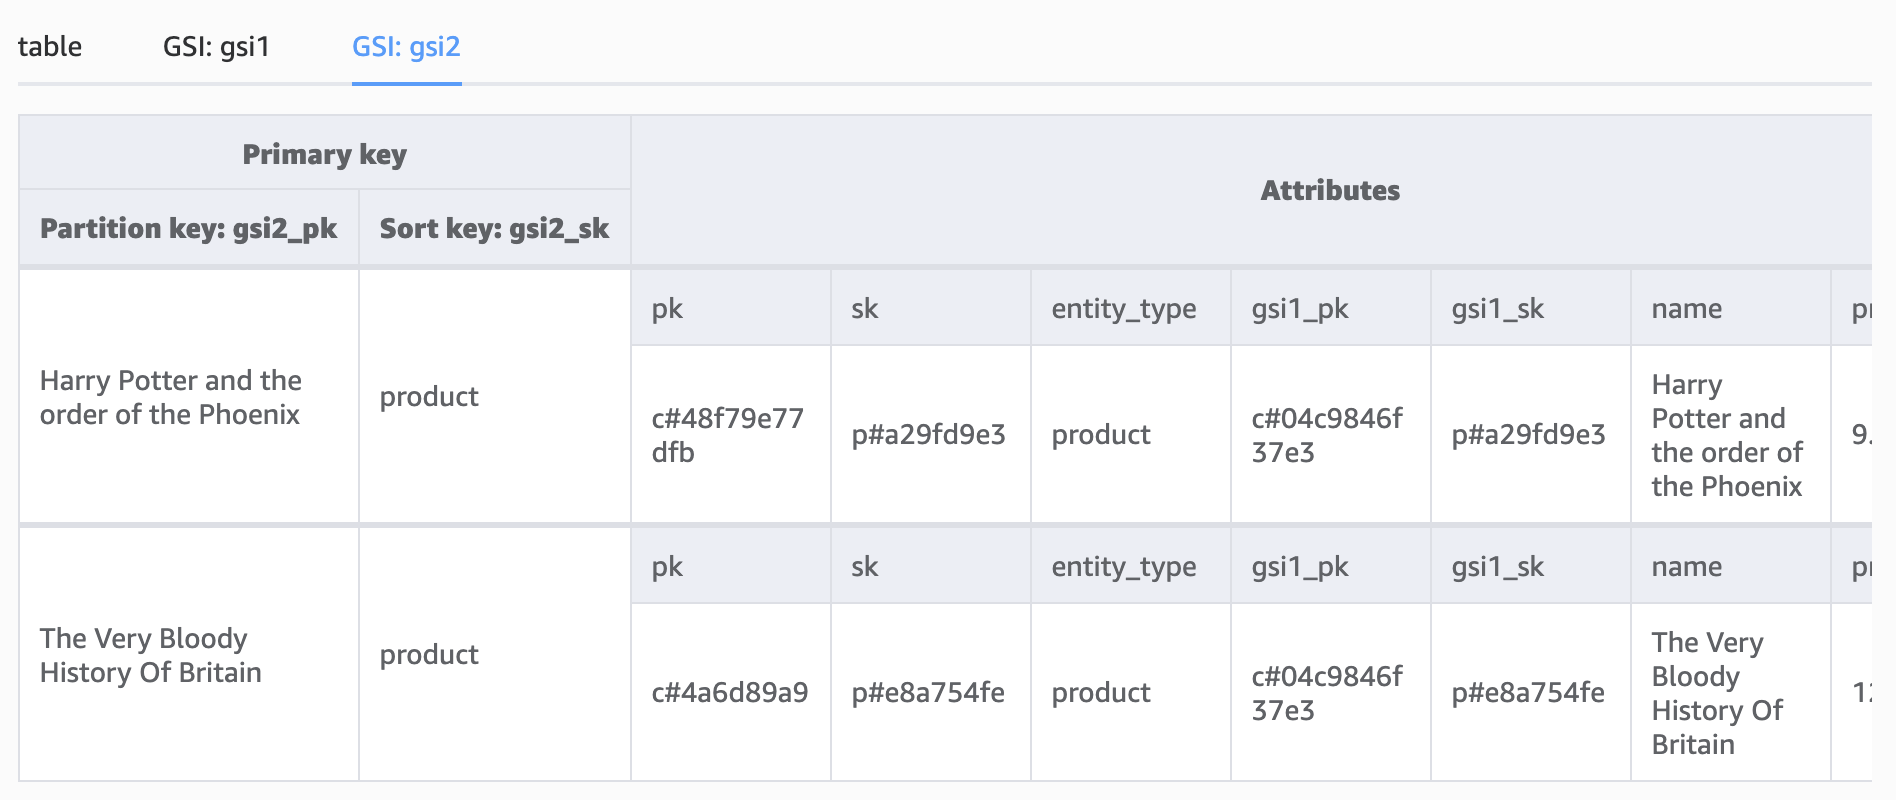
Denk daran: Bei DynamoDB muss der Partitionsschlüssel exakt angegeben werden. Diese Implementierung ist vielleicht nicht optimal, zeigt aber, wie drei Indizes unterschiedliche Zugriffsmuster ermöglichen.
Im nächsten Tutorial zeige ich, wie sich das durch die Integration eines Suchindex lösen lässt.
Sowohl Warenkorbartikel als auch Bestellpositionen speichern wir in der Kundenpartition. Über die GSIs können wir alle Produkte in einem Warenkorb, alle Produkte in einer Bestellung und alle jemals bestellten Produkte eines Kunden abfragen.
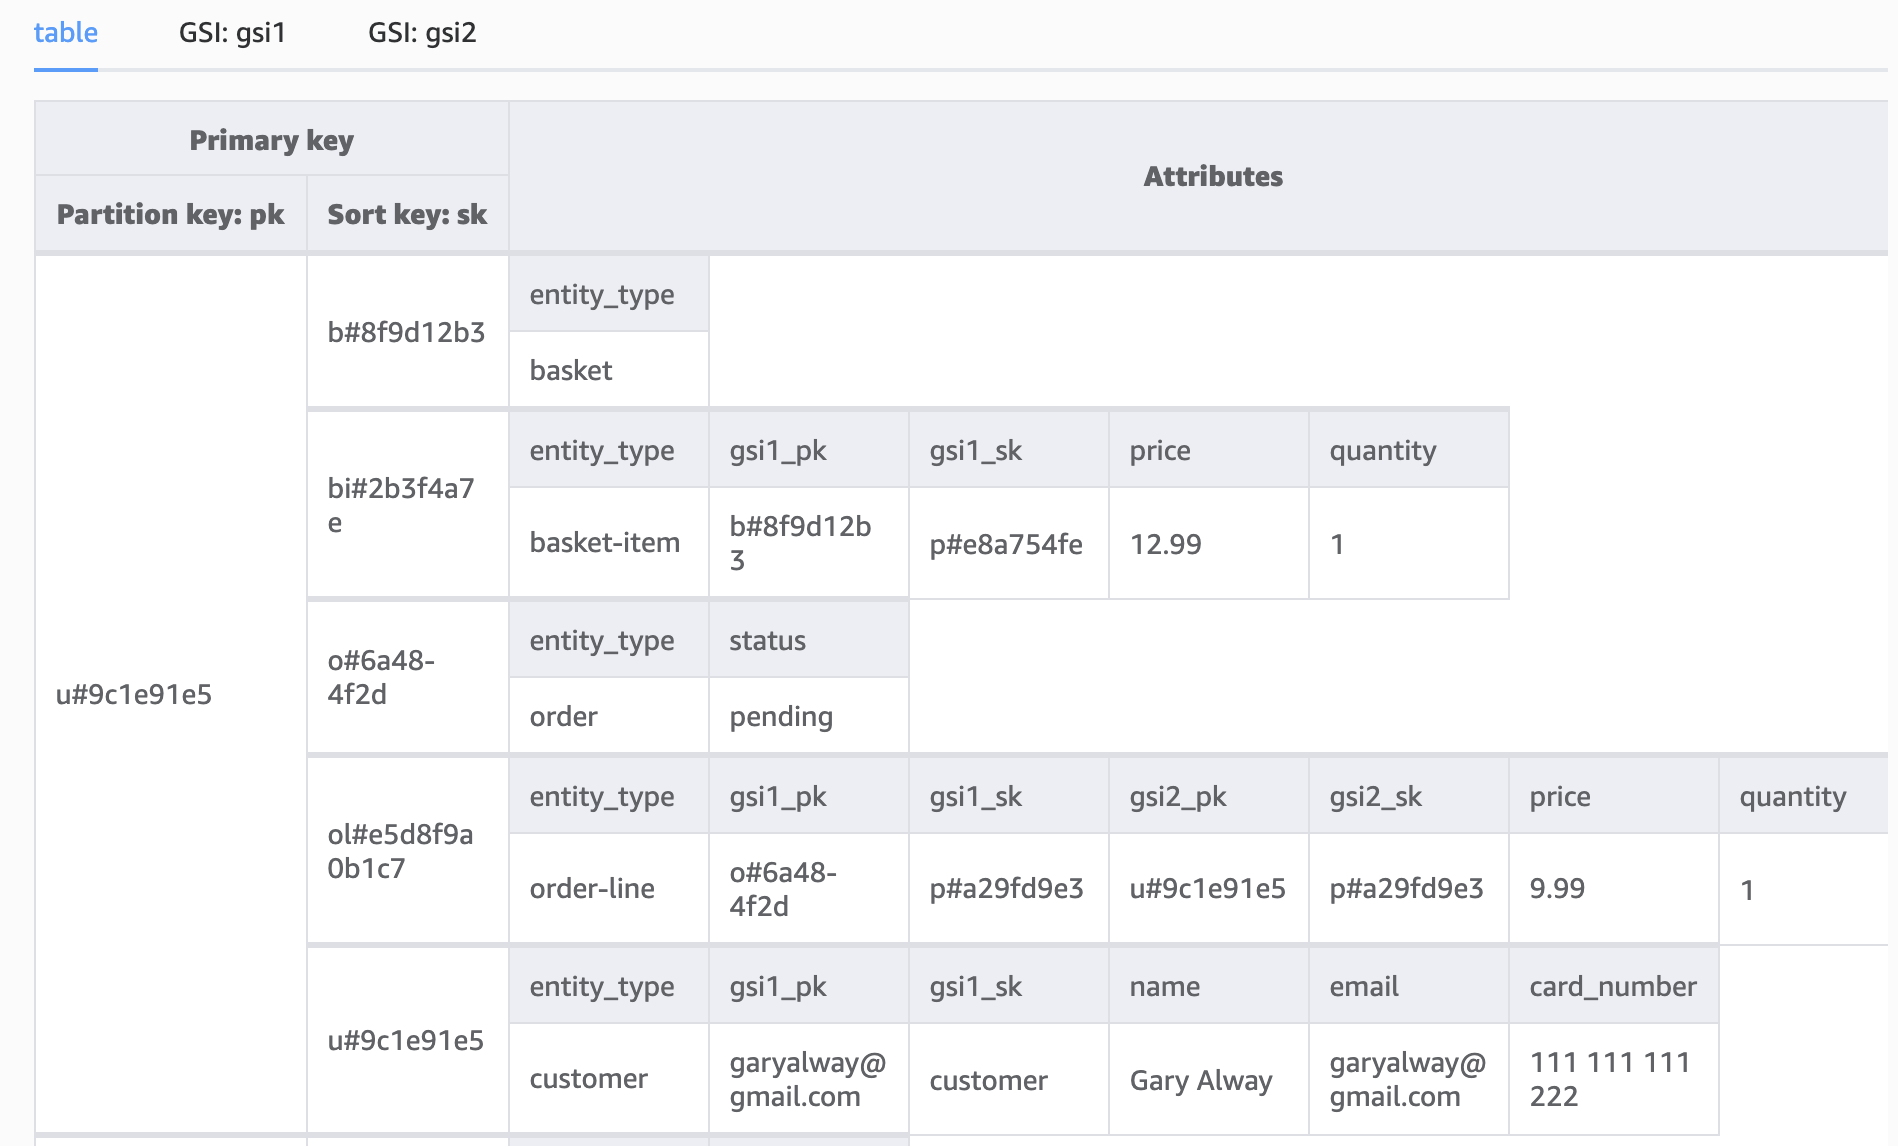
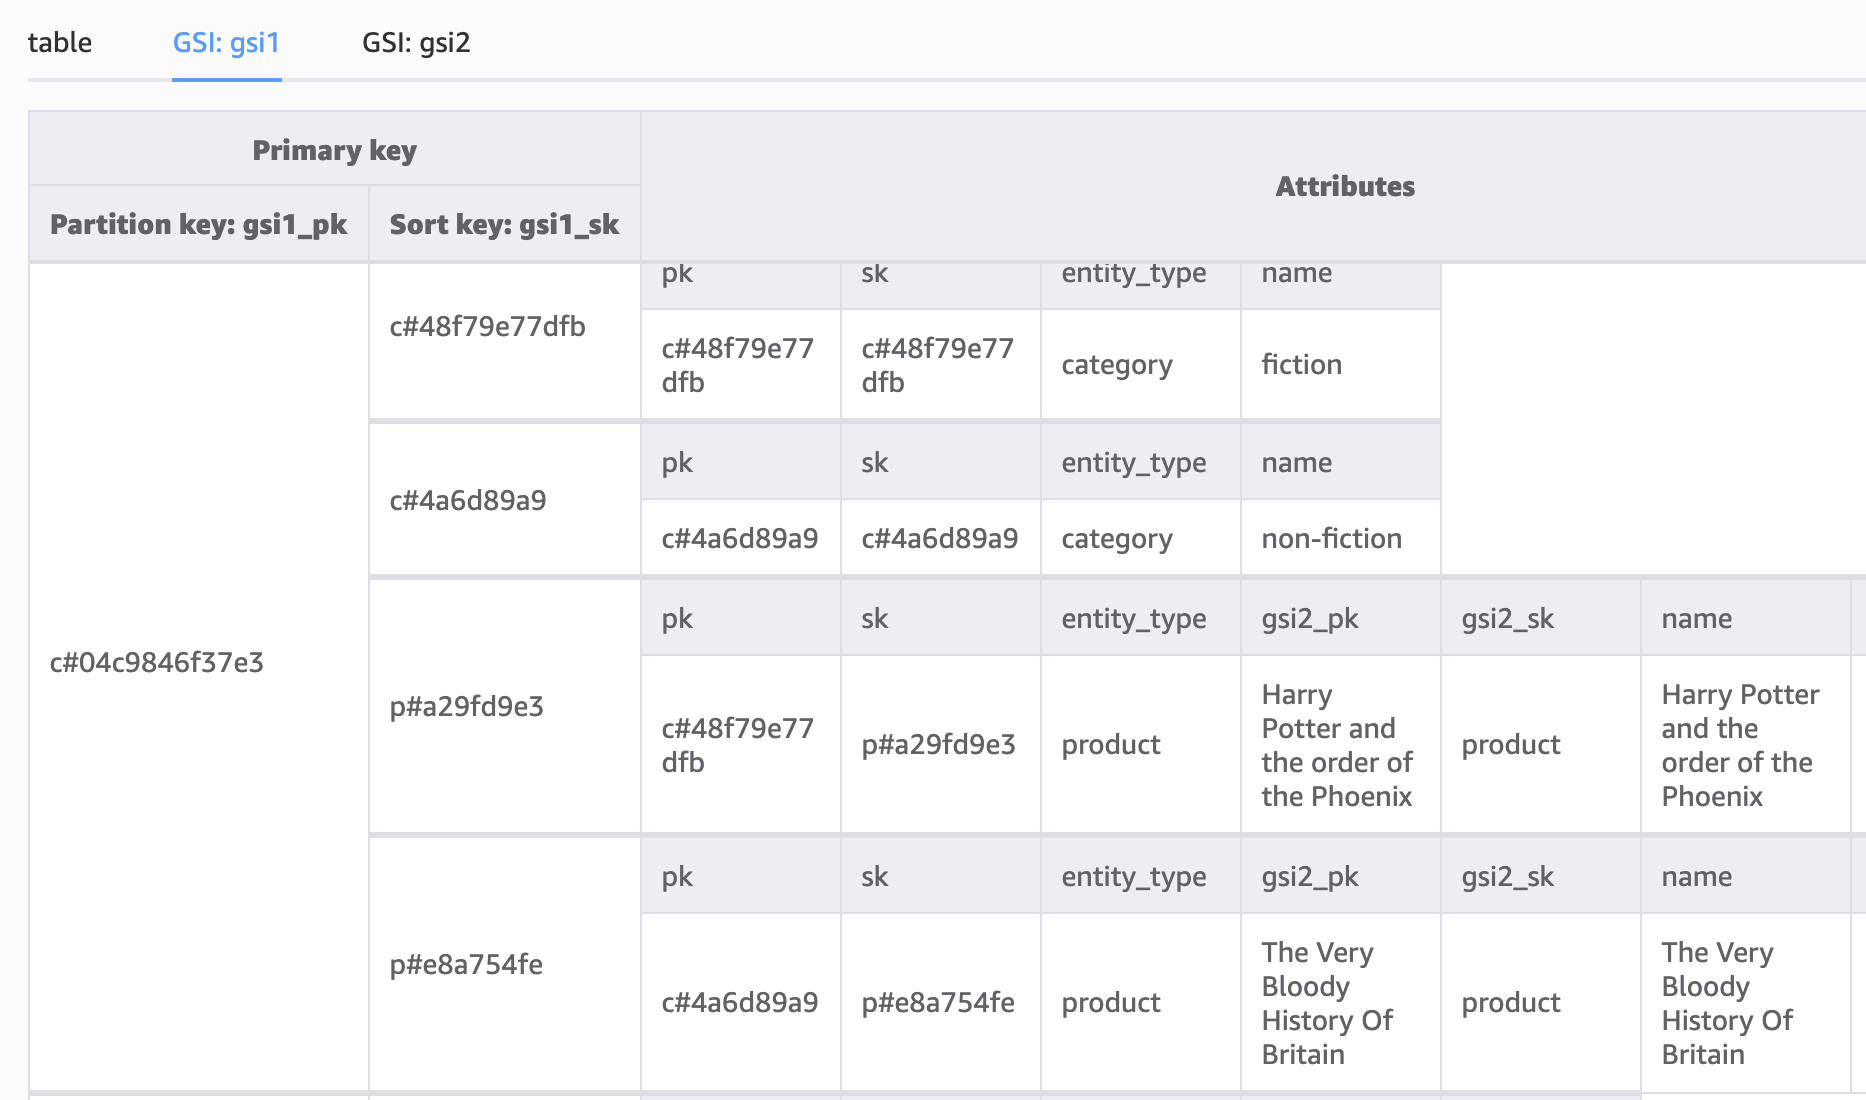
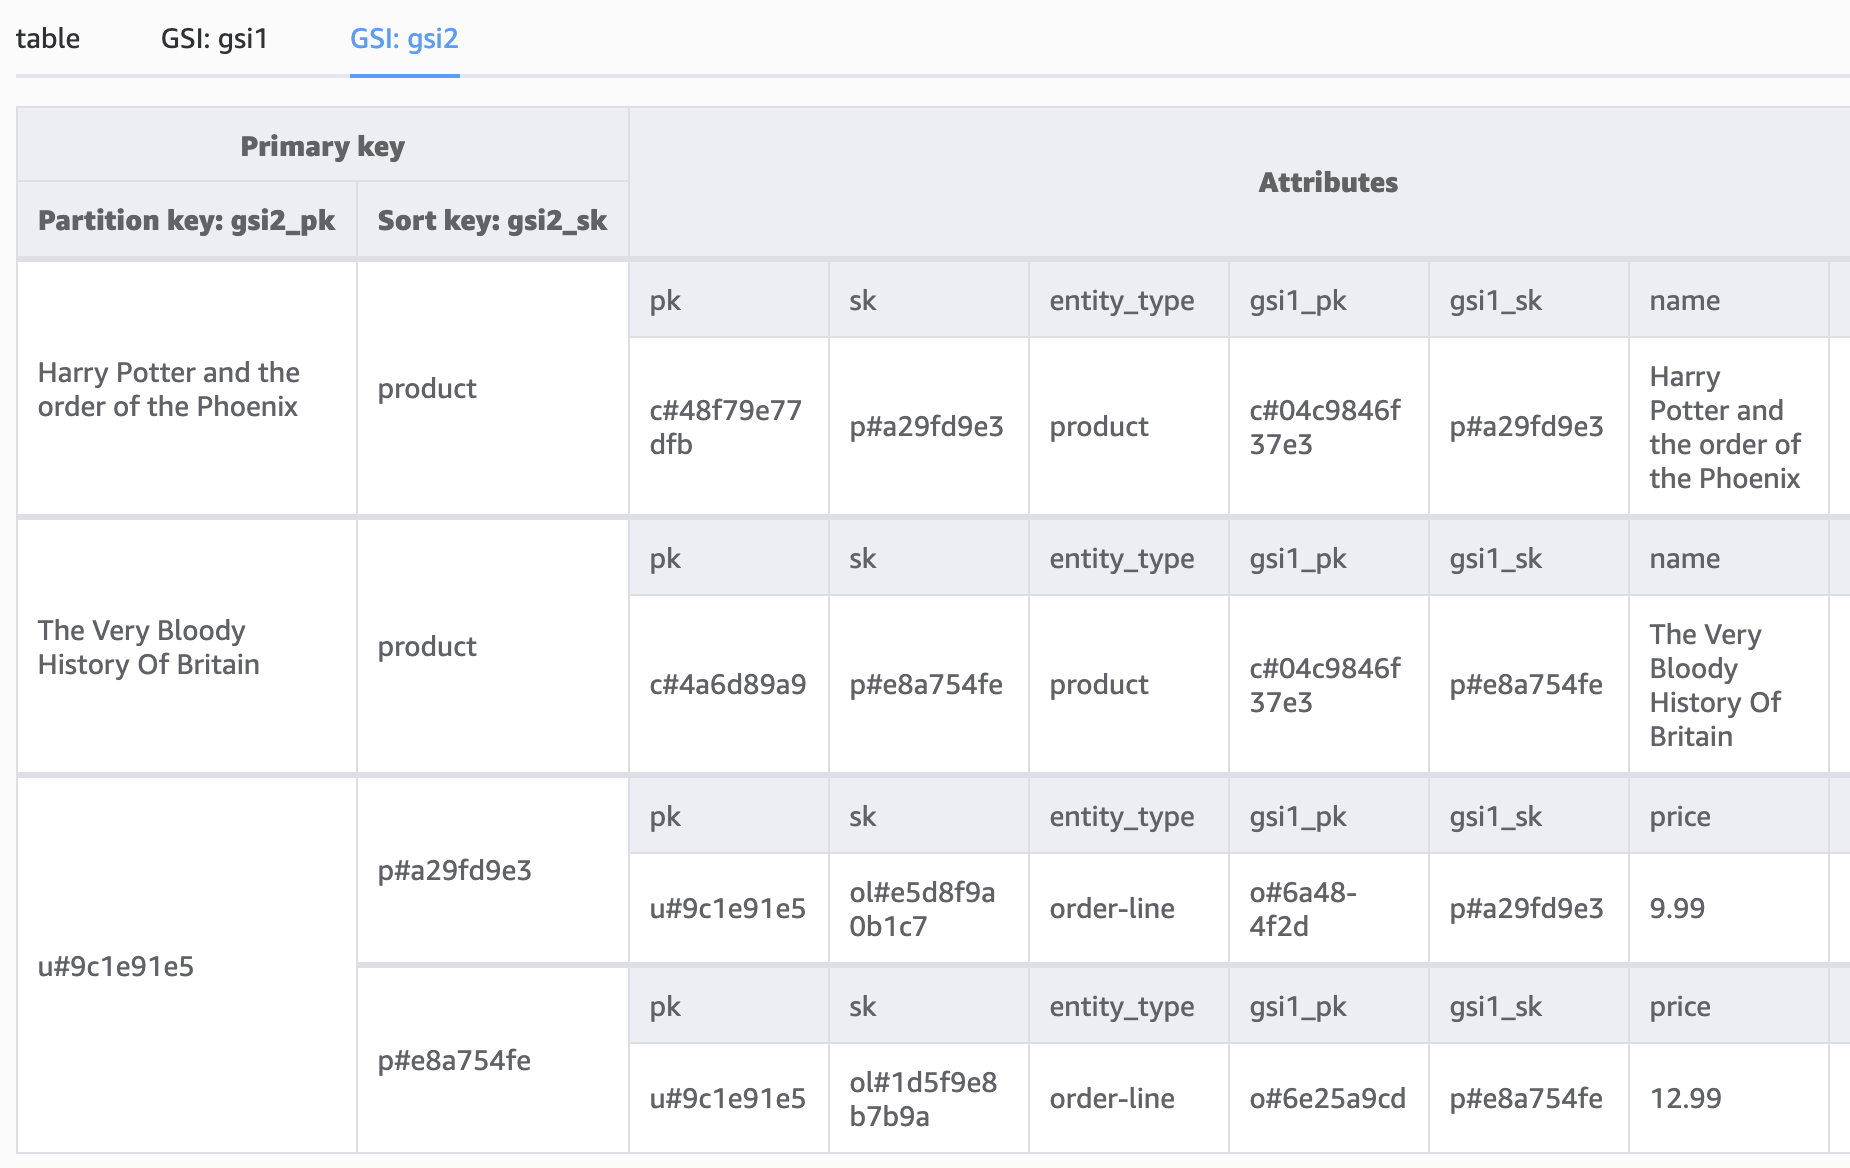
Dieses letzte Beispiel zeigt die Bestellhistorie eines Kunden mit zwei Produkten aus zwei verschiedenen Bestellungen.
Wenn dich interessiert, wie Datenmodellierung in SQL-Datenbanken funktioniert, liefert unser Webinar „Data Modeling in SQL“ wertvolle Einblicke, die dein Verständnis von NoSQL ergänzen.
Das Single-Table-Design mit DynamoDB bietet viele Vorteile, bringt aber auch einige Herausforderungen und Überlegungen mit sich:
Alle Daten in einer einzigen Tabelle zu managen, kann komplex werden – vor allem, wenn deine Anwendung wächst und sich verändert.
Du musst Daten so planen und strukturieren, dass verschiedene Abfragemuster unterstützt werden. Außerdem hängt die Effektivität des Single-Table-Designs eng mit deiner Anwendungslogik zusammen; sie ist entscheidend für reibungslosen Datenzugriff und effiziente Abfragen.
Nur mit durchdachter Datenstruktur und sauberer Anwendungslogik funktioniert Single-Table-Design wirklich gut.
DynamoDB unterstützt Global Secondary Indexes für unterschiedliche Abfragemuster. Diese müssen jedoch bereitgestellt und gepflegt werden – das erhöht Kosten und Komplexität.
Die richtige Wahl des Partition Keys ist entscheidend für gleichmäßige Datenverteilung und Performance. Ungeeignete Keys führen zu „hot partitions“ und Engpässen.
Mit wachsendem Datenvolumen kann die Single-Table stark anwachsen – mit Auswirkungen auf Speicher- sowie Lese-/Schreibkosten.
DynamoDB bietet keine native Volltextsuche. Dafür ist die Integration externer Services wie Elasticsearch nötig.
Schemaänderungen sind herausfordernd – insbesondere in Produktion. Eventuell musst du bestehende Daten migrieren oder die Anwendungslogik anpassen.
Je nach Lese-Konsistenz (stark oder eventually consistent) musst du potenzielle Konsistenzthemen berücksichtigen – GSIs werden asynchron repliziert.
Die Abfragefähigkeiten von DynamoDB sind stark, aber nicht so flexibel wie SQL.
Wenn du lernen möchtest, wie man Datenbanken zielführend entwirft und typische Stolpersteine umgeht, schau dir unseren Kurs Database Design an.
Wer mit NoSQL arbeitet, sollte sich bewusst vom vertrauten Denken relationaler Designmuster lösen – du musst Altes verlernen, um Neues zu meistern.
Das Single-Table-Design verspricht eine global skalierbare Datenbank, die große Lasten mit verlässlicher, berechenbarer Performance stemmt.
Diese Performance gibt es nicht umsonst: Sie verlangt sorgfältige Planung und eine durchdachte Implementierung von Datenstruktur und Anwendungslogik – am besten von Beginn an.
Vertiefe dein Wissen mit unserem Kurs zu NoSQL Concepts!
Starte heute deine Data Journey!
Kurs
Kurs
Kurs