Cours
Concepts NoSQL
2 h
19K
Bienvenue dans l’univers de DynamoDB, où l’efficacité et une scalabilité sans limite se rejoignent… dans une seule table. Dans ce tutoriel complet, nous allons entreprendre un parcours stimulant pour dévoiler tout le potentiel de la conception NoSQL en table unique.
Découvrez l’art de simplifier des modèles de données complexes tout en exploitant la pleine puissance d’une structure unifiée, capable d’absorber sans effort l’essor continu de vos besoins.
Que vous soyez un développeur aguerri des bases NoSQL ou que vous débutiez votre aventure data, préparez-vous à offrir un nouveau niveau de scalabilité à vos applications grâce à une architecture de données robuste !
Avant de commencer, il est important de comprendre la différence entre NoSQL et les bases relationnelles, dans quels scénarios utiliser l’un ou l’autre, et pourquoi ces technologies ont été inventées. Un bref retour sur l’histoire du traitement des données s’impose.
Vous pouvez en savoir plus sur l’importance des bases NoSQL en data science dans un article dédié.
La base relationnelle est une technologie bien connue et largement utilisée depuis les années 1970. Deux des principaux problèmes qu’elle résout sont le stockage et l’intégrité référentielle.
Les données y sont « normalisées », généralement jusqu’à la troisième forme normale, ce qui réduit l’empreinte de stockage tout en garantissant la cohérence des mises à jour avec le reste des données.
La taille de l’empreinte de données persistée était cruciale car, historiquement, le composant le plus coûteux d’un data center était le disque dur. Ce n’est plus le cas aujourd’hui : c’est désormais le CPU qui coûte le plus cher, tandis que le stockage a drastiquement baissé. Cela ne rend pas la base relationnelle obsolète ; elle reste pertinente pour :
La « pression des données » décrit la capacité d’un système à traiter un certain volume de données dans des coûts et/ou des délais raisonnables.
Les bases NoSQL sont apparues à la fin des années 1990 pour répondre aux problèmes de pression des données qui dégradaient les performances des bases relationnelles face à des volumes applicatifs toujours croissants.
Dans une base relationnelle, le CPU peut devenir un goulet d’étranglement majeur : le serveur s’épuise à récupérer et recoller des données normalisées pour produire les vues dénormalisées consommées par les applications.
On peut atténuer cela en ajoutant des réplicas de lecture, mais NoSQL adopte une autre approche : stocker les données applicatives sous une forme dénormalisée, prête à l’emploi pour les applications. L’empreinte de données est plus grande qu’en relationnel, mais la charge CPU diminue, le serveur se comportant essentiellement comme un simple routeur qui, via un algorithme de hachage, pointe vers un emplacement disque au sein du data center. Les usages typiques du NoSQL :
De nombreuses études fournissent des données objectives permettant de comparer les performances SQL vs NoSQL à grande échelle.
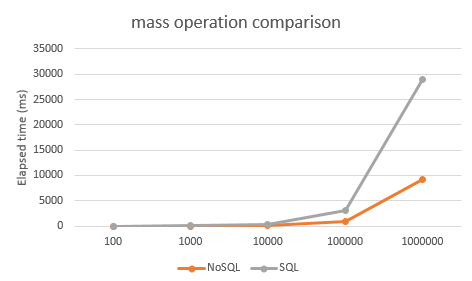
Dernier point important : les données stockées dans une base NoSQL restent des données relationnelles. Si elles ne l’étaient pas, nous les stockerions simplement dans un filestore.
On ne modélise pas une base NoSQL comme une base relationnelle ; c’est donc un anti-pattern de transposer un schéma normalisé tel quel dans NoSQL avec plusieurs tables à joindre, car NoSQL n’a ni opérateur de jointure, ni intégrité référentielle.
Une table NoSQL équivaut à un catalogue en base relationnelle. Il faut modéliser les données pour qu’elles soient stockées dénormalisées, prêtes à être consommées par les applications.
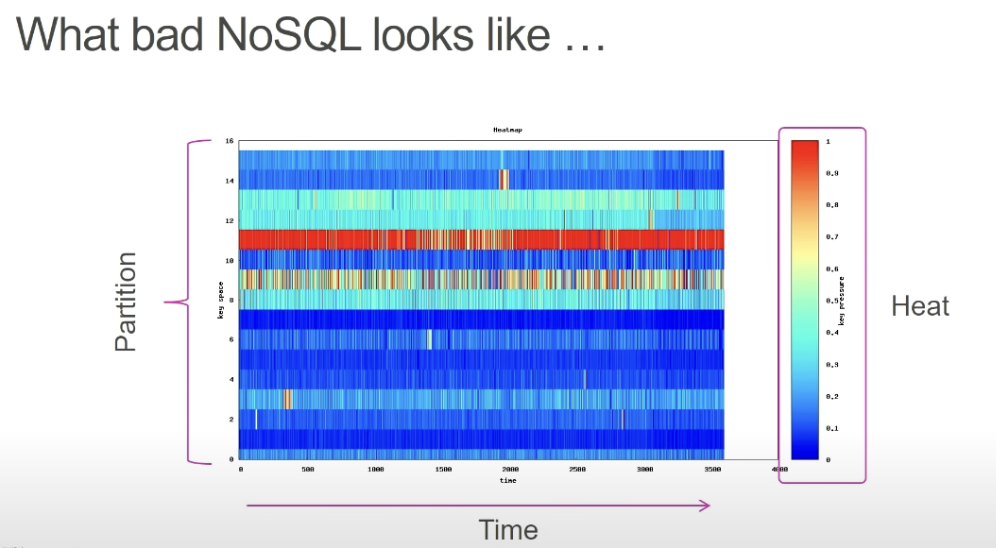
Autre anti-pattern : les « hot keys ». La plupart (voire toutes) les requêtes tombent alors sur un seul nœud de stockage, signe que l’espace de clés est mal conçu.
La carte de chaleur des accès ressemblera à ceci :
AWS DynamoDB est un magasin clé-valeur de type colonnes larges, entièrement managé et serverless : il prend en charge un grand nombre d’items (ou lignes) dans une table, sans obligation d’attributs identiques entre items. Types pris en charge :
Comme indiqué, NoSQL s’emploie quand les schémas d’accès applicatifs sont bien connus et qu’il faut soutenir un grand nombre de TPS. DynamoDB passe à l’échelle pour toute charge et offre des temps de réponse rapides et constants jusqu’à 4 millions de TPS, avec une faible latence (10 à 20 ms).
Chaque item (ou ligne) possède une clé de partition qui l’identifie de façon unique et détermine la distribution des données sur le stockage sous-jacent.
Les items peuvent avoir une clé de tri optionnelle définissant l’ordre d’écriture sur disque au sein d’une partition. Les clés de tri permettent d’interroger des partitions avec des plages et filtres complexes (les filtres s’appliquent côté client, pas côté base).
La clé de partition sert à créer un index de hachage, puis chaque item est réparti selon ce hachage sur un espace de clés virtuel. Cet espace est découpé en segments mappés sur des dispositifs de stockage physiques, pouvant croître ou rétrécir dynamiquement selon le volume de données.
Voilà pourquoi DynamoDB reste rapide et constant à toute échelle : le moteur agit comme un service de routage, des clés hachées vers le stockage physique.
Dans ce tutoriel, nous allons modéliser une boutique en ligne nommée Daintree.com.
(Fun fact : la forêt tropicale de Daintree, dans le Queensland en Australie, est l’une des plus anciennes au monde : environ 180 millions d’années !)
Commençons par un diagramme de relations d’entités (ERD) très simplifié pour visualiser ce que nous allons modéliser.
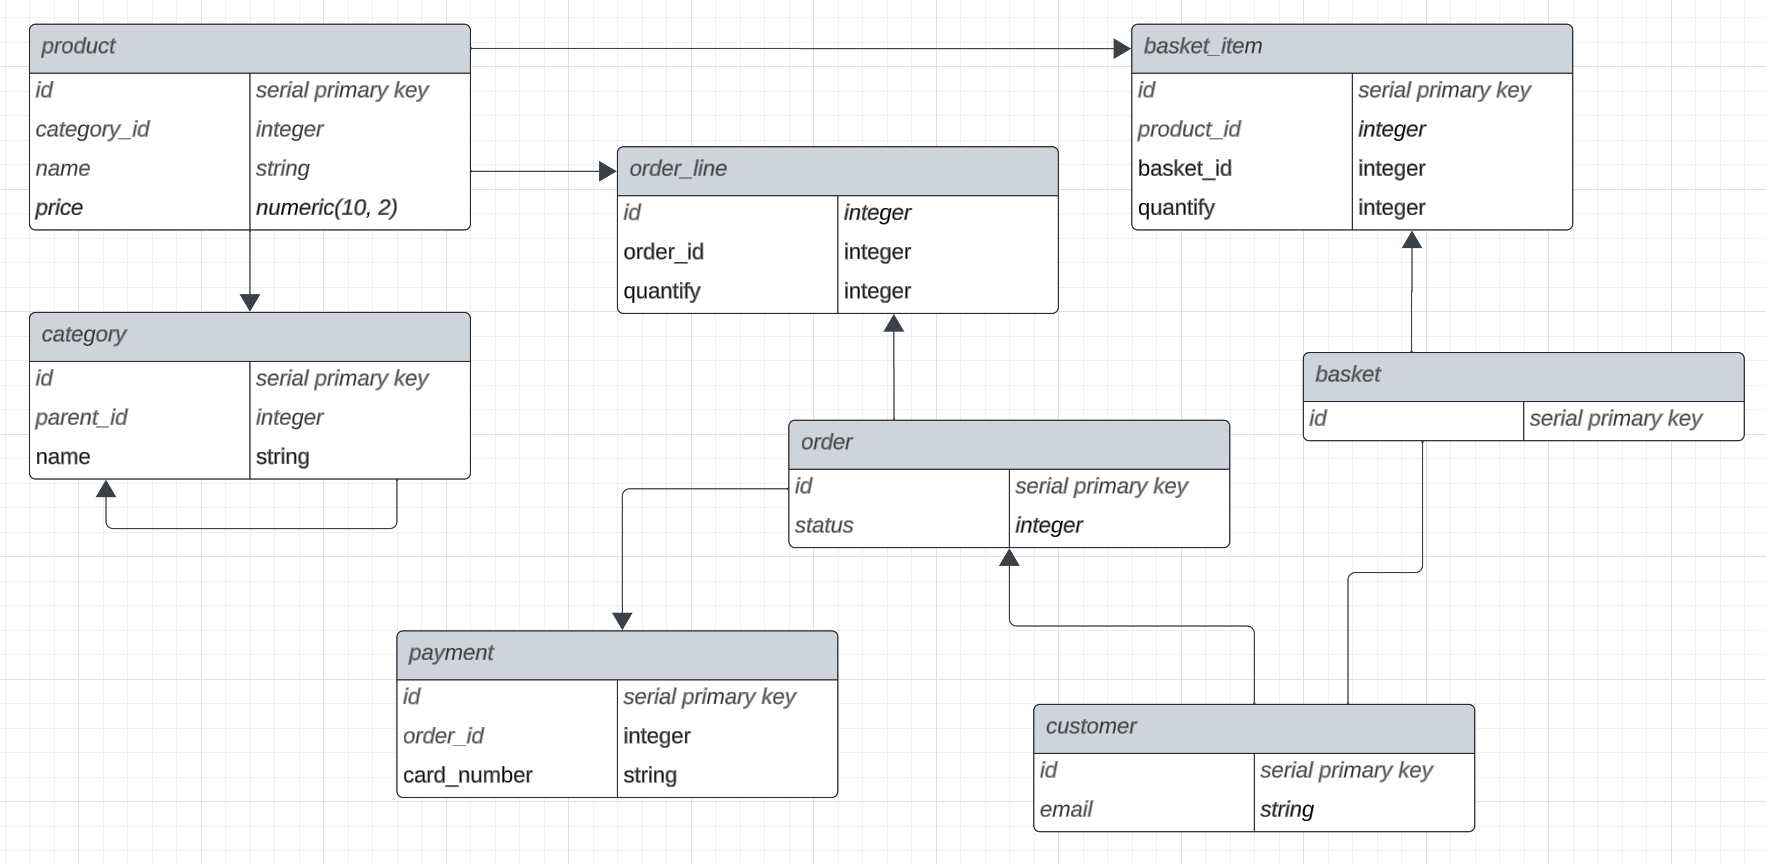
On en déduit qu’un client peut créer un panier et y ajouter plusieurs produits en quantités variables.
Un produit appartient à une catégorie, laquelle peut avoir des catégories parentes.
Les paniers deviennent des commandes, qui peuvent être réglées en plusieurs paiements.
Comme indiqué, il s’agit d’une vision très simplifiée des relations et attributs d’une application e-commerce, mais elle suffit pour ce tutoriel.
Dans une base relationnelle, cette étape préoccupe moins. SQL est un langage extrêmement puissant qui, pour peu que le schéma soit bien conçu, nous laisse interroger et manipuler les données avec une grande flexibilité. Ce n’est pas le cas avec le pattern « table unique » en NoSQL, car nous devons stocker les données dénormalisées et prêtes à être consommées directement par l’application.
Voici les schémas d’accès que notre application e-commerce pourrait nécessiter :
NoSQL Workbench est un outil gratuit d’AWS pour modéliser des tables DynamoDB.
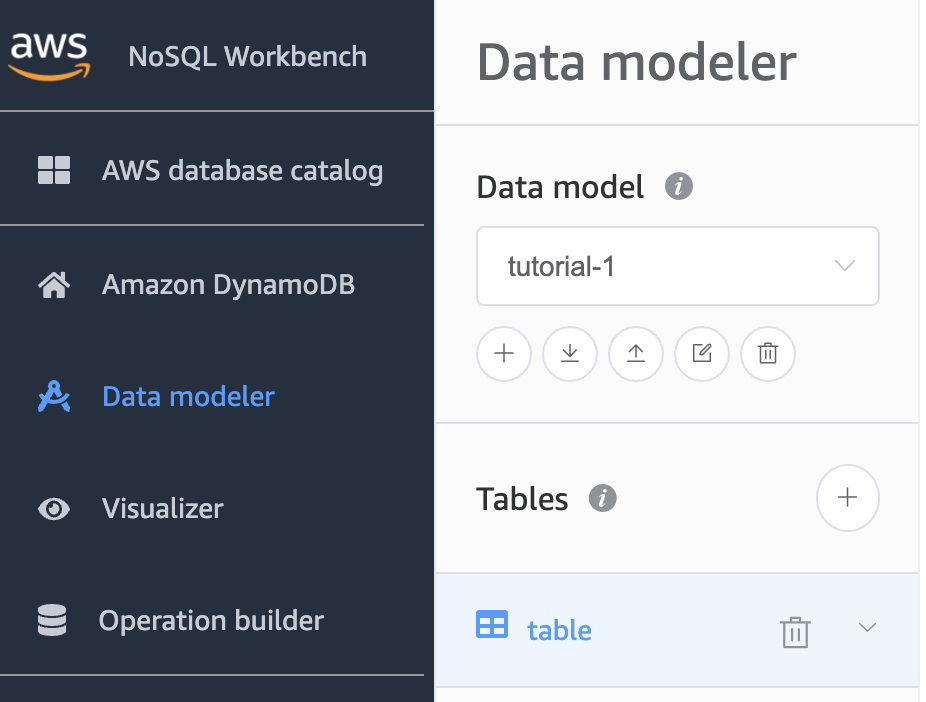
Allez dans le Data modeler et créez un nouveau modèle de données avec une nouvelle table :
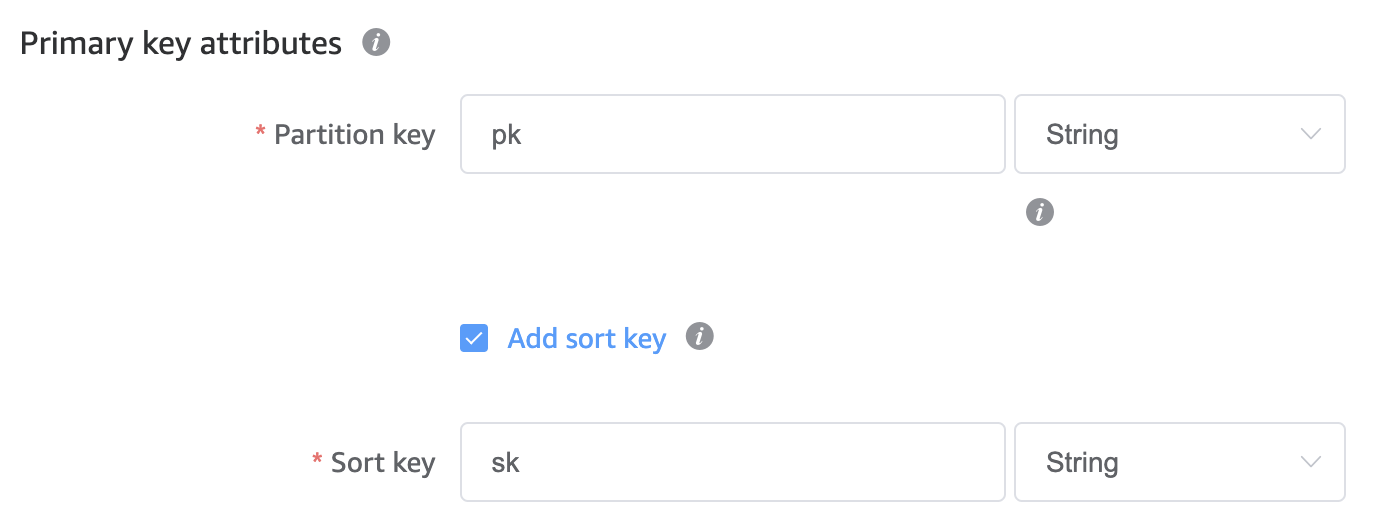
Nous allons garder des noms génériques pour les clés primaires : PK et SK (chaînes).
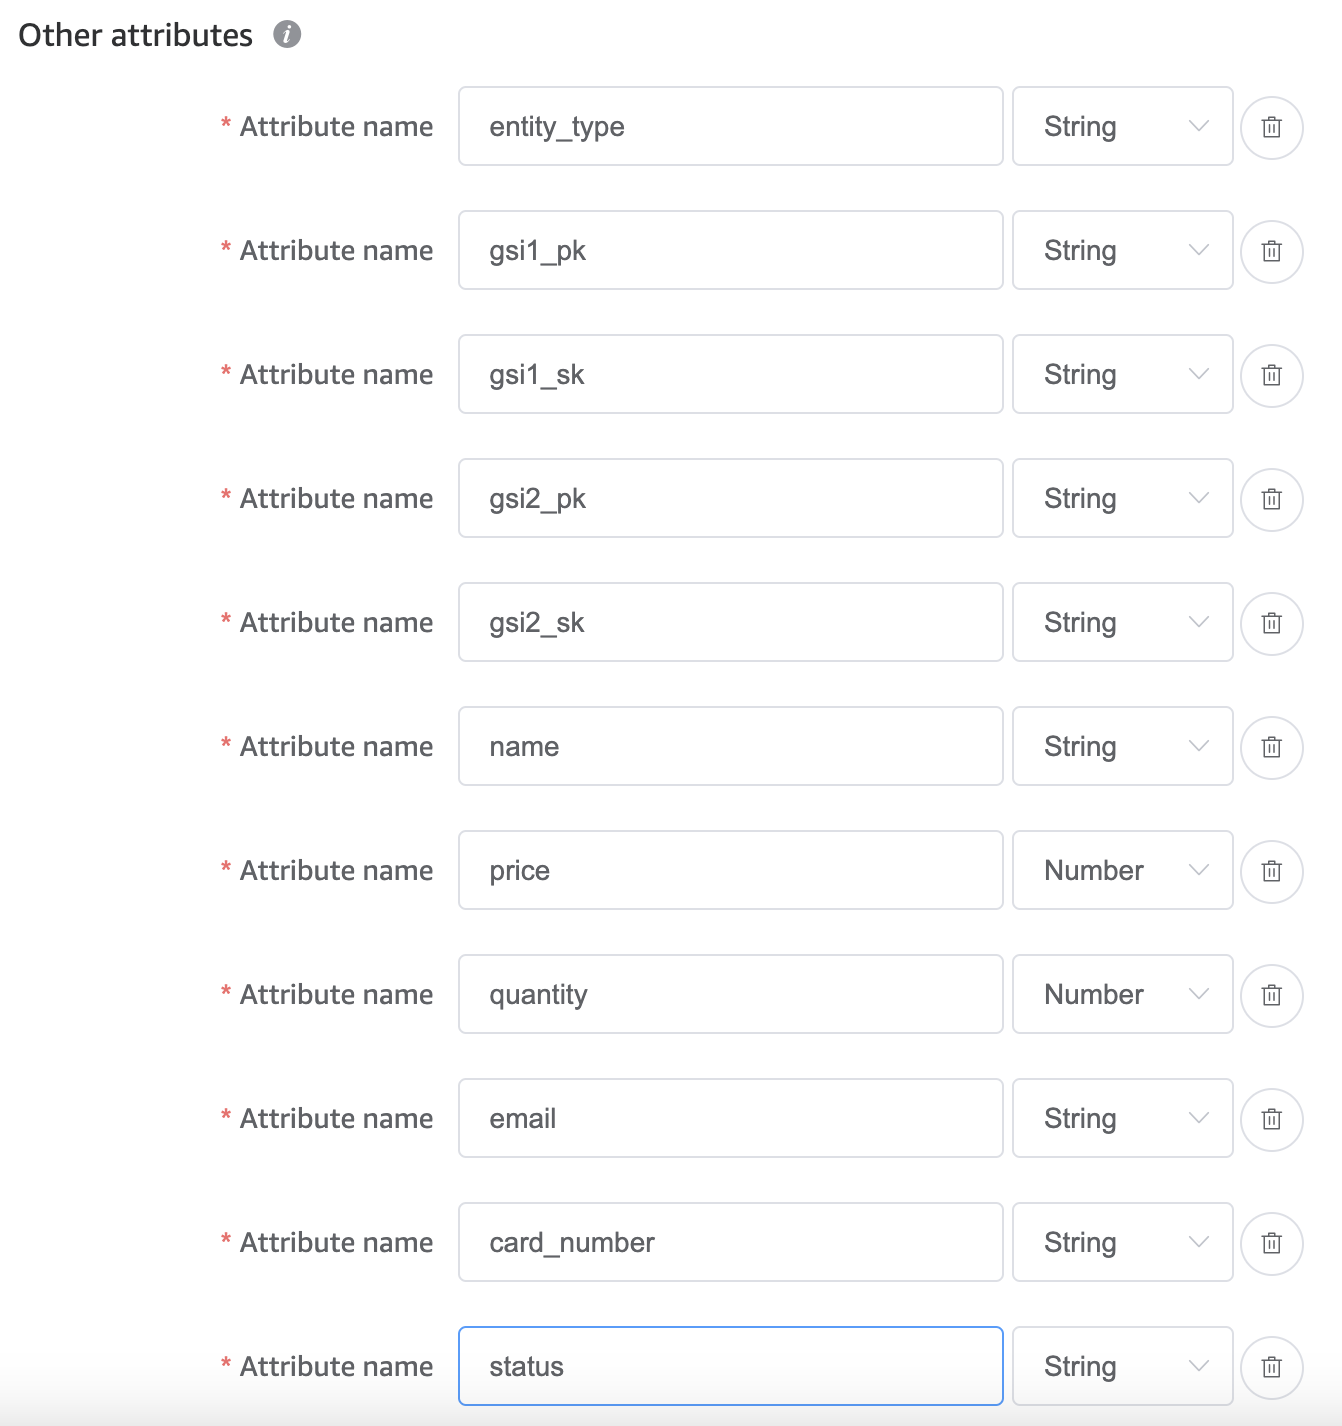
Pour les attributs supplémentaires, nous stockerons le entity_type ainsi que deux paires d’attributs de clé primaire pour les GSI (PK et SK).
Un GSI est un index secondaire global, une copie de votre table que DynamoDB maintient à jour (de façon asynchrone !) mais stockée avec d’autres paires de clés primaires. C’est le mécanisme clé qui permet à une table unique de supporter plusieurs schémas d’accès. Nous y reviendrons ; pour l’heure, retenez que ces clés stockent les clés primaires d’entités liées.
Les autres attributs à ajouter sont les attributs non clés de nos données (remarque : cette étape ne concerne que la phase de design et ne sera pas explicitement définie lors du provisionnement de la table réelle) :
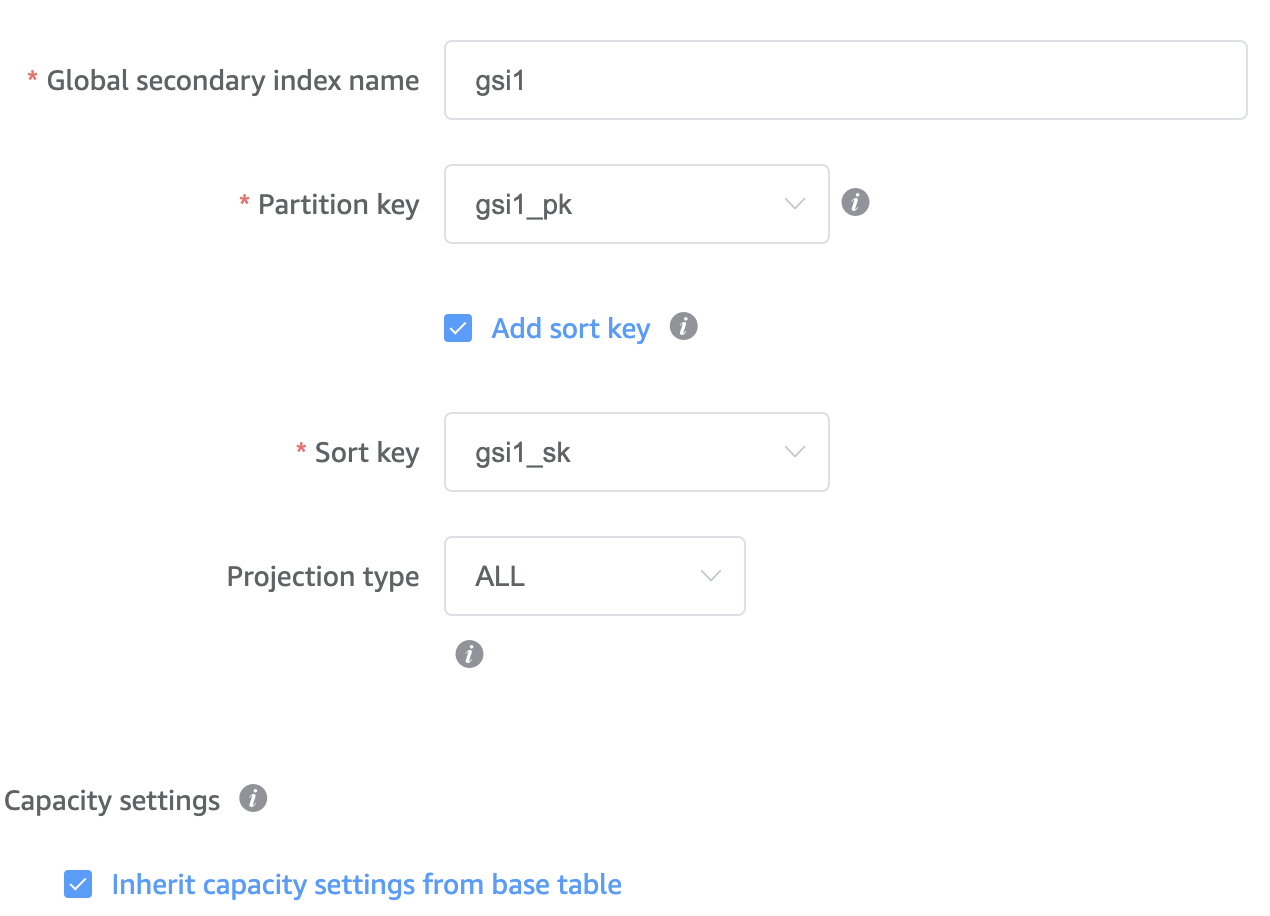
Ensuite, ajoutons les deux GSI à l’aide des clés définies à l’étape précédente :
Enregistrez, puis cliquez sur visualize the data model. Vous devriez voir votre table, encore vide. Cliquez sur edit table, puis en haut à droite sur edit data pour ajouter de nouvelles lignes :
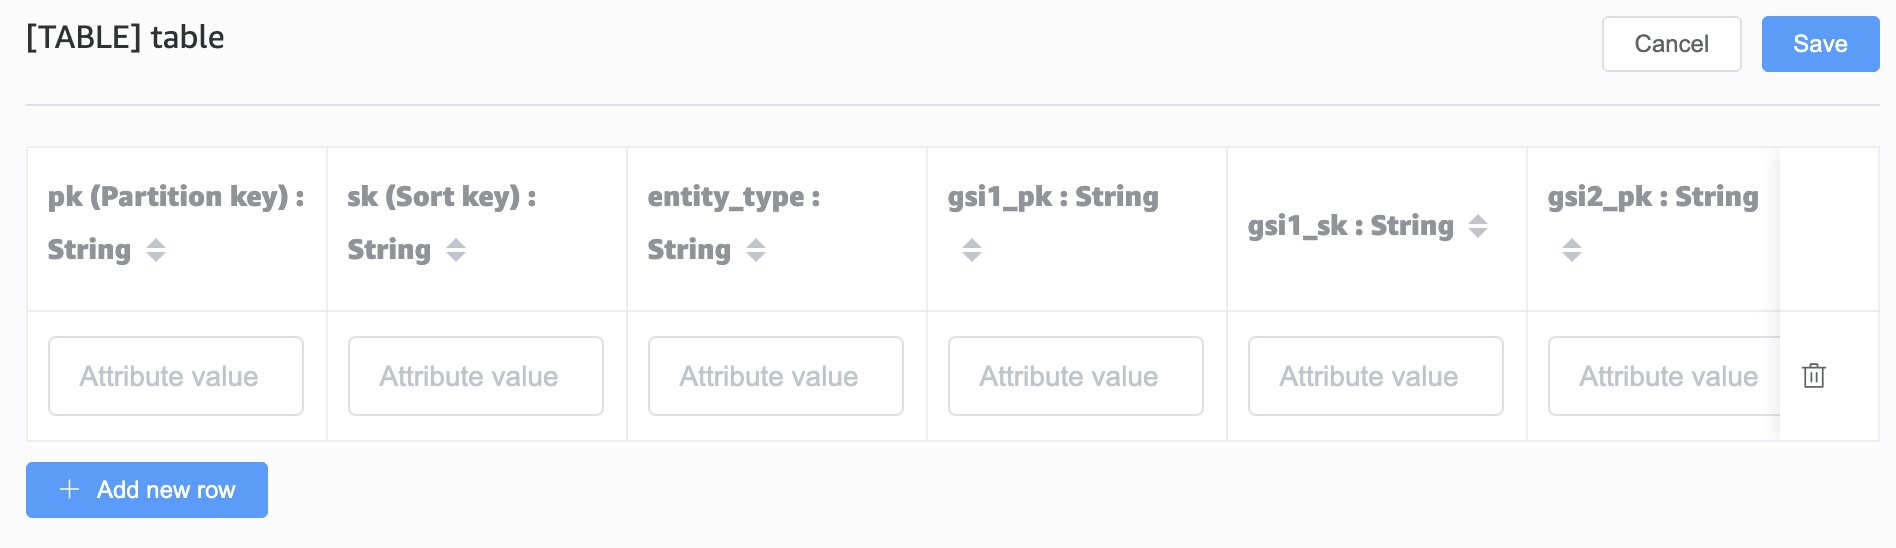
Avant d’ajouter des données, définissons les préfixes de clés primaires pour chaque entité :
|
product |
p# |
|
category |
c# |
|
customer (user) |
u# |
|
basket |
b# |
|
basket item |
bi# |
|
order |
o# |
|
order line |
ol# |
|
payment |
py# |
|
invoice |
i# |
La majorité des schémas d’accès tournent autour du client. Pour notre index primaire, nous utiliserons donc l’ID client comme clé de partition principale, et l’enregistrement client lui-même sera identifié par une clé de tri égale à l’ID client.
Nous pouvons ensuite créer facilement les relations client→commandes et client→paniers en réutilisant la même clé de partition avec une clé de tri unique.
Notre vue agrégée ressemble maintenant à ceci :
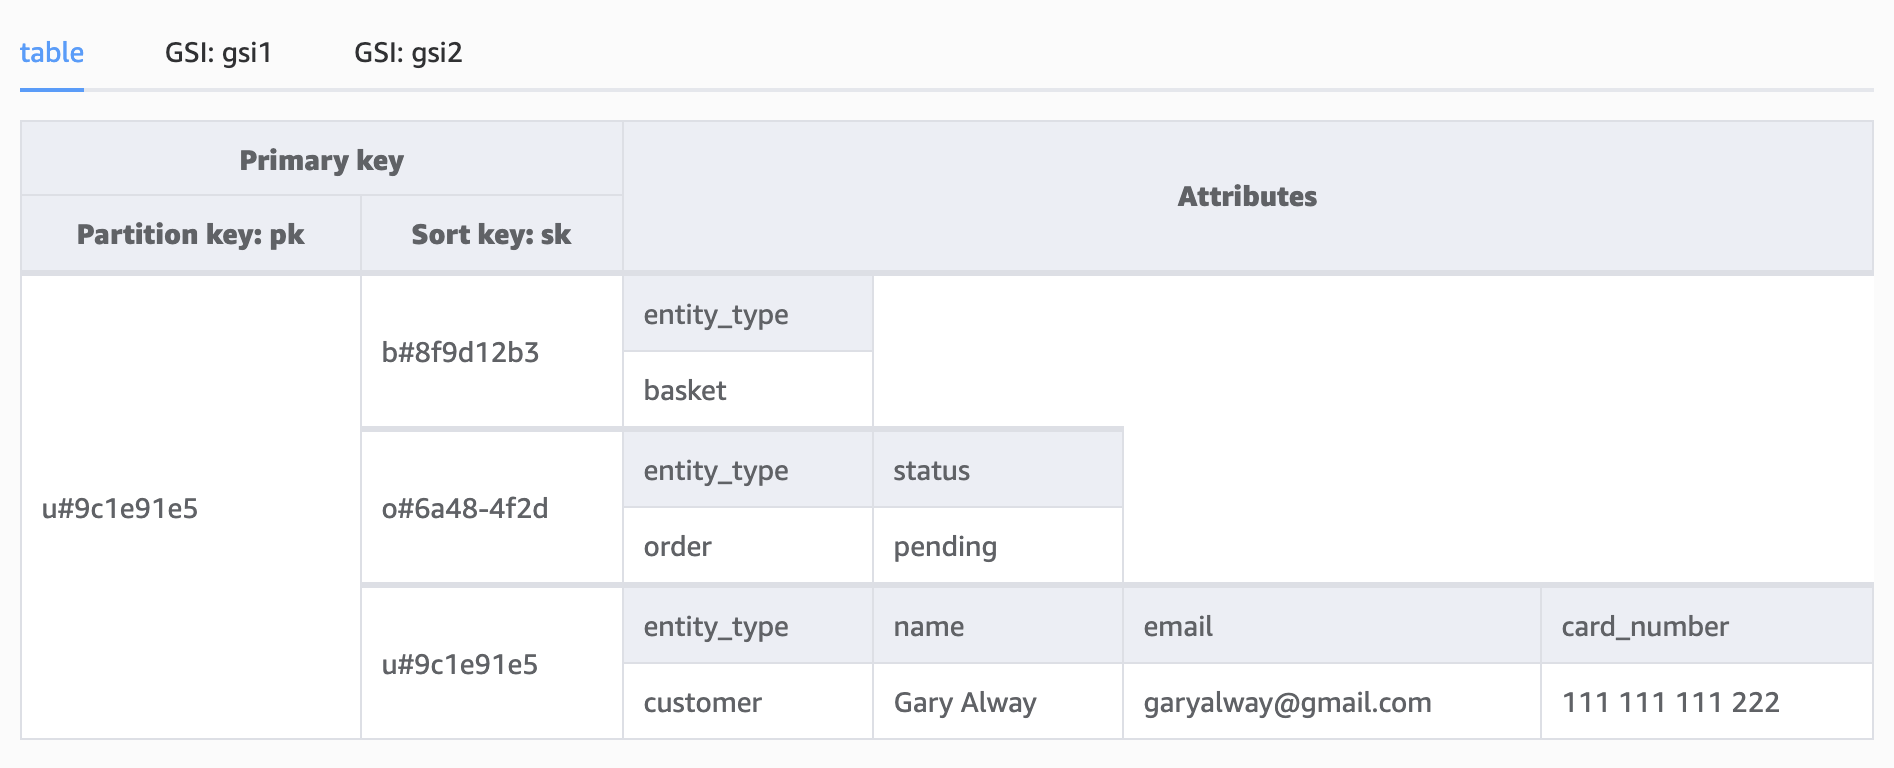
Nous pouvons interroger ces trois enregistrements en une seule commande, en requêtant toute la partition du client :
export const getAllCustomerRecords = async (id: string) =>
  dynamoClient
    .query({
      TableName: TABLE_NAME,
      KeyConditionExpression: "pk=:pk",
      ExpressionAttributeValues: {
        ":pk": valueToAttributeValue(addPrefix(id, CUSTOMER_PREFIX)),
      },
    })
    .then((result) => result.Items);
À mesure que la table grossit, ce type de requête peut devenir moins efficace : il renverra toutes les commandes passées par le client, ainsi que les autres enregistrements (paniers, factures, etc.). Mais il est utile de savoir que nous pouvons récupérer toutes les données client en une seule requête si nécessaire.
Un léger ajustement des valeurs d’attributs d’expression, avec une correspondance partielle (begins_with) sur la clé de tri, nous permet d’interroger :
L’enseignement clé : comment modéliser des relations un-à-un et un-à-plusieurs en NoSQL.
Ces entités illustrent une autre relation un-à-plusieurs : une catégorie peut contenir de nombreux produits.
Les catégories ont aussi une hiérarchie : une catégorie peut avoir des sous-catégories, et les produits peuvent se trouver n’importe où dans cet arbre.
Modélisons cela avec des livres, répartis en fiction et non-fiction.
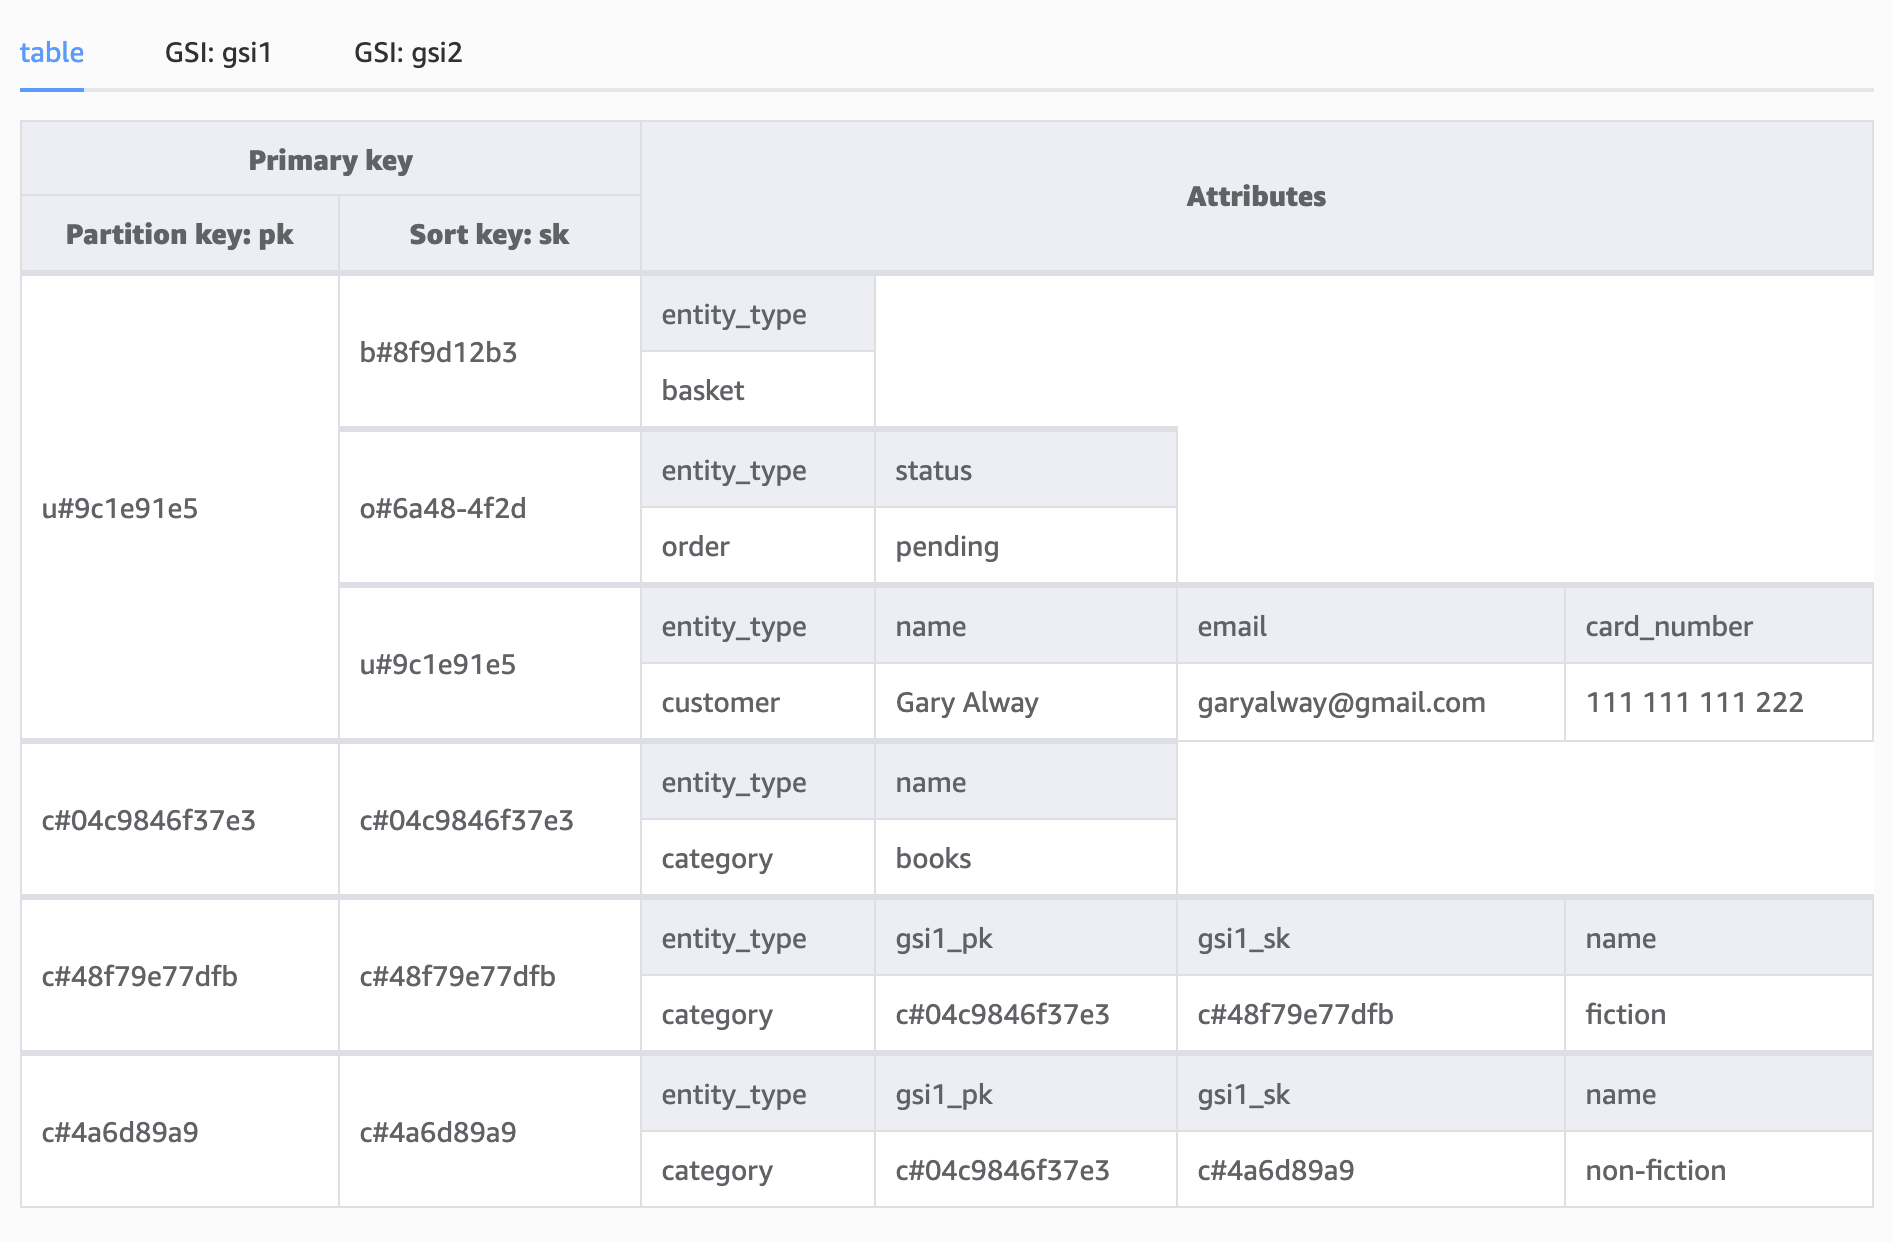
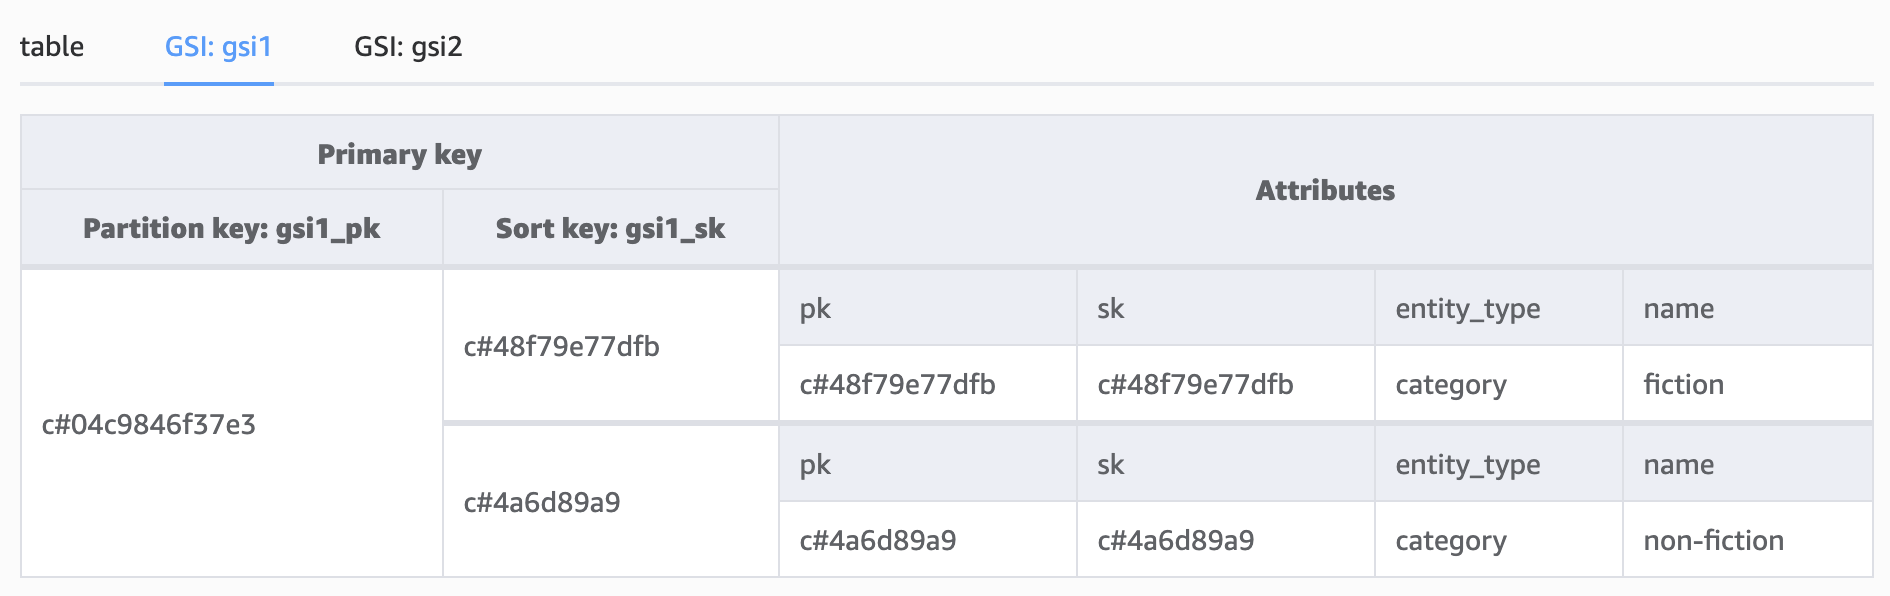
Remarquez que nous avons renseigné les clés d’attribut GSI pour les sous-catégories, en positionnant GSI1_PK sur l’ID de la catégorie parente et GSI1_SK sur l’ID de la sous-catégorie. Cela nous permet d’interroger toutes les sous-catégories d’une catégorie via GSI1 :
Le même index, GSI1, ne sert pas qu’aux relations un-à-plusieurs. Par exemple, si nous voulons rechercher un client par email, le modèle actuel ne le permet pas directement, sauf à changer légèrement la manière d’enregistrer les données :
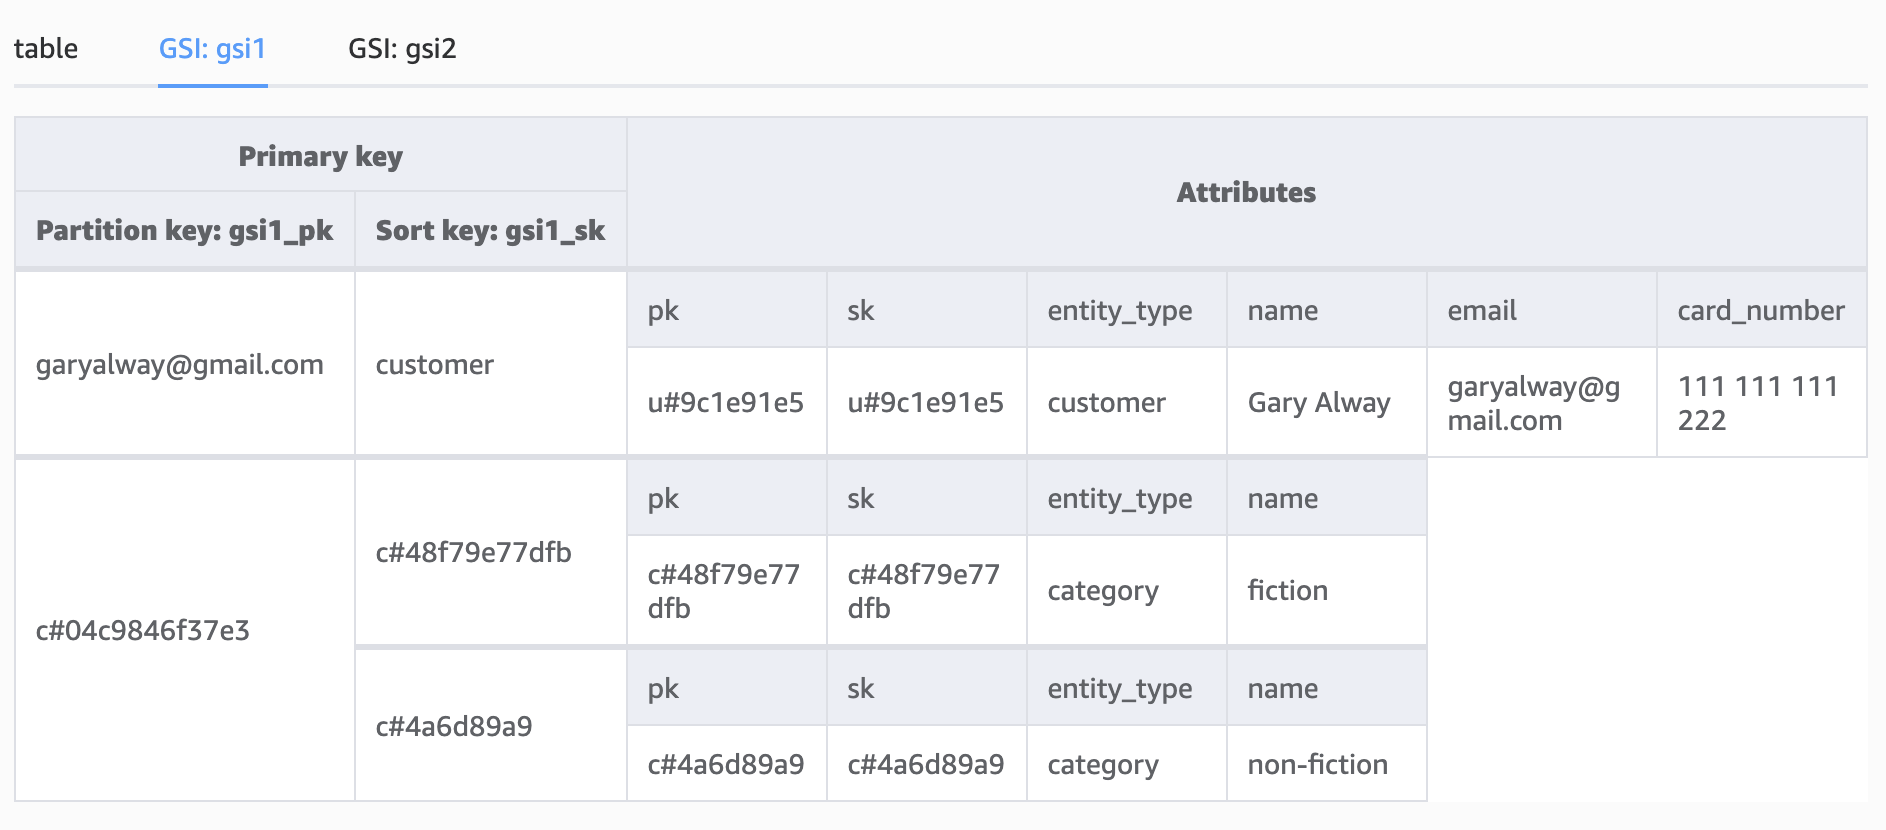
En stockant l’adresse email du client et le type d’entité comme PK et SK du GSI :
Pour faciliter la distribution des données dans DynamoDB, on peut aller plus loin et stocker l’email sous forme de hachage.
export const getCustomerByEmail = async (email: string) =>
  dynamoClient
    .query({
      TableName: TABLE_NAME,
      IndexName: "gsi1",
      KeyConditionExpression: "gsi1_pk = :email AND gsi1_sk = :entityType",
      ExpressionAttributeValues: {
        ":email": valueToAttributeValue(email),
        ":entityType": valueToAttributeValue(entityType),
      },
    })
    .then(({ Items }) => Items?.[0]);
Jusqu’ici, vous vous demandiez peut-être pourquoi tous les index portent des noms génériques et des clés nommées simplement PK et SK. La réponse devrait être claire : les données que nous stockons et les index que nous maintenons sont flexibles et capables de supporter plusieurs schémas d’accès selon le type d’entité.
Voici le code Terraform de la table utilisée jusqu’à présent :
resource "aws_dynamodb_table" "tutorial-1" {
  name = "tutorial-1"
  billing_mode = "PAY_PER_REQUEST"
  hash_key = "pk"
  range_key = "sk"


  attribute {
    name = "pk"
    type = "S"
  }


  attribute {
    name = "sk"
    type = "S"
  }


  attribute {
    name = "gsi1_pk"
    type = "S"
  }


  attribute {
    name = "gsi1_sk"
    type = "S"
  }


  attribute {
    name = "gsi2_pk"
    type = "S"
  }


  attribute {
    name = "gsi2_sk"
    type = "S"
  }


  global_secondary_index {
    name = "gsi1"
    hash_key = "gsi1_pk"
    range_key = "gsi1_sk"
    projection_type = "ALL"
  }


  global_secondary_index {
    name = "gsi2"
    hash_key = "gsi2_pk"
    range_key = "gsi2_sk"
    projection_type = "ALL"
  }
}
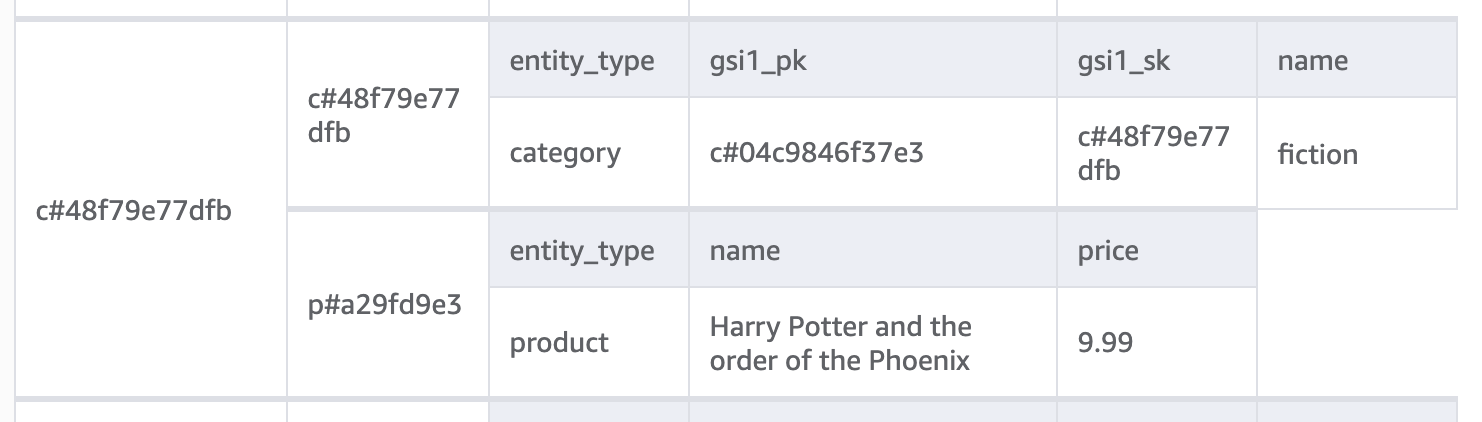
Le stockage des produits suit le même schéma un-à-plusieurs : la clé de partition est l’ID de catégorie et la clé de tri est l’ID produit :
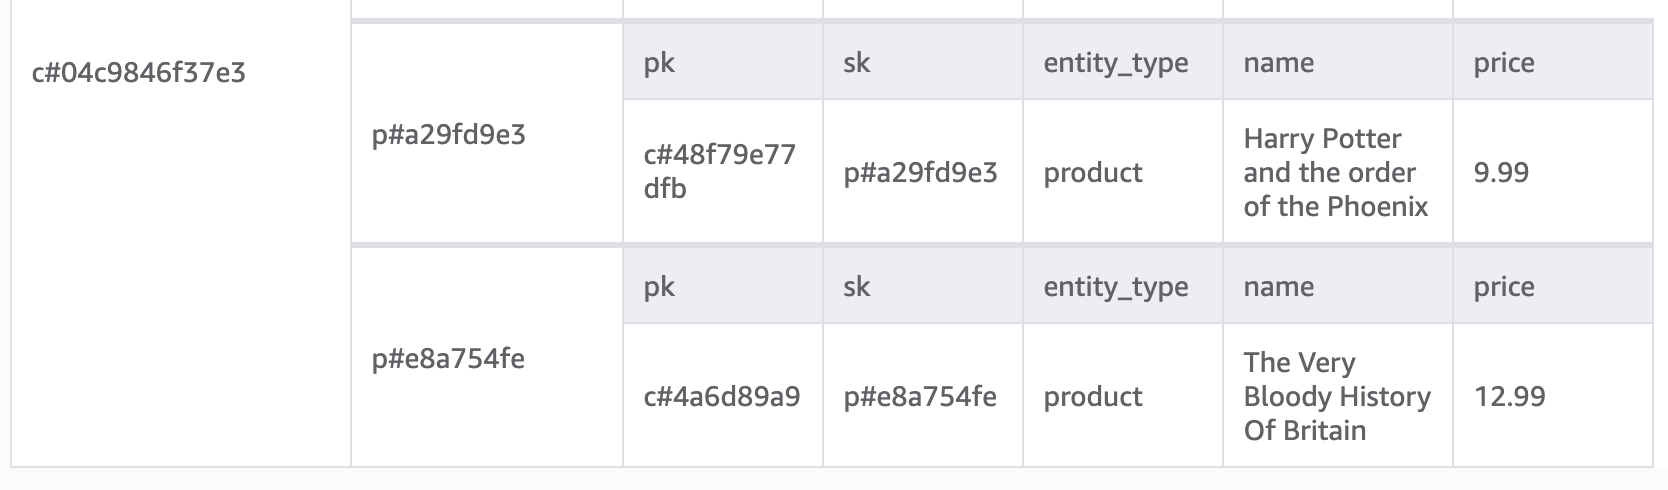
En ajoutant la catégorie parente dans GSI1, nous pouvons interroger tous les livres de notre base :
En production, nous pourrions utiliser DynamoDB Streams pour pousser les données vers un cluster Elasticsearch et permettre la recherche par titre de livre. Mais comment, avec le modèle actuel, interroger par titre de produit ?
GSI1 étant déjà utilisé, nous pouvons exploiter GSI2 pour cela :
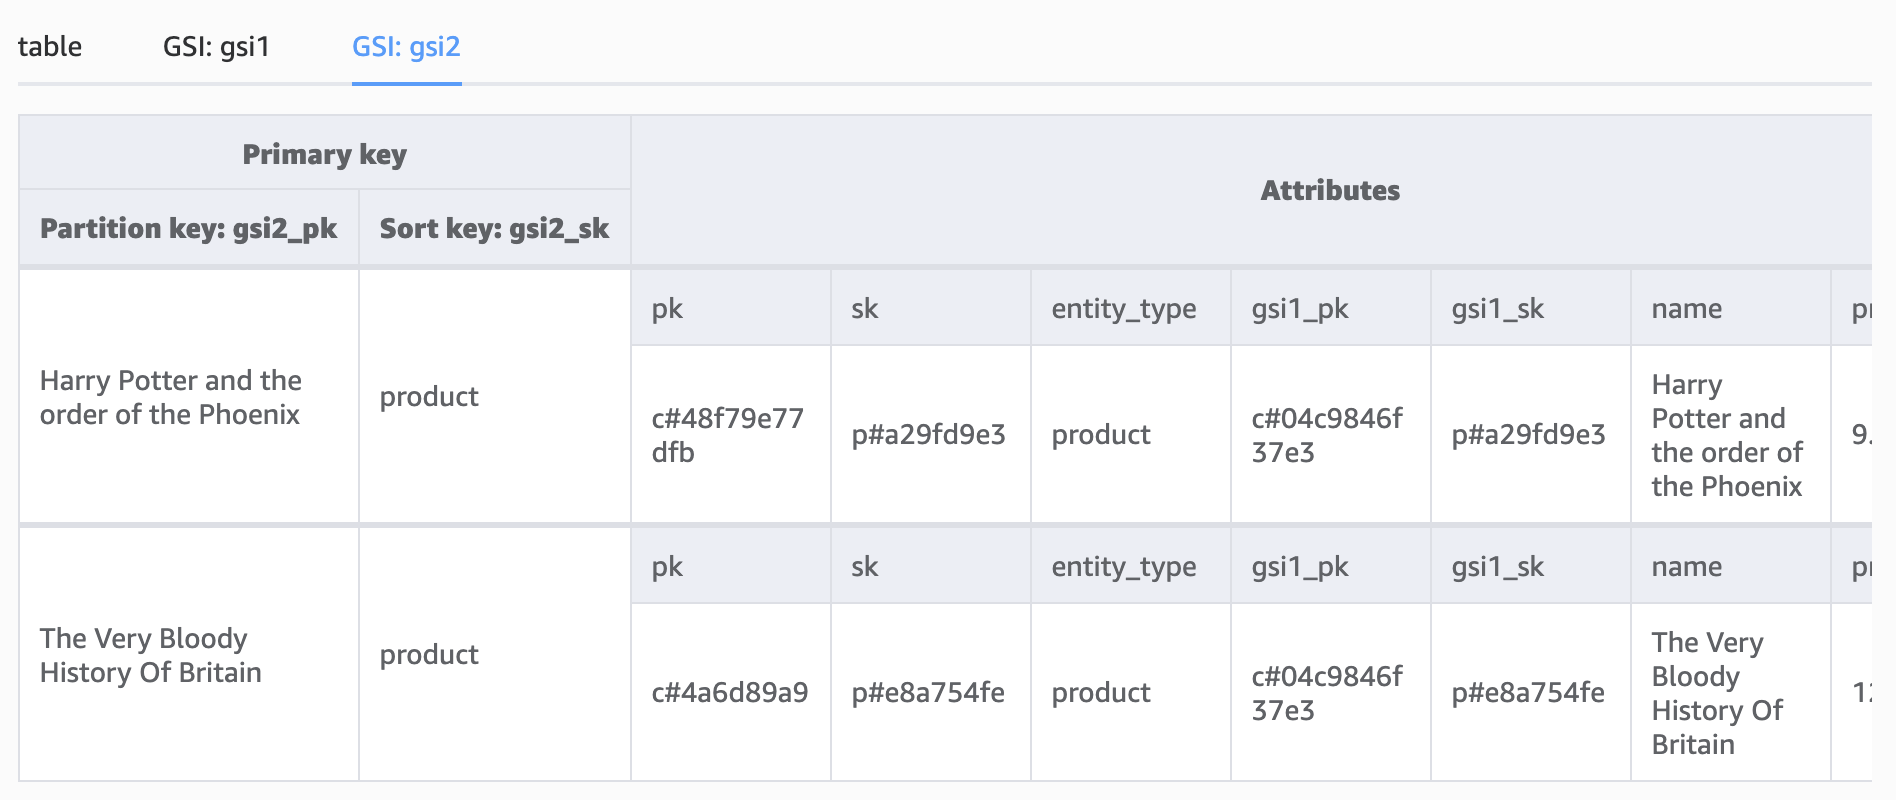
Rappel : pour interroger DynamoDB, vous devez fournir la clé de partition exacte. Cette implémentation n’est donc pas optimale, mais elle illustre comment utiliser trois index pour des schémas d’accès différents.
Dans mon prochain tutoriel, je montrerai comment résoudre ce point via l’intégration à un index de recherche.
Les articles de panier et les lignes de commande sont stockés dans la partition du client ; nous pouvons utiliser les GSI pour interroger tous les produits d’un panier, tous les produits d’une commande, et l’ensemble des produits qu’un client a commandés.
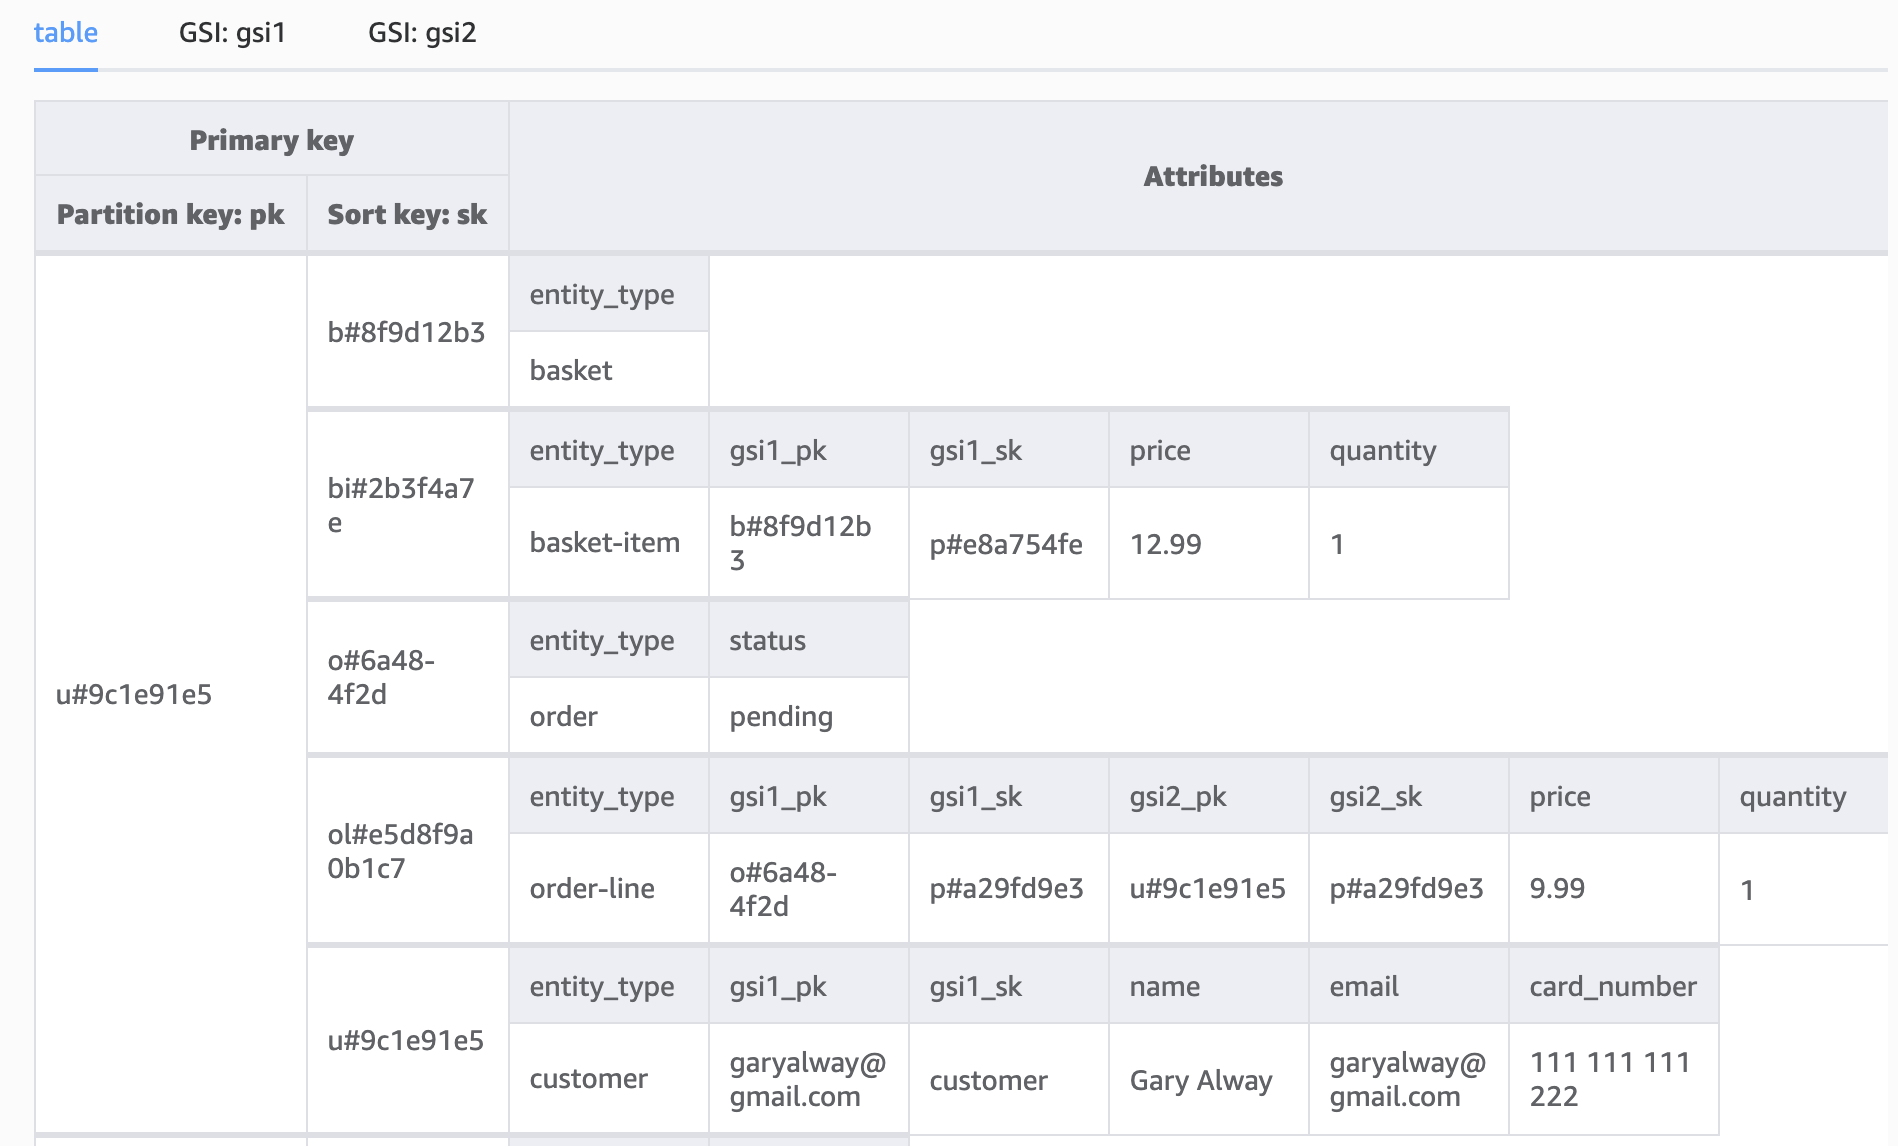
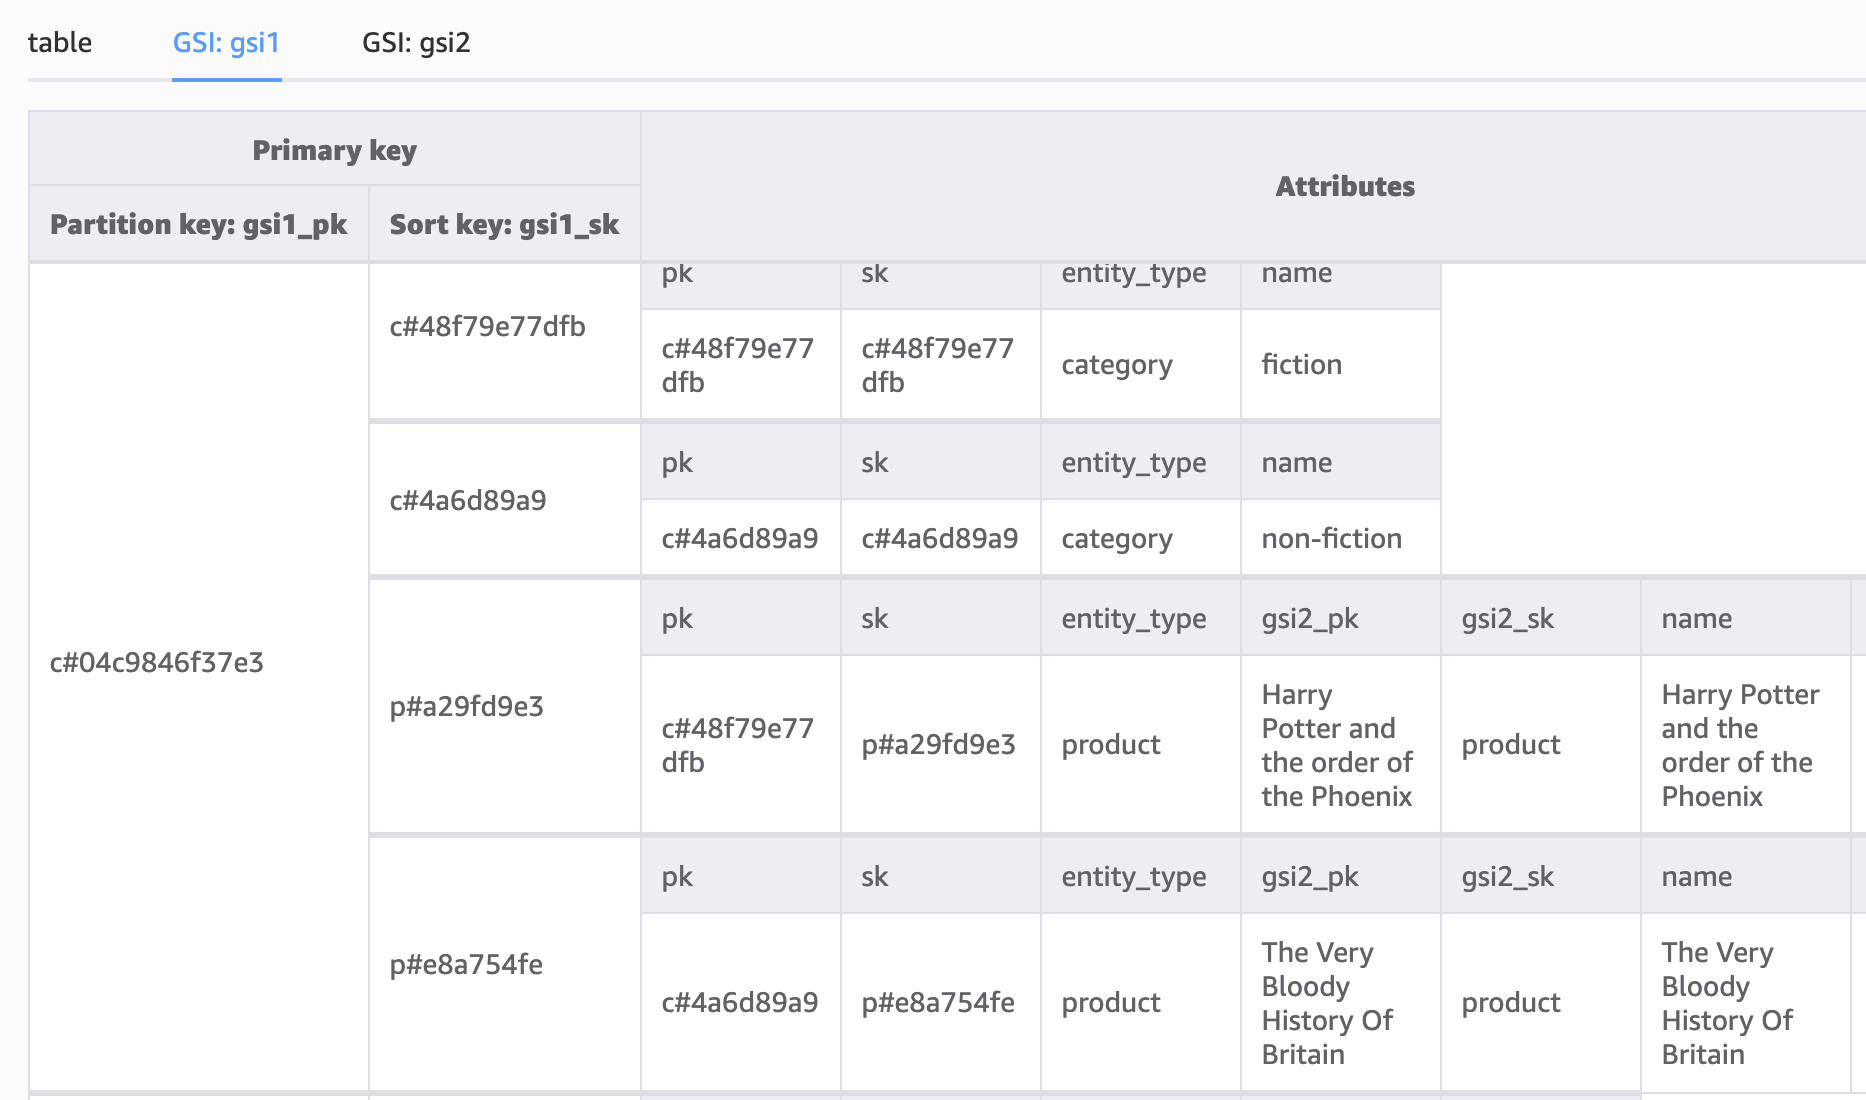
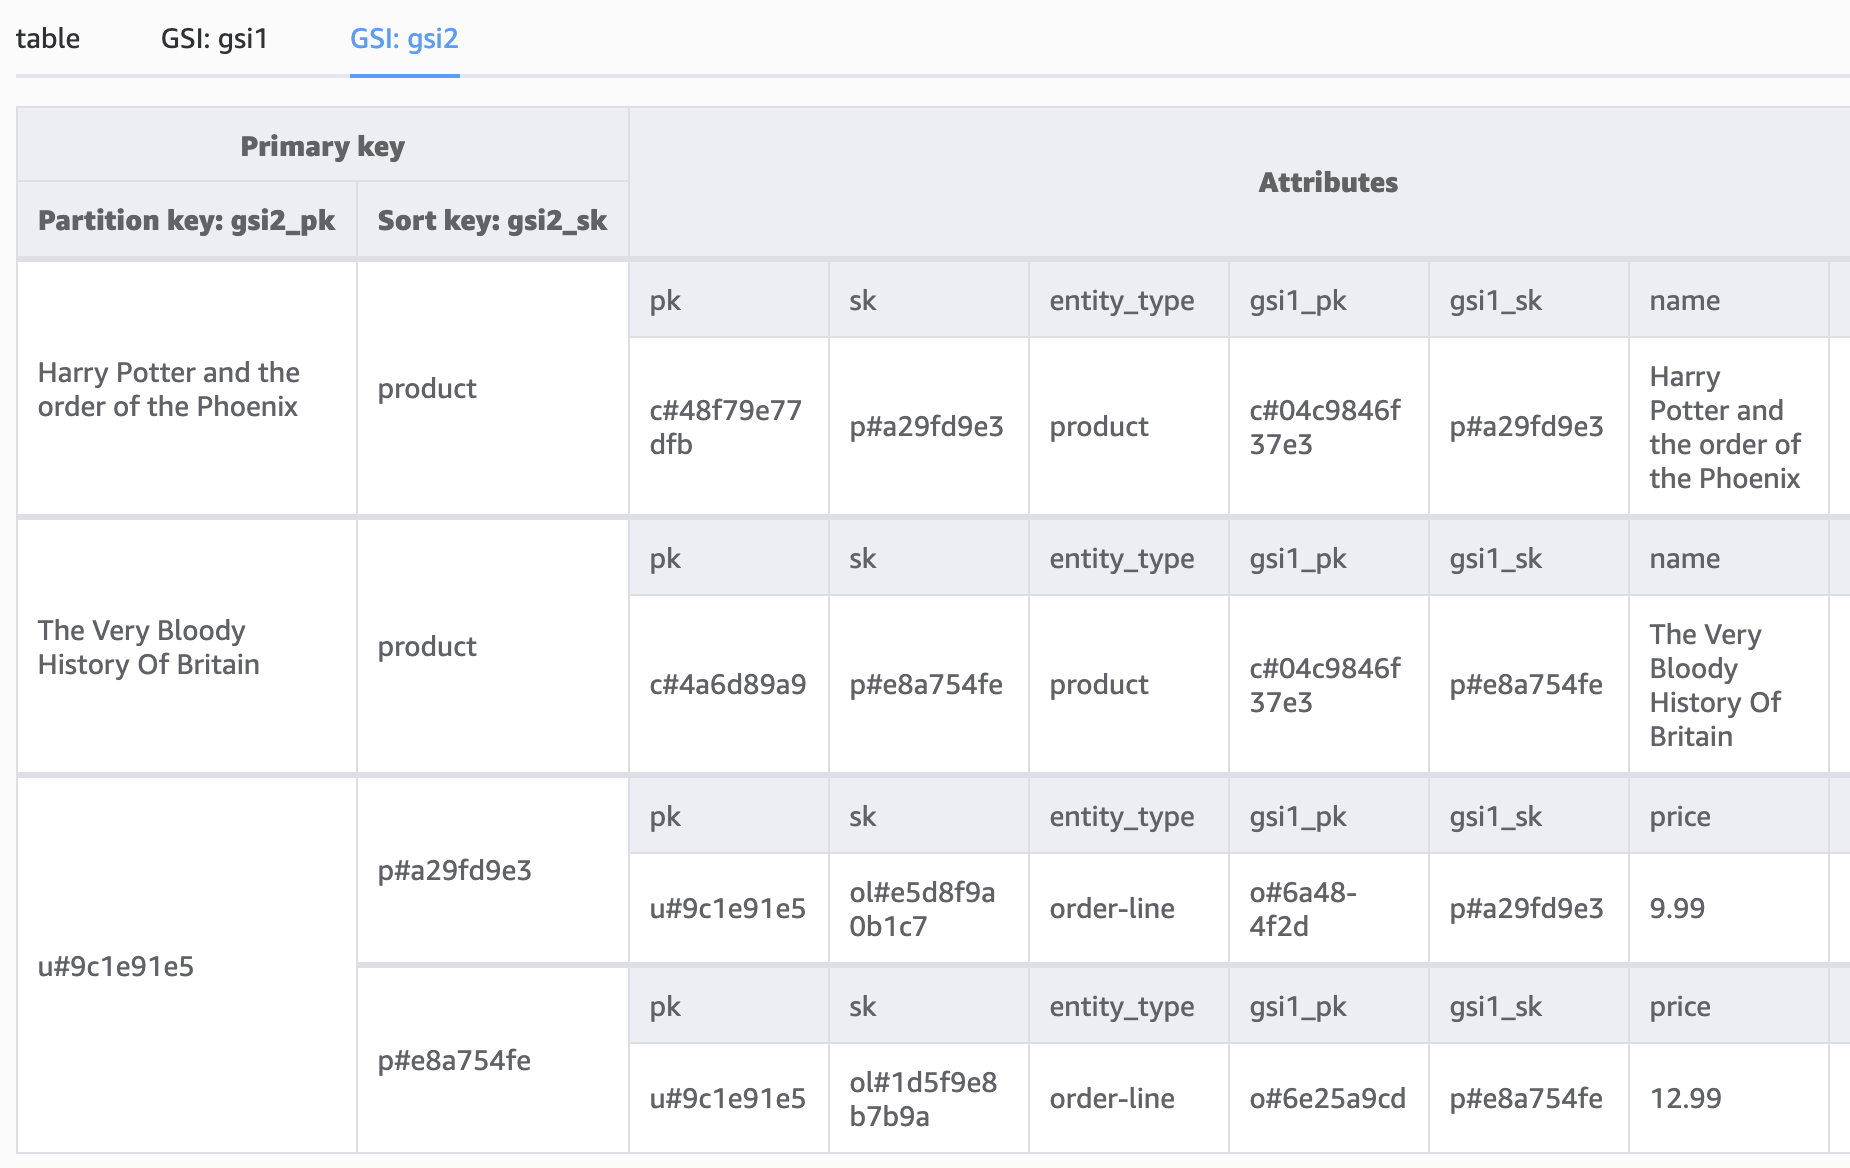
Ce dernier exemple montre l’historique de commandes d’un client avec deux produits issus de deux commandes différentes.
Si la modélisation des données en SQL vous intéresse, notre webinaire Data Modeling in SQL complète utilement la compréhension de la modélisation NoSQL.
L’usage d’une table unique avec DynamoDB offre de nombreux avantages, mais impose aussi des défis et points d’attention :
Gérer toutes vos données dans une seule table peut devenir complexe, surtout à mesure que l’application grandit et évolue.
Vous devez planifier et structurer soigneusement vos données pour répondre à divers schémas de requêtes. De plus, l’efficacité d’un design en table unique dépend étroitement de votre logique applicative ; elle joue un rôle central pour garantir un accès fluide et des requêtes performantes.
Réfléchir à la fois à la structure des données et à la logique applicative est indispensable pour un design en table unique efficace.
DynamoDB propose des index secondaires globaux pour supporter différents schémas de requêtes, mais il faut les provisionner et les maintenir, ce qui accroît les coûts et la complexité.
Le choix de la bonne clé de partition est crucial pour une distribution homogène des données et des performances de requête. Un mauvais choix peut engendrer des partitions « chaudes » et des goulets d’étranglement.
Avec la croissance du volume, votre table unique peut devenir très volumineuse, impactant le coût de stockage ainsi que les coûts de lecture et d’écriture.
DynamoDB ne prend pas en charge nativement la recherche plein texte ; il faut intégrer des services comme Elasticsearch pour cette fonctionnalité.
Modifier le schéma de table peut s’avérer délicat, surtout en production. Vous devrez peut-être migrer des données existantes ou adapter votre logique applicative.
Selon votre choix de cohérence de lecture (forte ou éventuelle), vous devrez anticiper d’éventuels défis de cohérence des données, en gardant à l’esprit que les GSI sont répliqués de manière asynchrone.
Les capacités de requête de DynamoDB sont puissantes, mais moins flexibles que celles du SQL.
Pour approfondir la conception efficace de bases et contourner ces défis, consultez notre cours Database Design.
Avec une base NoSQL, il est crucial de se détacher des schémas relationnels familiers : il faut « désapprendre » pour mieux reconstruire.
Adopter le pattern de la table unique, c’est se donner les moyens d’une base escalable à l’échelle mondiale, prête à absorber de très forts trafics avec des performances fiables et prévisibles.
Mais cet avantage se mérite : il exige en amont une planification minutieuse et une implémentation réfléchie de la structure de la base et de la logique applicative.
Consolidez vos acquis avec notre cours NoSQL concepts !
Commencez votre aventure data dès aujourd’hui !
Cours
Cours
Cours