
लर्निंग पाथ
आर्टिफिशियल इंटेलिजेंस (AI) अब सिर्फ विज्ञान-कथा का विचार नहीं रहा; यह हमारे रोजमर्रा के नवाचारों की प्रेरक शक्ति है। नेटफ्लिक्स द्वारा आपकी अगली पसंदीदा सीरीज़ सुझाने से लेकर टेस्ला की सेल्फ-ड्राइविंग कारों और Amazon Alexa के वर्चुअल असिस्टेंट तक—AI उन अत्याधुनिक तकनीकों को शक्ति देता है जो हमारी ज़िंदगी को आकार देती हैं। लेकिन क्या आपने कभी सोचा है:
इन प्रणालियों के पीछे क्या है?
ये हकीकत में कैसे बदलती हैं?
इसका उत्तर AI प्रोजेक्ट साइकिल में छिपा है—एक संरचित ढांचा जो विचारों को असरदार समाधानों में बदलता है।
यह लेख AI प्रोजेक्ट साइकिल के सात मुख्य चरणों को तोड़कर समझाता है कि किस तरह हर कदम—समस्या निर्धारण से लेकर डिप्लॉयमेंट तक—प्रभावी AI प्रणालियाँ बनाने में योगदान देता है। यदि आप AI विषय में नए हैं, तो हमारी AI Fundamentals स्किल ट्रैक ज़रूर देखें और बुनियादी समझ में महारत हासिल करें।
AI प्रोजेक्ट साइकिल क्या है?
AI प्रोजेक्ट साइकिल, आर्टिफिशियल इंटेलिजेंस (AI) समाधानों को विशिष्ट समस्याओं के समाधान हेतु विकसित और डिप्लॉय करने का चरणबद्ध ढांचा है, जो विचारों को प्रभावशाली, वास्तविक-जीवन अनुप्रयोगों में बदलता है।
कई चरणों में फैला यह ढांचा, समस्या की पहचान से लेकर मॉडल डिप्लॉयमेंट तक के कार्यों में संगठनों और व्यक्तियों का मार्गदर्शन करता है। हर कदम स्पष्ट रोडमैप देकर परिभाषित लक्ष्यों और अंतिम सफलता को हासिल करने में AI समाधान की सफलता सुनिश्चित करने में अहम भूमिका निभाता है।
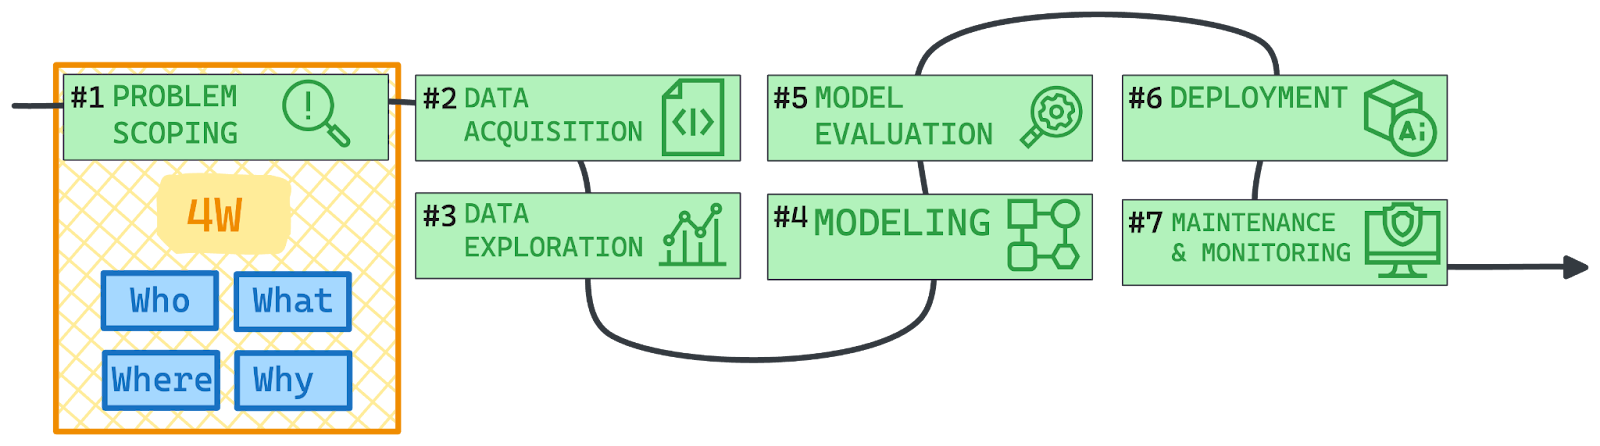
चित्र: लेखक द्वारा
AI प्रोजेक्ट लाइफसाइकल: चरण-दर-चरण
आइए AI प्रोजेक्ट लाइफसाइकल के हर हिस्से को विस्तार से समझें।
चरण 1 - समस्या निर्धारण (Problem scoping)
किसी भी क्षेत्र में, किसी भी प्रोजेक्ट की शुरुआत से पहले, जिस समस्या को हम सुलझाना चाहते हैं उसे पहचानना एक मूलभूत कार्य है। इसी वजह से AI प्रोजेक्ट साइकिल भी अलग नहीं है और इसे समस्या निर्धारण के चरण से ही शुरू होना चाहिए।
यह उस चुनौती या अवसर को परिभाषित करने की प्रक्रिया है जिसे AI संबोधित कर सकता है, विशिष्ट उद्देश्यों को तय करना और सफलता के स्पष्ट मापदंड स्थापित करना।
4Ws समस्या कैनवस
समस्या को प्रभावी ढंग से स्कोप करने के लिए, विस्तृत आवश्यकताएँ जुटाना और संदर्भ का विश्लेषण करना जरूरी है—इसके लिए 4Ws समस्या कैनवस का उपयोग करें—एक संरचित ढांचा जो समस्या की समग्र समझ सुनिश्चित करता है:
- Who (कौन): सबसे पहले उन हितधारकों की पहचान करें जो समस्या से प्रभावित हैं—वे व्यक्ति या संगठन जो प्रस्तावित समाधान से लाभान्वित होंगे।
- What (क्या): इसके बाद समस्या की प्रकृति को समझें। इसकी विशेषताओं का विश्लेषण करें, साक्ष्यों से इसके अस्तित्व को मान्य करें, और स्पष्ट करें कि यह समस्या क्यों है।
- Where (कहाँ): अगला कदम है यह निर्धारित करना कि समस्या किन स्थानों और संदर्भों में उत्पन्न होती है। यह समझना कि यह कब और कहाँ होती है, उन पैटर्नों और रुझानों की पहचान में मदद करता है जो प्रभावी समाधान के लिए महत्वपूर्ण हैं।
- Why (क्यों): अंत में, समस्या के समाधान का उद्देश्य स्थापित करें। लाभ, अपेक्षित परिणाम, और वह मूल्य परिभाषित करें जो AI समाधान हितधारकों के लिए लाएगा।
इन प्रश्नों को व्यवस्थित रूप से संबोधित करके, समस्या निर्धारण AI प्रोजेक्ट को व्यावसायिक लक्ष्यों और हितधारकों की अपेक्षाओं के अनुरूप करने की बुनियाद रखता है।
चरण 2 - डेटा अधिग्रहण (Data acquisition)
किसी भी AI प्रोजेक्ट में, डेटा वह ईंधन है जो सीखने को संभव बनाता है। यही कारण है कि स्वच्छ, सुव्यवस्थित और प्रासंगिक डेटा अन्वेषण, मॉडलिंग और डिप्लॉयमेंट जैसे अगले चरणों के लिए ठोस आधार प्रदान करता है। सही तरीके से अधिग्रहित डेटा यह सुनिश्चित करता है कि आपका AI प्रोजेक्ट सही दिशा में शुरू हो, त्रुटियाँ कम हों और प्रभाव अधिकतम हो।
यही डेटा अधिग्रहण का सार है; इसमें आपके AI सिस्टम को ट्रेन और वैलिडेट करने के लिए आवश्यक डेटा का स्रोत ढूंढना, उसे साफ़ करना और व्यवस्थित करना शामिल है। उद्देश्य यह सुनिश्चित करना है कि डेटा व्यापक, सटीक और मौजूदा समस्या के लिए उपयुक्त हो, साथ ही गोपनीयता और नैतिक पहलुओं का ध्यान रखा जाए।
यहाँ प्रमुख चरण दिए गए हैं:
- डेटा संग्रह: विविध स्रोतों से डेटा की पहचान करें और एकत्र करें, जैसे:
- सर्वेक्षण
- वेब स्क्रैपिंग
- सेंसर और कैमरे
- अवलोकनात्मक अध्ययन
- APIs
- डेटा गुणवत्ता आश्वासन: कच्चे डेटा में अक्सर त्रुटियाँ, मिसिंग वैल्यू या असंगतियाँ होती हैं। उपयोग से पहले हमें सुनिश्चित करना चाहिए कि डेटा स्वच्छ है। उच्च-गुणवत्ता वाला डेटा AI मॉडल को प्रभावी ढंग से सीखने और सटीक भविष्यवाणियाँ देने में सक्षम बनाता है।
- फीचर चयन: AI मॉडल के लिए आवश्यक विशिष्ट डेटा विशेषताओं—जिन्हें फीचर्स कहा जाता है—की पहचान करें। प्रासंगिक फीचर्स चुनना मॉडल की सफलता के लिए अत्यंत महत्वपूर्ण है।
- नैतिक विचार: डेटा गोपनीयता की रक्षा करें और संवेदनशील जानकारी का नैतिक प्रबंधन सुनिश्चित करें। इसमें GDPR जैसी विनियमनों का अनुपालन और डेटा उपयोग के बारे में पारदर्शिता बनाए रखना शामिल है।
चरण 3 - डेटा अन्वेषण (Data exploration)
डेटा को देखते समय हमें अक्सर केवल संख्याओं का ढेर दिखता है। हालाँकि, इसका अर्थ निकालना ज़रूरी है। यहीं डेटा अन्वेषण काम आता है, जो हमें छिपे पैटर्न खोजने देता है। यह संख्याओं को ऐसे चित्रों में बदलने के बारे में है जो लोगों के लिए आसानी से समझने योग्य हों। डेटा अन्वेषण, पैटर्न, रुझान और विसंगतियाँ उजागर कर कच्चे डेटा को उपयोगी अंतर्दृष्टि में बदल देता है।
इस प्रक्रिया में कई कदम शामिल होते हैं:
- पैटर्न ढूँढना: ऐसी सह-संबंधों और रुझानों की पहचान करें जो मॉडल विकास में मार्गदर्शन करें।
- डेटा का दृश्यांकन: समझ बढ़ाने और मुख्य अंतर्दृष्टियों को उजागर करने के लिए विजुअल्स से डेटा को सरल बनाएं।
- विसंगतियों का प्रबंधन: आउटलायर्स का पता लगाएँ और उन्हें संबोधित करें ताकि डेटा की अखंडता बनी रहे।
- अगले चरणों का निर्धारण: मॉडलिंग के लिए उपयुक्त विश्लेषणात्मक विधियाँ और टूल्स चुनें।
प्रभावी अन्वेषण सुनिश्चित करता है कि डेटा मॉडलिंग के लिए तैयार है और प्रोजेक्ट उद्देश्यों के अनुरूप है, जो हमें अगले चरण तक ले जाता है:
चरण 4 - मॉडलिंग
मॉडलिंग AI प्रोजेक्ट साइकिल का केंद्र है, जहाँ डेटा को एल्गोरिद्म और गणितीय ढाँचों के माध्यम से उपयोगी अंतर्दृष्टि में बदला जाता है। इस चरण में पहचानी गई समस्या को प्रभावी ढंग से हल करने के लिए AI मॉडलों का चयन, प्रशिक्षण और फाइन-ट्यूनिंग शामिल है।
इस चरण के मुख्य घटक हैं:
- सही मॉडल का चयन: समस्या के अनुरूप AI मॉडल चुनें, जैसे Logistic Regression, Naive Bayes या Recurrent Neural Networks (RNNs) जैसे उन्नत विकल्प। मॉडल का चुनाव समाधान की सटीकता और प्रभावशीलता पर गहरा प्रभाव डालता है।
- मॉडल का प्रशिक्षण: चयनित मॉडल को तैयार किए गए डेटा से ट्रेन करें। प्रशिक्षण AI को डेटा में मौजूद पैटर्न और संबंध सीखने में सक्षम बनाता है, जो भविष्यवाणियाँ या निर्णय लेने की नींव बनते हैं। कार्य की जटिलता के आधार पर यह चरण पर्याप्त कंप्यूट संसाधन और समय ले सकता है।
- फाइन-ट्यूनिंग और अनुकूलन: हाइपरपैरामीटर्स समायोजित करके और आर्किटेक्चर में बदलाव कर मॉडल को परिष्कृत करें ताकि प्रदर्शन बेहतर हो। यह पुनरावृत्त प्रक्रिया मॉडल को प्रोजेक्ट उद्देश्यों के अनुरूप लाती है और श्रेष्ठ परिणाम देती है।
- एकाधिक मॉडलों का मूल्यांकन: विभिन्न मॉडलों का परीक्षण और तुलना करें ताकि सर्वश्रेष्ठ प्रदर्शन करने वाला मॉडल चुना जा सके। मूल्यांकन यह सुनिश्चित करता है कि चुना गया मॉडल न केवल सटीक है बल्कि दिए गए कार्य के लिए मजबूत और कुशल भी है।
मॉडलिंग कच्चे डेटा और उपयोगी अंतर्दृष्टि के बीच पुल का काम करती है, जिससे AI समाधान वास्तविक परिस्थितियों में विश्वसनीय और असरदार परिणाम दे पाते हैं।
चरण 5 - मूल्यांकन (Evaluation)
मूल्यांकन AI प्रोजेक्ट साइकिल का एक निर्णायक चरण है, जहाँ मॉडल के प्रदर्शन का कड़ाई से परीक्षण किया जाता है ताकि सुनिश्चित हो सके कि वह अपेक्षा के अनुरूप काम कर रहा है। इस चरण में प्रमुख मीट्रिक्स के आधार पर मॉडल का आकलन, अनदेखे डेटा पर उसकी विश्वसनीयता का सत्यापन और व्यावसायिक उद्देश्यों के अनुरूपता की पुष्टि शामिल है।
यहाँ प्रमुख कदम हैं:
- प्रदर्शन मीट्रिक्स का आकलन: निम्नलिखित मीट्रिक्स से मॉडल की प्रभावशीलता का मूल्यांकन करें:
- Accuracy: सही भविष्यवाणियों के समग्र अनुपात को मापता है।
- Precision: सभी सकारात्मक भविष्यवाणियों में से सही सकारात्मक का अनुपात देखकर फॉल्स पॉज़िटिव्स को कम करने की मॉडल की क्षमता दर्शाता है।
- Recall (Sensitivity): सभी प्रासंगिक सकारात्मक मामलों की पहचान करने की मॉडल की क्षमता को दर्शाता है, ताकि कोई महत्वपूर्ण डेटा छूटे नहीं।
- F1 score: असंतुलित डेटासेट्स पर विशेष रूप से उपयोगी, प्रिसिशन और रिकॉल के बीच संतुलन स्थापित करता है।
- क्रॉस-वैलिडेशन: अलग-अलग डेटा सबसेट्स पर मॉडल की मजबूती जाँचने के लिए क्रॉस-वैलिडेशन करें। यह सुनिश्चित करता है कि मॉडल लगातार अच्छा प्रदर्शन करे और किसी विशेष डेटासेट के प्रति ओवरफिट न हो।
- अनदेखे डेटा पर परीक्षण: एक अलग टेस्टिंग डेटासेट का उपयोग कर वास्तविक दुनिया की स्थितियों का अनुकरण करें और प्रशिक्षण डेटा से परे मॉडल की सामान्यीकरण क्षमता का मूल्यांकन करें।
- व्यावसायिक अनुरूपता: सत्यापित करें कि मॉडल प्रोजेक्ट के व्यावसायिक लक्ष्यों और हितधारकों की अपेक्षाओं को पूरा करता है। सफल AI समाधान केवल तकनीकी रूप से सक्षम नहीं, बल्कि अपने लक्ष्यों को प्रभावी ढंग से हासिल करने में भी असरदार होना चाहिए।
सघन मूल्यांकन सुनिश्चित करता है कि AI मॉडल सटीक, विश्वसनीय और उस समस्या के अनुरूप है जिसे वह हल करना चाहता है। यह चरण वास्तविक अनुप्रयोगों में प्रभावी प्रदर्शन की विश्वसनीयता देता है और डिप्लॉयमेंट की नींव रखता है।
चरण 6 - डिप्लॉयमेंट
डिप्लॉयमेंट वह चरण है जहाँ AI मॉडल विकास से आगे बढ़कर वास्तविक उपयोग में आता है। इस कदम में मॉडल को प्रणालियों या प्लेटफॉर्म्स में एकीकृत किया जाता है ताकि वह व्यावहारिक समस्याओं को प्रभावी ढंग से सुलझा सके।
डिप्लॉयमेंट के मुख्य चरण हैं:
- इंटीग्रेशन: मॉडल को मौजूदा इन्फ्रास्ट्रक्चर, एप्लिकेशंस या सेवाओं में समाहित करें।
- डिप्लॉयमेंट विकल्प: प्रोजेक्ट की ज़रूरतों के आधार पर क्लाउड-आधारित समाधान, ऑन-प्रिमाइसेस सेटअप या एज डिवाइसेस में से चुनाव करें।
- प्रदर्शन निगरानी: वास्तविक परिस्थितियों में मॉडल को ट्रैक करें ताकि सटीकता सुनिश्चित हो और ड्रिफ्ट जैसी संभावित समस्याएँ दूर की जा सकें।
- स्केलेबिलिटी और मेंटेनेंस: बढ़ते डेटा लोड के लिए कॉन्फ़िगर करें और नियमित अपडेट्स के प्रोटोकॉल स्थापित करें।
प्रभावी डिप्लॉयमेंट सुनिश्चित करता है कि मॉडल लक्षित लाभ प्रदान करे और विश्वसनीय, स्केलेबल व अनुकूलनीय बना रहे। AI मॉडलों को डिप्लॉय और मेंटेन करने का व्यावहारिक दृष्टिकोण सीखने के लिए हमारा MLOps डिप्लॉयमेंट और लाइफसाइक्लिंग पर कोर्स देखें।
चरण 7: मेंटेनेंस और मॉनिटरिंग
मेंटेनेंस सुनिश्चित करता है कि AI मॉडल समय के साथ नए डेटा और बदलती परिस्थितियों के अनुरूप ढलते हुए सटीक और प्रभावी बने रहें।
यहाँ पालन करने के कदम शामिल हैं:
- नियमित अपडेट्स: सटीकता बनाए रखने के लिए मॉडल को नए डेटा से फिर से ट्रेन और परिष्कृत करें।
- प्रदर्शन ट्रैकिंग: ड्रिफ्ट या गिरावट जैसी समस्याओं का पता लगाने के लिए मीट्रिक्स पर नज़र रखें।
- फीडबैक लूप्स: वास्तविक दुनिया की अंतर्दृष्टियों का उपयोग कर मॉडल में क्रमिक सुधार करें।
निरंतर मेंटेनेंस AI मॉडल को विश्वसनीय, प्रासंगिक और अपने उद्देश्यों के अनुरूप रखता है, जिससे दीर्घकालीन सफलता सुनिश्चित होती है। यदि आप विशेष रूप से मशीन लर्निंग के लिए ऐसा ही ढांचा देखना चाहते हैं, तो यह ML लाइफसाइकिल पर व्यापक मार्गदर्शक देखें।
AI प्रोजेक्ट साइकिल में श्रेष्ठ प्रथाएँ
AI को प्रभावी ढंग से लागू करने के लिए सावधानीपूर्वक योजना, सहयोग, और नैतिकता व स्केलेबिलिटी पर फोकस आवश्यक है। श्रेष्ठ प्रथाएँ अपनाने से सफलता सुनिश्चित करने में मदद मिलती है और जोखिम कम होते हैं।
- नैतिकता और जिम्मेदारी को प्राथमिकता दें: पारदर्शिता, निष्पक्षता और व्याख्येयता के साथ AI सिस्टम विकसित करें, और नैतिक दिशानिर्देशों व विनियमों का पालन सुनिश्चित करें।
- सहयोग को बढ़ावा दें: तकनीकी विशेषज्ञों, डोमेन विशेषज्ञों और गैर-तकनीकी हितधारकों सहित बहु-विषयक टीमों को शामिल करें ताकि विविध दृष्टिकोण मिलें और अपेक्षाएँ संरेखित हों।
- मजबूत परीक्षण का लाभ उठाएँ: विभिन्न डेटासेट्स और एडवर्सेरियल टेस्टिंग का उपयोग कर मॉडलों का अलग-अलग परिदृश्यों में मूल्यांकन करें और संभावित विफलता मोड्स की पहचान करें।
- नियमित बेंचमार्किंग करें: प्रतिस्पर्धात्मकता और अनुकूलनशीलता सुनिश्चित करने के लिए अपने मॉडल के प्रदर्शन की निरंतर तुलना करें।
- सफलता को स्पष्ट रूप से परिभाषित करें: अस्पष्टता और स्कोप क्रीप से बचने के लिए स्पष्ट, मापने योग्य सफलता मीट्रिक्स स्थापित करें।
- इंक्रीमेंटल दृष्टिकोण अपनाएँ: बड़ा सोचें लेकिन छोटा शुरू करें—भविष्य की वृद्धि की नींव के रूप में सरल, प्रभावशाली उपयोग मामलों पर ध्यान दें।
- MLOps में निवेश करें: प्रोडक्शन में AI मॉडलों को डिप्लॉय और मेंटेन करने की जटिलताओं को प्रभावी ढंग से संभालने के लिए शुरुआती चरण में ही एक मजबूत MLOps ढांचा बनाएं।
AI पहलों के प्रबंधन पर अतिरिक्त रणनीतियों के लिए, यह सूचनाप्रद ब्लॉग: AI प्रोजेक्ट्स को प्रभावी ढंग से कैसे मैनेज करें पढ़ें।
AI प्रोजेक्ट साइकिल की आम चुनौतियाँ और उनसे निपटने के तरीके
AI प्रोजेक्ट्स को अक्सर तकनीकी, नैतिक और परिचालन चुनौतियों का सामना करना पड़ता है। इन्हें सक्रिय रूप से संबोधित करने से प्रोजेक्ट की सफलता और दीर्घकालीन मूल्य में बढ़ोतरी होती है। इसी कारण मैंने एक तालिका तैयार की है जिसमें कुछ सबसे आम चुनौतियाँ और उन्हें आकलित करने के तरीके दिए गए हैं।
|
मुख्य चुनौती |
सुझाए गए समाधान |
|
डेटा की कमी या असंतुलन |
डेटासेट विविधता बढ़ाने के लिए डेटा ऑग्मेंटेशन, सिंथेटिक डेटा जनरेशन या ट्रांसफर लर्निंग का उपयोग करें। |
|
डेटा और मॉडलों में पक्षपात (Bias) |
विशेषीकृत टूल्स से नियमित रूप से बायस की निगरानी करें और नैतिक जोखिम कम करने के लिए मानव फीडबैक से रिइनफोर्समेंट लर्निंग (RLHF) अपनाएँ। |
|
पालन और विनियमन |
कड़े ऑडिट के माध्यम से कानूनी मानकों का अनुपालन सुनिश्चित करें और पारदर्शिता के लिए दस्तावेजीकरण बनाए रखें। |
|
ओवरफिटिंग और सामान्यीकरण में कमी |
विभिन्न इनपुट्स पर अच्छे से सामान्यीकरण करने वाले मॉडल बनाने हेतु क्रॉस-वैलिडेशन और रेग्युलराइज़ेशन जैसी तकनीकों का उपयोग करें। |
|
रियल-टाइम अनुप्रयोगों में विलंबता |
स्पीड बढ़ाने के लिए क्वांटाइज़ेशन और डिस्टिलेशन तकनीकों से मॉडलों का अनुकूलन करें, बिना सटीकता से समझौता किए। |
|
इंटीग्रेशन की जटिलता |
मॉड्यूलर आर्किटेक्चर और सुव्यवस्थित APIs लागू करें ताकि मौजूदा प्रणालियों में एकीकरण सरल बने। |
|
लागत प्रबंधन |
कुशलता के लिए मॉडल आर्किटेक्चर और संचालन का अनुकूलन करें, और किफायती क्लाउड समाधान चुनें। |
AI प्रोजेक्ट साइकिल: केस स्टडीज़ और वास्तविक अनुप्रयोग
AI प्रोजेक्ट साइकिल की प्रासंगिकता ई-कॉमर्स से लेकर हेल्थकेयर जैसे विशेष क्षेत्रों तक विभिन्न अनुप्रयोगों में दिखती है। यहाँ दो उदाहरण हैं जो इसके क्रियान्वयन को दर्शाते हैं:
1. ई-कॉमर्स प्लेटफ़ॉर्म के लिए रिकमेन्डेशन सिस्टम
उद्देश्य: व्यक्तिगत सिफारिशों के माध्यम से उपयोगकर्ता सहभागिता बढ़ाना और बिक्री में वृद्धि करना।
AI प्रोजेक्ट साइकिल का उपयोग:
- समस्या निर्धारण: उपयोगकर्ता की पसंद और व्यवहार के अनुरूप उत्पाद सुझाने के लक्ष्य को परिभाषित करें, और ग्राहकों व बिज़नेस टीम जैसे हितधारकों की पहचान करें।
- डेटा अधिग्रहण: ग्राहक डेटा एकत्र करें, जिसमें खरीद इतिहास, ब्राउज़िंग पैटर्न और डेमोग्राफ़िक्स शामिल हों, और डेटा गोपनीयता अनुपालन सुनिश्चित करें।
- डेटा अन्वेषण: बार-बार साथ खरीदे जाने वाले आइटम या मौसमी रुझानों जैसे पैटर्न का विश्लेषण करें और संभावित विसंगतियों की पहचान करें।
- मॉडलिंग: कोलैबोरेटिव फ़िल्टरिंग या न्यूरल नेटवर्क्स जैसे मशीन लर्निंग मॉडल विकसित और प्रशिक्षित करें ताकि उत्पाद वरीयताओं की सटीक भविष्यवाणी हो सके।
- मूल्यांकन: प्रिसिशन और रिकॉल जैसे मीट्रिक्स से मॉडल का परीक्षण करें ताकि सिफारिशें सटीक और सार्थक हों।
- डिप्लॉयमेंट: मॉडल को ई-कॉमर्स प्लेटफ़ॉर्म में एकीकृत करें, यह सुनिश्चित करते हुए कि वह मौजूदा प्रणालियों के साथ सहजता से काम करे।
- मेंटेनेंस और मॉनिटरिंग: मॉडल को नए डेटा से लगातार अपडेट करें और प्रदर्शन पर नज़र रखें ताकि ड्रिफ्ट या बदलते उपयोगकर्ता व्यवहार जैसी समस्याएँ संभाली जा सकें।
परिणाम: एक गतिशील सिफारिश प्रणाली जो ग्राहक अनुभव को बेहतर बनाती है और राजस्व वृद्धि को बढ़ावा देती है।
2. हेल्थकेयर डोमेन में ChatGPT जैसा एक चैटबॉट
उद्देश्य: एक संवादात्मक AI इंटरफ़ेस के माध्यम से उपयोगकर्ताओं को सटीक और विश्वसनीय स्वास्थ्य जानकारी प्रदान करना।
AI प्रोजेक्ट साइकिल का उपयोग:
- समस्या निर्धारण: स्वास्थ्य-संबंधी प्रश्नों का उत्तर देने के चैटबॉट के उद्देश्य को स्थापित करें, साथ ही नैतिक और कानूनी मानकों का पालन सुनिश्चित करें। हितधारकों में मरीज, स्वास्थ्य प्रदाता और नियामकीय संस्थाएँ शामिल हैं।
- डेटा अधिग्रहण: विविध, उच्च-गुणवत्ता वाले चिकित्सकीय डेटासेट्स जुटाएँ, जिनमें क्लिनिकल दिशानिर्देश, मेडिकल साहित्य और उपयोगकर्ता इंटरेक्शन लॉग शामिल हों, और मरीज की गोपनीयता की रक्षा करें।
- डेटा अन्वेषण: सामान्य स्वास्थ्य चिंताओं, अक्सर पूछे जाने वाले प्रश्नों और प्रभावी मॉडल प्रशिक्षण हेतु भाषा पैटर्न की पहचान करने के लिए डेटा का विश्लेषण करें।
- मॉडलिंग: ChatGPT जैसे बड़े भाषा मॉडल को डोमेन-विशिष्ट डेटासेट्स पर फाइन-ट्यून करें, और विशेषज्ञ सलाह के अनुरूप उत्तरों के लिए मानव फीडबैक के साथ रिइनफोर्समेंट लर्निंग (RLHF) शामिल करें।
- मूल्यांकन: उत्तरों की सटीकता, प्रासंगिकता और सुरक्षा जैसे मीट्रिक्स के आधार पर मॉडल का आकलन करें ताकि विश्वसनीय जानकारी प्रदान की जा सके।
- डिप्लॉयमेंट: चैटबॉट को वेब या ऐप-आधारित सेवा के रूप में डिप्लॉय करें, और पहुँच बढ़ाने के लिए मौजूदा हेल्थकेयर सिस्टम्स में एकीकृत करें।
- मेंटेनेंस और मॉनिटरिंग: इंटरेक्शंस की निगरानी करें ताकि उत्तरों को परिष्कृत किया जा सके, गलत जानकारी का समाधान हो, और अद्यतन चिकित्सकीय ज्ञान से मॉडल को फिर से प्रशिक्षित किया जा सके।
परिणाम: एक विश्वसनीय, स्वास्थ्य-केंद्रित चैटबॉट जो सटीक, सुलभ और नैतिक जानकारी प्रदान करता है, और उपयोगकर्ताओं को सूचित स्वास्थ्य निर्णय लेने में सक्षम बनाता है।
जो लोग व्यापार में AI की भूमिका समझना चाहते हैं, उनके लिए यह AI Business Fundamentals ट्रैक एक अच्छा शुरुआती बिंदु है।
निष्कर्ष
AI प्रोजेक्ट साइकिल नवाचारी विचारों को प्रभावकारी वास्तविक-जीवन समाधानों में बदलने के लिए एक संरचित रोडमैप प्रदान करता है। समस्या निर्धारण से लेकर डिप्लॉयमेंट और सतत मेंटेनेंस तक, हर चरण AI प्रणालियों की सफलता और विश्वसनीयता सुनिश्चित करने में अहम है। यह व्यवस्थित दृष्टिकोण स्पष्ट उद्देश्यों को परिभाषित करने और मूल्यवान अंतर्दृष्टियाँ खोजने में मदद करता है, साथ ही मज़बूत, नैतिक और प्रभावी AI मॉडलों के निर्माण का समर्थन करता है।
AI प्रोजेक्ट साइकिल अपनाकर, संगठन AI विकास की जटिलताओं को आत्मविश्वास के साथ नेविगेट कर सकते हैं। यह सहयोग को प्रोत्साहित करता है, नैतिक जिम्मेदारी को बढ़ावा देता है, और तकनीकी प्रयासों को व्यावसायिक लक्ष्यों के अनुरूप करता है। चाहे आप नया AI उपक्रम शुरू कर रहे हों या मौजूदा समाधान को निखार रहे हों, इस लाइफसाइकल को अपनाना कृत्रिम बुद्धिमत्ता के निरंतर विकसित हो रहे क्षेत्र में सार्थक और टिकाऊ परिणाम पाने की कुंजी है। यदि आप AI क्षेत्र में बिल्कुल नए हैं, तो DataCamp का AI Fundamentals ट्रैक शुरू कर सकते हैं। अधिक उन्नत उपयोगकर्ताओं के लिए, अपनी AI स्किल्स सुधारने हेतु अन्य अच्छे संसाधन हैं:
जोसेप यूरोपीय परियोजनाओं में विशेषज्ञता रखने वाले फ्रीलांस डेटा साइंटिस्ट हैं, जिन्हें डेटा स्टोरेज, प्रोसेसिंग, उन्नत एनालिटिक्स, और प्रभावशाली डेटा स्टोरीटेलिंग में महारत है।
एक शिक्षक के रूप में, वे यूनिवर्सिटी ऑफ नवार्रा के मास्टर’s प्रोग्राम में बिग डेटा पढ़ाते हैं और Medium, KDNuggets, तथा DataCamp जैसे प्लेटफ़ॉर्म पर लेखों के माध्यम से अपने विचार साझा करते हैं। जोसेप अपनी न्यूज़लेटर Databites (databites.tech) में भी डेटा और टेक के बारे में लिखते हैं।
उन्होंने पॉलिटेक्निक यूनिवर्सिटी ऑफ कैटालोनिया से इंजीनियरिंग फिजिक्स में बीएस और पॉम्पेऊ फाब्रा यूनिवर्सिटी से इंटेलिजेंट इंटरएक्टिव सिस्टम्स में एमएस किया है।
