कोर्स
बिज़नेस के लिए मशीन लर्निंग
2 घंटा
47.7K
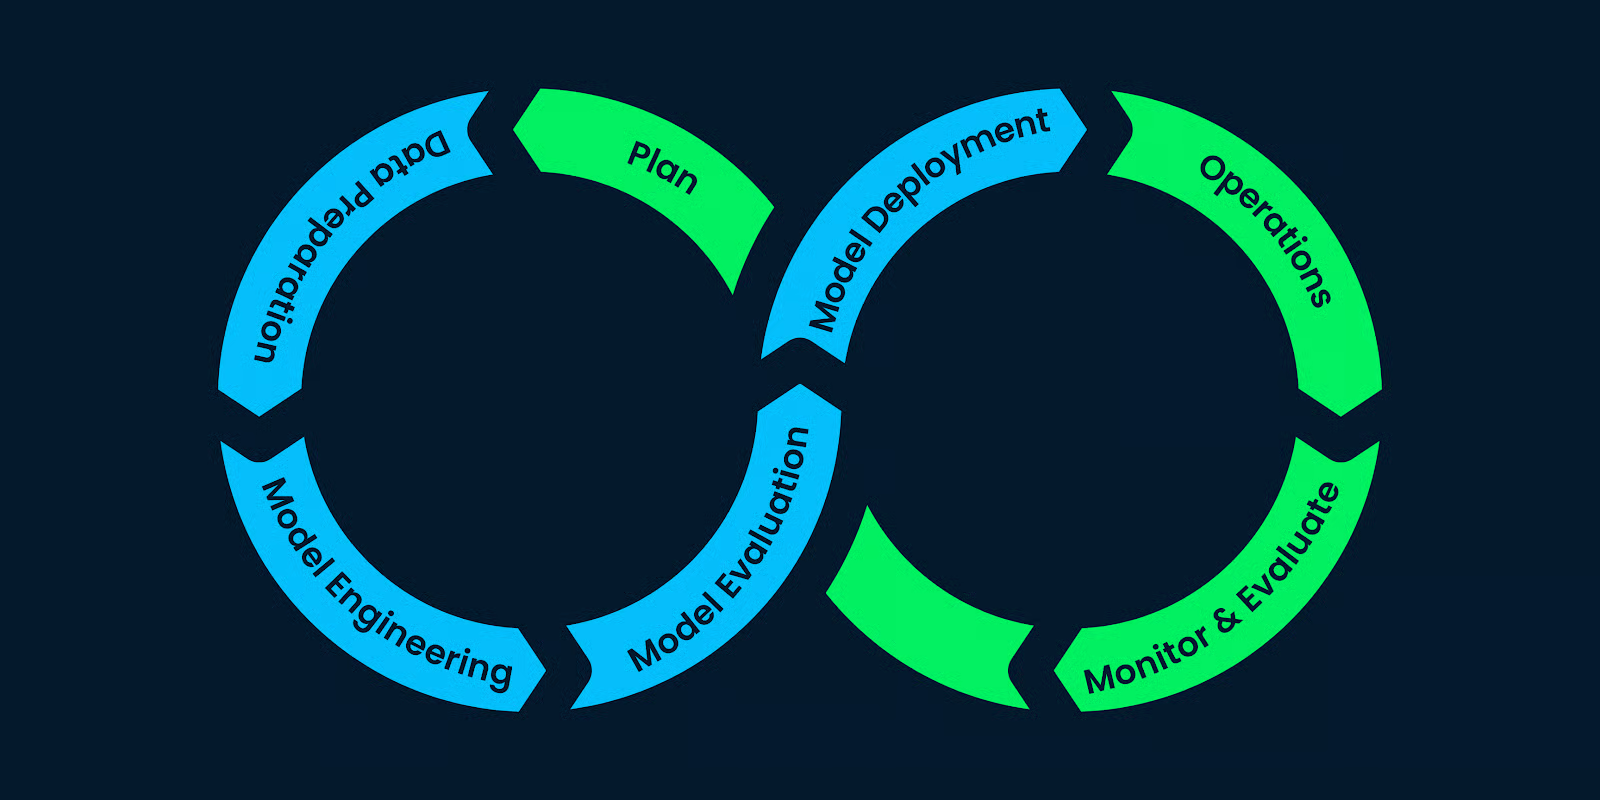
आम तौर पर हम मानते हैं कि मशीन लर्निंग (ML) प्रोजेक्ट में डेटा प्रोसेसिंग, मॉडल ट्रेनिंग और मॉडल डिप्लॉयमेंट शामिल होते हैं। लेकिन बात इससे कहीं आगे जाती है.
हमें बिज़नेस और डेटा की समझ, डेटा संग्रह तकनीकें, डेटा एनालिटिक्स, मॉडल निर्माण और मॉडल का मूल्यांकन भी चाहिए। इसके अलावा, डिप्लॉयमेंट के बाद लगातार मॉनिटरिंग और मेंटेनेंस भी आवश्यक है।
मशीन लर्निंग लाइफसाइकिल में ऐसे चरण होते हैं जो प्रोजेक्ट को संरचना देते हैं और कंपनी के संसाधनों का प्रभावी विभाजन करते हैं। इन चरणों का पालन करने से कंपनियाँ टिकाऊ, किफायती और गुणवत्तापूर्ण AI उत्पाद बना पाती हैं।
इस पोस्ट में, हम प्रत्येक चरण को समझाने के लिए क्वालिटी एश्योरेंस पद्धति के साथ मशीन लर्निंग एप्लिकेशन के विकास के लिए क्रॉस-इंडस्ट्री स्टैंडर्ड प्रोसेस (CRISP-ML(Q)) का उपयोग करेंगे। CRISP-ML(Q) टिकाऊ मशीन लर्निंग एप्लिकेशन बनाने का औद्योगिक मानक है।
मशीन लर्निंग चक्र के हर चरण में आवश्यकताओं और बाधाओं का कड़ाई से पालन करते हुए क्वालिटी एश्योरेंस ढाँचा अपनाया जाता है, जिससे निरंतर सुधार और मेंटेनेंस संभव हो। क्वालिटी एश्योरेंस के बारे में अधिक जानने के लिए CRISP-ML(Q) ब्लॉग पढ़ें।
गैर-तकनीकी व्यक्तियों और प्रबंधकों के लिए, हमारे संक्षिप्त कोर्स Understanding Machine Learning को देखें। यह उन्हें मशीन लर्निंग, मॉडलिंग और डीप लर्निंग (AI) की सामान्य समझ देगा। आप एक अलग लेख में AI और मशीन लर्निंग के बीच के अंतर भी जान सकते हैं।

चित्र: लेखक
योजना चरण में ML एप्लिकेशन के दायरे, सफलता मीट्रिक और व्यवहार्यता का आकलन शामिल है। आपको बिज़नेस को समझना होगा और यह भी कि मौजूदा प्रक्रिया को बेहतर बनाने के लिए मशीन लर्निंग का उपयोग कैसे करें। उदाहरण के लिए: क्या हमें मशीन लर्निंग की आवश्यकता है? क्या हम साधारण प्रोग्रामिंग से भी समान आवश्यकताएँ पूरी कर सकते हैं?
आपको लागत-लाभ विश्लेषण भी समझना होगा और यह तय करना होगा कि समाधान को आप कई चरणों में कैसे शिप करेंगे। साथ ही, बिज़नेस, मशीन लर्निंग मॉडल (Accuracy, F1 score, AUC) और आर्थिक (मुख्य प्रदर्शन संकेतक) के लिए स्पष्ट और मापने योग्य सफलता मीट्रिक तय करनी होंगी।
अंततः, आपको एक व्यवहार्यता रिपोर्ट बनानी होगी।
इसमें निम्नलिखित जानकारी शामिल होगी:
बिज़नेस लीडर्स Machine Learning for Business कोर्स लेकर मशीन लर्निंग की बुनियाद सीख सकते हैं और इन सीखों को बिज़नेस रणनीतियाँ बनाने व ML समाधान लागू करने में प्रयोग कर सकते हैं।
 चित्र: लेखक
डेटा तैयारी अनुभाग को चार भागों में बाँटा गया है: डेटा संग्रह और लेबलिंग, क्लीनिंग, प्रबंधन और प्रोसेसिंग।
सबसे पहले हमें तय करना होगा कि डेटा कैसे एकत्र किया जाएगा—आंतरिक डेटा इकट्ठा करके, ओपन-सोर्स से, वेंडरों से खरीदकर, या सिंथेटिक डेटा बनाकर। हर विधि के अपने फायदे और सीमाएँ हैं, और कई मामलों में हमें चारों तरीकों से डेटा मिलता है।
संग्रह के बाद, हमें डेटा को लेबल करना होता है। साफ़-सुथरा और लेबल किया हुआ डेटा खरीदना सभी कंपनियों के लिए संभव नहीं है, और विकास के दौरान आपको डेटा चयन में बदलाव भी करने पड़ सकते हैं। इसलिए आप इसे थोक में नहीं खरीद सकते, और अंततः यह डेटा समाधान के लिए बेकार भी साबित हो सकता है।
डेटा संग्रह और लेबलिंग में कंपनी के अधिकांश संसाधन लगते हैं: धन, समय, प्रोफेशनल्स, विषय विशेषज्ञ और कानूनी समझौते।
इसके बाद, हम मिसिंग वैल्यू इम्प्यूट करेंगे, गलत लेबल वाले डेटा का विश्लेषण करेंगे, आउटलाइनर्स हटाएँगे और शोर कम करेंगे। आप इस प्रक्रिया को ऑटोमेट करने के लिए डेटा पाइपलाइन बनाएँगे और डेटा क्वालिटी वेरिफिकेशन करेंगे।
डेटा प्रोसेसिंग चरण में फीचर चयन, असंतुलित क्लासेस से निपटना, फीचर इंजीनियरिंग, डेटा ऑग्मेंटेशन, और डेटा को नॉर्मलाइज़ व स्केल करना शामिल है।
पुनरुत्पादन योग्य परिणामों के लिए, हम मेटाडेटा, डेटा मॉडलिंग, ट्रांसफॉर्मेशन पाइपलाइंस और फीचर स्टोर्स को स्टोर और वर्ज़न करेंगे।
अंत में, हम डेटा स्टोरेज समाधान, पुनरुत्पादन हेतु डेटा वर्ज़निंग, मेटाडेटा स्टोरेज और ETL पाइपलाइंस तय करेंगे। यह भाग मॉडल ट्रेनिंग के लिए निरंतर डेटा स्ट्रीम सुनिश्चित करेगा।

चित्र: लेखक
इस चरण में, हम योजना चरण की सारी जानकारी का उपयोग करके मशीन लर्निंग मॉडल बनाएँगे और प्रशिक्षित करेंगे। उदाहरण के लिए: मॉडल मीट्रिक ट्रैक करना, स्केलेबिलिटी और मज़बूती सुनिश्चित करना, और स्टोरेज व कंप्यूट संसाधनों का अनुकूलन।
हम मॉडल आर्किटेक्चर, कोड क्वालिटी, मशीन लर्निंग एक्सपेरिमेंट्स, मॉडल ट्रेनिंग और एनसेंबलिंग पर ध्यान देंगे।
फीचर्स, हाइपरपैरामीटर्स, ML एक्सपेरिमेंट्स, मॉडल आर्किटेक्चर, डेवलपमेंट एनवायरनमेंट और मेटाडेटा को पुनरुत्पादन के लिए स्टोर और वर्ज़न किया जाता है।
Machine Learning Scientist with Python करियर ट्रैक लेकर मॉडल इंजीनियरिंग में शामिल चरणों के बारे में जानें। यह आपको मशीन लर्निंग इंजीनियर की नौकरी के लिए आवश्यक कौशल में निपुण बनने में मदद करेगा।
 चित्र: लेखक
अब जब हमने मॉडल का संस्करण अंतिम रूप दे दिया है, तो विभिन्न मीट्रिक्स परखने का समय है। क्यों? ताकि हम सुनिश्चित कर सकें कि हमारा मॉडल प्रोडक्शन के लिए तैयार है।
हम सबसे पहले अपने मॉडल को टेस्ट डेटासेट पर परखेंगे और भविष्यवाणियों में त्रुटियों की पहचान करने के लिए विषय विशेषज्ञों को शामिल करेंगे।
हमें यह भी सुनिश्चित करना है कि हम AI समाधान बनाते समय औद्योगिक, नैतिक और कानूनी ढाँचों का पालन कर रहे हैं।
इसके अलावा, हम अपने मॉडल की मज़बूती को रैंडम और वास्तविक दुनिया के डेटा पर परखेंगे। यह सुनिश्चित करते हुए कि मॉडल पर्याप्त तेज़ी से इंफरेंस दे ताकि मूल्य उत्पन्न हो।
अंत में, हम परिणामों की तुलना नियोजित सफलता मीट्रिक्स से करेंगे और यह तय करेंगे कि मॉडल को डिप्लॉय करना है या नहीं। इस चरण में, गुणवत्ता और पुनरुत्पादन बनाए रखने के लिए हर प्रक्रिया दर्ज और वर्ज़न की जाती है।
 चित्र: लेखक
इस चरण में, हम मशीन लर्निंग मॉडल्स को मौजूदा सिस्टम में डिप्लॉय करते हैं। उदाहरण के लिए: उत्पाद के आकार के आधार पर स्वचालित वेयरहाउस लेबलिंग शुरू करना। हम मौजूदा सिस्टम में एक कंप्यूटर विज़न मॉडल डिप्लॉय करेंगे, जो कैमरा से ली गई छवियों का उपयोग करके लेबल प्रिंट करेगा।
आम तौर पर मॉडल्स को क्लाउड और लोकल सर्वर, वेब ब्राउज़र, सॉफ़्टवेयर पैकेज के रूप में, और एज डिवाइस पर डिप्लॉय किया जा सकता है। उसके बाद, आप API, वेब ऐप, प्लगइन्स या डैशबोर्ड से प्रेडिक्शंस एक्सेस कर सकते हैं।
डिप्लॉयमेंट प्रक्रिया में, हम इंफरेंस हार्डवेयर परिभाषित करते हैं। हमें यह सुनिश्चित करना है कि तेज़ परिणाम देने के लिए हमारे पास पर्याप्त RAM, स्टोरेज और कंप्यूटिंग पावर हो। इसके बाद, हम प्रोडक्शन में मॉडल के प्रदर्शन का A/B टेस्टिंग से आकलन करेंगे, उपयोगकर्ता स्वीकृति सुनिश्चित करते हुए।
डिप्लॉयमेंट रणनीति महत्वपूर्ण है। आपको सुनिश्चित करना होगा कि बदलाव निर्बाध हों और उपयोगकर्ता अनुभव में सुधार हो। साथ ही, प्रोजेक्ट मैनेजर को एक आपदा प्रबंधन योजना तैयार करनी चाहिए। इसमें फॉलबैक रणनीति, निरंतर मॉनिटरिंग, विसंगति पहचान और नुकसान को न्यूनतम करना शामिल होना चाहिए।
 चित्र: लेखक
मॉडल को प्रोडक्शन में डिप्लॉय करने के बाद हमें सिस्टम की लगातार निगरानी और सुधार करना होता है। हम मॉडल मीट्रिक्स, हार्डवेयर और सॉफ़्टवेयर प्रदर्शन, और ग्राहक संतुष्टि की मॉनिटरिंग करेंगे।
मॉनिटरिंग पूरी तरह स्वचालित होती है, और पेशेवरों को विसंगतियों, मॉडल और सिस्टम प्रदर्शन में गिरावट, तथा खराब ग्राहक समीक्षाओं के बारे में सूचित किया जाता है।
प्रदर्शन में कमी का अलर्ट मिलने के बाद, हम मुद्दों का आकलन करेंगे और नए डेटा पर मॉडल को प्रशिक्षित करने या मॉडल आर्किटेक्चर में बदलाव करने की कोशिश करेंगे। यह एक सतत प्रक्रिया है।
दुर्लभ मामलों में, हमें पूरे मशीन लर्निंग लाइफसाइकिल को फिर से तैयार करना पड़ता है—डेटा प्रोसेसिंग और मॉडल ट्रेनिंग तकनीकों में सुधार करने, नए सॉफ़्टवेयर और हार्डवेयर अपडेट करने, और निरंतर इंटीग्रेशन के लिए नया फ़्रेमवर्क लागू करने हेतु।
ज्यादातर विश्वविद्यालयों में डेटा साइंस के छात्र केवल डेटा प्रोसेसिंग, मॉडल निर्माण और ट्रेनिंग, और कुछ मामलों में डिप्लॉयमेंट के बारे में सीखते हैं। उन्हें मानक औद्योगिक क्वालिटी एश्योरेंस प्रैक्टिस, डेटा संग्रह और लेबलिंग तकनीकें, मशीन लर्निंग पाइपलाइंस, डेटा वर्ज़निंग, ML एक्सपेरिमेंट्स ट्रैकिंग, और निरंतर मॉनिटरिंग व मेंटेनेंस नहीं सिखाया जाता।
 चित्र: लेखक
यदि आप डेटा साइंस प्रोफेशनल भी हैं, तब भी आपको सीखना चाहिए कि शीर्ष टेक कंपनियाँ अरबों ग्राहकों के लिए टिकाऊ मशीन लर्निंग एप्लिकेशन कैसे बनाती हैं। आप Designing Machine Learning Workflows in Python भी सीख सकते हैं ताकि ऐसी पाइपलाइंस बना सकें जो समय की कसौटी पर खरी उतरें। यह आपको स्टैंडर्ड वर्कफ़्लो, ह्यूमन-इन-द-लूप प्रक्रियाएँ, मॉडल लाइफसाइकिल मैनेजमेंट और अनसुपरवाइज़्ड वर्कफ़्लो सिखाएगा।
इस लेख में, हमने आवश्यकताओं और बाधाओं के आधार पर मशीन लर्निंग प्रोजेक्ट प्लानिंग, डेटा संग्रह और लेबलिंग, मॉडल इंजीनियरिंग, मॉडल मूल्यांकन, मॉडल डिप्लॉयमेंट, तथा मॉनिटरिंग और मेंटेनेंस के बारे में जाना। इसके अलावा, हमने गुणवत्ता बनाए रखने, परिणामों को पुनरुत्पादित करने, और विफलता की स्थिति में प्रक्रिया को डीबग करने के विभिन्न तरीकों पर भी चर्चा की।
मशीन लर्निंग कोर्सेज़
कोर्स
कोर्स
कोर्स