आज कई संगठन अपनी डिजिटल परिवर्तन पहलों के हिस्से के रूप में डेटा साइंस प्रथाएँ अपना रहे हैं। फिर भी, उनमें से अधिकांश अपने डेटा का लाभ एक डेटा रणनीति और अपनी संस्था में डेटा साइंस को स्केल करने के लिए स्पष्ट ब्लूप्रिंट के बिना नहीं उठा पाएंगे। McKinsey ने पाया कि डिजिटल परिवर्तन पहलों से गुजर रही 1,000 कंपनियों में से केवल आठ ही कुछ पायलट प्रोजेक्ट्स से आगे डेटा साइंस को स्केल कर पाईं।
इसके अलावा, जबकि ज़्यादातर संगठन डेटा-प्रेरित होने के मूल्य को समझते हैं, कई संगठन डेटा साइंस को एक अलग-थलग केंद्रीकृत सपोर्ट फ़ंक्शन की तरह मानते हैं जो विभिन्न टीमों के अनुरोधों पर काम करता है। यह मूल रूप से उस बात के विपरीत है जो डेटा साइंस होना चाहिए—यानी व्यावसायिक लक्ष्यों को हासिल करने का साधन। जैसा कि Anaconda के CEO पीटर वांग कहते हैं, डेटा साइंस व्यापार जगत में मार्गदर्शन के लिए "जांच और अन्वेषण का एक तरीका" है।
जिस तरह एक भौतिक विज्ञानी प्राकृतिक दुनिया के बारे में तर्क करने के लिए गणित का उपयोग करता है, उसी तरह डेटा वैज्ञानिक व्यावसायिक दुनिया के बारे में तर्क करने के लिए गणितीय और कम्प्यूटेशनल टूल्स का सहारा लेते हैं। — पीटर वांग, Anaconda CEO
यह अलगाव उस गलत धारणा से और गहरा हो जाता है कि डेटा साइंस का अंतिम लक्ष्य हमेशा ऐसे आर्टिफिशियल इंटेलिजेंस मॉडल होने चाहिए जो किसी संगठन के उत्पादन के प्रमुख हिस्सों को स्वचालित या सुव्यवस्थित कर दें। त्वरित रिटर्न की तलाश करने वाली कंपनियाँ अक्सर पाती हैं कि ऐसा आमतौर पर नहीं होता।
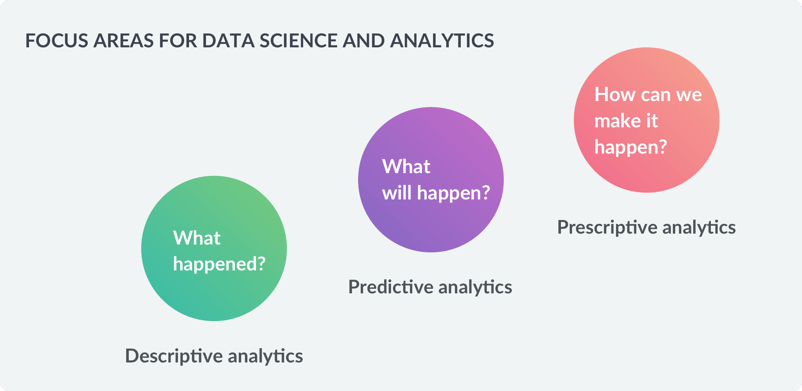
डेटा साइंस का यह संकीर्ण दृष्टिकोण इसका मूल्य अपेक्षाकृत कठिन भविष्यवाणात्मक एनालिटिक्स (यानी डेटा के साथ भविष्य की भविष्यवाणी करने की क्षमता) तक सीमित कर देता है। यह बड़े पैमाने पर मशीन लर्निंग करने के लिए आवश्यक इंफ्रास्ट्रक्चर कार्य को भी नज़रअंदाज़ करता है। हालाँकि, डेटा साइंस का बड़ा मूल्य अपेक्षाकृत सरल वर्णनात्मक एनालिटिक्स (डेटा को समझना और उसे सही लोगों तक पहुँचाना) और प्रिस्क्रिप्टिव एनालिटिक्स (डेटा-आधारित निर्णय लेना) लागू करने से आता है।
सफल डिजिटल परिवर्तन पूरा करने के लिए डेटा साइंस और एनालिटिक्स में संगठनात्मक क्षमताएँ विकसित करना ज़रूरी है। इसके लिए एक स्मार्ट, समावेशी और स्केलेबल डेटा रणनीति बनाना और लागू करना आवश्यक है।
यहीं हमारा IPTOP फ़्रेमवर्क काम आता है। IPTOP एक फ़्रेमवर्क है जो पाँच स्तंभों (I nfrastructure, P eople, T ools, O rganization, और P rocesses) की स्थापना करता है ताकि आपकी डेटा रणनीति को स्केलेबल तरीके से लागू कर सफल डिजिटल परिवर्तन पूरा किया जा सके। अधिक जानने के लिए हमारी आगामी वेबिनार श्रृंखला में शामिल हों।
इंफ्रास्ट्रक्चर
किसी भी डेटा रणनीति का उद्देश्य कच्चे डेटा को अंतर्दृष्टियों और निर्णयों में बदलना होता है। इसके लिए आवश्यक है कि संगठन अपना डेटा सुरक्षित और कुशलतापूर्वक एकत्रित करें, रिकॉर्ड करें और संग्रहीत करें ताकि वह सभी के लिए सुलभ हो। लेकिन डेटा अक्सर विभिन्न रूपों, आकारों और प्रारूपों में एकत्रित होता है। इस यात्रा में सहायक विविध डेटाबेस, डेटा लेक, डेटा वेयरहाउस, स्क्रिप्ट्स और डैशबोर्ड्स मिलकर डेटा इंफ्रास्ट्रक्चर का निर्माण करते हैं। एक मजबूत डेटा इंफ्रास्ट्रक्चर बनाने के लिए श्रेष्ठ प्रथाओं की समझ आवश्यक है।
पीपल
बेहतर निर्णयों के अंतिम लक्ष्य के साधन के रूप में डेटा साइंस को देखने से संगठन अपनी टीमों का निर्माण आवश्यक कौशलों के आधार पर कर सकते हैं। भूमिका-आधारित दृष्टिकोण में व्यावसायिक उद्देश्यों—जैसे चर्न की भविष्यवाणी करना या डैशबोर्ड्स के साथ डेटा का विज़ुअलाइज़ेशन—हासिल करने के लिए आवश्यक कौशलों के साथ प्रदर्शन लक्ष्यों की पहचान, आकलन और मैपिंग शामिल होती है। इसका परिणाम प्रत्येक भूमिका के लिए समर्पित लर्निंग पाथ्स के रूप में निकलता है।
इसका एक अच्छा उदाहरण है Airbnb का Data University, जो उनका स्वामित्व प्रशिक्षण कार्यक्रम है, जिसे हर कर्मचारी को डेटा-आधारित निर्णय लेने के लिए आवश्यक कौशलों से लैस करने के लिए बनाया गया है। ऐसे कर्मचारी जो मूल रूप से डेटा वैज्ञानिक नहीं हैं, उन्हें Citizen Data Scientists बनने में सक्षम बनाने से डेटा साइंस टीम का समय अधिक रणनीतिक परियोजनाओं पर काम करने के लिए मुक्त हुआ है।
टूल्स
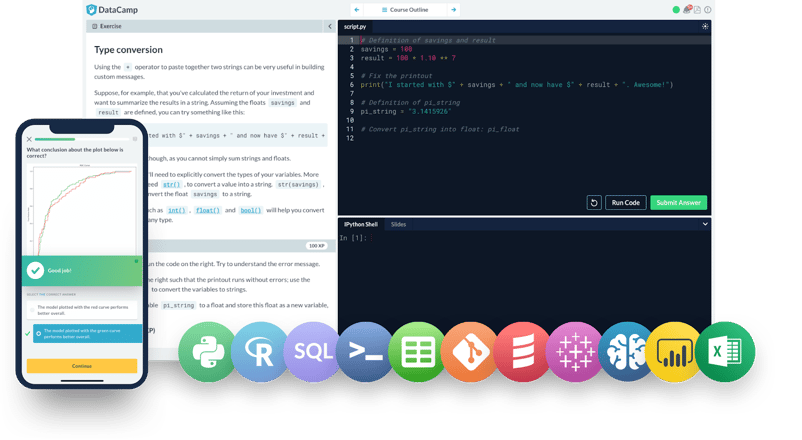
जहाँ इंफ्रास्ट्रक्चर संगठनों को डेटा से अंतर्दृष्टियाँ देने में सक्षम बनाता है, वहीं टूल्स पूरी संस्था में एक सामान्य डेटा भाषा अपनाने को सुगम और प्रोत्साहित करते हैं। डेटा एक्सेस, विश्लेषण, विज़ुअलाइज़ेशन और डैशबोर्ड्स के लिए टूल्स का उपयोग संगठनों को अधिक कुशल बनाता है और अंतर्दृष्टि प्राप्त करने के समय को घटाता है। ये टूल्स ओपन सोर्स प्रोग्रामिंग भाषाओं जैसे Python, R, और SQL से लेकर Power BI, Tableau, और Excel जैसे पॉइंट-एंड-क्लिक आधारित टूल्स तक हो सकते हैं।
इन टूल्स के ऊपर डेटा तक पहुँच को सुव्यवस्थित करने वाले संगठन-विशिष्ट फ़्रेमवर्क बनाना, डेटा साइंस को स्केल करने की दहलीज़ को काफी कम कर देता है। DataCamp में, हमारे पास स्वामित्व वाले Python और R पैकेज हैं जो सरल कमांड्स के माध्यम से डेटा लेक से जुड़ना, डेटा क्वेरी करना और उसे एग्रीगेट करना आसान बना देते हैं। कोई भी "पिछले Y हफ्तों में पाठ्यक्रम X की रेटिंग क्या थी?" जैसे प्रश्नों का उत्तर एक-दो पंक्तियों के कोड से दे सकता है। इसी तरह, Airbnb के पास एक R पैकेज है जो उनकी वांछित सौंदर्य शैली के अनुसार डेटा क्वेरी करने और विज़ुअलाइज़ करने में सहायक है, जिससे पूरी संस्था में सुसंगत डेटा विश्लेषण और विज़ुअलाइज़ेशन सुनिश्चित करने में अनुमान लगाने का झंझट खत्म हो जाता है।
ऑर्गनाइजेशन
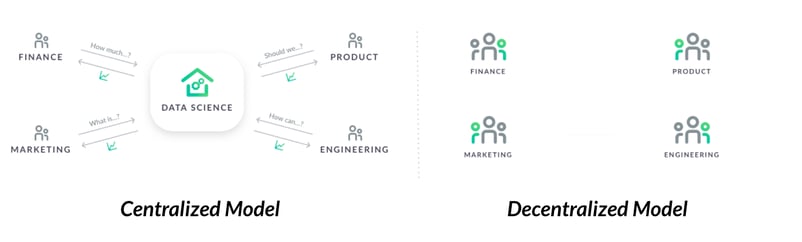
डेटा रणनीति का एक महत्वपूर्ण आयाम है डेटा प्रोफेशनल्स का संगठन। चूँकि अधिकांश कंपनियों में रिपोर्टिंग संरचनाएँ और एजेंडा काम को दिशा देते हैं, इसलिए संगठनात्मक संरचना ऐसी होनी चाहिए जो आपकी कंपनी को टिकाऊ सफलता के लिए तैयार करे। एक केंद्रीकृत मॉडल, जिसमें डेटा वैज्ञानिक एक ही डेटा साइंस टीम का हिस्सा होते हैं, और एक विकेंद्रीकृत मॉडल, जिसमें डेटा वैज्ञानिक विभिन्न विभागों में एम्बेडेड होते हैं—इन दोनों के बीच समझौते होते हैं।
केंद्रीकृत मॉडल में, एक केंद्रीय डेटा साइंस टीम अन्य विभागों से आने वाले सूचना अनुरोधों को प्राथमिकता देती है और उन पर काम करती है। इस मॉडल में, प्रश्न अंदर आते हैं और उत्तर बाहर जाने की अपेक्षा होती है। इससे डेटा साइंस टीम उत्कृष्टता का केंद्र बन सकती है, जहाँ डेटा वैज्ञानिक एक रणनीतिक दिशा के तहत सहयोग करते हैं और ज्ञान साझा करते हैं। हालाँकि, इससे डेटा साइंस टीमें और उनके टूल्स अलग-थलग पड़ जाते हैं, जो डेटा वैज्ञानिकों के लिए अन्य विभागों के साथ समन्वय और संचार को जटिल बना देता है।
विकेंद्रीकृत मॉडल में, डेटा वैज्ञानिक संगठन के विभिन्न विभागों में एम्बेडेड होते हैं। इससे डेटा साइंस को अपने विभाग की रणनीतिक दिशा को प्रभावित करने में स्थान मिलता है, क्योंकि डेटा वैज्ञानिक सफलता के लिए आवश्यक डोमेन ज्ञान अर्जित करते हैं। हालाँकि, चूँकि वे बिखरे हुए होते हैं और बिज़नेस टीम मैनेजर्स द्वारा प्रबंधित किए जाते हैं, तो इसका नतीजा डेटा वैज्ञानिकों की वृद्धि, सीखने-विकास और सहयोग की क्षमता पर प्रतिकूल प्रभाव के रूप में सामने आ सकता है।
इन दोनों मॉडलों को एक स्पेक्ट्रम के दो छोरों के रूप में देखना चाहिए। कई हाइब्रिड मॉडल हैं जो केंद्रीकृत और विकेंद्रीकृत मॉडलों के तत्वों को मिलाते हैं, और विभागों को समूहबद्ध करने के अलग-अलग तरीकों से बड़े पैमाने पर डेटा साइंस के मूल्य को अधिकतम करते हैं।
प्रोसेसेज़
अंततः, एक स्केलेबल डेटा रणनीति बनाने के लिए मानकों, सर्वोत्तम प्रथाओं और प्रक्रियाओं पर संरेखण आवश्यक है। संरेखण को बढ़ावा देना सहयोग को सुगम बनाने और संगठन के अलग-थलग पड़ने से बचने के लिए बेहद ज़रूरी है। इससे सभी टीमें एक सामान्य डेटा भाषा के तहत निर्बाध रूप से साथ काम कर सकती हैं और संवाद कर सकती हैं।
प्रोसेसेज़ पर संरेखण बनाना शुरू करने का एक आसान तरीका है पूर्वनिर्धारित प्रोजेक्ट संरचना और टेम्पलेट तैयार करना, जहाँ किसी एनालिटिक्स प्रोजेक्ट के विभिन्न कार्यों और उप-कार्यों को उनकी आवश्यकताओं के साथ पहले से मैप किया गया हो। Microsoft ने The Team Data Science Process अपनाया है, जो किसी भी हितधारक को प्रोजेक्ट आवश्यकताओं को स्पष्ट रूप से समझने, डेटा विश्लेषण और कम्प्यूटिंग पावर एक्सेस के लिए टेम्पलेट्स उपयोग करने, और प्रक्रिया के विभिन्न चरणों के स्वामियों की पहचान करने की अनुमति देता है।
आपके संगठन और उद्योग के आधार पर, पूर्वनिर्धारित प्रोजेक्ट टेम्पलेट्स विशिष्ट नियामकीय आवश्यकताओं के अधीन हो सकते हैं और जटिल प्रक्रियाओं की माँग कर सकते हैं। टीमों और डेटा प्रोफेशनल्स के बीच बढ़े हुए संरेखण के लिए आप ओपन सोर्स टूल्स का उपयोग कर सकते हैं ताकि प्रोजेक्ट संरचना टेम्पलेट्स निर्धारित किए जा सकें।
डेटा मैच्योरिटी असेसमेंट लें ताकि अपनी टीम के डेटा दृष्टिकोण को बेहतर समझ सकें।

आज कई संगठन अपनी डिजिटल परिवर्तन पहलों के हिस्से के रूप में डेटा साइंस प्रथाएँ अपना रहे हैं। फिर भी, उनमें से अधिकांश अपने डेटा का लाभ एक डेटा रणनीति और अपनी संस्था में डेटा साइंस को स्केल करने के लिए स्पष्ट ब्लूप्रिंट के बिना नहीं उठा पाएंगे। McKinsey ने पाया कि डिजिटल परिवर्तन पहलों से गुजर रही 1,000 कंपनियों में से केवल आठ ही कुछ पायलट प्रोजेक्ट्स से आगे डेटा साइंस को स्केल कर पाईं।
इसके अलावा, जबकि ज़्यादातर संगठन डेटा-प्रेरित होने के मूल्य को समझते हैं, कई संगठन डेटा साइंस को एक अलग-थलग केंद्रीकृत सपोर्ट फ़ंक्शन की तरह मानते हैं जो विभिन्न टीमों के अनुरोधों पर काम करता है। यह मूल रूप से उस बात के विपरीत है जो डेटा साइंस होना चाहिए—यानी व्यावसायिक लक्ष्यों को हासिल करने का साधन। जैसा कि Anaconda के CEO पीटर वांग कहते हैं, डेटा साइंस व्यापार जगत में मार्गदर्शन के लिए "जांच और अन्वेषण का एक तरीका" है।
यह अलगाव उस गलत धारणा से और गहरा हो जाता है कि डेटा साइंस का अंतिम लक्ष्य हमेशा ऐसे आर्टिफिशियल इंटेलिजेंस मॉडल होने चाहिए जो किसी संगठन के उत्पादन के प्रमुख हिस्सों को स्वचालित या सुव्यवस्थित कर दें। त्वरित रिटर्न की तलाश करने वाली कंपनियाँ अक्सर पाती हैं कि ऐसा आमतौर पर नहीं होता।
डेटा साइंस का यह संकीर्ण दृष्टिकोण इसका मूल्य अपेक्षाकृत कठिन भविष्यवाणात्मक एनालिटिक्स (यानी डेटा के साथ भविष्य की भविष्यवाणी करने की क्षमता) तक सीमित कर देता है। यह बड़े पैमाने पर मशीन लर्निंग करने के लिए आवश्यक इंफ्रास्ट्रक्चर कार्य को भी नज़रअंदाज़ करता है। हालाँकि, डेटा साइंस का बड़ा मूल्य अपेक्षाकृत सरल वर्णनात्मक एनालिटिक्स (डेटा को समझना और उसे सही लोगों तक पहुँचाना) और प्रिस्क्रिप्टिव एनालिटिक्स (डेटा-आधारित निर्णय लेना) लागू करने से आता है।
सफल डिजिटल परिवर्तन पूरा करने के लिए डेटा साइंस और एनालिटिक्स में संगठनात्मक क्षमताएँ विकसित करना ज़रूरी है। इसके लिए एक स्मार्ट, समावेशी और स्केलेबल डेटा रणनीति बनाना और लागू करना आवश्यक है।
यहीं हमारा IPTOP फ़्रेमवर्क काम आता है। IPTOP एक फ़्रेमवर्क है जो पाँच स्तंभों (I nfrastructure, P eople, T ools, O rganization, और P rocesses) की स्थापना करता है ताकि आपकी डेटा रणनीति को स्केलेबल तरीके से लागू कर सफल डिजिटल परिवर्तन पूरा किया जा सके। अधिक जानने के लिए हमारी आगामी वेबिनार श्रृंखला में शामिल हों।
इंफ्रास्ट्रक्चर
किसी भी डेटा रणनीति का उद्देश्य कच्चे डेटा को अंतर्दृष्टियों और निर्णयों में बदलना होता है। इसके लिए आवश्यक है कि संगठन अपना डेटा सुरक्षित और कुशलतापूर्वक एकत्रित करें, रिकॉर्ड करें और संग्रहीत करें ताकि वह सभी के लिए सुलभ हो। लेकिन डेटा अक्सर विभिन्न रूपों, आकारों और प्रारूपों में एकत्रित होता है। इस यात्रा में सहायक विविध डेटाबेस, डेटा लेक, डेटा वेयरहाउस, स्क्रिप्ट्स और डैशबोर्ड्स मिलकर डेटा इंफ्रास्ट्रक्चर का निर्माण करते हैं। एक मजबूत डेटा इंफ्रास्ट्रक्चर बनाने के लिए श्रेष्ठ प्रथाओं की समझ आवश्यक है।
पीपल
बेहतर निर्णयों के अंतिम लक्ष्य के साधन के रूप में डेटा साइंस को देखने से संगठन अपनी टीमों का निर्माण आवश्यक कौशलों के आधार पर कर सकते हैं। भूमिका-आधारित दृष्टिकोण में व्यावसायिक उद्देश्यों—जैसे चर्न की भविष्यवाणी करना या डैशबोर्ड्स के साथ डेटा का विज़ुअलाइज़ेशन—हासिल करने के लिए आवश्यक कौशलों के साथ प्रदर्शन लक्ष्यों की पहचान, आकलन और मैपिंग शामिल होती है। इसका परिणाम प्रत्येक भूमिका के लिए समर्पित लर्निंग पाथ्स के रूप में निकलता है।
इसका एक अच्छा उदाहरण है Airbnb का Data University, जो उनका स्वामित्व प्रशिक्षण कार्यक्रम है, जिसे हर कर्मचारी को डेटा-आधारित निर्णय लेने के लिए आवश्यक कौशलों से लैस करने के लिए बनाया गया है। ऐसे कर्मचारी जो मूल रूप से डेटा वैज्ञानिक नहीं हैं, उन्हें Citizen Data Scientists बनने में सक्षम बनाने से डेटा साइंस टीम का समय अधिक रणनीतिक परियोजनाओं पर काम करने के लिए मुक्त हुआ है।
टूल्स
जहाँ इंफ्रास्ट्रक्चर संगठनों को डेटा से अंतर्दृष्टियाँ देने में सक्षम बनाता है, वहीं टूल्स पूरी संस्था में एक सामान्य डेटा भाषा अपनाने को सुगम और प्रोत्साहित करते हैं। डेटा एक्सेस, विश्लेषण, विज़ुअलाइज़ेशन और डैशबोर्ड्स के लिए टूल्स का उपयोग संगठनों को अधिक कुशल बनाता है और अंतर्दृष्टि प्राप्त करने के समय को घटाता है। ये टूल्स ओपन सोर्स प्रोग्रामिंग भाषाओं जैसे Python, R, और SQL से लेकर Power BI, Tableau, और Excel जैसे पॉइंट-एंड-क्लिक आधारित टूल्स तक हो सकते हैं।
इन टूल्स के ऊपर डेटा तक पहुँच को सुव्यवस्थित करने वाले संगठन-विशिष्ट फ़्रेमवर्क बनाना, डेटा साइंस को स्केल करने की दहलीज़ को काफी कम कर देता है। DataCamp में, हमारे पास स्वामित्व वाले Python और R पैकेज हैं जो सरल कमांड्स के माध्यम से डेटा लेक से जुड़ना, डेटा क्वेरी करना और उसे एग्रीगेट करना आसान बना देते हैं। कोई भी "पिछले Y हफ्तों में पाठ्यक्रम X की रेटिंग क्या थी?" जैसे प्रश्नों का उत्तर एक-दो पंक्तियों के कोड से दे सकता है। इसी तरह, Airbnb के पास एक R पैकेज है जो उनकी वांछित सौंदर्य शैली के अनुसार डेटा क्वेरी करने और विज़ुअलाइज़ करने में सहायक है, जिससे पूरी संस्था में सुसंगत डेटा विश्लेषण और विज़ुअलाइज़ेशन सुनिश्चित करने में अनुमान लगाने का झंझट खत्म हो जाता है।
ऑर्गनाइजेशन
डेटा रणनीति का एक महत्वपूर्ण आयाम है डेटा प्रोफेशनल्स का संगठन। चूँकि अधिकांश कंपनियों में रिपोर्टिंग संरचनाएँ और एजेंडा काम को दिशा देते हैं, इसलिए संगठनात्मक संरचना ऐसी होनी चाहिए जो आपकी कंपनी को टिकाऊ सफलता के लिए तैयार करे। एक केंद्रीकृत मॉडल, जिसमें डेटा वैज्ञानिक एक ही डेटा साइंस टीम का हिस्सा होते हैं, और एक विकेंद्रीकृत मॉडल, जिसमें डेटा वैज्ञानिक विभिन्न विभागों में एम्बेडेड होते हैं—इन दोनों के बीच समझौते होते हैं।
केंद्रीकृत मॉडल में, एक केंद्रीय डेटा साइंस टीम अन्य विभागों से आने वाले सूचना अनुरोधों को प्राथमिकता देती है और उन पर काम करती है। इस मॉडल में, प्रश्न अंदर आते हैं और उत्तर बाहर जाने की अपेक्षा होती है। इससे डेटा साइंस टीम उत्कृष्टता का केंद्र बन सकती है, जहाँ डेटा वैज्ञानिक एक रणनीतिक दिशा के तहत सहयोग करते हैं और ज्ञान साझा करते हैं। हालाँकि, इससे डेटा साइंस टीमें और उनके टूल्स अलग-थलग पड़ जाते हैं, जो डेटा वैज्ञानिकों के लिए अन्य विभागों के साथ समन्वय और संचार को जटिल बना देता है।
विकेंद्रीकृत मॉडल में, डेटा वैज्ञानिक संगठन के विभिन्न विभागों में एम्बेडेड होते हैं। इससे डेटा साइंस को अपने विभाग की रणनीतिक दिशा को प्रभावित करने में स्थान मिलता है, क्योंकि डेटा वैज्ञानिक सफलता के लिए आवश्यक डोमेन ज्ञान अर्जित करते हैं। हालाँकि, चूँकि वे बिखरे हुए होते हैं और बिज़नेस टीम मैनेजर्स द्वारा प्रबंधित किए जाते हैं, तो इसका नतीजा डेटा वैज्ञानिकों की वृद्धि, सीखने-विकास और सहयोग की क्षमता पर प्रतिकूल प्रभाव के रूप में सामने आ सकता है।
इन दोनों मॉडलों को एक स्पेक्ट्रम के दो छोरों के रूप में देखना चाहिए। कई हाइब्रिड मॉडल हैं जो केंद्रीकृत और विकेंद्रीकृत मॉडलों के तत्वों को मिलाते हैं, और विभागों को समूहबद्ध करने के अलग-अलग तरीकों से बड़े पैमाने पर डेटा साइंस के मूल्य को अधिकतम करते हैं।
प्रोसेसेज़
अंततः, एक स्केलेबल डेटा रणनीति बनाने के लिए मानकों, सर्वोत्तम प्रथाओं और प्रक्रियाओं पर संरेखण आवश्यक है। संरेखण को बढ़ावा देना सहयोग को सुगम बनाने और संगठन के अलग-थलग पड़ने से बचने के लिए बेहद ज़रूरी है। इससे सभी टीमें एक सामान्य डेटा भाषा के तहत निर्बाध रूप से साथ काम कर सकती हैं और संवाद कर सकती हैं।
प्रोसेसेज़ पर संरेखण बनाना शुरू करने का एक आसान तरीका है पूर्वनिर्धारित प्रोजेक्ट संरचना और टेम्पलेट तैयार करना, जहाँ किसी एनालिटिक्स प्रोजेक्ट के विभिन्न कार्यों और उप-कार्यों को उनकी आवश्यकताओं के साथ पहले से मैप किया गया हो। Microsoft ने The Team Data Science Process अपनाया है, जो किसी भी हितधारक को प्रोजेक्ट आवश्यकताओं को स्पष्ट रूप से समझने, डेटा विश्लेषण और कम्प्यूटिंग पावर एक्सेस के लिए टेम्पलेट्स उपयोग करने, और प्रक्रिया के विभिन्न चरणों के स्वामियों की पहचान करने की अनुमति देता है।
आपके संगठन और उद्योग के आधार पर, पूर्वनिर्धारित प्रोजेक्ट टेम्पलेट्स विशिष्ट नियामकीय आवश्यकताओं के अधीन हो सकते हैं और जटिल प्रक्रियाओं की माँग कर सकते हैं। टीमों और डेटा प्रोफेशनल्स के बीच बढ़े हुए संरेखण के लिए आप ओपन सोर्स टूल्स का उपयोग कर सकते हैं ताकि प्रोजेक्ट संरचना टेम्पलेट्स निर्धारित किए जा सकें।
डेटा मैच्योरिटी असेसमेंट लें ताकि अपनी टीम के डेटा दृष्टिकोण को बेहतर समझ सकें।