डेटा साइंस और मशीन लर्निंग पहले से कहीं अधिक लोकप्रिय हो गए हैं। इस क्षेत्र की वृद्धि के साथ, आज प्रैक्टिशनर्स के लिए उपलब्ध टूल्स के पूरे स्पेक्ट्रम का परिपक्व होना भी देखा गया है।
एक उल्लेखनीय बदलाव यह है कि कई नए टूल्स, स्टार्टअप्स, और संपूर्ण श्रेणियाँ उभरी हैं जो प्रैक्टिशनर्स और संगठनों द्वारा झेली जाने वाली विशिष्ट समस्याओं को हल करने पर केंद्रित हैं। इस इन्फोग्राफिक में, हम 2022 में डेटा साइंस और मशीन लर्निंग में टूल्स के परिदृश्य का एक अवलोकन प्रदान करते हैं।
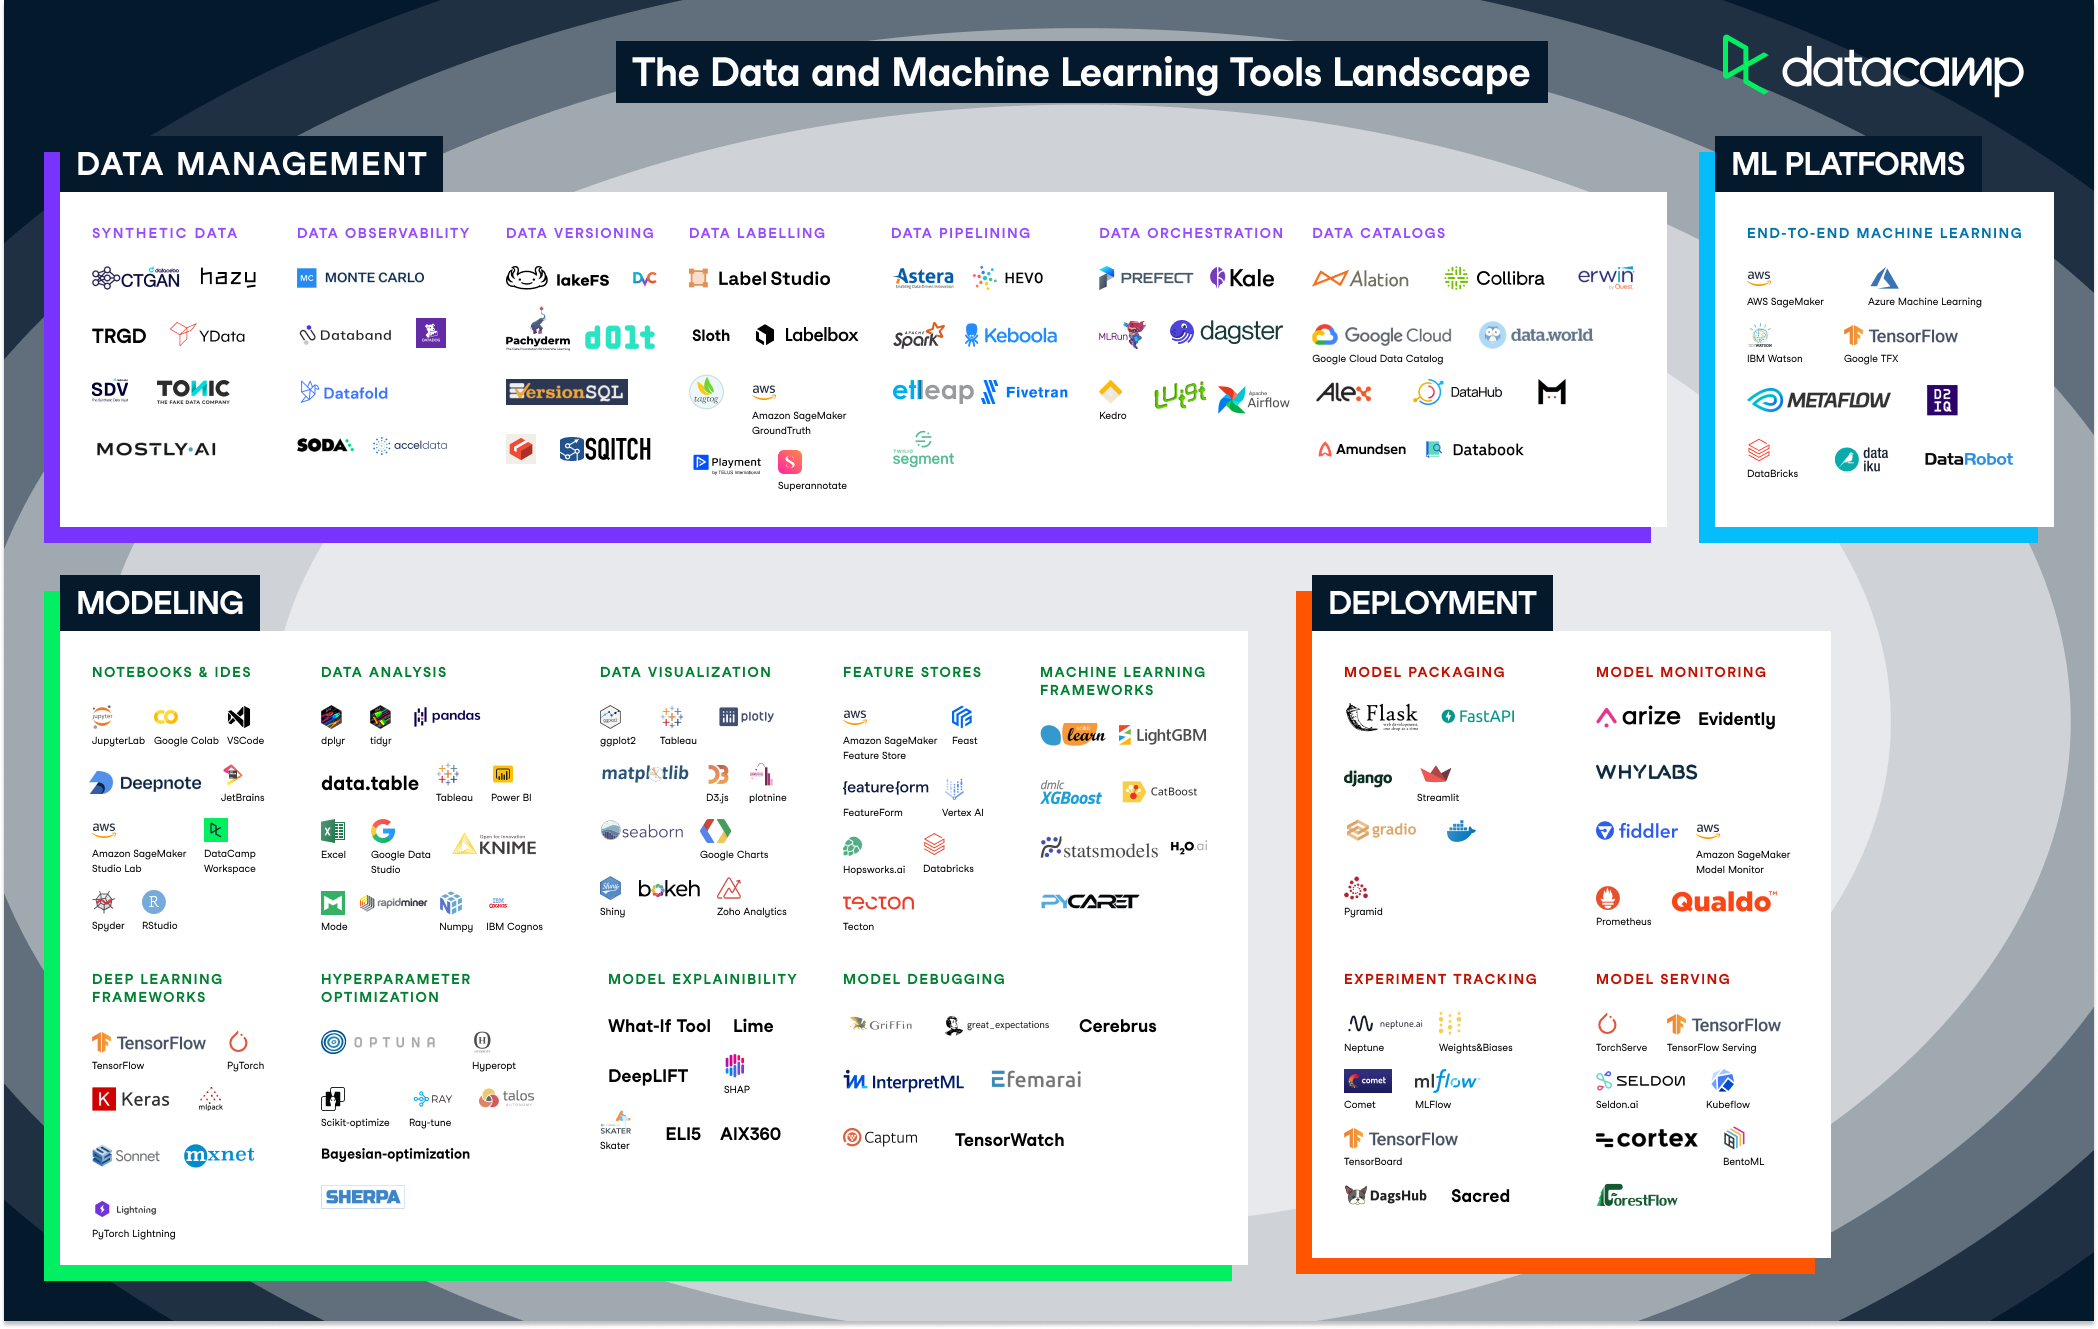
इस इन्फोग्राफिक के डाउनलोड करने योग्य संस्करण के लिए, ऊपर दी गई छवि पर क्लिक करें।
नीचे, आपको ऊपर दिए गए इन्फोग्राफिक में उल्लिखित टूल्स का विस्तृत अवलोकन मिलेगा।
डेटा प्रबंधन
पिछले कुछ वर्षों में टूलिंग की स्थिति में एक बड़ा सुधार उन अनेक टूल्स का आगमन रहा है जो प्रैक्टिशनर्स को डेटा साइंस और मशीन लर्निंग वर्कफ़्लो के लिए डेटा को बेहतर ढंग से प्रबंधित करने में सक्षम बनाते हैं। इनमें सिंथेटिक डेटा जनरेशन टूल्स जो डेटा उत्पन्न करने की सुविधा देते हैं, डेटा ऑब्ज़र्वेबिलिटी टूल्स जो प्रोडक्शन में डेटा पाइपलाइनों की निगरानी करते हैं, डेटा वर्ज़निंग टूल्स जो डेटा पर वर्ज़न कंट्रोल प्रदान करते हैं, डेटा पाइपलिनिंग और ऑर्केस्ट्रेशन टूल्स जो वर्कफ़्लोज़ के ऑर्केस्ट्रेशन में मदद करते हैं, डेटा कैटलॉग जो संगठन के डेटा को उपभोग के लिए प्रदर्शित करते हैं, और बहुत कुछ शामिल हैं।
सिंथेटिक डेटा
डेटा ऑब्ज़र्वेबिलिटी
डेटा वर्ज़निंग
डेटा लेबलिंग
डेटा पाइपलिनिंग
डेटा ऑर्केस्ट्रेशन
डेटा कैटलॉग
एंड-टू-एंड मशीन लर्निंग प्लेटफ़ॉर्म
मशीन लर्निंग प्लेटफ़ॉर्म धीरे-धीरे मानक बनते जा रहे हैं। ये प्लेटफ़ॉर्म फीचर प्रोसेसिंग से लेकर डिप्लॉयमेंट तक एंड-टू-एंड मशीन लर्निंग करने की क्षमता प्रदान करते हैं, जहाँ कुछ टूल्स स्वचालित मशीन लर्निंग और डिप्लॉयमेंट की सुविधा भी देते हैं।
मॉडलिंग
डेटा साइंस इकोसिस्टम के भीतर, नोटबुक्स और IDEs, डेटा विश्लेषण पैकेज और सॉफ़्टवेयर, डेटा विज़ुअलाइज़ेशन, मशीन लर्निंग में उपयोग की जाने वाली फीचर्स को संग्रहित करने के लिए फीचर स्टोर्स, डीप लर्निंग और मशीन लर्निंग लाइब्रेरीज़, हाइपरपैरामीटर ऑप्टिमाइज़ेशन लाइब्रेरीज़, मॉडल डिबगिंग टूल्स, और बहुत कुछ जैसे असंख्य टूल्स शामिल हैं।
नोटबुक्स और IDEs
डेटा विश्लेषण
डेटा विज़ुअलाइज़ेशन
फीचर स्टोर्स
मशीन लर्निंग फ़्रेमवर्क
डीप लर्निंग फ़्रेमवर्क
हाइपरपैरामीटर ऑप्टिमाइज़ेशन
मॉडल की व्याख्यात्मकता
मॉडल डिबगिंग
डिप्लॉयमेंट
पिछले दो वर्षों में MLOps और प्रोडक्शन में मशीन लर्निंग मॉडल्स को डिप्लॉय करने के महत्व में तेज़ी से वृद्धि हुई है। इससे ऐसे टूल्स के विकास और उत्क्रांति को बढ़ावा मिला है जो प्रैक्टिशनर्स को मॉडल्स को एप्लिकेशन में पैकेज करने, प्रोडक्शन में मॉडल्स की निगरानी करने, बड़े पैमाने पर प्रयोगों को ट्रैक करने, और मॉडल्स को प्रोडक्शन में सर्व करने की सुविधा देते हैं।
मॉडल पैकेजिंग
मॉडल मॉनिटरिंग
प्रयोग ट्रैकिंग
मॉडल सर्विंग

डेटा साइंस और मशीन लर्निंग पहले से कहीं अधिक लोकप्रिय हो गए हैं। इस क्षेत्र की वृद्धि के साथ, आज प्रैक्टिशनर्स के लिए उपलब्ध टूल्स के पूरे स्पेक्ट्रम का परिपक्व होना भी देखा गया है।
एक उल्लेखनीय बदलाव यह है कि कई नए टूल्स, स्टार्टअप्स, और संपूर्ण श्रेणियाँ उभरी हैं जो प्रैक्टिशनर्स और संगठनों द्वारा झेली जाने वाली विशिष्ट समस्याओं को हल करने पर केंद्रित हैं। इस इन्फोग्राफिक में, हम 2022 में डेटा साइंस और मशीन लर्निंग में टूल्स के परिदृश्य का एक अवलोकन प्रदान करते हैं।
इस इन्फोग्राफिक के डाउनलोड करने योग्य संस्करण के लिए, ऊपर दी गई छवि पर क्लिक करें।
नीचे, आपको ऊपर दिए गए इन्फोग्राफिक में उल्लिखित टूल्स का विस्तृत अवलोकन मिलेगा।
डेटा प्रबंधन
पिछले कुछ वर्षों में टूलिंग की स्थिति में एक बड़ा सुधार उन अनेक टूल्स का आगमन रहा है जो प्रैक्टिशनर्स को डेटा साइंस और मशीन लर्निंग वर्कफ़्लो के लिए डेटा को बेहतर ढंग से प्रबंधित करने में सक्षम बनाते हैं। इनमें सिंथेटिक डेटा जनरेशन टूल्स जो डेटा उत्पन्न करने की सुविधा देते हैं, डेटा ऑब्ज़र्वेबिलिटी टूल्स जो प्रोडक्शन में डेटा पाइपलाइनों की निगरानी करते हैं, डेटा वर्ज़निंग टूल्स जो डेटा पर वर्ज़न कंट्रोल प्रदान करते हैं, डेटा पाइपलिनिंग और ऑर्केस्ट्रेशन टूल्स जो वर्कफ़्लोज़ के ऑर्केस्ट्रेशन में मदद करते हैं, डेटा कैटलॉग जो संगठन के डेटा को उपभोग के लिए प्रदर्शित करते हैं, और बहुत कुछ शामिल हैं।
सिंथेटिक डेटा
डेटा ऑब्ज़र्वेबिलिटी
डेटा वर्ज़निंग
डेटा लेबलिंग
डेटा पाइपलिनिंग
डेटा ऑर्केस्ट्रेशन
डेटा कैटलॉग
एंड-टू-एंड मशीन लर्निंग प्लेटफ़ॉर्म
मशीन लर्निंग प्लेटफ़ॉर्म धीरे-धीरे मानक बनते जा रहे हैं। ये प्लेटफ़ॉर्म फीचर प्रोसेसिंग से लेकर डिप्लॉयमेंट तक एंड-टू-एंड मशीन लर्निंग करने की क्षमता प्रदान करते हैं, जहाँ कुछ टूल्स स्वचालित मशीन लर्निंग और डिप्लॉयमेंट की सुविधा भी देते हैं।
मॉडलिंग
डेटा साइंस इकोसिस्टम के भीतर, नोटबुक्स और IDEs, डेटा विश्लेषण पैकेज और सॉफ़्टवेयर, डेटा विज़ुअलाइज़ेशन, मशीन लर्निंग में उपयोग की जाने वाली फीचर्स को संग्रहित करने के लिए फीचर स्टोर्स, डीप लर्निंग और मशीन लर्निंग लाइब्रेरीज़, हाइपरपैरामीटर ऑप्टिमाइज़ेशन लाइब्रेरीज़, मॉडल डिबगिंग टूल्स, और बहुत कुछ जैसे असंख्य टूल्स शामिल हैं।
नोटबुक्स और IDEs
डेटा विश्लेषण
डेटा विज़ुअलाइज़ेशन
फीचर स्टोर्स
मशीन लर्निंग फ़्रेमवर्क
डीप लर्निंग फ़्रेमवर्क
हाइपरपैरामीटर ऑप्टिमाइज़ेशन
मॉडल की व्याख्यात्मकता
मॉडल डिबगिंग
डिप्लॉयमेंट
पिछले दो वर्षों में MLOps और प्रोडक्शन में मशीन लर्निंग मॉडल्स को डिप्लॉय करने के महत्व में तेज़ी से वृद्धि हुई है। इससे ऐसे टूल्स के विकास और उत्क्रांति को बढ़ावा मिला है जो प्रैक्टिशनर्स को मॉडल्स को एप्लिकेशन में पैकेज करने, प्रोडक्शन में मॉडल्स की निगरानी करने, बड़े पैमाने पर प्रयोगों को ट्रैक करने, और मॉडल्स को प्रोडक्शन में सर्व करने की सुविधा देते हैं।
मॉडल पैकेजिंग
मॉडल मॉनिटरिंग
प्रयोग ट्रैकिंग
मॉडल सर्विंग