
कुछ चीज़ें थीं जिन्हें मैं बदलना चाहता था। मैंने यह फॉलो‑अप प्रॉम्प्ट भेजा:
1. एक ज़्यादा विश्वसनीय डायनासोर बनाइए—वह ब्लॉब बिल्कुल डायनासोर जैसा नहीं दिखता।
2. उपयोगकर्ता को किसी कुंजी को दबाकर गेम शुरू करने का विकल्प दें—गेम तुरंत शुरू न करें। सुनिश्चित करें कि सभी निर्देश स्क्रीन पर बने रहें।
3. जब गेम ओवर हो, तो उपयोगकर्ता को फिर से प्रयास करने का मौका दें।
दूसरा परिणाम:
वह डायनासोर मुझे ज़्यादा पुरानी फ़िल्म के कैमरे जैसा लगता है, लेकिन बाकी सब बढ़िया है।
बड़े इनपुट के साथ मल्टीमॉडल रीजनिंग
Stanford ने हाल ही में The 2025 AI Index Report जारी किया—AI उद्योग की मौजूदा स्थिति का 450‑पृष्ठ (117,649 टोकन) का अवलोकन। मैंने o4-mini-high से इसे पढ़कर 2026 के लिए 10 रुझान भविष्यवाणी करने को कहा। इसने कार्य को अच्छे से संभाला और सिर्फ़ 9 सेकंड में पूरा कर दिया।
इसने 2026 के लिए ये रुझान बताए:
- नए रीजनिंग बेंचमार्क्स पर लगभग‑मानव प्रदर्शन
- प्रोडक्शन LLMs के लिए अति‑निम्न लागत इन्फ़रेंस
- सिंथेटिक‑प्लस‑रियल डेटा प्रशिक्षण पाइपलाइंस
- AI‑नेटिव हार्डवेयर का व्यापक अपनाव
- मल्टीमॉडल फ़ाउंडेशन मॉडल्स का मानकीकरण
- रेस्पॉन्सिबल‑AI सर्टिफ़िकेशन और ऑडिटिंग व्यवस्थाएँ
- AI‑संचालित वैज्ञानिक खोज नोबेल‑योग्य कार्य को तेज़ करती है
- वैश्विक समन्वय के साथ स्थानीयकृत AI गवर्नेंस फ़्रेमवर्क
- AI शिक्षा का लोकतांत्रीकरण और कार्यबल‑तैयारी
- सहयोगी नॉलेज वर्कर्स के रूप में AI एजेंट
इनमें से अधिकांश वाजिब लगे, हालांकि कुछ भविष्यवाणियाँ आशावाद की ओर झुकी हुई हैं। नंबर दो लें—हाँ, इन्फ़रेंस लागतें घट रही हैं, लेकिन “अति‑निम्न” कहना अतिशयोक्ति है, खासकर बड़े मॉडलों और कम‑ऑप्टिमाइज़्ड डिप्लॉयमेंट्स के लिए।
नंबर चार भी इसी तरह है: AI‑नेटिव हार्डवेयर आगे बढ़ रहा है, लेकिन आपूर्ति शृंखलाओं, सॉफ़्टवेयर इंटीग्रेशन और इकोसिस्टम सपोर्ट पर व्यापक अपनाव निर्भर करता है—जिनमें समय लगता है।
जहाँ तक नंबर नौ का सवाल है, हम अब भी AI शिक्षा के पूर्ण लोकतंत्रीकरण से काफी दूर हैं, लेकिन निष्पक्षता से कहें तो, मॉडल ने “पूर्ण” नहीं कहा।
O4-Mini बेंचमार्क्स
O4-mini को तेज़ और लागत‑कुशल मॉडल के रूप में डिज़ाइन किया गया है, लेकिन यह व्यापक रीजनिंग बेंचमार्क्स पर अब भी अच्छा प्रदर्शन करता है। कुछ मामलों में, यह o3 जैसे बड़े मॉडलों को भी पीछे छोड़ देता है।
गणित और तर्क
ये परीक्षण संरचित तर्क पर केंद्रित हैं, जो अक्सर गणित समस्याओं को सही ढंग से हल करने के लिए कई चरणों की मांग करते हैं। उदाहरण के लिए, AIME बेंचमार्क्स प्रतिस्पर्धी हाई‑स्कूल गणित प्रतियोगिताओं से लिए गए हैं।
- AIME 2024: o4-mini (बिना टूल्स) 93.4% स्कोर करता है, जो o3 (91.6%), o3-mini (87.3%), और o1 (74.3%) से बेहतर है।
- AIME 2025: o4-mini (बिना टूल्स) 92.7% स्कोर करता है, फिर से o3 (88.9%), o3-mini (86.5%), और o1 (79.2%) को पछाड़ते हुए
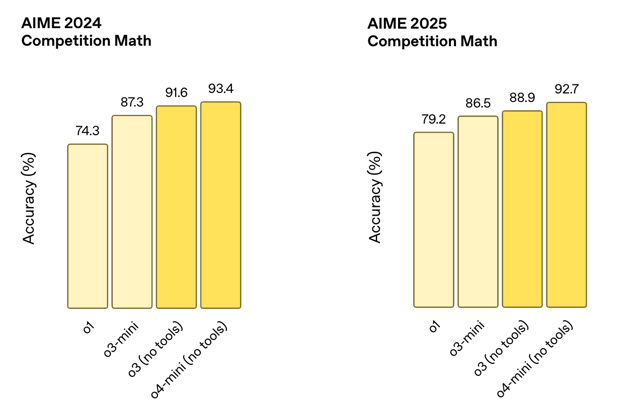
स्रोत: OpenAI
कोडिंग
ये बेंचमार्क्स मॉडल की कोड लिखने, डिबग करने और समझने की क्षमता का परीक्षण करते हैं। Codeforces एक प्रतिस्पर्धी प्रोग्रामिंग डेटासेट है, जबकि SWE‑Bench और Aider Polyglot वास्तविक‑दुनिया इंजीनियरिंग कार्यों का सिमुलेशन करते हैं।
- Codeforces: o4-mini (टर्मिनल के साथ) का ELO 2719 है, जो o3 (2706) से थोड़ा ऊपर है। o3-mini 2073 स्कोर करता है, और o1 काफी पीछे 1891 पर है।
- SWE‑Bench Verified: o4-mini 68.1% स्कोर करता है, o3 के 69.1% से थोड़ा पीछे, और o1 (48.9%) व o3-mini (49.3%) से आगे।
- Aider Polyglot (कोड संपादन): o4-mini-high 68.9% (whole) और 58.2% (diff) स्कोर करता है। तुलना के लिए, o3-high 81.3% (whole) और 79.6% (diff) स्कोर करता है।
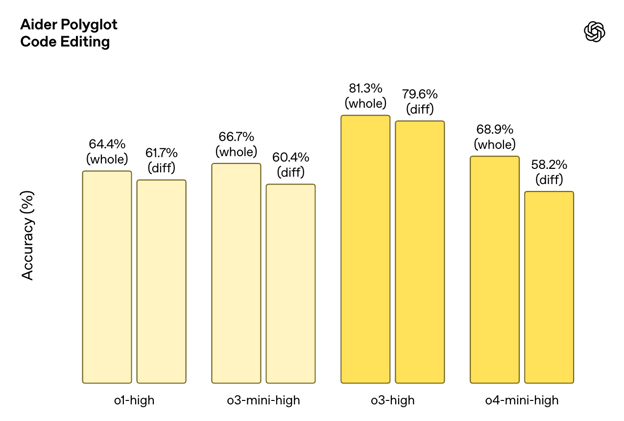
स्रोत: OpenAI
मल्टीमॉडल रीजनिंग
ये बेंचमार्क्स मापते हैं कि मॉडल दृश्य इनपुट—जैसे डायग्राम, चार्ट, और फ़िगर—को कितनी अच्छी तरह प्रोसेस करता है। परीक्षण इमेज समझ को तार्किक रीजनिंग के साथ जोड़ते हैं।
- MMMU: o4-mini का स्कोर 81.6% है, जो o3 (82.9%) के क़रीब और o1 (77.6%) से बेहतर है।
- MathVista: o4-mini 84.3% स्कोर करता है, o3 (86.8%) से पीछे, लेकिन o1 (71.8%) से काफ़ी ऊपर।
- CharXiv (वैज्ञानिक फ़िगर): o4-mini 72.0% तक पहुँचता है, o3 (78.6%) से पीछे लेकिन o1 (55.1%) से आगे।
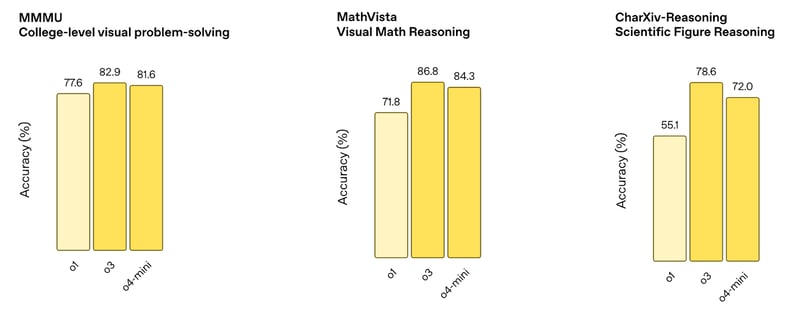
स्रोत: OpenAI
सामान्य QA और रीजनिंग
ये डेटासेट व्यापक प्रश्न‑उत्तर क्षमता का परीक्षण करते हैं, जिनमें PhD‑स्तरीय विज्ञान प्रश्न और विभिन्न विषयों में ओपन‑एंडेड रीजनिंग शामिल है। अच्छा स्कोर पाने के लिए अक्सर टूल उपयोग की ज़रूरत होती है।
- GPQA Diamond: o4-mini 81.4% स्कोर करता है, o3 (83.3%) से पीछे लेकिन o1 (78.0%) और o3-mini (77.0%) से ऊपर।
- Humanity’s Last Exam:
- o4-mini (बिना टूल्स): 14.28%
- o4-mini (Python + ब्राउज़िंग के साथ): 17.70%
- संदर्भ के लिए, o3 (टूल्स के साथ) ने 24.90% स्कोर किया, और Deep Research ने 26.60% स्कोर किया।
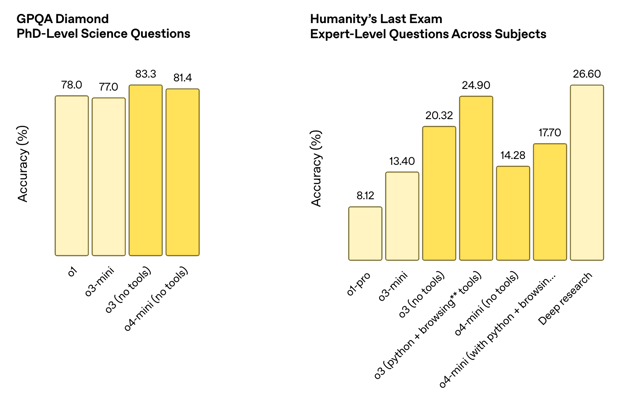
स्रोत: OpenAI
O4-Mini बनाम O3: आपको कौन‑सा उपयोग करना चाहिए?
O4-mini और o3 एक ही आधारभूत डिज़ाइन दर्शन पर आधारित हैं: टूल्स के साथ तर्क कर सकने वाले मॉडल, जो चरण‑दर‑चरण सोचें और टेक्स्ट, कोड व इमेज के साथ काम करें। लेकिन ये अलग‑अलग समझौतों के लिए बने हैं। संक्षेप में:
- चुनें o3 यदि सटीकता आपकी सर्वोच्च प्राथमिकता है और लागत कम मायने रखती है।
- चुनें o4-mini यदि स्पीड, वॉल्यूम या लागत‑कुशलता, कुछ अतिरिक्त बेंचमार्क अंकों से अधिक महत्वपूर्ण हैं।
कुल मिलाकर O3 अधिक मज़बूत है
O3, CharXiv, MathVista और Humanity’s Last Exam जैसे बेंचमार्क्स पर o4-mini से अधिक स्कोर करता है। यह उन जटिल कार्यों पर भी बेहतर स्थिरता दिखाता है जिनमें लंबी तर्क‑श्रृंखला या सटीक कोड जनरेशन की आवश्यकता होती है। यदि आप शोध समस्याओं, वैज्ञानिक वर्कफ़्लोज़, या ऐसे किसी भी कार्य पर काम कर रहे हैं जहाँ सटीकता स्पीड या लागत से अधिक महत्वपूर्ण है, तो o3 संभवतः अधिक सुरक्षित विकल्प है।
O4-mini कहीं अधिक सस्ता और तेज़ है
कीमत में फ़र्क़ काफ़ी बड़ा है: o4-mini की कीमत इनपुट के लिए $1.10 और आउटपुट के लिए $4.40 है, जबकि o3 के लिए क्रमशः $10 और $40। यह लगभग हर तरह से 10 गुना फ़र्क़ है। आपको तेज़ प्रतिक्रिया समय और उच्च थ्रूपुट भी मिलता है, जो इसे प्रोडक्शन वातावरण, रीयल‑टाइम टूल्स, या किसी भी स्केल वाले सिस्टम के लिए बेहतर बनाता है।
मल्टीमॉडैलिटी निर्णायक कारक नहीं है
दोनों मॉडल मल्टीमॉडल और टूल‑सक्षम हैं। दोनों Python, ब्राउज़िंग और विज़न का समर्थन करते हैं। यदि आप केवल इसी फीचर सेट की तलाश में हैं, तो कोई भी चलेगा।
ChatGPT और API में o4-mini तक कैसे पहुँचें
आप अपने प्लान के अनुसार ChatGPT और OpenAI API—दोनों में o4-mini का उपयोग कर सकते हैं।
ChatGPT में
यदि आप Plus, Pro, या Team सब्सक्रिप्शन के साथ ChatGPT का उपयोग कर रहे हैं, तो o4-mini पहले से उपलब्ध है। आप इसे मॉडल सिलेक्टर में “o4-mini” और “o4-mini-high” के रूप में सूचीबद्ध देखेंगे।
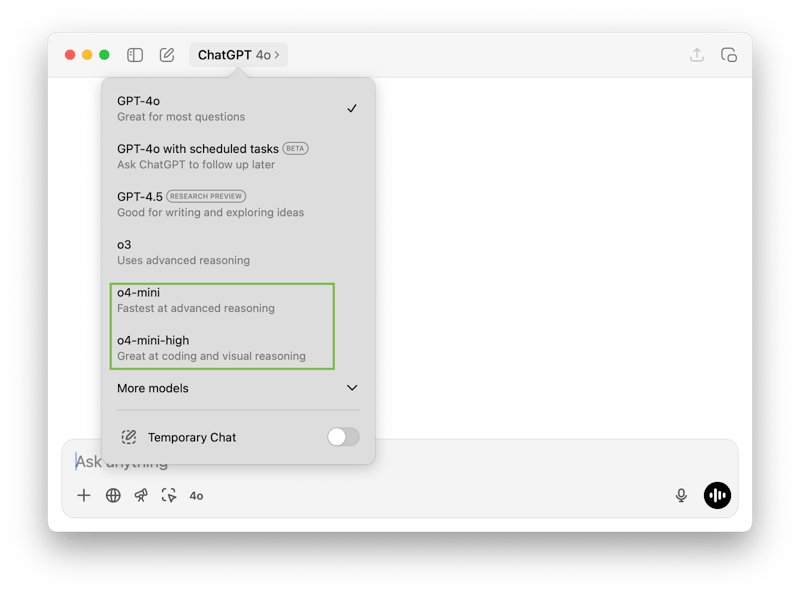
ये पुराने o3-mini और o1 विकल्पों की जगह लेते हैं। फ़्री उपयोगकर्ता भी कंपोज़र में प्रॉम्प्ट भेजने से पहले “Think” मोड चुनकर सीमित रूप में o4-mini आज़मा सकते हैं। ध्यान दें:
- o4-mini डिफ़ॉल्ट तेज़ संस्करण है।
- o4-mini-high बेहतर गुणवत्ता के लिए बढ़े हुए इन्फ़रेंस प्रयास के साथ चलता है, जिसकी कीमत स्पीड में कमी है।
API में
o4-mini OpenAI API के Chat Completions और Responses एंडपॉइंट्स के माध्यम से भी उपलब्ध है। दोनों संस्करण (स्टैंडर्ड और हाई) टूल उपयोग का समर्थन करते हैं, जिनमें ब्राउज़िंग, Python और इमेज इनपुट शामिल हैं—यह आपकी टूलसेट कॉन्फ़िगरेशन पर निर्भर करता है।
वर्तमान स्नैपशॉट के लिए मॉडल ID o4-mini-2025-04-16 है। कीमत प्रति मिलियन इनपुट टोकन $1.10 और प्रति मिलियन आउटपुट टोकन $4.40 निर्धारित है, साथ ही कैशिंग और बैचिंग समर्थित हैं। यदि आप Responses API के साथ काम कर रहे हैं, तो आपको रीजनिंग टोकन दृश्यता और मल्टी‑स्टेप चेन में टूल निष्पादन पर अधिक नियंत्रण भी मिलता है।
निष्कर्ष
o4-mini, गणित, कोड और मल्टीमॉडल कार्यों में ठोस प्रदर्शन देता है, जबकि o3 की तुलना में इन्फ़रेंस लागत को एक क्रम तक घटा देता है। बेंचमार्क्स दिखाते हैं कि यह उन कार्यों में भी टिकता है जहाँ मॉडल आमतौर पर जूझते हैं, जैसे मल्टीमॉडल रीजनिंग या कोडिंग।
यह पहली बार भी है जब OpenAI के किसी मिनी मॉडल में पूर्ण टूल समर्थन और नैटिव मल्टीमॉडैलिटी शामिल है। सिर्फ़ यही बात इसे o3-mini और o1 से आगे रखती है, जिन्हें यह अधिकांश ChatGPT टियर्स में प्रतिस्थापित करता है। और o4-mini-high के जुड़ने से, उपयोगकर्ताओं को स्पीड और आउटपुट गुणवत्ता के बीच संतुलन पर थोड़ा अधिक नियंत्रण मिलता है।
o4-mini सही मॉडल है या नहीं, यह कार्य पर निर्भर करता है। कच्ची क्षमता की दृष्टि से यह o3 को नहीं पछाड़ेगा, लेकिन किसी भी चीज़ के लिए जिसे तेज़ चलना है, आसानी से स्केल करना है, या सीमित बजट में रहना है—यह एक मज़बूत विकल्प है, और कई मामलों में, पर्याप्त अच्छा।
FAQs
क्या मैं o4-mini को फाइन‑ट्यून कर सकता/सकती हूँ?
नहीं। फिलहाल, o4-mini के लिए फाइन‑ट्यूनिंग समर्थित नहीं है।
API में o4-mini कौन‑से टूल्स का समर्थन करता है?
o4-mini, सेटअप के आधार पर Python, इमेज विश्लेषण और वेब ब्राउज़िंग जैसे टूल्स के साथ काम करता है।
o4-mini की संदर्भ विंडो क्या है?
o4-mini 200,000 टोकन की संदर्भ विंडो का समर्थन करता है, जिसमें अधिकतम 100,000 आउटपुट टोकन हैं। इससे यह लंबे दस्तावेज़, ट्रांसक्रिप्ट या बहु‑चरणीय रीजनिंग कार्यों को ट्रंकेशन के बिना संभाल सकता है।

मैं एक संपादक और लेखक हूँ जो AI ब्लॉग, ट्यूटोरियल, और समाचार कवर करता/करती हूँ, यह सुनिश्चित करते हुए कि सब कुछ ठोस कंटेंट रणनीति और SEO के सर्वोत्तम तरीकों के अनुरूप हो। मैंने Python, सांख्यिकी, प्रायिकता, और डेटा विज़ुअलाइज़ेशन पर डेटा साइंस पाठ्यक्रम लिखे हैं। मेरा एक पुरस्कृत उपन्यास भी प्रकाशित हो चुका है, और खाली समय में मैं पटकथा लेखन और फ़िल्म निर्देशन में समय बिताता/बिताती हूँ।
OpenAI ने हाल ही में o4-mini पेश किया है—एक नया रीजनिंग मॉडल जो o3 की तुलना में तेज़ और सस्ता है, फिर भी Python, ब्राउज़िंग और इमेज इनपुट जैसे टूल्स का समर्थन करता है। o3-mini के विपरीत, यह डिफ़ॉल्ट रूप से मल्टीमॉडल भी है।
इस लेख में, मैं देखता हूँ कि o4-mini वास्तव में क्या कर सकता है। मैंने गणित, कोड और विज़ुअल इनपुट पर कुछ व्यावहारिक परीक्षण चलाए हैं, और यह दिखाने के लिए OpenAI के आधिकारिक बेंचमार्क नंबर शामिल किए हैं कि यह o3 और o1 जैसे मॉडलों के मुकाबले कैसा ठहरता है।
आपको मूल्य निर्धारण, उपलब्धता, और किन स्थितियों में o4-mini को अन्य मॉडलों पर चुनना समझदारी है—इसकी भी जानकारी मिलेगी।
हम अपने पाठकों को AI की नवीनतम जानकारी से अपडेट रखते हैं The Median के ज़रिए—हमारा मुफ़्त शुक्रवार न्यूज़लेटर जो हफ्ते की प्रमुख कहानियों को सरलता से समझाता है। सब्सक्राइब करें और हफ्ते में कुछ ही मिनटों में अपडेट रहें:
O4-Mini क्या है?
O4-mini, OpenAI की o-सीरीज़ में हाल का छोटा-स्केल रीजनिंग मॉडल है। इसे स्पीड, किफ़ायत और टूल-आधारित रीजनिंग के लिए ऑप्टिमाइज़ किया गया है, 200,000-टोकन संदर्भ विंडो और 100,000 आउटपुट टोकन तक के समर्थन के साथ—जो o3 और o1 के बराबर है।
स्रोत: OpenAI
जहाँ सबसे बड़ा फर्क पड़ता है, वह है लागत और डिप्लॉयमेंट क्षमता। o4-mini की दरें प्रति मिलियन इनपुट टोकन $1.10 और प्रति मिलियन आउटपुट टोकन $4.40 हैं, जबकि o3 के लिए इनपुट $10.00 और आउटपुट $40.00 हैं—इनपुट और आउटपुट दोनों पर लगभग 10 गुना लागत में कमी। जैसा कि हम बेंचमार्क अनुभाग में देखेंगे, o4-mini का प्रदर्शन o3 के तुलनीय है।
o4-mini API प्राइसिंग (बाएँ) बनाम o3 की प्राइसिंग (दाएँ)
टूल्स की दृष्टि से, o4-mini Python, ब्राउज़िंग और इमेज इनपुट के साथ संगत है, और मानक OpenAI एंडपॉइंट्स—Chat Completions और Responses—से इंटीग्रेट होता है। स्ट्रीमिंग, फ़ंक्शन कॉलिंग, और स्ट्रक्चर्ड आउटपुट समर्थित हैं। फ़ाइन-ट्यूनिंग और एम्बेडिंग्स समर्थित नहीं हैं।
o4-mini बनाम o4-mini-high
यदि आपने ChatGPT ऐप खोला है, तो आपने o4-mini और o4-mini-high के बीच चुनने का विकल्प देखा होगा। o4-mini-high, उसी आधारभूत मॉडल का एक कॉन्फ़िगरेशन है जिसमें इन्फ़रेंस प्रयास बढ़ा होता है। इसका मतलब:
यदि आपको तेज़ कम्प्लीशन चाहिए, तो o4-mini बेहतर विकल्प हो सकता है। अधिक जटिल रीजनिंग (खासतौर पर जब कोडिंग या विज़ुअल इनपुट पर रीजनिंग करनी हो), लंबा संदर्भ, या सटीकता-सम्बंधित उपयोग मामलों के लिए, o4-mini-high बेहतर आउटपुट दे सकता है।
O4-Mini का परीक्षण
आइए o4-mini को थोड़े गणित, कोडिंग और मल्टीमॉडल इनपुट पर परखते हैं।
गणित
सबसे पहले, मैं एक सरल गणना से शुरू करना चाहता था जो आमतौर पर भाषा मॉडलों को उलझा देती है। मेरा मकसद बुनियादी अंकगणित कौशल जाँचना नहीं था—बल्कि यह देखना था कि मॉडल इसे हल करने के लिए सही तरीका चुनता है या नहीं, चाहे चरण-दर-चरण तर्क से या कैलकुलेटर जैसे टूल को कॉल करके।
पहले प्रयास में आउटपुट गलत था। मैंने कैलकुलेटर का उपयोग करने का सुझाव दिया, और दूसरी बार उत्तर सही था, लेकिन दो समस्याएँ रहीं। पहली, इसने परिणाम को “लगभग” बताया, जबकि इस घटाव में न राउंडिंग की ज़रूरत थी न अनुमान की।
दूसरी, इसके रीजनिंग से पता चला कि इसने वास्तव में कैलकुलेटर का उपयोग नहीं किया था, बावजूद इसके कि आउटपुट में लिखा था “कैलकुलेटर दिखाता है” (जो परिणाम प्राप्त करने के तरीक़े का गलत प्रतिनिधित्व है)। अजीब बात यह भी थी कि इसने वेब सर्च किया, जो एक साधारण गणित समस्या के लिए अनावश्यक लगता है।
इसके बाद, मैंने मॉडल को एक अधिक चुनौतीपूर्ण गणित समस्या पर परखा, और इस बार परिणाम ठोस था। इसने तेज़ी से जवाब दिया और समस्या को एक छोटे Python स्क्रिप्ट से हल किया, जिसे मैं सीधे इसकी चेन-ऑफ़-थॉट में देख सकता था। तर्क-प्रक्रिया के हिस्से के रूप में कोड देख पाना सच में उपयोगी फ़ीचर है।
एक छोटा P5js गेम जनरेट करना
कुछ हफ्ते पहले, जब मैंने Gemini 2.5 Pro का परीक्षण किया था, तो मैंने एक त्वरित p5.js गेम जनरेट किया था ताकि यह देखा जा सके कि वह क्रिएटिव कोडिंग कार्यों को कैसे हैंडल करता है। मैं वही प्रॉम्प्ट o4-mini के साथ चलाना चाहता था, लेकिन इस बार मैंने o4-mini-high का उपयोग किया। परिणाम Gemini 2.5 Pro से बहुत अलग नहीं था—जो कि शानदार है, यह देखते हुए कि यह एक छोटा मॉडल है।
प्रॉम्प्ट था: मेरे लिए एक मनमोहक एंडलेस रनर गेम बनाइए। स्क्रीन पर मुख्य निर्देश दें। p5js सीन हो, HTML न हो। मुझे पिक्सेलेटेड डायनासोर और दिलचस्प बैकग्राउंड अच्छे लगते हैं।
और पहला परिणाम: