नवंबर 2022 में OpenAI ने ChatGPT लॉन्च किया। कुछ ही दिनों में अपनी अभूतपूर्व क्षमताओं के साथ इसने दुनिया भर में धूम मचा दी। जनरेटिव AI की क्रांति शुरू हो चुकी थी, और हर कोई यही पूछ रहा था: आगे क्या?
उस समय, ChatGPT और बड़े भाषा मॉडल्स (LLMs) द्वारा संचालित कई अन्य जनरेटिव AI टूल्स उपयोगकर्ताओं से केवल टेक्स्ट इनपुट लेते और टेक्स्ट आउटपुट ही जनरेट करते थे। दूसरे शब्दों में, उन्हें यूनिमोडल AI टूल्स माना जाता था।
हालाँकि, यह तो बस शुरुआत थी। हम अभी LLMs की क्षमताओं की सतह ही खरोंच रहे थे। ChatGPT के लॉन्च के सिर्फ एक साल बाद ही उद्योग की प्रगति चौंकाने वाली रही है, जिससे संभव की सीमाएँ तय करना बेहद मुश्किल हो गया है—जैसा कि हमने अपने अलग लेख ChatGPT और जनरेटिव AI के दीर्घकालिक प्रभाव में विश्लेषित किया है।
आज, अगर हमें यह सवाल जवाब देना हो कि आगे क्या? तो सबसे अच्छा उत्तर शायद मल्टीमोडल लर्निंग है। यह चल रही AI क्रांति की सबसे आशाजनक प्रवृत्तियों में से एक है। मल्टीमोडल जनरेटिव AI मॉडल्स विभिन्न प्रकार के इनपुट्स को संयोजित करने और ऐसे आउटपुट बनाने में सक्षम हैं जिनमें एक से अधिक प्रकार के आउटपुट शामिल हो सकते हैं।
इस गाइड में, हम आपको मल्टीमोडल AI की अवधारणा से परिचित कराएँगे। हम मल्टीमोडल AI की परिभाषा, इसके मूल सिद्धांत, आधारभूत तकनीकों और उपयोगों पर नज़र डालेंगे, साथ ही यह भी देखेंगे कि असल दुनिया में इन्हें कैसे लागू किया जाए। मल्टीमोडैलिटी के लिए तैयार हैं? आइए शुरू करें!
मल्टीमोडल AI को समझना
हालाँकि अधिकांश उन्नत जनरेटिव AI टूल अभी भी मनुष्यों की तरह सोचने में सक्षम नहीं हैं, वे ऐसे क्रांतिकारी परिणाम दे रहे हैं जो हमें आर्टिफिशियल जनरल इंटेलिजेंस (AGI) की दहलीज़ के और करीब ले जा रहे हैं। यह शब्द एक परिकल्पित AI प्रणाली को संदर्भित करता है जो मनुष्यों की तरह विविध कार्यों में समझ, सीखने और ज्ञान लागू करने में सक्षम हो।
AGI हासिल करने पर होने वाली बहस में एक केंद्रीय प्रश्न यह है कि मनुष्य कैसे सीखते हैं। और यह हमें मानव मस्तिष्क के काम करने के तरीके तक ले जाता है। संक्षेप में कहें तो, हमारा मस्तिष्क पाँच इंद्रियों पर निर्भर रहता है ताकि आसपास के वातावरण से हर प्रकार की जानकारी एकत्र कर सके। यह जानकारी फिर हमारी स्मृति में संग्रहीत होती है, नए निष्कर्ष सीखने के लिए प्रोसेस की जाती है, और निर्णय लेने में काम आती है।
पहले आधुनिक जनरेटिव AI मॉडल्स, जैसे ChatGPT, यूनिमोडल माने जाते थे; यानी वे केवल एक प्रकार के डेटा को इनपुट के रूप में ले सकते थे और उसी प्रकार का आउटपुट दे सकते थे। विशेष रूप से, अधिकांश मॉडल्स टेक्स्ट प्रॉम्प्ट्स को प्रोसेस करने और टेक्स्ट उत्तर जनरेट करने के लिए डिज़ाइन किए गए थे।
यह तार्किक भी है, क्योंकि इन मॉडल्स को ट्रेन करने के लिए भारी मात्रा में डेटा चाहिए होता है, और टेक्स्ट न केवल आसानी से संग्रहीत और प्रोसेस किया जा सकता है, बल्कि यह आसानी से उपलब्ध भी है। यह आश्चर्य की बात नहीं कि ChatGPT जैसे टूल्स का अधिकांश प्रशिक्षण डेटा इंटरनेट के अलग-अलग स्रोतों से आता है। हम इन सभी तकनीकी बातों को अपने What is ChatGPT लेख में समझाते हैं, जहाँ हमने सवाल सीधे ChatGPT से ही पूछे हैं।
हालाँकि, पढ़ना मनुष्यों के सीखने के अनेक तरीकों में से केवल एक है, और कई कार्यों के लिए यह सबसे प्रभावी भी नहीं होता।
मल्टीमोडल लर्निंग AI का वह उप-क्षेत्र है जो मशीनों की सीखने की क्षमता को बढ़ाने के लिए उन्हें बड़े पैमाने पर टेक्स्ट के साथ-साथ अन्य डेटा प्रकारों—जिन्हें संवेदी डेटा भी कहा जाता है—जैसे छवियाँ, वीडियो, या ऑडियो रिकॉर्डिंग से प्रशिक्षित करता है। यह मॉडल्स को टेक्स्ट विवरणों और उनसे जुड़ी छवियों, वीडियो या ऑडियो के बीच नए पैटर्न और सहसंबंध सीखने में सक्षम बनाता है।
मल्टीमोडल लर्निंग बुद्धिमान प्रणालियों के लिए नई संभावनाएँ खोल रही है। प्रशिक्षण प्रक्रिया के दौरान कई डेटा प्रकारों का संयोजन मल्टीमोडल AI मॉडल्स को कई तरह के इनपुट स्वीकार करने और कई प्रकार के आउटपुट जनरेट करने के लिए उपयुक्त बनाता है। उदाहरण के लिए, ChatGPT का फाउंडेशन मॉडल GPT-4, छवि और टेक्स्ट दोनों इनपुट स्वीकार कर सकता है और टेक्स्ट आउटपुट जनरेट करता है, और OpenAI का हाल ही में घोषित Sora टेक्स्ट-टू-वीडियो मॉडल।
मल्टीमोडल AI के मुख्य सिद्धांत
मल्टीमोडल जनरेटिव AI मॉडल्स अत्याधुनिक LLMs में जटिलता की एक नई परत जोड़ते हैं। ये मॉडल्स ट्रांसफॉर्मर नामक न्यूरल आर्किटेक्चर के एक प्रकार पर आधारित होते हैं। Google शोधकर्ताओं द्वारा विकसित ट्रांसफॉर्मर्स एन्कोडर-डीकोडर आर्किटेक्चर और अटेंशन मैकेनिज्म पर निर्भर रहते हैं जिससे डेटा का कुशल प्रोसेसिंग संभव हो पाता है।
यह एक काफ़ी जटिल प्रक्रिया है जिसे समझना कठिन हो सकता है। यदि आप जानना चाहते हैं कि LLMs और ट्रांसफॉर्मर्स कैसे काम करते हैं, तो हमारा How Transformers Work गाइड ज़रूर पढ़ें, या यदि आप हाथ गंदे करके चरण-दर-चरण LLMs बनाना सीखना चाहते हैं, तो हमारा Large Language Models (LLMs) Concepts कोर्स देखें।
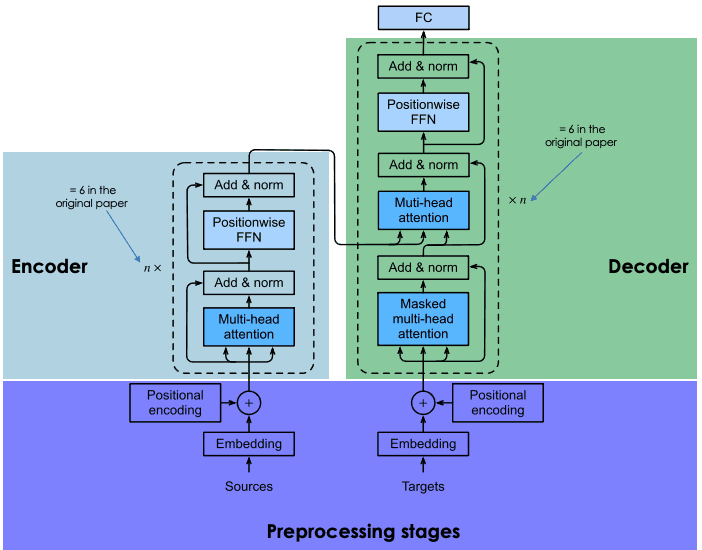
स्रोत: DataCamp
मल्टीमोडल AI, विभिन्न डेटा प्रकारों को एकीकृत करने और आधारभूत डेटा की अधिक संपूर्ण और सटीक समझ बनाने के लिए डेटा फ्यूज़न तकनीकों पर निर्भर करता है। अंतिम लक्ष्य विभिन्न डेटा मोडैलिटीज़ द्वारा उपलब्ध कराई गई पूरक जानकारी को मिलाकर बेहतर भविष्यवाणियाँ करना है।
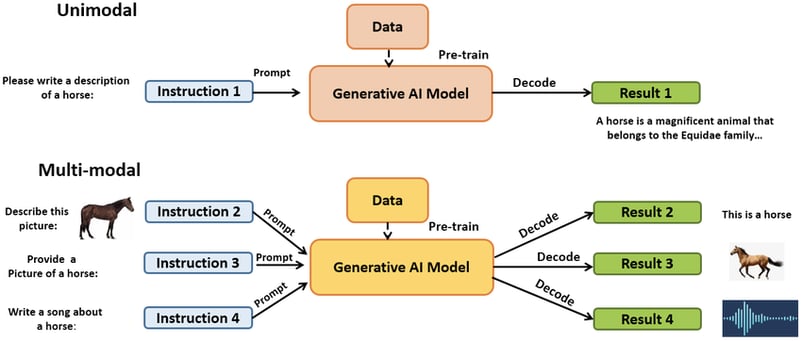
यूनिमोडल बनाम मल्टीमोडल AI। स्रोत: ResearchGate
मल्टीमोडल चुनौतियों से निपटने के लिए कई डेटा फ्यूज़न तकनीकें लागू की जा सकती हैं। फ्यूज़न जिस प्रोसेसिंग चरण पर होता है, उसके आधार पर हम डेटा फ्यूज़न तकनीकों को तीन श्रेणियों में बाँट सकते हैं:
- अर्ली फ्यूज़न। इसमें विभिन्न मोडैलिटीज़ को मॉडल में एन्कोड करके एक साझा प्रतिनिधित्व स्पेस बनाया जाता है। इस प्रक्रिया का परिणाम एक एकल, मोडैलिटी-इनवेरिएंट आउटपुट होता है जो सभी मोडैलिटीज़ की सिमैंटिक जानकारी को समेटे रहता है।
- मिड फ्यूज़न। इसमें अलग-अलग प्रीप्रोसेसिंग चरणों पर मोडैलिटीज़ को संयोजित किया जाता है। यह न्यूरल नेटवर्क में विशेष लेयर्स बनाकर हासिल किया जाता है जो खास तौर पर डेटा फ्यूज़न के लिए डिज़ाइन की गई होती हैं।
- लेट फ्यूज़न। इसमें अलग-अलग मोडैलिटीज़ को प्रोसेस करने के लिए कई मॉडल बनाए जाते हैं और प्रत्येक मॉडल के आउटपुट को एक नई एल्गोरिदमिक लेयर में जोड़ा जाता है।
हर तरह के परिदृश्यों के लिए कोई एकल डेटा फ्यूज़न तकनीक सर्वोत्तम नहीं होती। इसके बजाय, चुनी गई तकनीक मौजूदा मल्टीमोडल कार्य पर निर्भर करेगी। इसलिए, सबसे उपयुक्त मल्टीमोडल AI पाइपलाइन खोजने के लिए ट्रायल-अनुभव की प्रक्रिया की आवश्यकता पड़ सकती है।
मल्टीमोडल AI को शक्ति देने वाली तकनीकें
मल्टीमोडल AI, AI के कई उप-क्षेत्रों में संचित ज्ञान का परिणाम है। हाल के वर्षों में, AI प्रैक्टिशनर्स और शोधकर्ताओं ने कई फ़ॉर्मैट्स और मोडैलिटीज़ में डेटा को स्टोर और प्रोसेस करने में उल्लेखनीय प्रगति की है।
नीचे वे डोमेन्स दिए गए हैं जो मल्टीमोडल AI की उछाल को ऊर्जा दे रहे हैं:
डीप लर्निंग
डीप लर्निंग AI का वह उप-क्षेत्र है जो जटिल कार्यों को हल करने के लिए आर्टिफ़िशियल न्यूरल नेटवर्क नामक एल्गोरिदम का उपयोग करता है। मौजूदा जनरेटिव AI क्रांति डीप लर्निंग मॉडल्स, विशेष रूप से ट्रांसफॉर्मर्स, द्वारा संचालित है, जो एक प्रकार की न्यूरल आर्किटेक्चर हैं।
मल्टीमोडल AI का भविष्य भी इसी डोमेन में नई प्रगति पर निर्भर करेगा। खास तौर पर, ट्रांसफॉर्मर्स की क्षमताओं को बढ़ाने के नए तरीकों के साथ-साथ नई डेटा फ्यूज़न तकनीकों की खोज के लिए और शोध की ज़रूरत है।
इस आशाजनक क्षेत्र में अपनी सीख को आगे बढ़ाने के लिए हमारा Deep Learning in Python ट्रैक देखें।
नेचुरल लैंग्वेज प्रोसेसिंग (NLP)
NLP, कृत्रिम बुद्धिमत्ता में एक केंद्रीय तकनीक है, जो मानव संचार और कंप्यूटर समझ के बीच की खाई को पाटती है। यह एक बहु-विषयक क्षेत्र है जो कंप्यूटरों को मानव भाषा की व्याख्या, विश्लेषण और उत्पन्न करने में सक्षम बनाता है, जिससे मनुष्यों और मशीनों के बीच सहज इंटरेक्शन संभव हो पाता है।
चूँकि मशीनों से संवाद करने का प्राथमिक तरीका टेक्स्ट है, इसलिए यह आश्चर्यजनक नहीं कि NLP, जनरेटिव AI मॉडल्स—मल्टीमोडल सहित—के उच्च प्रदर्शन को सुनिश्चित करने के लिए महत्वपूर्ण है।
NLP में रुचि है? असंरचित डेटा को मूल्यवान अंतर्दृष्टियों में बदलने के लिए आवश्यक कोर NLP कौशल पाने हेतु हमारा Natural Language Processing in Python ट्रैक देखें।
कंप्यूटर विज़न
इमेज विश्लेषण, जिसे कंप्यूटर विज़न भी कहते हैं, उन तकनीकों का समूह है जिसके माध्यम से कंप्यूटर किसी छवि को “देख” और समझ सकते हैं। इस क्षेत्र में हुई प्रगति ने ऐसे मल्टीमोडल AI मॉडल्स के विकास को संभव किया है जो छवियों और वीडियो को इनपुट और आउटपुट—दोनों रूपों में—प्रोसेस कर सकते हैं।
यदि आप इस रोचक विषय में और गहराई से जाना चाहते हैं, तो अपने डेटा साइंस टूलबॉक्स में इमेज प्रोसेसिंग कौशल जोड़ने के लिए हमारा Image Processing with Python स्किल ट्रैक देखें।
ऑडियो प्रोसेसिंग
कुछ सबसे उन्नत जनरेटिव AI मॉडल्स ऑडियो फ़ाइलों को इनपुट और आउटपुट—दोनों रूपों में—प्रोसेस करने में सक्षम हैं। ऑडियो प्रोसेसिंग की संभावनाएँ वॉयस मैसेज की व्याख्या से लेकर एकसाथ अनुवाद और संगीत रचना तक फैली हुई हैं।
Python में कच्ची ऑडियो फ़ाइलों से स्पीच को लोड, ट्रांसफ़ॉर्म और ट्रांसक्राइब करना सीखने के लिए हमारा Spoken Language Processing in Python कोर्स देखें।
मल्टीमोडल AI के अनुप्रयोग
मल्टीमोडल लर्निंग मशीनों को नई “इंद्रियाँ” प्रदान करती है, जिससे उनकी सटीकता और व्याख्या क्षमताएँ बढ़ती हैं। ये शक्तियाँ विभिन्न क्षेत्रों और उद्योगों में अनेक नए अनुप्रयोगों का मार्ग खोल रही हैं, जिनमें शामिल हैं:
ऑगमेंटेड जनरेटिव AI
पहली पीढ़ी के अधिकांश जनरेटिव AI मॉडल्स टेक्स्ट-टू-टेक्स्ट थे, जो उपयोगकर्ताओं के टेक्स्ट प्रॉम्प्ट्स को प्रोसेस करके टेक्स्ट उत्तर प्रदान कर सकते थे। मल्टीमोडल मॉडल्स, जैसे GPT-4 Turbo, Google Gemini, या DALL-E, इनपुट और आउटपुट—दोनों पक्षों पर—उपयोगकर्ता अनुभव को बेहतर करने वाली नई संभावनाओं के साथ आते हैं। चाहे कई मोडैलिटीज़ में प्रॉम्प्ट स्वीकार करना हो या विभिन्न फ़ॉर्मैट्स में सामग्री जनरेट करना, मल्टीमोडल AI एजेंट्स की संभावनाएँ असीम लगती हैं।
स्वचालित कारें
स्वचालित कारें बड़े पैमाने पर मल्टीमोडल AI पर निर्भर करती हैं। ये कारें कई सेंसर से लैस होती हैं जो आसपास से अलग-अलग फ़ॉर्मैट्स में जानकारी प्रोसेस करती हैं। इन स्रोतों को प्रभावी और कुशल तरीके से संयोजित कर वास्तविक समय में बुद्धिमान निर्णय लेने के लिए मल्टीमोडल लर्निंग महत्वपूर्ण है।
बायोमेडिसिन
बायोबैंक्स, इलेक्ट्रॉनिक स्वास्थ्य रिकॉर्ड्स, क्लिनिकल इमेजिंग, मेडिकल सेंसर, साथ ही जीनोमिक डेटा से बायोमेडिकल डेटा की बढ़ती उपलब्धता चिकित्सा के क्षेत्र में मल्टीमोडल AI मॉडल्स के निर्माण को गति दे रही है। ये मॉडल्स कई मोडैलिटीज़ में आने वाले इन विभिन्न डेटा स्रोतों को प्रोसेस करने में सक्षम होते हैं, जिससे मानव स्वास्थ्य और रोगों के रहस्यों को सुलझाने और बुद्धिमान नैदानिक निर्णय लेने में मदद मिलती है।
पृथ्वी विज्ञान और जलवायु परिवर्तन
स्थलीय सेंसर, ड्रोन, सैटेलाइट डेटा और अन्य मापन तकनीकों के तेज़ी से विस्तार से हमारे ग्रह को समझने की क्षमता बढ़ रही है। इस जानकारी को सटीकता से संयोजित करने और नए अनुप्रयोगों व टूल्स बनाने में—जैसे ग्रीनहाउस गैस उत्सर्जन की निगरानी, चरम जलवायु घटनाओं का पूर्वानुमान, और प्रिसीजन कृषि—मल्टीमोडल AI अत्यंत महत्वपूर्ण है।
मल्टीमोडल AI समाधान लागू करने की चुनौतियाँ
मल्टीमोडल AI का उभार व्यवसायों, सरकारों और व्यक्तियों के लिए असीम संभावनाएँ लेकर आ रहा है। हालाँकि, किसी भी नवप्रवर्तक तकनीक की तरह, उन्हें अपनी दैनिक कार्यप्रणाली में लागू करना चुनौतीपूर्ण हो सकता है।
सबसे पहले, आपको उन उपयोग मामलों की पहचान करनी होगी जो आपकी विशिष्ट आवश्यकताओं से मेल खाते हों। अवधारणा से परिनियोजन तक पहुँचना हमेशा आसान नहीं होता, खासकर तब जब आपके पास मल्टीमोडल AI के पीछे की तकनीकी बारीकियों को सही से समझने वाले लोग न हों। हालांकि मौजूदा डेटा साक्षरता कौशल अंतर को देखते हुए, अपने मॉडल्स को प्रोडक्शन में ले जाने के लिए सही लोगों को खोजना कठिन और महँगा हो सकता है, क्योंकि कंपनियाँ इस सीमित प्रतिभा को आकर्षित करने के लिए ऊँची रकम देने को तैयार हैं।
अंततः, जब जनरेटिव AI की बात आती है, तो सामर्थ्य का ज़िक्र करना अनिवार्य है। ये मॉडल्स, खासकर मल्टीमोडल वाले, काम करने के लिए पर्याप्त कंप्यूटिंग संसाधन मांगते हैं, और इसका अर्थ है धन। इसलिए, किसी भी जनरेटिव AI समाधान को अपनाने से पहले, यह आकलन करना महत्वपूर्ण है कि आप कितने संसाधन निवेश करना चाहते हैं।
मल्टीमोडल AI के जोखिम
किसी भी नई तकनीक की तरह, मल्टीमोडल AI मॉडल्स के साथ भी कई संभावित जोखिम हैं जिनसे सावधानीपूर्वक निपटना होगा:
- पारदर्शिता की कमी। एल्गोरिदमिक अपारदर्शिता जनरेटिव AI से जुड़ी मुख्य चिंताओं में से एक है। यह मल्टीमोडल AI पर भी लागू होती है। इन मॉडलों को प्रायः उनकी जटिलता के कारण ‘ब्लैक बॉक्स’ कहा जाता है, जिससे उनके तर्क और आंतरिक कार्यप्रणाली की निगरानी असंभव हो जाती है।
- मल्टीमोडल AI पर एकाधिकार। मल्टीमोडल मॉडल विकसित करने, ट्रेन करने और चलाने के लिए आवश्यक भारी संसाधनों को देखते हुए, बाज़ार कुछ बड़ी टेक कंपनियों में अत्यधिक केंद्रित है जिनके पास आवश्यक विशेषज्ञता और साधन हैं। सौभाग्य से, बढ़ती संख्या में ओपन-सोर्स LLMs बाज़ार में आ रहे हैं, जिससे डेवलपर्स, AI शोधकर्ताओं और समाज के लिए LLMs को समझना और चलाना आसान हो रहा है।
- पक्षपात और भेदभाव। जिन डेटा पर मल्टीमोडल AI मॉडल्स को ट्रेन किया जाता है, उनके आधार पर उनमें ऐसे पक्षपात हो सकते हैं जो अनुचित निर्णयों का कारण बनते हैं और अक्सर विशेष रूप से अल्पसंख्यक समूहों के खिलाफ भेदभाव को बढ़ाते हैं। जैसा कि पहले ही उल्लेख किया गया है, संभावित पक्षपात को बेहतर ढंग से समझने और दूर करने के लिए पारदर्शिता आवश्यक है।
- गोपनीयता से जुड़े मुद्दे। मल्टीमोडल AI मॉडल्स को कई स्रोतों और फ़ॉर्मैट्स से आने वाले भारी मात्रा के डेटा से प्रशिक्षित किया जाता है। कई मामलों में इसमें व्यक्तिगत डेटा भी शामिल हो सकता है। यह डेटा गोपनीयता और सुरक्षा से जुड़े जोखिमों और समस्याओं को जन्म दे सकता है।
- नैतिक विचार। मल्टीमोडल AI कभी-कभी ऐसे निर्णयों की ओर ले जा सकता है जिनका हमारे जीवन पर गंभीर असर हो, और जो हमारे मौलिक अधिकारों को प्रभावित करें। हमने एक अलग पोस्ट में जनरेटिव AI की नैतिकता की पड़ताल की है।
- पर्यावरणीय विचार। शोधकर्ता और पर्यावरणीय निगरानी संस्थाएँ जनरेटिव AI मॉडल्स के प्रशिक्षण और संचालन से जुड़े पर्यावरणीय पदचिह्न को लेकर चिंताएँ जता रहे हैं। स्वामित्व वाले मल्टीमोडल AI मॉडल्स के मालिक प्रायः मॉडलों द्वारा उपभोग की गई ऊर्जा और संसाधनों, या उससे जुड़े पर्यावरणीय प्रभाव की जानकारी प्रकाशित नहीं करते—जो इन टूल्स के तेज़ी से अपनाव के साथ बेहद चिंताजनक है।
मल्टीमोडल AI का भविष्य
मल्टीमोडल AI निश्चित रूप से जनरेटिव AI क्रांति की अगली सीमा है। मल्टीमोडल लर्निंग के क्षेत्र में तेज़ी से हो रहा विकास हर तरह के उद्देश्यों के लिए नए मॉडल्स और अनुप्रयोगों के सृजन को गति दे रहा है। हम इस क्रांति की अभी शुरुआत में हैं। जैसे-जैसे अधिक और नई मोडैलिटीज़ को संयोजित करने की तकनीकें विकसित होंगी, मल्टीमोडल AI का दायरा और विस्तृत होगा।
हालाँकि, बड़ी शक्ति के साथ बड़ी ज़िम्मेदारी भी आती है। एक न्यायसंगत और टिकाऊ भविष्य सुनिश्चित करने के लिए मल्टीमोडल AI से जुड़े गंभीर जोखिमों और चुनौतियों का समाधान करना आवश्यक है।
यदि आप जनरेटिव AI में शुरुआत करना चाहते हैं, तो DataCamp आपके लिए तैयार है। हमारे समर्पित कोर्स, ब्लॉग और सामग्री देखें:


नवंबर 2022 में OpenAI ने ChatGPT लॉन्च किया। कुछ ही दिनों में अपनी अभूतपूर्व क्षमताओं के साथ इसने दुनिया भर में धूम मचा दी। जनरेटिव AI की क्रांति शुरू हो चुकी थी, और हर कोई यही पूछ रहा था: आगे क्या?
उस समय, ChatGPT और बड़े भाषा मॉडल्स (LLMs) द्वारा संचालित कई अन्य जनरेटिव AI टूल्स उपयोगकर्ताओं से केवल टेक्स्ट इनपुट लेते और टेक्स्ट आउटपुट ही जनरेट करते थे। दूसरे शब्दों में, उन्हें यूनिमोडल AI टूल्स माना जाता था।
हालाँकि, यह तो बस शुरुआत थी। हम अभी LLMs की क्षमताओं की सतह ही खरोंच रहे थे। ChatGPT के लॉन्च के सिर्फ एक साल बाद ही उद्योग की प्रगति चौंकाने वाली रही है, जिससे संभव की सीमाएँ तय करना बेहद मुश्किल हो गया है—जैसा कि हमने अपने अलग लेख ChatGPT और जनरेटिव AI के दीर्घकालिक प्रभाव में विश्लेषित किया है।
आज, अगर हमें यह सवाल जवाब देना हो कि आगे क्या? तो सबसे अच्छा उत्तर शायद मल्टीमोडल लर्निंग है। यह चल रही AI क्रांति की सबसे आशाजनक प्रवृत्तियों में से एक है। मल्टीमोडल जनरेटिव AI मॉडल्स विभिन्न प्रकार के इनपुट्स को संयोजित करने और ऐसे आउटपुट बनाने में सक्षम हैं जिनमें एक से अधिक प्रकार के आउटपुट शामिल हो सकते हैं।
इस गाइड में, हम आपको मल्टीमोडल AI की अवधारणा से परिचित कराएँगे। हम मल्टीमोडल AI की परिभाषा, इसके मूल सिद्धांत, आधारभूत तकनीकों और उपयोगों पर नज़र डालेंगे, साथ ही यह भी देखेंगे कि असल दुनिया में इन्हें कैसे लागू किया जाए। मल्टीमोडैलिटी के लिए तैयार हैं? आइए शुरू करें!
मल्टीमोडल AI को समझना
हालाँकि अधिकांश उन्नत जनरेटिव AI टूल अभी भी मनुष्यों की तरह सोचने में सक्षम नहीं हैं, वे ऐसे क्रांतिकारी परिणाम दे रहे हैं जो हमें आर्टिफिशियल जनरल इंटेलिजेंस (AGI) की दहलीज़ के और करीब ले जा रहे हैं। यह शब्द एक परिकल्पित AI प्रणाली को संदर्भित करता है जो मनुष्यों की तरह विविध कार्यों में समझ, सीखने और ज्ञान लागू करने में सक्षम हो।
AGI हासिल करने पर होने वाली बहस में एक केंद्रीय प्रश्न यह है कि मनुष्य कैसे सीखते हैं। और यह हमें मानव मस्तिष्क के काम करने के तरीके तक ले जाता है। संक्षेप में कहें तो, हमारा मस्तिष्क पाँच इंद्रियों पर निर्भर रहता है ताकि आसपास के वातावरण से हर प्रकार की जानकारी एकत्र कर सके। यह जानकारी फिर हमारी स्मृति में संग्रहीत होती है, नए निष्कर्ष सीखने के लिए प्रोसेस की जाती है, और निर्णय लेने में काम आती है।
पहले आधुनिक जनरेटिव AI मॉडल्स, जैसे ChatGPT, यूनिमोडल माने जाते थे; यानी वे केवल एक प्रकार के डेटा को इनपुट के रूप में ले सकते थे और उसी प्रकार का आउटपुट दे सकते थे। विशेष रूप से, अधिकांश मॉडल्स टेक्स्ट प्रॉम्प्ट्स को प्रोसेस करने और टेक्स्ट उत्तर जनरेट करने के लिए डिज़ाइन किए गए थे।
यह तार्किक भी है, क्योंकि इन मॉडल्स को ट्रेन करने के लिए भारी मात्रा में डेटा चाहिए होता है, और टेक्स्ट न केवल आसानी से संग्रहीत और प्रोसेस किया जा सकता है, बल्कि यह आसानी से उपलब्ध भी है। यह आश्चर्य की बात नहीं कि ChatGPT जैसे टूल्स का अधिकांश प्रशिक्षण डेटा इंटरनेट के अलग-अलग स्रोतों से आता है। हम इन सभी तकनीकी बातों को अपने What is ChatGPT लेख में समझाते हैं, जहाँ हमने सवाल सीधे ChatGPT से ही पूछे हैं।
हालाँकि, पढ़ना मनुष्यों के सीखने के अनेक तरीकों में से केवल एक है, और कई कार्यों के लिए यह सबसे प्रभावी भी नहीं होता।
मल्टीमोडल लर्निंग AI का वह उप-क्षेत्र है जो मशीनों की सीखने की क्षमता को बढ़ाने के लिए उन्हें बड़े पैमाने पर टेक्स्ट के साथ-साथ अन्य डेटा प्रकारों—जिन्हें संवेदी डेटा भी कहा जाता है—जैसे छवियाँ, वीडियो, या ऑडियो रिकॉर्डिंग से प्रशिक्षित करता है। यह मॉडल्स को टेक्स्ट विवरणों और उनसे जुड़ी छवियों, वीडियो या ऑडियो के बीच नए पैटर्न और सहसंबंध सीखने में सक्षम बनाता है।
मल्टीमोडल लर्निंग बुद्धिमान प्रणालियों के लिए नई संभावनाएँ खोल रही है। प्रशिक्षण प्रक्रिया के दौरान कई डेटा प्रकारों का संयोजन मल्टीमोडल AI मॉडल्स को कई तरह के इनपुट स्वीकार करने और कई प्रकार के आउटपुट जनरेट करने के लिए उपयुक्त बनाता है। उदाहरण के लिए, ChatGPT का फाउंडेशन मॉडल GPT-4, छवि और टेक्स्ट दोनों इनपुट स्वीकार कर सकता है और टेक्स्ट आउटपुट जनरेट करता है, और OpenAI का हाल ही में घोषित Sora टेक्स्ट-टू-वीडियो मॉडल।
मल्टीमोडल AI के मुख्य सिद्धांत
मल्टीमोडल जनरेटिव AI मॉडल्स अत्याधुनिक LLMs में जटिलता की एक नई परत जोड़ते हैं। ये मॉडल्स ट्रांसफॉर्मर नामक न्यूरल आर्किटेक्चर के एक प्रकार पर आधारित होते हैं। Google शोधकर्ताओं द्वारा विकसित ट्रांसफॉर्मर्स एन्कोडर-डीकोडर आर्किटेक्चर और अटेंशन मैकेनिज्म पर निर्भर रहते हैं जिससे डेटा का कुशल प्रोसेसिंग संभव हो पाता है।
यह एक काफ़ी जटिल प्रक्रिया है जिसे समझना कठिन हो सकता है। यदि आप जानना चाहते हैं कि LLMs और ट्रांसफॉर्मर्स कैसे काम करते हैं, तो हमारा How Transformers Work गाइड ज़रूर पढ़ें, या यदि आप हाथ गंदे करके चरण-दर-चरण LLMs बनाना सीखना चाहते हैं, तो हमारा Large Language Models (LLMs) Concepts कोर्स देखें।
स्रोत: DataCamp
मल्टीमोडल AI, विभिन्न डेटा प्रकारों को एकीकृत करने और आधारभूत डेटा की अधिक संपूर्ण और सटीक समझ बनाने के लिए डेटा फ्यूज़न तकनीकों पर निर्भर करता है। अंतिम लक्ष्य विभिन्न डेटा मोडैलिटीज़ द्वारा उपलब्ध कराई गई पूरक जानकारी को मिलाकर बेहतर भविष्यवाणियाँ करना है।
यूनिमोडल बनाम मल्टीमोडल AI। स्रोत: ResearchGate
मल्टीमोडल चुनौतियों से निपटने के लिए कई डेटा फ्यूज़न तकनीकें लागू की जा सकती हैं। फ्यूज़न जिस प्रोसेसिंग चरण पर होता है, उसके आधार पर हम डेटा फ्यूज़न तकनीकों को तीन श्रेणियों में बाँट सकते हैं:
हर तरह के परिदृश्यों के लिए कोई एकल डेटा फ्यूज़न तकनीक सर्वोत्तम नहीं होती। इसके बजाय, चुनी गई तकनीक मौजूदा मल्टीमोडल कार्य पर निर्भर करेगी। इसलिए, सबसे उपयुक्त मल्टीमोडल AI पाइपलाइन खोजने के लिए ट्रायल-अनुभव की प्रक्रिया की आवश्यकता पड़ सकती है।
मल्टीमोडल AI को शक्ति देने वाली तकनीकें
मल्टीमोडल AI, AI के कई उप-क्षेत्रों में संचित ज्ञान का परिणाम है। हाल के वर्षों में, AI प्रैक्टिशनर्स और शोधकर्ताओं ने कई फ़ॉर्मैट्स और मोडैलिटीज़ में डेटा को स्टोर और प्रोसेस करने में उल्लेखनीय प्रगति की है।
नीचे वे डोमेन्स दिए गए हैं जो मल्टीमोडल AI की उछाल को ऊर्जा दे रहे हैं:
डीप लर्निंग
डीप लर्निंग AI का वह उप-क्षेत्र है जो जटिल कार्यों को हल करने के लिए आर्टिफ़िशियल न्यूरल नेटवर्क नामक एल्गोरिदम का उपयोग करता है। मौजूदा जनरेटिव AI क्रांति डीप लर्निंग मॉडल्स, विशेष रूप से ट्रांसफॉर्मर्स, द्वारा संचालित है, जो एक प्रकार की न्यूरल आर्किटेक्चर हैं।
मल्टीमोडल AI का भविष्य भी इसी डोमेन में नई प्रगति पर निर्भर करेगा। खास तौर पर, ट्रांसफॉर्मर्स की क्षमताओं को बढ़ाने के नए तरीकों के साथ-साथ नई डेटा फ्यूज़न तकनीकों की खोज के लिए और शोध की ज़रूरत है।
इस आशाजनक क्षेत्र में अपनी सीख को आगे बढ़ाने के लिए हमारा Deep Learning in Python ट्रैक देखें।
नेचुरल लैंग्वेज प्रोसेसिंग (NLP)
NLP, कृत्रिम बुद्धिमत्ता में एक केंद्रीय तकनीक है, जो मानव संचार और कंप्यूटर समझ के बीच की खाई को पाटती है। यह एक बहु-विषयक क्षेत्र है जो कंप्यूटरों को मानव भाषा की व्याख्या, विश्लेषण और उत्पन्न करने में सक्षम बनाता है, जिससे मनुष्यों और मशीनों के बीच सहज इंटरेक्शन संभव हो पाता है।
चूँकि मशीनों से संवाद करने का प्राथमिक तरीका टेक्स्ट है, इसलिए यह आश्चर्यजनक नहीं कि NLP, जनरेटिव AI मॉडल्स—मल्टीमोडल सहित—के उच्च प्रदर्शन को सुनिश्चित करने के लिए महत्वपूर्ण है।
NLP में रुचि है? असंरचित डेटा को मूल्यवान अंतर्दृष्टियों में बदलने के लिए आवश्यक कोर NLP कौशल पाने हेतु हमारा Natural Language Processing in Python ट्रैक देखें।
कंप्यूटर विज़न
इमेज विश्लेषण, जिसे कंप्यूटर विज़न भी कहते हैं, उन तकनीकों का समूह है जिसके माध्यम से कंप्यूटर किसी छवि को “देख” और समझ सकते हैं। इस क्षेत्र में हुई प्रगति ने ऐसे मल्टीमोडल AI मॉडल्स के विकास को संभव किया है जो छवियों और वीडियो को इनपुट और आउटपुट—दोनों रूपों में—प्रोसेस कर सकते हैं।
यदि आप इस रोचक विषय में और गहराई से जाना चाहते हैं, तो अपने डेटा साइंस टूलबॉक्स में इमेज प्रोसेसिंग कौशल जोड़ने के लिए हमारा Image Processing with Python स्किल ट्रैक देखें।
ऑडियो प्रोसेसिंग
कुछ सबसे उन्नत जनरेटिव AI मॉडल्स ऑडियो फ़ाइलों को इनपुट और आउटपुट—दोनों रूपों में—प्रोसेस करने में सक्षम हैं। ऑडियो प्रोसेसिंग की संभावनाएँ वॉयस मैसेज की व्याख्या से लेकर एकसाथ अनुवाद और संगीत रचना तक फैली हुई हैं।
Python में कच्ची ऑडियो फ़ाइलों से स्पीच को लोड, ट्रांसफ़ॉर्म और ट्रांसक्राइब करना सीखने के लिए हमारा Spoken Language Processing in Python कोर्स देखें।
मल्टीमोडल AI के अनुप्रयोग
मल्टीमोडल लर्निंग मशीनों को नई “इंद्रियाँ” प्रदान करती है, जिससे उनकी सटीकता और व्याख्या क्षमताएँ बढ़ती हैं। ये शक्तियाँ विभिन्न क्षेत्रों और उद्योगों में अनेक नए अनुप्रयोगों का मार्ग खोल रही हैं, जिनमें शामिल हैं:
ऑगमेंटेड जनरेटिव AI
पहली पीढ़ी के अधिकांश जनरेटिव AI मॉडल्स टेक्स्ट-टू-टेक्स्ट थे, जो उपयोगकर्ताओं के टेक्स्ट प्रॉम्प्ट्स को प्रोसेस करके टेक्स्ट उत्तर प्रदान कर सकते थे। मल्टीमोडल मॉडल्स, जैसे GPT-4 Turbo, Google Gemini, या DALL-E, इनपुट और आउटपुट—दोनों पक्षों पर—उपयोगकर्ता अनुभव को बेहतर करने वाली नई संभावनाओं के साथ आते हैं। चाहे कई मोडैलिटीज़ में प्रॉम्प्ट स्वीकार करना हो या विभिन्न फ़ॉर्मैट्स में सामग्री जनरेट करना, मल्टीमोडल AI एजेंट्स की संभावनाएँ असीम लगती हैं।
स्वचालित कारें
स्वचालित कारें बड़े पैमाने पर मल्टीमोडल AI पर निर्भर करती हैं। ये कारें कई सेंसर से लैस होती हैं जो आसपास से अलग-अलग फ़ॉर्मैट्स में जानकारी प्रोसेस करती हैं। इन स्रोतों को प्रभावी और कुशल तरीके से संयोजित कर वास्तविक समय में बुद्धिमान निर्णय लेने के लिए मल्टीमोडल लर्निंग महत्वपूर्ण है।
बायोमेडिसिन
बायोबैंक्स, इलेक्ट्रॉनिक स्वास्थ्य रिकॉर्ड्स, क्लिनिकल इमेजिंग, मेडिकल सेंसर, साथ ही जीनोमिक डेटा से बायोमेडिकल डेटा की बढ़ती उपलब्धता चिकित्सा के क्षेत्र में मल्टीमोडल AI मॉडल्स के निर्माण को गति दे रही है। ये मॉडल्स कई मोडैलिटीज़ में आने वाले इन विभिन्न डेटा स्रोतों को प्रोसेस करने में सक्षम होते हैं, जिससे मानव स्वास्थ्य और रोगों के रहस्यों को सुलझाने और बुद्धिमान नैदानिक निर्णय लेने में मदद मिलती है।
पृथ्वी विज्ञान और जलवायु परिवर्तन
स्थलीय सेंसर, ड्रोन, सैटेलाइट डेटा और अन्य मापन तकनीकों के तेज़ी से विस्तार से हमारे ग्रह को समझने की क्षमता बढ़ रही है। इस जानकारी को सटीकता से संयोजित करने और नए अनुप्रयोगों व टूल्स बनाने में—जैसे ग्रीनहाउस गैस उत्सर्जन की निगरानी, चरम जलवायु घटनाओं का पूर्वानुमान, और प्रिसीजन कृषि—मल्टीमोडल AI अत्यंत महत्वपूर्ण है।
मल्टीमोडल AI समाधान लागू करने की चुनौतियाँ
मल्टीमोडल AI का उभार व्यवसायों, सरकारों और व्यक्तियों के लिए असीम संभावनाएँ लेकर आ रहा है। हालाँकि, किसी भी नवप्रवर्तक तकनीक की तरह, उन्हें अपनी दैनिक कार्यप्रणाली में लागू करना चुनौतीपूर्ण हो सकता है।
सबसे पहले, आपको उन उपयोग मामलों की पहचान करनी होगी जो आपकी विशिष्ट आवश्यकताओं से मेल खाते हों। अवधारणा से परिनियोजन तक पहुँचना हमेशा आसान नहीं होता, खासकर तब जब आपके पास मल्टीमोडल AI के पीछे की तकनीकी बारीकियों को सही से समझने वाले लोग न हों। हालांकि मौजूदा डेटा साक्षरता कौशल अंतर को देखते हुए, अपने मॉडल्स को प्रोडक्शन में ले जाने के लिए सही लोगों को खोजना कठिन और महँगा हो सकता है, क्योंकि कंपनियाँ इस सीमित प्रतिभा को आकर्षित करने के लिए ऊँची रकम देने को तैयार हैं।
अंततः, जब जनरेटिव AI की बात आती है, तो सामर्थ्य का ज़िक्र करना अनिवार्य है। ये मॉडल्स, खासकर मल्टीमोडल वाले, काम करने के लिए पर्याप्त कंप्यूटिंग संसाधन मांगते हैं, और इसका अर्थ है धन। इसलिए, किसी भी जनरेटिव AI समाधान को अपनाने से पहले, यह आकलन करना महत्वपूर्ण है कि आप कितने संसाधन निवेश करना चाहते हैं।
मल्टीमोडल AI के जोखिम
किसी भी नई तकनीक की तरह, मल्टीमोडल AI मॉडल्स के साथ भी कई संभावित जोखिम हैं जिनसे सावधानीपूर्वक निपटना होगा:
मल्टीमोडल AI का भविष्य
मल्टीमोडल AI निश्चित रूप से जनरेटिव AI क्रांति की अगली सीमा है। मल्टीमोडल लर्निंग के क्षेत्र में तेज़ी से हो रहा विकास हर तरह के उद्देश्यों के लिए नए मॉडल्स और अनुप्रयोगों के सृजन को गति दे रहा है। हम इस क्रांति की अभी शुरुआत में हैं। जैसे-जैसे अधिक और नई मोडैलिटीज़ को संयोजित करने की तकनीकें विकसित होंगी, मल्टीमोडल AI का दायरा और विस्तृत होगा।
हालाँकि, बड़ी शक्ति के साथ बड़ी ज़िम्मेदारी भी आती है। एक न्यायसंगत और टिकाऊ भविष्य सुनिश्चित करने के लिए मल्टीमोडल AI से जुड़े गंभीर जोखिमों और चुनौतियों का समाधान करना आवश्यक है।
यदि आप जनरेटिव AI में शुरुआत करना चाहते हैं, तो DataCamp आपके लिए तैयार है। हमारे समर्पित कोर्स, ब्लॉग और सामग्री देखें: