
有几处我想修改。我发出了如下跟进提示:
1. 画一只更像样的恐龙——那个团块完全不像恐龙。
2. 让用户可以按键开始游戏——不要立即开始。确保仍在屏幕上保留所有说明。
3. 游戏结束时,让用户可以再试一次。
第二次结果:
那只恐龙在我看来更像一台老式摄影机,但其余部分都很棒。
大规模输入的多模态推理
斯坦福近日发布了《2025 AI 指数报告》,这是一份 450 页(117,649 令牌)概览,介绍 AI 行业的现状。我让 o4-mini-high 阅读并预测 2026 年的 10 大趋势。它处理得很好,仅用 9 秒就完成了。
以下是它对 2026 年的预测:
- 在新推理基准上接近人类水平的表现
- 面向生产级 LLM 的超低成本推理
- 合成+真实数据的训练管道
- AI 原生硬件的广泛采用
- 多模态基础模型的标准化
- 负责任 AI 的认证与审计机制
- AI 驱动的科学发现加速诺奖级研究
- 本地化的 AI 治理框架与全球协同
- AI 教育的普及化与劳动力就绪度提升
- 作为协作型知识工作者的 AI 代理
大多预测有道理,但有些略显乐观。比如第二条——是的,推理成本在下降,但“超低”可能有些夸张,尤其对更大模型与未充分优化的部署而言。
第四条也类似:AI 原生硬件在进步,但要实现广泛采用,还取决于供应链、软件集成与生态支持,这些都需要时间。
至于第九条,距真正称得上 AI 教育的全面普及还有相当距离,不过公平地说,模型并未说“完全”。
O4-Mini 基准评测
O4-mini 的设计目标是快速且高性价比,但在广泛的推理基准上仍有不俗表现。在某些情况下,甚至超过像 o3 这样的更大型模型。
数学与逻辑
这些测试强调结构化推理,通常需要多步操作才能正确解出数学题。例如 AIME 基准来自高中数学竞赛。
- AIME 2024:o4-mini(无工具)得分 93.4%,高于 o3(91.6%)、o3-mini(87.3%)与 o1(74.3%)。
- AIME 2025:o4-mini(无工具)得分 92.7%,同样领先于 o3(88.9%)、o3-mini(86.5%)与 o1(79.2%)。
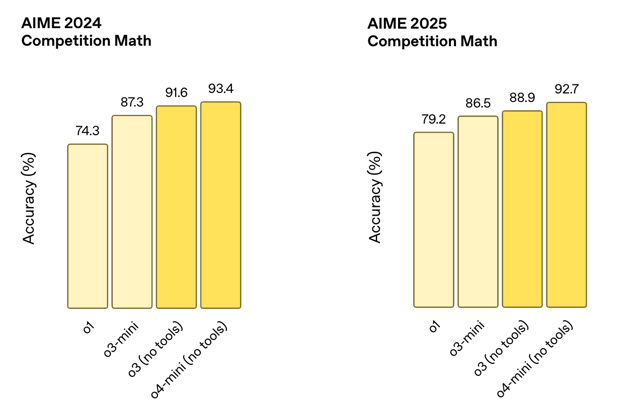
来源: OpenAI
编码
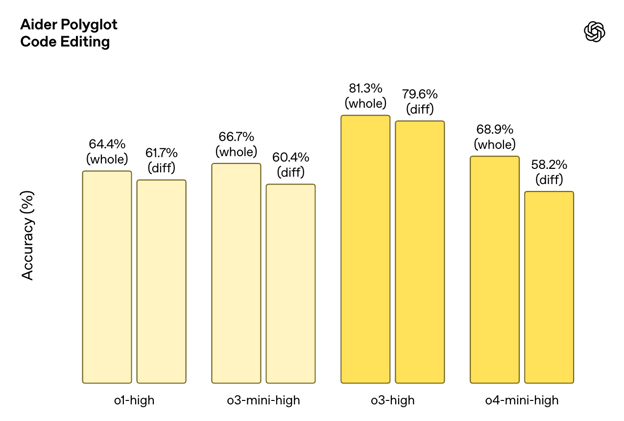
这些基准测试模型编写、调试与理解代码的能力。Codeforces 是一套竞技编程数据集,而 SWE-Bench 与 Aider Polyglot 则模拟真实工程任务。
- Codeforces:o4-mini(含终端)ELO 为 2719,略高于 o3(2706)。o3-mini 为 2073,o1 明显落后在 1891。
- SWE-Bench Verified:o4-mini 得分 68.1%,略低于 o3 的 69.1%,但领先于 o1(48.9%)与 o3-mini(49.3%)。
- Aider Polyglot(代码编辑):o4-mini-high 得分 68.9%(whole) 与 58.2%(diff)。对比之下,o3-high 得分为 81.3%(whole) 与 79.6%(diff)。
来源: OpenAI
多模态推理
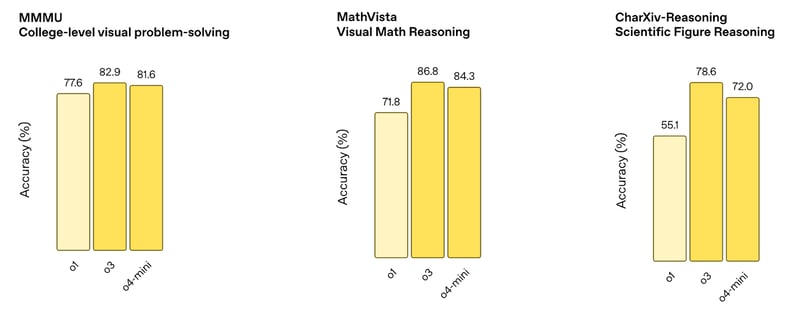
这些基准衡量模型处理视觉输入(如图表、曲线与示意图)的能力,将图像理解与逻辑推理结合考察。
- MMMU:o4-mini 得分 81.6%,接近 o3(82.9%),并好于 o1(77.6%)。
- MathVista:o4-mini 得分 84.3%,落后于 o3(86.8%),但显著高于 o1(71.8%)。
- CharXiv(科学图像):o4-mini 达到 72.0%,低于 o3(78.6%),但高于 o1(55.1%)。
来源: OpenAI
通用问答与推理
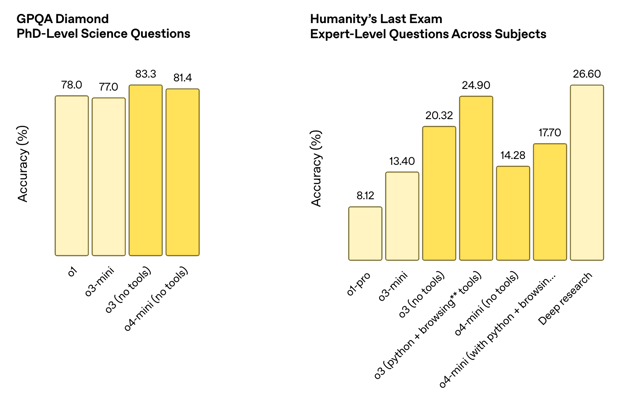
这些数据集测试广泛的问答能力,包括博士级科学问题与跨学科的开放式推理。为取得高分,往往需要使用工具。
- GPQA Diamond:o4-mini 得分 81.4%,低于 o3(83.3%),但高于 o1(78.0%)与 o3-mini(77.0%)。
- Humanity’s Last Exam:
- o4-mini(无工具):14.28%
- o4-mini(含 Python + 浏览):17.70%
- 作参照,o3(含工具)得分 24.90%,Deep Research 得分 26.60%。
来源: OpenAI
O4-Mini 与 O3:该选哪一个?
O4-mini 与 o3 的设计理念一致:能配合工具进行推理、逐步思考,并处理文本、代码与图像。但它们面向的取舍不同。简言之:
- 如果精度是首要考量、成本次之,请选 o3。
- 如果更看重速度、量级或成本效率,而不是追求再多出几个基准点,请选 o4-mini。
O3 整体更强
在 CharXiv、MathVista 与 Humanity’s Last Exam 等基准上,o3 的得分高于 o4-mini。它在需要更长推理链或精确代码生成的复杂任务上也更稳定。如果您从事研究问题、科学流程,或任何将准确性置于速度或成本之上的工作,o3 往往是更稳妥的选择。
O4-mini 更便宜也更快
价格差异显著:o4-mini 的输入 $1.10、输出 $4.40,而 o3 分别为 $10 与 $40。几乎全线是 10 倍差距。您还将获得更快的响应时间与更高的吞吐,这使其更适合生产环境、实时工具或任何需要规模化运行的场景。
多模态并非决策因素
两款模型都具备多模态与工具能力,都支持 Python、浏览与视觉。如果您只是需要这类特性,任选其一都可。
如何在 ChatGPT 与 API 中使用 o4-mini
根据您的套餐,您可以在 ChatGPT 与 OpenAI API 中使用 o4-mini。
在 ChatGPT 中
如果您订阅了 ChatGPT Plus、Pro 或 Team,o4-mini 已可使用。您会在模型选择器中看到 “o4-mini” 与 “o4-mini-high”。
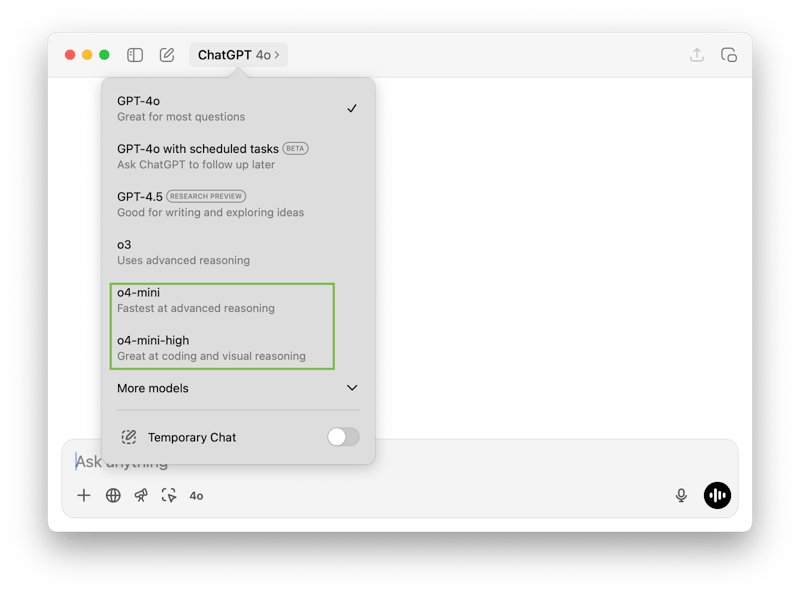
这些选项取代了较早的 o3-mini 与 o1。免费用户也可通过在发送提示前在撰写器中选择 “Think” 模式,有限体验 o4-mini。注意:
- o4-mini 是默认的快速版本。
- o4-mini-high 通过提高推理投入来提升质量,但牺牲速度。
在 API 中
o4-mini 也可通过OpenAI API 的 Chat Completions 与 Responses 端点使用。标准版与高推理版均支持工具使用,包括浏览、Python 与图像输入,具体取决于您的工具集配置。
当前快照的模型 ID 为 o4-mini-2025-04-16。定价为每百万输入令牌 $1.10、每百万输出令牌 $4.40,支持缓存与批处理。若您使用 Responses API,还可见到推理令牌并对多步链路中的工具执行有更多控制。
结论
o4-mini 在数学、代码与多模态任务上都有扎实表现,同时相比 o3 将推理成本降低了一个数量级。基准结果显示,即便是多模态推理或编码这类模型通常会吃力的任务,它也能撑得住。
这也是 OpenAI 首次将全量工具支持与原生多模态引入 mini 级模型。仅此一点,就使它领先于 o3-mini 与 o1,而它也在大多数 ChatGPT 层级中取代了这两者。随着 o4-mini-high 的加入,用户还能更好地在速度与输出质量之间做权衡。
是否选择 o4-mini 取决于任务本身。论原始能力它比不过 o3,但凡是需要快速运行、易于扩展或预算更紧的场景,它都是很强的选项——而且在很多情况下,已经足够好。
常见问题
我可以对 o4-mini 进行微调吗?
不支持。截至目前,o4-mini 不支持微调。
o4-mini 在 API 中支持哪些工具?
o4-mini 可与 Python、图像分析与网页浏览等工具配合使用,取决于具体的设置。
o4-mini 的上下文窗口是多少?
o4-mini 支持 200,000 令牌的上下文窗口,最多可输出 100,000 个令牌。这使其能够处理长文档、转录或多步推理任务而不被截断。

我是一名编辑和撰稿人,专注于 AI 博客、教程与新闻,确保内容契合成熟的内容策略并遵循 SEO 最佳实践。我编写过关于 Python、统计学、概率和数据可视化的数据科学课程。我的长篇小说曾获奖,业余时间从事影视剧本创作和电影导演。
OpenAI 近日发布了 o4-mini,这是一款新的推理模型,目标是在保持对 Python、浏览与图像输入等工具支持的同时,比 o3 更快、更便宜。与 o3-mini 不同,它默认就是多模态。
本文将更深入地了解 o4-mini 的实际能力。我在数学、代码与视觉输入上做了几项实测,并加入 OpenAI 官方基准数据,看看它与 o3、o1 等模型如何对比。
您还将看到关于定价、可用性,以及在何种情况下应选择 o4-mini 而不是其他模型的细节。
我们通过每周五发布的免费通讯 The Median,为读者带来最新 AI 动态,精炼解读一周要闻。订阅即可每周用几分钟保持更新:
什么是 O4-Mini?
O4-mini 是 OpenAI o 系列中最新的小型推理模型。它针对速度、成本与工具增强推理进行了优化,提供 200,000 令牌的上下文窗口,并支持最高 100,000 个输出令牌——这与 o3 和 o1 相当。
来源: OpenAI
其最大的差异体现在成本与部署效率。o4-mini 的价格为每百万输入令牌 $1.10、每百万输出令牌 $4.40,而 o3 分别为 $10.00 和 $40.00——输入与输出均约 10 倍降幅。正如下文基准部分所示,o4-mini 的表现可与 o3 相媲美。
o4-mini API 定价(左)与 o3 定价(右)
在工具支持方面,o4-mini 兼容 Python、浏览与图像输入,并可集成到标准 OpenAI 端点,包括 Chat Completions 与 Responses。支持流式输出、函数调用与结构化输出。不支持微调与嵌入。
o4-mini vs. o4-mini-high
如果您打开 ChatGPT 应用,或许会注意到可以在 o4-mini 与 o4-mini-high 之间选择。o4-mini-high 是同一底层模型的配置版本,推理投入更高。这意味着:
如果您需要更快的完成速度,o4-mini 可能更合适。若任务涉及更复杂的推理(尤其是结合代码或视觉输入)、更长上下文,或对精度要求更高,o4-mini-high 可能会提供更好的输出。
测试 O4-Mini
我们来用一点数学、编码与多模态输入来测试 o4-mini。
数学
首先,我用一道常常会难倒语言模型的简单计算开头。我的目的不是测基本算术——而是看模型会不会选择正确的方法来解题,是逐步推理,还是调用计算器等工具。
第一次回答是错的。我建议它使用计算器,第二次虽然答对了,但仍有两个问题。首先,它把结果描述为“约等于”,而这道减法并不需要四舍五入或估算。
其次,从其推理看,它其实并未使用计算器,但输出中却写着“计算器显示”(这会误导结果的获得方式)。奇怪的是,它还去搜索了网页,而对一题基础数学题来说这似乎没必要。
接着我用一道更具挑战的数学题来测试,这次表现就很稳。它响应很快,并用一段简短的 Python 脚本解决了问题,我能直接在其思维链中看到这段代码。把代码作为推理过程的一部分供检查,确实很有用。
生成一个简短的 P5js 游戏
几周前,我测试Gemini 2.5 Pro 时,曾生成一个简易的 p5.js 游戏,看看它处理创意编程的表现。我想用相同的提示在 o4-mini 上再试一次,不过这次使用了o4-mini-high。结果与 Gemini 2.5 Pro 的差距并不大,考虑到这是更小的模型,这表现相当不错。
提示为:为我做一个吸引人的无尽跑酷游戏。关键说明显示在屏幕上。p5js 场景,无需 HTML。我喜欢像素风恐龙和有趣的背景。
首次结果如下: