महत्वपूर्ण व्यावसायिक मीट्रिक्स पर नियमित अंतराल पर रिपोर्टिंग करना कई विश्लेषकों की मूल जिम्मेदारी है। इसे लगातार और बिना गलतियों के करना आपके संगठन के लिए व्यावसायिक निर्णयों का समर्थन करने में अत्यंत मूल्यवान है, लेकिन किस कीमत पर? अक्सर, आपको डेटा एकत्र करने, मुख्य प्रदर्शन संकेतकों के साथ रिपोर्ट बनाने और उसे हितधारकों के साथ साझा करने के लिए कई मैन्युअल चरणों से गुजरना पड़ता है। यह वर्कफ़्लो समय-साध्य होने के साथ-साथ त्रुटि-प्रवण भी है।
खुशकिस्मती से, एक बेहतर तरीका है: आप DataCamp Workspace की शेड्यूलिंग क्षमताओं का लाभ उठाकर सूचनात्मक विज़ुअलाइज़ेशन के साथ व्यावसायिक मीट्रिक्स पर स्वचालित रूप से रिपोर्ट कर सकते हैं, जिससे आपका समय बचेगा और आपके रिपोर्टिंग प्रोसेस में त्रुटियों की संभावना कम होगी।
इस लेख में, हम स्टॉक मार्केट डेटा पर एक रिपोर्ट चलाकर इस वर्कफ़्लो को प्रदर्शित करेंगे (क्योंकि लगभग हर दिन नया डेटा आता है) और इसे आवर्ती शेड्यूल पर चलाएँगे ताकि नोटबुक हमेशा बाज़ार में हो रही ताज़ा घटनाओं को प्रतिबिंबित करे।
क्या आप इस लेख को वीडियो फ़ॉर्मेट में देखना पसंद करेंगे? DataCamp ने इसी विषय पर एक कोड-अलॉन्ग आयोजित किया था, जिसमें Microsoft SQL Server डेटाबेस में संग्रहीत साइकिल बिक्री डेटा पर स्वचालित रिपोर्टिंग सेट की गई थी। आप इस लिंक पर जाकर इस कोड-अलॉन्ग को रीप्ले कर सकते हैं।
रिपोर्ट बनाना
शुरू करने के लिए, हमें Workspace में एक नया डेटा प्रोजेक्ट (जिसे वर्कस्पेस कहा जाता है) बनाना है जो वे ऑपरेशन करता है जिन्हें हम अगले चरण में स्वचालित करना चाहते हैं। इस ट्यूटोरियल के उद्देश्य से, हम स्टॉक मार्केट डेटा के साथ काम करेंगे, क्योंकि यह डेटा सार्वजनिक रूप से उपलब्ध है और नियमित रूप से अपडेट होता है। इस तरह, समय के साथ हमारी रिपोर्ट बदलती रहेगी।
सबसे सुविधाजनक तरीका है कि किसी ऐसे वर्कस्पेस की कॉपी बना लें जिसमें पहले से सारा कोड मौजूद हो। यदि आप हर चरण स्वयं करना चाहते हैं, तो शुरू से नया वर्कस्पेस बनाएँ और एक Python कोड सेल जोड़ें जो स्टॉक मार्केट डेटा इम्पोर्ट करता है और उसे विज़ुअलाइज़ करता है:
import pandas as pd
import plotly.express as px
import yfinance as yf

# Define how many stock I own of each ticker
holdings = {
    'AAPL': 16,
    'TSLA': 15,
    'TEAM': 7,
}

# Get the data
tickers = list(holdings.keys())
data = yf.download(tickers, start="2023-01-01")

# Wrangle the data
adj_close = data['Adj Close'].reset_index()
adj_close_long = pd.melt(
    adj_close,
    id_vars='Date',
    value_vars=tickers,
    var_name='ticker',
    value_name='adj_close'
)
adj_close_long['total_value'] = adj_close_long['adj_close'] * adj_close_long['ticker'].map(holdings)
adj_close_long

# Show the position values for stocks in my portfolio
fig = px.line(
    adj_close_long, x='Date', y='total_value', color='ticker'
)
fig.update_layout(
    title="Position values for for stocks in my portfolio",
    yaxis_title="Position Value",
    xaxis_title="Date"
)
fig.show()
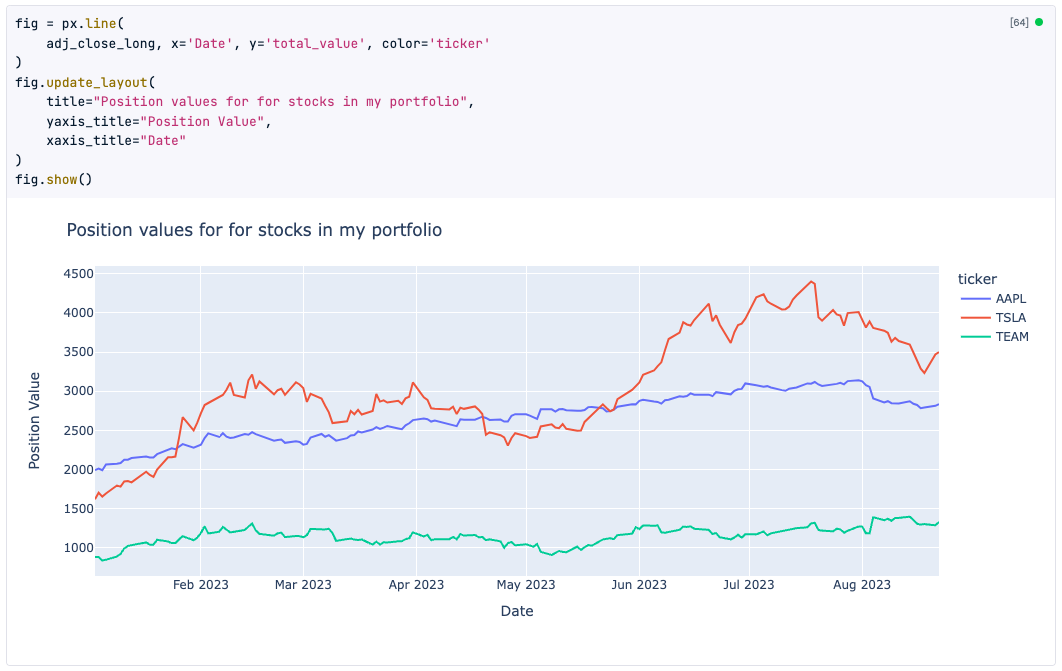
इस कोड की विस्तृत व्याख्या इस लेख के दायरे से बाहर है; हमारा उद्देश्य बस इतना है कि कुछ Python कोड चल पड़े ताकि अगले चरण में हम इसे शेड्यूल कर सकें! आप अपने वर्कस्पेस नोटबुक में ऊपर दिए गए “Run” बटन पर क्लिक करके जाँच सकते हैं कि कोड ठीक से चलता है। आपको एक सुंदर plotly प्लॉट दिखाई देना चाहिए:
रिपोर्ट को स्वचालित करना
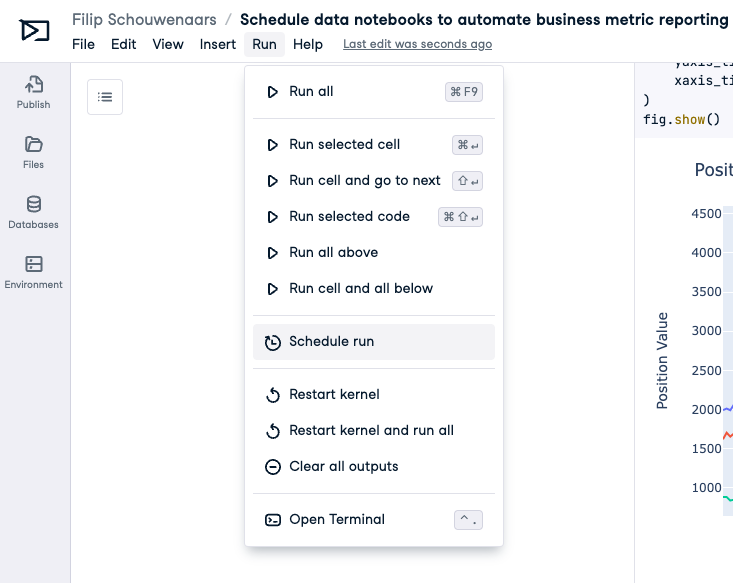
अब जब हमारे पास कुछ Python कोड के साथ एक वर्कस्पेस है, तो आइए इसे इस तरह कॉन्फ़िगर करते हैं कि यह आवर्ती शेड्यूल पर चले! “Run” मेनू पर जाएँ और “Schedule run” चुनें:
मॉडल में, आप दैनिक या साप्ताहिक फ़्रीक्वेंसी चुनकर और निष्पादन समय निर्धारित करके नोटबुक रन शेड्यूल कर सकते हैं। अतिरिक्त रूप से, आप सफल और असफल दोनों रन के लिए ईमेल सूचनाएँ प्राप्त करने का विकल्प भी चुन सकते हैं।
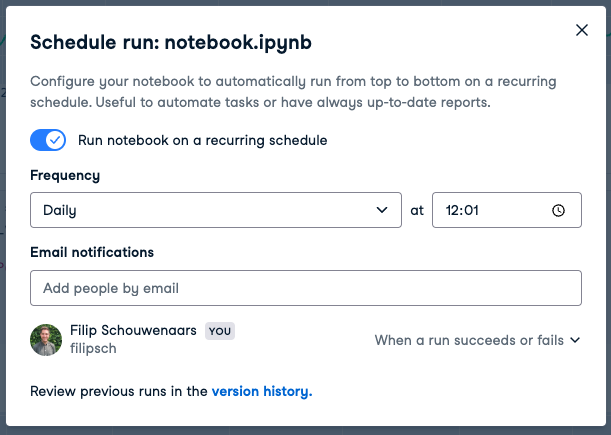
प्रयोग के लिए, अपनी नोटबुक को दैनिक शेड्यूल पर चलने के लिए सेट करें, समय अभी से कुछ ही मिनट आगे का रखें, ताकि आप शेड्यूलिंग को क्रियान्वयन में देख सकें!
जादू होते हुए देखें
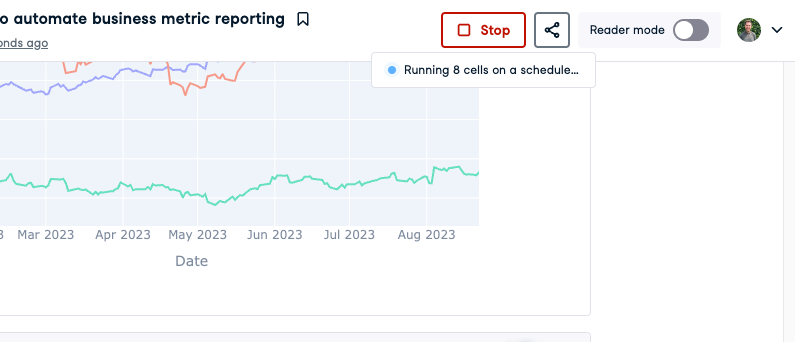
यदि आपने नोटबुक को कुछ मिनट आगे के समय पर चलने के लिए कॉन्फ़िगर किया है, तो निर्धारित रन शुरू होने के लिए एक-दो मिनट प्रतीक्षा करें। आपके द्वारा निर्धारित समय पर, आपको Run बटन के नीचे “Running X cells on a schedule” संदेश दिखाई देगा। सारा कोड ऊपर से नीचे तक दोबारा निष्पादित हो रहा है, ताकि पिछली बार की तुलना में नया डेटा उपलब्ध होने पर आउटपुट अपडेट हो जाए।
यदि आपने सफल रन पर ईमेल भेजने के लिए वर्कस्पेस को कॉन्फ़िगर किया है, तो आपके इनबॉक्स में एक ईमेल भी मिला होगा:
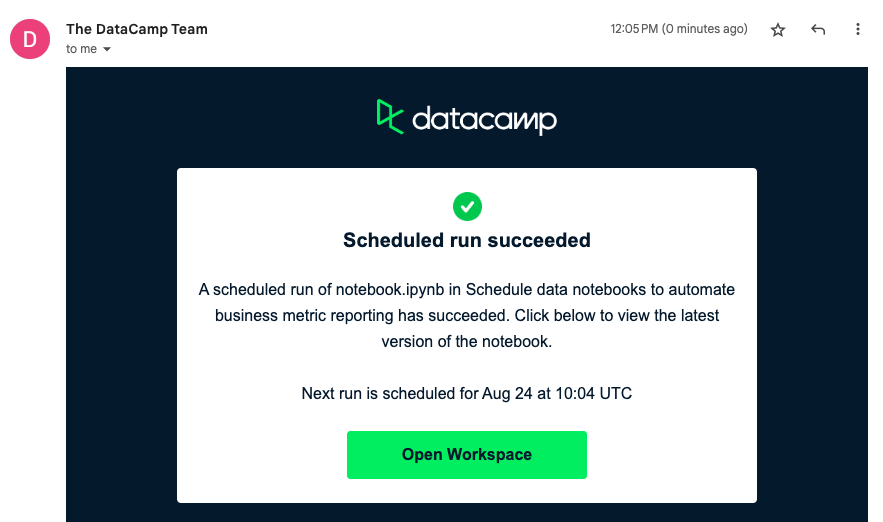
बस इतना ही! अब आपकी नोटबुक प्रतिदिन या साप्ताहिक रूप से, जैसा आपने कॉन्फ़िगर किया है, चलेगी, इसलिए जब भी आप वर्कस्पेस पर जाएँगे, वहाँ हमेशा नवीनतम डेटा होगा। स्टॉक मार्केट डेटा वाले इस उदाहरण में, इसका मतलब है कि आप अपने स्टॉक पोर्टफोलियो के कुल मूल्य के बारे में हमेशा अपडेट रहेंगे।
व्यावसायिक संदर्भ में, आप इस फीचर का उपयोग Workspace के किसी नैटिव डेटा कनेक्टर के साथ मिलाकर कर सकते हैं, जैसे कि PostgreSQL डेटाबेस, Snowflake डेटा वेयरहाउस या Redshift क्लस्टर से कनेक्ट कर अपनी कंपनी का नवीनतम डेटा खींचें और हितधारकों के साथ साझा करने के लिए सारगर्भित रिपोर्ट बनाएँ।
लॉन्च के बाद से, Workspace उपयोगकर्ताओं ने इस फीचर का उपयोग विभिन्न उद्देश्यों के लिए किया है, जिनमें शामिल हैं:
- माइग्रेशन के दौरान डेटा वैलिडेशन जाँचें चलाना ताकि अलग-अलग स्रोतों के बीच डेटा की संगति सुनिश्चित हो सके,
- नियमित रूप से अपडेट होने वाले पब्लिक पॉलिसी पेजों से डेटा स्क्रैप करना ताकि डेटासेट बनाए जा सकें और नागरिक नियुक्तियों की निष्पक्षता की निगरानी की जा सके, और
- Customer.io जैसी समाधानों के साथ एकीकृत करके डेटा संग्रह को स्वचालित करना और SaaS एप्लिकेशन उपयोगकर्ताओं को व्यक्तिगत साप्ताहिक ईमेल डाइजेस्ट भेजना।
Python की लचीलापन और Workspace का पूर्ण-कॉन्फ़िगर किया हुआ नोटबुक वातावरण मिलकर एक शक्तिशाली संयोजन बनाते हैं; हम उत्सुक हैं जानने के लिए कि आप इस नए Workspace फीचर से क्या-क्या तैयार करते हैं!