कोर्स
Python में MongoDB परिचय
3 घंटा
24.3K
यदि आपने कभी कठोर डेटाबेस स्कीमा या जटिल स्केलिंग समस्याओं से जूझा है, तो आप अकेले नहीं हैं। वहीं MongoDB काम आता है। एक लचीला, उच्च-प्रदर्शन NoSQL डेटाबेस के रूप में, MongoDB ने डेवलपर्स के डेटा को संग्रहीत करने और उस पर काम करने के तरीके को बदल दिया है। मुझे अभी भी याद है जब मैंने इसे पहली बार इस्तेमाल किया था—JSON-जैसे दस्तावेज़ों पर क्वेरी करना सहज लगा था।
इस लेख में, मैं बताऊंगा कि MongoDB क्या है, यह इतना लोकप्रिय क्यों है, और आप इसे कैसे उपयोग कर सकते हैं।
MongoDB एक ओपन-सोर्स NoSQL डेटाबेस है जिसे दस्तावेज़-उन्मुख डेटा के साथ काम करने के लिए डिज़ाइन किया गया है। पारंपरिक पंक्तियों और स्तंभों के बजाय, यह डेटा को लचीले, JSON-जैसे दस्तावेज़ों में संग्रहीत करता है, जिससे यह तेज़ी से विकसित होने वाले एप्लिकेशनों के लिए आदर्श बनता है।
"MongoDB" नाम humongous शब्द से आया है, जो बताता है कि यह विशाल मात्रा में डेटा संभालने के लिए बनाया गया है। इसे 2009 में 10gen (अब MongoDB Inc.) ने जारी किया, और तब से यह लगातार बढ़ रहा है। MongoDB बड़े, वितरित डेटासेट को उच्च प्रदर्शन बनाए रखते हुए संभालने में उत्कृष्ट है।
MongoDB अलग-अलग ज़रूरतों के हिसाब से कई रूपों में आता है। छोटै प्रोजेक्ट्स के लिए मुफ़्त Community Edition उपलब्ध है। और यदि आप इंफ्रास्ट्रक्चर से नहीं जूझना चाहते, MongoDB Atlas एक पूरी तरह मैनेज्ड क्लाउड सेवा है जो AWS, Google Cloud, और Azure पर चलती है। इस लचीलापन ने MongoDB को विभिन्न उद्योगों में अपनाने में मदद की है।
> यदि आप MongoDB और NoSQL डेटाबेस में नए हैं, तो गहराई में जाने से पहले मुख्य अवधारणाएँ समझने के लिए यह शुरुआती-अनुकूल NoSQL ट्यूटोरियल देखें। आप व्यापक Introduction to NoSQL और NoSQL Concepts कोर्स भी एक्सप्लोर कर सकते हैं, ताकि समझ सकें कि MongoDB बड़े NoSQL इकोसिस्टम में कैसे फिट बैठता है।
MongoDB उन सुविधाओं से लैस है जो आधुनिक, डेटा-गहन एप्लिकेशनों पर काम करने वाले डेवलपर्स के लिए इसे पसंदीदा विकल्प बनाती हैं। आइए इस अनुभाग में इन्हें देखें।
MongoDB, BSON (Binary JSON) नामक फ़ॉर्मेट का उपयोग करके JSON-जैसे दस्तावेज़ों के कलेक्शनों में डेटा संग्रहीत करता है।
JSON एक मानव-पठनीय, टेक्स्ट-आधारित फ़ॉर्मेट है जो स्ट्रिंग्स, नंबर्स और एरेज़ जैसे बुनियादी डेटा टाइप्स को सपोर्ट करता है। BSON, इसका बाइनरी समकक्ष, JSON को अतिरिक्त टाइप्स जैसे दिनांक, बाइनरी डेटा, और सटीक संख्यात्मक फ़ॉर्मेट (जैसे, integers, floats) के साथ विस्तारित करता है।
जहाँ JSON पठनीयता के लिए उपयुक्त है, वहीं BSON स्टोरेज, गति, और उन्नत डेटा हैंडलिंग के लिए अनुकूलित है, जो इसे MongoDB के लिए पसंदीदा फ़ॉर्मेट बनाता है।
MongoDB के साथ इंटरैक्ट करते समय, डेवलपर अपनी प्रोग्रामिंग भाषा की मूल डेटा संरचनाओं (जैसे, JavaScript ऑब्जेक्ट्स या Python डिक्शनरीज़) के साथ काम करते हैं। MongoDB ड्राइवर इन संरचनाओं और BSON के बीच कन्वर्ज़न संभालता है, जिससे डेटा स्टोरेज और रिट्रीवल निर्बाध हो जाता है।
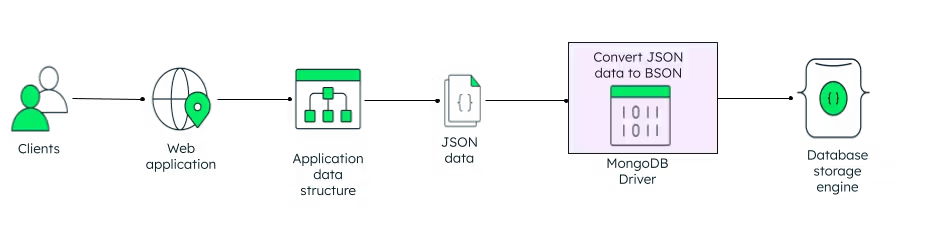
MongoDB डेटा को BSON के रूप में कैसे संग्रहीत करता है। इमेज सोर्स: MongoDB.
MongoDB डेटा को कलेक्शंस और डॉक्युमेंट्स में व्यवस्थित करता है:
MongoDB का स्कीमा-रहित डिज़ाइन इसकी सबसे शक्तिशाली विशेषताओं में से एक है, जो विविध और विकसित होते डेटा को संभालने के लिए असाधारण लचीलापन प्रदान करता है।
पारंपरिक रिलेशनल डेटाबेस के विपरीत, जहाँ नया फ़ील्ड जोड़ने के लिए पूरे टेबल स्ट्रक्चर में बदलाव करना पड़ता है, MongoDB में एक ही कलेक्शन के डॉक्युमेंट्स के फ़ील्ड और संरचना पूरी तरह अलग हो सकती है। यह कठोर स्कीमाओं की ज़रूरत को समाप्त करता है और विविध डेटा को बिना एकरूपता थोपे स्टोर करना आसान बनाता है।
आइए देखें कि MongoDB और पारंपरिक रिलेशनल डेटाबेस में स्कीमा परिवर्तन कैसे काम करते हैं:
एक रिलेशनल डेटाबेस में, यदि आप products टेबल में नया फ़ील्ड (जैसे, discount_price) जोड़ना चाहते हैं, तो आपको:
MongoDB में, आप products कलेक्शन में केवल संबंधित डॉक्युमेंट्स में ही discount_price फ़ील्ड जोड़ सकते हैं। उदाहरण के लिए:
// Document 1
{
  "_id": 1,
  "name": "Laptop",
  "price": 1200
}

// Document 2
{
  "_id": 2,
  "name": "Smartphone",
  "price": 800,
  "discount_price": 750  // New field added only where needed
}
यह लचीलापन तेज़ी से बदलते परिवेशों में अनमोल है, जहाँ डेटा आवश्यकताएँ अक्सर बदलती रहती हैं। यह डेवलपर्स को बिना डाउनटाइम या जटिल माइग्रेशन के जल्दी अनुकूलन की अनुमति देता है, जिससे MongoDB एगाइल डेवलपमेंट और आधुनिक एप्लिकेशनों के लिए आदर्श बनता है।
MongoDB को उच्च-प्रदर्शन डेटा स्टोरेज और रिट्रीवल के लिए डिज़ाइन किया गया है, जिससे यह गति और स्केलेबिलिटी की मांग करने वाले एप्लिकेशनों के लिए उपयुक्त बनता है।
इसकी प्रमुख विशेषताओं में से एक है मेमोरी-मैप्ड फ़ाइलें, जो ऑपरेटिंग सिस्टम को कैशिंग कुशलता से हैंडल करने देती हैं, जिससे लेटेंसी घटती है और पढ़ने/लिखने के कार्यों में सुधार होता है। क्वेरी प्रदर्शन तेज़ करने के लिए MongoDB विभिन्न प्रकार के इंडेक्स का समर्थन करता है, जिनमें सिंगल-फ़ील्ड, कंपाउंड, जियोस्पैशियल, टेक्स्ट, और हैश्ड इंडेक्स शामिल हैं।
अल्ट्रा-लो लेटेंसी उपयोग मामलों के लिए MongoDB इन-मेमाेरी स्टोरेज इंजन प्रदान करता है, जो सब कुछ RAM में रखकर डेटा एक्सेस को तेज़ करता है। इसके अलावा, MongoDB का क्वेरी ऑप्टिमाइज़र स्वतः सर्वश्रेष्ठ इंडेक्स और निष्पादन योजनाएँ चुनकर कुशल क्वेरी निष्पादन सुनिश्चित करता है।
इन सुविधाओं के साथ क्षैतिज स्केलिंग (sharding) जोड़कर, MongoDB रियल-टाइम एनालिटिक्स, मोबाइल ऐप्स और IoT सिस्टम जैसे उच्च-थ्रूपुट एप्लिकेशनों के लिए एक मज़बूत विकल्प बन जाता है।
यदि आप MongoDB में नए हैं, तो चिंता न करें—इसे सेट अप करना सरल है, और आप लोकल इंस्टॉल या क्लाउड विकल्प में से चुन सकते हैं। आइए यहाँ इन विकल्पों को देखें।
1. MongoDB लोकली इंस्टॉल करें: आप अपने लोकल मशीन पर MongoDB Community Edition को यहाँ से डाउनलोड कर आधिकारिक MongoDB वेबसाइट से सकते हैं। इंस्टॉलेशन निर्देश Windows, macOS, और Linux के लिए उपलब्ध हैं, और सेटअप प्रक्रिया आमतौर पर कुछ ही चरणों में पूरी हो जाती है। यह विकल्प आपको अपने वातावरण पर पूरा नियंत्रण देता है और विकास तथा परीक्षण के लिए आदर्श है।
2. MongoDB Atlas का उपयोग करें (क्लाउड-आधारित): यदि आप लोकल सेटअप छोड़ना चाहते हैं, MongoDB Atlas एक बेहतरीन विकल्प है। यह MongoDB की पूरी तरह प्रबंधित क्लाउड सेवा है, जो AWS, Azure, और Google Cloud पर चलती है। Atlas आपके लिए इन्फ्रास्ट्रक्चर संभालता है—बैकअप, स्केलिंग, और अपडेट स्वतः हो जाते हैं। साथ ही, उदार फ्री टियर उपलब्ध है, जिससे बिना लागत के शुरुआत करना आसान होता है।
चाहे आप लोकल इंस्टॉलेशन का नियंत्रण पसंद करें या क्लाउड की सुविधा, MongoDB आपके वर्कफ़्लो के मुताबिक़ सही रास्ता चुनना आसान बनाता है।
MongoDB इंस्टॉल होने के बाद अगला कदम उससे कनेक्ट करना है—चाहे शेल में तेज़ परीक्षण के लिए हो या अपने एप्लिकेशनों में इंटीग्रेट करने के लिए।
Mongo शेल का उपयोग:
आप Mongo शेल का उपयोग करके MongoDB से कनेक्ट हो सकते हैं, जो डेटाबेस के साथ इंटरैक्ट करने के लिए कमांड-लाइन इंटरफेस है। बस टर्मिनल में mongosh चलाएँ ताकि शेल शुरू हो जाए।
mongoshयह शेल शुरू करता है और डिफ़ॉल्ट रूप से आपके लोकल MongoDB इंस्टेंस से कनेक्ट करता है।
एप्लिकेशन से कनेक्ट करना:
एप्लिकेशन विकास के लिए, आप Python, JavaScript (Node.js) या Java जैसी प्रोग्रामिंग भाषाओं के माध्यम से MongoDB के आधिकारिक ड्राइवर्स का उपयोग करके कनेक्ट कर सकते हैं। उदाहरण के लिए, Python में आप pymongo लाइब्रेरी का उपयोग करके कनेक्शन स्थापित कर सकते हैं:
from pymongo import MongoClient

uri = "your_mongodb_connection_string"
client = MongoClient(uri)

try:
    # Test the connection
    client.admin.command('ping')
    print("Connected to MongoDB!")
except Exception as e:
    print(e)
finally:
    client.close()
"your_mongodb_connection_string" को अपने लोकल या Atlas कनेक्शन URI से बदलें। कनेक्ट होने के बाद, आप डॉक्युमेंट्स डालने और क्वेरी करने के लिए तैयार हैं।
> Python में काम कर रहे हैं? यह Introduction to Using MongoDB for Data Science with Python कोर्स कनेक्ट करना, क्वेरी करना, और Python का उपयोग करके MongoDB डेटा का विश्लेषण करना सिखाने के लिए एक बेहतरीन जगह है।
MongoDB डेटाबेस, कलेक्शंस और डॉक्युमेंट्स के साथ इंटरैक्ट करने के लिए कमांड्स का एक सेट प्रदान करता है। यहाँ शुरुआत करने के लिए कुछ मुख्य कमांड्स दिए गए हैं:
use myDatabaseयह कमांड myDatabase नाम के डेटाबेस पर स्विच करता है। यदि यह अभी मौजूद नहीं है, तो पहली बार डेटा जोड़ने पर MongoDB इसे बना देगा।
db.createCollection("myCollection")वर्तमान डेटाबेस में myCollection नाम का नया कलेक्शन बनाता है।
db.myCollection.insertOne({ name: "Alice", age: 30 })myCollection कलेक्शन में नया डॉक्युमेंट जोड़ता है।
db.myCollection.find({ age: { $gt: 25 } })age फ़ील्ड 25 से अधिक वाले सभी डॉक्युमेंट्स प्राप्त करता है।
ये कमांड्स सिर्फ़ शुरुआत हैं—MongoDB में शक्तिशाली क्वेरींग, इंडेक्सिंग और एग्रीगेशन क्षमताएँ हैं। आप कमांड्स की पूरी सूची आधिकारिक MongoDB डॉक्यूमेंटेशन में देख सकते हैं।
> यदि आप और गहन, हैंड्स-ऑन गाइड ढूँढ रहे हैं, तो यह MongoDB ट्यूटोरियल आपको सेटअप और बुनियादी ऑपरेशनों को चरण-दर-चरण समझाता है।
MongoDB का अधिकतम लाभ उठाना चाहते हैं? ये सर्वोत्तम प्रथाएँ प्रदर्शन बढ़ाने, आम गलतियों से बचने, और सुचारू रूप से स्केल होने वाले एप्लिकेशन बनाने में आपकी मदद करेंगी।
MongoDB के प्रदर्शन को अनुकूलित करने के लिए उचित इंडेक्सिंग आवश्यक है। आपके इंडेक्स प्रभावी रहें, इसके लिए कुछ प्रमुख रणनीतियाँ यहाँ दी गई हैं:
last_name और first_name दोनों पर क्वेरी करते हैं, तो दोनों फ़ील्ड्स पर कंपाउंड इंडेक्स अधिक कुशल होगा।status या gender)। कंपाउंड इंडेक्स मदद कर सकते हैं, लेकिन सुनिश्चित करें कि संयोजित फ़ील्ड्स की कार्डिनेलिटी उच्च हो।> और अधिक जानने के लिए MongoDB की इंडेक्सिंग के लिए प्रदर्शन सर्वोत्तम प्रथाएँ देखें, और प्रभावी रणनीतियों में गहराई से जाएँ।
MongoDB के प्रदर्शन और स्केलेबिलिटी को अनुकूलित करने के लिए प्रभावी डेटा मॉडलिंग महत्वपूर्ण है। MongoDB का दस्तावेज़-उन्मुख मॉडल डेटा संरचना में लचीलापन देता है, लेकिन दक्षता सुनिश्चित करने के लिए सावधानीपूर्वक योजना की आवश्यकता होती है।
यहाँ MongoDB में डेटा मॉडलिंग के कुछ सर्वोत्तम अभ्यास दिए गए हैं:
product_id रेफरेंस के माध्यम से जोड़ा जा सकता है।अपने MongoDB डिप्लॉयमेंट की सुरक्षा करना डेटा अखंडता, उपलब्धता, और अनुपालन सुनिश्चित करने के लिए महत्वपूर्ण है। यहाँ मज़बूत बैकअप और सुरक्षा प्रथाएँ लागू करने के लिए मार्गदर्शिका दी गई है।
mongodump और mongorestore का उपयोग करके बैकअप बनाएँ और पुनर्स्थापित करें। ये टूल्स आपको BSON फ़ॉर्मेट में डेटा एक्सपोर्ट और इम्पोर्ट करने देते हैं, जिससे संगतता और सुसंगतता सुनिश्चित होती है। अधिक उन्नत बैकअप समाधानों के लिए, oplog बैकअप (Ops Manager) का उपयोग करके point-in-time रिकवरी पर विचार करें। इससे आप अपने डेटाबेस को किसी विशिष्ट क्षण पर पुनर्स्थापित कर सकते हैं, और डेटा हानि को न्यूनतम कर सकते हैं।चाहे आप एक छोटा साइड प्रोजेक्ट बना रहे हों या बड़े पैमाने का एंटरप्राइज़ एप्लिकेशन, MongoDB आपको अपने तरीक़े से डेटा के साथ काम करने की लचीलापन और क्षमता देता है। इसका दस्तावेज़-आधारित मॉडल, डायनेमिक स्कीमा डिज़ाइन, और सहज स्केल करने की क्षमता इसे आधुनिक डेवलपर्स के लिए पसंदीदा विकल्प बनाती है। इसे प्रभावी ढंग से उपयोग करना समझकर—और सर्वोत्तम प्रथाओं का पालन करके—आप तेज़, लचीले, और फ्यूचर-प्रूफ़ एप्लिकेशन बनाने की राह पर अच्छी तरह अग्रसर होंगे।
अपनी स्किल्स को अगले स्तर पर ले जाना चाहते हैं? अन्वेषण करें MongoDB Certification गाइड ताकि समझ सकें सर्टिफ़िकेशन में क्या शामिल है, या अपने अगले टेक रोल की तैयारी के लिए इन सामान्य MongoDB इंटरव्यू प्रश्नों पर नज़र डालें।
इन कोर्सेज़ के साथ MongoDB के बारे में और जानें!
कोर्स
कोर्स
कोर्स