Corso
Introduzione a MongoDB in Python
3 ore
24.4K
Se ti sei mai scontrato con schemi di database rigidi o problemi di scalabilità macchinosi, non sei il solo. È qui che entra in gioco MongoDB. Come database NoSQL flessibile e ad alte prestazioni, MongoDB ha cambiato il modo in cui gli sviluppatori pensano all’archiviazione e alla gestione dei dati. Ricordo ancora la prima volta che l’ho usato: interrogare documenti in stile JSON mi è sembrato subito intuitivo.
In questo articolo ti spiego cos’è MongoDB, perché è così popolare e come puoi usarlo.
MongoDB è un database NoSQL open-source progettato per lavorare con dati orientati ai documenti. Invece delle tradizionali righe e colonne, archivia i dati in documenti flessibili simili a JSON, il che lo rende ideale per applicazioni che devono evolvere rapidamente.
Il nome "MongoDB" deriva da humongous, a indicare che è costruito per gestire quantità enormi di dati. È stato rilasciato nel 2009 dal team di 10gen (ora MongoDB Inc.) e da allora è in costante crescita. MongoDB è perfetto per gestire dataset grandi e distribuiti mantenendo prestazioni elevate.
MongoDB è disponibile in diverse varianti, a seconda delle esigenze. C’è la Community Edition gratuita, ottima per progetti più piccoli. E se non vuoi occuparti dell’infrastruttura, MongoDB Atlas è un servizio cloud completamente gestito che gira su AWS, Google Cloud e Azure. Questa flessibilità ha davvero aiutato la diffusione di MongoDB in diversi settori.
> Se sei alle prime armi con MongoDB e i databases NoSQL, dai un’occhiata a questo tutorial NoSQL per principianti per capire i concetti di base prima di andare più a fondo. Puoi anche esplorare i corsi più ampi Introduzione a NoSQL e Concetti NoSQL per vedere come MongoDB si inserisce nell’ecosistema NoSQL.
MongoDB è ricco di funzionalità che lo rendono una scelta di riferimento per gli sviluppatori che lavorano con applicazioni moderne e data-intensive. Rivediamole in questa sezione.
MongoDB archivia i dati in raccolte di documenti simili a JSON usando un formato chiamato BSON (Binary JSON).
JSON è un formato testuale leggibile da umani che supporta tipi di dati di base come stringhe, numeri e array. BSON, la sua controparte binaria, estende JSON con tipi aggiuntivi come date, dati binari e formati numerici precisi (ad es. interi, float).
Mentre JSON è ideale per la leggibilità, BSON è ottimizzato per archiviazione, velocità e gestione avanzata dei dati, rendendolo il formato preferito da MongoDB.
Quando interagiscono con MongoDB, gli sviluppatori lavorano con le strutture dati native del proprio linguaggio di programmazione (ad es. oggetti JavaScript o dizionari Python). Il driver MongoDB gestisce la conversione tra queste strutture e BSON, garantendo archiviazione e recupero dei dati senza interruzioni.
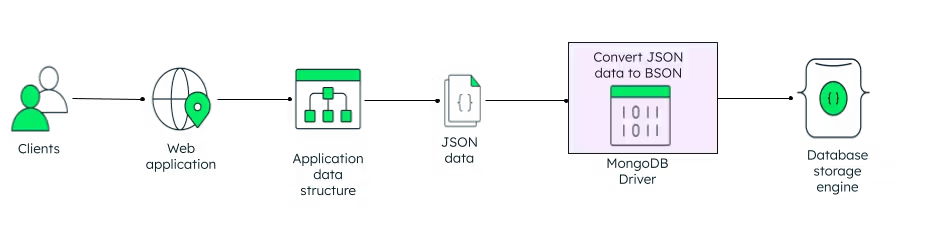
Come MongoDB archivia i dati come BSON. Fonte immagine: MongoDB.
MongoDB organizza i dati in raccolte e documenti:
Il design senza schema di MongoDB è una delle sue caratteristiche più potenti, offrendo una flessibilità eccezionale nella gestione di dati eterogenei e in evoluzione.
A differenza dei database relazionali tradizionali, dove aggiungere un nuovo campo richiede di modificare l’intera struttura della tabella, MongoDB consente a documenti all’interno della stessa raccolta di avere campi e strutture completamente diversi. Questo elimina la necessità di schemi rigidi e rende più semplice archiviare dati vari senza imporre uniformità.
Vediamo più da vicino come funzionano le modifiche di schema in MongoDB rispetto ai database relazionali tradizionali:
In un database relazionale, se vuoi aggiungere un nuovo campo (ad es. discount_price) a una tabella products, dovresti:
In MongoDB, puoi semplicemente aggiungere il campo discount_price solo ai documenti pertinenti nella raccolta products. Per esempio:
// Document 1
{
  "_id": 1,
  "name": "Laptop",
  "price": 1200
}

// Document 2
{
  "_id": 2,
  "name": "Smartphone",
  "price": 800,
  "discount_price": 750  // New field added only where needed
}
Questa flessibilità è inestimabile in ambienti frenetici in cui i requisiti dei dati cambiano spesso. Permette agli sviluppatori di adattarsi rapidamente senza downtime o migrazioni complesse, rendendo MongoDB ideale per lo sviluppo agile e le applicazioni moderne.
MongoDB è progettato per l’archiviazione e il recupero dei dati ad alte prestazioni, rendendolo ideale per applicazioni che richiedono velocità e scalabilità.
Una delle sue caratteristiche chiave è l’uso di file mappati in memoria, che consentono al sistema operativo di gestire la cache in modo efficiente, riducendo la latenza e migliorando le operazioni di lettura/scrittura. MongoDB supporta inoltre vari tipi di indici, tra cui indici su singolo campo, composti, geospaziali, testuali e hashed, per accelerare le prestazioni delle query.
MongoDB offre un motore di archiviazione in-memory per casi d’uso a latenza ultra-bassa, consentendo un accesso più rapido ai dati mantenendo tutto in RAM. Inoltre, l’ottimizzatore di query di MongoDB garantisce un’esecuzione efficiente scegliendo automaticamente i migliori indici e piani di esecuzione.
Queste caratteristiche, unite allo scaling orizzontale tramite sharding, rendono MongoDB una scelta solida per applicazioni ad alto throughput come analytics in tempo reale, app mobile e sistemi IoT.
Se sei nuovo a MongoDB, niente paura: configurarlo è semplice e puoi scegliere tra un’installazione locale o un’opzione cloud. Vediamo queste possibilità qui.
1. Installa MongoDB in locale: puoi installare la Community Edition di MongoDB sulla tua macchina scaricandola dal sito ufficiale di MongoDB. Le istruzioni di installazione sono disponibili per Windows, macOS e Linux, e il processo di setup in genere richiede solo pochi passaggi. Questa opzione ti dà il pieno controllo sul tuo ambiente ed è ideale per sviluppo e test.
2. Usa MongoDB Atlas (basato su cloud): se preferisci evitare la configurazione locale, MongoDB Atlas è un’ottima alternativa. È il servizio cloud completamente gestito di MongoDB e gira su AWS, Azure e Google Cloud. Atlas gestisce per te l’infrastruttura: backup, scaling e aggiornamenti sono tutti automatici. Inoltre, c’è un generoso livello gratuito, che rende facile iniziare senza costi.
Che tu preferisca il controllo di un’installazione locale o la comodità del cloud, MongoDB rende semplice scegliere il percorso che meglio si adatta al tuo flusso di lavoro.
Una volta installato MongoDB, il passo successivo è connetterti—sia per test rapidi nella shell sia per integrarlo nelle tue applicazioni.
Usare la Mongo shell:
Puoi connetterti a MongoDB usando la Mongo shell, un’interfaccia a riga di comando per interagire con il database. Esegui semplicemente mongosh nel terminale per avviare la shell.
mongoshQuesto avvia la shell e, per impostazione predefinita, ti connette all’istanza locale di MongoDB.
Connessione da un’applicazione:
Per lo sviluppo di applicazioni, puoi connetterti tramite linguaggi come Python, JavaScript (Node.js) o Java usando i driver ufficiali di MongoDB. Ad esempio, in Python puoi usare la libreria pymongo per stabilire una connessione:
from pymongo import MongoClient

uri = "your_mongodb_connection_string"
client = MongoClient(uri)

try:
    # Test the connection
    client.admin.command('ping')
    print("Connected to MongoDB!")
except Exception as e:
    print(e)
finally:
    client.close()
Sostituisci "your_mongodb_connection_string" con il tuo URI di connessione locale o Atlas. Una volta connesso, sei pronto per iniziare a inserire e interrogare documenti.
> Lavori in Python? Questo corso Introduzione all’uso di MongoDB per la Data Science con Python è un ottimo punto di partenza per imparare a connettere, interrogare e analizzare dati MongoDB con Python.
MongoDB offre una serie di comandi per interagire con database, raccolte e documenti. Ecco alcuni comandi fondamentali per iniziare:
use myDatabaseQuesto comando passa a un database chiamato myDatabase. Se non esiste ancora, MongoDB lo creerà quando aggiungi i primi dati.
db.createCollection("myCollection")Crea una nuova raccolta chiamata myCollection all’interno del database corrente.
db.myCollection.insertOne({ name: "Alice", age: 30 })Aggiunge un nuovo documento alla raccolta myCollection.
db.myCollection.find({ age: { $gt: 25 } })Recupera tutti i documenti in cui il campo age è maggiore di 25.
Questi comandi sono solo la punta dell’iceberg: MongoDB offre potenti funzionalità di query, indicizzazione e aggregazione. Puoi esplorare l’elenco completo dei comando nella documentazione ufficiale di MongoDB.
> Se cerchi una guida più approfondita e pratica, questo tutorial su come configurare e interrogare i database MongoDB ti accompagna passo dopo passo nel setup e nelle operazioni di base.
Vuoi ottenere il massimo da MongoDB? Queste best practice possono aiutarti a aumentare le prestazioni, evitare gli errori più comuni e creare applicazioni che scalano senza problemi.
Un’indicizzazione corretta è essenziale per ottimizzare le prestazioni di MongoDB. Ecco alcune strategie chiave per assicurarti che i tuoi indici siano efficaci:
last_name e first_name, un indice composto su entrambi i campi sarà più efficiente.status o gender). Gli indici composti possono aiutare, ma assicurati che l’insieme dei campi abbia alta cardinalità.> Dai un’occhiata alle best practice di performance per l’indicizzazione di MongoDB per approfondire strategie efficaci.
Un efficace data modeling è cruciale per ottimizzare le prestazioni e la scalabilità di MongoDB. Il modello orientato ai documenti offre flessibilità nella strutturazione dei dati, ma richiede una pianificazione attenta per garantire efficienza.
Ecco alcune best practice per il data modeling in MongoDB:
product_id.Proteggere la tua distribuzione MongoDB è fondamentale per garantire integrità, disponibilità e conformità dei dati. Ecco una guida per implementare pratiche solide di backup e sicurezza.
mongodump e mongorestore per creare e ripristinare backup. Questi strumenti ti permettono di esportare e importare dati in formato BSON, garantendo compatibilità e coerenza. Per soluzioni di backup più avanzate, considera il ripristino point-in-time usando i backup dell’oplog (Ops Manager). Questo ti permette di ripristinare il database a un momento specifico, riducendo al minimo la perdita di dati.Che tu stia creando un piccolo progetto personale o un’applicazione enterprise su larga scala, MongoDB ti offre flessibilità e potenza per lavorare con i dati alle tue condizioni. Il suo modello basato su documenti, il design dinamico dello schema e la capacità di scalare senza sforzo lo rendono una scelta di riferimento per gli sviluppatori moderni. Capendo come usarlo in modo efficace—e seguendo le best practice—sarai sulla buona strada per creare applicazioni veloci, flessibili e a prova di futuro.
Vuoi portare le tue competenze al livello successivo? Esplora la guida alla certificazione MongoDB per capire cosa comporta ottenere la certificazione, oppure ripassa con queste domande di colloquio comuni su MongoDB per prepararti al tuo prossimo ruolo tech.
Approfondisci MongoDB con questi corsi!
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



