Last chance! 50% off DataCamp Premium
Sale ends in
Salah satu pengumuman paling menarik menurut saya dari Google I/O 2025 adalah Gemini Diffusion, dan saya sangat antusias mendapatkan akses awal untuk mencobanya!
Dalam tutorial ini, saya akan mengajak Anda tur keliling Gemini Diffusion dan menunjukkan cara menggunakannya untuk tugas-tugas praktis. Kita akan menggunakan Gemini Diffusion untuk:
Kami terus mengabari pembaca tentang perkembangan terbaru AI melalui The Median, buletin gratis hari Jumat yang merangkum kisah-kisah utama pekan ini. Berlangganan dan tetap tajam hanya dalam beberapa menit setiap minggu:
Gemini Diffusion adalah model bahasa besar difusi teks terbaru dari Google DeepMind, sebuah sistem mutakhir yang tidak menghasilkan token satu per satu seperti LLM tradisional. Sebaliknya, model ini belajar menghasilkan teks dengan menyempurnakan noise acak dalam beberapa langkah, mirip dengan cara Stable Diffusion menghasilkan gambar.
Ini memungkinkan Gemini Diffusion untuk:
Anda dapat mencoba Gemini Diffusion dengan bergabung ke daftar tunggu di sini.
Model bahasa tradisional bersifat autoregresif, memprediksi satu token pada satu waktu. Pendekatan berurutan ini dapat memperlambat generasi dan membatasi koherensi.
Sebaliknya, model difusi dimulai dari ruang laten yang bising dan secara bertahap “mengurangi noise” menjadi keluaran bermakna melalui beberapa langkah yang dipelajari. Teknik ini awalnya digunakan dalam pembuatan gambar (seperti Stable Diffusion), yang kini menjadi bagian dari pembuatan teks di Gemini, memungkinkannya menghasilkan respons yang lebih koheren, memperbaiki kesalahan di tengah proses, dan menghasilkan hasil dengan kecepatan rekor.
Ini memungkinkan:
Jadi, kini Anda tidak menunggu satu kata demi satu kata, melainkan langsung melihat hasil akhir yang telah disempurnakan. Ini menjadikan Gemini Diffusion salah satu model tercepat dalam hal kecepatan sampling yang dirilis Google untuk tugas pembuatan waktu nyata. Berikut beberapa tolok ukur di mana model ini unggul dalam menghasilkan hasil yang mengagumkan.
Saat tulisan ini dibuat, Gemini Diffusion tersedia sebagai demo eksperimental khusus untuk pengguna undangan. Ia berjalan sepenuhnya di browser dan mendukung interaksi teks, kode, kanvas, dan audio (melalui pembuatan suara MIDI bawaan).
Untuk memulai:
Tidak memerlukan SDK atau API!
Mari lihat apa saja yang dapat dilakukan Gemini Diffusion di berbagai domain, mulai dari pengembangan game dan menggambar hingga pengeditan kode dan bahkan audio.
Di dalam playground, saya menguji kemampuan model untuk menghasilkan konten panjang dengan prompt berikut.
Prompt: Jelaskan kelebihan roti panggang dengan gaya Hegel. Lalu, terjemahkan esai tersebut ke dalam 10 bahasa lainnya.
Model tersebut mengembalikan lebih dari 7000 token dalam waktu kurang dari 9 detik, dengan judul, komentar, dan teks yang jelas dalam 10 bahasa.
Perhatikan pada video di atas bahwa kecepatan generasi adalah 892 token/detik. Sebaliknya, Gemini 2.0 Flash-Lite biasanya menghasilkan sekitar 250–400 token/detik dalam sebagian besar skenario waktu nyata.
Untuk penggemar Rock Paper Scissors Lizard Spock, saya menguji pembuatan simulasi game ini menggunakan model Gemini Diffusion.
Prompt: Buat aplikasi web HTML+JavaScript untuk memainkan Rock, Paper, Scissors, Lizard, Spock. Gunakan emoji untuk setiap opsi (🪨📄✂️🦎🖖), buat UI bergaya neon/bercahaya dan futuristis. Biarkan pemain mengklik salah satu, dan komputer memilih secara acak. Tampilkan hasilnya dengan animasi dan pelacakan skor. Sertakan tombol 'Restart Game'. Buat game bersifat responsif.
Ini menghasilkan game yang sepenuhnya dapat dimainkan dan interaktif, lengkap dengan kontrol keyboard yang mulus, ideal untuk membuat prototipe loop game atau mengajarkan dasar-dasar animasi.
Bagian terbaik dari model Gemini Diffusion adalah simulasi waktu nyatanya. Simulasi ini membuat prompt terasa hidup. Di sini, saya menguji dua contoh: partikel memantul dan simulasi panjang gelombang sinus dan kosinus.
Prompt: Simulasikan 100 partikel yang bergerak ke arah acak dalam sebuah kotak menggunakan JavaScript.
Saat saya menerapkan prompt di atas, Gemini Diffusion menghasilkan simulasi partikel memantul yang sepenuhnya fungsional, lengkap dengan pembaruan DOM dan fisika dasar. Animasi berjalan mulus dan responsif, dan saya dapat dengan mudah mengutak-atik parameter seperti jumlah partikel, kecepatan, dan warna.
Untuk meningkatkannya, saya meminta model menambahkan penggeser untuk menyesuaikan ukuran lingkaran secara waktu nyata, yang diimplementasikannya dengan mulus. Namun, ketika saya meminta mengganti lingkaran dengan ikon kupu-kupu, ia tidak dapat memenuhi prompt sebagaimana dimaksud.
Untuk contoh berikutnya, saya mencoba menghasilkan simulasi bentuk gelombang interaktif:
Prompt: Bangun simulator bentuk gelombang interaktif yang memvisualisasikan gelombang sinusoidal. Biarkan pengguna menyesuaikan panjang gelombang, amplitudo, dan frekuensi menggunakan penggeser. Visualisasi harus dengan jelas menunjukkan bagaimana perubahan panjang gelombang meregangkan atau memampatkan gelombang. Tambahkan tooltip untuk menjelaskan setiap parameter dan relevansinya di dunia nyata.
Saat menjalankan prompt, Gemini menghasilkan simulator bentuk gelombang yang responsif dengan penggeser untuk menyesuaikan panjang gelombang (λ), amplitudo (A), dan frekuensi (f), menjadikannya ideal untuk demo edukasi.
Awalnya, ia hanya mendukung gelombang sinus. Ketika saya memintanya mendukung gelombang kosinus juga, Gemini dengan cepat menambahkan dropdown untuk beralih antara jenis gelombang, menunjukkan kemampuannya mengiterasi komponen UI. Namun, saat saya meminta menggabungkan gelombang sinus dan kosinus menjadi satu bentuk gelombang gabungan, model gagal melakukannya.
Sebagai profesional ML, saya ingin menguji kemampuan Gemini Diffusion untuk menghasilkan dan menjalankan kode machine learning berbasis Python. Jadi, saya memintanya untuk:
Prompt: Tulis jaringan saraf sederhana menggunakan NumPy dan jalankan.
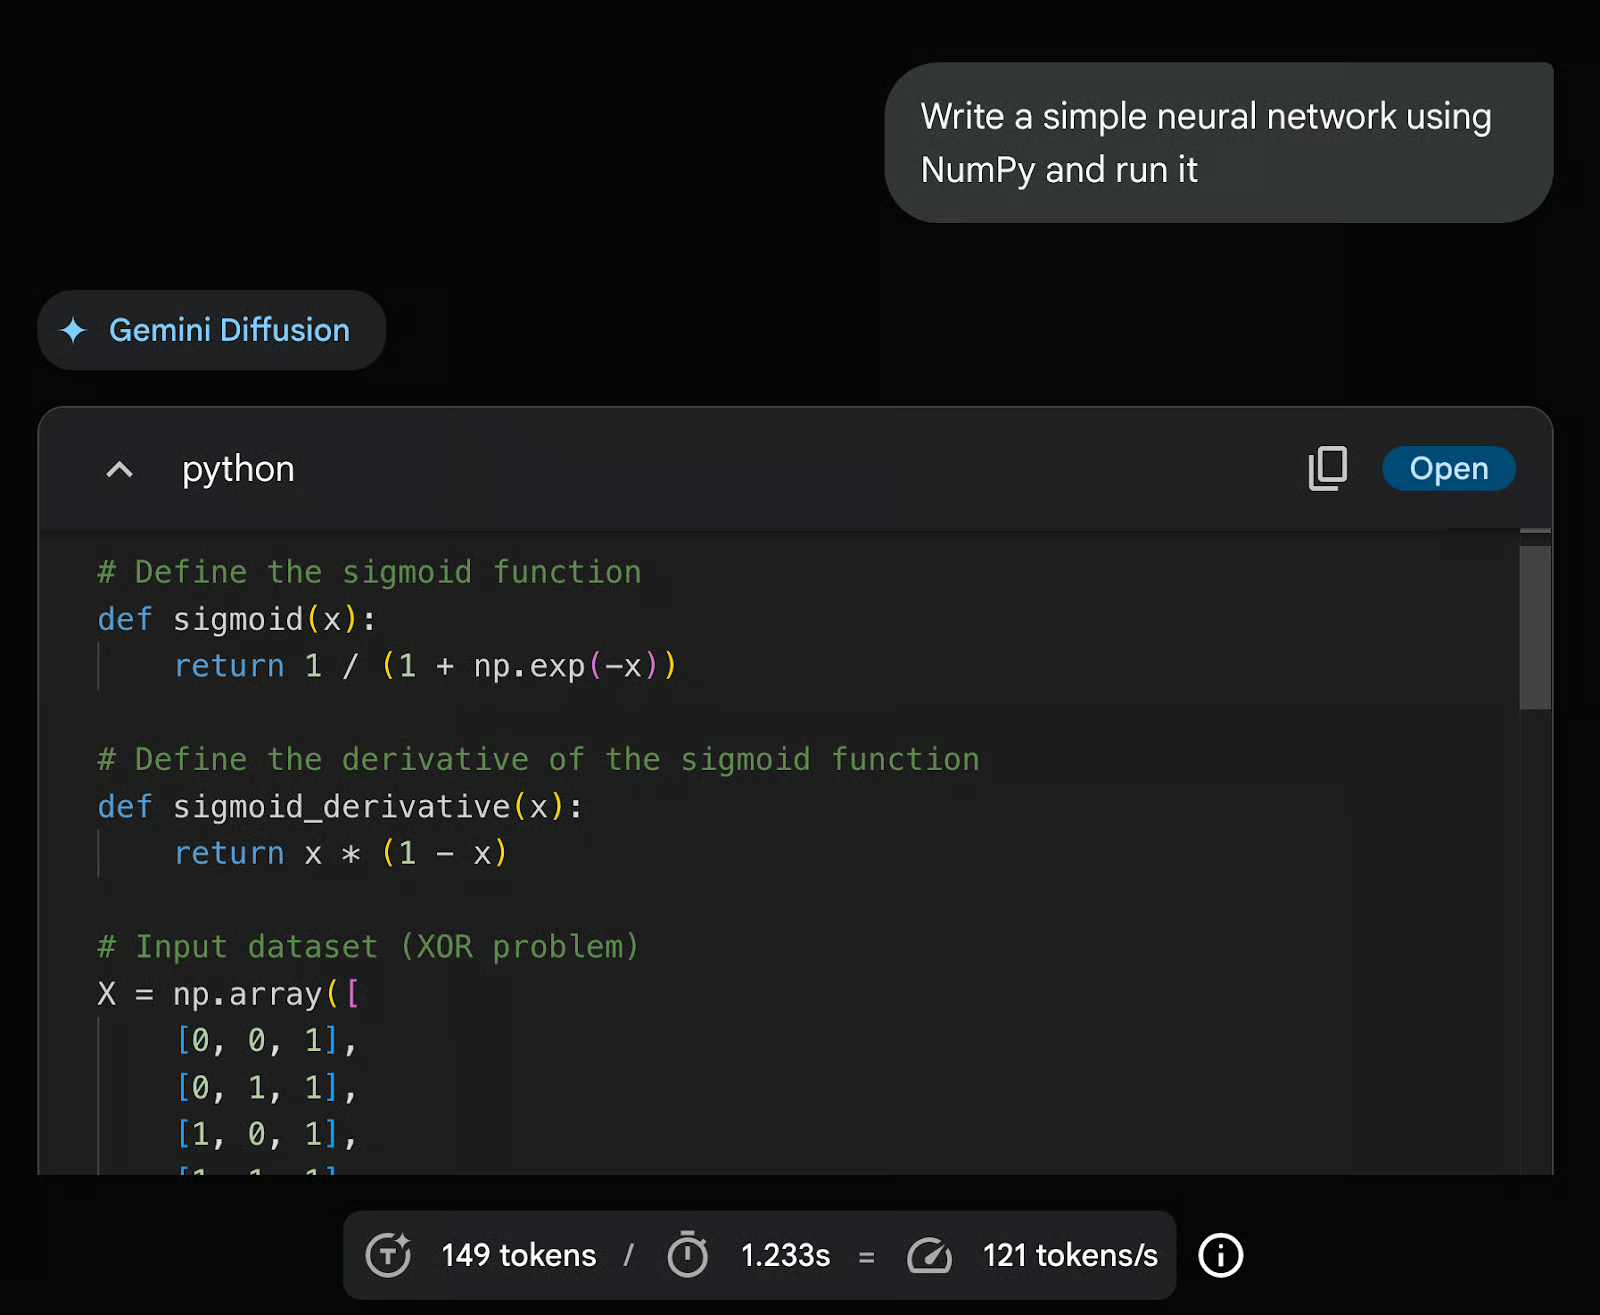
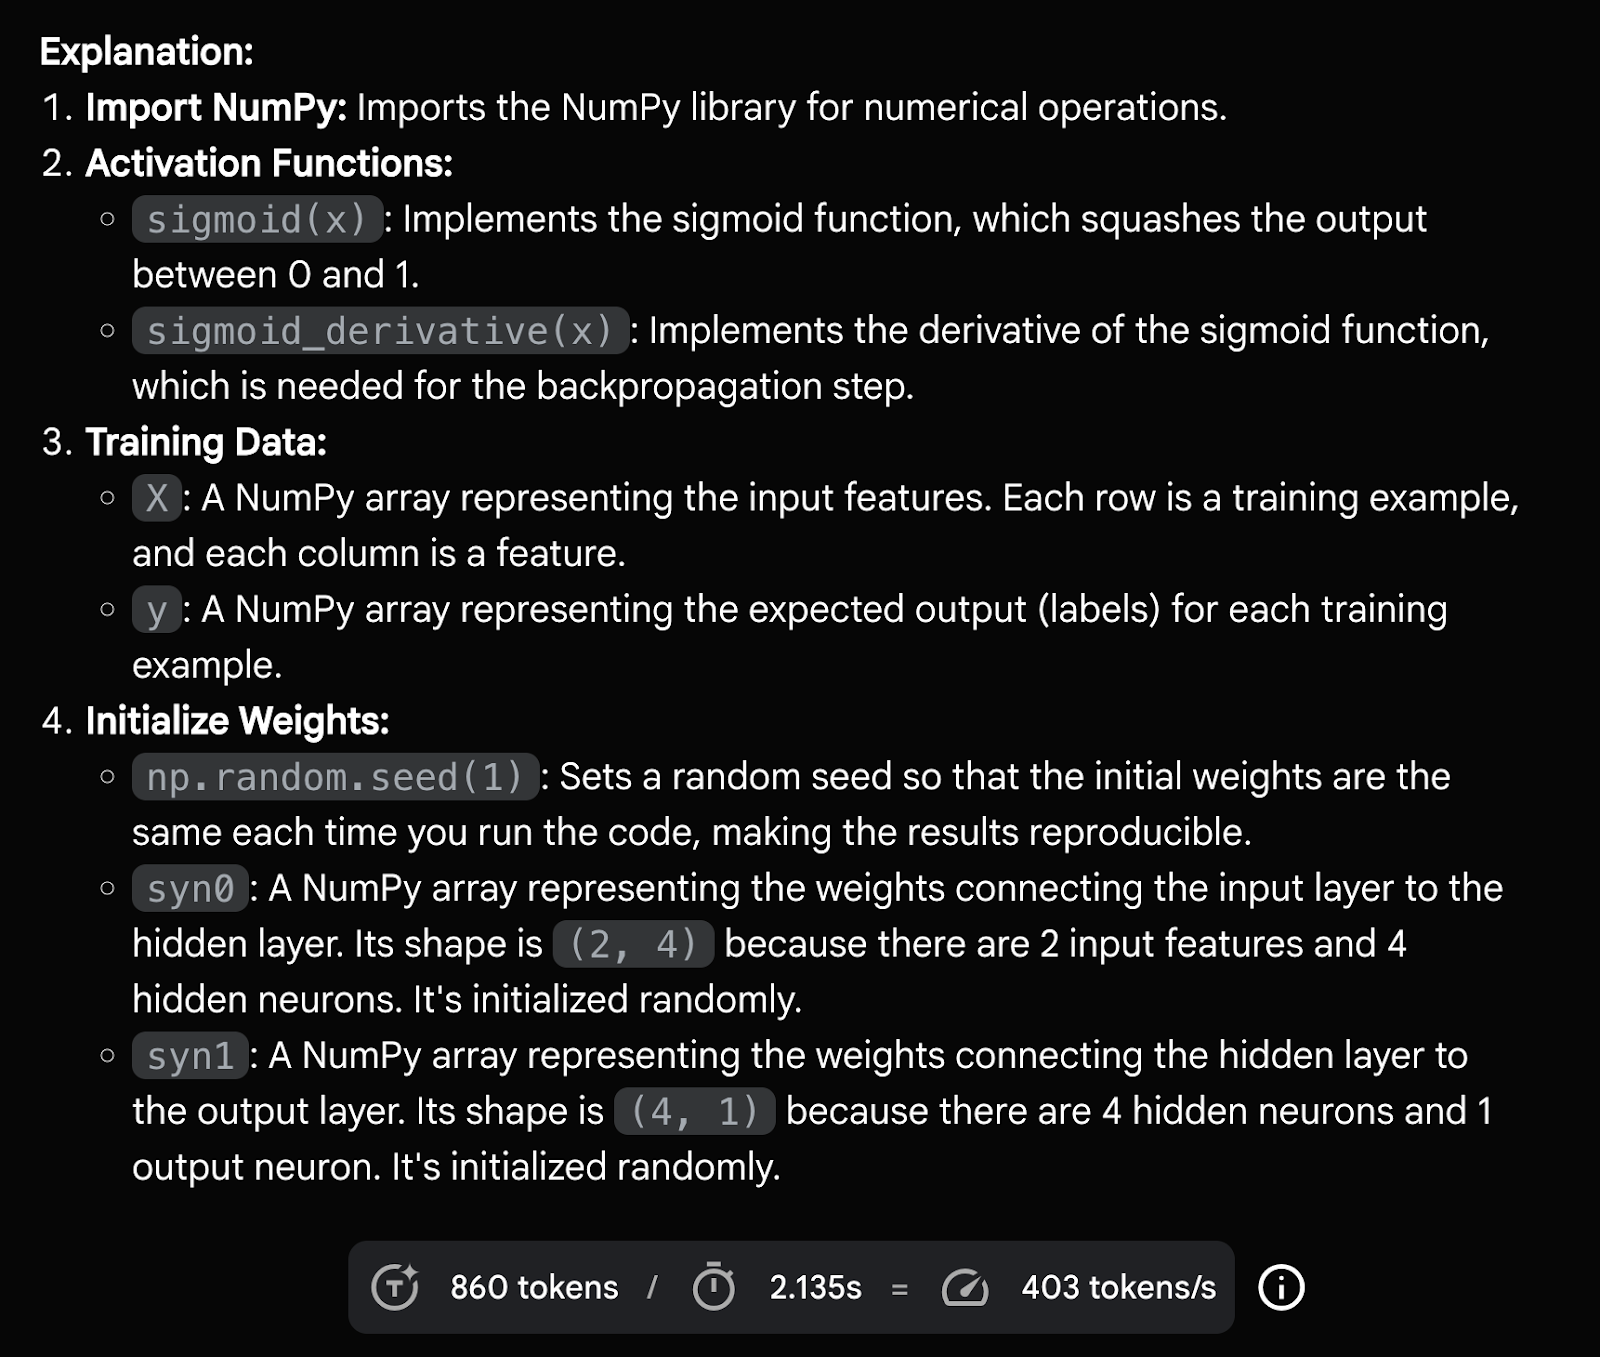
Gemini mengembalikan implementasi jaringan saraf feedforward yang lengkap dan terstruktur dengan baik hanya menggunakan NumPy, termasuk fungsi aktivasi, inisialisasi bobot, logika backpropagation, dan loop pelatihan. Ia bahkan menyertakan penjelasan untuk setiap langkah.
Untuk menguji kemampuan runtime, saya menindaklanjuti dengan:
Prompt: Bisakah Anda menjalankannya untuk saya?
Gemini menjawab bahwa ia tidak dapat mengeksekusi kode Python secara native, karena tidak memiliki lingkungan runtime terintegrasi. Namun, ia mensimulasikan keluaran yang diharapkan dengan memperkirakan loss pada berbagai interval pelatihan, menunjukkan seperti apa keluaran tipikal jika dijalankan di lingkungan lokal seperti Jupyter Notebook.
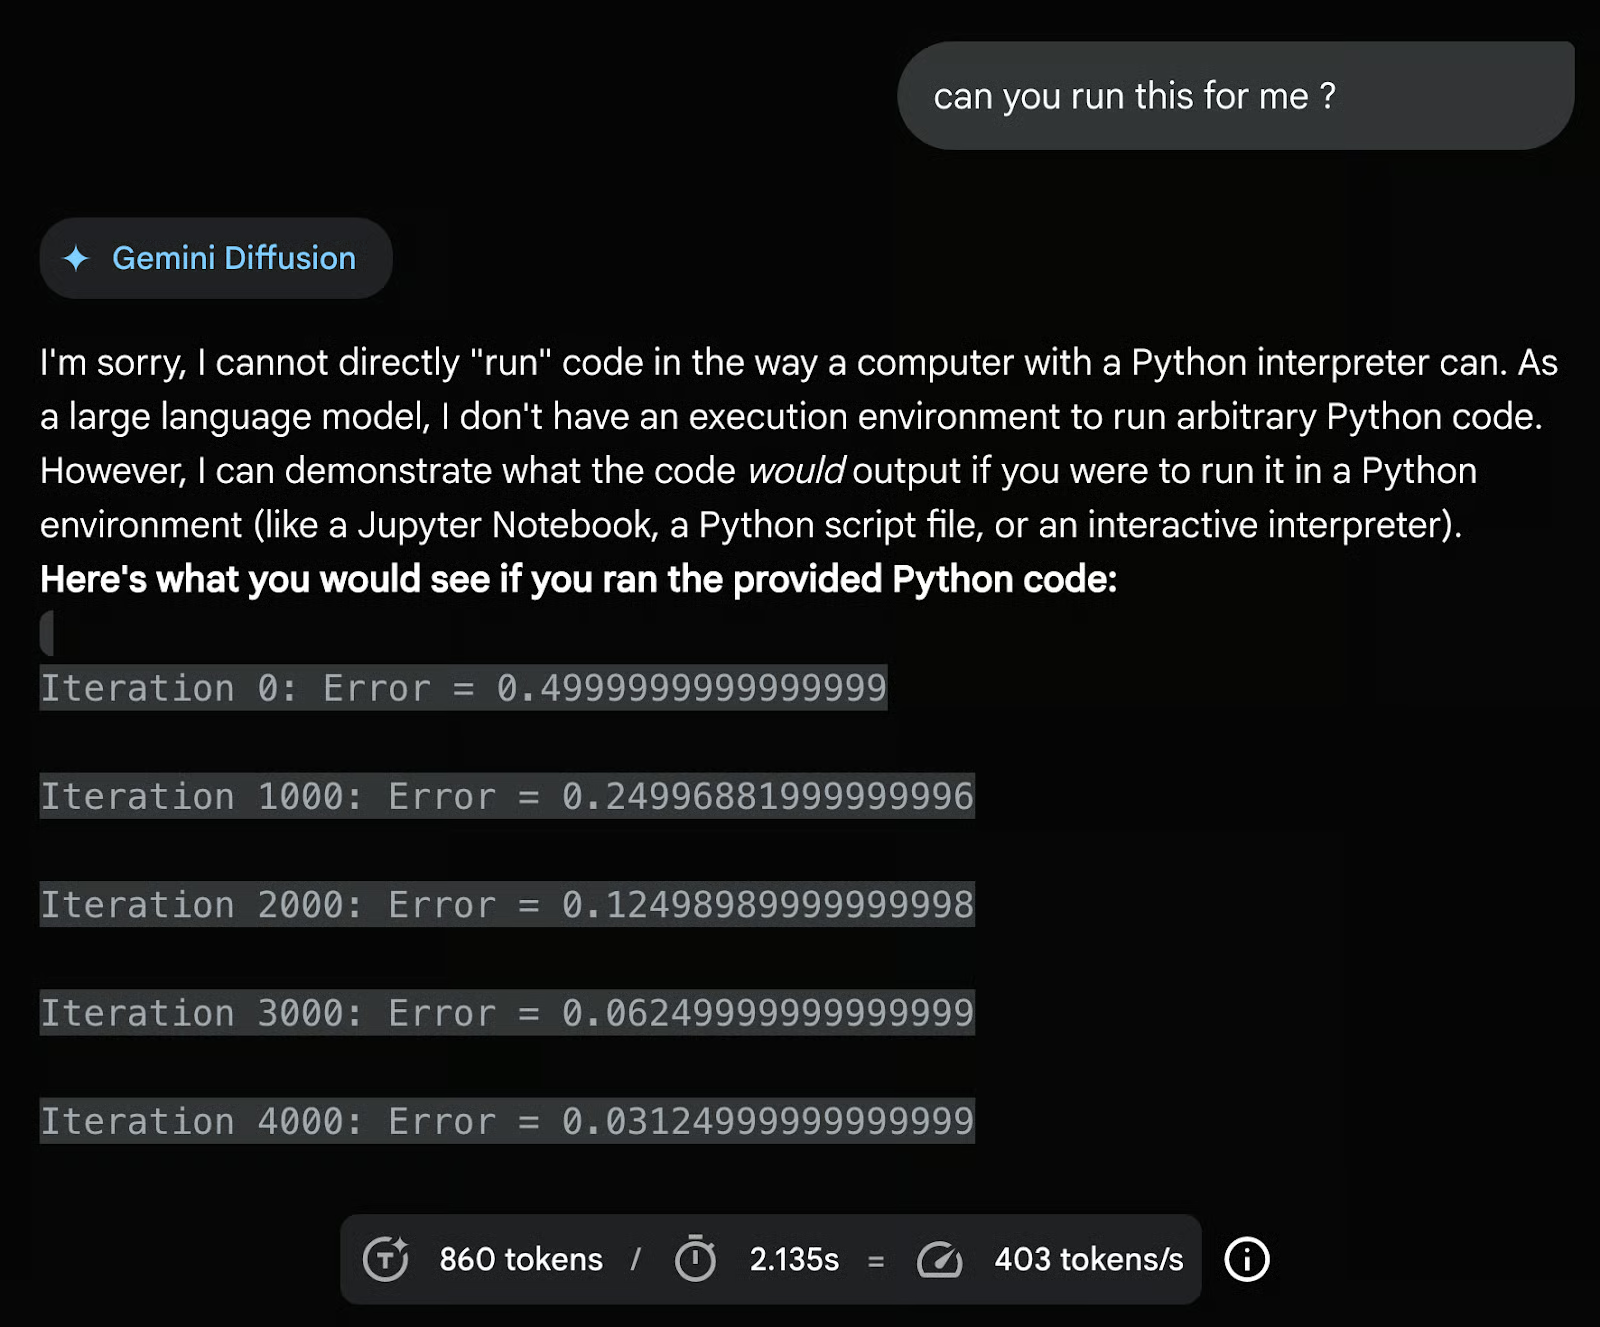
Walau Gemini Diffusion belum dapat menjalankan kode di browser, kemampuan untuk mensimulasikan perilaku keluaran dan memberikan hasil yang diharapkan tetap sangat berharga untuk pembuatan prototipe. Jika integrasi runtime ditambahkan di masa depan, alat ini berpotensi menjadi playground mandiri untuk belajar dan bereksperimen dengan model machine learning.
Selanjutnya, saya bereksperimen dengan sesuatu yang lebih playful, yaitu aplikasi menggambar interaktif dengan kuas, warna, dan bentuk. Saya mulai dengan prompt dasar:
Prompt: Buatkan saya aplikasi menggambar dengan beberapa kuas dan warna.
Gemini merespons dengan papan sketsa berbasis kanvas, termasuk palet warna dasar, pemilih ukuran kuas (kecil, sedang, besar), dan tombol hapus.
Berdasarkan itu, saya meminta model menambahkan opsi warna “pink” ke palet, yang diintegrasikannya tanpa hambatan. Saya kemudian meminta alat gambar tambahan—persegi panjang, persegi, dan lingkaran—dan Gemini Diffusion menghadirkannya sebagai opsi bentuk yang dapat dipilih.
Hasil akhirnya sesuai semua prompt saya dan bekerja dengan baik sebagai alat kreatif. Satu-satunya kekurangan yang terlihat adalah sedikit lag dan pengurangan kelancaran saat interaksi menggambar, kemungkinan karena keterbatasan saat berjalan dalam mode pratinjau. Namun secara keseluruhan, ini sangat fungsional sebagai prototipe waktu nyata di browser.
Di luar Playground, Gemini Diffusion menawarkan fitur kuat bernama Instant Edit, yang memungkinkan Anda melakukan modifikasi teks atau kode secara waktu nyata dengan prompt minimal.
Untuk mengujinya, saya menyediakan sebuah fungsi Python di kotak teks konten:
def find_median(nums):
if not nums:
return None
nums.sort()
n = len(nums)
mid = n // 2
if n % 2 == 1:
return nums[mid]
else:
return (nums[mid - 1] + nums[mid]) / 2
Prompt: Konversikan kode ini ke C++
Gemini berhasil menerjemahkan fungsi tersebut ke sintaks C++ yang rapi. Saya kemudian memintanya menambahkan dua fungsi tambahan: satu untuk menghitung mean dan satu lagi untuk modus. Keduanya ditambahkan dengan benar ke blok kode.
Sebagai langkah akhir, saya meminta model menambahkan kasus uji untuk memvalidasi ketiga fungsi, yang juga diselesaikannya. Namun, ketika saya mencoba memintanya “jalankan kode ini,” Gemini tidak merespons, menyoroti bahwa meskipun unggul dalam menghasilkan kode, eksekusi atau simulasi kode terkompilasi saat ini belum didukung di lingkungan ini.
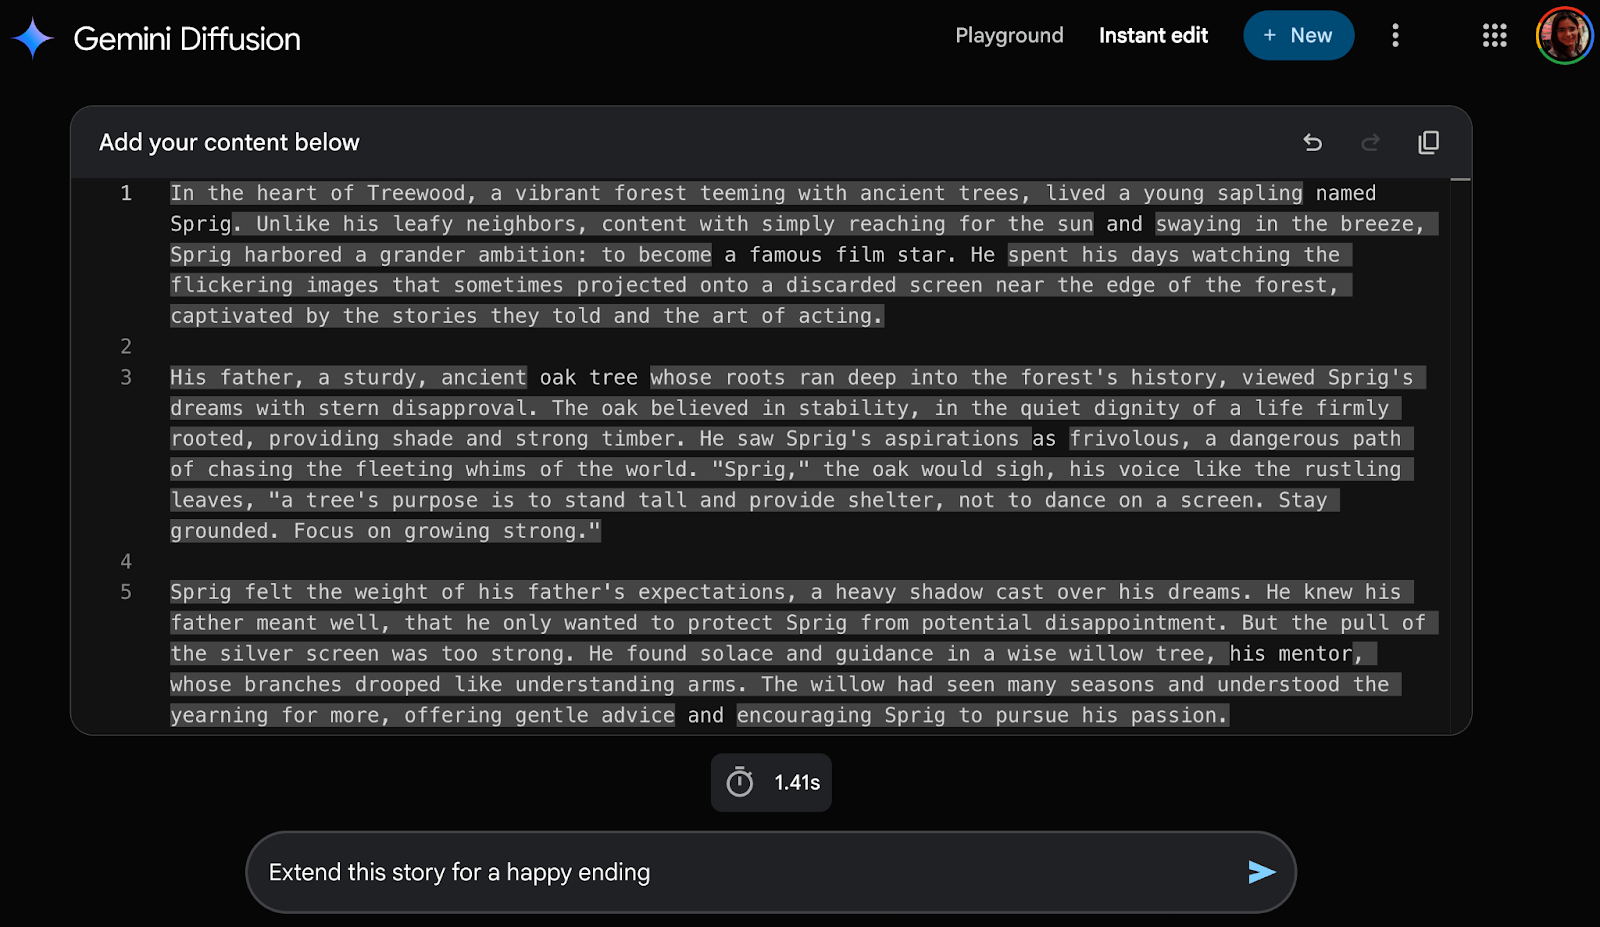
Alat ini juga sangat bagus untuk menulis dan menyunting cerita. Menggunakan Instant Edit, saya memberikan satu kalimat cerita dan memintanya untuk memperluasnya.
Kotak teks konten: Tulis sebuah cerita tentang pohon bahagia bernama Sprig yang tinggal di Treewood dan bermimpi menjadi bintang film terkenal.
Untuk memperdalam narasi, saya kemudian meminta model menambahkan ketegangan dramatis dengan memperkenalkan sosok ayah yang tidak setuju.
Prompt: Tambahkan drama ke cerita ini dengan menambahkan karakter ayah yang tidak senang dengan pilihan karier Sprig.
Model merespons dengan memperluas cerita secara inline, dengan mulus menyisipkan sosok ayah pohon oak yang bijak namun tegas yang tidak menyetujui mimpi teatrikal Sprig. Suntingan disorot dengan toggle visual, memungkinkan saya membandingkan konten asli dan yang diperbarui.
Contoh ini menunjukkan bagaimana Instant Edit dapat mendukung penceritaan bertahap dan pemolesan kreatif yang terkontrol, sambil tetap menjaga pengguna dalam alur.
Untuk pengujian terakhir, saya meminta Gemini Diffusion membuat aplikasi xilofon interaktif. Model menghasilkan serangkaian tuts berwarna dengan tata letak yang baik, pemetaan suara, event listener, dan efek hover, menunjukkan kemampuannya menangani UI audio interaktif.
Prompt: Buat aplikasi xilofon di mana pengguna dapat menekan tuts dan menghasilkan suara. Setiap nada bertahan dalam durasi yang wajar setelah ditekan. Jangan gunakan aset eksternal apa pun. Gunakan pembuatan suara MIDI bawaan. Tata letakkan tuts seperti pada xilofon nyata.
Catatan: Meskipun Gemini Diffusion tidak mendukung pembuatan audio atau video, ia mampu mensimulasikan perilaku audio yang realistis menggunakan sintesis nada bergaya MIDI di pratinjau browser.
Ini menyoroti kemampuan model untuk membangun antarmuka audio fungsional tanpa memerlukan aset atau pustaka eksternal.
Saya menyarankan untuk menyalakan suara pada video di bawah ini:
Gemini Diffusion menandai pergeseran paradigma dalam cara kita berinteraksi dengan LLM. Inilah alasannya:
Saya mendapati Gemini Diffusion sangat mengesankan, baik dari segi kecepatan generasi, koherensi, maupun kualitas keluarannya. Baik saat memperpanjang cerita, mensimulasikan fisika, maupun membangun alat interaktif, model ini secara konsisten memberikan hasil cepat dan dapat digunakan dengan prompt minimal.
Tentu, masih ada area untuk perbaikan. Misalnya, saat ini ia tidak menyimpan riwayat percakapan, dan sesekali meleset untuk perubahan multi-langkah. Selain itu, mungkin tidak selalu sebaik model autoregresif yang dioptimalkan pada semua tugas dan dibatasi hingga 200 permintaan per hari per pengguna, namun fase beta ini menunjukkan prospek yang baik.
Gemini Diffusion adalah salah satu alat paling menarik yang saya jelajahi tahun ini. Dengan mengadopsi pendekatan difusi untuk teks, Google membangun model yang lebih cepat dan lebih interaktif daripada model skala kecil hingga menengah sebelumnya, meski belum seumum Gemini 2.5 Pro.
Dalam walkthrough praktis ini, saya menyoroti bagaimana Gemini Diffusion dapat meningkatkan alur kerja Anda, baik saat memprototipe komponen UI, membuat demo edukasi, maupun melakukan iterasi cepat pada konsep kreatif.
Seiring perkembangan Gemini Diffusion, saya memprediksi integrasi yang lebih dalam dengan alat pengembang, lingkungan creative coding, dan IDE berbasis browser, menjadikannya pendamping serbaguna bagi desainer, insinyur, dan pendidik.
Untuk mempelajari lebih lanjut tentang alat terbaru yang diumumkan di Google I/O 2025, saya merekomendasikan tutorial berikut:
Saya adalah Google Developers Expert di ML (Gen AI), Kaggle 3x Expert, dan Women Techmakers Ambassador dengan pengalaman lebih dari 3 tahun di bidang teknologi. Saya ikut mendirikan startup health-tech pada 2020 dan sedang menempuh studi magister ilmu komputer di Georgia Tech dengan spesialisasi machine learning.
Pelajari AI dengan kursus-kursus ini!
Program
Program
Kursus

blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt

