Lewati ke konten utama

Veo 3 dari Google: Panduan dengan Contoh Praktis

Pelajari cara menggunakan Veo 3 untuk membuat iklan spes, menjaga konsistensi karakter di berbagai bidikan, dan memperoleh kontrol modular dengan fitur Ingredients.
Diperbarui 28 Sep 2026  · 12 mnt Baca

Jelajahi bersama AI

ChatGPTClaudePerplexity

Veo 3 dari Google adalah salah satu generator video AI terbaru. Yang langsung menonjol bagi saya adalah kemampuannya menghasilkan audio secara native. Anda dapat membuat klip video lengkap dengan suara bawaan—dialog, efek ambient, musik latar. Itu sesuatu yang belum saya lihat di Runway atau Sora. Pada titik ini, saya akan bilang Veo 3 selangkah lebih maju, terutama dengan peluncuran Veo 3.1, yang kami bahas dalam panduan praktis terpisah untuk Veo 3.1.

Saya sudah melihat cukup banyak demo video AI untuk tahu bahwa sering kali itu terlalu menjanjikan. Tampak rapi, tetapi begitu prompt Anda melenceng ke wilayah yang tidak familiar dibandingkan data pelatihan—setting yang aneh, karakter yang tidak biasa, atau sesuatu yang terlalu subtil—kebanyakan model kewalahan.

Namun saya mencoba Veo 3, dan begini pendapat saya: ini sangat baik. Di bawah ini, saya jelaskan cara kerjanya dan menunjukkan beberapa klip yang berhasil saya buat. Saya rasa Anda akan terkesan.

Kami terus memperbarui pembaca tentang yang terbaru di AI melalui The Median, buletin gratis hari Jumat yang merangkum cerita-cerita kunci sepanjang pekan. Berlangganan dan tetap tajam hanya dalam beberapa menit tiap minggu:

Apa Itu Veo 3? 

Sebelum kita praktik dan saya tunjukkan contohnya, mari pahami sekilas apa itu Veo dan apa yang baru darinya.

Veo 3 adalah model generasi video AI milik Google, diumumkan di Google I/O 2025. Model ini mengubah prompt teks atau gambar menjadi video definisi tinggi, kini dengan integrasi audio native. Artinya, Veo 3 dapat menghasilkan dialog tersinkron, suara ambient, dan musik latar, menghasilkan klip yang terasa sangat hidup.

Berikut contohnya:

Saat ini, Veo 3 hanya tersedia di AS dan hanya melalui Flow, antarmuka pembuatan film bertenaga AI terbaru milik Google. Untuk mengaksesnya, Anda memerlukan paket AI Ultra seharga $250/bulan (sekitar $272 dengan pajak).

Mari mulai membangun!

Membuat Iklan

Untuk uji pertama, saya ingin membuat iklan one-shot untuk merek permen mint fiksi bernama Mintro. Idenya: singkat, nendang, dan mudah diingat. Saya membayangkan momen canggung yang bisa dirasakan—sesuatu yang bisa jadi penahan gulir cepat.

Begini setelannya: dua rekan kerja terjebak di lift kantor yang padat, berhadapan, ruang di mana rasa percaya diri (dan napas segar) berarti. Untuk memecah ketegangan, salah satunya melontarkan kalimat yang sama tragisnya dan lucunya:

“Saya pernah bersin saat rapat all-hands dan menekan ‘share screen’ di saat bersamaan. Tak ada yang selamat.”

Lalu iklan memotong ke logo Mintro, beserta tagline:

“Disetujui untuk obrolan di lift.”

Jika Anda ingin mengikuti, gunakan instruksi visual pada gambar ini untuk membuat video dengan Veo 3:
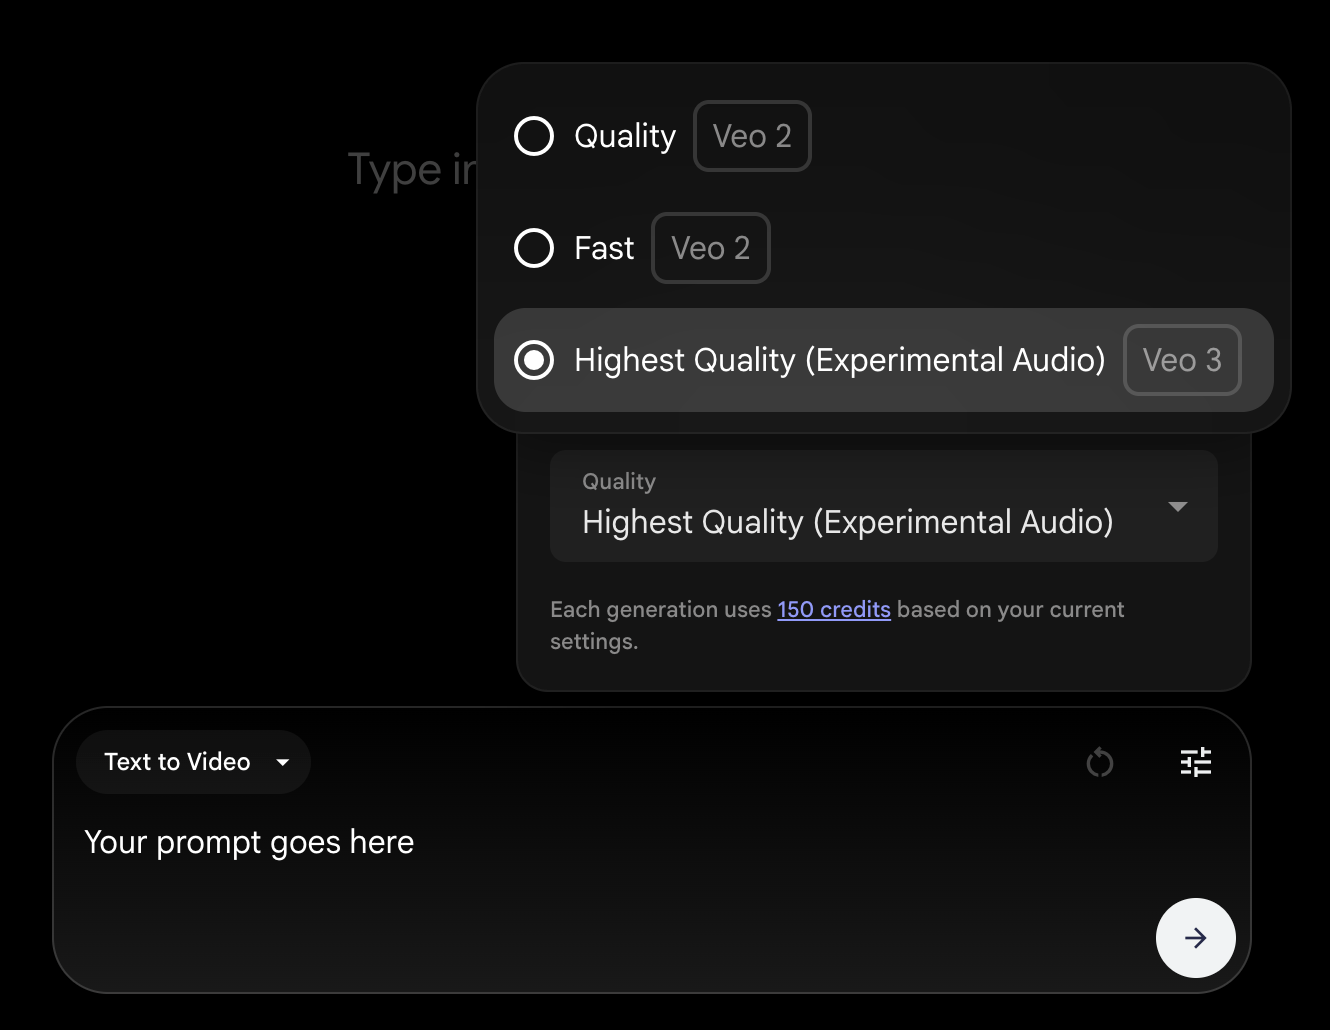
cara membuat video dengan veo 3

Mari mulai dengan prompt ini dan lihat hasilnya:

Prompt:

Sebuah lift kantor yang penuh sesak saat jam sibuk pagi. Dua rekan kerja berpakaian rapi berdiri berhadapan, berdekatan dengan canggung karena ruang yang padat. Salah satunya, tetap berwajah datar, sedikit mendekat dan berkata, “Saya pernah bersin saat rapat all-hands dan menekan ‘share screen’ di saat bersamaan. Tak ada yang selamat.” Yang lain berusaha menahan tawa. Lift berbunyi ding, dan pintu terbuka ke lantai kantor yang ramai.

Versi pertama tampak menjanjikan, tetapi ada beberapa hal yang kurang pas.

Pertama, semua orang di dalam lift menatap karakter utama—mengalihkan fokus ke arah yang salah. Saya ingin orang-orang di sekeliling tetap tenggelam dalam pikirannya masing-masing, seperti kebanyakan dari kita saat berangkat kerja di pagi hari. Idealnya, seseorang melihat ponselnya, orang lain melamun, mungkin ada yang membetulkan tas—tetapi tidak ada yang memperhatikan interaksi itu.

Masalah lain: si perempuan memegangi hidungnya, yang secara halus menyiratkan napas si pria bau. Itu sepenuhnya merusak pesan iklan—ini seharusnya tentang rasa percaya diri berkat napas segar. Gestur itu harus dihilangkan.

Setting-nya juga terasa janggal. Entah mengapa, lift terbuka langsung ke ruang kantor, yang bukan tata letak kantor pada umumnya. Biasanya, lift terbuka ke lorong atau lobi, bukan langsung ke meja kerja seseorang. Detail kecil, tapi membuat adegan terasa aneh dan artifisial.

Selain itu, muncul takarir di video, yang tidak saya minta—dan ejaannya berantakan. Terakhir, suasana suara di dalam lift terlalu hening. Butuh sesuatu yang subtil, seperti musik lift lembut dari speaker di atas kepala, agar lingkungannya terasa nyata.

Dengan catatan-catatan ini, saya membuat sekitar lima iterasi hingga mendapatkan versi yang terasa oke. Tidak sempurna, tetapi jauh lebih mendekati yang saya inginkan.

Berikut prompt revisi yang saya gunakan:

Prompt:

Sebuah lift kantor yang sangat padat saat jam sibuk pagi. Pintu tertutup di awal video, dan saat mulai terbuka perlahan, kita mendengar musik lift lembut dari speaker di langit-langit dan dengung mekanis halus. Kamera menahan satu bidikan tunggal yang kontinu, sudut setinggi mata, fokus ketat pada dua rekan kerja berpakaian rapi yang berdiri berhadapan — berdekatan dengan canggung karena ruang yang padat. Tepat saat pintu lift setengah terbuka, pria itu dengan tenang dan percaya diri berkata: “Saya pernah bersin saat rapat all-hands dan menekan ‘share screen’ di saat bersamaan. Tak ada yang selamat.” Perempuan itu bereaksi dengan tawa tulus — terhibur namun tidak berlebihan — dan ia tidak pernah berbicara, mundur, menyentuh wajah, atau melangkah ke belakang. Di sekitar mereka, penumpang lift lainnya tetap santai dan tak acuh: ada yang menggulir ponsel, yang lain menatap ke depan sambil melamun, orang lain menggeser tasnya — tetapi tidak ada yang melihat atau bereaksi pada dua karakter utama. Pintu terus terbuka penuh, dan di akhir bidikan, kedua rekan kerja itu melangkah keluar dari lift sementara kamera tetap diam di tempat. Para karakter tidak pernah menatap kamera. Jangan sertakan takarir, subtitle, atau teks apa pun di layar.

Versi ini sudah tepat untuk sebagian besar blocking dan nadanya. Namun, masih ada beberapa masalah kecil:

  • Pintu lift terbuka sedikit terlalu cepat, terasa mengagetkan.
  • Audionya masih terasa terlalu hening, meski sudah diminta ada musik lift.

Berdasarkan pengalaman saya dengan AI, perlu satu menit untuk mencapai 90% hasil, dan satu jam untuk menyempurnakan 10% terakhir—meski jujur saja, hampir tak pernah persis seperti yang diinginkan. Jadi saya bawa drafnya ke DaVinci Resolve dan sisanya saya kerjakan manual. Butuh sekitar 15 menit penyuntingan ringan—sekadar fade, musik latar, dan logo Mintro dengan tagline di akhir.

Logo itu sendiri dibuat menggunakan Whisk, alat desain Google yang berjalan dengan Imagen 4 (Anda juga bisa menemukannya di Gemini jika lebih suka bekerja dari aplikasi). Hasilnya cukup bersih sehingga bisa saya pasang tanpa perlu diutak-atik.

Dengan penyuntingan tersebut, iklannya siap. Pendek, aneh, dan—semoga—ingat terus.

Membuat Adegan Multi-Shot dengan Konsistensi Karakter

Sekarang saya ingin menunjukkan cara membangun adegan multi-shot dengan konsistensi karakter—artinya karakter yang sama mempertahankan wajah dan penampilan dari satu bidikan ke bidikan berikutnya. Kedengarannya dasar, tetapi dalam pembuatan video AI, kontinuitas seperti ini masih sulit diwujudkan.

Sebagai klarifikasi: sebuah adegan adalah satuan cerita dengan kesinambungan waktu dan tempat. Bisa terdiri dari satu atau beberapa bidikan, tergantung bagaimana Anda memecahnya. Setelah memahami struktur itu, akan lebih mudah membangun adegan penuh—dan pada akhirnya menyusunnya menjadi sesuatu seperti film pendek.

Untuk demonstrasi, saya akan membuat kisah sangat singkat yang terinspirasi dari salah satu fiksi kilat terbesar yang sering dikaitkan dengan Hemingway:

Dijual: sepatu bayi, belum pernah dipakai.

Itulah inti emosional yang ingin saya bangun. Saya membayangkan mikro-narasi dua bidikan untuk menghidupkan kalimat ini:

  • Bidikan 1: Seorang perempuan di akhir usia 30-an membuka lemari lorong yang penuh mantel tua, linen terlipat, dan beberapa kotak kardus tanpa label. Ia menurunkan salah satu kotak dengan hati-hati dan berlutut di lantai. Ia membuka kotak dan perlahan membuka bungkus sebuah benda kecil di dalamnya: sepasang sepatu bayi putih bersih, tersemat dalam kertas tisu.
  • Bidikan 2: Beberapa menit kemudian, di dapur. Perempuan itu duduk sendirian di meja dapur, ponsel di tangan. Kamera menahan sudut samping yang tetap, medium-close. Ia meletakkan sepatu bayi di meja di sampingnya dan mulai mengetik listing di ponselnya. Teks pada layar ponsel: “Dijual: sepatu bayi, belum pernah dipakai.”

Kali ini, saya tidak akan melakukan iterasi untuk hasil yang halus dan sinematis. Tujuan saya hanya menunjukkan apa yang mungkin dilakukan dengan alat ini—bagaimana menetapkan nada dan menjaga penampilan karakter di beberapa bidikan.

Mari mulai dengan menghasilkan bidikan pertama secara normal (seperti saat kita membuat bidikan untuk iklan).

Prompt:

Interior rumah yang tenang dan berpenghuni saat pagi hari. Cahaya alami menyaring lembut melalui jendela lorong. Seorang perempuan di akhir usia 30-an membuka lemari lorong yang penuh mantel tua, linen terlipat, dan beberapa kotak kardus tanpa label. Ia menurunkan salah satu kotak dengan lembut dan berlutut ke lantai. Kamera tetap diam pada sudut medium-wide, setinggi mata. Ia membuka kotak dan dengan hati-hati membuka bungkus sebuah benda kecil di dalamnya: sepasang sepatu bayi putih bersih, tersemat dalam kertas tisu. Ia duduk bersandar di tumitnya, memegang sepatu itu di pangkuannya. Ekspresinya sulit dibaca — tidak sedih, hanya hadir dan tenang. Bidikan ini hening dan tidak terburu-buru. Tanpa musik. Tekankan ambience alami — suara lembut rumah, derit pintu lemari, gesekan kardus, dan detail halus di kejauhan seperti detik jam atau kicau burung di luar jendela. Momennya harus terasa hening dan nyata. Gaya visual: realisme hangat dan membumi dengan pencahayaan alami. Hindari gaya sinematik yang berlebihan. Pertahankan satu bidikan kontinu tanpa potongan atau zoom. Jangan sertakan teks atau takarir apa pun di layar.

Tidak buruk sama sekali. Saya suka framing, warnanya, dan audionya lumayan. Aktingnya tidak istimewa—tidak banyak emosi—tetapi mari kita kesampingkan itu.

Anggaplah sekarang kita ingin lanjut ke bidikan berikutnya di dapur. Peluang terbaik untuk menjaga konsistensi karakter—mempertahankan wajah, busana, dan penampilan umum yang sama—adalah menggunakan Scene Builder.

Setelah Anda puas dengan bidikan pertama, klik Add to scene:
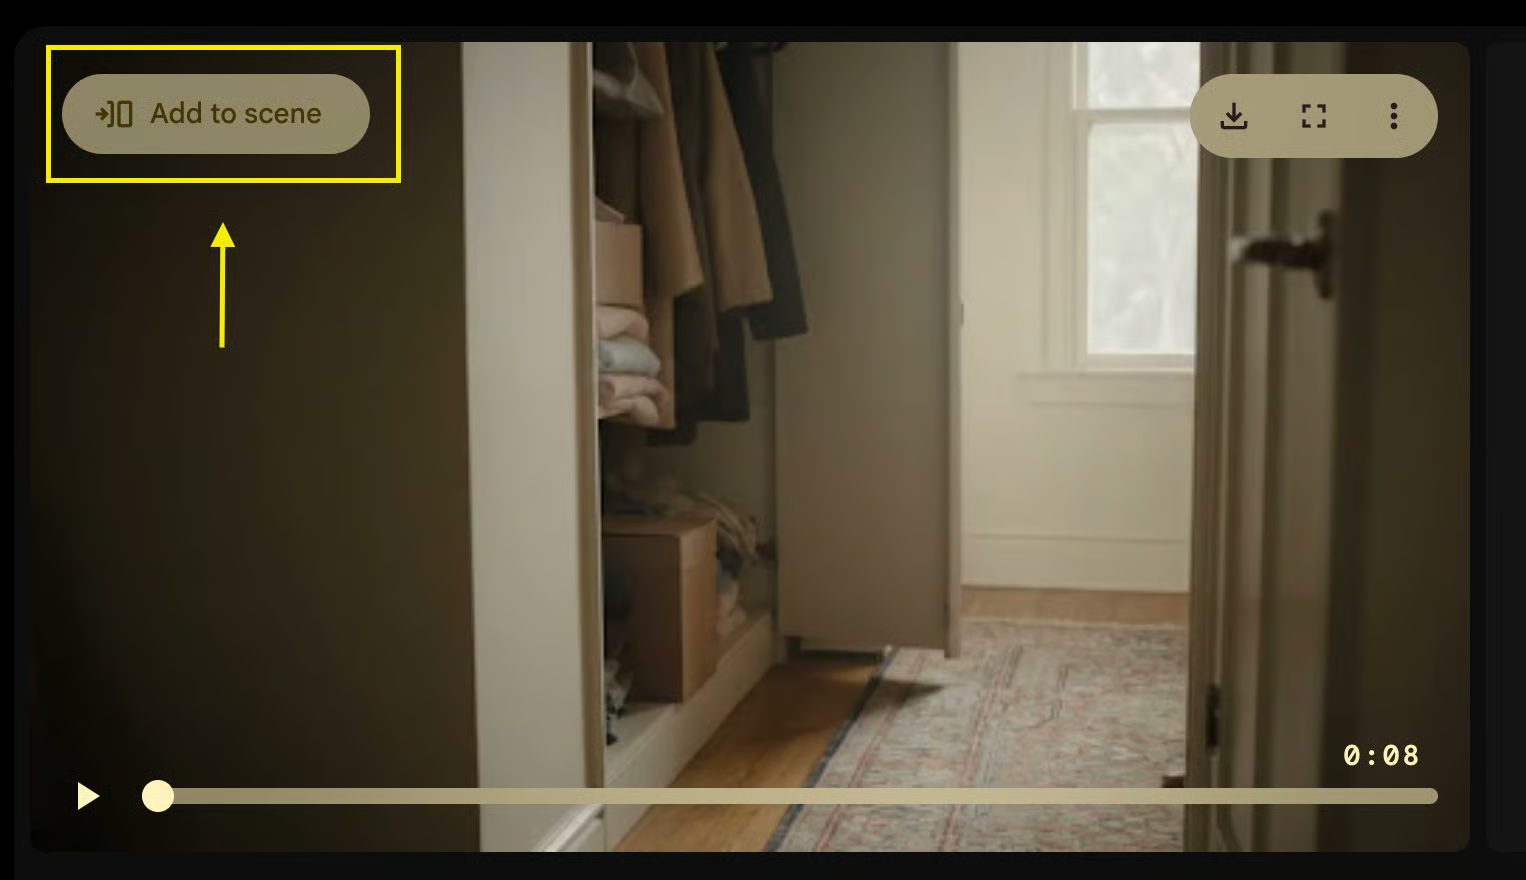
Timeline akan terbuka. Klik tanda plus, lalu pilih antara:

  • Jump to: Ini terjadi lalu (adegan lompat ke)
  • Extend: Ini terjadi lalu (bidikan diperpanjang)

Untuk contoh ini, saya butuh cut, jadi saya pilih Jump to dan menggunakan prompt ini (saya mendapatkannya setelah beberapa iterasi—fitur ini jelas masih perlu perbaikan):

Prompt:

Di dapur beberapa menit kemudian. Sinar matahari menyaring lembut melintasi meja dan lantai, menciptakan suasana tenang dan hening. Ambience rumah yang pelan — dengung lembut kulkas, derit halus kursi, ketukan ringan pada layar ponsel. Tanpa musik atau suara eksternal. Perempuan itu duduk sendirian di meja dapur, ponsel di tangan. Kamera menahan sudut samping yang tetap, medium-close. Ia meletakkan sepatu bayi di meja di sampingnya dan mulai mengetik listing di ponselnya. Kamera memotong ke bidikan over-the-shoulder atau insert ketat yang menampilkan layar ponsel: “Dijual: sepatu bayi, belum pernah dipakai.” Ia menatap teks itu cukup lama, ibu jarinya melayang di atas tombol posting. Matanya mulai berkaca-kaca, tetapi ia cepat mengedip untuk menahannya. Ia tidak menangis — sebagai gantinya, ia mengunci ponsel, meletakkannya telungkup, dan mengembuskan napas, menenangkan diri. Ekspresinya tertahan dan sulit dibaca, tetapi bahasa tubuhnya mengatakan semuanya: ini tidak mudah. Jangan sertakan subtitle di layar.

Kepatuhan terhadap prompt rendah—nada dan komposisinya tidak sesuai bayangan saya. Meski begitu, konsistensi karakternya lumayan: potongan rambut sama, struktur wajah mirip, tetapi pakaiannya berubah.

Saya juga melihat beberapa artefak visual di output (lihat sepatu). Dan meskipun saya mengharapkan satu bidikan, saya mendapat tiga potongan terpisah dalam satu generasi. Belakangan, saya sadar tanpa sengaja menyarankan potongan kedua dalam prompt, jadi itu kesalahan saya—tetapi saya tetap tidak tahu dari mana bidikan ketiga muncul.

Selain itu, ekspor dari Scene Builder menghapus audio sepenuhnya. Saya tidak tahu apakah itu bug atau keterbatasan pengaturan saat ini, tetapi tampaknya belum ada solusi langsung. Anda bisa mengunduh tiap bidikan secara terpisah—jadi saya sambung lagi di DaVinci Resolve.

Masih banyak pekerjaan yang harus dilakukan Google pada fitur Scene Builder, tetapi ini menjanjikan!

Kontrol Modular dengan Ingredients to Video

Salah satu fitur yang lebih eksperimental (dan menyenangkan) di Flow adalah Ingredients to Video. Ini memberi Anda kontrol modular: Anda menghasilkan elemen-elemen individual—disebut ingredients—lalu menggabungkannya menjadi sebuah adegan.

Anda dapat membuat ingredients menggunakan generasi gambar, meskipun unggah gambar belum didukung. Berikut contoh dari tim Google:

Untuk pengujian ini, saya ingin mencoba sesuatu yang agak absurd—sebuah pendek komikal bergaya Kafka:

Seekor serangga berwajah manusia mengemudikan SUV. Namun ada twist-nya (seakan itu belum cukup): kursi pengemudinya adalah kursi raja.

Pertama, mari pilih opsi Ingredients to Video:
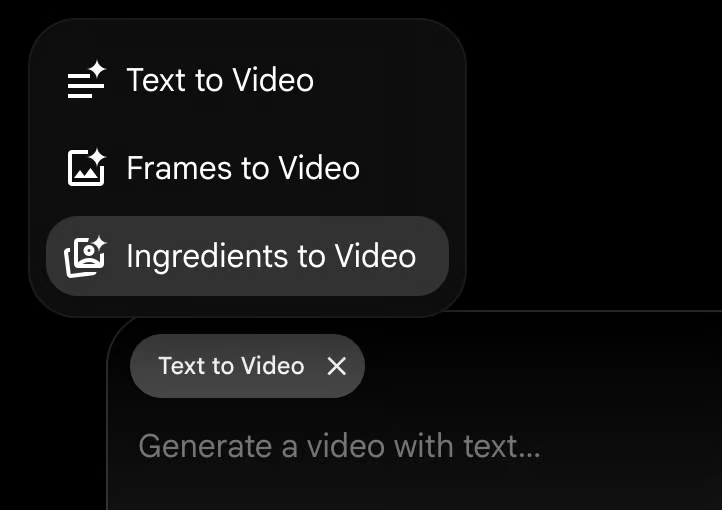
fitur ingredients to video di veo 3

Saya mulai dengan menghasilkan tiga ingredients satu per satu: kursi, SUV, dan serangga.
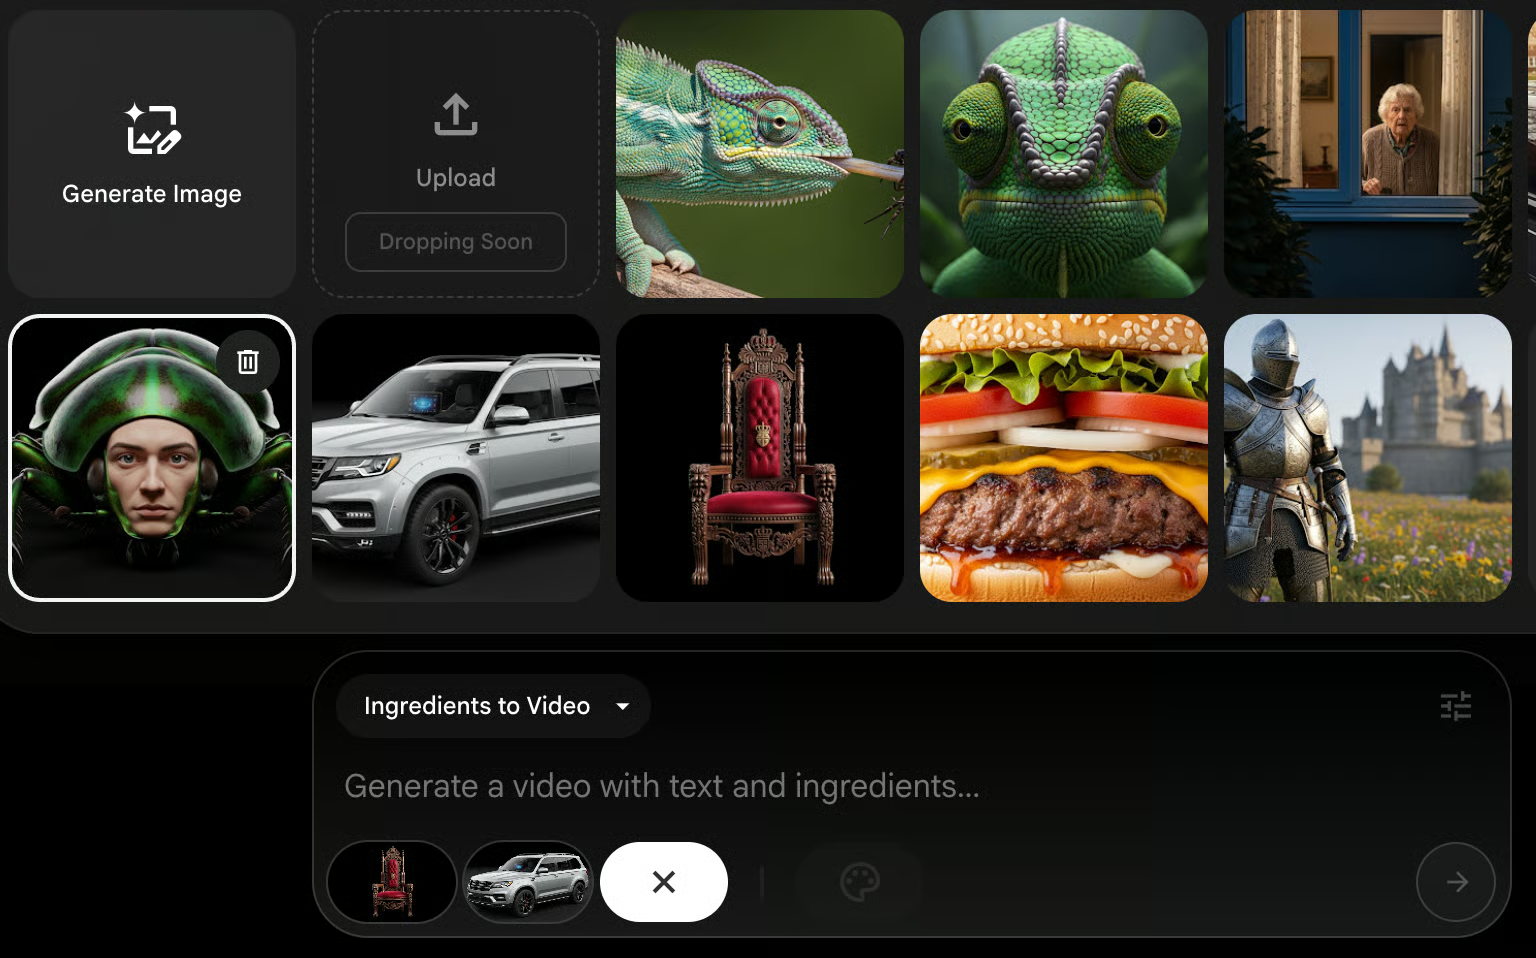
menghasilkan ingredients di veo 3

Sayangnya, fitur ini saat ini berjalan di Veo 2, bukan Veo 3. Secara teknis, Anda bisa memilih Veo 3 dari dropdown, tetapi selalu otomatis kembali ke Veo 2 saat generasi dan menampilkan peringatan ini:
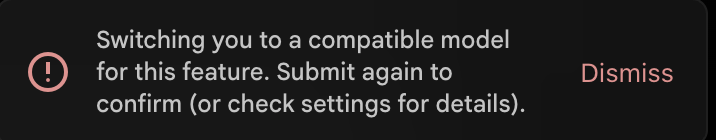
peringatan veo 3

Seperti yang diduga, kualitas outputnya kurang memuaskan:

Prompt:

Seekor serangga berwajah manusia dengan tenang mengemudikan SUV, duduk di atas singgasana raja yang berukuran besar.

Meski begitu, dua dari tiga ingredients—terutama serangga dan kursinya—tampil mengejutkan bagus. SUV-nya, tidak begitu…

Dengan kapabilitas Veo 3, setelan ini kemungkinan akan jauh lebih kuat. Untuk saat ini, mode ini menjanjikan, tetapi belum sampai.

Frames to Video

Gagasan Frames to Video adalah: Anda memberikan bingkai pertama dan terakhir kepada model, dan model mencoba menganimasikan transisi di antaranya (melalui gerakan kamera yang bisa Anda kendalikan). Anda dapat membuat bingkai ini dari prompt atau (nantinya) mengunggah sendiri—unggah gambar belum tersedia.
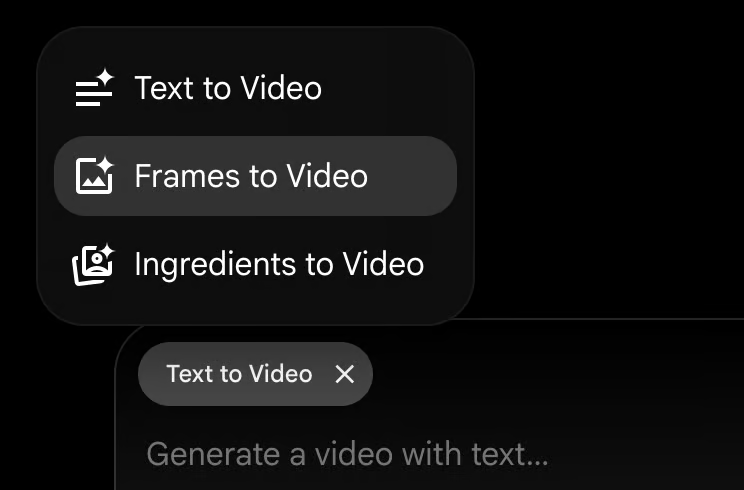
frames to video di veo 3

Seperti fitur Ingredients, mode ini otomatis default ke Veo 2, yang sangat membatasi kualitas. Saya tidak berhasil menghasilkan sesuatu yang benar-benar berguna dengannya.

Akhirnya, saya menggunakannya untuk menganimasikan satu bidikan bunglon. Saya mengatur gambar yang sama sebagai bingkai awal dan akhir dan meminta gerakan kamera dolly-in—tetapi bagian itu tidak dipatuhi pada render akhir.

Prompt:

Seekor bunglon duduk tak bergerak di dahan, matanya perlahan memindai ke arah berlawanan saat menunggu mangsa dengan sabar.

Praktik Terbaik Veo 3

Saat pertama kali mendapat akses ke Veo 3 melalui Flow, Anda akan mulai dengan 12.500 kredit. Setiap generasi video mengonsumsi sebagian dari total tersebut—150 kredit per generasi dengan Veo 3—jadi ada baiknya bersikap strategis sejak awal.

Saran saya: pikirkan matang-matang prompt Anda dan hasilkan hanya satu output setiap kali. Anda perlu membagi kredit itu sepanjang bulan, dan setiap generasi memakan waktu—sering kali 2 hingga 3 menit atau lebih. Itu membuat iterasi relatif lambat, jadi coba-coba tidaklah murah atau cepat.

Untuk penyusunan prompt, Google menyediakan panduan prompt generasi video Vertex AI yang memberikan wawasan tentang penyusunan prompt efektif untuk Veo. Panduan ini menekankan pentingnya prompt yang jelas dan deskriptif serta menyediakan contoh untuk membantu Anda memulai.

Jika Anda mencari panduan tambahan, Runway Gen-3 Alpha Prompting Guide merupakan sumber yang berharga. Panduan ini menawarkan strategi terperinci untuk menyusun prompt yang menghasilkan keluaran video berkualitas tinggi, yang juga bermanfaat saat bekerja dengan Veo 3.

Kesimpulan

Saya belum pernah sekagum ini terhadap terobosan AI sejak generasi gambar GPT-4o.

Veo 3 menghadirkan sesuatu yang terasa benar-benar baru: video koheren dengan audio dari prompt bahasa natural. Itu saja sudah membedakannya dari semua yang pernah saya uji.

Tentu, ada cacatnya—drift prompt, kurangnya akses penuh Veo 3 di alat kunci seperti Scene Builder, dan sesekali gangguan visual—tetapi pengalaman intinya sungguh menggairahkan.

Yang menonjol adalah betapa dekatnya ini terasa sebagai alur kerja kreatif yang layak pakai. Dengan sedikit penyuntingan dan penyusunan prompt yang cermat, Anda bisa beralih dari ide ke storyboard hingga proyek pendek yang berfungsi dalam beberapa jam. Ditambah konsistensi karakter (meski agak rapuh), audio yang sudah tertanam, dan dukungan untuk alur kerja modular, ini mulai terlihat seperti alat yang serius.


Alex Olteanu's photo
Author
Alex Olteanu
LinkedIn

Saya adalah editor dan penulis yang mengulas blog, tutorial, dan berita AI, memastikan semuanya selaras dengan strategi konten yang kuat dan praktik terbaik SEO. Saya telah menulis kursus data science tentang Python, statistik, probabilitas, dan visualisasi data. Saya juga telah menerbitkan novel pemenang penghargaan dan menghabiskan waktu luang untuk menulis skenario serta menyutradarai film.

Topik
Kecerdasan Buatan
AI Generatif
Berita AI

Pelajari AI dengan kursus-kursus ini!

Program

Dasar-Dasar Kecerdasan Buatan

10 jam
Pelajari dasar-dasar kecerdasan buatan (AI), pelajari cara memanfaatkan AI secara efektif untuk pekerjaan, dan jelajahi model seperti ChatGPT untuk memahami lanskap AI yang dinamis.
Lihat DetailRight Arrow
Mulai Kursus
Lihat SelengkapnyaRight Arrow
Terkait

blogs

12 Alternatif ChatGPT Terbaik yang Bisa Anda Coba pada 2026

Artikel ini menyajikan daftar alternatif ChatGPT yang akan meningkatkan produktivitas Anda.
Javier Canales Luna's photo

Javier Canales Luna

14 mnt

blogs

40 Pertanyaan Wawancara DBMS Teratas di 2026

Kuasai pertanyaan wawancara basis data, dari konsep SQL dasar hingga skenario desain sistem tingkat lanjut. Panduan mendalam ini mencakup semua yang Anda perlukan untuk sukses di wawancara DBMS dan meraih peran berikutnya.
Dario Radečić's photo

Dario Radečić

15 mnt

blogs

Spaghetti Plot dan Jalur Badai

Temukan alasan mengapa Anda sebaiknya (tidak) menggunakan spaghetti plot untuk menyampaikan ketidakpastian jalur prediksi badai serta dampaknya terhadap interpretasi.
Hugo Bowne-Anderson's photo

Hugo Bowne-Anderson

13 mnt

blogs

Tutorial Korelasi di R

Dapatkan pengenalan dasar-dasar korelasi di R: pelajari lebih lanjut tentang koefisien korelasi, matriks korelasi, plotting korelasi, dan sebagainya.
David Woods's photo

David Woods

13 mnt

Lihat SelengkapnyaLihat Selengkapnya
