跳至内容

Gemini Diffusion:含8个实用示例的指南

了解谷歌的 Gemini Diffusion 是什么以及其工作原理,并通过八个实用示例学习其在文本生成、游戏开发、仿真等方面的应用。
已更新 2026年10月6日  · 8分钟 阅读

使用 AI 探索

ChatGPTClaudePerplexity

在我看来,Google I/O 2025 上最有意思的发布之一是Gemini Diffusion,而且我很高兴能提前上手体验!

在本教程中,我将带您了解 Gemini Diffusion,并演示如何将其用于实际任务。我们将用 Gemini Diffusion 来:

  • 以“闪电”速度生成文本
  • 构建实时粒子仿真和木琴音频应用
  • 应用代码修复并查看实时预览
  • 创建实时绘图工具和基于浏览器的游戏

我们通过免费周报 The Median 为读者带来 AI 最新动态,用几分钟带您读懂一周要闻。订阅以保持敏锐:

什么是 Gemini Diffusion?

Gemini Diffusion 是 Google DeepMind 推出的全新文本扩散大型语言模型,一种最前沿的系统,它不像传统 LLM 那样逐个生成 token。相反,它通过多步次对随机噪声进行精炼来生成文本,有点类似 Stable Diffusion 生成图像的方式。

这使得 Gemini Diffusion 可以:

  • 一次性生成连贯的整段输出
  • 在生成过程中快速自我纠错
  • 为用户提供包含实时预览、可编辑代码和创作控制的交互体验

您可以通过加入候补名单来体验 Gemini Diffusion,点此报名。

Gemini Diffusion 如何工作?

传统语言模型是自回归的,一次预测一个 token。这种序列式的方法会拖慢生成速度并限制连贯性。

而扩散模型从嘈杂的潜空间出发,通过多次学习到的步骤逐渐“去噪”得到有意义的输出。这一技术最初用于图像生成(如 Stable Diffusion),如今已被引入 Gemini 的文本生成,使其能够生成更连贯的响应、在中途纠错,并以创纪录的速度产出结果。

这带来了以下优势:

  • 更快的文本生成(最高达 1479 tokens/秒)
  • 更连贯的文本段落
  • 更优的实时编辑工作流

因此,您不再需要一字一字地等待,而是可以即时看到完整、打磨过的结果。这使 Gemini Diffusion 成为谷歌用于实时生成任务中采样速度最快的模型之一。以下是该模型在产出如此出色结果方面表现优异的一些基准。

如何访问 Gemini Diffusion?

撰文时,Gemini Diffusion 作为实验性演示仅向受邀用户开放。它完全在浏览器中运行,支持文本、代码、画布和音频交互(通过内置的 MIDI 声音生成)。

开始体验:

  1. 前往 Gemini Diffusion 候补名单表单
  2. 使用您的 Google 帐号登录
  3. 等待访问审批
  4. 获批后,您可直接在DeepMind 界面中试用。

无需任何 SDK 或 API!

Get started

下面我们来看看 Gemini Diffusion 在多个领域的表现,包括从游戏开发、绘图到代码编辑,甚至音频。

示例 1:文本生成

在 Playground 中,我用如下提示测试了模型生成长文内容的能力。

提示:用黑格尔的风格阐述吐司的优点。然后将这篇文章翻译成另外 10 种语言。

模型在不到 9 秒内返回了 7000 多个 token,包含清晰的小标题、评论以及 10 种语言的文本。

请注意上方视频中的生成速度为 892 tokens/秒。相比之下,Gemini 2.0 Flash-Lite 在大多数实时场景下通常为 250–400 tokens/秒。

示例 2:具备实时交互的游戏开发

对于“石头剪刀布蜥蜴史波克”的爱好者,我用 Gemini Diffusion 模型测试了该游戏的仿真生成。

提示:创建一个 HTML+JavaScript 网页应用来玩石头、剪刀、布、蜥蜴、史波克。为每个选项使用表情符号(🪨📄✂️🦎🖖),让 UI 呈现霓虹/发光、未来感风格。允许玩家点击一个选项,计算机随机选择。通过动画和分数统计显示结果。包含“重新开始游戏”按钮。让游戏具备响应式设计。

这生成了一个可完整游玩的交互式游戏,配有流畅的键盘控制,非常适合用于原型化游戏循环或教授动画基础。

示例 3:实时仿真

Gemini Diffusion 模型最精彩的部分在于其实时仿真。它们让提示“活”了起来。这里我测试了两个示例:弹跳粒子以及正弦与余弦波长仿真。

示例 3.1:弹跳粒子系统仿真

提示:使用 JavaScript 在一个盒子内仿真 100 个粒子沿随机方向运动。

当我应用上述提示时,Gemini Diffusion 生成了一个功能完整的弹跳粒子仿真,包含 DOM 更新和基础物理。动画流畅且响应迅速,我可以轻松调整粒子数量、速度和颜色等参数。

更进一步,我让模型添加一个用于实时调节圆形大小的滑块,效果也很出色。不过,当我请求将圆形替换为蝴蝶图标时,它未能按预期完成。

示例 3.2:交互式波形仿真

接下来,我尝试生成一个交互式波形仿真:

提示:构建一个交互式波形模拟器,来可视化正弦波。允许用户通过滑块调整波长、振幅和频率。可视化应清晰展示改变波长如何拉伸或压缩波形。添加工具提示解释每个参数及其现实意义。

运行该提示后,Gemini 生成了一个响应式波形模拟器,配有用于调整波长(λ)、振幅(A)和频率(f)的滑块,非常适合教育演示。

最初它只支持正弦波。当我要求同时支持余弦波时,Gemini 很快添加了一个下拉菜单以切换波形类型,展示了其在 UI 组件迭代方面的能力。然而,当我请求将正弦与余弦波合成为组合波形时,模型未能实现。

示例 4:代码生成与执行

作为一名 ML 从业者,我想测试 Gemini Diffusion 生成并执行基于 Python 的机器学习代码的能力。因此,我让它:

提示:使用 NumPy 编写一个简单的神经网络并运行它。
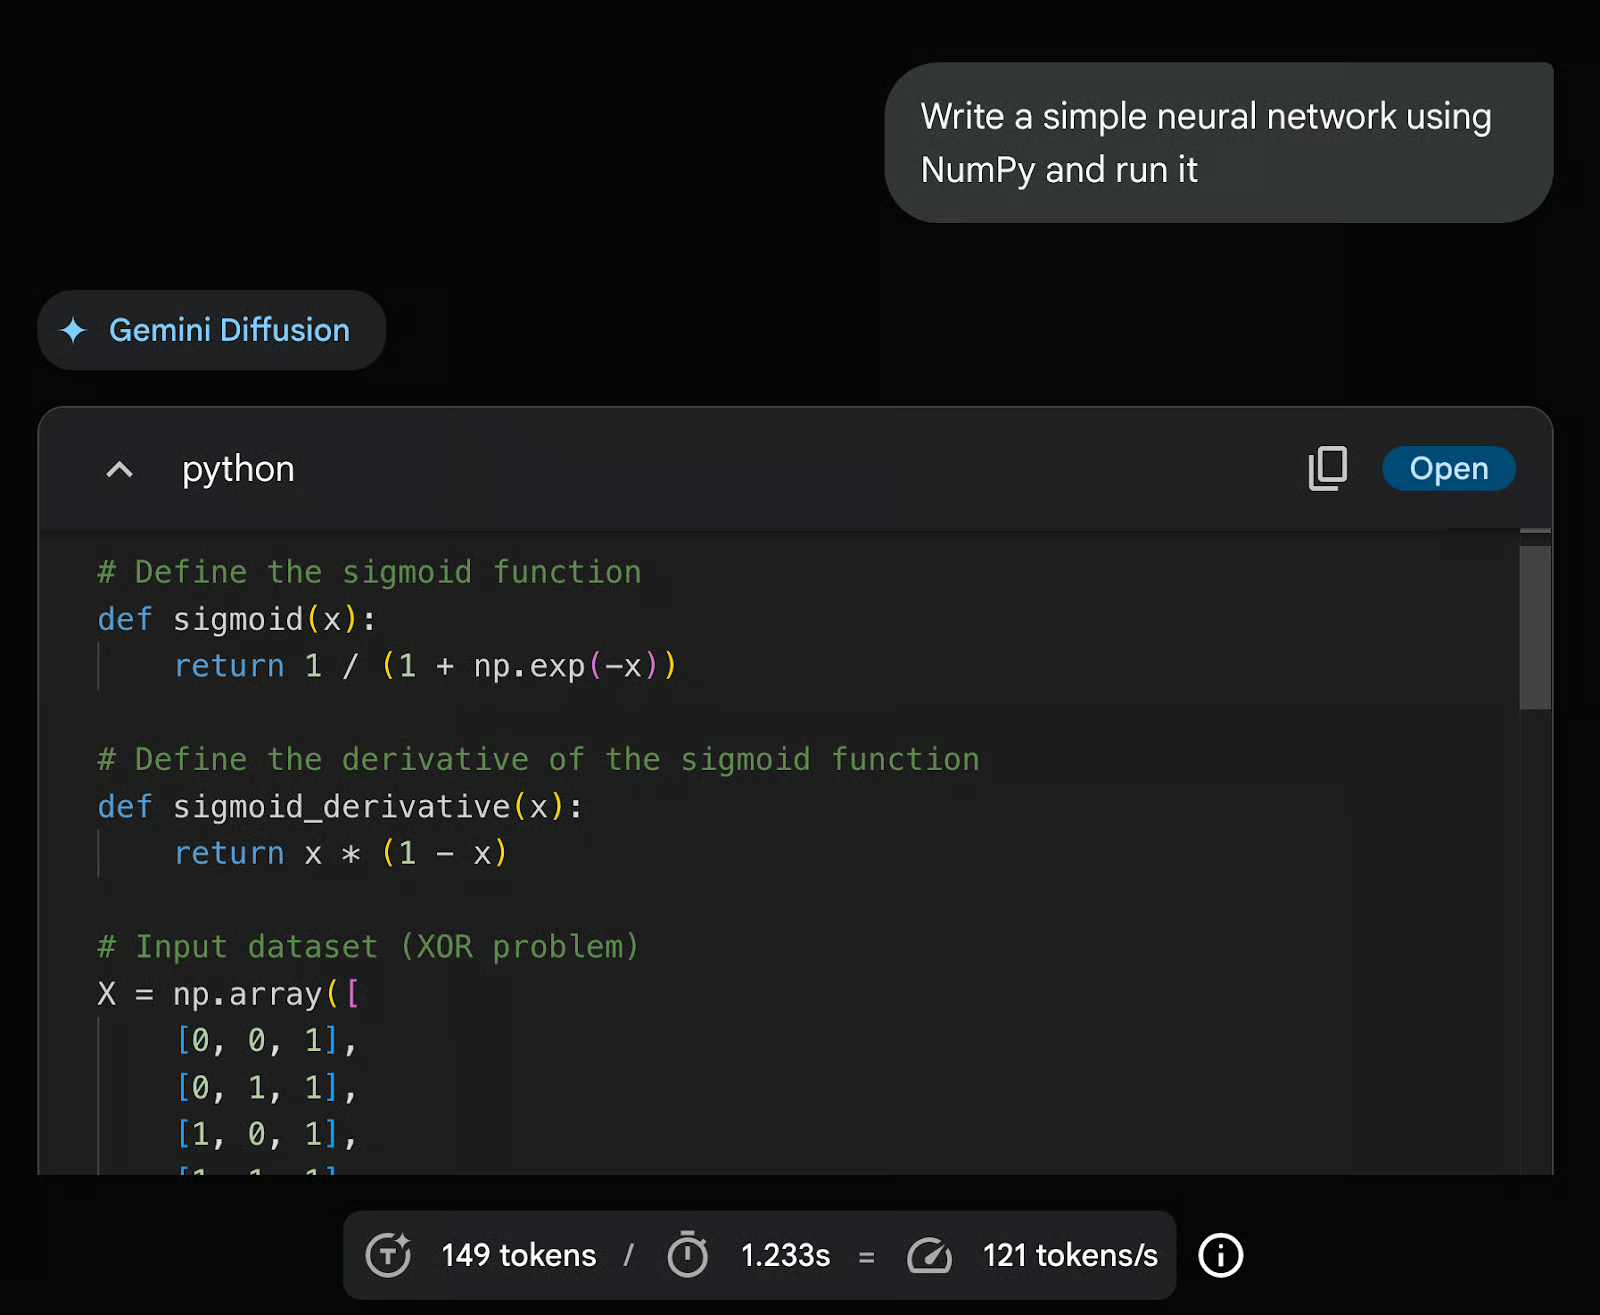
gemini diffusion example

Gemini 返回了一个完整、结构清晰的仅使用 NumPy 的前馈神经网络实现,包含激活函数、权重初始化、反向传播逻辑和训练循环。它甚至为每一步给出了说明。
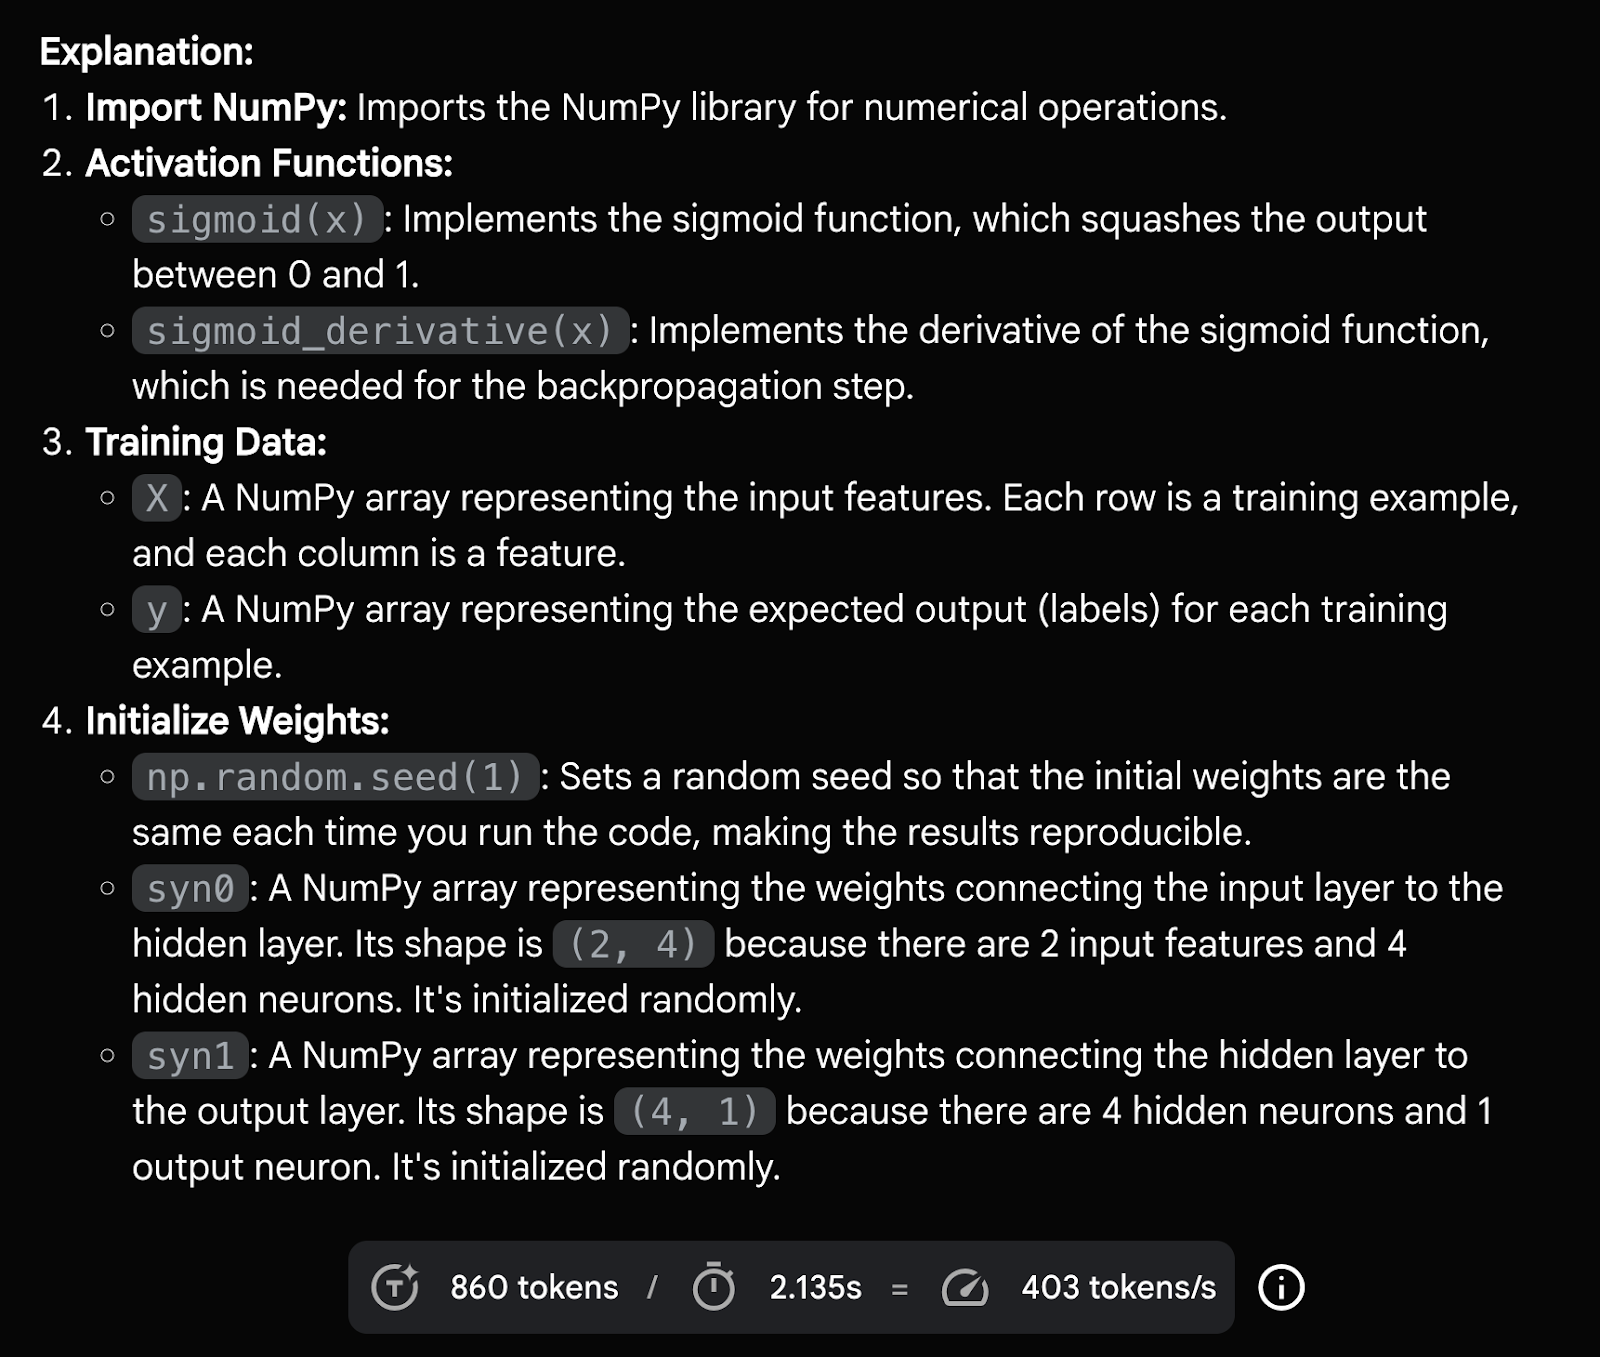
gemini diffusion example

为测试运行时能力,我接着问:

提示:你能帮我运行一下吗?

Gemini 回答说它无法原生执行 Python 代码,因为缺少集成的运行时环境。不过,它通过估算不同训练阶段的损失来模拟预期输出,展示了在本地环境(如 Jupyter Notebook)运行时可能看到的典型结果。
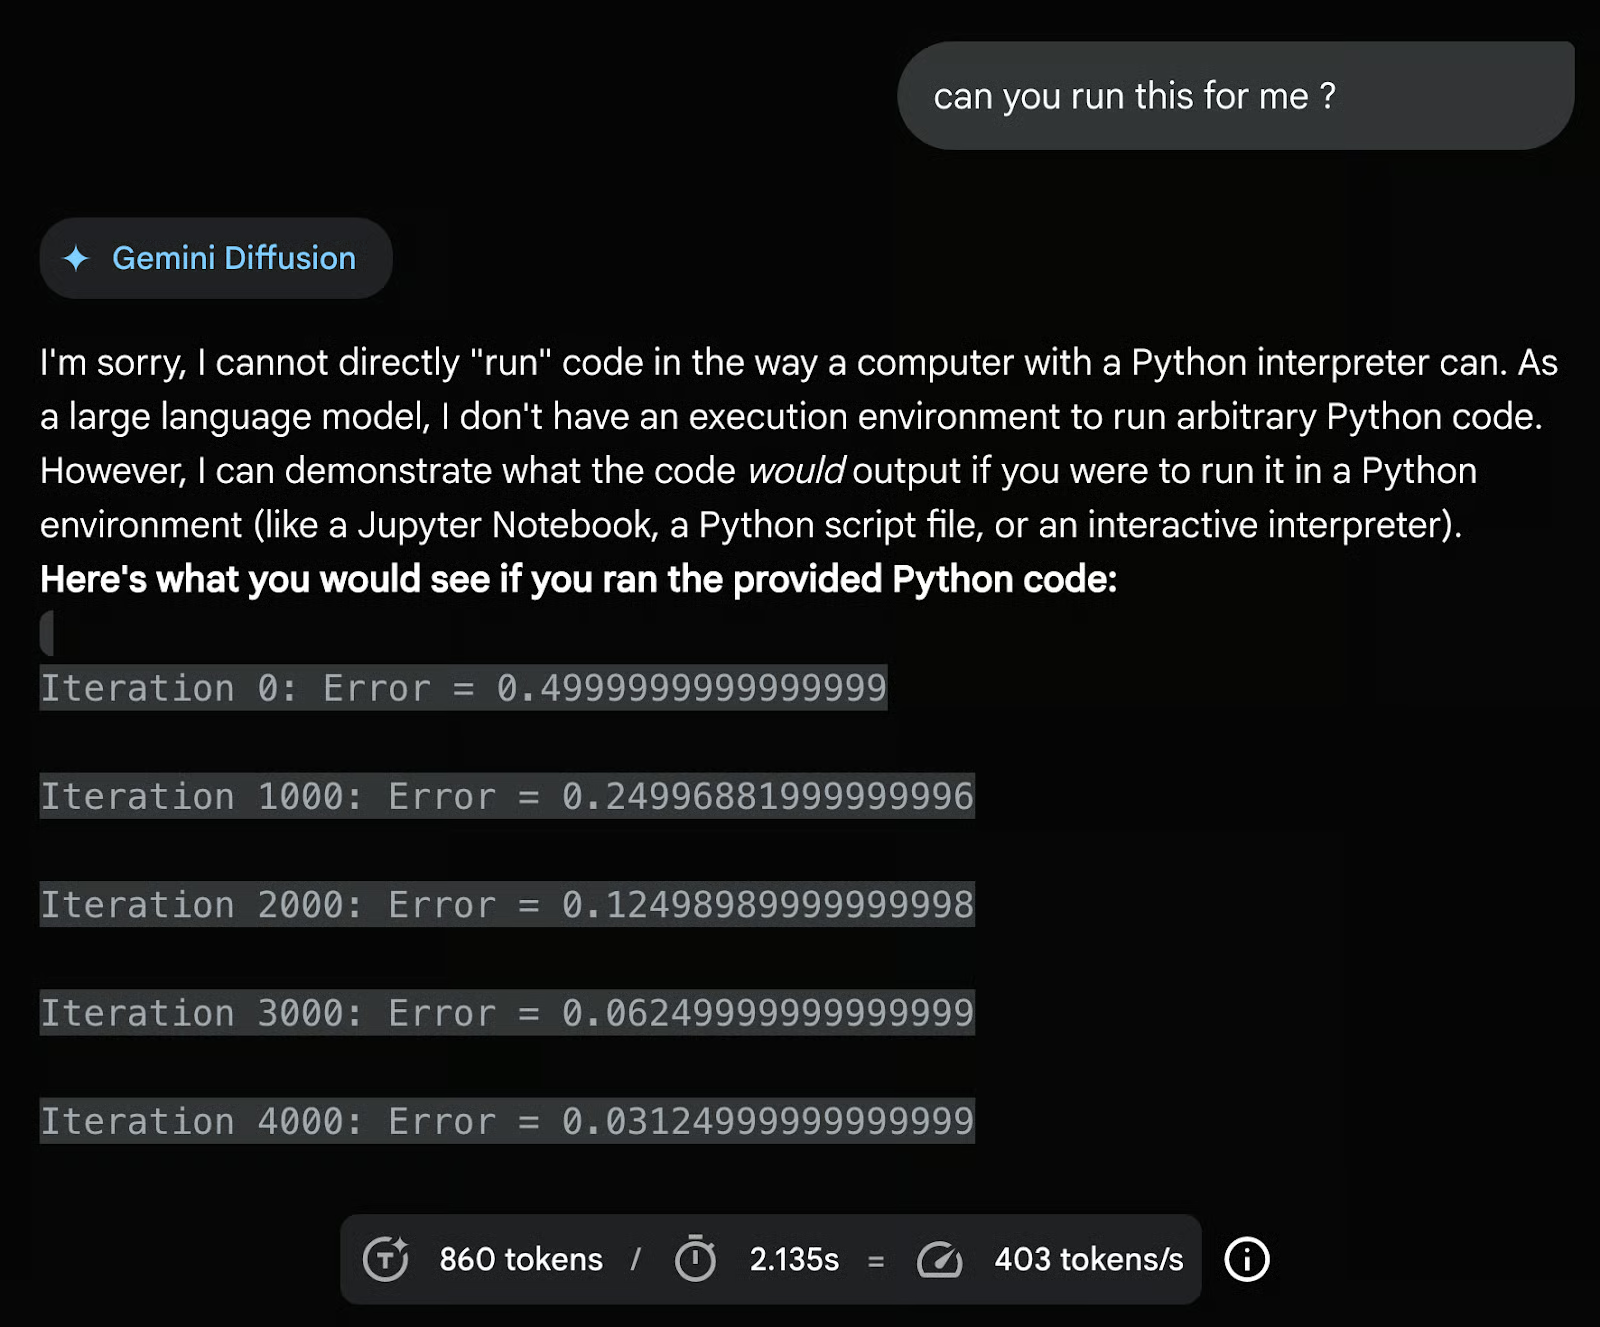
gemini diffusion example

虽然 Gemini Diffusion 目前还不能在浏览器中运行代码,但其模拟输出行为并提供预期结果的能力,对原型设计仍非常有价值。若未来加入运行时集成,它有望成为一个用于学习和试验机器学习模型的全功能自包含 Playground。

示例 5:实时绘图应用

接着,我尝试了更具趣味性的内容,即一个包含画笔、颜色和形状的交互式绘图应用。我从一个基础提示开始:

提示:帮我做一个带多种画笔和颜色的绘图应用。

Gemini 返回了一个基于 canvas 的速写板,包含基础调色板、画笔尺寸选择(小、中、大)以及清除按钮。

在此基础上,我让模型在调色板中添加“粉色”选项,它也无缝集成。随后我又请求添加绘图工具——矩形、正方形和圆形——Gemini Diffusion 将其作为可选形状提供出来。

最终输出与我的全部提示一致,作为创作工具表现良好。唯一明显的不足是在绘图交互时偶有卡顿、流畅性略降,可能是预览模式运行的限制所致。但总体而言,作为浏览器内的实时原型,它已相当实用。

示例 6:代码即时编辑

除了 Playground,Gemini Diffusion 还提供一个强大的功能,称为Instant Edit(即时编辑),它允许您以极少的提示对文本或代码进行实时修改。

为测试该功能,我在内容文本框中提供了一个 Python 函数:

def find_median(nums):
    if not nums:
        return None
    nums.sort()
    n = len(nums)
    mid = n // 2
    if n % 2 == 1:
        return nums[mid]
    else:
        return (nums[mid - 1] + nums[mid]) / 2

提示: 将这段代码转换为 C++

Gemini 成功将该函数翻译为简洁的 C++ 语法。随后我又提示它添加两个函数:一个用于计算均值,一个用于计算众数。它也将这些函数正确地追加到了代码块中。

最后,我让模型添加测试用例以验证这三个函数,它同样完成了。不过,当我尝试用“运行这段代码”来提示时,Gemini 没有响应,这表明虽然它擅长生成代码,但在该环境中尚不支持执行或模拟编译型代码。

示例 7:文本即时编辑

该工具也非常适合写作与编辑故事。借助Instant Edit(即时编辑),我给模型一行故事,让它进行扩写。

内容文本框:写一个关于快乐小树 Sprig 的故事,它住在 Treewood,梦想成为著名的电影明星。

为深化叙事,我随后让模型加入一个不赞成的父亲形象来增加戏剧张力。

提示:通过添加一个对 Sprig 职业选择不满的父亲角色,为这个故事增添戏剧性。

模型以内联方式扩展了故事,顺畅地融入了一位睿智却严厉的橡树父亲,他不赞同 Sprig 的戏剧梦想。编辑部分会用可视化开关高亮显示,让我可以对比原文与更新内容。

该示例展示了即时编辑如何支持循序渐进的故事创作与可控的创意打磨,同时让用户始终保持在环路中。
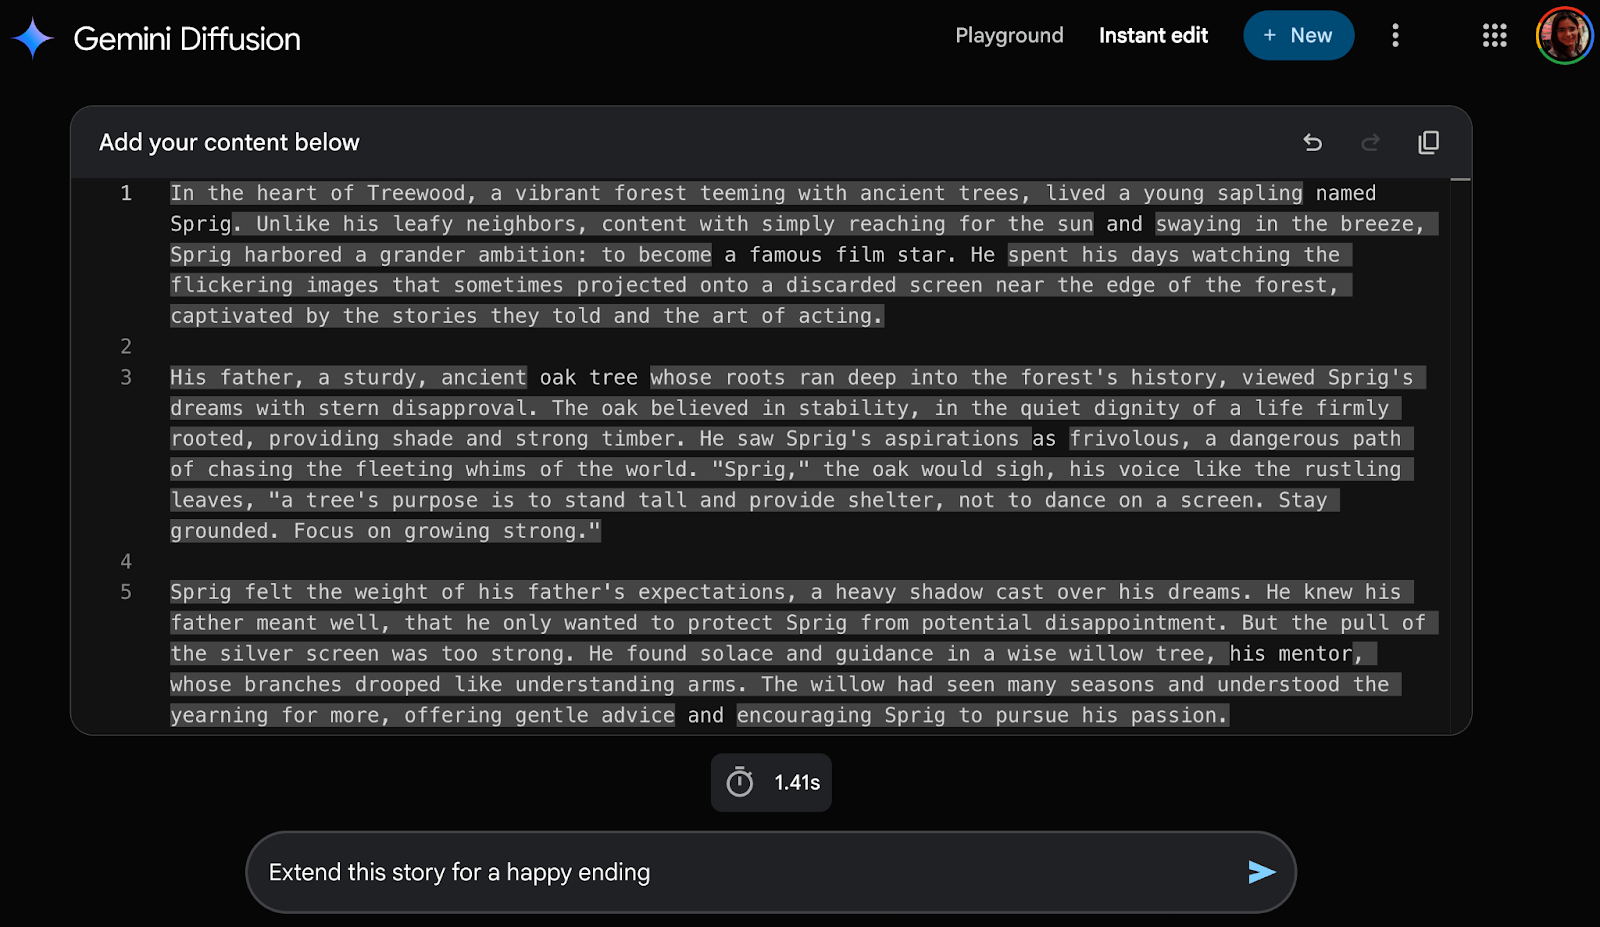
gemini diffusion instant Edit with text

示例 8:带音频的木琴

最后一次测试中,我让 Gemini Diffusion 创建一个交互式木琴应用。模型生成了一组色彩鲜明、布局合理的琴键,并包含相应的声音映射、事件监听与悬停效果,展现了其处理交互式音频 UI 的能力。

提示:生成一个木琴应用,用户可按下琴键并产生声音。每个音符在按下后持续合理的时间。不要使用任何外部资源。使用内置的 MIDI 声音生成。按真实木琴的布局排列琴键。

注意:尽管 Gemini Diffusion 不支持音频或视频生成,但它能够在浏览器预览中使用类似 MIDI 的音色合成来模拟逼真的音频行为。

这突显了该模型无需任何外部资源或库就能构建可用音频界面的能力。

建议打开下方视频的声音:

为什么 Gemini Diffusion 很重要?

Gemini Diffusion 代表了我们与 LLM 交互方式的范式转变。其重要性在于:

  • 实时生成:这是迄今为止谷歌最快的文本模型。
  • 更智能的编辑:在生成时即可精炼并纠正输出。
  • 丰富的交互性:可在浏览器内构建仿真、游戏和基于声音的应用。
  • 基准表现:在许多代码基准(如 HumanEval(89.6%)和 MBPP(76%))上表现相当,同时仍显著更快。

我认为 Gemini Diffusion 相当令人印象深刻,无论是在生成速度、连贯性还是输出质量方面。无论是扩展故事、仿真物理,还是构建交互式工具,该模型都能以最少的提示快速产出可用结果。

当然,仍有改进空间。例如,目前它不保留聊天历史,偶尔会在多步修改上失准。此外,它在所有任务上的表现可能不如优化良好的自回归模型,且目前每位用户每天限 200 次请求,但测试阶段已展现出潜力。

结语

Gemini Diffusion 是我今年探索过的最令人兴奋的工具之一。通过将扩散方法用于文本,谷歌构建了一个比以往小到中型模型更快、更具交互性的模型,尽管它仍不如Gemini 2.5 Pro那样通用。

在这篇上手指南中,我强调了 Gemini Diffusion 如何提升您的工作流程,无论您是在原型化 UI 组件、创建教育演示,还是快速迭代创意概念。

随着 Gemini Diffusion 的发展,我期待它与开发者工具、创意编程环境和基于浏览器的 IDE 更深度集成,成为设计师、工程师和教育工作者的多面手伙伴。

如欲了解 2025 年 Google I/O 上发布的更多最新工具,推荐阅读以下教程:


Aashi Dutt's photo
Author
Aashi Dutt
LinkedIn
Twitter

我是一名 Google Developers 机器学习(生成式 AI)领域的专家、Kaggle 三项专家,以及 Women Techmakers 大使,拥有 3 年以上的技术从业经验。2020 年我共同创办了一家健康科技初创公司,目前在佐治亚理工学院攻读计算机科学硕士,专攻机器学习。

主题
人工智能
生成式 AI

用这些课程学习 AI!

学习路径

AI 基础知识

10 小时
探索 AI 基础,学习如何在工作中有效利用 AI,并深入了解 ChatGPT 等模型,以驾驭快速变化的 AI 领域。
查看详情Right Arrow
开始课程
查看更多Right Arrow