Tutorial API GPT-Realtime-2: Tiga Uji, Tiga Putusan
Pelajari perbedaan gpt-realtime-2, gpt-realtime-translate, dan gpt-realtime-whisper dari OpenAI, lalu uji masing-masing dengan kode Python WebSocket yang berfungsi.
Artikel ikhtisar kami tentang GPT-Realtime-2 membahas peluncuran, klaim tolok ukur, dan mengapa OpenAI memisahkan suara realtime ke dalam keluarga model kecil. Tutorial ini dimulai dari titik artikel tersebut berhenti: menyambungkan ke API, mengirim audio, dan melihat apa yang berubah di kode.
Pemisahan itu penting dalam praktik. Uji 1 menggunakangpt-realtime-whisper untuk transkripsi, Uji 2 menggunakangpt-realtime-translateuntuk terjemahan langsung, dan Uji 3 menggunakan gpt-realtime-2untuk asisten suara. Model utama juga berfungsi untuk tugas yang lebih sederhana seperti terjemahan atau transkripsi, tetapi Anda akan membayar untuk tingkat penalaran dan mode respons yang tidak diperlukan, jadi itu berlebihan.
Menyiapkan API GPT-Realtime-2 di Python
Sebelum pengujian, ada baiknya memisahkan transport, autentikasi, dan format audio. Detail tersebut sebagian besar tetap sama di seluruh contoh. Endpoint model dan nama event adalah yang berubah saat artikel bergerak dari keluaran teks ke ucapan terjemahan dan kemudian ke loop suara penuh.
Memilih antara WebRTC dan WebSocket
Dokumentasi OpenAI memberikan aturan sederhana: gunakan WebRTC untuk klien browser dan seluler, dan gunakan WebSocket untuk aplikasi sisi server. WebRTC menangani jitter buffering dan transport audio. WebSocket masuk akal ketika backend sudah menerima audio mentah dari penyedia teleponi atau pipeline media.
Dua jalur transport untuk Realtime API. Gambar oleh Penulis.
Karena alasan itu, ketiga uji Python menggunakan WebSocket. Jalur ini menampilkan nama event secara langsung, sehingga perbedaan model terlihat di kode. Untuk build browser, gunakan secret klien sementara agar kunci API Anda tidak pernah mencapai frontend.
Lingkungan dan paket Python
Gunakan Python 3.9 atau lebih baru. Kode lengkap untuk keempat skrip tersedia di github.com/KhalidAbdelaty/gpt-realtime-api. Clone terlebih dahulu, lalu instal dependensinya:
git clone https://github.com/KhalidAbdelaty/gpt-realtime-api.git
cd gpt-realtime-api
pip install websocket-client sounddevice numpy python-dotenvDidukung oleh
websocket-clientmenangani socket. sounddevicemenangkap audio mikrofon, numpymengonversi buffer, danpython-dotenv memuat kunci API. Di macOS, Anda mungkin perlu brew install portaudio sebelum sounddevice berfungsi. Di Linux, instal portaudio19-dev.
import os
from dotenv import load_dotenv

load_dotenv()
OPENAI_API_KEY = os.environ.get("OPENAI_API_KEY")Didukung oleh
Autentikasi dan URL WebSocket
Koneksi sisi server menggunakan header Authorization: Bearer pada handshake WebSocket. TambahkanOpenAI-Safety-Identifierjika aplikasi melacak pengguna individual. Ini adalah jalur yang digunakan nanti di pengujian:
# Voice agent
wss://api.openai.com/v1/realtime?model=gpt-realtime-2# Translation
wss://api.openai.com/v1/realtime/translations?model=gpt-realtime-translate
# Transcription
wss://api.openai.com/v1/realtime?intent=transcriptionDidukung oleh
Jalur terjemahan itu penting nanti di Uji 2, karena itu satu-satunya endpoint yang tidak menggunakan /v1/realtime secara langsung.
Uji 1: Transkripsi Audio Real-Time dengan GPT-Realtime-Whisper
Transkripsi adalah area yang sering dibangun berlebihan. Jika keluarannya hanya teks, model transkripsi sudah cukup.
Apa yang diuji
gpt-realtime-whisper menerima audio dan mengeluarkan delta transkrip. Ia tidak melakukan penalaran, memanggil tool, atau berbicara kembali. Pekerjaan yang lebih kecil itulah mengapa biayanya dihitung berdasarkan durasi audio, bukan model token yang sama seperti gpt-realtime-2. Bagian biaya akan kembali ke tarif tersebut.
Penelusuran kode
Field kuncinya adalahsession.type: "transcription". Itu memberi tahu API untuk melewati respons asisten dan hanya mengeluarkan event transkrip. Skrip lengkap juga menangani penangkapan mikrofon dan threading. Ini bagian yang mengubah perilaku sesi Realtime:
session_config ={"type":"session.update","session":{"type":"transcription","audio":{"input":{"format":{"type":"audio/pcm","rate":24000},"transcription":{"model":"gpt-realtime-whisper","language":"en"},"turn_detection":None}}}}
ws.send(json.dumps(session_config))
ws.send(json.dumps({"type":"input_audio_buffer.append","audio": audio_b64
}))
ws.send(json.dumps({"type":"input_audio_buffer.commit"}))Didukung oleh
Gunakan audio PCM16 mono 24 kHz, dikodekan sebagai base64. Tidak seperti sesi agen suara, skrip melakukan commit input buffer secara manual menggunakan timer alih-alih deteksi giliran server_vad. Commit kosong memunculkan input_audio_buffer_commit_empty, itulah sebabnya skrip lengkap hanya melakukan commit setelah audio nyata dikirim.
Delta transkrip tiba kata demi kata secara real-time. Gambar oleh Penulis.
Perilaku yang diamati
Dalam pengujian lokal saya, hasil transkrip muncul dalam jendela commit, kira-kira 3 hingga 4 detik setelah ucapan dimulai. Karena setelan ini mengandalkan commit manual alih-alih VAD, latensi terkait dengan interval commit.
Perhatikan juga pengurutan: event penyelesaian dari giliran yang tumpang tindih dapat tiba tidak berurutan, jadi rekonsiliasi berdasarkan item_id jika Anda membangun UI di sekitar stream.
Transkripsi dipicu oleh commit manual berkala, bukan oleh deteksi keheningan. Gambar oleh Penulis.
Putusan: Lulus. Untuk transkripsi langsung sisi server, gpt-realtime-whisper melakukan apa yang dibutuhkan uji ini. Saya tetap akan menguji dengan mikrofon nyata, aksen, dan kebisingan ruangan sebelum menetapkan target latensi.
Uji 2: Terjemahan Real-Time dengan GPT-Realtime-Translate
Terjemahan ucapan langsung sekilas terlihat mirip dengan transkripsi, tetapi siklus hidup sesi berbeda. Endpoint terjemahan menghapus loop respons asisten, yang membuat contoh lebih pendek.
Apa yang diuji
Sesi terjemahan tidak memiliki loop giliran asisten dan tidak ada response.create. Model bekerja sebagai juru bahasa langsung, bukan agen percakapan. Untuk tanya jawab, tool, atau status percakapan, artikel beralih ke gpt-realtime-2 di Uji 3.
Sesi terjemahan menggunakan endpoint khusus yang terpisah. Gambar oleh Penulis.
Model mendukung lebih dari 70 bahasa input dan 13 bahasa output. Anda menetapkan target dengan session.audio.output.language; deteksi bahasa sumber bersifat otomatis. Batasannya jelas: tidak ada prompt kustom, tidak ada pemilihan suara, dan tidak ada glosarium domain.
Penelusuran kode
Seperti disebutkan sebelumnya, terjemahan menggunakan URL WebSocket /translations. Dua detail lain juga berubah: field target session.audio.output.language dan nama event session.input_audio_buffer.append. Perhatikan prefiks session.. Sesi terjemahan menggunakannya di sini.
url ="wss://api.openai.com/v1/realtime/translations?model=gpt-realtime-translate"
session_config ={"type":"session.update","session":{"audio":{"output":{"language":"es"},"input":{"transcription":{"model":"gpt-realtime-whisper"},"noise_reduction":{"type":"near_field"}}}}}
ws.send(json.dumps(session_config))
ws.send(json.dumps({"type":"session.input_audio_buffer.append","audio": audio_b64
}))Didukung oleh
Audio terjemahan datang pada session.output_audio.delta, dan byte audio ada di event["delta"], bukan event["audio"]. Transkrip sumber dan terjemahan tiba secara terpisah:
if event_type =="session.output_audio.delta":
audio_out_queue.put(base64.b64decode(event["delta"]))elif event_type =="session.input_transcript.delta":print("[EN]", event.get("delta",""), end="")elif event_type =="session.output_transcript.delta":print("[ES]", event.get("delta",""), end="")Didukung oleh
Satu kasus tepi: jika audio sumber sudah dalam bahasa target, model dapat menghasilkan keheningan alih-alih meneruskannya.
Perilaku yang diamati
Untuk frasa pendek Inggris-ke-Spanyol, audio terjemahan dimulai sebelum ujaran sumber selesai. Terminal menampilkan baris [EN] dan [ES] yang saling bertumpuk saat delta mengalir. Pasangan bahasa yang lebih jauh dapat menunggu lebih lama untuk konteks. Saya bisa mengikuti suara terjemahan tanpa masalah, tetapi pemilihan suara kustom tidak tersedia.
Putusan: Lulus, dengan catatan.gpt-realtime-translate berfungsi untuk terjemahan langsung. Ini kurang berguna ketika kontrol terminologi atau branding suara penting.
Uji 3: Membangun Asisten Suara dengan Gilir Peran dan Barge-In
Ini adalah uji gpt-realtime-2: agen suara yang mendengarkan, berbicara, menjaga konteks, dan dapat memanggil tool. Ini juga titik di mana kode klien mulai lebih penting, karena pemutaran dan status giliran bisa tidak sinkron.
Apa yang diuji
gpt-realtime-2 adalah model penalaran speech-to-speech. Ia menghindari pipeline terpisah STT-ke-LLM-ke-TTS, dan jendela konteks 128K memberi lebih banyak ruang untuk sesi panjang. Penalaran dikendalikan dengan reasoning.effort; mulai dari low kecuali tugas membutuhkan lebih banyak penalaran, karena setelan lebih tinggi menambah latensi.
Penelusuran kode
Setelan di bawah menggunakan semantic_vad, yang melihat isyarat ujaran alih-alih keheningan saja. eagerness mengontrol seberapa cepat model memutuskan pengguna sudah selesai. Bagian yang perlu diperhatikan adalah nama model, setelan keluaran audio, response.create manual, dan nama event audio asisten:
session_config ={"type":"session.update","session":{"type":"realtime","model":"gpt-realtime-2","output_modalities":["audio"],"audio":{"input":{"format":{"type":"audio/pcm","rate":24000},"transcription":{"model":"gpt-realtime-whisper","language":"en"},"turn_detection":{"type":"semantic_vad","eagerness":"medium","create_response":False,"interrupt_response":True}},"output":{"format":{"type":"audio/pcm","rate":24000},"voice":"marin"}},"instructions":"You are a helpful voice assistant. Keep answers short.","reasoning":{"effort":"low"}}}Didukung oleh
Saat transkrip pengguna selesai, klien membuat respons asisten. Audio asisten kemudian datang sebagai response.output_audio.delta, bukan response.audio.delta.
if event_type =="conversation.item.input_audio_transcription.completed":
ws.send(json.dumps({"type":"response.create"}))elif event_type =="response.output_audio.delta":
audio_out_queue.put(base64.b64decode(event["delta"]))Didukung oleh
Menangani barge-in
Urutan interupsi mudah dilakukan salah. Saat pengguna berbicara menimpa asisten, server mengirim input_audio_buffer.speech_started. Klien menghentikan pemutaran, mencatat berapa banyak audio yang sudah diputar, dan mengirim conversation.item.truncate dengan audio_end_ms untuk melacak di mana audio dipotong. Jika tidak, server akan terus mentranskripsikan teks yang tidak pernah didengar pengguna, dan giliran berikutnya bisa terasa janggal.
if current_response_item_id and playback_position_ms >0:
ws.send(json.dumps({"type":"conversation.item.truncate","item_id": current_response_item_id,"content_index":0,"audio_end_ms": playback_position_ms
}))Didukung oleh
Satu masalah praktis dengan speaker laptop: mikrofon dapat menangkap keluaran audio asisten dan mengirimkannya kembali ke model. Skrip contoh menggunakan MUTE_MIC_DURING_ASSISTANT = True untuk membisukan aliran input saat asisten berbicara dan selama jeda singkat setelahnya. Setel ke False hanya jika Anda menggunakan headphone dan ingin dukungan interupsi.
Truncation membuat server dan klien tetap sinkron. Gambar oleh Penulis.
WebRTC dan SIP menangani lebih banyak buffering ini. Dengan jalur WebSocket yang digunakan di tutorial ini, klien yang menanganinya. Penghitung di skrip contoh cukup untuk demo; kode produksi harus melacak stempel waktu dari aliran keluaran audio.
Mengonfigurasi preamble untuk latensi penalaran
Saat reasoning.effort di atas low, keheningan menjadi terasa. Preamble lisan yang singkat dapat ditambahkan di prompt sistem:
# Preambles
Use a short spoken update before longer tasks.
Keep preambles under five seconds.
Skip preambles for short factual questions.Didukung oleh
Perilaku ini didokumentasikan untuk gpt-realtime-2.
Perilaku yang diamati
Pergantian giliran bekerja pada setelan default di ruangan yang tenang. Dengan speaker laptop, saya perlu membisukan mikrofon; tanpa itu, model mendengar keluarannya sendiri dan memulai loop gema.
Di ruangan yang lebih bising, setelan VAD dan penempatan mikrofon lebih berpengaruh. Memori percakapan tetap konsisten selama uji sepuluh menit, tetapi saya tidak akan merilis aplikasi yang lebih panjang tanpa rencana reconnect.
Putusan: Lulus untuk loop suara inti.gpt-realtime-2 menangani asisten dengan upaya penalaran rendah dalam uji saya. Pekerjaan ekstra ada di klien: pemutaran, penanganan interupsi, reconnect, dan pemanggilan tool jika aplikasi membutuhkannya.
Demo Streamlit: Tiga Model dalam Satu Antarmuka
Aplikasi Streamlit menempatkan pengujian di balik pemilih tab. Anda bisa merekam audio, memilih bahasa target, dan membandingkan jalur model tanpa mengedit skrip. Saya menjaga ini sebagai aplikasi demo alih-alih jalur pengajaran utama, karena skrip terminal menampilkan event lebih langsung.
Tiga model dalam satu antarmuka bertab. Gambar oleh Penulis.
Video demo di bawah menunjukkan tab terhadap kunci API aktif. Setiap tab menggunakan panggilan Realtime WebSocket nyata.
Jalankan aplikasi dari folder yang sama dengan skrip:
Kunci API Anda dimasukkan di sidebar dan tidak disimpan di mana pun. Untuk aplikasi publik, taruh di Streamlit Secrets sebagai gantinya.
Biaya dan Latensi GPT-Realtime-2 dalam Praktik
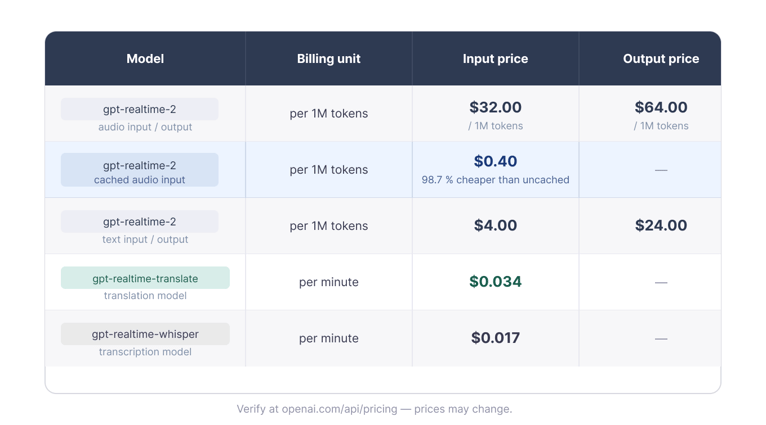
Seperti disebutkan di Uji 1, penetapan harga terbagi menjadi dua kelompok: gpt-realtime-2 ditagih berdasarkan token, sementara terjemahan dan transkripsi ditagih per menit.
Penagihan token dan menit menurut model. Gambar oleh Penulis.
Untuk transkripsi dan terjemahan, biaya meningkat sesuai durasi. Pada saat penulisan, tiga puluh menit berbiaya sekitar $0,51 pada gpt-realtime-whisper dan sekitar $1,02 pada gpt-realtime-translate.
Agen suara lebih sulit diperkirakan karena token audio terakumulasi di kedua sisi percakapan. Lama sesi, rasio berbicara, upaya penalaran, dan ukuran konteks semuanya berpengaruh. Prompt caching dapat mengurangi biaya ketika giliran percakapan sebelumnya tetap stabil.
Panggilan transkripsi REST plus TTS adalah perbandingan yang berbeda kecuali interaksi langsung diperlukan. whisper-1 lebih murah untuk berkas, tetapi itu bukan jenis API yang sama.
Batas API GPT-Realtime-2, Persyaratan Audio, dan Pemecahan Masalah
Ini adalah batas yang memengaruhi percobaan pertama saya. Sebagian besar kegagalan berasal dari format audio atau kesalahan siklus hidup sesi, bukan dari model itu sendiri.
Kendala transport dan audio
Seperti dicatat di uji pertama, audio WebSocket harus PCM16 pada 24 kHz, mono, dan dienkode base64. Setiap event input_audio_buffer.append dibatasi hingga 15 MB, jadi potongan 50 milidetik tetap jauh di bawah batas. G.711 juga didukung untuk teleponi.
Sesi Realtime berakhir setelah 60 menit di OpenAI dan 30 menit di Azure OpenAI. Aplikasi yang lebih lama memerlukan rencana reconnect dan cara membangun ulang state. Suara juga harus dipilih sebelum keluaran audio pertama; tidak bisa berganti di tengah sesi.
Batas laju dan kuota
Batas laju berbasis tier dan spesifik proyek. Tier 1 saat ini mencantumkan 200 permintaan per menit dan 40.000 token per menit untuk gpt-realtime-2. Tier Gratis tidak didukung.
Kesalahan umum dan sisi kasar
Kesalahan yang paling sering saya temui adalah commit buffer kosong dan format audio yang salah. Untuk agen suara, perhatikan juga loop umpan balik di mana mikrofon mendengar keluaran speaker asisten. Gunakan headphone, pembatalan echo, atau pembisuan mikrofon.
Untuk sesi panjang, lakukan reconnect sekitar 55 menit alih-alih menunggu kedaluwarsa. Satu kekusutan di docs: halaman model gpt-realtime-2 memiliki baris umum "Streaming: Not supported", sementara panduan Realtime mendokumentasikan penggunaan /v1/realtime. Baris itu merujuk pada streaming Chat Completions, bukan perilaku Realtime API.
Putusan Akhir
Pola yang sama muncul di ketiga uji: setiap pekerjaan memiliki model dan endpoint masing-masing. Pemisahan itu memengaruhi apa yang bisa dilakukan model, bagaimana penagihannya, dan seberapa banyak kode klien yang perlu Anda tangani.
Seperti ditunjukkan di atas, gpt-realtime-whisper mencakup teks langsung, gpt-realtime-translate mencakup terjemahan ucapan langsung, dan gpt-realtime-2 mencakup perilaku asisten dengan ucapan, penalaran, dan konteks.
Kodenya tidak menunjukkan satu model menggantikan yang lain. Kode tersebut menunjukkan bahwa aplikasi suara realtime bergantung pada desain sesi. Titik awal saya adalah model terkecil yang sesuai dengan pekerjaan, dengan sisa waktu rekayasa dihabiskan untuk kualitas audio, pergantian giliran, reconnect, dan state klien.
Untuk latar belakang lebih lanjut, tutorial kami membahas topik audio dan Realtime API terkait:
Saya seorang data engineer dan pembangun komunitas yang bekerja lintas pipeline data, cloud, dan perkakas AI sambil menulis tutorial praktis dan berdampak tinggi untuk DataCamp dan pengembang yang sedang berkembang.
Temukan alasan mengapa Anda sebaiknya (tidak) menggunakan spaghetti plot untuk menyampaikan ketidakpastian jalur prediksi badai serta dampaknya terhadap interpretasi.
Kuasai pertanyaan wawancara basis data, dari konsep SQL dasar hingga skenario desain sistem tingkat lanjut. Panduan mendalam ini mencakup semua yang Anda perlukan untuk sukses di wawancara DBMS dan meraih peran berikutnya.





Artikel ikhtisar kami tentang GPT-Realtime-2 membahas peluncuran, klaim tolok ukur, dan mengapa OpenAI memisahkan suara realtime ke dalam keluarga model kecil. Tutorial ini dimulai dari titik artikel tersebut berhenti: menyambungkan ke API, mengirim audio, dan melihat apa yang berubah di kode.
Pemisahan itu penting dalam praktik. Uji 1 menggunakan
gpt-realtime-whisperuntuk transkripsi, Uji 2 menggunakangpt-realtime-translateuntuk terjemahan langsung, dan Uji 3 menggunakangpt-realtime-2untuk asisten suara. Model utama juga berfungsi untuk tugas yang lebih sederhana seperti terjemahan atau transkripsi, tetapi Anda akan membayar untuk tingkat penalaran dan mode respons yang tidak diperlukan, jadi itu berlebihan.Menyiapkan API GPT-Realtime-2 di Python
Sebelum pengujian, ada baiknya memisahkan transport, autentikasi, dan format audio. Detail tersebut sebagian besar tetap sama di seluruh contoh. Endpoint model dan nama event adalah yang berubah saat artikel bergerak dari keluaran teks ke ucapan terjemahan dan kemudian ke loop suara penuh.
Memilih antara WebRTC dan WebSocket
Dokumentasi OpenAI memberikan aturan sederhana: gunakan WebRTC untuk klien browser dan seluler, dan gunakan WebSocket untuk aplikasi sisi server. WebRTC menangani jitter buffering dan transport audio. WebSocket masuk akal ketika backend sudah menerima audio mentah dari penyedia teleponi atau pipeline media.
Dua jalur transport untuk Realtime API. Gambar oleh Penulis.
Karena alasan itu, ketiga uji Python menggunakan WebSocket. Jalur ini menampilkan nama event secara langsung, sehingga perbedaan model terlihat di kode. Untuk build browser, gunakan secret klien sementara agar kunci API Anda tidak pernah mencapai frontend.
Lingkungan dan paket Python
Gunakan Python 3.9 atau lebih baru. Kode lengkap untuk keempat skrip tersedia di github.com/KhalidAbdelaty/gpt-realtime-api. Clone terlebih dahulu, lalu instal dependensinya:
websocket-clientmenangani socket.sounddevicemenangkap audio mikrofon,numpymengonversi buffer, danpython-dotenvmemuat kunci API. Di macOS, Anda mungkin perlubrew install portaudiosebelumsounddeviceberfungsi. Di Linux, instalportaudio19-dev.Buat berkas
.envdi root proyek Anda:Lalu muat di setiap skrip:
Autentikasi dan URL WebSocket
Koneksi sisi server menggunakan header
Authorization: Bearerpada handshake WebSocket. TambahkanOpenAI-Safety-Identifierjika aplikasi melacak pengguna individual. Ini adalah jalur yang digunakan nanti di pengujian:Jalur terjemahan itu penting nanti di Uji 2, karena itu satu-satunya endpoint yang tidak menggunakan
/v1/realtimesecara langsung.Uji 1: Transkripsi Audio Real-Time dengan GPT-Realtime-Whisper
Transkripsi adalah area yang sering dibangun berlebihan. Jika keluarannya hanya teks, model transkripsi sudah cukup.
Apa yang diuji
gpt-realtime-whispermenerima audio dan mengeluarkan delta transkrip. Ia tidak melakukan penalaran, memanggil tool, atau berbicara kembali. Pekerjaan yang lebih kecil itulah mengapa biayanya dihitung berdasarkan durasi audio, bukan model token yang sama sepertigpt-realtime-2. Bagian biaya akan kembali ke tarif tersebut.Penelusuran kode
Field kuncinya adalah
session.type: "transcription". Itu memberi tahu API untuk melewati respons asisten dan hanya mengeluarkan event transkrip. Skrip lengkap juga menangani penangkapan mikrofon dan threading. Ini bagian yang mengubah perilaku sesi Realtime:Gunakan audio PCM16 mono 24 kHz, dikodekan sebagai base64. Tidak seperti sesi agen suara, skrip melakukan commit input buffer secara manual menggunakan timer alih-alih deteksi giliran
server_vad. Commit kosong memunculkaninput_audio_buffer_commit_empty, itulah sebabnya skrip lengkap hanya melakukan commit setelah audio nyata dikirim.Delta transkrip tiba kata demi kata secara real-time. Gambar oleh Penulis.
Perilaku yang diamati
Dalam pengujian lokal saya, hasil transkrip muncul dalam jendela commit, kira-kira 3 hingga 4 detik setelah ucapan dimulai. Karena setelan ini mengandalkan commit manual alih-alih VAD, latensi terkait dengan interval commit.
Perhatikan juga pengurutan: event penyelesaian dari giliran yang tumpang tindih dapat tiba tidak berurutan, jadi rekonsiliasi berdasarkan
item_idjika Anda membangun UI di sekitar stream.Transkripsi dipicu oleh commit manual berkala, bukan oleh deteksi keheningan. Gambar oleh Penulis.
Putusan: Lulus. Untuk transkripsi langsung sisi server,
gpt-realtime-whispermelakukan apa yang dibutuhkan uji ini. Saya tetap akan menguji dengan mikrofon nyata, aksen, dan kebisingan ruangan sebelum menetapkan target latensi.Uji 2: Terjemahan Real-Time dengan GPT-Realtime-Translate
Terjemahan ucapan langsung sekilas terlihat mirip dengan transkripsi, tetapi siklus hidup sesi berbeda. Endpoint terjemahan menghapus loop respons asisten, yang membuat contoh lebih pendek.
Apa yang diuji
Sesi terjemahan tidak memiliki loop giliran asisten dan tidak ada
response.create. Model bekerja sebagai juru bahasa langsung, bukan agen percakapan. Untuk tanya jawab, tool, atau status percakapan, artikel beralih kegpt-realtime-2di Uji 3.Sesi terjemahan menggunakan endpoint khusus yang terpisah. Gambar oleh Penulis.
Model mendukung lebih dari 70 bahasa input dan 13 bahasa output. Anda menetapkan target dengan
session.audio.output.language; deteksi bahasa sumber bersifat otomatis. Batasannya jelas: tidak ada prompt kustom, tidak ada pemilihan suara, dan tidak ada glosarium domain.Penelusuran kode
Seperti disebutkan sebelumnya, terjemahan menggunakan URL WebSocket
/translations. Dua detail lain juga berubah: field targetsession.audio.output.languagedan nama eventsession.input_audio_buffer.append. Perhatikan prefikssession.. Sesi terjemahan menggunakannya di sini.Audio terjemahan datang pada
session.output_audio.delta, dan byte audio ada dievent["delta"], bukanevent["audio"]. Transkrip sumber dan terjemahan tiba secara terpisah:Satu kasus tepi: jika audio sumber sudah dalam bahasa target, model dapat menghasilkan keheningan alih-alih meneruskannya.
Perilaku yang diamati
Untuk frasa pendek Inggris-ke-Spanyol, audio terjemahan dimulai sebelum ujaran sumber selesai. Terminal menampilkan baris
[EN]dan[ES]yang saling bertumpuk saat delta mengalir. Pasangan bahasa yang lebih jauh dapat menunggu lebih lama untuk konteks. Saya bisa mengikuti suara terjemahan tanpa masalah, tetapi pemilihan suara kustom tidak tersedia.Putusan: Lulus, dengan catatan.
gpt-realtime-translateberfungsi untuk terjemahan langsung. Ini kurang berguna ketika kontrol terminologi atau branding suara penting.Uji 3: Membangun Asisten Suara dengan Gilir Peran dan Barge-In
Ini adalah uji
gpt-realtime-2: agen suara yang mendengarkan, berbicara, menjaga konteks, dan dapat memanggil tool. Ini juga titik di mana kode klien mulai lebih penting, karena pemutaran dan status giliran bisa tidak sinkron.Apa yang diuji
gpt-realtime-2adalah model penalaran speech-to-speech. Ia menghindari pipeline terpisah STT-ke-LLM-ke-TTS, dan jendela konteks 128K memberi lebih banyak ruang untuk sesi panjang. Penalaran dikendalikan denganreasoning.effort; mulai darilowkecuali tugas membutuhkan lebih banyak penalaran, karena setelan lebih tinggi menambah latensi.Penelusuran kode
Setelan di bawah menggunakan
semantic_vad, yang melihat isyarat ujaran alih-alih keheningan saja.eagernessmengontrol seberapa cepat model memutuskan pengguna sudah selesai. Bagian yang perlu diperhatikan adalah nama model, setelan keluaran audio,response.createmanual, dan nama event audio asisten:Saat transkrip pengguna selesai, klien membuat respons asisten. Audio asisten kemudian datang sebagai
response.output_audio.delta, bukanresponse.audio.delta.Menangani barge-in
Urutan interupsi mudah dilakukan salah. Saat pengguna berbicara menimpa asisten, server mengirim
input_audio_buffer.speech_started. Klien menghentikan pemutaran, mencatat berapa banyak audio yang sudah diputar, dan mengirimconversation.item.truncatedenganaudio_end_msuntuk melacak di mana audio dipotong. Jika tidak, server akan terus mentranskripsikan teks yang tidak pernah didengar pengguna, dan giliran berikutnya bisa terasa janggal.Satu masalah praktis dengan speaker laptop: mikrofon dapat menangkap keluaran audio asisten dan mengirimkannya kembali ke model. Skrip contoh menggunakan
MUTE_MIC_DURING_ASSISTANT = Trueuntuk membisukan aliran input saat asisten berbicara dan selama jeda singkat setelahnya. Setel keFalsehanya jika Anda menggunakan headphone dan ingin dukungan interupsi.Truncation membuat server dan klien tetap sinkron. Gambar oleh Penulis.
WebRTC dan SIP menangani lebih banyak buffering ini. Dengan jalur WebSocket yang digunakan di tutorial ini, klien yang menanganinya. Penghitung di skrip contoh cukup untuk demo; kode produksi harus melacak stempel waktu dari aliran keluaran audio.
Mengonfigurasi preamble untuk latensi penalaran
Saat
reasoning.effortdi ataslow, keheningan menjadi terasa. Preamble lisan yang singkat dapat ditambahkan di prompt sistem:Perilaku ini didokumentasikan untuk
gpt-realtime-2.Perilaku yang diamati
Pergantian giliran bekerja pada setelan default di ruangan yang tenang. Dengan speaker laptop, saya perlu membisukan mikrofon; tanpa itu, model mendengar keluarannya sendiri dan memulai loop gema.
Di ruangan yang lebih bising, setelan VAD dan penempatan mikrofon lebih berpengaruh. Memori percakapan tetap konsisten selama uji sepuluh menit, tetapi saya tidak akan merilis aplikasi yang lebih panjang tanpa rencana reconnect.
Putusan: Lulus untuk loop suara inti.
gpt-realtime-2menangani asisten dengan upaya penalaran rendah dalam uji saya. Pekerjaan ekstra ada di klien: pemutaran, penanganan interupsi, reconnect, dan pemanggilan tool jika aplikasi membutuhkannya.Demo Streamlit: Tiga Model dalam Satu Antarmuka
Aplikasi Streamlit menempatkan pengujian di balik pemilih tab. Anda bisa merekam audio, memilih bahasa target, dan membandingkan jalur model tanpa mengedit skrip. Saya menjaga ini sebagai aplikasi demo alih-alih jalur pengajaran utama, karena skrip terminal menampilkan event lebih langsung.
Tiga model dalam satu antarmuka bertab. Gambar oleh Penulis.
Video demo di bawah menunjukkan tab terhadap kunci API aktif. Setiap tab menggunakan panggilan Realtime WebSocket nyata.